
作者注:Kimi K3.1 Pro の 2.8T パラメータ、104B の活性化パラメータ、MXFP4 量子化、1M コンテキストを解説します。重みの容量と必要なハードウェアを見積もり、$2/$10 の API 価格と比較したうえで、「自部署か API か」を判断するための表とチェックリストを紹介します。
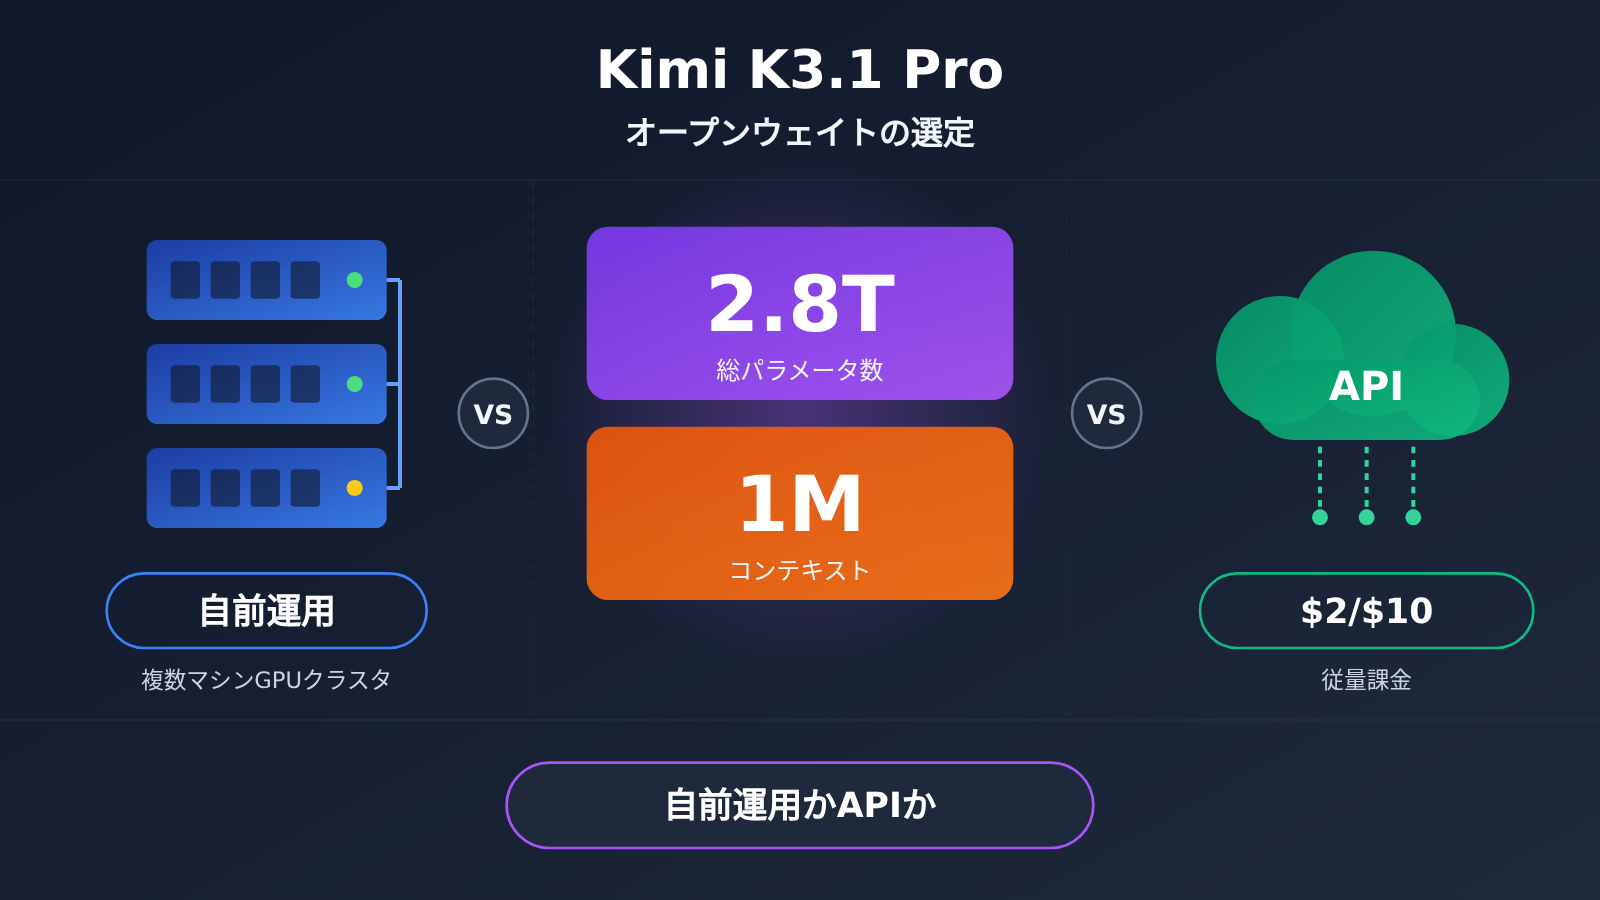
先に結論を言うと、Kimi K3.1 Pro は総パラメータ数 2.8T の MoE モデルで、1台のマシンでは動かせません。MXFP4 で見積もっても、重みだけで TB 単位の容量が必要です。一般的な 8 GPU 搭載の単一ノードサーバーには収まらず、複数ノードにまたがる GPU でのデプロイが必要になります。さらに、1M コンテキストの KV Cache 用に GPU メモリを確保しなければなりません。重みの公開によって「モデルを入手できるか」という問題は解決しますが、「モデルを十分に動かせるか」のハードルが下がるわけではありません。
そのため、ほとんどの技術チームにとっては、まず $2/$10 の価格で API を利用するほうが現実的です。呼び出し量が多く安定している、データを自社のデータセンター内に留める必要がある、チームに GPU クラスタの運用能力がある――この3つの条件がすべて揃って初めて、自部署のコストを本格的に検討する価値があります。この記事ではベンチマークの結果を繰り返すのではなく、まず重みとハードウェアに必要なコストを見積もり、次に稼働率と運用コストを検討したうえで、チームのタイプ別におすすめの選択肢を紹介します。まずは性能を検証したいという場合は、APIYI apiyi.com のような集約プラットフォームを1つのキーで利用し、その後の方針を決めることもできます。
Kimi K3.1 Pro の仕様:2.8T パラメータと 1M コンテキストが意味すること
Kimi K3.1 Pro は K3.1 シリーズの最初のモデルで、重みが公開されています。MoE(混合エキスパート)アーキテクチャを採用し、総パラメータ数は 2.8T、各トークンで実際に活性化されるパラメータは約 104B です。ストレージコストは 2.8T に応じてかかる一方、計算コストは 104B 規模の稠密モデルに近いと考えるとわかりやすいでしょう。これは MoE を自前でデプロイする際の典型的な悩みでもあります。計算能力の要件はそれほど大きくないものの、必要な GPU メモリを減らすのは困難です。
もう一つの重要なポイントは、量子化を考慮した学習(QAT)です。公式には MXFP4 の重みと MXFP8 の活性値を組み合わせ、学習段階から量子化を考慮しています。つまり、低精度での動作がモデルの「ネイティブな形」であり、事後的に圧縮したものではありません。理論上、精度の損失を抑えやすくなります。ただし、推論ハードウェアや推論エンジンには、MX シリーズのマイクロスケーリング形式を効率的にサポートすることが求められます。
| 仕様項目 | Kimi K3.1 Pro の仕様 | 選定時のポイント |
|---|---|---|
| アーキテクチャ | MoE、93 層 | ストレージは総パラメータ数、計算量は活性化パラメータ数に応じて決まる |
| 総パラメータ数 | 2.8T | 重みのサイズと GPU メモリの必要量の下限を左右する |
| 活性化パラメータ数 | 104B | トークンあたりの計算量を左右する |
| 視覚エンコーダー | MoonViT-V2、401M パラメータ | ネイティブのマルチモーダル対応で、画像理解に外部ツールは不要 |
| 量子化方式 | MXFP4 の重み / MXFP8 の活性値、QAT | 低精度がネイティブな形で、ハードウェアのサポートが必要 |
| コンテキスト | 1M tokens | 長文書や大規模リポジトリに適しているが、KV Cache の負荷が大きい |
| 想定用途 | プログラミング、3D 制作、金融リサーチ、Agent | 複雑なタスクや複数段階にわたる呼び出しを重視 |
Kimi K3.1 Pro の 1M コンテキストとマルチモーダル機能
1M tokens のコンテキストウィンドウには、中規模のコードリポジトリや決算資料一式、長編の研究資料を一度に収められます。これはまさに Agent や金融リサーチの用途で求められる能力です。また、ネイティブのマルチモーダル対応により、画像やスクリーンショット、グラフを直接読み取れるため、3D 制作やプログラミングのタスクにも活用しやすくなっています。
ただし、自前でデプロイする場合、これらの機能にはいずれもコストが伴います。長いコンテキストでは KV Cache がシーケンス長に比例して増加するため、1M をフルに使うと GPU メモリの使用量が非常に大きくなる可能性があります。視覚エンコーダー自体は大きくないものの、マルチモーダル入力の前処理やバッチ処理のスケジューリングによって、推論サービスはより複雑になります。API を利用する場合、これらはサービス提供側が担うため、利用者はトークンに応じた料金を支払うだけです。
Kimi K3.1 Pro の重みのサイズと必要なハードウェア
Kimi K3.1 Pro の重みの推定サイズ
まず、以下のサイズはパラメータ数からの推定値であり、実際のファイルサイズは公式発表を確認してください。MXFP4 では1パラメータあたり約4 bit、つまり0.5バイトを使用するため、2.8Tパラメータは約1.4TBになります。MX形式ではブロックごとのスケーリング係数も別途保存する必要があり、さらに視覚エンコーダーや埋め込み層などはより高い精度で保持される可能性もあります。そのため、実際のファイルサイズは単純な計算値より少し大きくなるのが一般的です。
| 精度の想定 | 1パラメータあたりのバイト数 | 2.8Tの重みの推定サイズ | 説明 |
|---|---|---|---|
| MXFP4 | 約0.5バイト | 約1.4TB | 公式が主に推奨する形式。スケーリング係数のオーバーヘッドは含まない |
| 8 bit級 | 約1バイト | 約2.8TB | 比較用であり、公式の推奨ではない |
| BF16 | 2バイト | 約5.6TB | QATの意義を示すための比較用 |
この表が示すように、最も容量を抑えられるMXFP4でも、重みのサイズはTB級です。ダウンロード、整合性の検証、複数マシンへの配布だけでも相応の作業が必要で、ストレージと内部ネットワークの帯域を事前に計画しておく必要があります。
Kimi K3.1 Pro の自己ホスティングに必要なハードウェア
1.4TBとして大まかに計算すると、80GBのVRAMを搭載したアクセラレータカードを使う場合、重みを格納するだけで約18枚が必要です。これにはKV Cache、活性値、推論エンジンの動作に必要な容量は含まれていません。一般的な8枚構成のサーバーでは明らかに足りず、1枚あたりのVRAMがより大きい新世代カードに変更しても、単一ノードでは重みをかろうじて格納できる程度で、長いコンテキストに必要な余裕を確保するのは困難です。そのため、現実的には複数カード・複数マシンを使い、テンソル並列、エキスパート並列、パイプライン並列を組み合わせてモデルを分割することになります。
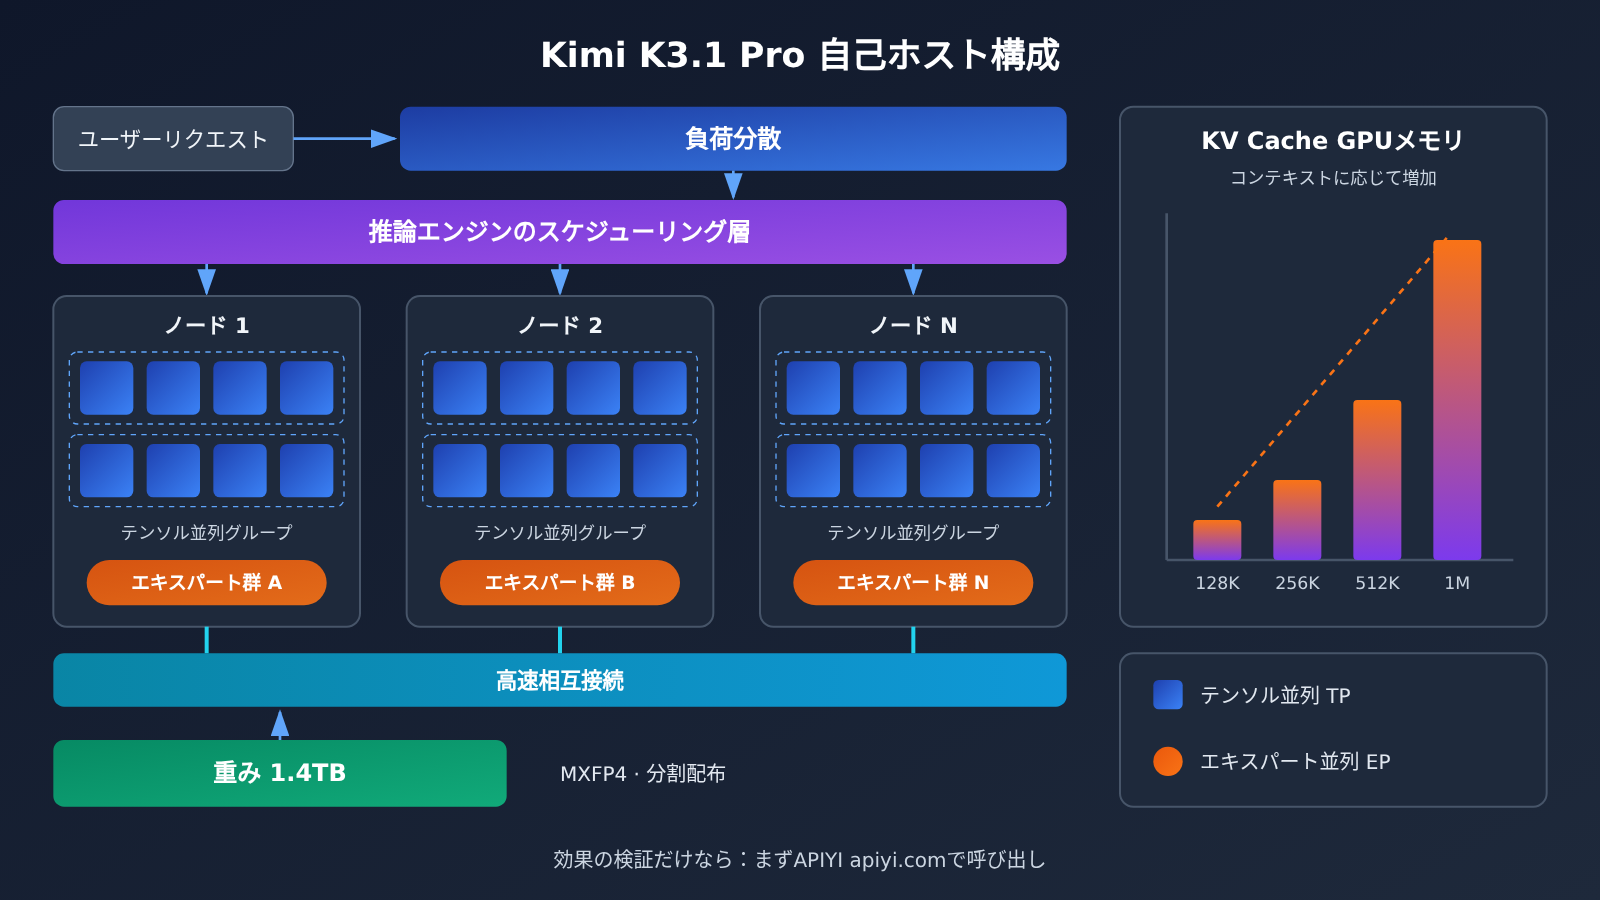
ハードウェア以外にも、過小評価されがちなコストがいくつかあります。
- 推論エンジンと並列化戦略:MoEのエキスパート並列とMX形式をサポートする推論フレームワークが必要です。推奨エンジンや並列化の構成については、公式のデプロイドキュメントを確認してください。
- ノード間接続:エキスパート並列ではノード間の通信が大量に発生するため、ネットワークの帯域幅とレイテンシがスループットに直接影響します。
- サーバールームと電力:複数マシンからなるGPUクラスターの電源、冷却、ラックスペースを事前に確保する必要があります。
- ピーク時の処理容量:アクセスが集中する時間帯に備えて余剰容量が必要ですが、閑散時にはその計算資源が遊休コストになります。
- 運用人員:モデルのアップグレード、障害対応、監視とアラートには、GPUクラスターに詳しいエンジニアによる継続的な対応が必要です。
なお、参考資料には公式のスループットとコストの実測データがないため、この記事でも自社構築にかかる具体的な費用は提示していません。実際にプロジェクトを立ち上げる際は、公式のデプロイドキュメントと自社での負荷テスト結果を基に判断してください。
Kimi K3.1 Pro のライセンス:オープンウェイトでも商用利用は自由とは限らない
「オープンウェイト」と「オープンソースで自由に商用利用できる」ことは別物です。モデルを選定する段階で、必ず確認しましょう。多くのオープンウェイトモデルでは、売上やユーザー規模に応じた制限、製品内での出典表示義務など、商用利用に条件を設けています。Kimi K3.1 Pro の具体的な商用利用条件、売上の閾値、通知義務については、必ず公式ライセンスの原文を確認してください。
直接的な商用利用のほかにも、追加の要件が生じる可能性がある行為があります。
- 配布:重みやその派生版を第三者に提供すること。
- 変更:ファインチューニング、蒸留、マージ後のモデルにライセンスがどう適用されるか。
- ホスティングサービス:自社でデプロイしたモデルを API として外部に提供すること。ライセンスで特に制約されることが多いケースです。
ハードウェアを購入する前に、法務担当者と技術責任者が一緒にライセンスを条項ごとに確認し、書面で結論をまとめることをおすすめします。公式 API や第三者プラットフォームを通じて呼び出す場合は、主にサービス利用規約に従うことになり、通常は重みの配布に関する問題は生じません。ただし、データの取り扱いや利用範囲が規約に適合しているかは、同様に確認が必要です。
Kimi K3.1 Pro API の料金:$2/$10 をどう計算する?
公式 API のモデル ID は kimi-k3.1-pro です。OpenAI および Anthropic と互換性のあるインターフェースを提供しているため、既存プロジェクトへの導入に必要な変更はわずかです。料金は 100 万 tokens あたりで計算されます。
| 課金項目 | 標準版 kimi-k3.1-pro |
Highspeed 版 | 説明 |
|---|---|---|---|
| 入力 | $2 |
$4 |
100 万 tokens あたり |
| 出力 | $10 |
$20 |
100 万 tokens あたり |
| キャッシュヒット | $0.20 |
公式情報を参照 | 繰り返し使う接頭部分のコストを大幅に削減可能 |
| キャッシュ書き込み | $2 |
公式情報を参照 | 標準入力と同じ料金 |
| 速度 | 基準 | 約 3 倍 | 低遅延が求められる場面向け |
計算例を見てみましょう(実測値ではなく、料金換算の例です)。月間入力が 1 億 tokens、出力が 2,000 万 tokens の場合、標準版の料金は 100 × $2 + 20 × $10 = 約 $400 です。入力の 70% がキャッシュにヒットすると、入力部分は 70 × $0.20 + 30 × $2 = $74 となり、合計は約 $274 に下がります。同じ使用量で Highspeed 版を使う場合、キャッシュを考慮しなければ約 $800 です。
この金額から、コスト感がよくわかります。月に 1 億 tokens 以上を呼び出しても、API 料金は複数台で構成する GPU クラスターの月間減価償却費、電気代、人件費の合計を大きく下回ります。Agent の利用では、システムプロンプトやツール定義が繰り返し使われることが多いため、キャッシュヒット料金を活用することが、API 利用時の最も直接的なコスト削減策です。
接続方法は、クライアントが OpenAI 互換プロトコルに対応していれば、base_url を https://api.apiyi.com/v1 に変更し、モデル名にプラットフォームが提供するモデル ID を入力するだけです。追加のアダプターを作成する必要はありません。
🚀 クイックスタート:チームで Kimi、Claude、GPT、Gemini の同じタスクにおける性能を比較したい場合は、APIYI apiyi.com を通じて、1 つの APIキーでまとめて呼び出せます。コンソールではモデル一覧、使用量、ログを確認できます。
kimi-k3.1-proの提供状況と具体的な料金は、コンソールの最新情報をご確認ください。
Kimi K3.1 Pro のセルフホスティングとAPIの主な違い
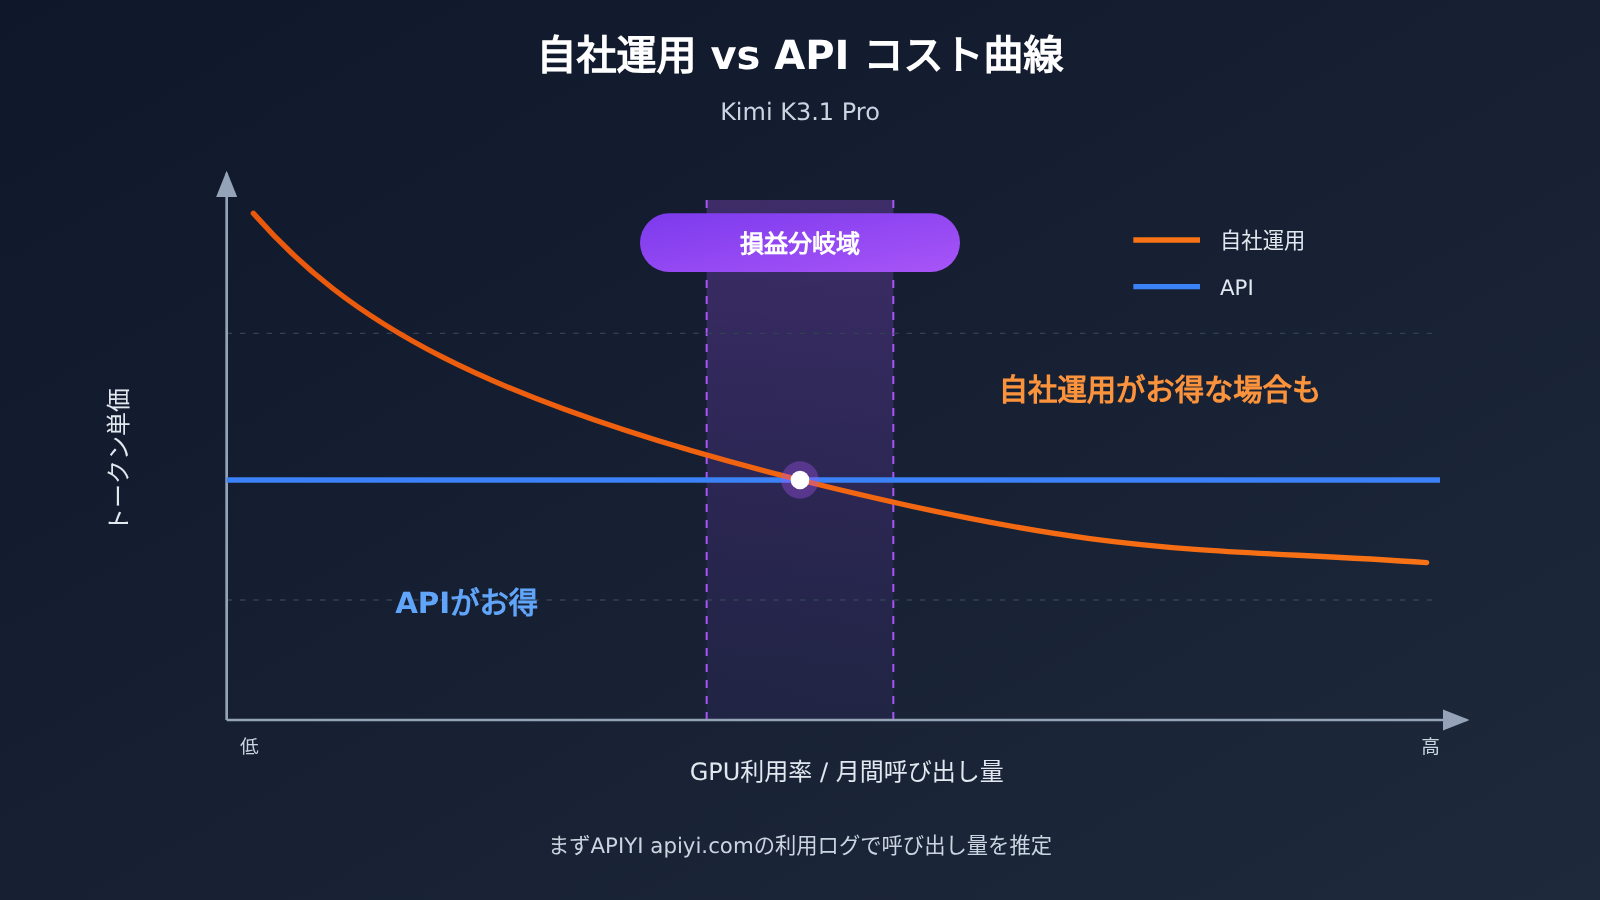
セルフホスティングとAPIの本質的な違いは、コスト構造にあります。APIは純粋な変動費で、使った分だけ支払うため、使わなければ費用はかかりません。一方、セルフホスティングは固定費が高く、限界費用が低い構造です。ハードウェア、サーバールーム、人員に一度投資すると、フル稼働していなくても費用が発生します。そのため、決め手となるのは利用率です。クラスターが長期間高負荷で稼働して初めて、固定費を含むトークン単価がAPIの料金を下回る可能性があります。
| 判断基準 | Kimi K3.1 Pro のセルフホスティング | APIの利用 | おすすめ |
|---|---|---|---|
| 利用率 | コストを分散するには長期間の高負荷稼働が必要 | 従量課金で、アイドル時の無駄がない | 利用頻度が低〜中程度ならAPI |
| データコンプライアンス | データを完全に自社環境内に保持できる | データをサービス提供者に送信する必要がある | 規制が厳しい場合はセルフホスティング |
| 初期投資 | 複数台のGPU、サーバールーム、ネットワークなどへの投資が大きい | ほぼゼロ | API |
| 運用コスト | 専任のGPUクラスター運用担当者が必要 | サービス提供者が負担 | API |
| ピーク時の拡張性 | 余剰リソースの確保が必要で、拡張にも時間がかかる | 比較的柔軟だが、レート制限を受ける | API |
| カスタマイズ性 | ファインチューニングや推論設定の変更が可能 | インターフェースのパラメーターに制限される | 高度なカスタマイズにはセルフホスティング |
| 運用開始までの時間 | 数週間〜数か月 | 数時間 | API |
| 利用方法 | 推論サービスを自前で構築 | 公式API、APIYI apiyi.com などのプラットフォーム | ニーズによる |
APIとの比較:APIは運用開始までの速さ、柔軟性、総保有コストの面で優位です。ただし、データを外部に送信する必要があり、インターフェースで調整できるパラメーターも限られます。これに対し、セルフホスティングはデータの管理と高度なカスタマイズに強く、厳しい規制下にあり、かつ呼び出し量が非常に多いチームに適しています。
セルフホスティングとの比較:セルフホスティングは単位コストの上限や制御性の面で可能性がある一方、初期投資、運用人員、リソースが遊休状態になるリスクはいずれも大きくなります。呼び出し量に変動がある場合や、GPUを運用するチームがない場合は、APIのほうが堅実な選択です。
Kimi K3.1 Pro の用途別おすすめと選択のポイント
Kimi K3.1 Pro API の利用に向いているチーム
- スタートアップや中小規模のチーム:GPUクラスターや専任の運用担当者がいない場合、APIが現実的な選択肢です。
- 呼び出し量の変動が大きい事業:日中はピークで夜間は閑散とする場合や、イベント期間中に急増する場合でも、従量課金ならリソースの遊休を避けられます。
- 迅速なリリースが必要なプロジェクト:製品の検証段階ではスピードが重要です。APIなら数時間で接続できます。
- 複数モデルを並行評価するチーム:同じタスクでほかのモデルと比較するなら、それぞれをデプロイするより、共通のインターフェースを使うほうがはるかに簡単です。
Kimi K3.1 Pro の自社デプロイに向いているチーム
- データを組織外に出せない場合:金融、医療、政府機関・企業などで、コンプライアンス上、データを完全に内部ネットワーク内に置く必要があるケースです。
- 高頻度かつ安定した呼び出しがある場合:24時間365日、高負荷が続き、長期にわたって高い稼働率を維持できます。
- GPUクラスターと運用チームをすでに持っている場合:追加投資を抑えながら、モデルを既存のインフラに組み込めます。
- 高度なカスタマイズが必要な場合:公開された重みを使ったファインチューニングや、特殊な推論最適化が必要なケースです。ただし、ライセンスで許可されていることが前提です。
ハイブリッドな選択肢
見落とされがちな方法として、試作にはAPIを使い、本番運用時に自社構築を再検討するという選択肢もあります。あるいは、機密性の高いデータは自社デプロイで処理し、一般的なトラフィックにはAPIを使う方法もあります。前者は実際の呼び出しデータに基づいて判断でき、後者はコンプライアンスと柔軟性を両立できます。
💡 選択のアドバイス:ハードウェアに投資する前に、まずはAPIYI(apiyi.com)を通じて一定期間、実際の業務トラフィックを処理することをおすすめします。コンソールの使用量ログから、1日あたりのトークン数、ピーク時と閑散時の比率、キャッシュヒット率を集計しましょう。これらのデータが、自社デプロイの採算性を判断する最も信頼できる根拠になります。
よくある質問 FAQ
Q1:Kimi K3.1 Pro は単一サーバーにセルフホストできますか?
MXFP4 で試算すると重みだけで約 1.4TB になるため、一般的な GPU 8 枚構成のサーバーには収まりません。GPU あたりの VRAM 容量が大きいノードでも、1M コンテキストの KV Cache に十分な余裕を確保するのは困難です。現実的には複数台・複数 GPU でのデプロイが必要で、具体的な構成は公式のデプロイドキュメントを確認してください。
Q2:活性化パラメータが 104B なら、ハードウェア要件も 104B を基準に考えればよいですか?
いいえ。活性化パラメータはトークンごとの計算量を左右しますが、すべてのエキスパートの重みを VRAM に常駐させる必要があるため、VRAM 要件は総パラメータ数の 2.8T を基準に計算します。これが MoE モデルの「計算は速いが、搭載する重みは多い」という特徴です。
Q3:重みが公開されたら、すぐに商用利用できますか?
必ずしもそうではありません。重みの公開は無条件の商用利用を意味するものではなく、収益の閾値、通知義務、ホスティングサービスに関する制限などは、公式ライセンスの原文を確認する必要があります。ハードウェアを調達する前に、法務担当者に確認することをおすすめします。
Q4:Kimi K3.1 Pro の API を低コストで試すにはどうすればよいですか?
APIYI apiyi.com に登録すると、新規ユーザー向けの無料テスト枠を使って、OpenAI 互換インターフェース経由で既存プロジェクトに組み込めます。プラットフォームでは 1 つの APIキーで Kimi シリーズや Claude、GPT、Gemini などのモデルを呼び出せます。`kimi-k3.1-pro` の提供状況と価格はコンソールで確認してください。
Q5:標準版と Highspeed 版はどう選べばよいですか?
Highspeed の価格は `$4/$20` で、標準版の 2 倍ですが、速度は約 3 倍です。ユーザーとのリアルタイムな対話や、最初の文字が出力されるまでの遅延に敏感なエージェントには Highspeed が適しています。オフラインのバッチ処理やバックグラウンドタスクでは、標準版とキャッシュを組み合わせるほうが費用を抑えられます。
まとめ:Kimi K3.1 Pro の自部署 vs API チェックリスト
Kimi K3.1 Pro の重みが公開されたことで、条件の整ったチームは完全に管理できる選択肢を手にしました。ただし、2.8T パラメータという規模から「クラスター級」のモデルに分類されます。自部署のハードルは、重みをダウンロードできるかどうかよりも、ハードウェア、稼働率、運用・保守、ライセンスの4つにあります。多くのチームにとっては、まず $2/$10 の API でサービスを稼働させ、実際のデータをもとに自部署を検討するのが最もリスクの低い進め方です。
Kimi K3.1 Pro の重要ポイント Key Takeaways
- 仕様:総パラメータ数 2.8T、活性化パラメータ数 104B、93層の MoE、ネイティブマルチモーダル、コンテキストウィンドウ 1M。
- 重み:MXFP4 で約 1.4TB と推定。実際のサイズは公式ファイルを確認する必要があり、単一マシンには収まりません。
- ハードウェア:複数 GPU・複数マシンでの並列デプロイが必要。長いコンテキスト向けの KV Cache 用に GPU メモリを確保する必要もあります。
- ライセンス:重みの公開は、無条件での商用利用を意味しません。条件は公式ライセンスを確認してください。
- 価格:標準版は
$2/$10、キャッシュヒット時は$0.20、Highspeed は$4/$20。 - 判断:稼働率が重要な変数です。利用頻度が低〜中程度で変動の大きいサービスでは、まず API を選びましょう。
自部署 vs API チェックリスト
| チェック項目 | API を選ぶ目安 | 自部署を選ぶ目安 |
|---|---|---|
| 呼び出し量 | 月間の呼び出し量が少ない、または変動が大きい | 長期にわたり 7×24 の高負荷で稼働する |
| データコンプライアンス | データをサービス提供者に送信できる | データを社内ネットワーク内に留める必要がある |
| GPU 環境 | クラスターも専任の運用担当者もいない | 複数マシンのクラスターと運用チームがある |
| ライセンス | 配布やホスティングの条項を扱いたくない | 法務部門が商用利用の条件を確認済み |
| 提供開始までの時間 | できるだけ早くリリースして検証したい | 数週間から数か月のデプロイ期間を許容できる |
| コストデータ | 実際の呼び出し統計がまだない | 実データを使って損益分岐点を算出済み |
チェック項目の大半が左列に当てはまるなら、API を選べば十分です。APIYI apiyi.com なら、1つの Key で Kimi シリーズやその他の主要モデルにアクセスできます。コンソールの利用ログで実データを蓄積し、呼び出し量やコンプライアンス要件が自部署に見合う段階になったら、そのデータをもとに検討することをおすすめします。
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYI のサイトトップページからお気軽にお問い合わせください。接続方法の詳細は docs.apiyi.com のドキュメントセンターをご覧ください。


