
Note de l’auteur : analyse des 2.8T de paramètres de Kimi K3.1 Pro, dont 104B activés, de sa quantification MXFP4 et de sa fenêtre de contexte de 1M. Nous estimons la taille des poids et les exigences matérielles, puis les comparons au tarif API de $2/$10, avec un tableau de décision et une liste de vérification pour choisir entre autodéploiement et API.
Commençons par la conclusion : Kimi K3.1 Pro est un modèle MoE de 2.8T de paramètres au total, impossible à faire fonctionner sur une seule machine. Avec une estimation en MXFP4, les poids seuls occupent plusieurs téraoctets. Ils ne tiennent pas sur un serveur classique à 8 cartes GPU : il faut au minimum un déploiement multi-GPU réparti sur plusieurs nœuds, tout en réservant de la mémoire GPU pour le cache KV de la fenêtre de contexte de 1M. L’ouverture des poids résout la question de l’accès au modèle, mais ne facilite pas pour autant son exploitation dans de bonnes conditions.
Pour la grande majorité des équipes techniques, commencer par utiliser l’API au tarif de $2/$10 est donc plus réaliste. L’autodéploiement ne mérite une étude sérieuse des coûts que si trois conditions sont réunies : un volume d’appels élevé et stable, l’obligation de conserver les données dans ses propres locaux et une équipe capable d’exploiter un cluster GPU. Plutôt que de répéter les résultats des benchmarks, cet article calcule d’abord les coûts liés aux poids et au matériel, puis ceux liés au taux d’utilisation et à l’exploitation, avant de proposer des recommandations selon le profil de l’équipe. Pour commencer par vérifier les performances, vous pouvez passer par une plateforme d’agrégation comme APIYI apiyi.com avec une seule clé, puis décider de la suite.
Kimi K3.1 Pro : ce que signifient ses 2.8T de paramètres et son contexte de 1M
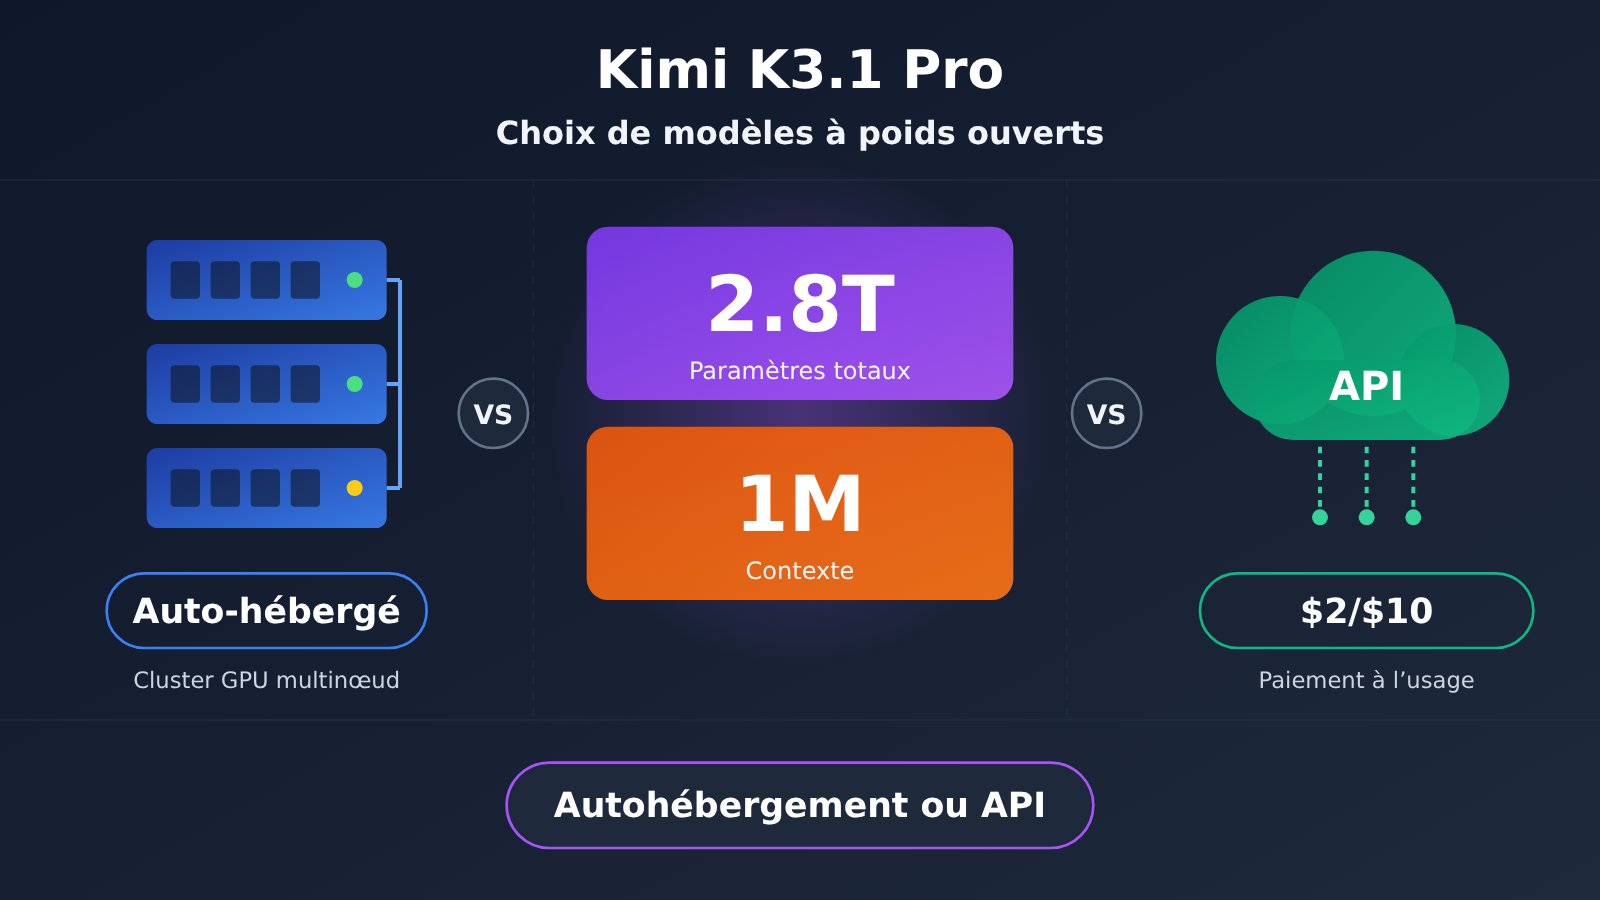
Kimi K3.1 Pro est le premier modèle de la série K3.1. Ses poids sont disponibles en accès ouvert. Il repose sur une architecture MoE (mélange d’experts) qui compte 2.8T de paramètres au total, dont environ 104B sont activés pour chaque token. Autrement dit, le coût de stockage correspond aux 2.8T de paramètres, tandis que le coût de calcul se rapproche de celui d’un modèle dense de 104B de paramètres. C’est le compromis classique du déploiement autonome d’un MoE : les besoins en calcul restent relativement maîtrisés, mais ceux en mémoire GPU sont difficiles à réduire.
Autre point clé : l’entraînement sensible à la quantification (QAT). Le modèle utilise des poids MXFP4 et des activations MXFP8, avec une quantification prise en compte dès l’entraînement. La basse précision est donc son « format natif », plutôt qu’une version compressée après coup. En théorie, cela permet de mieux maîtriser la perte de précision. En revanche, le matériel et le moteur d’inférence doivent prendre en charge efficacement les formats à micro-échelle de la famille MX.
| Caractéristique | Spécification de Kimi K3.1 Pro | Ce que cela implique pour le choix du modèle |
|---|---|---|
| Architecture | MoE, 93 couches | Le stockage dépend du nombre total de paramètres, le calcul du nombre de paramètres activés |
| Paramètres totaux | 2.8T | Déterminent le volume des poids et la mémoire GPU minimale nécessaire |
| Paramètres activés | 104B | Déterminent la quantité de calcul par token |
| Encodeur visuel | MoonViT-V2, 401M de paramètres | Multimodal natif : aucun composant externe nécessaire pour comprendre les images |
| Quantification | Poids MXFP4 / activations MXFP8, QAT | La basse précision est native, mais dépend de la prise en charge matérielle |
| Contexte | 1M de tokens | Adapté aux longs documents et aux grands dépôts, mais exigeant pour le cache KV |
| Usages ciblés | Programmation, création 3D, recherche financière, agents | Privilégie les tâches complexes et les chaînes d’appels longues |
La fenêtre de contexte de 1M et les capacités multimodales de Kimi K3.1 Pro
Une fenêtre de contexte de 1M de tokens permet d’intégrer en une seule fois un dépôt de code de taille moyenne, un ensemble complet de rapports financiers ou de longs documents de recherche. C’est précisément ce qu’il faut pour les agents et la recherche financière. Le multimodal natif permet aussi au modèle de lire directement des images, des captures d’écran et des graphiques, ce qui facilite les tâches de création 3D et de programmation.
Ces deux capacités ont toutefois un coût en déploiement autonome. Avec un long contexte, le cache KV grandit de façon linéaire avec la longueur de la séquence : utiliser la totalité du contexte de 1M peut donc consommer beaucoup de mémoire GPU. L’encodeur visuel lui-même est peu volumineux, mais le prétraitement des entrées multimodales et l’organisation des lots rendent le service d’inférence plus complexe. En passant par une API, le fournisseur prend ces aspects en charge et vous ne payez qu’au token.
Taille des poids de Kimi K3.1 Pro et exigences matérielles
Estimation de la taille des poids de Kimi K3.1 Pro
Précisons d’abord que les tailles ci-dessous sont estimées à partir du nombre de paramètres ; la taille réelle des fichiers dépendra de la version publiée officiellement. En MXFP4, chaque paramètre occupe environ 4 bits, soit 0,5 octet. Pour 2.8T paramètres, cela représente environ 1.4 TB. Le format MX nécessite aussi un espace supplémentaire pour les facteurs d’échelle par bloc. En ajoutant les composants qui peuvent conserver une précision plus élevée, comme l’encodeur visuel et les couches d’embedding, les fichiers réels sont généralement un peu plus volumineux que cette estimation théorique.
| Précision supposée | Octets par paramètre | Taille estimée des poids pour 2.8T paramètres | Remarques |
|---|---|---|---|
| MXFP4 | Environ 0,5 octet | Environ 1.4 TB | Format mis en avant officiellement, sans l’espace supplémentaire nécessaire aux facteurs d’échelle |
| Niveau 8 bits | Environ 1 octet | Environ 2.8 TB | À titre de comparaison uniquement, non recommandé officiellement |
| BF16 | 2 octets | Environ 5.6 TB | À titre de comparaison uniquement, pour illustrer l’intérêt du QAT |
Ce tableau montre que même dans le format MXFP4, le plus économe, les poids représentent déjà plusieurs téraoctets. Leur téléchargement, leur vérification et leur distribution sur plusieurs machines constituent un projet d’ingénierie à part entière : il faut prévoir le stockage et la bande passante du réseau interne en amont.
Exigences matérielles pour héberger Kimi K3.1 Pro soi-même
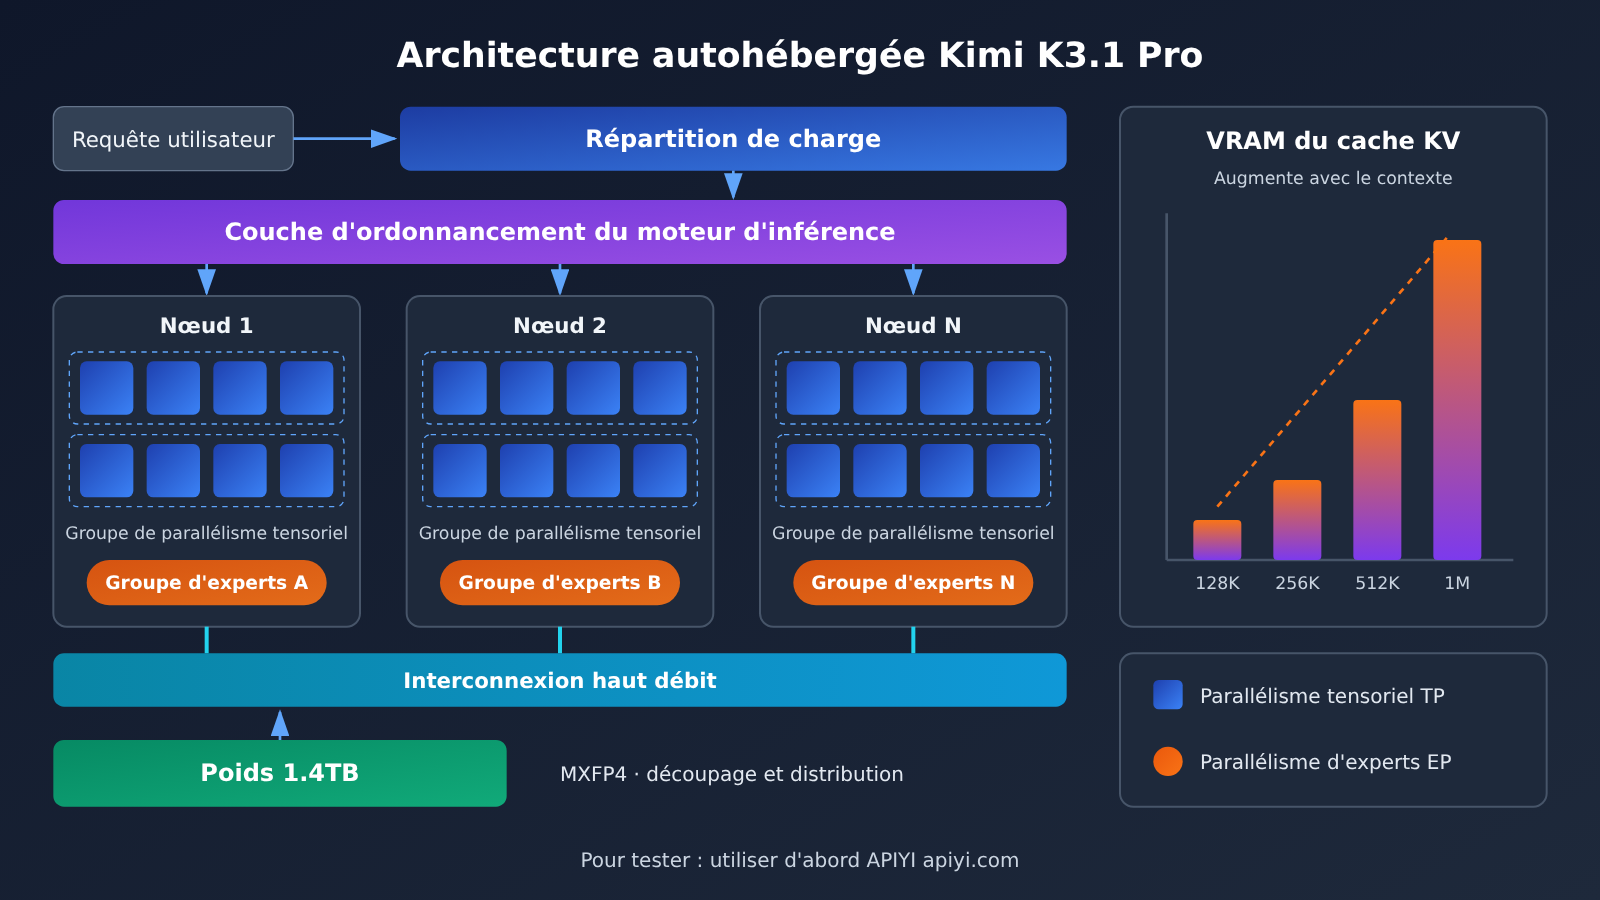
Sur la base d’une estimation de 1.4 TB, il faut près de 18 cartes accélératrices dotées de 80 GB de mémoire vidéo rien que pour charger les poids. Et cela ne tient pas compte du KV Cache, des activations ni des ressources nécessaires au fonctionnement du moteur d’inférence. Un serveur classique à 8 cartes ne suffit clairement pas. Même avec des cartes de nouvelle génération dotées de plus de mémoire, un seul nœud pourra tout juste contenir les poids, sans laisser suffisamment de marge pour les contextes longs. En pratique, il faut donc une configuration multicarte et multiserveur, qui répartit le modèle en combinant parallélisme tensoriel, parallélisme des experts et parallélisme par pipeline.
Au-delà du matériel, plusieurs catégories de coûts sont faciles à sous-estimer :
- Moteur d’inférence et stratégie de parallélisme : il faut un framework d’inférence compatible avec le parallélisme des experts MoE et le format MX. Pour le moteur recommandé et la configuration du parallélisme, référez-vous à la documentation officielle de déploiement.
- Interconnexion entre les nœuds : le parallélisme des experts génère beaucoup de communications entre les nœuds. La bande passante et la latence du réseau ont donc un effet direct sur le débit.
- Salle serveurs et alimentation électrique : l’alimentation, le refroidissement et l’espace en baie d’un cluster GPU multiserveur doivent être prévus à l’avance.
- Capacité en période de pointe : les pics d’activité exigent une capacité supplémentaire qui reste inutilisée pendant les périodes creuses, tout en continuant à coûter.
- Équipe d’exploitation : les mises à niveau du modèle, le dépannage, la supervision et les alertes nécessitent l’intervention régulière d’ingénieurs qui maîtrisent les clusters GPU.
À noter : les sources consultées ne fournissent pas de mesures officielles du débit ni des coûts, et cet article ne propose donc pas de devis ferme pour une infrastructure interne. Si vous envisagez de lancer le projet, basez-vous sur la documentation officielle de déploiement et sur vos propres tests de charge.
Licence de Kimi K3.1 Pro : poids ouverts ne veut pas dire usage commercial sans condition
« Poids ouverts » et « open source librement utilisable à des fins commerciales » sont deux choses différentes. Vérifiez ce point dès le choix du modèle. Les licences de nombreux modèles à poids ouverts imposent des conditions à l’usage commercial : seuils de revenus ou de nombre d’utilisateurs, obligation de mentionner la source dans le produit, etc. Pour connaître les conditions commerciales, les seuils de revenus et les obligations de notification de Kimi K3.1 Pro, seul le texte de la licence officielle fait foi.
Au-delà de l’usage commercial direct, plusieurs types d’activités peuvent être soumis à des exigences supplémentaires :
- Distribution : fournir les poids ou des versions dérivées à des tiers.
- Modification : déterminer comment la licence s’applique aux modèles affinés, distillés ou fusionnés.
- Service hébergé : proposer à des tiers, sous forme d’API, un modèle déployé sur sa propre infrastructure. C’est souvent un cas d’usage particulièrement encadré par les licences.
Il est conseillé aux responsables juridiques et techniques d’examiner ensemble chaque clause de la licence et de consigner leurs conclusions par écrit avant d’acheter du matériel. Lorsque vous utilisez l’API officielle ou une plateforme tierce pour invoquer le modèle, ce sont principalement les conditions de service qui s’appliquent. La distribution des poids n’est généralement pas en jeu, mais il reste nécessaire de vérifier que l’utilisation des données et les usages prévus sont conformes.
Prix de l’API Kimi K3.1 Pro : comment calculer les coûts à $2/$10
L’ID du modèle dans l’API officielle est kimi-k3.1-pro. Il propose des interfaces compatibles avec OpenAI et Anthropic, ce qui demande peu de modifications dans les projets existants. Les tarifs sont indiqués par million de tokens :
| Facturation | Version standard kimi-k3.1-pro |
Version Highspeed | Détails |
|---|---|---|---|
| Entrée | $2 |
$4 |
Par million de tokens |
| Sortie | $10 |
$20 |
Par million de tokens |
| Accès au cache | $0.20 |
Voir le tarif officiel | Les préfixes répétés peuvent réduire fortement les coûts |
| Écriture dans le cache | $2 |
Voir le tarif officiel | Même prix que l’entrée standard |
| Vitesse | Référence | Environ 3 fois plus rapide | Utile lorsque la latence est importante |
Prenons un exemple pour comprendre le calcul : il s’agit d’une conversion tarifaire, pas d’un test réel. Avec 100 millions de tokens en entrée et 20 millions en sortie par mois, la version standard coûterait environ 100 × $2 + 20 × $10 = $400. Si 70 % des entrées sont servies depuis le cache, leur coût passe à 70 × $0.20 + 30 × $2 = $74, soit un total d’environ $274. En version Highspeed, pour le même usage et sans tenir compte du cache, le coût serait d’environ $800.
Ces ordres de grandeur sont parlants : même avec des centaines de millions de tokens par mois, la facture API reste bien inférieure à la somme de l’amortissement mensuel, de l’électricité et des coûts de personnel d’un cluster GPU multiserveur. Dans les scénarios d’agents, les invites système et les définitions d’outils sont souvent très répétitives. Profiter du tarif des accès au cache est donc le moyen le plus direct de réduire les coûts avec une API.
Pour l’intégration, si votre client prend en charge le protocole compatible OpenAI, il suffit de remplacer base_url par https://api.apiyi.com/v1 et de renseigner l’ID du modèle fourni par la plateforme. Aucune couche d’adaptation supplémentaire n’est nécessaire.
🚀 Démarrage rapide : si votre équipe souhaite comparer les performances de Kimi, Claude, GPT et Gemini sur une même tâche, APIYI apiyi.com permet de les invoquer avec une seule clé API et de consulter la liste des modèles, l’utilisation et les journaux dans la console. Pour savoir si
kimi-k3.1-proest disponible et à quel prix, consultez les informations en temps réel dans la console.
Kimi K3.1 Pro : principales différences entre auto-hébergement et API
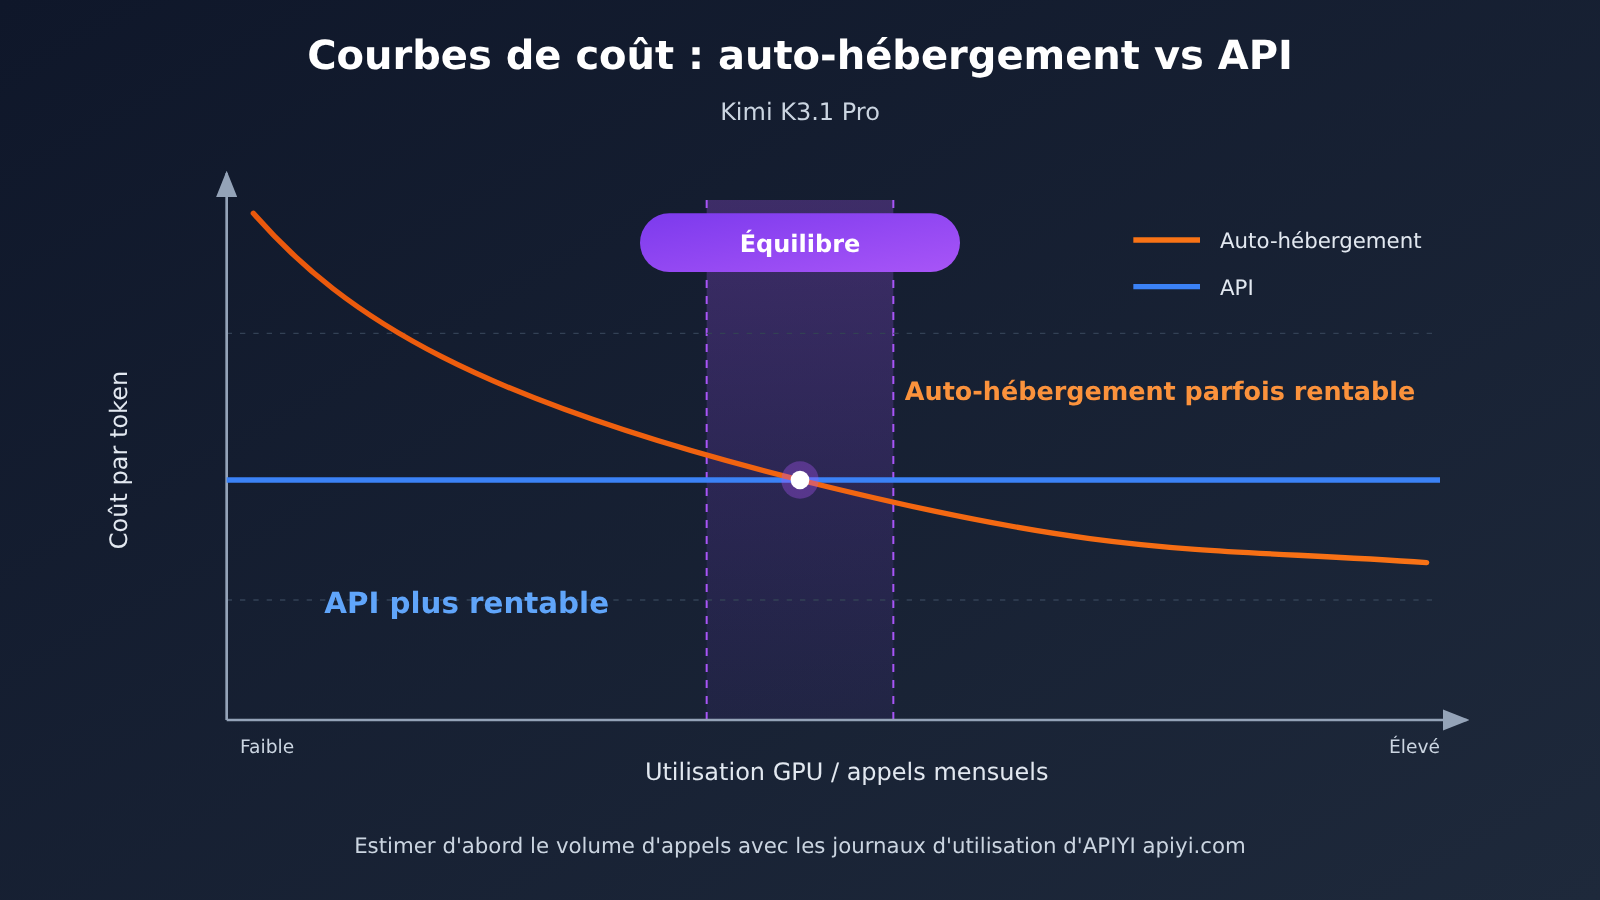
La différence fondamentale entre l’auto-hébergement et l’API tient à la structure des coûts. L’API repose uniquement sur des coûts variables : vous payez ce que vous utilisez, et rien lorsque vous ne l’utilisez pas. L’auto-hébergement combine des coûts fixes élevés et un faible coût marginal : une fois le matériel, l’infrastructure et les équipes en place, les dépenses continuent, que les ressources soient pleinement utilisées ou non. La variable décisive est donc le taux d’utilisation : ce n’est que si le cluster reste durablement très sollicité que le coût par token, une fois les frais amortis, peut devenir inférieur au tarif de l’API.
| Critère de décision | Auto-hébergement de Kimi K3.1 Pro | Utilisation de l’API | Option à privilégier |
|---|---|---|---|
| Taux d’utilisation | Charge élevée et durable nécessaire pour amortir les coûts | Paiement à l’usage, sans gaspillage lié aux ressources inutilisées | API pour une utilisation faible à moyenne |
| Conformité des données | Les données peuvent rester entièrement dans le périmètre de l’organisation | Les données doivent être envoyées au fournisseur | Auto-hébergement en cas de réglementation stricte |
| Investissement initial | Important : plusieurs machines GPU, infrastructure et réseau | Presque nul | API |
| Coûts d’exploitation | Nécessite une équipe dédiée à l’exploitation du cluster GPU | Pris en charge par le fournisseur | API |
| Élasticité en période de pointe | Capacité supplémentaire à prévoir ; montée en charge lente | Bonne élasticité, sous réserve des limites de débit | API |
| Personnalisation | Ajustement fin et modification de la configuration d’inférence possibles | Limitée aux paramètres de l’interface | Auto-hébergement pour une personnalisation poussée |
| Délai de mise en production | De plusieurs semaines à plusieurs mois | Quelques heures | API |
| Canal d’accès | Service d’inférence développé en interne | API officielle, plateformes comme APIYI apiyi.com | Selon les besoins |
Analyse comparative de l’API : l’API garde l’avantage en matière de rapidité de mise en production, d’élasticité et de coût total de possession. En revanche, les données doivent sortir du périmètre de l’organisation et les paramètres configurables de l’interface sont limités. L’auto-hébergement offre un meilleur contrôle des données et une personnalisation plus poussée : il convient davantage aux équipes soumises à une réglementation stricte et dont le volume d’appels est très élevé.
Analyse comparative de l’auto-hébergement : l’auto-hébergement peut offrir un coût unitaire plus avantageux et un meilleur contrôle, mais l’investissement initial, les besoins en personnel d’exploitation et le risque de ressources inutilisées sont élevés. Lorsque le volume d’appels fluctue ou qu’aucune équipe GPU n’est disponible, l’API reste le choix le plus prudent.
Kimi K3.1 Pro : cas d’usage et conseils pour choisir
Les équipes qui ont intérêt à utiliser l’API Kimi K3.1 Pro
- Start-up et petites équipes : sans cluster GPU ni équipe d’exploitation dédiée, l’API est la seule option raisonnable.
- Activités dont le volume d’appels fluctue fortement : pics en journée, creux la nuit ou hausse soudaine lors d’un événement : la facturation à l’usage évite de payer des ressources inutilisées.
- Projets à lancer rapidement : pendant la phase de validation d’un produit, la vitesse prime. L’intégration peut être réalisée en quelques heures.
- Évaluation de plusieurs modèles en parallèle : pour comparer différents modèles sur une même tâche, une interface unifiée est bien plus simple que des déploiements séparés.
Les équipes qui ont intérêt à déployer Kimi K3.1 Pro elles-mêmes
- Données devant rester dans le réseau interne : dans la finance, la santé ou les organismes publics, les exigences de conformité peuvent imposer que toutes les données restent sur place.
- Appels fréquents et réguliers : la charge reste élevée 24 heures sur 24, 7 jours sur 7, et le taux d’utilisation peut se maintenir durablement à un niveau élevé.
- Cluster GPU et équipe d’exploitation déjà en place : l’investissement supplémentaire reste maîtrisable et le modèle peut être intégré à l’infrastructure existante.
- Besoins de personnalisation poussée : il faut affiner le modèle à partir de ses poids ouverts ou appliquer des optimisations d’inférence spécifiques, sous réserve que la licence l’autorise.
L’approche hybride
Une autre solution, souvent négligée, consiste à utiliser l’API pour le prototypage, puis à réévaluer le déploiement en interne pour la production. On peut aussi faire l’inverse : traiter les données sensibles avec un modèle déployé en interne et utiliser l’API pour le trafic courant. La première approche permet de remplacer les estimations approximatives par des données d’utilisation réelles ; la seconde concilie conformité et flexibilité.
💡 Notre conseil : avant d’investir dans du matériel, faites passer votre trafic réel par APIYI apiyi.com pendant quelque temps. Utilisez les journaux de la console pour mesurer le nombre quotidien de tokens, le rapport entre pics et creux, ainsi que le taux de succès du cache. Ces données constituent la base la plus fiable pour déterminer si un déploiement en interne serait rentable.
Questions fréquentes (FAQ)
Q1 : Peut-on héberger Kimi K3.1 Pro sur un seul serveur ?
En MXFP4, les poids sont estimés à environ 1,4 To. Ils ne tiennent pas sur un serveur classique à 8 GPU, et même les machines dotées de GPU avec plus de mémoire vidéo auront du mal à garder assez de place pour le cache KV d’un contexte de 1M de tokens. En pratique, il faut prévoir un déploiement sur plusieurs GPU et plusieurs machines. Consultez la documentation officielle pour la configuration exacte.
Q2 : Les 104B de paramètres actifs signifient-ils que les besoins matériels se calculent uniquement sur cette base ?
Non. Les paramètres actifs déterminent la quantité de calcul par token, mais les poids de tous les experts doivent rester en mémoire vidéo. Les besoins en mémoire se calculent donc toujours sur les 2,8T de paramètres au total. C’est la particularité des modèles MoE : ils demandent moins de calcul, mais beaucoup de mémoire.
Q3 : La mise à disposition des poids autorise-t-elle automatiquement une utilisation commerciale ?
Pas nécessairement. Des poids ouverts ne signifient pas une utilisation commerciale sans conditions. Les seuils de revenus, les obligations de notification et les restrictions sur les services hébergés dépendent du texte de la licence officielle. Mieux vaut les faire vérifier par votre service juridique avant d’acheter du matériel.
Q4 : Comment essayer l’API de Kimi K3.1 Pro à moindre coût ?
Vous pouvez vous inscrire sur APIYI, apiyi.com, et utiliser le crédit de test gratuit offert aux nouveaux utilisateurs. L’interface compatible OpenAI permet de l’intégrer à vos projets existants. Une seule clé sur la plateforme permet d’invoquer les modèles de la gamme Kimi ainsi que Claude, GPT, Gemini et d’autres. Consultez la console pour vérifier la disponibilité et le tarif de `kimi-k3.1-pro`.
Q5 : Comment choisir entre la version standard et la version Highspeed ?
À `$4/$20`, Highspeed coûte deux fois plus cher que la version standard, mais elle est environ trois fois plus rapide. Elle convient aux interactions en temps réel avec les utilisateurs et aux agents sensibles au délai avant le premier token. Pour les traitements par lots hors ligne et les tâches en arrière-plan, la version standard avec mise en cache est plus économique.
Conclusion : Kimi K3.1 Pro, liste de vérification pour choisir entre l’autohébergement et l’API
L’ouverture des poids de Kimi K3.1 Pro est une bonne nouvelle : elle offre une option entièrement maîtrisable aux équipes qui en ont les moyens. Mais avec ses 2,8 T de paramètres, le modèle nécessite un cluster. La principale difficulté de l’autohébergement n’est pas de télécharger les poids, mais de faire le bilan du matériel, du taux d’utilisation, de l’exploitation et de la licence. Pour la plupart des équipes, la voie la moins risquée consiste à démarrer avec l’API à $2/$10, puis à évaluer l’autohébergement à partir de données réelles.
Kimi K3.1 Pro : les points clés
- Spécifications : 2,8 T de paramètres au total, 104 B activés, 93 couches MoE, multimodal natif et contexte de 1 M.
- Poids : environ 1,4 To en MXFP4 selon les estimations ; les fichiers officiels font foi. Ils ne tiennent pas sur une seule machine.
- Matériel : déploiement parallèle sur plusieurs GPU et plusieurs machines, avec de la mémoire GPU à réserver pour le cache KV des contextes longs.
- Licence : poids ouverts ne signifie pas libre utilisation commerciale ; les conditions sont celles de la licence officielle.
- Prix : version standard à
$2/$10,$0.20en cas de cache hit, version Highspeed à$4/$20. - Décision : le taux d’utilisation est déterminant. Pour les charges faibles à moyennes ou très variables, privilégiez l’API.
Liste de vérification : autohébergement ou API
| Critère | Signes en faveur de l’API | Signes en faveur de l’autohébergement |
|---|---|---|
| Volume d’appels | Volume mensuel faible ou très variable | Charge élevée en continu, 7 j/7 et 24 h/24 |
| Conformité des données | Les données peuvent être transmises au fournisseur | Les données doivent rester sur le réseau interne |
| Capacité GPU | Pas de cluster ni d’équipe d’exploitation dédiée | Cluster multiserveur et équipe d’exploitation déjà en place |
| Licence | Pas envie de gérer les clauses de distribution et d’hébergement | Conditions d’utilisation commerciale validées par l’équipe juridique |
| Délai de mise en production | Besoin de lancer rapidement le service pour le valider | Déploiement sur plusieurs semaines ou mois acceptable |
| Données de coûts | Pas encore de statistiques d’utilisation réelles | Seuil de rentabilité déjà calculé à partir de données réelles |
Si la plupart de vos réponses se trouvent dans la colonne de gauche, optez directement pour l’API. Nous recommandons d’utiliser APIYI, sur apiyi.com, pour accéder à la gamme Kimi et aux autres modèles majeurs avec une seule clé. Les journaux d’utilisation de la console vous permettront de recueillir des données réelles. Lorsque votre volume d’appels et vos besoins de conformité le justifieront, vous pourrez vous appuyer sur ces données pour évaluer l’autohébergement.
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour en savoir plus sur l’intégration, consultez le centre de documentation sur docs.apiyi.com.


