
Nota do autor: uma análise dos 2,8T de parâmetros, 104B de parâmetros ativos, quantização MXFP4 e contexto de 1M do Kimi K3.1 Pro. O artigo estima o tamanho dos pesos e os requisitos de hardware, compara os preços da API de $2/$10 e traz uma tabela de decisão e um checklist para escolher entre autohospedagem e API.
Vamos direto à conclusão: o Kimi K3.1 Pro é um modelo MoE com 2,8T de parâmetros totais que não roda em uma única máquina. Com MXFP4, estima-se que só os pesos ocupem terabytes e não caibam em um servidor comum de nó único com 8 GPUs. É necessário distribuir o modelo entre várias GPUs e nós, além de reservar memória de vídeo para o cache KV do contexto de 1M. Os pesos abertos resolvem a questão do acesso ao modelo, mas não reduzem os requisitos para executá-lo bem.
Por isso, para a grande maioria das equipes técnicas, começar pela API ao preço de $2/$10 é mais viável. A autohospedagem só vale uma análise séria quando três condições se cumprem ao mesmo tempo: o volume de chamadas é alto e estável, os dados precisam permanecer no próprio datacenter e a equipe tem experiência em operar clusters de GPU. Neste artigo, em vez de repetir resultados de benchmarks, vamos calcular os custos de pesos e hardware, depois os de utilização e operação e, por fim, fazer recomendações por tipo de equipe. Para quem quer apenas testar o desempenho primeiro, é possível usar uma única chave em uma plataforma agregadora como a APIYI, apiyi.com, e decidir o caminho depois.
Especificações do Kimi K3.1 Pro: o que significam 2,8T de parâmetros e contexto de 1M
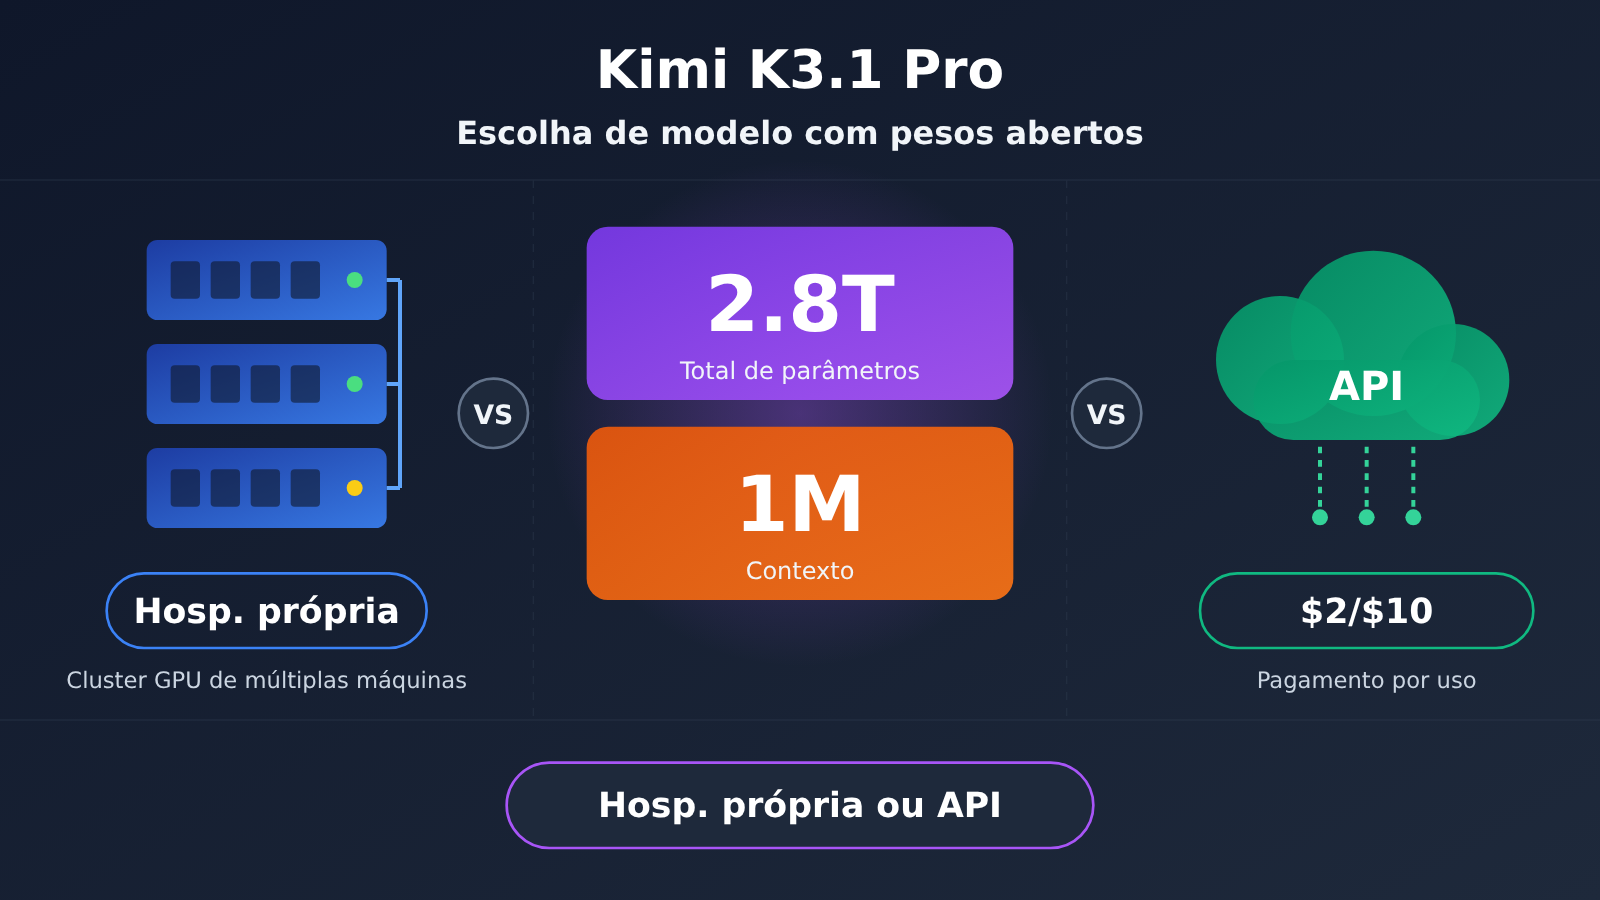
O Kimi K3.1 Pro é o primeiro modelo da série K3.1 e foi lançado com pesos abertos. Ele usa uma arquitetura MoE (mistura de especialistas), com 2,8T de parâmetros no total e cerca de 104B ativados por token. Em outras palavras: o custo de armazenamento corresponde a 2,8T, enquanto o custo computacional fica mais próximo do de um modelo denso de 104B. Esse é um dilema típico de hospedar um modelo MoE por conta própria: a demanda por processamento não é tão extrema, mas é difícil reduzir a necessidade de memória de GPU.
Outro ponto importante é o treinamento com consciência de quantização (QAT). A configuração oficial combina pesos MXFP4 com ativações MXFP8 e já considera a quantização durante o treinamento. Isso significa que a execução em baixa precisão é a “forma nativa” do modelo, e não uma versão comprimida posteriormente. Em teoria, isso torna a perda de precisão mais controlável. Por outro lado, o hardware e o mecanismo de inferência precisam oferecer suporte eficiente aos formatos de microescala da série MX.
| Especificação | Parâmetros do Kimi K3.1 Pro | O que isso significa na escolha |
|---|---|---|
| Arquitetura | MoE, 93 camadas | O armazenamento depende do total de parâmetros; o processamento, dos parâmetros ativados |
| Total de parâmetros | 2,8T | Determina o tamanho dos pesos e o mínimo de memória de GPU necessário |
| Parâmetros ativados | 104B | Determina o processamento por token |
| Codificador visual | MoonViT-V2, 401M de parâmetros | Multimodal nativo, entende imagens sem componentes externos |
| Quantização | Pesos MXFP4 / ativações MXFP8, QAT | Baixa precisão nativa, dependente de suporte do hardware |
| Contexto | 1M tokens | Útil para documentos longos e repositórios grandes, mas exige muito do KV Cache |
| Cenários de uso | Programação, criação 3D, pesquisa financeira, Agent | Foco em tarefas complexas e chamadas com várias etapas |
Contexto de 1M e capacidade multimodal do Kimi K3.1 Pro
Uma janela de contexto de 1M tokens é suficiente para incluir de uma só vez um repositório de código de tamanho médio, um conjunto completo de relatórios financeiros ou pesquisas extensas. É justamente o que cenários de Agent e pesquisa financeira precisam. A capacidade multimodal nativa permite que o modelo leia imagens, capturas de tela e gráficos diretamente, o que também facilita tarefas de criação 3D e programação.
Mas essas duas capacidades têm um custo na hospedagem própria. Um contexto longo faz com que o KV Cache cresça linearmente com o tamanho da sequência, e a memória de GPU ocupada ao usar os 1M completos pode ser considerável. O codificador visual em si não é grande, mas o pré-processamento de entradas multimodais e o agendamento de lotes tornam o serviço de inferência mais complexo. Ao usar uma API, o provedor cuida de tudo isso e você paga apenas pelos tokens.
Tamanho dos pesos e requisitos de hardware do Kimi K3.1 Pro
Estimativa do tamanho dos pesos do Kimi K3.1 Pro
Antes de tudo: os tamanhos abaixo são estimativas baseadas na quantidade de parâmetros; o tamanho real dos arquivos dependerá da versão oficial. No formato MXFP4, cada parâmetro ocupa cerca de 4 bits, ou 0,5 byte. Para 2,8 trilhões de parâmetros, isso dá aproximadamente 1,4 TB. O formato MX também precisa armazenar fatores de escala por bloco. Além disso, componentes como o codificador visual e a camada de embeddings podem manter uma precisão maior, então o arquivo real costuma ser um pouco maior que o valor calculado.
| Precisão considerada | Bytes por parâmetro | Tamanho estimado dos pesos de 2,8 trilhões de parâmetros | Observações |
|---|---|---|---|
| MXFP4 | Cerca de 0,5 byte | Cerca de 1,4 TB | Formato priorizado oficialmente, sem incluir o espaço dos fatores de escala |
| Nível de 8 bits | Cerca de 1 byte | Cerca de 2,8 TB | Apenas para comparação, não é uma recomendação oficial |
| BF16 | 2 bytes | Cerca de 5,6 TB | Apenas para comparação, mostra a importância do QAT |
O ponto é que, mesmo no formato mais econômico, o MXFP4, os pesos já ocupam terabytes. Baixar, verificar e distribuir esses arquivos para várias máquinas já é um projeto de engenharia por si só. Por isso, é preciso planejar com antecedência o armazenamento e a largura de banda da rede interna.
Requisitos de hardware para hospedar o Kimi K3.1 Pro por conta própria
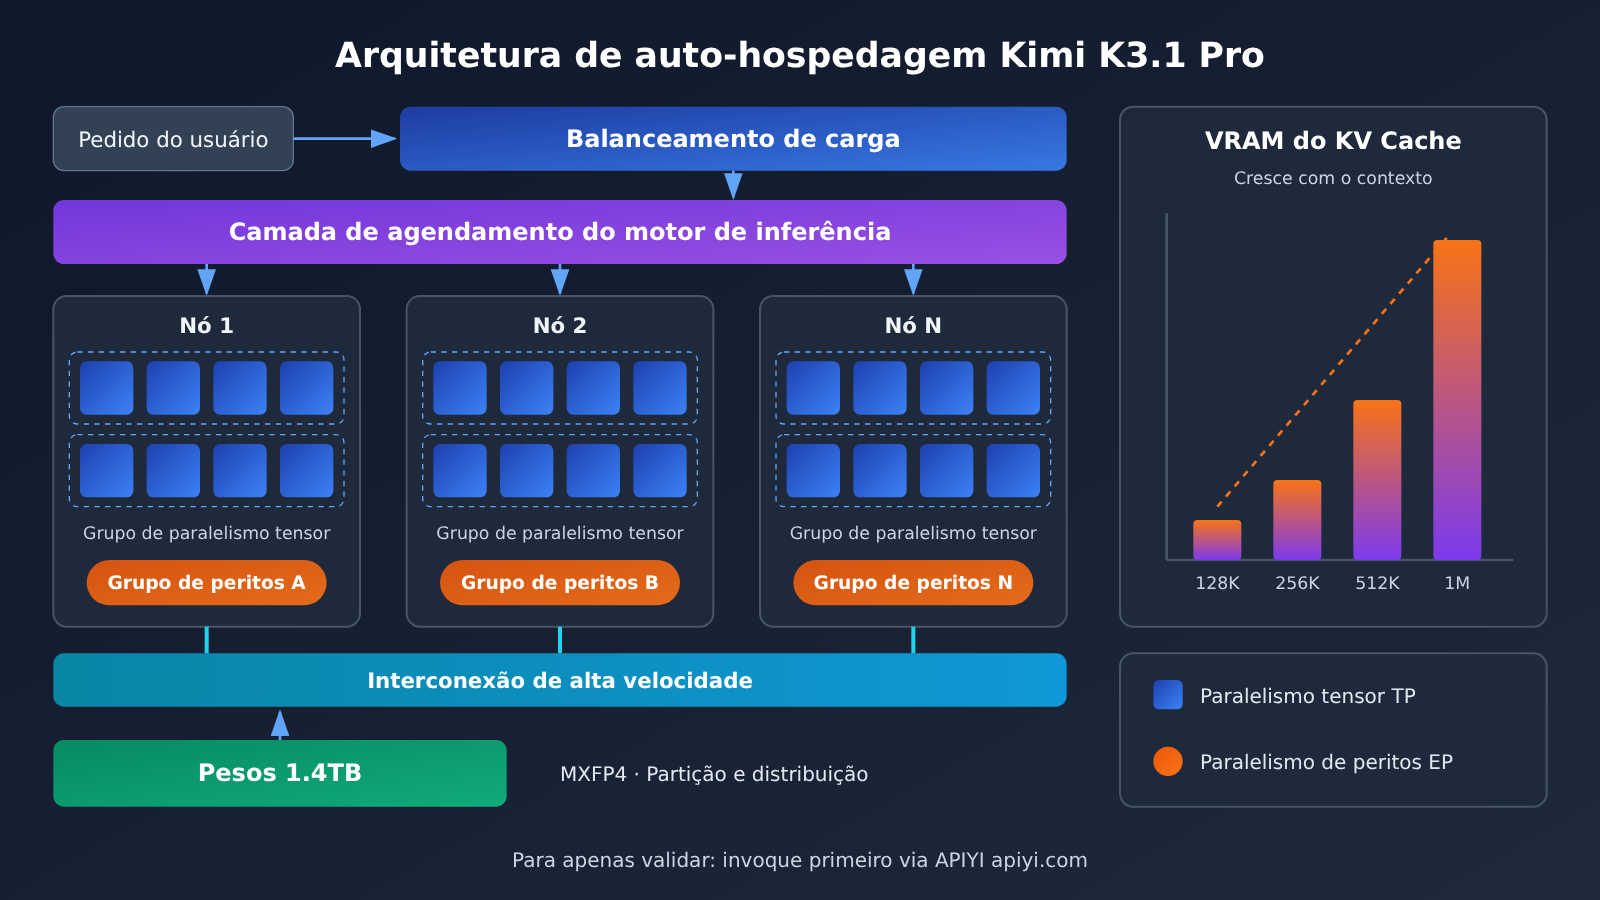
Usando 1,4 TB como estimativa, seriam necessárias quase 18 placas aceleradoras com 80 GB de VRAM cada só para acomodar os pesos. Isso sem contar o KV Cache, as ativações e os recursos usados pelo motor de inferência. Um servidor convencional com 8 placas claramente não basta. Mesmo com placas de nova geração que tenham mais VRAM, um único nó dificilmente teria espaço suficiente para acomodar os pesos e ainda deixar a margem necessária para contextos longos. Na prática, a solução tende a exigir várias placas e várias máquinas, dividindo o modelo com uma combinação de paralelismo de tensores, paralelismo de especialistas e paralelismo de pipeline.
Além do hardware, há outros custos que são fáceis de subestimar:
- Motor de inferência e estratégia de paralelismo: é necessário um framework de inferência compatível com paralelismo de especialistas em MoE e com o formato MX. Consulte a documentação oficial de implantação para saber quais motores e configurações de paralelismo são recomendados.
- Interconexão entre nós: o paralelismo de especialistas gera muita comunicação entre nós, e a largura de banda e a latência da rede afetam diretamente a vazão.
- Data center e energia: a alimentação elétrica, a refrigeração e o espaço em rack de um cluster de GPU com várias máquinas precisam ser planejados com antecedência.
- Capacidade para picos: os horários de maior demanda exigem capacidade adicional, que fica ociosa nos períodos de baixa e representa um custo.
- Equipe de operações: atualizações do modelo, resolução de falhas, monitoramento e alertas exigem o trabalho contínuo de engenheiros com experiência em clusters de GPU.
Vale reforçar que as fontes consultadas não trazem dados oficiais de vazão e custo medidos na prática, e este artigo também não apresenta um orçamento fechado para uma infraestrutura própria. Se você for levar o projeto adiante, use a documentação oficial de implantação e os resultados dos seus próprios testes de carga como referência.
Licença do Kimi K3.1 Pro: pesos abertos não significam uso comercial irrestrito
“Pesos abertos” e “código aberto com uso comercial irrestrito” são coisas diferentes. Vale conferir isso logo na escolha do modelo. As licenças de muitos modelos com pesos abertos impõem condições para uso comercial, como limites de receita ou número de usuários e obrigações de informar a origem do modelo no produto. Para as condições comerciais, os limites de receita e as obrigações de notificação do Kimi K3.1 Pro, consulte sempre o texto original da licença oficial.
Além do uso comercial direto, algumas atividades podem ter exigências adicionais:
- Distribuição: disponibilizar os pesos ou versões derivadas a terceiros.
- Modificação: como a licença se aplica a modelos após ajuste fino, destilação ou mesclagem.
- Serviço hospedado: disponibilizar externamente, via API, um modelo hospedado pela própria empresa costuma ser um cenário sujeito a restrições específicas.
O ideal é que as equipes jurídica e técnica analisem a licença juntas, item por item, e registrem uma conclusão por escrito antes de comprar hardware. Ao usar a API oficial ou uma plataforma de terceiros, o que vale principalmente são os termos de serviço. Em geral, não há distribuição de pesos, mas ainda é preciso verificar se o uso dos dados e a finalidade estão em conformidade com as regras.
Preço da API do Kimi K3.1 Pro: como calcular os $2/$10
O ID do modelo na API oficial é kimi-k3.1-pro. A API oferece interfaces compatíveis com OpenAI e Anthropic, então o custo de adaptação de projetos existentes é baixo. Os preços são cobrados por milhão de tokens:
| Item de cobrança | Versão padrão kimi-k3.1-pro |
Versão Highspeed | Observações |
|---|---|---|---|
| Entrada | $2 |
$4 |
Por milhão de tokens |
| Saída | $10 |
$20 |
Por milhão de tokens |
| Acerto de cache | $0.20 |
Consulte o preço oficial | Prefixos repetidos podem reduzir bastante os custos |
| Gravação em cache | $2 |
Consulte o preço oficial | Mesmo preço da entrada padrão |
| Velocidade | Referência | Cerca de 3 vezes maior | Opção para cenários sensíveis à latência |
Um exemplo de cálculo ajuda a entender os valores (não é um teste real, apenas uma conversão de preços): suponha 100 milhões de tokens de entrada e 20 milhões de tokens de saída por mês. O custo da versão padrão seria de aproximadamente 100 × $2 + 20 × $10 = $400. Se 70% da entrada tiver acerto de cache, o custo de entrada passa a ser 70 × $0.20 + 30 × $2 = $74, e o total cai para cerca de $274. Na versão Highspeed, o mesmo volume, sem considerar o cache, custaria cerca de $800.
Essa escala mostra bem a diferença: mesmo com centenas de milhões de tokens processados por mês, a conta da API fica muito abaixo da soma mensal de depreciação, energia e mão de obra de um cluster de GPUs com várias máquinas. Em cenários com agentes, os comandos de sistema e as definições de ferramentas costumam se repetir bastante. Aproveitar o preço de acerto de cache é a maneira mais direta de reduzir os custos ao usar uma API.
Para integrar, basta que o cliente seja compatível com o protocolo da OpenAI: troque o base_url por https://api.apiyi.com/v1 e informe o ID do modelo disponibilizado pela plataforma. Não é preciso criar uma camada de adaptação adicional.
🚀 Começo rápido: se a equipe quiser comparar o desempenho de Kimi, Claude, GPT e Gemini na mesma tarefa, pode usar a APIYI apiyi.com para acessar todos com uma única chave API e consultar a lista de modelos, o uso e os logs no console. Para saber se
kimi-k3.1-projá está disponível e qual é o preço, consulte as informações atualizadas no console.
Kimi K3.1 Pro: principais diferenças entre implantação própria e API
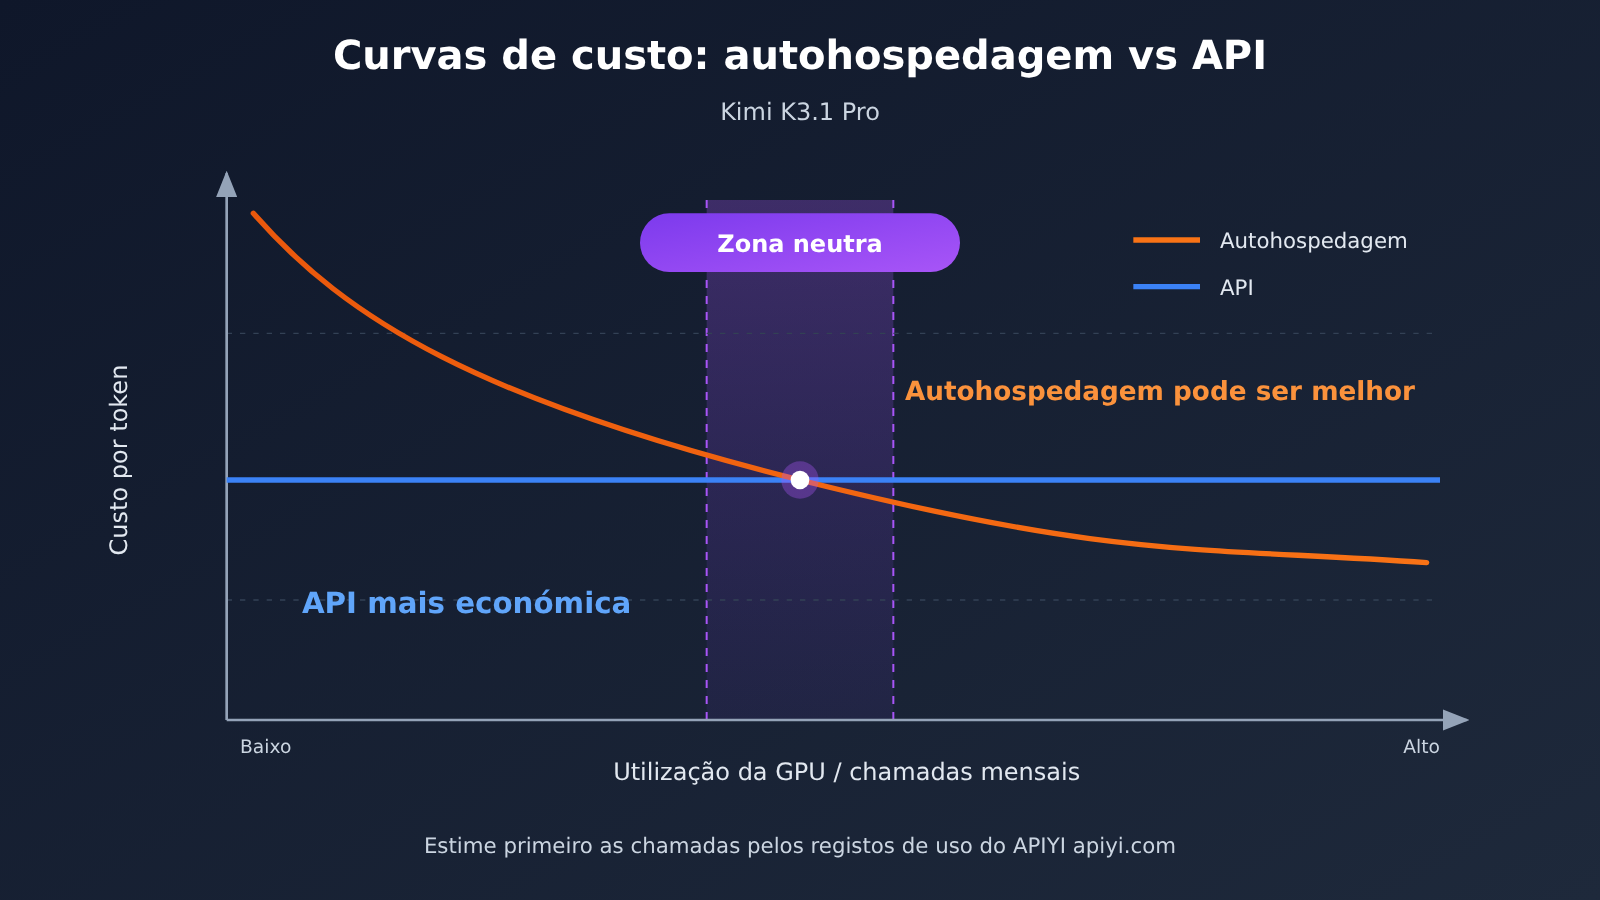
A diferença fundamental entre a implantação própria e a API está na estrutura de custos. A API tem custo totalmente variável: você paga pelo que usa e não gasta nada quando não usa. Já a implantação própria combina custos fixos altos com custos marginais baixos. Depois de investir em hardware, infraestrutura e equipe, você continua pagando mesmo que a capacidade não esteja sendo aproveitada ao máximo. Por isso, a variável decisiva é a utilização: somente com o cluster operando sob carga alta por períodos prolongados o custo por token, diluído, pode ficar abaixo do preço da API.
| Critério de decisão | Implantação própria do Kimi K3.1 Pro | Uso da API | Tendência |
|---|---|---|---|
| Utilização | Exige carga alta e contínua para diluir os custos | Pagamento por uso, sem desperdício por ociosidade | API para uso de baixa ou média frequência |
| Conformidade de dados | Os dados podem permanecer inteiramente no ambiente da organização | Os dados precisam ser enviados ao provedor | Implantação própria para setores com regulamentação rigorosa |
| Investimento inicial | Alto: vários servidores com GPU, infraestrutura e rede | Praticamente zero | API |
| Custo operacional | Exige equipe dedicada à operação do cluster de GPUs | Fica a cargo do provedor | API |
| Elasticidade em picos | Exige capacidade excedente e a expansão é lenta | Boa elasticidade, sujeita a limites de requisições | API |
| Personalização | Permite ajuste fino e alterações na configuração de inferência | Limitada aos parâmetros da interface | Implantação própria para personalização avançada |
| Tempo de entrada em produção | De semanas a meses | Horas | API |
| Canais de acesso | Serviço de inferência próprio | API oficial, plataformas como APIYI apiyi.com e outras | Depende da necessidade |
Análise comparativa da API: a API leva vantagem em tempo de entrada em produção, elasticidade e custo total de propriedade, mas exige o envio de dados para fora do ambiente da organização e oferece poucos parâmetros ajustáveis. Em comparação, a implantação própria oferece mais controle sobre os dados e maior capacidade de personalização, sendo mais adequada para equipes sujeitas a regulamentações rigorosas e com volume de chamadas muito alto.
Análise comparativa da implantação própria: a implantação própria tem potencial para oferecer menor custo por unidade e mais controle, mas envolve investimento inicial elevado, necessidade de equipe operacional e risco de ociosidade. Quando o volume de chamadas oscila ou não há uma equipe de GPU disponível, a API continua sendo a escolha mais segura.
Cenários recomendados e critérios de decisão para o Kimi K3.1 Pro
Equipes para as quais a API do Kimi K3.1 Pro é indicada
- Startups e equipes pequenas ou médias: sem cluster de GPUs nem equipe dedicada de operações, a API é a única opção razoável.
- Aplicações com demanda variável: com picos durante o dia, baixa demanda à noite ou aumentos repentinos em períodos de campanha, o pagamento por uso evita capacidade ociosa.
- Projetos que precisam entrar no ar rapidamente: na fase de validação do produto, velocidade é o mais importante, e a integração pode ser concluída em poucas horas.
- Avaliação paralela de vários modelos: quando é preciso comparar modelos na mesma tarefa, uma interface unificada dá muito menos trabalho do que implantar cada um separadamente.
Equipes para as quais a implantação própria do Kimi K3.1 Pro é indicada
- Dados que não podem sair do ambiente interno: em setores como financeiro e saúde, ou em órgãos governamentais e empresas, requisitos de conformidade podem exigir que os dados permaneçam integralmente na rede interna.
- Invocações frequentes e estáveis: carga elevada e contínua, 24 horas por dia, 7 dias por semana, com alto nível de utilização sustentado ao longo do tempo.
- Cluster de GPUs e equipe de operações já existentes: o investimento adicional é controlável, e o modelo pode ser integrado à infraestrutura atual.
- Necessidade de personalização avançada: é preciso fazer ajuste fino com base em pesos abertos ou otimizações específicas de inferência, desde que a licença permita.
Abordagem híbrida
Há outra opção que costuma passar despercebida: usar a API para criar o protótipo e reavaliar a implantação própria antes da produção. Ou o contrário: manter dados críticos e sensíveis na implantação própria e direcionar o tráfego geral para a API. A primeira abordagem substitui estimativas feitas no chute por dados reais de uso; a segunda equilibra conformidade e flexibilidade.
💡 Dica para decidir: antes de investir em hardware, rode o tráfego real da aplicação por um tempo pela APIYI apiyi.com. Use os registros de uso do console para calcular o número diário de tokens, a proporção entre picos e períodos de baixa e a taxa de acertos no cache. Esses dados são a base mais confiável para avaliar se a implantação própria vale a pena.
Perguntas frequentes FAQ
Q1: É possível hospedar o Kimi K3.1 Pro em um único servidor?
Estimados em MXFP4, os pesos ocupam cerca de 1,4 TB e não cabem em um servidor comum com 8 GPUs. Mesmo em um nó com mais memória de vídeo por GPU, seria difícil reservar espaço para o cache KV de um contexto de 1M. Na prática, é necessário distribuir a implantação entre várias GPUs e servidores. Consulte a documentação oficial para conhecer a configuração adequada.
Q2: Os 104B de parâmetros ativados significam que os requisitos de hardware são calculados com base apenas nesse número?
Não. Os parâmetros ativados determinam a quantidade de cálculos por token, mas os pesos de todos os especialistas precisam permanecer na memória de vídeo. Portanto, a necessidade de memória ainda é calculada com base nos 2,8T de parâmetros totais. Essa é justamente a característica dos modelos MoE: exigem menos cálculos, mas precisam armazenar muitos pesos.
Q3: Com os pesos abertos, é possível usar o modelo comercialmente sem restrições?
Não necessariamente. Pesos abertos não significam uso comercial incondicional. Limites de receita, obrigações de notificação e restrições a serviços hospedados devem ser verificados no texto original da licença oficial. É recomendável consultar o departamento jurídico antes de comprar hardware.
Q4: Como testar a API do Kimi K3.1 Pro gastando pouco?
Você pode se cadastrar na APIYI, em apiyi.com, e usar os créditos gratuitos de teste para novos usuários para integrar a API aos seus projetos por meio de uma interface compatível com a OpenAI. Com uma única chave API da plataforma, é possível invocar modelos da família Kimi, além de Claude, GPT, Gemini e outros. Consulte o console para verificar a disponibilidade e o preço de `kimi-k3.1-pro`.
Q5: Como escolher entre a versão padrão e a Highspeed?
A Highspeed custa `$4/$20`, o dobro da versão padrão, e é cerca de três vezes mais rápida. Ela é indicada para interações em tempo real com usuários e agentes sensíveis à latência do primeiro token. Para processamento em lote offline e tarefas em segundo plano, a versão padrão com cache é mais econômica.
Resumo: checklist de implantação própria vs. API do Kimi K3.1 Pro
A disponibilidade dos pesos do Kimi K3.1 Pro é uma boa notícia: ela oferece uma opção totalmente controlável às equipes que têm os recursos necessários. Mas seus 2,8T de parâmetros fazem dele um modelo para clusters. O desafio da implantação própria não é tanto baixar os pesos, mas lidar com quatro fatores: hardware, utilização, operação e licença. Para a maioria das equipes, o caminho de menor risco é começar com a API a $2/$10 e depois avaliar a implantação própria com base em dados reais.
Principais pontos sobre o Kimi K3.1 Pro
- Especificações: 2,8T de parâmetros totais, 104B ativados, 93 camadas MoE, multimodal nativo e janela de contexto de 1M.
- Pesos: estimativa de cerca de 1,4TB em MXFP4; o tamanho real depende dos arquivos oficiais. Não cabem em uma única máquina.
- Hardware: exige implantação paralela em várias GPUs e máquinas, além de memória de GPU reservada para o KV Cache de contextos longos.
- Licença: pesos abertos não significam uso comercial irrestrito; consulte as condições da licença oficial.
- Preços: versão padrão a
$2/$10, acerto de cache a$0.20e Highspeed a$4/$20. - Decisão: a utilização é a variável-chave. Para aplicações de baixa ou média frequência e com demanda instável, priorize a API.
Checklist: implantação própria vs. API
| Item | Sinal para escolher a API | Sinal para escolher a implantação própria |
|---|---|---|
| Volume de chamadas | Volume mensal baixo ou com grandes oscilações | Alta carga contínua, 7×24 |
| Conformidade de dados | Os dados podem ser enviados ao provedor | Os dados precisam permanecer na rede interna |
| Capacidade de GPU | Sem cluster ou equipe dedicada de operações | Já há um cluster com várias máquinas e equipe de operações |
| Licença | Não quer lidar com os termos de distribuição e hospedagem | O jurídico já confirmou as condições de uso comercial |
| Prazo de lançamento | É preciso lançar e validar rapidamente | Um prazo de implantação de semanas a meses é aceitável |
| Dados de custo | Ainda não há estatísticas reais de chamadas | O ponto de equilíbrio já foi calculado com dados reais |
Se a maioria dos itens se encaixa na coluna da esquerda, basta usar a API. Recomendamos acessar a família Kimi e outros modelos populares com uma única chave pela APIYI, em apiyi.com. Use os logs de uso do console para reunir dados reais e, quando o volume de chamadas e as necessidades de conformidade justificarem, avalie a implantação própria com base nesses dados.
Autor: Equipe técnica da APIYI
Contato técnico: entre em contato conosco pela página inicial do site da APIYI. Para mais instruções de integração, acesse a central de documentação em docs.apiyi.com.


