
Anmerkung des Autors: Kimi K3.1 Pro im Hardware- und Kostencheck: 2.8T Parameter, 104B aktiv, MXFP4 und 1M Kontext. Dazu API-Preise von $2/$10, Entscheidungstabelle und Checkliste.
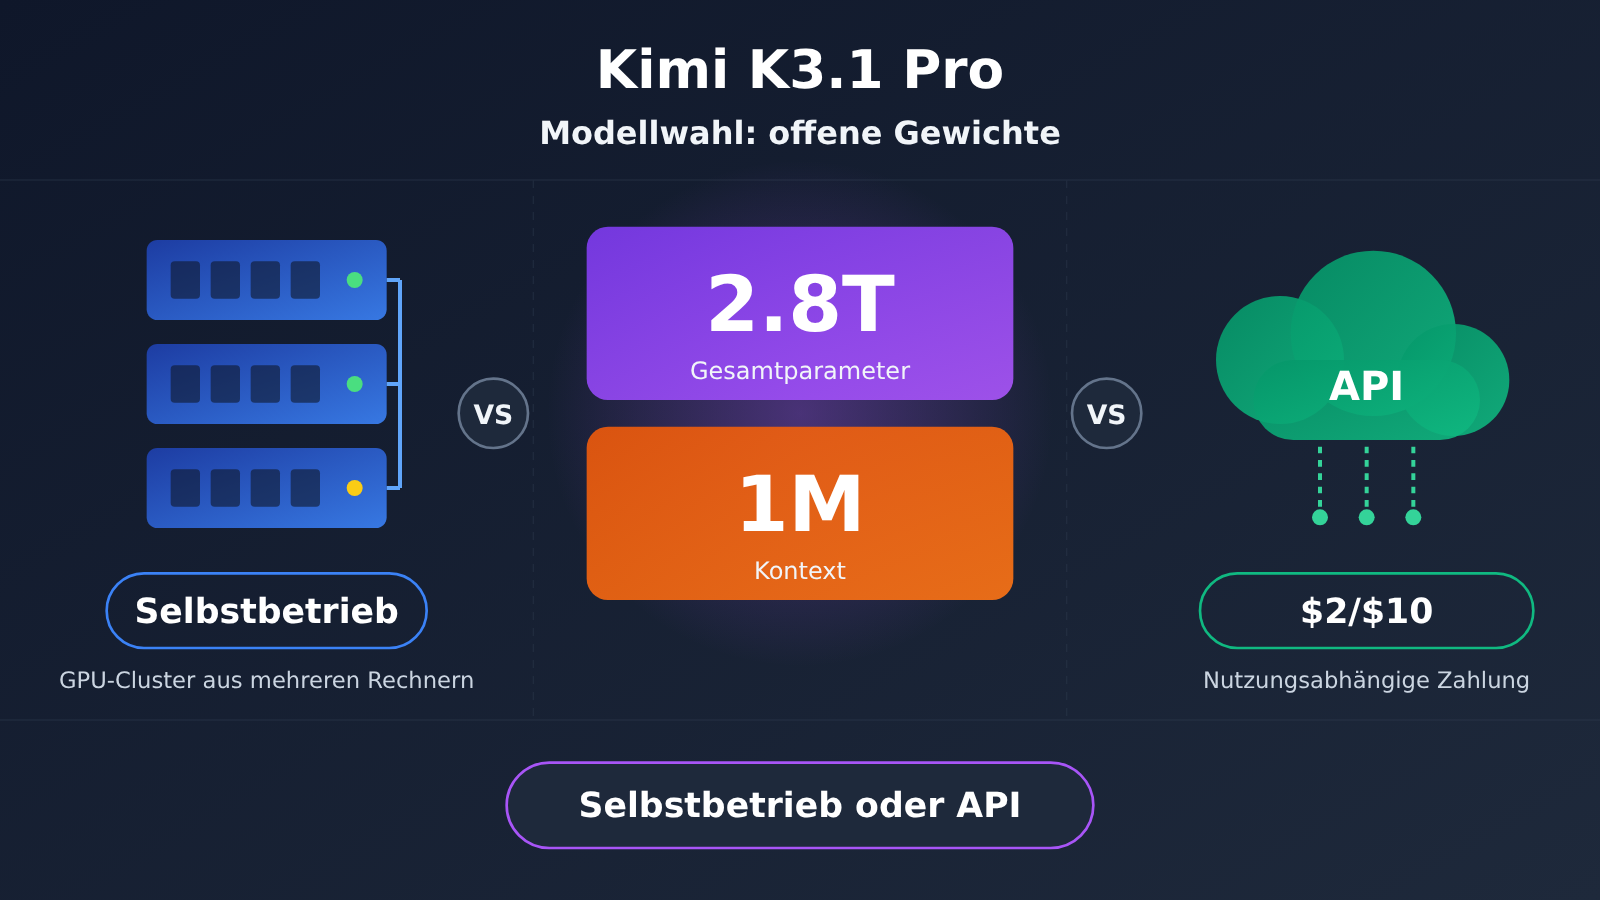
Das Wichtigste vorweg: Kimi K3.1 Pro ist ein MoE-Modell mit insgesamt 2.8T Parametern und lässt sich nicht auf einer einzelnen Maschine betreiben. Bei MXFP4-Quantisierung liegen allein die Modellgewichte schätzungsweise im Terabyte-Bereich. Sie passen nicht auf einen üblichen Einzelserver mit acht GPUs. Nötig ist mindestens eine Bereitstellung über mehrere GPUs und Server hinweg – und zusätzlich GPU-Speicher für den KV-Cache des 1M-Kontexts. Offene Modellgewichte beantworten die Frage, ob man das Modell bekommen kann. Sie senken aber nicht die Hürde, es auch zuverlässig zu betreiben.
Für die meisten Technikteams ist es daher realistischer, zunächst die API zum Preis von $2/$10 zu nutzen. Selbsthosting lohnt eine genauere Kostenrechnung erst, wenn drei Bedingungen gleichzeitig erfüllt sind: Das Aufrufvolumen ist hoch und stabil, die Daten müssen im eigenen Rechenzentrum bleiben und das Team kann einen GPU-Cluster selbst betreiben. Dieser Artikel wiederholt keine Benchmark-Ergebnisse, sondern rechnet zunächst Modellgewichte und Hardware durch, dann Auslastung und Betrieb. Abschließend folgen Empfehlungen für verschiedene Teamtypen. Wer zuerst nur die Leistung prüfen möchte, kann über eine Aggregationsplattform wie APIYI auf apiyi.com mit einem einzigen API-Schlüssel einsteigen und danach über das weitere Vorgehen entscheiden.
Kimi K3.1 Pro im Überblick: Was 2.8T Parameter und 1M Kontext bedeuten
Kimi K3.1 Pro ist das erste Modell der K3.1-Serie und wird mit offenen Modellgewichten veröffentlicht. Es nutzt eine MoE-Architektur (Mixture of Experts) mit insgesamt 2.8T Parametern, von denen pro Token rund 104B aktiviert werden. Vereinfacht gesagt: Der Speicherbedarf richtet sich nach den gesamten 2.8T Parametern, der Rechenaufwand liegt dagegen näher an dem eines dichten Modells mit 104B Parametern. Das ist auch der typische Zielkonflikt bei selbst betriebenen MoE-Modellen: Der Rechenbedarf ist nicht ganz so hoch, der Bedarf an GPU-Speicher lässt sich aber nur schwer senken.
Ein weiterer wichtiger Punkt ist quantisierungsbewusstes Training (QAT). Die Entwickler setzen auf MXFP4-Gewichte und MXFP8-Aktivierungen und berücksichtigen die Quantisierung bereits während des Trainings. Der Betrieb mit niedriger Präzision ist damit die „native Form“ des Modells und keine nachträglich komprimierte Variante. Theoretisch lassen sich Präzisionsverluste dadurch besser kontrollieren. Allerdings stellt das auch Anforderungen an die Inferenzhardware und die Inferenz-Engine: Beide müssen die Mikroskalierungsformate der MX-Serie effizient unterstützen.
| Spezifikation | Kimi K3.1 Pro | Bedeutung für die Auswahl |
|---|---|---|
| Architektur | MoE, 93 Schichten | Der Speicherbedarf richtet sich nach allen Parametern, der Rechenaufwand nach den aktivierten |
| Parameter insgesamt | 2.8T | Bestimmen die Größe der Modellgewichte und den mindestens benötigten GPU-Speicher |
| Aktivierte Parameter | 104B | Bestimmen den Rechenaufwand pro Token |
| Vision-Encoder | MoonViT-V2, 401M Parameter | Nativ multimodal, Bildverständnis ohne zusätzliche Komponenten |
| Quantisierung | MXFP4-Gewichte / MXFP8-Aktivierungen, QAT | Niedrige Präzision als native Form, abhängig von Hardwareunterstützung |
| Kontext | 1M Tokens | Geeignet für lange Dokumente und große Repositories, hoher Bedarf für den KV-Cache |
| Einsatzbereiche | Programmierung, 3D-Erstellung, Finanzrecherche, Agenten | Schwerpunkt auf komplexen Aufgaben und langen Aufrufketten |
Das 1M-Kontextfenster und die multimodalen Fähigkeiten von Kimi K3.1 Pro
Das Kontextfenster von 1M Tokens reicht aus, um ein mittelgroßes Code-Repository, einen vollständigen Satz von Finanzberichten oder umfangreiche Rechercheunterlagen auf einmal zu verarbeiten. Genau das ist für Agenten und die Finanzrecherche hilfreich. Dank nativer multimodaler Fähigkeiten kann das Modell außerdem Bilder, Screenshots und Diagramme direkt lesen – praktisch etwa für 3D-Erstellung und Programmieraufgaben.
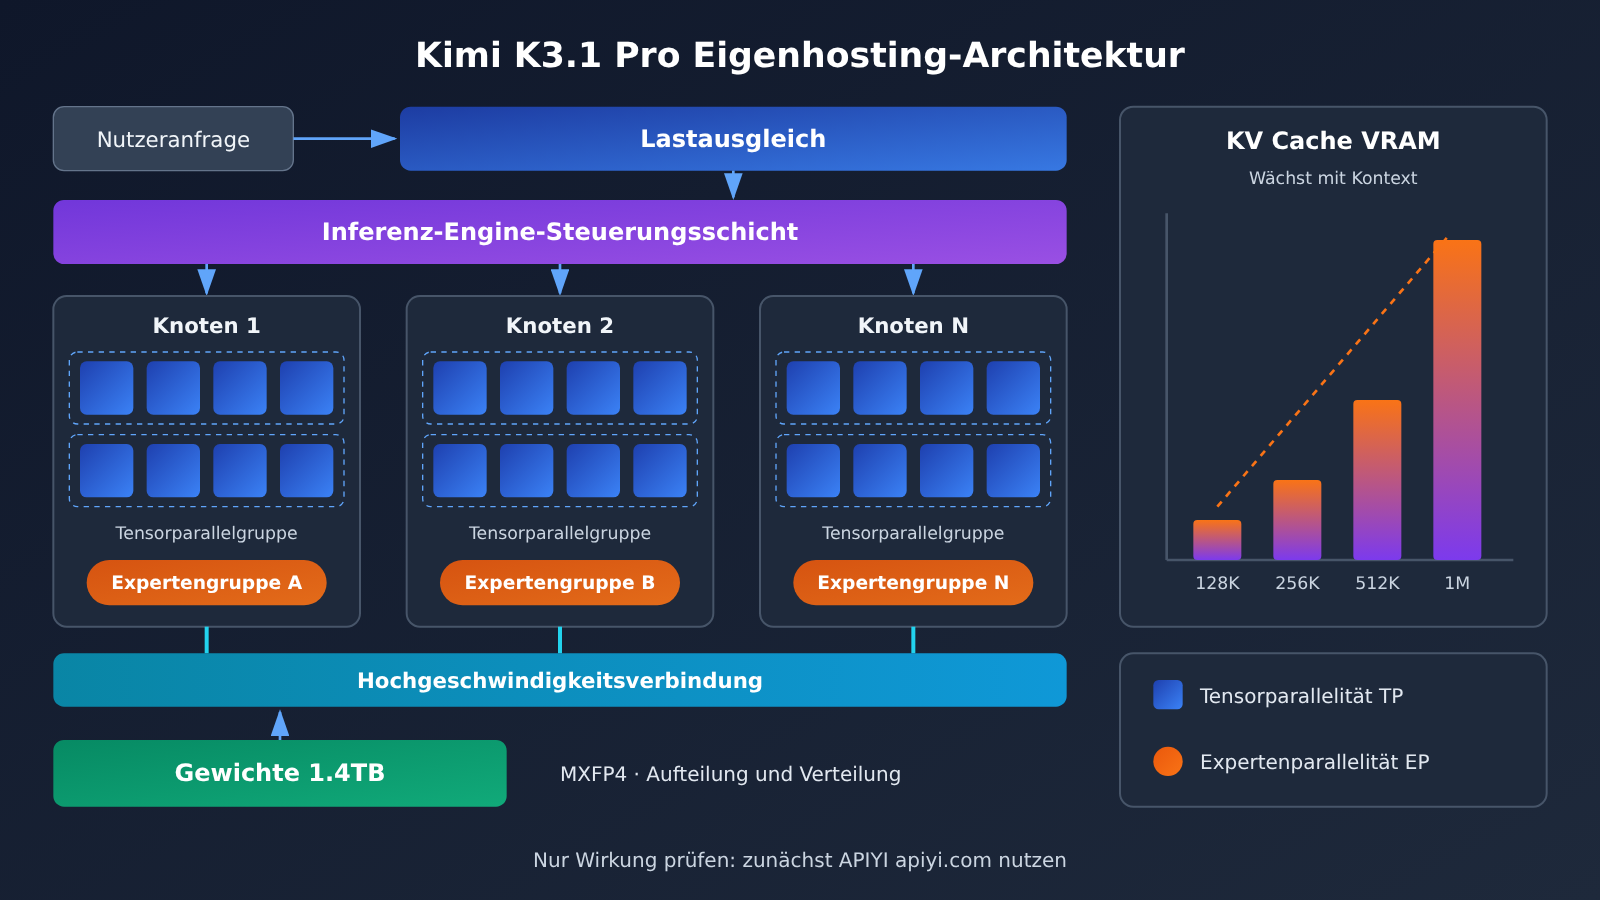
Beim Selbstbetrieb haben beide Fähigkeiten allerdings ihren Preis. Bei langen Kontexten wächst der KV-Cache linear mit der Sequenzlänge. Wird das 1M-Kontextfenster vollständig genutzt, kann der benötigte GPU-Speicher erheblich sein. Der Vision-Encoder selbst ist zwar nicht groß, doch die Vorverarbeitung und Batch-Planung multimodaler Eingaben machen den Inferenzdienst komplexer. Bei der Nutzung über eine API übernimmt der Dienstanbieter diese Aufgaben; Sie zahlen lediglich pro Token.
Größe der Kimi-K3.1-Pro-Gewichte und Hardwareanforderungen
Geschätzte Größe der Kimi-K3.1-Pro-Gewichte
Vorweg: Die folgenden Größen sind anhand der Parameterzahl geschätzt. Maßgeblich ist die tatsächlich veröffentlichte Dateigröße. Bei MXFP4 belegt jeder Parameter etwa 4 Bit, also 0,5 Byte. Für 2,8 Billionen Parameter ergibt das rund 1,4 TB. Das MX-Format muss zusätzlich Skalierungsfaktoren für einzelne Blöcke speichern. Hinzu kommen Komponenten wie der visuelle Encoder und die Einbettungsschicht, die möglicherweise mit höherer Präzision vorliegen. Die tatsächlichen Dateien sind daher normalerweise etwas größer als der rein rechnerische Wert.
| Angenommene Präzision | Byte pro Parameter | Geschätzte Größe der Gewichte bei 2,8 Billionen Parametern | Anmerkung |
|---|---|---|---|
| MXFP4 | ca. 0,5 Byte | ca. 1,4 TB | Offiziell bevorzugtes Format, ohne zusätzlichen Speicherbedarf für Skalierungsfaktoren |
| 8-Bit-Niveau | ca. 1 Byte | ca. 2,8 TB | Nur zum Vergleich, keine offizielle Empfehlung |
| BF16 | 2 Byte | ca. 5,6 TB | Nur zum Vergleich, verdeutlicht den Nutzen von QAT |
Die Tabelle zeigt: Selbst mit dem sparsamsten Format MXFP4 liegen die Gewichte bereits im Terabyte-Bereich. Das Herunterladen, Überprüfen und Verteilen auf mehrere Rechner ist für sich genommen schon eine technische Herausforderung. Speicherplatz und Bandbreite im internen Netzwerk sollten daher frühzeitig eingeplant werden.
Hardwareanforderungen für das Self-Hosting von Kimi K3.1 Pro
Grob gerechnet braucht man bei 1,4 TB und Beschleunigerkarten mit jeweils 80 GB Grafikspeicher allein für die Modellgewichte knapp 18 Karten. KV-Cache, Aktivierungswerte und der Laufzeit-Overhead der Inferenz-Engine sind dabei noch nicht berücksichtigt. Ein herkömmlicher Server mit acht Karten reicht also nicht aus. Selbst mit Karten der neueren Generation und mehr Speicher pro Karte passen die Gewichte nur knapp auf einen einzelnen Knoten – für lange Kontexte bleibt kaum Spielraum. In der Praxis führt daher kaum ein Weg an mehreren Karten und mehreren Servern vorbei. Das Modell wird dabei durch eine Kombination aus Tensor-, Experten- und Pipeline-Parallelisierung aufgeteilt.
Neben der Hardware werden einige weitere Kosten leicht unterschätzt:
- Inferenz-Engine und Parallelisierungsstrategie: Nötig ist ein Inferenz-Framework, das MoE-Expertenparallelisierung und das MX-Format unterstützt. Empfehlungen zur Engine und zur Parallelisierung finden sich in der offiziellen Deployment-Dokumentation.
- Verbindung zwischen den Knoten: Expertenparallelisierung erzeugt viel Datenverkehr zwischen den Knoten. Bandbreite und Latenz des Netzwerks wirken sich direkt auf den Durchsatz aus.
- Rechenzentrum und Stromversorgung: Stromversorgung, Kühlung und Platz im Rack für einen GPU-Cluster aus mehreren Servern müssen frühzeitig geplant werden.
- Kapazität für Lastspitzen: Zu Spitzenzeiten sind zusätzliche Reserven nötig. In Zeiten geringer Auslastung verursacht diese ungenutzte Rechenleistung Kosten.
- Betriebspersonal: Modell-Upgrades, Fehleranalyse sowie Monitoring und Alarmierung erfordern dauerhaft den Einsatz von Fachleuten für GPU-Cluster.
Wichtig: In den herangezogenen Quellen finden sich keine offiziellen Messwerte zu Durchsatz und Kosten. Deshalb nennt dieser Artikel auch keinen verbindlichen Preis für den Eigenbetrieb. Wenn Sie ein solches Projekt planen, orientieren Sie sich an der offiziellen Deployment-Dokumentation und an Ihren eigenen Lasttests.
Kimi K3.1 Pro und die Lizenz: Offene Gewichte bedeuten nicht freie kommerzielle Nutzung
„Offene Gewichte“ und „Open Source zur uneingeschränkten kommerziellen Nutzung“ sind zwei verschiedene Dinge. Das sollten Sie schon bei der Modellauswahl prüfen. Viele Lizenzen für Modelle mit offenen Gewichten knüpfen die kommerzielle Nutzung an Bedingungen, etwa Umsatz- oder Nutzerzahlgrenzen oder die Pflicht, im Produkt auf die Herkunft hinzuweisen. Für die konkreten Bedingungen zur kommerziellen Nutzung, Umsatzgrenzen und Hinweispflichten von Kimi K3.1 Pro ist ausschließlich der Wortlaut der offiziellen Lizenz maßgeblich.
Neben der direkten kommerziellen Nutzung können auch für andere Aktivitäten zusätzliche Anforderungen gelten:
- Weitergabe: Bereitstellung der Gewichte oder abgeleiteter Versionen für Dritte.
- Änderungen: Anwendung der Lizenz auf Modelle, die durch Fine-Tuning, Destillation oder Zusammenführen entstanden sind.
- Gehostete Dienste: Bereitstellung eines selbst gehosteten Modells als öffentliche API – ein Szenario, das Lizenzen häufig besonders regeln.
Am besten gehen Rechtsabteilung und technische Verantwortliche die Lizenz gemeinsam Punkt für Punkt durch und halten ihre Schlussfolgerungen schriftlich fest, bevor Hardware beschafft wird. Bei Aufrufen über die offizielle API oder Plattformen von Drittanbietern gelten in erster Linie deren Nutzungsbedingungen. Die Weitergabe von Gewichten ist dabei normalerweise kein Thema. Trotzdem sollten Sie prüfen, ob die Datenverarbeitung und der geplante Nutzungsumfang den Vorgaben entsprechen.
Kimi K3.1 Pro API-Preise: So berechnen sich $2/$10
Die Modell-ID der offiziellen API lautet kimi-k3.1-pro. Sie bietet Schnittstellen, die mit OpenAI und Anthropic kompatibel sind. Bestehende Projekte lassen sich daher mit wenig Aufwand anpassen. Die Preise gelten jeweils pro Million Tokens:
| Abrechnungsposten | Standardversion kimi-k3.1-pro |
Highspeed-Version | Erläuterung |
|---|---|---|---|
| Eingabe | $2 |
$4 |
Pro Million Tokens |
| Ausgabe | $10 |
$20 |
Pro Million Tokens |
| Cache-Treffer | $0.20 |
Siehe offizielle Angaben | Wiederholte Präfixe können Kosten deutlich senken |
| Cache-Schreibvorgang | $2 |
Siehe offizielle Angaben | Gleicher Preis wie für die Standardeingabe |
| Geschwindigkeit | Basiswert | Etwa 3-mal so schnell | Option für latenzkritische Anwendungen |
Ein Rechenbeispiel zur Veranschaulichung – keine Messung: Bei 100 Millionen Eingabe- und 20 Millionen Ausgabe-Tokens pro Monat kostet die Standardversion ungefähr 100 × $2 + 20 × $10 = $400. Wenn 70 % der Eingabe-Tokens Cache-Treffer sind, kosten die Eingaben 70 × $0.20 + 30 × $2 = $74. Die Gesamtkosten sinken damit auf etwa $274. Bei gleichem Verbrauch kostet die Highspeed-Version ohne Berücksichtigung des Caches ungefähr $800.
Diese Größenordnung zeigt: Selbst bei Hunderten Millionen Tokens pro Monat liegt die API-Rechnung weit unter den monatlichen Abschreibungen, Strom- und Personalkosten eines GPU-Clusters mit mehreren Rechnern. In Agent-Anwendungen wiederholen sich System-Eingabeaufforderungen und Tool-Definitionen häufig. Cache-Treffer gezielt zu nutzen, ist daher eine der einfachsten Möglichkeiten, API-Kosten zu senken.
Für die Anbindung reicht ein Client, der das OpenAI-kompatible Protokoll unterstützt: Setzen Sie base_url auf https://api.apiyi.com/v1 und tragen Sie als Modellnamen die von der Plattform bereitgestellte Modell-ID ein. Eine zusätzliche Anpassungsschicht ist nicht nötig.
🚀 Schnellstart: Wenn Ihr Team Kimi, Claude, GPT und Gemini bei derselben Aufgabe vergleichen möchte, können Sie die Modelle über APIYI apiyi.com mit einem einzigen API-Schlüssel aufrufen. In der Konsole sehen Sie die Modellliste, den Verbrauch und die Logs. Ob
kimi-k3.1-probereits verfügbar ist und wie viel es kostet, erfahren Sie über die aktuellen Angaben in der Konsole.
Kimi K3.1 Pro: Die wichtigsten Unterschiede zwischen Self-Hosting und API
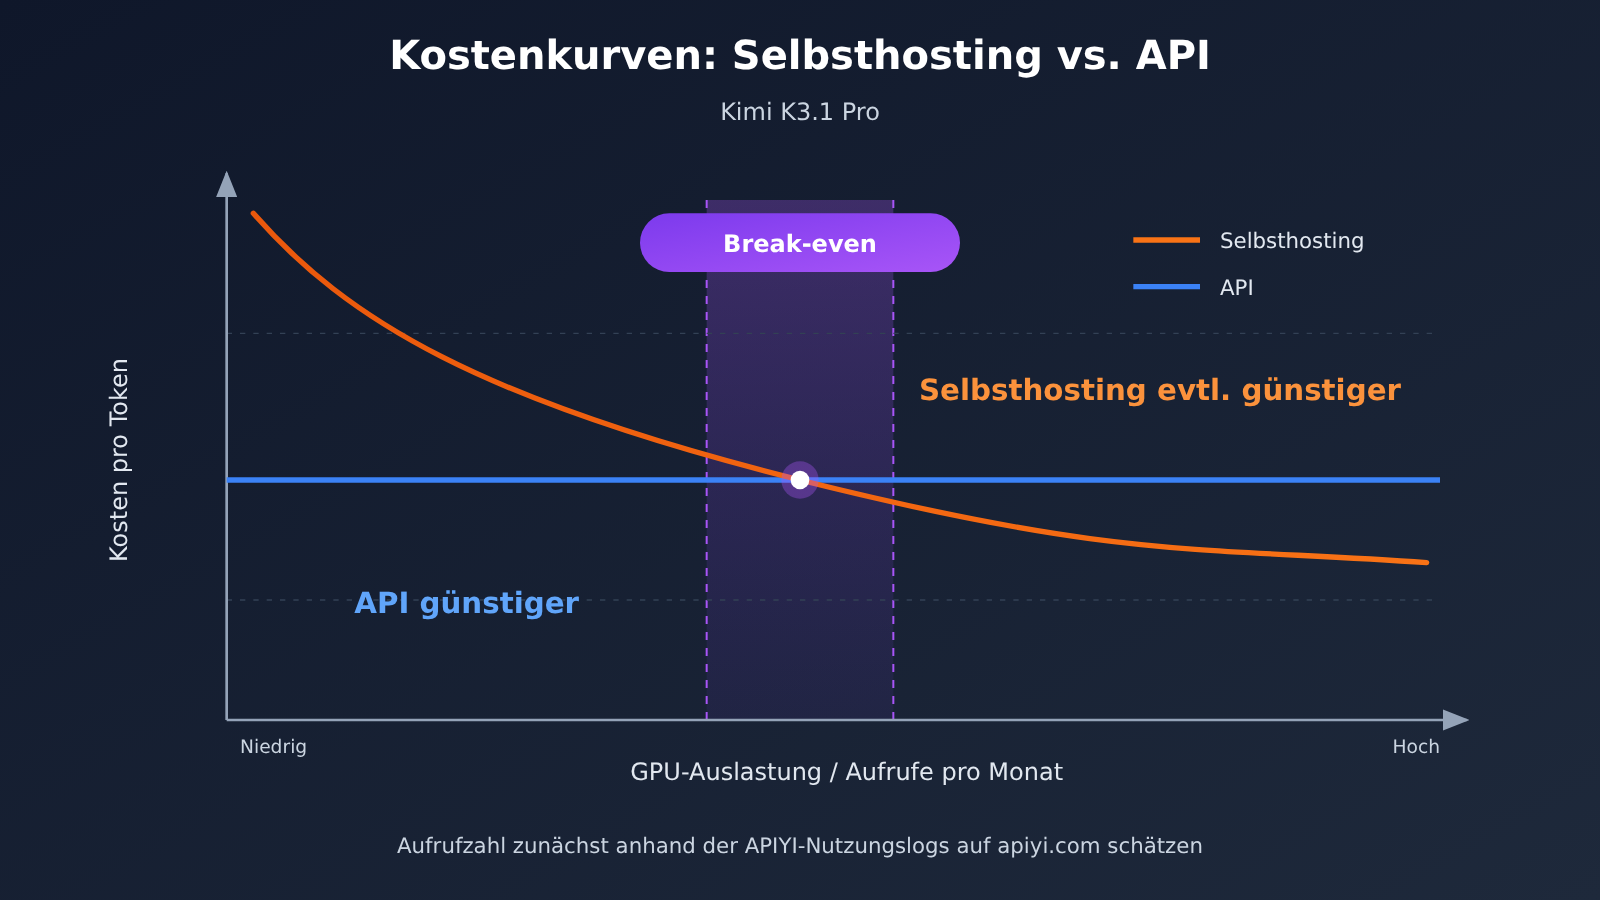
Der grundlegende Unterschied zwischen Self-Hosting und API liegt in der Kostenstruktur. Bei der API fallen ausschließlich variable Kosten an: Sie zahlen nur für die tatsächliche Nutzung. Self-Hosting bedeutet hohe Fixkosten bei niedrigen Grenzkosten. Sobald Hardware, Rechenzentrum und Personal bereitstehen, entstehen Kosten – unabhängig davon, ob die Kapazität voll genutzt wird. Die entscheidende Variable ist daher die Auslastung: Nur wenn der Cluster dauerhaft stark ausgelastet ist, können die umgelegten Kosten pro Token unter dem API-Preis liegen.
| Entscheidungskriterium | Self-Hosting von Kimi K3.1 Pro | API-Nutzung | Tendenz |
|---|---|---|---|
| Auslastung | Dauerhaft hohe Auslastung nötig, um Kosten zu verteilen | Nutzungsbasierte Abrechnung, keine Kosten durch Leerlauf | Bei geringer bis mittlerer Nutzung: API |
| Daten-Compliance | Daten können vollständig innerhalb der eigenen Umgebung bleiben | Daten müssen an den Dienstanbieter übermittelt werden | Bei strenger Regulierung: Self-Hosting |
| Anfangsinvestition | Hohe Investitionen in mehrere GPU-Server, Rechenzentrum und Netzwerk | Nahezu null | API |
| Betriebskosten | Dediziertes Personal für den Betrieb des GPU-Clusters erforderlich | Trägt der Dienstanbieter | API |
| Elastizität bei Lastspitzen | Reservekapazitäten nötig, langsame Skalierung | Gute Skalierbarkeit, begrenzt durch Rate Limits | API |
| Anpassbarkeit | Fine-Tuning und Änderungen an der Inferenzkonfiguration möglich | Durch Schnittstellenparameter begrenzt | Bei umfassenden Anpassungen: Self-Hosting |
| Zeit bis zur Inbetriebnahme | Wochen bis Monate | Stunden | API |
| Zugangsweg | Eigener Inferenzdienst | Offizielle API, Plattformen wie APIYI apiyi.com | Je nach Bedarf |
API im Vergleich: Die API liegt bei Inbetriebnahmegeschwindigkeit, Elastizität und Gesamtbetriebskosten vorn. Allerdings müssen Daten die eigene Umgebung verlassen, und die Anpassungsmöglichkeiten über die Schnittstelle sind begrenzt. Self-Hosting bietet dagegen Vorteile bei der Datenkontrolle und umfassenden Anpassungen. Es eignet sich eher für stark regulierte Teams mit sehr hohem Aufrufvolumen.
Self-Hosting im Vergleich: Self-Hosting bietet Potenzial für besser kontrollierbare Kosten pro Einheit und mehr Kontrolle. Allerdings sind die Anfangsinvestitionen, der Personalbedarf für den Betrieb und das Risiko ungenutzter Kapazitäten hoch. Bei schwankendem Aufrufvolumen oder fehlendem GPU-Team bleibt die API die sicherere Wahl.
Kimi K3.1 Pro: Einsatzszenarien und Entscheidungshilfe
Für welche Teams eignet sich die Kimi K3.1 Pro API?
- Start-ups und kleine bis mittlere Teams: Ohne GPU-Cluster und eigenes Betriebsteam ist die API die einzig sinnvolle Option.
- Geschäftsanwendungen mit schwankendem Aufkommen: Bei Spitzen am Tag, geringer Auslastung in der Nacht oder starken Anstiegen während Aktionen vermeidet nutzungsbasierte Abrechnung ungenutzte Kapazitäten.
- Projekte, die schnell live gehen müssen: In der Validierungsphase zählt vor allem Geschwindigkeit. Die Anbindung lässt sich innerhalb weniger Stunden umsetzen.
- Parallele Evaluierung mehrerer Modelle: Soll dieselbe Aufgabe mit verschiedenen Modellen verglichen werden, ist eine einheitliche Schnittstelle deutlich einfacher als separate Deployments.
Für welche Teams eignet sich ein eigenes Deployment von Kimi K3.1 Pro?
- Daten dürfen die eigene Umgebung nicht verlassen: Im Finanz- und Gesundheitswesen oder bei Behörden und staatlichen Unternehmen müssen Daten aus Compliance-Gründen vollständig im internen Netzwerk bleiben.
- Häufige, gleichmässige Aufrufe: Die Last ist rund um die Uhr hoch und die Auslastung lässt sich dauerhaft auf hohem Niveau halten.
- GPU-Cluster und Betriebsteam sind bereits vorhanden: Die zusätzlichen Investitionen bleiben überschaubar und das Modell lässt sich in die bestehende Infrastruktur integrieren.
- Umfangreiche Anpassungen sind nötig: Für Fine-Tuning auf Basis offener Modellgewichte oder spezielle Optimierungen der Inferenz – vorausgesetzt, die Lizenz erlaubt dies.
Hybrider Ansatz
Eine häufig übersehene Möglichkeit: Prototypen mit der API entwickeln und für den Produktionsbetrieb ein eigenes Deployment prüfen. Oder umgekehrt: Sensible Kerndaten werden lokal verarbeitet, allgemeine Anfragen laufen über die API. Der erste Ansatz ersetzt Schätzungen durch echte Nutzungsdaten, der zweite verbindet Compliance mit Flexibilität.
💡 Entscheidungshilfe: Bevor Sie in Hardware investieren, empfiehlt es sich, eine Zeit lang echten produktiven Datenverkehr über APIYI auf apiyi.com abzuwickeln. Ermitteln Sie anhand der Nutzungsprotokolle in der Konsole die tägliche Token-Anzahl, das Verhältnis zwischen Spitzen- und Grundlast sowie die Cache-Trefferquote. Diese Daten sind die zuverlässigste Grundlage, um die Wirtschaftlichkeit eines eigenen Deployments zu beurteilen.
Häufige Fragen (FAQ)
Q1: Lässt sich Kimi K3.1 Pro auf einem einzelnen Server selbst betreiben?
Bei MXFP4 benötigen die Gewichte schätzungsweise 1.4TB. Auf einen herkömmlichen Server mit 8 GPUs passt das Modell nicht. Selbst auf Systemen mit mehr Speicher pro GPU dürfte kaum genug Platz für den KV-Cache eines Kontextfensters von 1M bleiben. Praktikabel ist eine Bereitstellung über mehrere GPUs und Server. Die genaue Konfiguration steht in der offiziellen Bereitstellungsdokumentation.
Q2: Bedeutet 104B aktivierte Parameter, dass sich die Hardwareanforderungen nur nach 104B richten?
Nein. Die aktivierten Parameter bestimmen den Rechenaufwand pro Token. Die Gewichte aller Experten müssen aber dauerhaft im GPU-Speicher liegen, sodass sich der Speicherbedarf weiterhin nach den 2.8T Gesamtparametern richtet. Das ist typisch für MoE-Modelle: Sie rechnen schnell, müssen aber viele Gewichte vorhalten.
Q3: Darf man das Modell nach der Veröffentlichung der Gewichte direkt kommerziell nutzen?
Nicht unbedingt. Offene Gewichte bedeuten keine uneingeschränkte kommerzielle Nutzung. Für Umsatzschwellen, Meldepflichten und Einschränkungen bei Hosting-Diensten ist der Wortlaut der offiziellen Lizenz maßgeblich. Lassen Sie die Bedingungen am besten vor dem Hardwarekauf rechtlich prüfen.
Q4: Wie lässt sich die API von Kimi K3.1 Pro günstig ausprobieren?
Sie können sich bei APIYI auf apiyi.com registrieren und das kostenlose Testguthaben für neue Nutzer verwenden. Über eine OpenAI-kompatible Schnittstelle lässt sich die API in bestehende Projekte einbinden. Mit einem API-Schlüssel der Plattform können Sie Modelle der Kimi-Reihe sowie Claude, GPT, Gemini und weitere Modelle aufrufen. Ob `kimi-k3.1-pro` verfügbar ist und was es kostet, sehen Sie in der Konsole.
Q5: Wie wählt man zwischen der Standard- und der Highspeed-Version?
Highspeed kostet `$4/$20`, also doppelt so viel wie die Standardversion, und ist etwa dreimal so schnell. Für Echtzeitinteraktionen mit Nutzern und Agenten, bei denen eine geringe Verzögerung bis zum ersten Zeichen wichtig ist, eignet sich Highspeed. Bei Offline-Stapelverarbeitung und Hintergrundaufgaben ist die Standardversion mit Caching günstiger.
Fazit: Kimi K3.1 Pro selbst betreiben oder per API nutzen?
Die offenen Gewichte von Kimi K3.1 Pro sind eine gute Nachricht: Teams mit den nötigen Ressourcen erhalten damit eine vollständig kontrollierbare Option. Mit 2,8 Billionen Parametern ist es allerdings ein Modell für den Clusterbetrieb. Die eigentlichen Hürden beim Selbstbetrieb sind nicht der Download der Gewichte, sondern Hardware, Auslastung, Betrieb und Lizenzbedingungen. Für die meisten Teams ist es am risikoärmsten, zunächst mit der API für $2/$10 zu starten und anhand tatsächlicher Nutzungsdaten zu prüfen, ob sich ein eigener Betrieb lohnt.
Kimi K3.1 Pro: Die wichtigsten Punkte
- Spezifikationen: 2,8 Billionen Parameter insgesamt, 104 Milliarden aktiviert, 93 MoE-Schichten, nativ multimodal, 1 Million Kontextlänge.
- Gewichte: Unter MXFP4 geschätzt rund 1,4 TB; massgeblich sind die offiziellen Dateien. Auf einen einzelnen Rechner passen sie nicht.
- Hardware: Erforderlich ist eine parallele Bereitstellung über mehrere GPUs und Rechner. Für den KV-Cache bei langen Kontexten muss zusätzlicher GPU-Speicher eingeplant werden.
- Lizenz: Offene Gewichte bedeuten nicht, dass die kommerzielle Nutzung uneingeschränkt erlaubt ist. Entscheidend ist die offizielle Lizenz.
- Preise: Standardversion
$2/$10, bei Cache-Treffer$0.20, Highspeed$4/$20. - Entscheidung: Die Auslastung ist der entscheidende Faktor. Bei niedriger bis mittlerer oder stark schwankender Nutzung ist die API meist die bessere Wahl.
Checkliste: Selbstbetrieb vs. API
| Prüfkriterium | Spricht für die API | Spricht für Selbstbetrieb |
|---|---|---|
| Aufrufvolumen | Geringes oder stark schwankendes monatliches Volumen | Dauerhaft hohe Auslastung rund um die Uhr |
| Daten-Compliance | Daten dürfen an den Dienstanbieter gesendet werden | Daten müssen im internen Netzwerk bleiben |
| GPU-Kapazität | Kein Cluster und kein dediziertes Betriebsteam | Cluster mit mehreren Rechnern und Betriebsteam vorhanden |
| Lizenz | Keine Auseinandersetzung mit Bedingungen für Weitergabe und Hosting gewünscht | Rechtsabteilung hat die Bedingungen für die kommerzielle Nutzung geprüft |
| Zeit bis zur Inbetriebnahme | Schneller Start und schnelle Validierung erforderlich | Bereitstellungszeit von Wochen bis Monaten ist akzeptabel |
| Kostendaten | Noch keine tatsächlichen Nutzungsstatistiken vorhanden | Break-even bereits anhand realer Daten berechnet |
Treffen die meisten Punkte in der linken Spalte zu, ist die API der direkte Weg. Über APIYI auf apiyi.com lassen sich die Kimi-Serie und andere gängige Modelle mit einem einzigen API-Schlüssel nutzen. Anhand der Nutzungsprotokolle in der Konsole können Sie reale Daten sammeln und den Selbstbetrieb prüfen, sobald Aufrufvolumen und Compliance-Anforderungen ihn tatsächlich nahelegen.
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI. Weitere Hinweise zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.


