
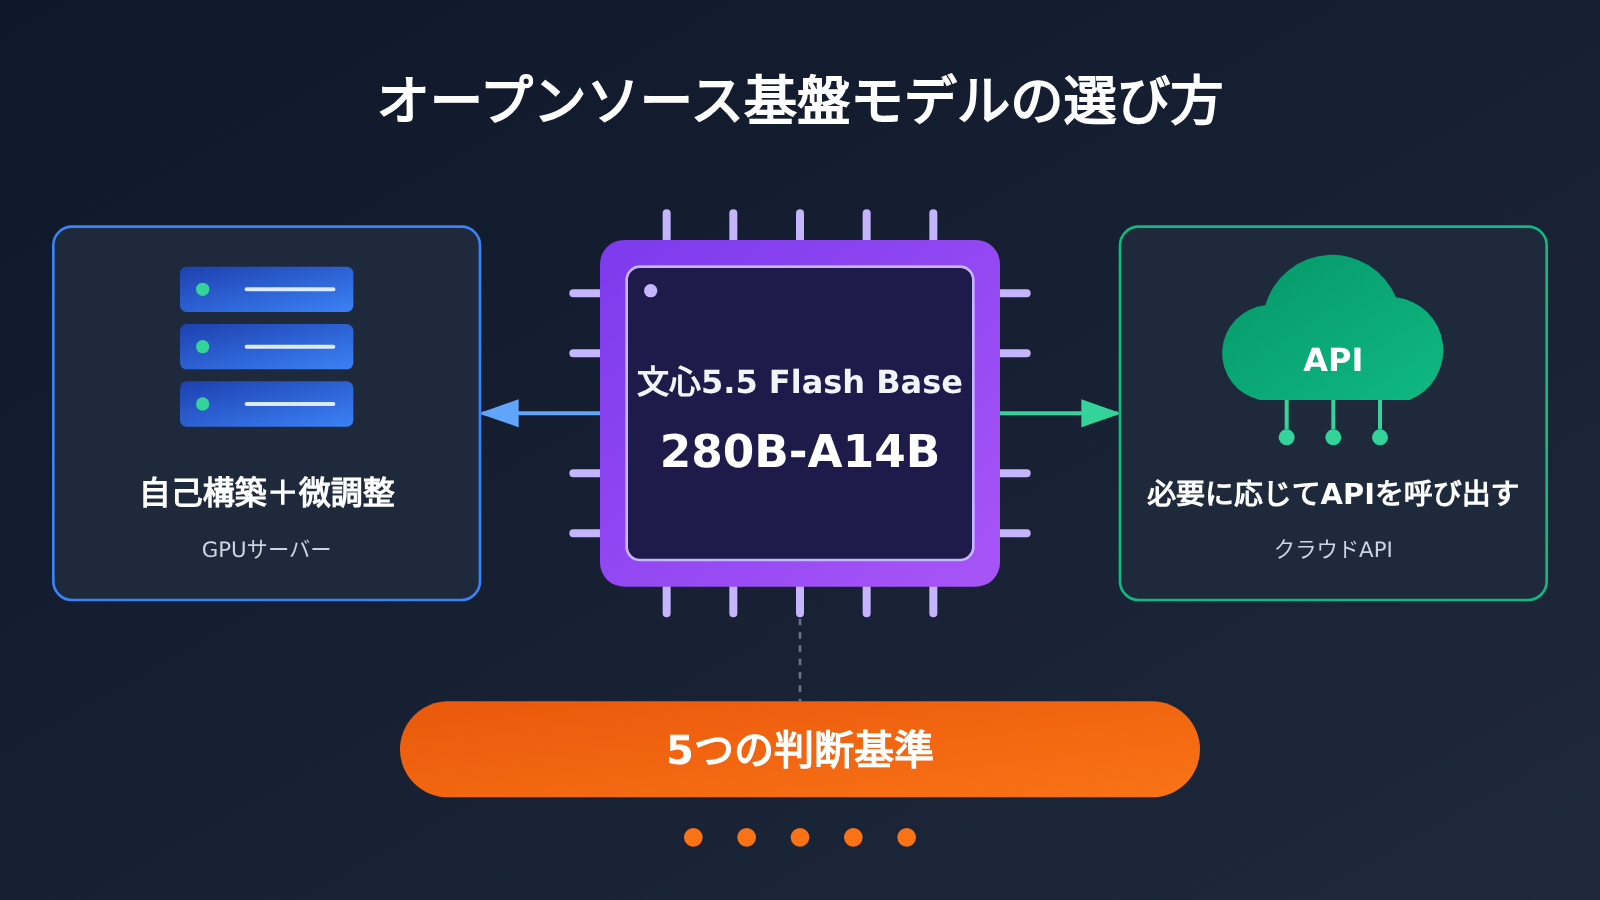
著者注:文心5.5 Flash Baseのオープンウェイトがダウンロードできるようになりました。この記事では、アーキテクチャとパラメータ、ハードウェア要件、利用目的、コストの4つの観点から、ベースモデルを自社でデプロイするか、必要に応じてAPIを呼び出すかを判断します。
2026年11月5日、百度は文心5.5 Flash Base(ERNIE-5.5-Flash-Base)を正式にリリースし、オープンソースとして公開しました。総パラメータ数280B、トークンごとの活性化パラメータ数14BのスパースMoEベースモデルで、複数のベンチマークで同規模モデルのSOTAを達成しています。ウェイトはHugging FaceでFP8版とBF16版が公開され、vLLMプラグインとSGLang Cookbookも同時にリリースされました。今回は「論文だけ公開してウェイトは非公開」というわけではありません。
この記事は単なるベンチマーク結果の紹介ではありません。「オープンソース+SOTA」を見てウェイトをダウンロードし、すぐに運用を始めようとするチームも少なくありません。しかし、見落としてはならないのは、これが中間学習も事後学習も行っていないBaseモデルだという点です。学習の出発点としては優れていますが、そのままチャットボットには使えません。
この記事でわかること:文心5.5 Flash Baseに適した用途、自社デプロイに必要なおおよそのVRAM容量、そして必要に応じてAPIを呼び出すほうが割安になる条件を解説します。
文心5.5 Flash Base の主なポイント
まずは、このモデルの重要な情報を表にまとめます。これらは、後ほど「デプロイするか、APIで呼び出すか」を判断するうえで重要です。
| ポイント | 説明 | モデル選定への影響 |
|---|---|---|
| モデルの位置づけ | 事前学習完了時点のチェックポイント。中間学習と事後学習は未実施 | そのままでは対話できず、追加学習に適している |
| パラメータ規模 | 総パラメータ数は280B、トークンあたりの活性化パラメータ数は14B | 推論時の計算量は少ないが、重みのVRAM使用量は280Bに基づく |
| コンテキスト | 学習時のコンテキストは128K、ファインチューニングと推論では1Mトークンをサポート | 長文書やリポジトリ規模のコードなどへの領域適応に適している |
| 重みの形式 | Hugging FaceでFP8とBF16を提供 | FP8ならデプロイのハードルを大幅に下げられる |
| エコシステムのサポート | vLLMプラグイン、SGLang Cookbook | 主要な推論フレームワークに直接組み込める |
文心5.5 Flash Base の「Base」とは
Baseモデルが学習しているのは「次のトークンを予測すること」だけで、「指示を理解して回答すること」は学んでいません。質問を与えても、回答する代わりに、さらに質問を続けて生成する可能性があります。百度の公式説明も明確で、開発者はこの共通の出発点を基に、領域適応、指示チューニング、推論能力の強化、Agentの学習を進められます。
つまり、最初の判断基準はシンプルです。目的が「モデルを使うこと」なら、Baseは求めているものではありません。「モデルを学習させること」が目的なら、良い出発点になります。百度はまた、文心5.5 Flashの正式版を近くリリースすると明かしています。対話にそのまま使いたいチームは、正式版を待つのもよいでしょう。
文心5.5 Flash Base と同規模の競合モデル
百度が公開した評価では、DeepSeek-V4-Flash-Base(284B-A13B)、Hy3-preview-Base(295B-A21B)、MiMo-V2.5-Base(310B-A15B)が比較対象となっています。文心5.5 Flash Baseは、推論、コード、各学問分野の能力、長いコンテキストを扱うタスクで優れた性能を示しました。コードAgentや長文書の理解などに向けてファインチューニングを行うチームにとって、候補に入れる価値のあるベースモデルです。
文心5.5 Flash Base の仕組み:効率を高める3つの改良
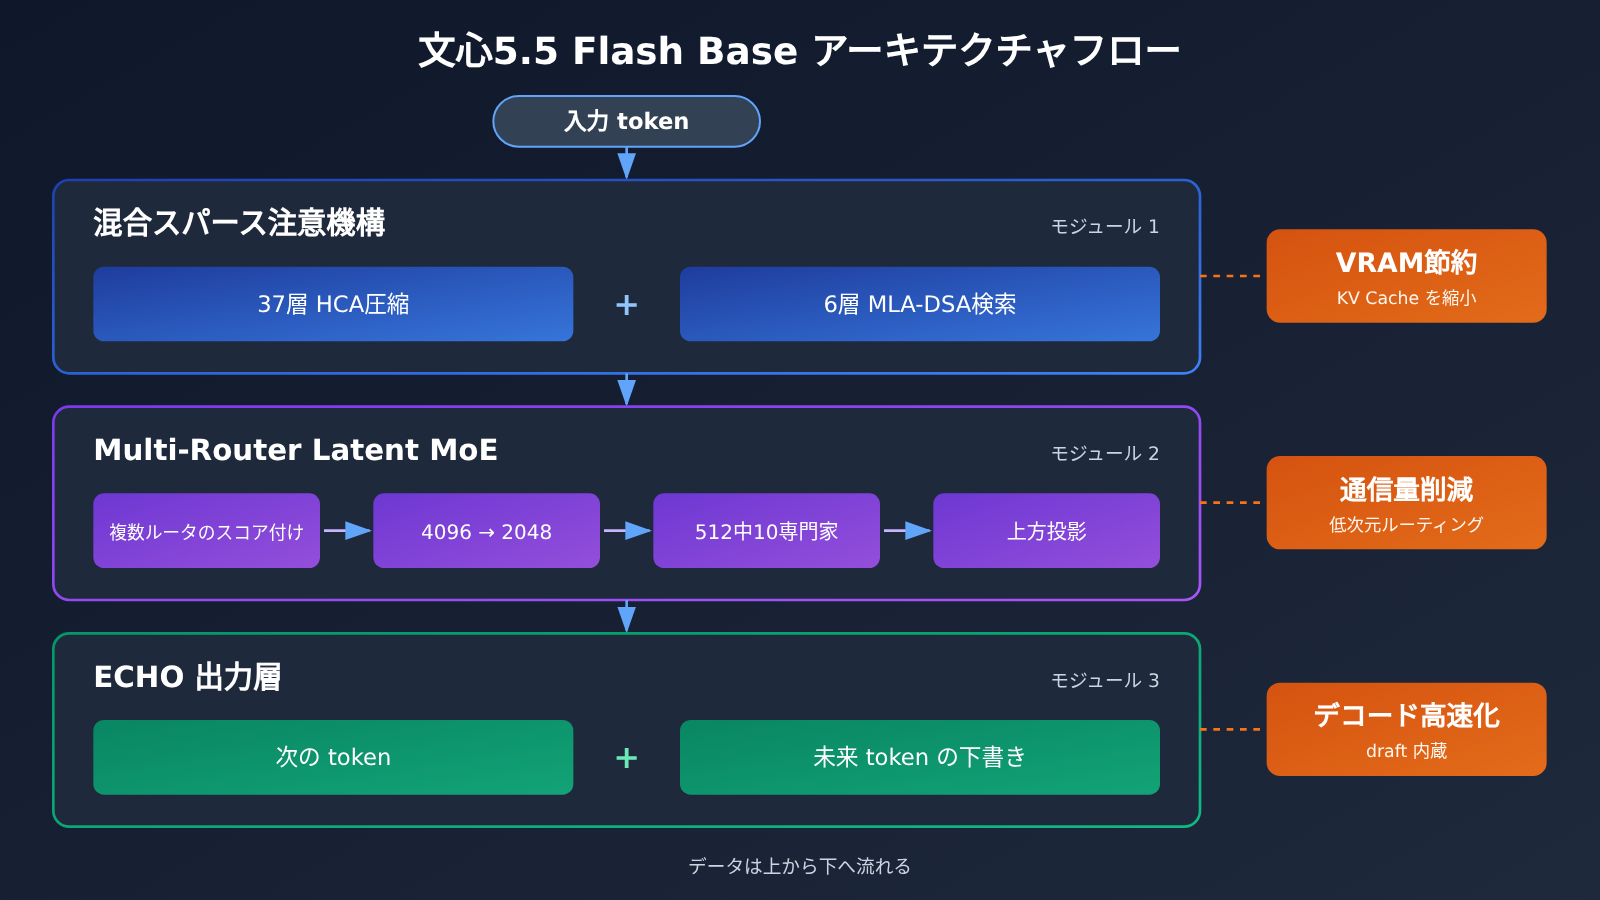
アーキテクチャを理解すると、デプロイコストの見積もりに役立ちます。文心チームは事前学習の設計段階から「効率」を重視し、アテンション、エキスパートのルーティング、未来の token 予測という3つの領域を中心に改良を加えています。
| モジュール | 主な設計 | デプロイ時のメリット |
|---|---|---|
| 混合スパースアテンション | 43層のうち37層が HCA(128 token ごとに1つのキャッシュに圧縮)、6層が MLA + DSA によるスパース検索 | KV Cache が大幅に縮小し、長いコンテキストでも GPU メモリを節約 |
| Multi-Router Latent MoE | 複数の Sigmoid ルーターが共同でスコアを算出し、512個のルーティング対象エキスパートから10個を選択。さらに共有エキスパート1個を使用し、エキスパートの計算は2048次元の潜在空間で実行 | エキスパートの FLOPs とデータ分配時の通信量が約半分に |
| ECHO | 本体の最終層を再利用して未来の token を予測 | パラメータを増やさず、投機デコード用の組み込み draft モデルとして直接利用可能 |
| 関連する設計 | MultiMax 出力ヘッド、約20万語彙の R2L トークナイザー | 数値や算術の処理がより安定 |
文心5.5 Flash Base の KV Cache が省メモリな理由
従来のモデルでは、各層が完全な KV Cache を保存するため、コンテキストが長くなるほど GPU メモリの負担が増えます。文心5.5 Flash Base では、37層が圧縮された「要約」だけを参照し、残る6層だけが token ごとに履歴へアクセスします。さらに、この6層では軽量の Indexer が Top-K の位置を選び、詳細な計算を行います。これにより、128K 以上の長いコンテキストでも、KV Cache の使用量は同規模の全アテンションモデルを大きく下回ります。自社でデプロイするチームにとって、GPU メモリを実際に節約できるメリットがあります。
ECHO が推論の高速化にもたらすもの
ECHO は事前学習時には追加で1 token だけを予測しますが、draft モデルとしては複数の token を連続して生成できます。その採用率は、同じ方法で学習した外付けの MTP モジュールを上回ります。自社デプロイ時に推論フレームワークがこの投機デコード方式に対応していれば、スループットの大幅な向上が見込めます。こうした推論の最適化を自分たちで完全に制御できることも、API と比べたオープンウェイトの利点です。
文心5.5 Flash Base クイックスタート:自前でのデプロイ手順
この基盤モデルを使って学習やプライベート環境での推論を行うと決めた方向けに、最短の手順を紹介します。コードは掲載せず、主要なパラメータを文章で説明します。
ステップ1:必要なGPUメモリを見積もる
MoEモデルの計算量は活性化パラメータ数を基準に算出しますが、重みはすべて読み込む必要があります。そのため、GPUメモリは総パラメータ数の280Bを基準に見積もります。以下は「パラメータあたりのバイト数 × パラメータ数」による概算です。KV Cache、活性化値、フレームワークのオーバーヘッドは含まれていないため、実際には公式ドキュメントと自社での検証結果を確認してください。
| 重みのバージョン | 重みに必要なGPUメモリの概算 | デプロイの目安(概算) | 適した用途 |
|---|---|---|---|
| FP8 | 約280GB | 80GB級GPUを8枚搭載した単一マシンで、KV Cache用の空きも確保可能 | 推論評価、軽量なサービス |
| BF16 | 約560GB | 大容量GPUを8枚搭載した単一マシン、または複数マシンでのテンソル並列 | 精度重視の評価とファインチューニングの出発点 |
| 全パラメータのファインチューニング | 推論時より大幅に多い(オプティマイザの状態と勾配も必要) | 複数マシンのクラスターと分散学習フレームワークが必要 | 本格的なドメイン適応 |
| LoRA系ファインチューニング | 推論と全パラメータ学習の中間 | ランクとシーケンス長によって異なる | 中小規模のチームによるドメイン適応 |
ステップ2:推論フレームワークを選び、重みを読み込む
公式からvLLMプラグインとSGLang Cookbookがあわせて提供されているため、まずはこの2つの資料に沿って進めることをおすすめします。具体的な手順は次のとおりです。
- Hugging FaceからFP8またはBF16の重みをダウンロードします。重みの読み込みに必要なGPUメモリと同程度のディスク容量を確保しておきましょう。
- vLLMをインストールして公式プラグインを読み込むか、SGLang Cookbookに従って起動パラメータを設定します。
- テンソル並列の規模をGPUの枚数に合わせます(vLLMでは
tensor-parallel-sizeパラメータに対応します)。 - まずは32K程度のコンテキスト長で動作を確認し、KV Cacheの使用量を観察しながら徐々に拡大します。
- 続きを生成させる形式のプロンプトでスモークテストを行います。たとえば、直接質問するのではなく、コードの冒頭を与えて続きを補完させます。
ステップ3:学習目標を明確にする
Baseの重みを導入してからが、本格的な作業の始まりです。一般的な方向性は、ドメイン固有のコーパスを使った継続事前学習、指示データを使ったSFT、SFTを基にした推論能力の強化やAgentの軌跡学習の3つです。文心は事前学習の段階で、commit、issue、PR、CIによる検証・修正などのコードデータや、マルチホップ質問応答形式の長文データをすでに取り込んでいます。そのため、コード開発と長文書の2つの分野では、ファインチューニングによる効果が特に期待できます。
🎯 技術的なアドバイス:GPUを使ってファインチューニングに着手する前に、まずは既存の指示モデルで業務用の評価セットを試し、「ベースラインスコア」を確認することをおすすめします。APIYI apiyi.comは主要なモデルを統一インターフェースで提供しており、比較用のベースラインを低コストで取得できます。そのうえで、基盤モデルの独自学習に投資する価値があるかを判断しましょう。
文心5.5 Flash Base クイックスタート:用途に合わせたAPI活用
まずお伝えしておきたいのは、APIYI では現在、文心5.5 Flash Base を含む文心 ERNIE シリーズのモデルはまだ提供していないという点です。できるだけ早く提供を開始する予定です。また、Base モデル自体は対話APIとして直接使う用途には適しておらず、多くのビジネス用途では指示追従版や推論版のほうが適しています。
「すぐに製品へ機能を組み込みたい」という場合は、まず提供中の実績あるモデルでシステムを構築し、文心5.5 Flash の正式版が提供開始された後に切り替えて比較できます。APIYI は OpenAI と Anthropic の両方のインターフェース形式に対応しているため、モデルの切り替えは model パラメータを変更するだけで済み、呼び出しロジックを書き直す必要はありません。
APIYI で提供中の代替モデルの価格
以下は APIYI の価格ページ docs.apiyi.com/models に基づく価格で、単位は100万トークンあたりの米ドルです。利用前にページの最新情報をご確認ください。
| モデル | 入力 | 出力 | キャッシュ | 適した用途 | 利用可能なプラットフォーム |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | 高い並列処理能力が必要なタスク、コスト重視のタスク | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | 長いコンテキスト、中国語を扱う用途 | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | プログラミングや Agent の主力モデル | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | 複雑な推論や難易度の高いタスク | APIYI apiyi.com |
| 文心5.5 Flash Base / 正式版 | — | — | — | APIYI では現在未提供 | できるだけ早く提供予定 |
このほか、APIYI では qwen3.8 シリーズなどの中国製モデルや、画像モデルの gpt-image-2.6-flare、gpt-image-2.6-sunburst も提供しています(テキスト入力 $5、画像入力 $8、出力 $30。こちらも価格ページをご確認ください)。なお、表中の deepseek-v4.1-flash は直接呼び出せる指示追従モデルであり、ベンチマーク比較の対象となった DeepSeek-V4-Flash-Base とは別のモデルです。
接続方法
OpenAI 形式では、SDK の base_url に APIYI のドキュメントに記載されたインターフェースのアドレスを設定し、api_key にコンソールで生成したAPIキーを入力するだけです。Anthropic SDK を使用しているプロジェクトも同様に直接接続できます。インターフェースの完全なアドレス、パラメータの説明、サンプルについては、APIYI のドキュメントセンター docs.apiyi.com を参照してください。
🚀 クイックスタート:まずは APIYI apiyi.com で deepseek-v4.1-flash または claude-sonnet-5-5 を使い、プロトタイプを動かしてみることをおすすめします。文心5.5 Flash の正式版がプラットフォームで提供開始された後は、モデル名を変更するだけで A/B 比較ができます。
文心5.5 Flash Base の自社デプロイと API 呼び出し:判断表
以下の5つの観点から、どちらが自分のチームに合っているかを判断できます。
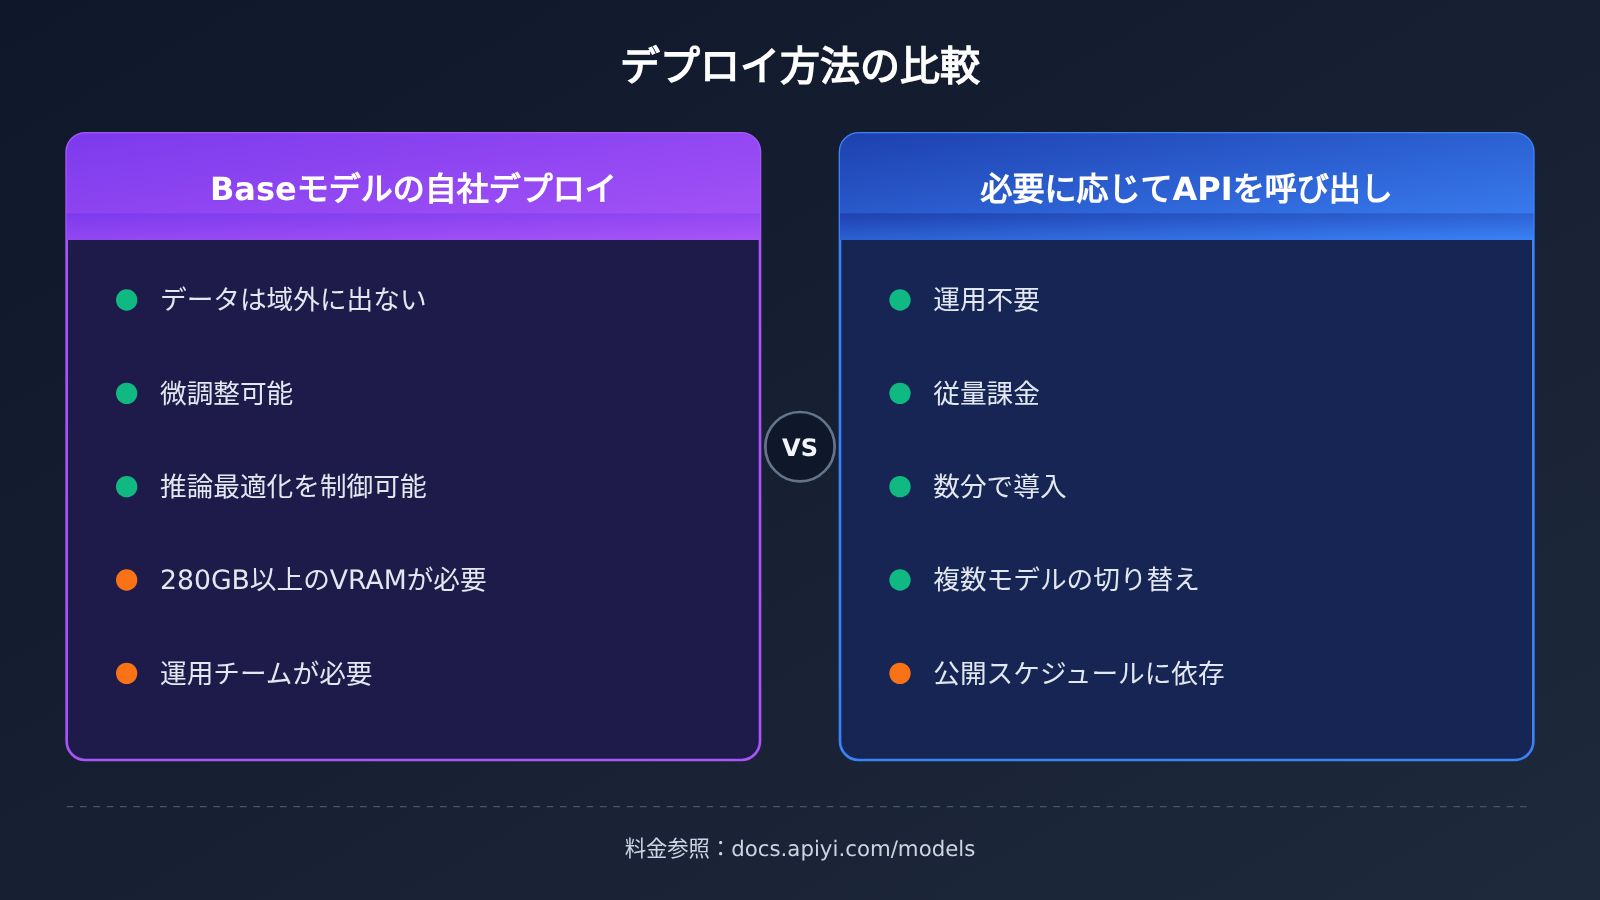
| 判断基準 | Base を自社デプロイ | API を必要に応じて呼び出す |
|---|---|---|
| 利用目的 | 特定分野での継続事前学習、SFT、RL、または研究の比較実験を行う | 質問応答、文章作成、コーディングアシスタントなどのアプリをすぐに開発する |
| データコンプライアンス | データを社内ネットワークの外に出せず、プライベート環境が必須 | クラウドにデータを送信でき、サービス提供者のコンプライアンス条件を受け入れられる |
| 呼び出し規模 | 長期にわたって安定した高負荷があり、GPU 使用率を高く維持できる | トラフィックの変動が大きい、または1日の呼び出し量が限られている |
| チームの能力 | 学習と推論の運用を担当するエンジニアがいる | アプリ開発が中心で、クラスタを保守したくない |
| サービス開始時期 | 数週間から数か月の学習期間を許容できる | 今週中にサービスを開始する必要がある |
文心5.5 Flash Base の2種類の典型的なユーザー
自社デプロイに適したチーム:例えば、金融、医療、政府・企業向けなど、プライベート環境を必要とする業界のチームです。特定分野のコーパスを大量に保有し、独自モデルの学習を目指しています。こうしたチームが文心5.5 Flash Base を選ぶ理由は、コードと長いコンテキストに対応する事前学習の基盤と、HCA アーキテクチャによる KV Cache の節約にあります。
API 呼び出しに適したチーム:例えば、SaaS、コンテンツツール、カスタマーサポートシステムを開発するアプリチームです。安定性、スピード、従量課金を重視します。このようなチームが Base モデルを直接使うと、かえって学習の手間が増えます。まずは実績のある指示追従モデルを使ってサービスを開始し、製品開発に注力するのが合理的です。
2つの方法は並行できる
多くのチームは、実際には「ハイブリッド方式」を採用しています。本番サービスでは API を呼び出して安定性を確保しながら、社内では Base の重みを使って実験を進めます。自社で学習したモデルが評価セットで API のベースラインを上回ったら、徐々にトラフィックを切り替えます。この方法ならリスクを最小限に抑えつつ、独自開発の投資に対して常に明確な比較基準を持てます。
💡 選び方のヒント:まだ判断に迷う場合は、まず費用を計算してみましょう。想定される月間呼び出し量を APIYI の料金ページにある単価で月額費用に換算し、GPU のレンタル費用や減価償却費と比較します。APIYI apiyi.com の統一インターフェースを使って1週間ほど小規模に試し、実際のトークン使用量を確認してから判断すれば、感覚だけで見積もるよりもはるかに正確です。
よくある質問 FAQ
Q1:文心5.5 Flash Baseとは何ですか?
百度が2026年11月5日にオープンソースとして公開した基盤モデルです。スパースMoEアーキテクチャを採用し、総パラメータ数は280B、tokenあたりの活性化パラメータ数は14Bです。33.5T tokensを使ってゼロから事前学習されています。公式が公開したのは事前学習終了時点の重みで、直接対話するためではなく、主に追加学習に使用します。
Q2:文心5.5 Flash BaseとDeepSeek-V4-Flash-Baseの違いは何ですか?
両者の規模は近く、DeepSeek-V4-Flash-Baseは284B-A13Bです。DeepSeek-V4-Flash-Baseも強力な基盤モデルですが、百度が公表した評価では、文心5.5 Flash Baseが推論、コード、学術分野、長いコンテキストの処理で上回っています。アーキテクチャ面では、文心はHCAとMLAを組み合わせたハイブリッド注意機構と、マルチルーターMoEを採用し、KV Cacheの圧縮とルーティングの安定性向上に重点を置いています。
Q3:文心5.5 Flashの正式版はいつリリースされますか?
百度は正式版を近くリリースするとしていますが、執筆時点(2026年11月6日)では具体的な日付を発表していません。正式版はBaseをもとに事後学習を実施したもので、アプリケーションへの直接組み込みに適しています。
Q4:文心5.5 Flash Baseはどのような用途に適していますか?
主に以下のような用途に適しています。
– **リポジトリ全体を扱うコードモデルの学習**:事前学習にはcommit、PR、CI修正などの開発データが含まれています。
– **長文書を扱う分野特化モデル**:法律関係の文書や調査レポートなど、長いコンテキストの理解に活用できます。ファインチューニングと推論では1M tokensに対応します。
– **学習手法の研究**:共通の出発点として、異なるSFTやRLの手法の効果を比較できます。
Q5:文心5.5 Flash Baseは現在API経由で呼び出せますか?
APIYIでは現在、このモデルはまだ提供しておらず、ERNIEシリーズ全体も未対応ですが、できるだけ早く提供する予定です。現時点では、APIYI apiyi.comでdeepseek-v4.1-flash、kimi-k3.1-pro、claude-sonnet-5-5など、提供中のモデルを呼び出せます。プラットフォームはOpenAIおよびAnthropicのインターフェース形式に対応しています。料金はdocs.apiyi.com/modelsをご確認ください。
Q6:文心5.5 Flash Baseを自前でデプロイする場合、どのような制約がありますか?
まず、必要なVRAMが多く、FP8の重みを使っても、重みだけで約280GBが必要です。また、Baseモデルはそのままでは実用できず、追加学習が欠かせません。さらに、長いコンテキストで推論するには、KV Cache用の容量も確保する必要があります。チームに学習や運用の経験が不足している場合は、まずAPIの利用をおすすめします。
Q7:中小規模のチームは文心5.5 Flash Baseをどう活用できますか?
クラウドGPUを借りてFP8推論による性能評価を行ったり、LoRAのような手法で軽量な分野適応を行ったりできます。本番環境のトラフィックには引き続きAPIを利用し、APIYI apiyi.comで得られた業務上のベースラインを、自社で学習したモデルの比較基準とすることをおすすめします。
文心5.5 Flash Base の重要ポイント Key Takeaways
- 位置づけは学習の出発点:Base は事後学習が行われていないため、ファインチューニングや研究に適していますが、そのままでは対話できません。
- 計算量は活性化パラメータ数、VRAMは全パラメータ数に依存:活性化されるのは 14B ですが、FP8 の重みだけでも約 280GB の VRAM が必要です。
- 長いコンテキストでもキャッシュを節約:37 層の HCA による圧縮と 6 層の MLA-DSA により、KV Cache を大幅に削減します。
- コードと長文の基礎能力が充実:リポジトリ全体を扱うコード向けモデルや、長文ドキュメント向けのドメイン特化モデルに適しています。
- エコシステムも準備済み:vLLM プラグインと SGLang Cookbook が同時に公開され、推論環境に導入しやすくなっています。
- API はまだ未対応:APIYI では現在、文心シリーズを提供していません。まずは提供済みのモデルで業務向けのベースラインを構築できます。
まとめ
文心5.5 Flash Base を選ぶ際のポイントは次のとおりです。
- まず目的を確認:モデルを学習させるなら Base を自社環境にデプロイし、モデルを利用するなら API を選ぶか正式版を待ちましょう。
- 次に必要な環境を確認:重みの保存には FP8 で約 280GB、BF16 で約 560GB の VRAM が必要です。
- 最後にコストを比較:実際の呼び出し量をもとに API の月額費用と GPU コストを比較しましょう。リスクを抑えるなら、両者を組み合わせる方法がおすすめです。
多くのアプリケーション開発チームにとっては、まず API で業務を動かし、オープンな Base モデルを使って社内で実験を進めるのが現実的です。APIYI apiyi.com の提供済みモデルを使えば、ベースラインを素早く構築できます。インターフェースの説明は docs.apiyi.com を、料金は docs.apiyi.com/models をご確認ください。文心シリーズの提供開始後は、同じコードのモデル名を変更するだけで比較できます。
📚 参考資料
- 量子位 – 百度による文心5.5 Flash Baseのオープンソース公開に関する記事:モデルの公開と評価の概要
- リンク:
qbitai.com/2026/11/507787.html -
内容:同サイズの基盤モデルとの比較と主要技術の紹介
-
APIYI ドキュメントセンター:エンドポイント、OpenAI・Anthropic互換の呼び出し方法
- リンク:
docs.apiyi.com -
内容:導入前の必読資料。パラメータとサンプルを掲載
-
APIYI モデル料金ページ:提供中のモデルの入力、出力、キャッシュの単価
- リンク:
docs.apiyi.com/models - 内容:本記事の料金はすべて、このページの実際のデータを基準とします
著者:APIYI 技術チーム
技術に関するお問い合わせ:APIYIのホームページ apiyi.com からお気軽にお問い合わせください。詳しい導入資料は、ドキュメントセンター docs.apiyi.com をご覧ください。


