
著者注:AI生成コード比率が30%を超えても、納品が速くなるとは限りません。この記事では「理論上の上限は7%」という数字の導き方を解説し、5つのプロセス上のボトルネックを分析するとともに、チーム向けのセルフチェックリストを紹介します。
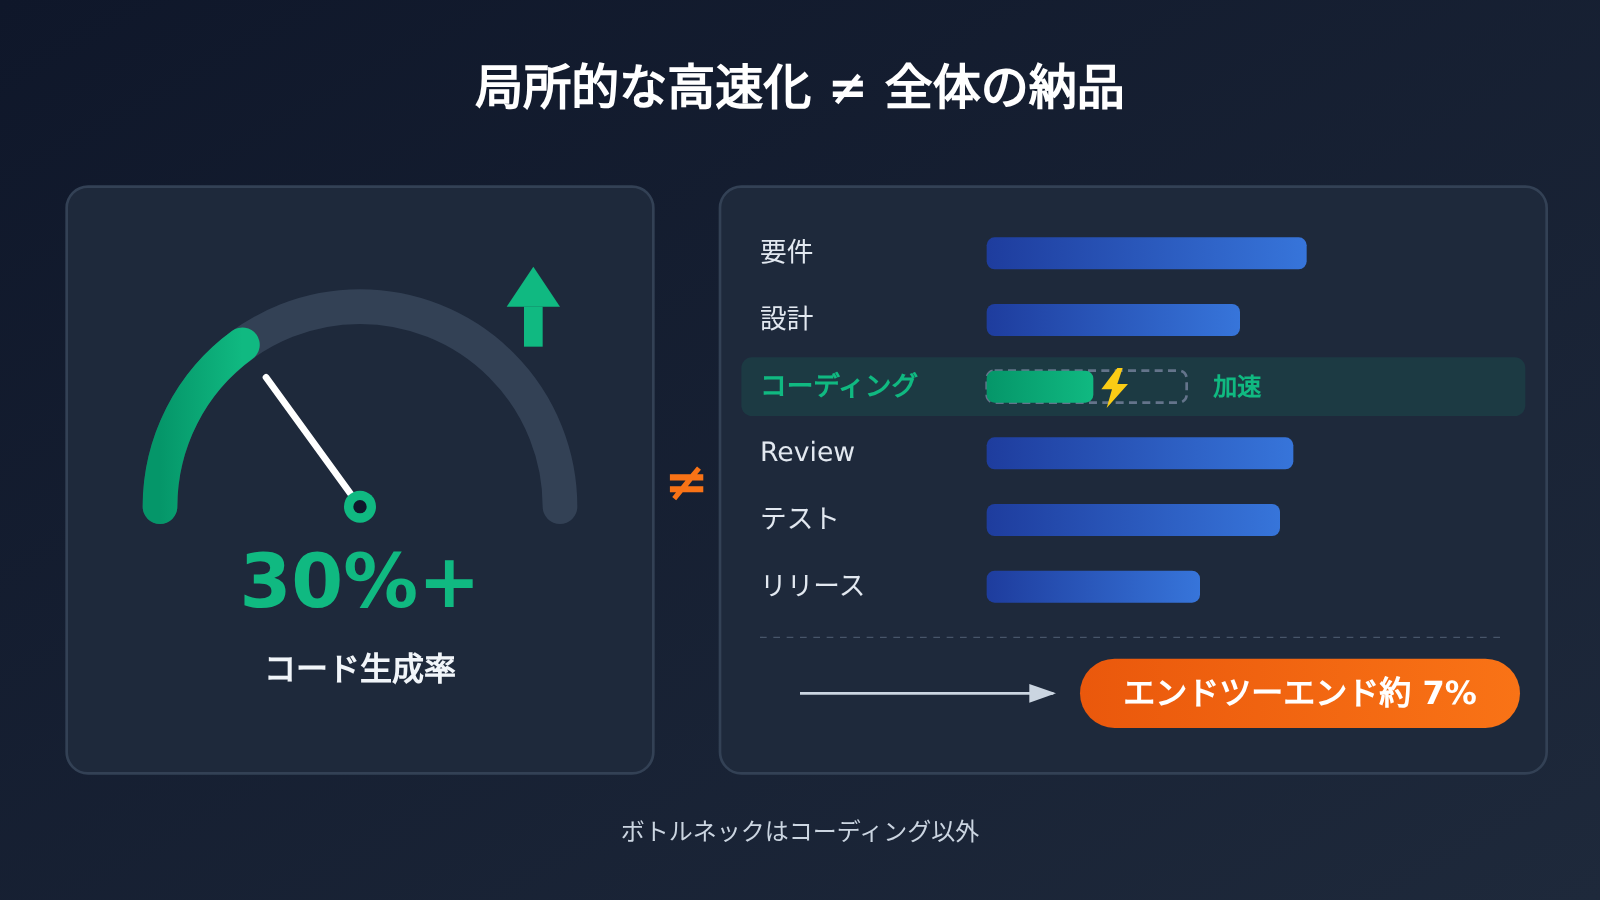
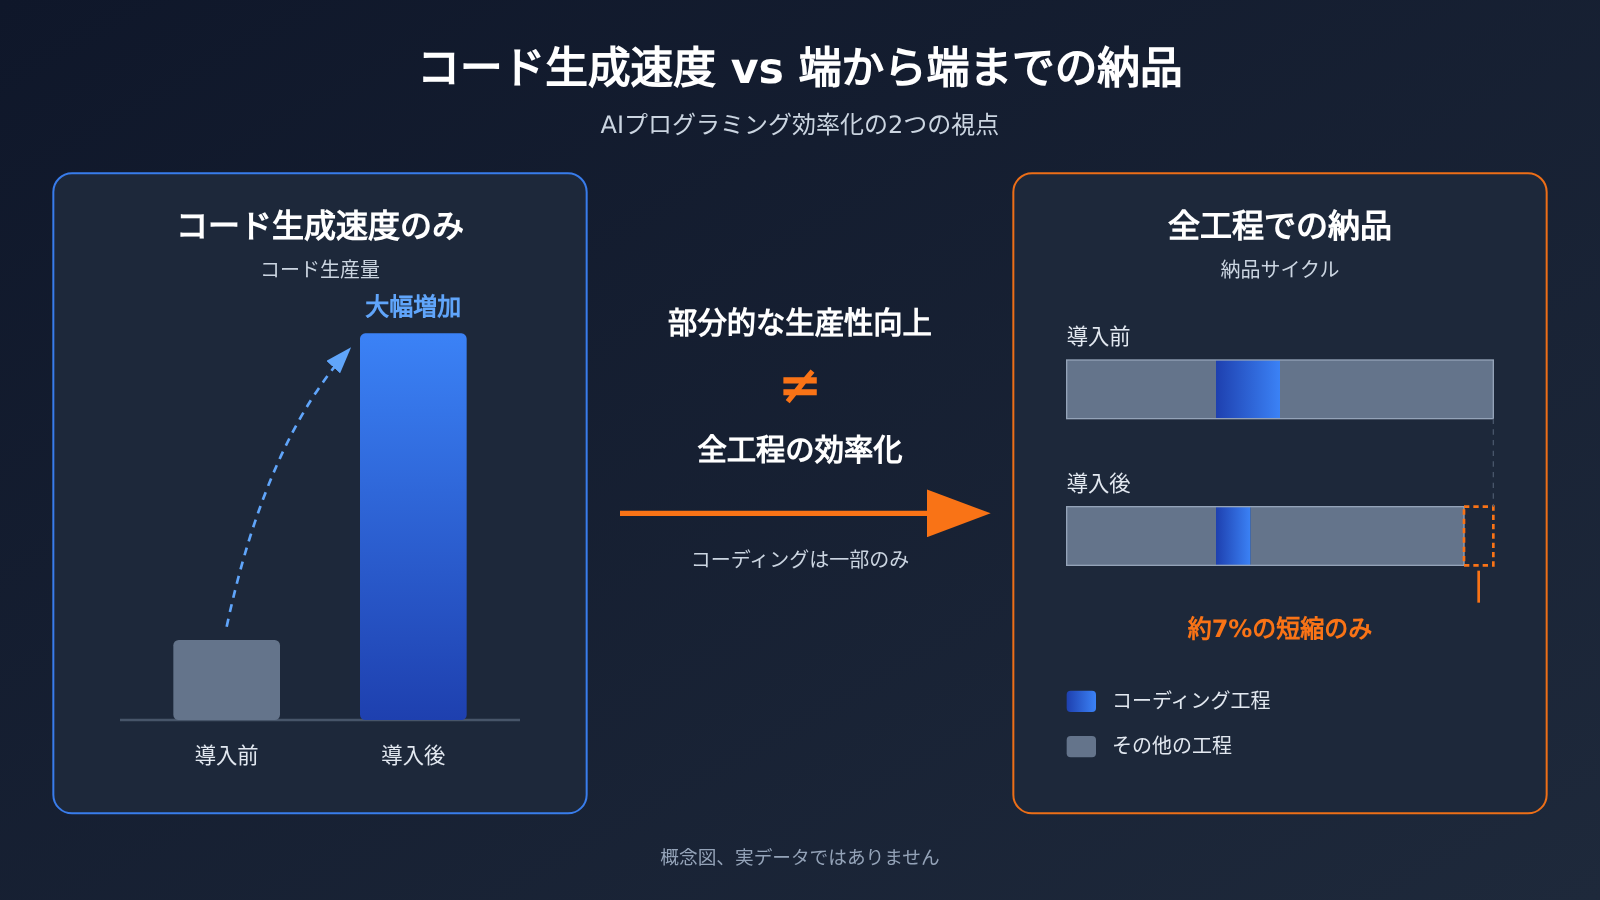
まず結論から言うと、AI生成コード比率は納品速度とイコールではありません。AIが生成したコードの割合が一桁台から30%以上に伸びても、増えるのは「コーディング」という工程のアウトプットだけです。納品までの時間には、要件確認、設計、レビュー、テスト、連携テスト、リリース、受け入れ確認も含まれます。コーディングは一連の流れの一部にすぎないことが多いため、AI生成コード比率がどれだけ上がっても、納品までの期間を短縮できるのはコーディング工程の比率で決まる範囲に限られます。
これは、ツールを導入してAI生成コード比率のレポートは好調なのに、納品までの期間はほとんど変わらない、という多くの技術マネージャーの疑問にも答えます。ある業界資料では、あるチームの作業時間の内訳をもとに、エンドツーエンドの効率改善は最大でも7%程度と推計しています。これはAIコーディングを否定するものではありません。本当に納品を遅らせているのは、コーディング以外の5つのボトルネックだと伝えるための数字です。この記事では、7%という数字の算出方法と、それが当てはまる条件、そしてチームでのセルフチェックの方法を解説します。
AIコード生成率30%超と7%の上限:要点を整理
計算の流れに入る前に、今回の議論で重要な情報と数字の定義を表にまとめます。特に、それぞれの数字の出所と信頼性に注目してください。以降の分析は、すべてこの前提に基づいています。
| 項目 | 内容 | 定義・出所 |
|---|---|---|
| AIコード生成率 | 30%超 | コードに占めるAI生成部分の割合。コーディング工程の成果のみを示す |
| エンドツーエンドの効率向上の上限 | 約7%程度 | 特定チームの所要時間の内訳に基づく推計であり、普遍的な法則ではない |
| 業界内での意見 | 約3%~5% | 意見交換から得られた数字で、検証可能なサンプルはない |
| 有効コードのスループット | 2~3倍 | チームの振り返りデータ。集計基準や比較方法は公開されていない |
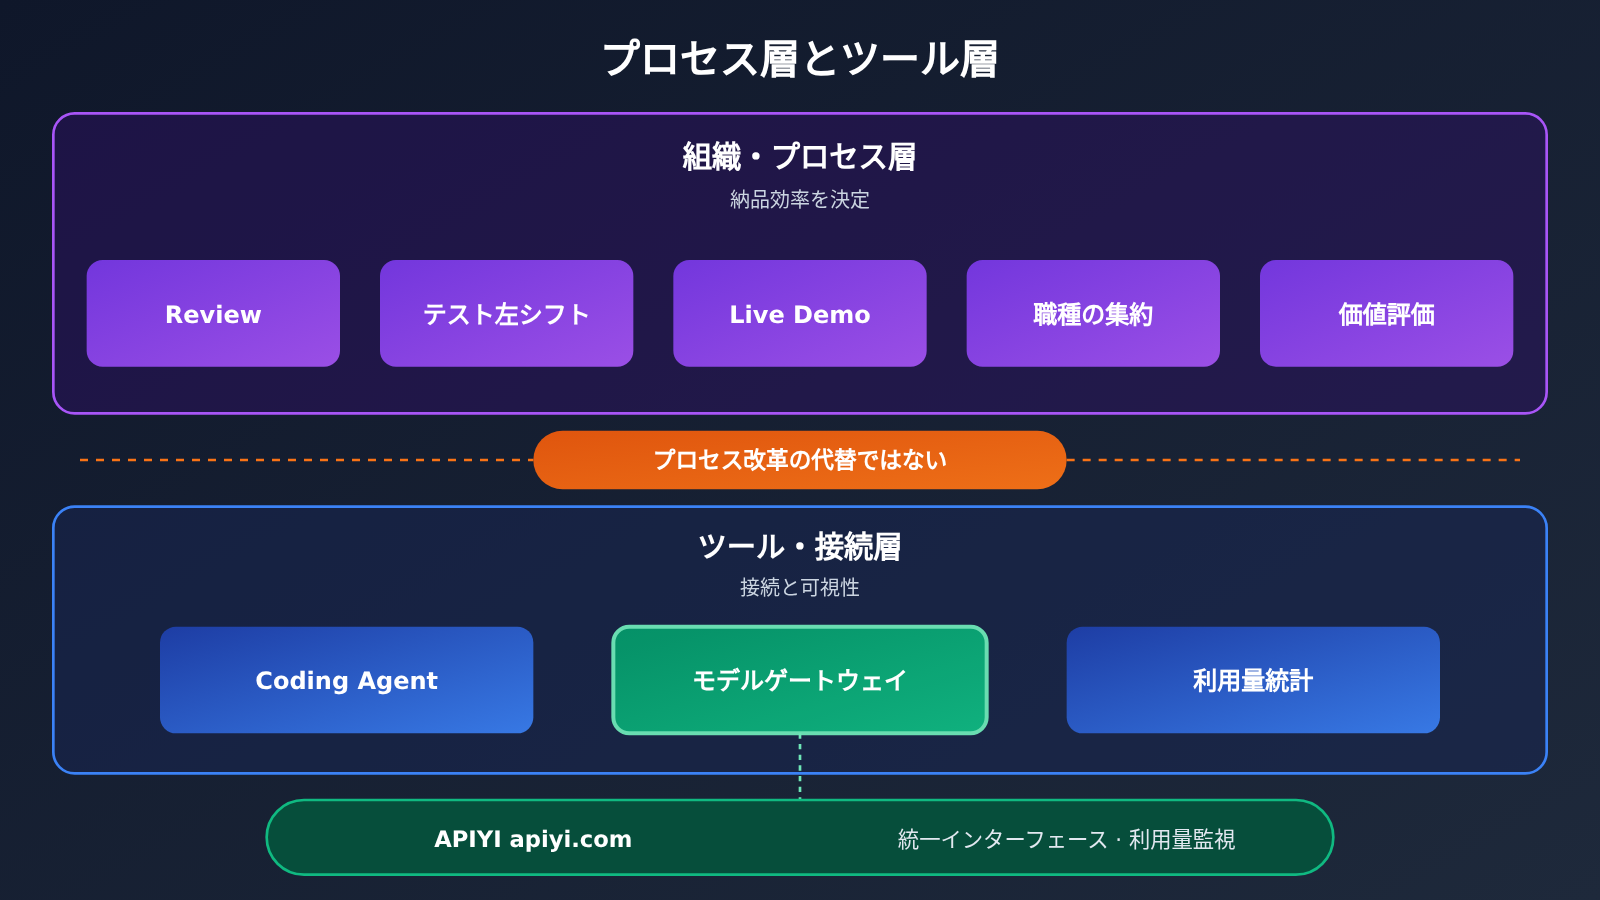
| 5つのボトルネック | レビュー待ち、テストと可観測性のシフトレフト、ライブデモ、職種の収束、価値レビュー | 組織とプロセスに関わる問題 |
| Coding Agentの接続 | APIYI apiyi.com などの集約インターフェースを通じて一元的に接続可能 | 接続と利用量の把握には役立つが、プロセス上のボトルネックは解消しない |
これらの数字は矛盾していません。「有効コードのスループットが2~3倍」はコーディング工程の成果を示し、「7%」と「3%~5%」はエンドツーエンドのデリバリーを示しています。前者は局所的な指標、後者は全体の指標であり、その間にはデリバリーの一連の工程が存在します。
7%という上限はどこから来るのか:AIコード生成率とコーディング時間の割合の関係
エンドツーエンドの効率改善を数式で分解する
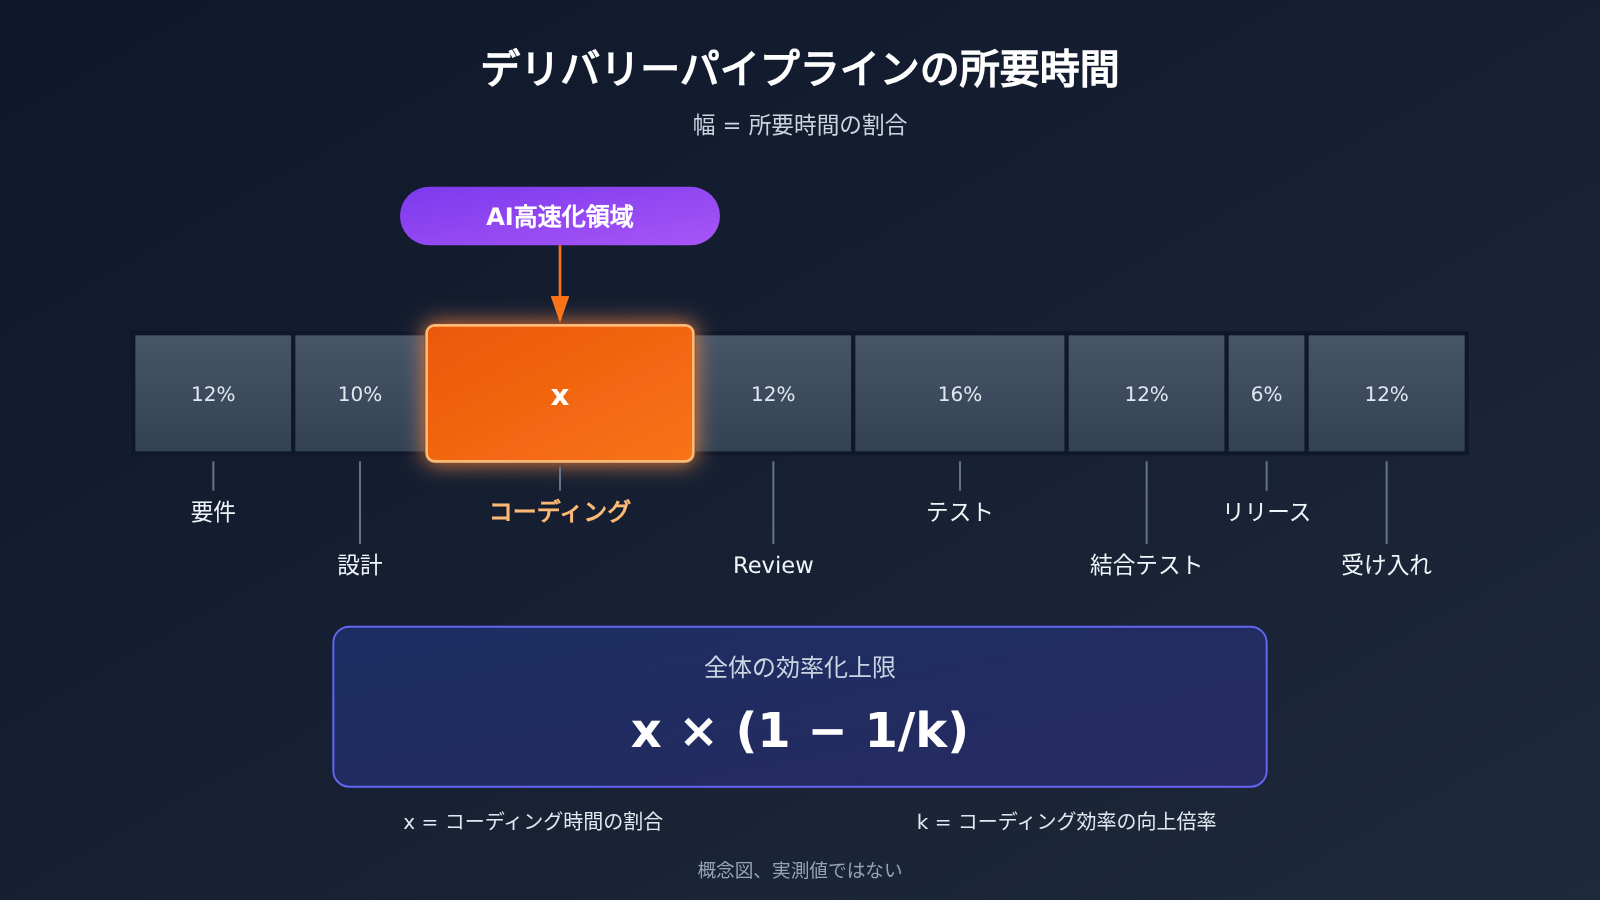
エンドツーエンドの効率改善の上限は、エンドツーエンドの効率改善上限 ≈ x × (1 - 1/k) という簡単な式で見積もれます。ここで x は、成果物の納品までにかかる時間全体に占めるコーディング工程の割合、k はコーディング工程の効率が何倍になったかを表します。これは本質的に、アムダールの法則を開発プロセスに適用したものです。システムの一部だけを高速化しても、全体の改善幅はその部分の占める割合によって制限されます。
わかりやすい例を挙げましょう。コーディングが納品までの時間の 14% を占め、AI によってコーディングが 2 倍速くなった(k = 2)とすると、14% × (1 - 1/2) = 7% です。仮にコーディング時間がゼロになったとしても(k が無限大に近づいても)、エンドツーエンドでは最大 14% しか短縮できません。以下の表は、いくつかの仮定に基づく計算結果です。あくまで数式の説明用であり、特定のチームの実測データではありません。
コーディング時間の割合 x |
コーディングの効率改善倍率 k |
エンドツーエンドの効率改善上限 | 解説 |
|---|---|---|---|
| 10% | 3 | 約 6.7% | コーディングが 3 倍速くなっても、全体では 7% 未満 |
| 14% | 2 | 7% | 資料の推算と同程度になる例 |
| 20% | 1.5 | 約 6.7% | 効率改善倍率が低いと、全体への効果はすぐに薄まる |
| 20% | 2 | 10% | コーディングの割合が高いチームほど改善の余地が大きい |
| 30% | 2 | 15% | コーディングに多くの時間を費やすチームの例 |
| 20% | 無限大に近づく | 20% | コーディング時間がゼロになった場合の理論上の上限 |
AIコード生成率 30% は、コーディングが 30% 速くなることではない
もう一つ、見落とされがちな点があります。AIコード生成率と k は同じものではありません。AIコード生成率は「コードのうち、どれだけを AI が書いたか」を示す一方、k は「コーディングの所要時間がどれだけ短縮されたか」を示します。AI が生成したコードも、読んでデバッグし、修正する必要があります。生成そのものにも、プロンプトの入力、待機、エラー修正といったコストがかかります。
極端に単純化して、AI が生成した 30% のコードにはまったく時間がかからないと仮定しても、コーディングの効率改善倍率は 1 / (1 - 0.3) ≈ 1.43 にとどまります。さらにコーディング時間の割合を考慮すると、エンドツーエンドでの改善幅はもっと小さくなります。したがって、資料にある 7% という数字は不思議ではありません。むしろ、問題の鍵は「より多くのコードを生成すること」ではなく、コーディング以外の工程にあることを示しています。
改めて強調すると、7% は、ある特定のチームの所要時間の内訳に基づく推算です。チームによってコーディング時間の割合、要件の安定度、テスト体制は異なるため、結果はこれより高くなることも低くなることもあります。この数字の価値は、直接当てはめられる結論ではなく、考えるための枠組みを提供している点にあります。
開発スピードが上がらない5つのボトルネック:コード生成速度の先にある本当の課題
コーディングが速くなると、そのしわ寄せは開発工程の下流へと移ります。以下の5つのボトルネックには、AIコーディングによって拡大した新たな問題もあれば、以前から存在していたものの、コーディングの速度に隠れて見えなかった問題もあります。
ボトルネック1:キーパーソンのレビュー待ち
AIが生成するコードが増えるほど、レビューが必要なコードも増えます。レビューは少数のキーパーソンに集中しがちです。彼らはビジネス上の背景を理解したうえで、AIが生成したコードの境界条件や潜在的なリスクも判断しなければなりません。その結果、コーディングで節約した時間の多くが、レビュー待ちの時間に変わってしまいます。
さらに厄介なのは、AIが生成したコードは「一見正しく見える」ことです。レビュアーはより注意深くコードを読む必要があるため、コード量あたりのレビューコストが下がるとは限りません。重要度に応じたレビューの実施、キーパーソン以外でも承認できる変更の明確化、規約チェックの自動化など、レビューの仕組みを見直さなければ、キーパーソンが開発工程全体で最も大きなボトルネックになってしまいます。
ボトルネック 2:テストと観測性の左シフト
多くのチームでは、テスト、監視、可観測性への取り組みが開発の後半になってから始まります。コーディングが速くなると、問題がテスト段階により早く積み上がり、かえって手戻りが集中します。テストケース、計測ポイント、アラートルールをコーディング前またはコーディング中に並行して設計できなければ、後半の結合テストや修正が、それまでの効率化の成果を食いつぶしてしまいます。
テストと観測性の左シフトの核心は、「検証」と「実装」を同時に進めることです。AIが生成したコードでは、これが特に重要になります。人が一行ずつ確認するのではなく、実際に動かせる検証手段を使って、生成結果が正しいかを素早く判断する必要があるからです。
ボトルネック 3:Live Demoで要件を確認し、手戻りを減らす
開発から納品までのサイクルで最もコストがかかるのは、コードを書くことよりも、間違って書いたものを修正することです。要件の認識違いによる手戻りが発生すると、コーディング、レビュー、テストをすべてやり直すことになります。AIによってコーディングのコストが下がった今、より効果的な使い方の一つは、動作するLive Demoを素早く作り、要件を依頼した人に実際に操作してもらいながら「イメージどおりか」を確認することです。
これは、要件確認をドキュメントのレビューからプロトタイプのレビューへと変えることに相当します。ドキュメントは人によって解釈が分かれがちですが、動作するDemoなら認識の違いを早い段階で明らかにできます。コーディングコストの低下がもたらす本当のメリットは、本番用のコードをより速く書き終えることではなく、より少ないコストで試行錯誤できることかもしれません。
ボトルネック 4:職種の統合と PDFE・ABE の役割の変化
従来の開発フローでは、プロダクト、デザイン、フロントエンド、バックエンド、テストの間で、数多くの引き継ぎが発生します。引き継ぎのたびに待ち時間が生まれ、コンテキストが失われ、認識を再びすり合わせる必要がありました。資料で言及されている PDFE や ABE などの役割を統合する取り組みは、一人または小さなチームがより長い工程をカバーし、引き継ぎの回数を減らすことを本質的な目的としています。
AI がより多くのコーディングを担うようになったことで、エンジニアは要件定義とテストの両方に業務の幅を広げる余力が生まれ、職種の統合が現実的になりました。ただし、異なる規模のチームがこのような組織変更を取り入れるための条件やコストについては、現時点では十分な根拠がありません。小規模チームにはもともと適している可能性がありますが、大規模な組織では責任範囲、評価、協業の方法を体系的に変える必要があり、単純にそのまま取り入れることはできません。
ボトルネック 5:価値レビューと概念辞書/SDD
概念やデータの定義が揃っていなければ、AI がコードを書くのが速いほど、誤りが広がるのも速くなります。同じ業務用語がモジュールごとに異なる意味で使われたり、インターフェースのフィールドの定義が一致していなかったりすると、結合テストや受け入れの段階で問題が一気に表面化します。資料で紹介されているのは、まず価値レビューを行い、次に概念辞書と SDD(仕様駆動開発)で概念とデータの定義を揃えてから、コードを書くという方法です。
価値レビューは「それをやる価値があるか」に答え、概念辞書と SDD は「私たちは同じことについて話しているか」に答えます。この2つのステップは初期コストを増やすように見えますが、AI に明確で一貫したコンテキストを与えることで、生成されるコードが最初から意図に沿いやすくなります。
5つのボトルネックと対応策
| ボトルネック | 典型的な症状 | 推奨アクション | 観察指標 |
|---|---|---|---|
| 中核メンバーによるレビューの順番待ち | PRの待ち時間が長くなり、中核メンバーに負荷が集中する | レビューをレベル分けし、規約チェックを自動化する | PRの平均待ち時間 |
| テストと可観測性の前倒し | 手戻りがテスト段階に集中する | テストケースと計測ポイントを早期に設計する | テスト段階での不具合による差し戻し回数 |
| Live Demoによる要件確認 | 受け入れ時に「欲しかったものと違う」と判明する | 動作するプロトタイプで要件を確認する | 要件変更と手戻りの回数 |
| 役割の集約 | 引き継ぎや待ち時間が多く、コンテキストが失われる | 引き継ぎ箇所を減らし、1人が担当する工程を広げる | 工程間の引き継ぎ回数 |
| 価値レビューと概念辞書/SDD | 結合テスト時に認識が食い違う | コーディング前に概念とデータの認識を合わせる | 結合テスト段階の問題件数 |
チームのセルフチェック:開発・提供にかかる時間とコード生成速度向上の効果をどう分解するか
7%か3%-5%かを議論するよりも、自分たちのチームの数字を計算してみましょう。以下はすぐに実践できる分解方法です。まずは小さなプロジェクトを選んで試してみてください。
- 工程を分ける:要件の提起からリリースまでを、要件、設計、コーディング、レビュー、テスト、結合テスト、リリース、受け入れに分け、それぞれの実作業時間と待ち時間を記録します。
- コーディングの割合を計算する:コーディング工程の所要時間を開発・提供の総時間で割り、
xを求めます。この数字が思ったより小さいと気づくチームも多いでしょう。 - 待ち時間と手戻りを見つける:レビューの順番待ち時間、テストでの手戻り回数、要件変更回数を個別に集計します。これらは多くの場合、見落とされがちな時間の大きな原因です。
- 成果物と価値を区別する:「コードの生産」と「提供可能な価値」を分けて考えます。コード生成速度やコミット行数は前者、リリースした機能数や提供までの期間は後者にあたります。
- 小規模に比較する:小さなプロジェクトで導入前後を比較します。コード生成速度のレポートだけを見て判断しないようにしましょう。
- 最大のボトルネックから改善する:最も時間がかかっている工程を優先して対処します。すべてのツール導入やプロセス改善を同時に進める必要はありません。
以下は、記入方法を示すための仮定に基づく所要時間の分解テンプレートです。特定のチームの実データではありません。自分たちのデータを入れて、コーディング工程の割合が実際にどの程度か確かめてみましょう。
| 開発・提供の工程 | 割合の例(仮定) | 主な時間のかかる作業 | AIプログラミングで直接加速できるか |
|---|---|---|---|
| 要件と価値のレビュー | 15% | 繰り返しのコミュニケーション、認識合わせ | 間接的に可能(Live Demo) |
| 設計 | 10% | 方案の議論、レビュー | 一部可能 |
| コーディング | 15% | コード作成、デバッグ | 直接可能 |
| レビュー | 15% | 順番待ち、審査 | 一部可能(レビュー支援) |
| テストと結合テスト | 25% | テストケースの実行、手戻り | 一部可能(テストケース生成) |
| リリースと受け入れ | 20% | 承認、受け入れフィードバック | ほとんど不可能 |
このテンプレートの目的は、時間の内訳を明らかにすることです。コーディングの割合が十数パーセントしかなければ、コード生成速度がさらに倍増しても、端から端までの全体的な効果は限定的です。本当の効率化の余地は、レビュー、テスト、要件の各工程にあります。
Coding Agent の接続と使用量の把握:APIYI でできること、できないこと
AIコーディングツールを導入するうえで、接続とコストの把握は避けて通れません。APIYI apiyi.com は Cursor や Cline などのコーディングツールとの接続に対応し、OpenAI 互換の統一インターフェースを提供しています。1つのAPIキーで OpenAI、Claude、Gemini などの主要モデルを呼び出せます。ツールの base_url に https://api.apiyi.com/v1 を設定するだけで接続できます。
開発生産性を担当するチームにとって、さらに役立つのが使用量データです。コンソールの使用量統計では、Coding Agent のトークン消費量やモデルごとの呼び出し状況を確認できます。どのタスクには高性能なモデルが適しているか、どのタスクなら軽量モデルで十分かを判断する材料になります。これらのデータを前述のデリバリー所要時間の内訳とあわせて見ることで、AIコーディングへの投資と成果の関係を評価できます。
💡 接続のヒント:チームで複数のコーディングモデルを評価している場合は、APIYI apiyi.com を通じて一元的に接続し、使用量を比較できます。新規ユーザーには無料のテスト枠があるため、まずは小規模なプロジェクトで比較してみるのがおすすめです。具体的な料金と利用可能なモデルは、コンソールとドキュメントをご確認ください。
ただし、明確にしておきたいのは、ゲートウェイそのものがエンドツーエンドのデリバリー効率を高めるわけではないという点です。ゲートウェイが解決するのは、接続の手間、モデルの切り替え、使用量の可視化です。レビュー待ち、テストの手戻り、要件のずれといったプロセス上のボトルネックは、組織側で解決する必要があります。ゲートウェイを効率化の解決策と考えるのは、コード生成率をデリバリーの指標とみなすのと同じ種類の誤りです。
よくある質問 FAQ
Q1:コード生成率が 30% を超えているのに、エンドツーエンドのデリバリーはなぜ約 7% しか速くならないのですか?
コード生成率が影響するのは、コーディング工程だけだからです。エンドツーエンドの効率改善の上限はおよそ `x × (1 – 1/k)` で表されます。コーディングの占める割合 `x` がもともと低ければ、改善効果にも上限があります。なお、7% は特定のチームの所要時間の内訳に基づく推計であり、普遍的な結論ではありません。自分たちのチームのデータを使って計算し直す必要があります。
Q2:3%-5% と 2-3 倍という数字は信頼できますか?
どちらも慎重に捉える必要があります。エンドツーエンドの効率が 3%-5% 改善したという話は業界内の情報交換に基づくもので、検証可能なサンプルがありません。有効なコードのスループットが 2-3 倍になったという数字はチームの振り返りに基づいていますが、集計基準や比較方法は公開されていません。参考にはなりますが、意思決定の直接的な根拠には適していません。
Q3:5 つのボトルネックのうち、どれから解決すべきですか?
まずは自分たちのデリバリーにかかる時間を工程ごとに分け、最も割合の大きい工程から対処しましょう。レビュー待ちやテストの手戻りが大部分を占めるチームもあれば、要件変更が最も深刻なチームもあります。すべての改善を同時に進めるのではなく、最大のボトルネックを一つずつ解消するほうが、効果を観察しやすくなります。
Q4:チームの Coding Agent におけるモデルの使用量とコストは、どう確認できますか?
プログラミングツールの接続先を同じ API エンドポイントに統一し、コンソールで token の消費量やモデルの利用状況を確認する方法があります。例えば、APIYI apiyi.com を通じて Cursor や Cline などのツールを接続すれば、使用量データを一元的に確認できます。ただし、使用量の把握は意思決定を補助するものです。プロセスのボトルネックは、引き続き組織側で解決する必要があります。
Q5:職種の統合はすべてのチームに適していますか?
必ずしもそうではありません。PDFE や ABE などの役割を統合する考え方は、引き継ぎを減らすことが目的です。ただし、規模の異なるチームが同じ変更を導入するための条件やコストについては、十分な根拠がありません。まずは一つのグループで試行し、引き継ぎ回数やデリバリー期間の変化を見てから、展開するかどうかを決めることをおすすめします。
コード生成率とエンドツーエンドのデリバリー:重要ポイント Key Takeaways
- コード生成率はデリバリー速度と同じではない:コーディング工程の成果を示すだけで、エンドツーエンドでの効率化を意味するものではありません。
- 7%は計算式からの推計値:
x × (1 - 1/k)で求められ、コーディング工程の割合によって改善効果の上限が決まります。 - 数値の前提を区別する:7%は特定のチームに基づく推計、3%〜5%は意見交換から得られた数値で、2〜3倍の算出条件は公開されていません。
- ボトルネックはコーディング以外にある:レビュー、テスト、要件確認、引き継ぎ、概念のすり合わせに多くの時間がかかります。
- まず所要時間を分解し、それからプロセスを改善する:小規模プロジェクトで前後を比較し、最も大きなボトルネックから一つずつ解消します。
- ツールは接続と可視化を担う:APIYI apiyi.com ではCoding Agentへの接続を一元化し、使用量を確認できますが、プロセス上の問題は解決できません。
まとめ:コード生成率が30%を超えた後、チームは何をすべきか
コード生成率が30%を超えたことは確かな進歩ですが、あくまで出発点です。エンドツーエンドのデリバリーは一連の工程全体で決まり、コーディングはその一部にすぎません。x × (1 - 1/k) という式は、部分的な高速化による効果の上限を明確に示しています。7%という数字が重要なのは、その正確さ以上に、「どれだけコードを書いたか」から「どれだけの価値を届けたか」へと目を向けるきっかけになるからです。
本当の効率化の余地は、レビュー体制、テストと可観測性のシフトレフト、Live Demoを使った要件確認、役割の集約、そして価値の評価と概念のすり合わせにあります。これらはすべて組織やプロセスに関わる取り組みであり、ツールで代替することはできません。ツール面では、APIYI apiyi.com を通じてコーディングモデルへの接続を一元化し、使用量を確認することをおすすめします。使用量データとデリバリーにかかった時間を合わせて、投資対効果を評価しましょう。
チームのセルフチェックリスト
- [ ] 要件の提起からリリースまでの所要時間を工程ごとに分解しましたか?
- [ ] デリバリー全体の時間に占めるコーディング工程の割合
xを算出しましたか? - [ ] レビューの待ち時間と中核メンバーの負荷を個別に集計しましたか?
- [ ] テストケース、計測ポイント、アラートをコーディング前またはコーディング中に設計していますか?
- [ ] 要件確認には文書だけでなく、動作するデモを使っていますか?
- [ ] 一つの要件が提起されてからリリースされるまでに、役割間の引き継ぎは何回ありますか?
- [ ] コーディング前に、主要な概念やデータの定義をすり合わせていますか(概念辞書/SDD)?
- [ ] 報告する指標は「コードの生産量」と「提供可能な価値」を区別していますか?
- [ ] コード生成率のレポートを見るだけでなく、小規模プロジェクトで改善前後を比較しましたか?
- [ ] すべてのツールを同時に導入するのではなく、最大のボトルネックを一つ選んで優先的に改善していますか?
参考資料
- コード生成率とエンドツーエンドのデリバリーに関する業界資料:本記事の7%の推計、五つのボトルネック、数値の前提に関する出典
- 注:資料は途中で切れているため、本記事は確認できる部分のみを基にまとめています。表示されていない内容は根拠としていません
- APIYI ドキュメントセンター:コーディングツールの接続と使用量の集計に関する説明
- リンク:
docs.apiyi.com - 注:価格とモデルの利用可否はコンソールとドキュメントをご確認ください
著者:APIYI 技術チーム
技術交流:お問い合わせは APIYI apiyi.com のトップページからどうぞ。接続に関する詳細資料は docs.apiyi.com のドキュメントセンターをご覧ください


