
Catatan penulis: Artikel ini membahas 2.8T parameter, 104B parameter aktif, kuantisasi MXFP4, dan konteks 1M pada Kimi K3.1 Pro. Kita akan memperkirakan ukuran bobot dan kebutuhan perangkat keras, membandingkannya dengan harga API $2/$10, serta menyediakan tabel keputusan dan daftar periksa untuk memilih antara deployment mandiri dan API.
Kesimpulannya: Kimi K3.1 Pro adalah model MoE dengan total 2.8T parameter yang tidak bisa dijalankan di satu mesin. Berdasarkan estimasi MXFP4, bobotnya saja berukuran dalam hitungan TB dan tidak muat di server satu node dengan 8 GPU yang umum digunakan. Deployment setidaknya membutuhkan banyak GPU di beberapa node, serta ruang memori GPU untuk KV Cache pada konteks 1M. Bobot terbuka menjawab pertanyaan “apakah modelnya bisa didapatkan”, tetapi tidak menurunkan kebutuhan untuk menjalankannya dengan baik.
Jadi, bagi sebagian besar tim teknis, memulai dengan pemanggilan API seharga $2/$10 lebih realistis. Deployment mandiri baru layak dipertimbangkan secara serius jika ketiga syarat ini terpenuhi sekaligus: volume pemanggilan besar dan stabil, data harus tetap berada di pusat data sendiri, dan tim memiliki kemampuan mengoperasikan klaster GPU. Artikel ini tidak akan mengulang skor benchmark. Kita akan menghitung kebutuhan bobot dan perangkat keras, lalu membahas utilisasi dan operasional, sebelum memberikan rekomendasi berdasarkan jenis tim. Jika hanya ingin menguji hasilnya terlebih dahulu, Anda bisa menggunakan satu Key dari platform agregasi seperti APIYI apiyi.com, lalu menentukan langkah selanjutnya.
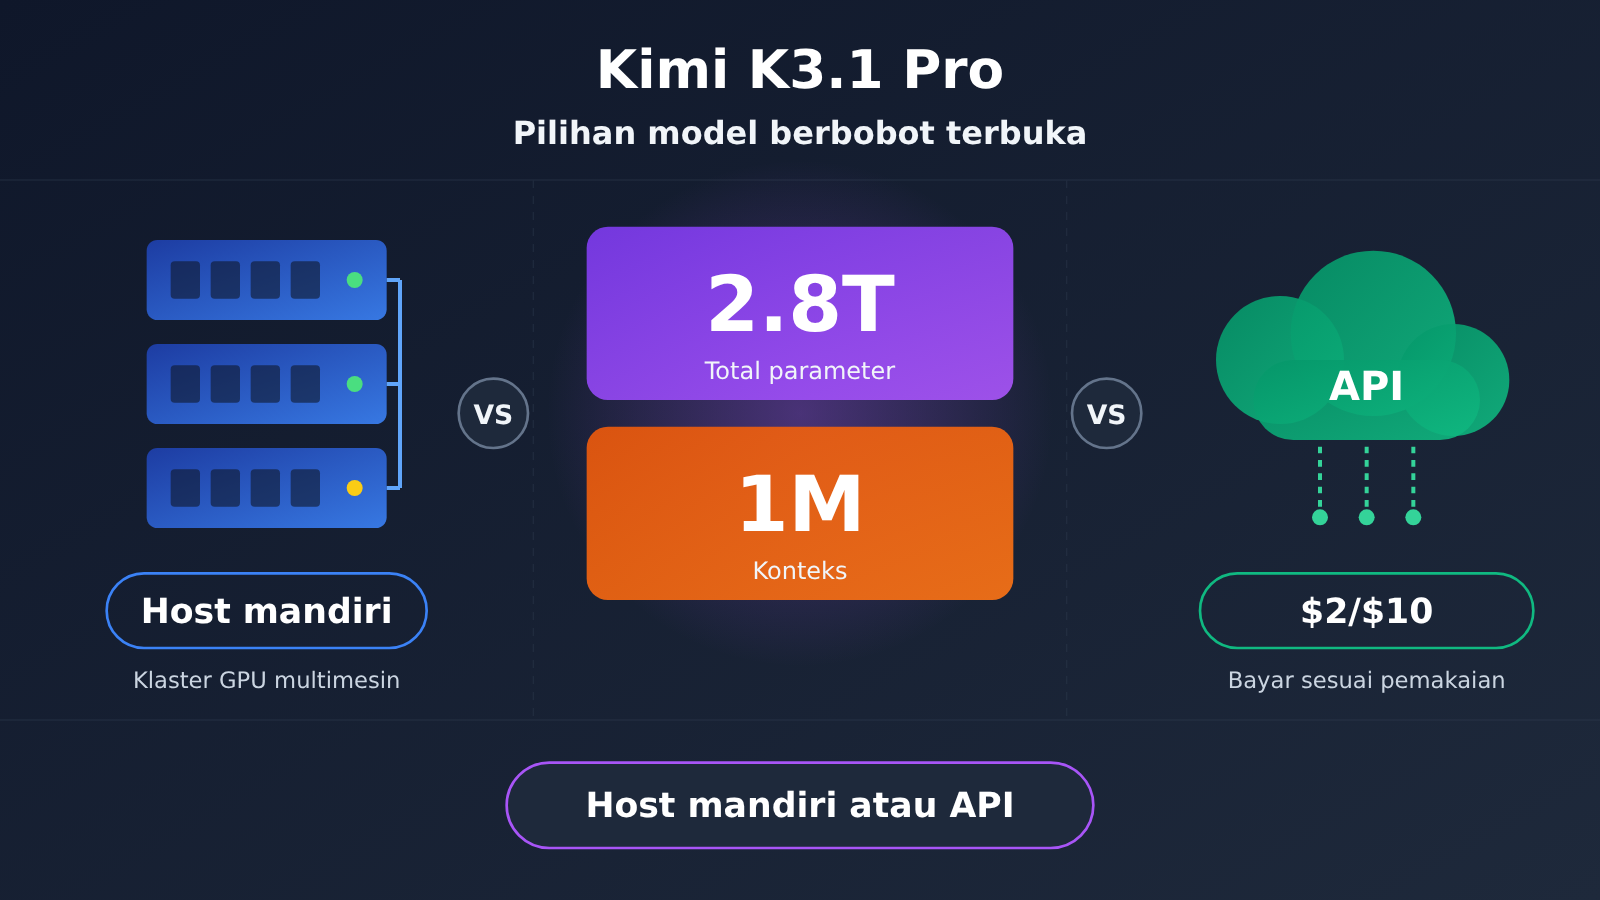
Spesifikasi Kimi K3.1 Pro: Apa Arti 2.8T Parameter dan Konteks 1M?
Kimi K3.1 Pro adalah model pertama dalam seri K3.1 dan dirilis dengan bobot terbuka. Model ini menggunakan arsitektur MoE (Mixture of Experts), dengan total 2.8T parameter dan sekitar 104B parameter yang aktif untuk setiap token. Sederhananya, kebutuhan penyimpanan dihitung berdasarkan 2.8T parameter, sementara biaya komputasinya lebih mendekati model padat dengan 104B parameter. Inilah dilema umum saat menerapkan MoE sendiri: kebutuhan komputasinya tidak terlalu besar, tetapi kebutuhan VRAM-nya sulit ditekan.
Hal penting lainnya adalah pelatihan sadar kuantisasi (QAT). Kimi menggunakan kombinasi bobot MXFP4 dan aktivasi MXFP8, dengan kuantisasi yang sudah diperhitungkan sejak tahap pelatihan. Artinya, operasi berpresisi rendah merupakan “bentuk asli” model, bukan versi yang dikompresi belakangan. Secara teori, penurunan akurasinya pun lebih terkendali. Namun, perangkat keras dan mesin inferensi harus mampu mendukung format mikroskala seri MX secara efisien.
| Spesifikasi | Parameter Kimi K3.1 Pro | Artinya untuk pemilihan model |
|---|---|---|
| Arsitektur | MoE, 93 lapisan | Penyimpanan dihitung berdasarkan total parameter, komputasi berdasarkan parameter aktif |
| Total parameter | 2.8T | Menentukan ukuran bobot dan kebutuhan minimum VRAM |
| Parameter aktif | 104B | Menentukan jumlah komputasi per token |
| Encoder visual | MoonViT-V2, 401M parameter | Multimodal bawaan, memahami gambar tanpa komponen tambahan |
| Metode kuantisasi | Bobot MXFP4 / aktivasi MXFP8, QAT | Presisi rendah merupakan bentuk asli model, bergantung pada dukungan perangkat keras |
| Konteks | 1M token | Cocok untuk dokumen panjang dan repositori besar, tetapi membebani KV Cache |
| Skenario penggunaan | Pemrograman, kreasi 3D, riset keuangan, Agent | Berfokus pada tugas kompleks dan rangkaian pemanggilan yang panjang |
Konteks 1M dan kemampuan multimodal Kimi K3.1 Pro
Jendela konteks 1M token cukup untuk memuat repositori kode berukuran sedang, satu set lengkap laporan keuangan, atau materi riset yang panjang sekaligus. Kemampuan ini sesuai untuk kebutuhan Agent dan riset keuangan. Dukungan multimodal bawaan juga memungkinkan model membaca gambar, tangkapan layar, dan grafik secara langsung, sehingga lebih praktis untuk tugas kreasi 3D dan pemrograman.
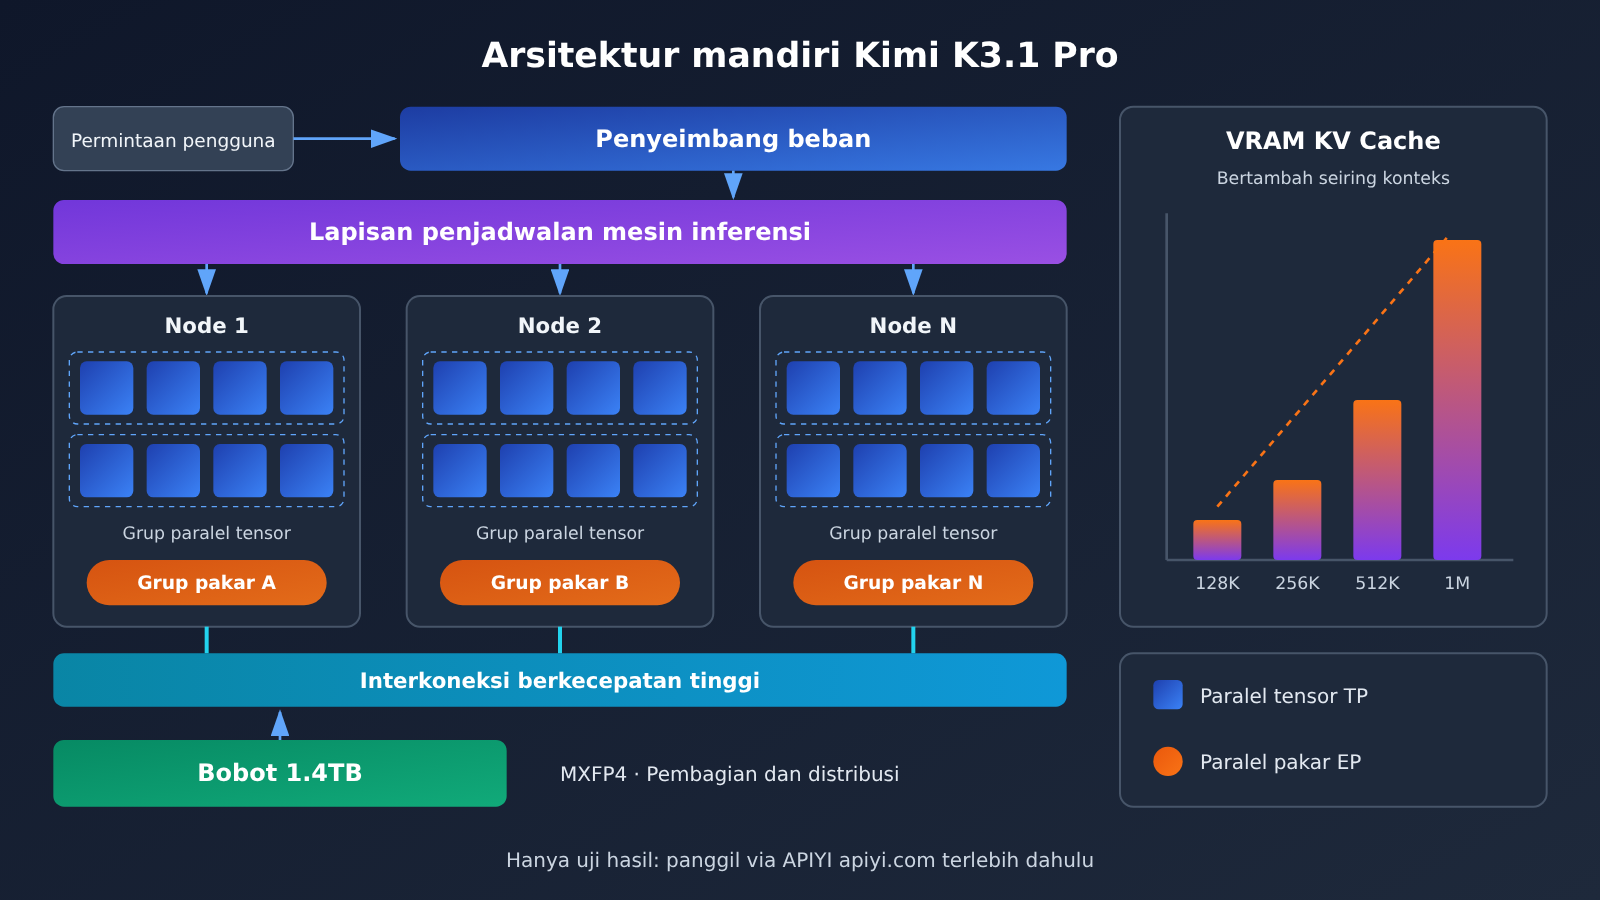
Namun, kedua kemampuan ini memiliki konsekuensi saat model diterapkan sendiri. Konteks yang panjang membuat KV Cache bertambah secara linear mengikuti panjang urutan. Saat benar-benar menggunakan 1M token penuh, kebutuhan VRAM bisa sangat besar. Encoder visualnya sendiri tidak besar, tetapi prapemrosesan input multimodal dan penjadwalan batch membuat layanan inferensi lebih rumit. Jika menggunakan API, semua itu ditangani oleh penyedia layanan dan Anda hanya membayar berdasarkan token.
Ukuran Bobot dan Kebutuhan Perangkat Keras Kimi K3.1 Pro
Estimasi Ukuran Bobot Kimi K3.1 Pro
Perlu dicatat: ukuran berikut diperkirakan berdasarkan jumlah parameter; ukuran file sebenarnya mengikuti rilis resmi. MXFP4 membutuhkan sekitar 4 bit atau 0,5 byte per parameter, sehingga 2.8T parameter setara dengan sekitar 1,4TB. Format MX juga memerlukan penyimpanan tambahan untuk faktor penskalaan per blok. Ditambah lagi, beberapa bagian seperti encoder visual dan lapisan embedding mungkin tetap menggunakan presisi lebih tinggi, sehingga ukuran file biasanya sedikit lebih besar dari hasil perhitungan tersebut.
| Asumsi presisi | Byte per parameter | Estimasi ukuran bobot 2.8T | Keterangan |
|---|---|---|---|
| MXFP4 | Sekitar 0,5 byte | Sekitar 1,4TB | Format utama yang direkomendasikan secara resmi, belum termasuk kebutuhan penyimpanan faktor penskalaan |
| Tingkat 8 bit | Sekitar 1 byte | Sekitar 2,8TB | Hanya sebagai perbandingan, bukan rekomendasi resmi |
| BF16 | 2 byte | Sekitar 5,6TB | Hanya sebagai perbandingan untuk menunjukkan manfaat QAT |
Tabel ini menunjukkan bahwa bahkan dengan MXFP4 yang paling hemat, ukuran bobot sudah mencapai skala TB. Mengunduh, memverifikasi, dan mendistribusikannya ke beberapa mesin saja sudah menjadi pekerjaan tersendiri. Kapasitas penyimpanan dan bandwidth jaringan internal pun perlu direncanakan sejak awal.
Kebutuhan Perangkat Keras untuk Deployment Mandiri Kimi K3.1 Pro
Dengan perkiraan kasar 1,4TB, dibutuhkan hampir 18 kartu akselerator dengan VRAM 80GB hanya untuk menampung bobot. Itu belum termasuk kebutuhan KV Cache, nilai aktivasi, dan operasional mesin inferensi. Server 8 kartu biasa jelas tidak cukup. Bahkan dengan kartu generasi baru yang memiliki VRAM lebih besar per kartu, satu node hanya akan mampu menampung bobot dengan sedikit ruang tersisa, sehingga sulit menyediakan kapasitas untuk konteks panjang. Karena itu, solusi yang realistis pada dasarnya memerlukan banyak kartu dan banyak mesin, dengan membagi model menggunakan kombinasi paralelisme tensor, paralelisme ahli, dan paralelisme pipeline.
Selain perangkat keras, ada beberapa jenis biaya yang mudah diremehkan:
- Mesin inferensi dan strategi paralelisme: Diperlukan framework inferensi yang mendukung paralelisme ahli MoE dan format MX. Rekomendasi mesin dan konfigurasi paralelisme mengikuti dokumentasi deployment resmi.
- Interkoneksi antarnode: Paralelisme ahli menghasilkan banyak komunikasi lintas node. Bandwidth dan latensi jaringan langsung memengaruhi throughput.
- Pusat data dan listrik: Pasokan listrik, pendinginan, dan ruang rak untuk klaster GPU multim mesin perlu disiapkan sejak awal.
- Kapasitas saat beban puncak: Beban puncak membutuhkan kapasitas cadangan tambahan, sementara pada periode sepi kapasitas komputasi tersebut menjadi biaya menganggur.
- Tenaga operasional: Peningkatan versi model, penelusuran masalah, pemantauan, dan peringatan membutuhkan keterlibatan jangka panjang dari engineer yang memahami klaster GPU.
Perlu ditekankan bahwa materi referensi tidak memuat data resmi tentang throughput dan biaya berdasarkan pengujian nyata. Karena itu, artikel ini juga tidak memberikan estimasi biaya pasti untuk deployment mandiri. Jika ingin memulai proyek, gunakan dokumentasi deployment resmi dan hasil uji beban Anda sendiri sebagai acuan.
Lisensi Kimi K3.1 Pro: Bobot terbuka bukan berarti bebas digunakan secara komersial
“Bobot terbuka” dan “open source yang bebas digunakan secara komersial” adalah dua hal berbeda. Pastikan hal ini sejak tahap pemilihan model. Lisensi banyak model berbobot terbuka menetapkan syarat penggunaan komersial, seperti batas pendapatan atau jumlah pengguna, serta kewajiban mencantumkan sumber dalam produk. Untuk syarat komersial, batas pendapatan, dan kewajiban pemberitahuan Kimi K3.1 Pro, selalu rujuk teks lisensi resmi.
Selain penggunaan komersial langsung, beberapa aktivitas lain mungkin memiliki persyaratan tambahan:
- Distribusi: Memberikan bobot atau versi turunannya kepada pihak ketiga.
- Modifikasi: Ketentuan lisensi untuk model hasil fine-tuning, distilasi, atau penggabungan.
- Layanan hosting: Menyediakan model yang di-deploy sendiri sebagai API untuk pihak luar sering menjadi salah satu skenario yang diatur secara khusus oleh lisensi.
Sebaiknya tim hukum dan penanggung jawab teknis meninjau lisensi bersama, lalu membuat kesimpulan tertulis sebelum membeli perangkat keras. Saat memanggil model melalui API resmi atau platform pihak ketiga, ketentuan yang berlaku terutama adalah persyaratan layanan. Biasanya tidak ada persoalan distribusi bobot, tetapi penggunaan data dan cakupan penggunaan tetap perlu diperiksa kepatuhannya.
Harga API Kimi K3.1 Pro: Cara menghitung $2/$10
ID model untuk API resmi adalah kimi-k3.1-pro. API ini menyediakan antarmuka yang kompatibel dengan OpenAI dan Anthropic, sehingga perubahan pada proyek yang sudah ada relatif sedikit. Harga dihitung per satu juta token:
| Komponen biaya | Versi standar kimi-k3.1-pro |
Versi Highspeed | Keterangan |
|---|---|---|---|
| Input | $2 |
$4 |
Per satu juta token |
| Output | $10 |
$20 |
Per satu juta token |
| Cache hit | $0.20 |
Lihat ketentuan resmi | Prefiks berulang dapat menekan biaya secara signifikan |
| Penulisan cache | $2 |
Lihat ketentuan resmi | Sama dengan harga input standar |
| Kecepatan | Acuan | Sekitar 3 kali lipat | Pilihan untuk skenario yang sensitif terhadap latensi |
Berikut contoh perhitungan untuk memudahkan pemahaman (bukan hasil pengujian, hanya konversi harga): misalkan penggunaan per bulan adalah 100 juta token input dan 20 juta token output. Biaya versi standar sekitar 100 × $2 + 20 × $10 = $400. Jika 70% input terkena cache hit, biaya input menjadi 70 × $0.20 + 30 × $2 = $74, sehingga total biaya turun menjadi sekitar $274. Untuk versi Highspeed, penggunaan yang sama tanpa memperhitungkan cache menelan biaya sekitar $800.
Perkiraan ini cukup menggambarkan perbedaannya: meskipun penggunaan mencapai ratusan juta token per bulan, tagihan API masih jauh lebih rendah daripada gabungan biaya penyusutan bulanan, listrik, dan tenaga kerja untuk klaster GPU multi-mesin. Dalam skenario agent, petunjuk sistem dan definisi tool sering kali berulang. Memanfaatkan harga cache hit adalah cara paling langsung untuk menekan biaya saat menggunakan API.
Untuk integrasi, selama klien mendukung protokol yang kompatibel dengan OpenAI, cukup ganti base_url menjadi https://api.apiyi.com/v1 dan isi nama model dengan ID model yang disediakan platform. Tidak perlu menulis lapisan adaptasi tambahan.
🚀 Mulai cepat: Jika tim ingin membandingkan performa Kimi, Claude, GPT, dan Gemini pada tugas yang sama, gunakan satu kunci API melalui APIYI apiyi.com untuk memanggil semuanya, lalu lihat daftar model, penggunaan, dan log di konsol. Untuk ketersediaan
kimi-k3.1-prodan harga pastinya, periksa informasi terbaru di konsol.
Perbedaan utama antara deployment mandiri Kimi K3.1 Pro dan API
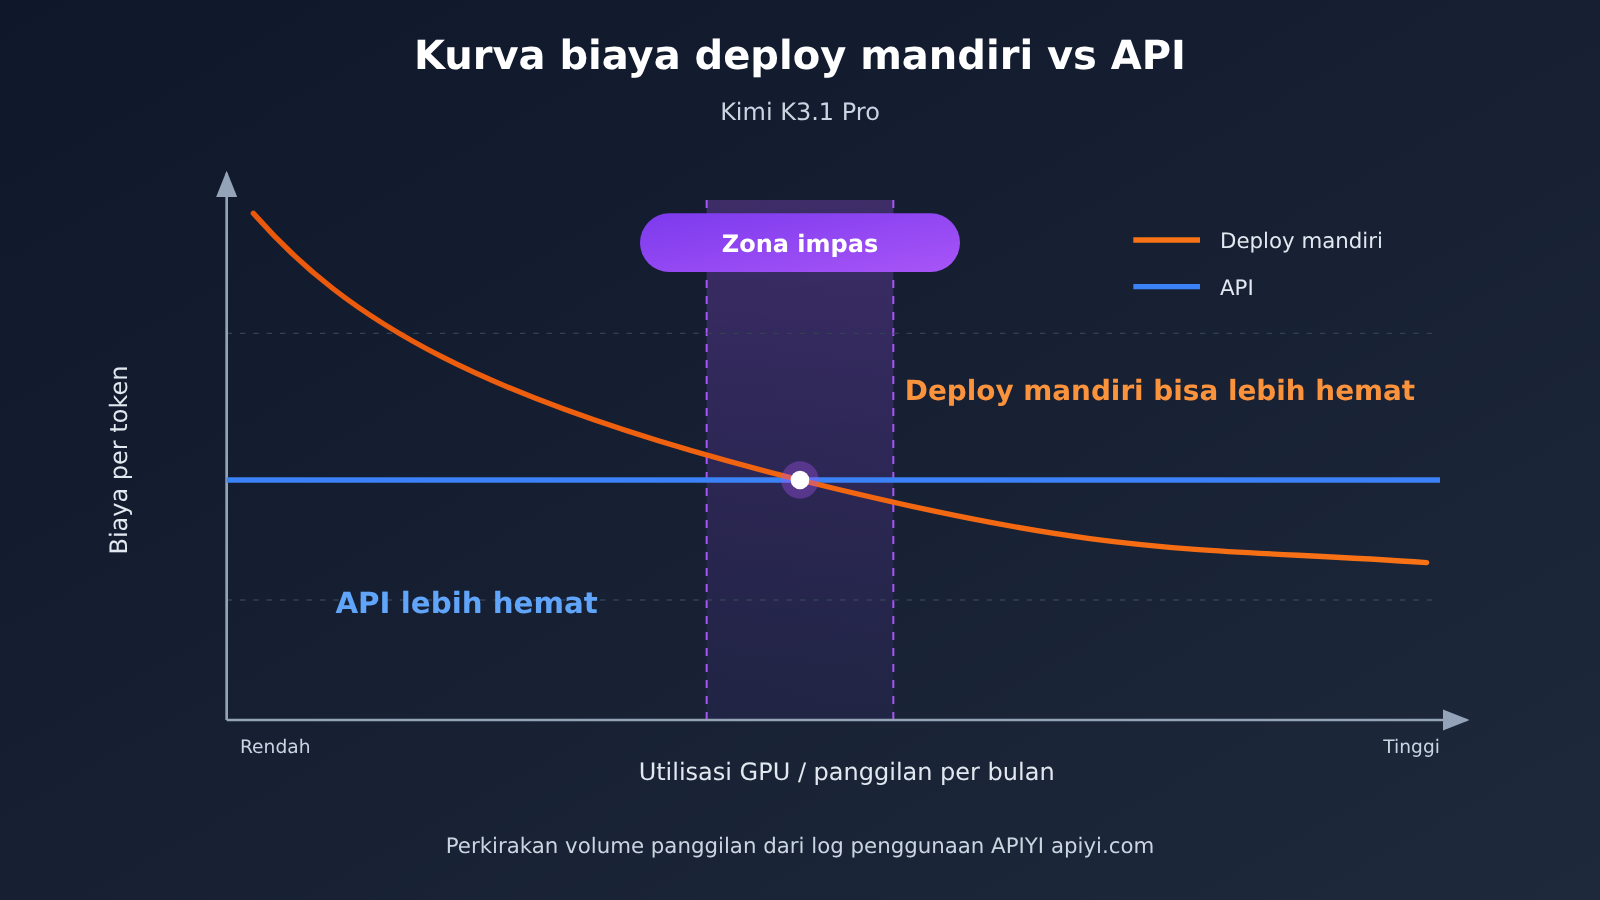
Perbedaan mendasar antara deployment mandiri dan API terletak pada struktur biayanya. API sepenuhnya menggunakan biaya variabel: bayar sesuai pemakaian, dan tidak ada biaya saat tidak digunakan. Deployment mandiri membutuhkan biaya tetap yang tinggi, tetapi biaya marginalnya rendah. Setelah investasi pada perangkat keras, ruang server, dan tenaga kerja dilakukan, biaya tetap berjalan meskipun kapasitas tidak terpakai penuh. Karena itu, variabel penentunya adalah tingkat utilisasi: biaya per token setelah biaya tetap dialokasikan baru berpotensi lebih rendah daripada harga API jika klaster terus berjalan dengan beban tinggi dalam jangka panjang.
| Dimensi keputusan | Deployment mandiri Kimi K3.1 Pro | Menggunakan API | Pilihan yang lebih sesuai |
|---|---|---|---|
| Tingkat utilisasi | Perlu beban tinggi dalam jangka panjang untuk mengalokasikan biaya | Bayar sesuai pemakaian, tanpa pemborosan akibat kapasitas menganggur | API untuk penggunaan rendah hingga sedang |
| Kepatuhan data | Data dapat sepenuhnya tetap berada di lingkungan sendiri | Data harus dikirim ke penyedia layanan | Deployment mandiri untuk regulasi ketat |
| Investasi awal | Besar: beberapa mesin GPU, ruang server, dan jaringan | Hampir nol | API |
| Biaya operasional | Membutuhkan tim khusus untuk mengelola klaster GPU | Ditanggung penyedia layanan | API |
| Elastisitas saat beban puncak | Perlu menyediakan kapasitas cadangan; penambahan kapasitas lambat | Lebih elastis, tetapi dibatasi oleh limit laju | API |
| Kemampuan kustomisasi | Dapat melakukan fine-tuning dan mengubah konfigurasi inferensi | Terbatas pada parameter antarmuka | Deployment mandiri untuk kustomisasi mendalam |
| Kecepatan peluncuran | Hitungan minggu hingga bulan | Hitungan jam | API |
| Saluran akses | Membangun layanan inferensi sendiri | API resmi, platform seperti APIYI apiyi.com | Bergantung pada kebutuhan |
Analisis perbandingan API: API unggul dalam kecepatan peluncuran, elastisitas, dan total biaya kepemilikan. Namun, data harus dikirim ke luar lingkungan sendiri dan parameter antarmuka yang dapat disesuaikan terbatas. Sebaliknya, deployment mandiri lebih unggul dalam kontrol data dan kustomisasi mendalam, sehingga lebih cocok untuk tim yang menghadapi regulasi ketat dan memiliki volume pemanggilan sangat besar.
Analisis perbandingan deployment mandiri: Deployment mandiri berpotensi menawarkan biaya per unit yang lebih terkendali serta kontrol yang lebih besar. Namun, investasi awal, kebutuhan tenaga operasional, dan risiko kapasitas menganggur juga tinggi. Untuk penggunaan dengan volume yang berfluktuasi atau tim tanpa keahlian GPU, API tetap menjadi pilihan yang lebih aman.
Rekomendasi Penggunaan dan Keputusan untuk Kimi K3.1 Pro
Tim yang Cocok Menggunakan API Kimi K3.1 Pro
- Startup dan tim kecil hingga menengah: Tidak memiliki klaster GPU atau tim operasional khusus, sehingga API menjadi satu-satunya pilihan yang masuk akal.
- Bisnis dengan volume pemanggilan yang fluktuatif: Beban tinggi pada siang hari, rendah pada malam hari, atau melonjak saat ada kampanye. Pembayaran berdasarkan pemakaian membantu menghindari kapasitas yang menganggur.
- Proyek yang perlu segera diluncurkan: Kecepatan adalah prioritas saat memvalidasi produk, dan integrasi bisa selesai dalam beberapa jam.
- Evaluasi beberapa model secara bersamaan: Untuk membandingkan model pada tugas yang sama, antarmuka terpadu jauh lebih praktis daripada men-deploy masing-masing model.
Tim yang Cocok Melakukan Deployment Mandiri Kimi K3.1 Pro
- Data tidak boleh keluar dari lingkungan internal: Dalam sektor keuangan, kesehatan, pemerintahan, dan perusahaan, aturan kepatuhan dapat mewajibkan seluruh data tetap berada di jaringan internal.
- Pemanggilan yang sering dan stabil: Beban tinggi berlangsung 24 jam sehari, 7 hari seminggu, dengan tingkat pemanfaatan yang bisa terus dipertahankan.
- Sudah memiliki klaster GPU dan tim operasional: Investasi tambahan lebih terkendali, dan model dapat dimasukkan ke infrastruktur yang sudah ada.
- Membutuhkan kustomisasi mendalam: Perlu melakukan fine-tuning berdasarkan bobot terbuka atau optimasi inferensi khusus, selama diizinkan oleh lisensi.
Pendekatan Hibrida
Ada juga pendekatan yang sering terlewat: gunakan API untuk membuat prototipe, lalu pertimbangkan deployment mandiri untuk produksi. Bisa juga sebaliknya: proses data inti yang sensitif melalui deployment mandiri, sementara lalu lintas umum melalui API. Pendekatan pertama menggantikan perkiraan kasar dengan data pemanggilan nyata, sedangkan pendekatan kedua menyeimbangkan kepatuhan dan fleksibilitas.
💡 Saran: Sebelum berinvestasi dalam perangkat keras, coba jalankan lalu lintas bisnis nyata melalui APIYI apiyi.com selama beberapa waktu. Gunakan log pemakaian di konsol untuk menghitung jumlah token harian, rasio beban puncak terhadap beban terendah, dan tingkat keberhasilan cache. Data ini menjadi dasar paling andal untuk menilai apakah deployment mandiri sepadan.
Pertanyaan Umum FAQ
Q1: Bisakah Kimi K3.1 Pro di-deploy sendiri pada satu server?
Dengan format MXFP4, bobot model diperkirakan mencapai 1.4TB, sehingga tidak muat di server biasa dengan 8 kartu GPU. Bahkan pada node dengan VRAM per kartu yang lebih besar, sulit menyisakan ruang untuk KV Cache dengan konteks 1M. Cara yang lebih realistis adalah deployment menggunakan beberapa GPU di beberapa server. Untuk konfigurasi spesifik, rujuk dokumentasi deployment resmi.
Q2: Apakah 104B parameter aktif berarti kebutuhan perangkat keras hanya dihitung berdasarkan 104B?
Tidak. Parameter aktif menentukan jumlah komputasi per token, tetapi bobot semua expert harus tetap dimuat di VRAM. Jadi, kebutuhan VRAM tetap dihitung berdasarkan total 2.8T parameter. Inilah ciri model MoE: “komputasinya cepat, tetapi membutuhkan ruang penyimpanan besar”.
Q3: Apakah bobot terbuka berarti model bisa langsung digunakan untuk keperluan komersial?
Belum tentu. Bobot terbuka tidak berarti penggunaan komersial diizinkan tanpa syarat. Batas pendapatan, kewajiban pemberitahuan, dan pembatasan layanan hosting harus mengacu pada teks lisensi resmi. Sebaiknya minta tim hukum untuk memastikannya sebelum membeli perangkat keras.
Q4: Bagaimana cara mencoba API Kimi K3.1 Pro dengan biaya rendah?
Anda bisa mendaftar di APIYI apiyi.com dan menggunakan kuota uji coba gratis untuk pengguna baru. Integrasikan ke proyek yang sudah ada melalui antarmuka yang kompatibel dengan OpenAI. Satu kunci API di platform ini dapat digunakan untuk memanggil model seri Kimi serta Claude, GPT, Gemini, dan lainnya. Ketersediaan serta harga `kimi-k3.1-pro` dapat dilihat di konsol.
Q5: Bagaimana memilih antara versi standar dan Highspeed?
Highspeed dibanderol `$4/$20`, dua kali harga versi standar, dengan kecepatan sekitar 3 kali lipat. Highspeed cocok untuk interaksi real-time dengan pengguna dan Agent yang sensitif terhadap latensi token pertama. Untuk pemrosesan batch offline dan tugas di latar belakang, versi standar dengan cache lebih hemat.
Kesimpulan: Checklist deployment mandiri vs API Kimi K3.1 Pro
Bobot terbuka Kimi K3.1 Pro adalah kabar baik karena memberi tim yang punya sumber daya opsi dengan kendali penuh. Namun, dengan 2,8T parameter, model ini tergolong model “sekelas klaster”. Tantangan deployment mandiri bukan sekadar mengunduh bobot, melainkan memperhitungkan perangkat keras, tingkat penggunaan, operasional, dan lisensi. Bagi sebagian besar tim, langkah paling rendah risiko adalah menjalankan bisnis terlebih dahulu dengan API $2/$10, lalu memakai data nyata untuk menilai apakah perlu melakukan deployment mandiri.
Poin utama Kimi K3.1 Pro
- Spesifikasi: 2,8T parameter total, 104B parameter aktif, 93 lapisan MoE, multimodal native, dan konteks 1M.
- Bobot: Diperkirakan sekitar 1,4TB dalam format MXFP4; ukuran sebenarnya mengacu pada berkas resmi. Tidak muat dalam satu mesin.
- Perangkat keras: Memerlukan deployment paralel di beberapa GPU dan mesin, serta cadangan memori GPU untuk KV Cache pada konteks panjang.
- Lisensi: Bobot terbuka bukan berarti bebas digunakan untuk keperluan komersial. Ketentuannya mengacu pada lisensi resmi.
- Harga: Versi standar
$2/$10, cache hit$0.20, dan Highspeed$4/$20. - Keputusan: Tingkat penggunaan adalah faktor utama. Untuk bisnis dengan frekuensi rendah hingga sedang atau permintaan yang sangat fluktuatif, prioritaskan API.
Checklist deployment mandiri vs API
| Aspek | Tanda sebaiknya memilih API | Tanda sebaiknya memilih deployment mandiri |
|---|---|---|
| Volume pemanggilan | Volume bulanan kecil atau berfluktuasi signifikan | Beban tinggi 7×24 dalam jangka panjang |
| Kepatuhan data | Data boleh dikirim ke penyedia layanan | Data harus tetap berada di jaringan internal |
| Kapabilitas GPU | Tidak punya klaster atau tim operasional khusus | Sudah punya klaster multimachine dan tim operasional |
| Lisensi | Tidak ingin menangani ketentuan distribusi dan hosting | Tim legal sudah memastikan ketentuan penggunaan komersial |
| Waktu peluncuran | Perlu segera diluncurkan untuk validasi | Dapat menerima proses deployment selama beberapa minggu hingga bulan |
| Data biaya | Belum punya statistik pemanggilan aktual | Sudah menghitung titik impas menggunakan data nyata |
Jika sebagian besar jawaban berada di kolom kiri, langsung gunakan API. Kami menyarankan penggunaan APIYI di apiyi.com untuk mengakses seri Kimi dan model populer lainnya dengan satu kunci API. Manfaatkan log penggunaan di konsol untuk mengumpulkan data nyata. Setelah volume pemanggilan dan kebutuhan kepatuhan memang menuntutnya, gunakan data tersebut untuk mengevaluasi deployment mandiri.
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Untuk panduan integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com.


