
Nota del autor: analizamos los 2,8T de parámetros de Kimi K3.1 Pro, sus 104B de parámetros activos, la cuantización MXFP4 y el contexto de 1M. Estimamos el tamaño de los pesos y los requisitos de hardware, los comparamos con el precio de la API de $2/$10 y presentamos una tabla de decisión y una lista de comprobación para elegir entre autodespliegue y API.
La conclusión primero: Kimi K3.1 Pro es un modelo MoE con 2,8T de parámetros totales que no se puede ejecutar en una sola máquina. Según una estimación con MXFP4, solo los pesos ocupan varios TB y no caben en un servidor habitual de un nodo con 8 GPU. Como mínimo, hace falta desplegarlo con varias tarjetas entre distintos nodos y reservar memoria de GPU para la caché KV de un contexto de 1M. Que los pesos sean abiertos resuelve la cuestión de si se puede acceder al modelo, pero no reduce los requisitos para ejecutarlo bien.
Por eso, para la gran mayoría de los equipos técnicos, es más realista empezar usando la API al precio de $2/$10. El autodespliegue solo merece un análisis serio cuando se cumplen estas tres condiciones a la vez: el volumen de llamadas es alto y estable, los datos deben permanecer en el centro de datos propio y el equipo tiene capacidad para operar un clúster de GPU. En este artículo no repetimos benchmarks: primero calculamos el costo de los pesos y el hardware, después el de la utilización y las operaciones, y por último ofrecemos recomendaciones según el tipo de equipo. Si solo quieres probar qué tal funciona, puedes acceder con una sola clave a través de una plataforma agregadora como APIYI apiyi.com y decidir después qué camino seguir.
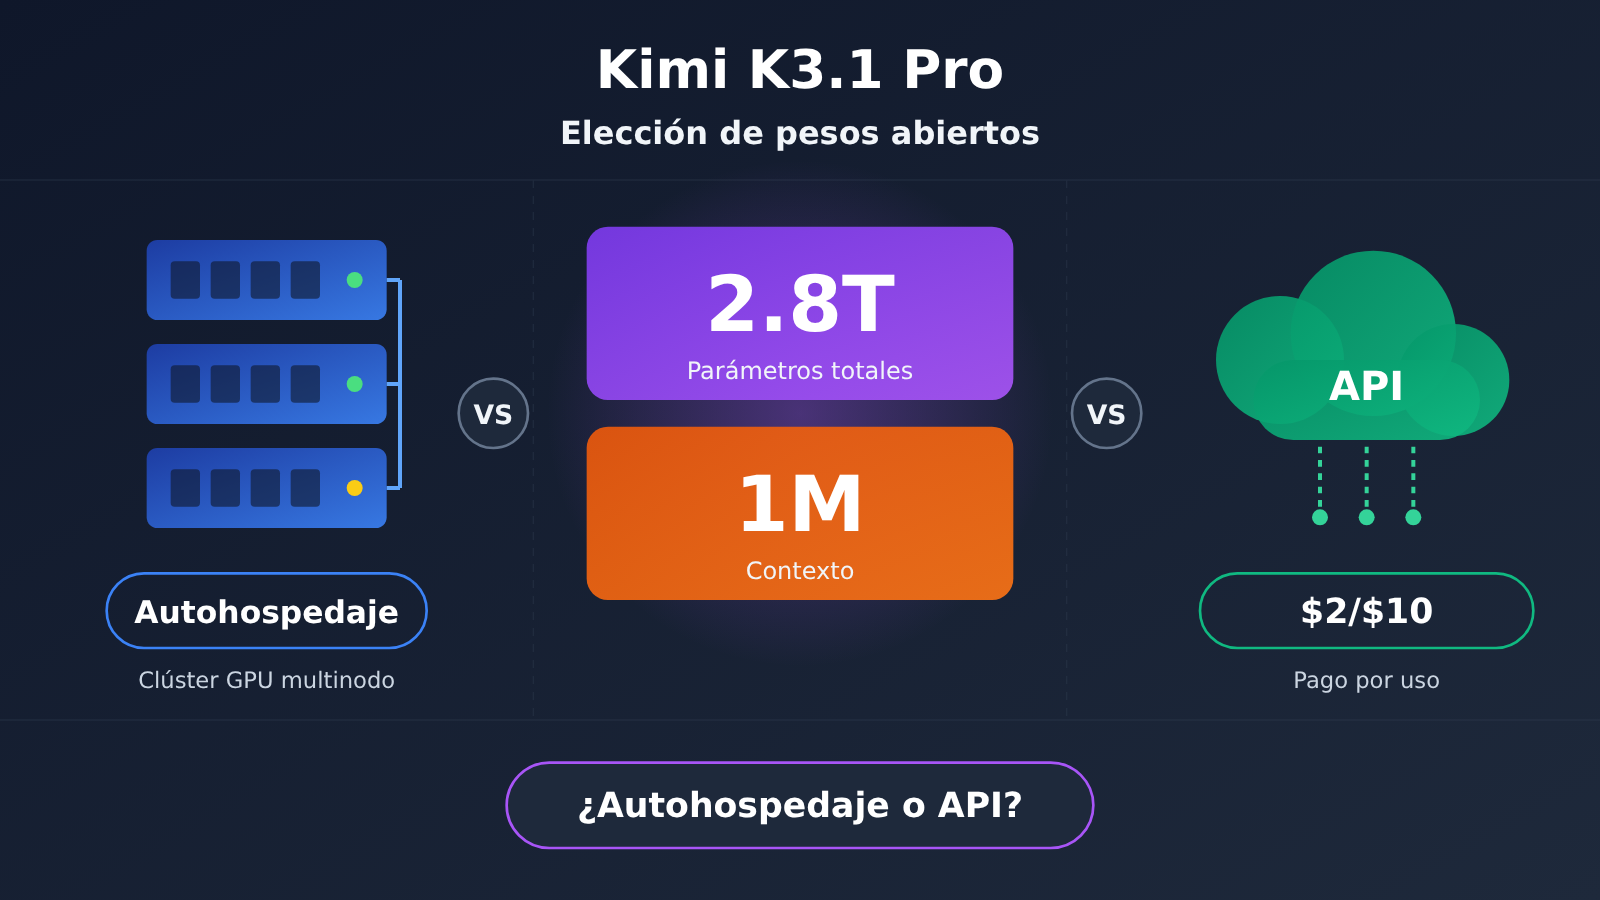
Especificaciones de Kimi K3.1 Pro: qué significan sus 2.8T de parámetros y su contexto de 1M
Kimi K3.1 Pro es el primer modelo de la serie K3.1 y se ha publicado con pesos abiertos. Utiliza una arquitectura MoE (mezcla de expertos), con 2.8T de parámetros en total, de los que activa aproximadamente 104B por cada token. Dicho de otro modo: el costo de almacenamiento se calcula sobre 2.8T, mientras que el costo de cómputo se acerca más al de un modelo denso de 104B. Esta es la paradoja habitual al desplegar un MoE por cuenta propia: la capacidad de cómputo necesaria no es tan desmesurada, pero resulta difícil reducir los requisitos de memoria de GPU.
Otro punto clave es el entrenamiento consciente de la cuantización (QAT). El modelo combina pesos MXFP4 con activaciones MXFP8 y tiene en cuenta la cuantización desde la fase de entrenamiento. Esto significa que la baja precisión es su «forma nativa», no una versión comprimida a posteriori, por lo que, en teoría, la pérdida de precisión es más fácil de controlar. Eso sí, también impone requisitos al hardware y al motor de inferencia, que deben ser capaces de admitir eficientemente los formatos de microescalado de la serie MX.
| Especificación | Parámetros de Kimi K3.1 Pro | Qué implica para la elección |
|---|---|---|
| Arquitectura | MoE, 93 capas | El almacenamiento depende de los parámetros totales; el cómputo, de los activados |
| Parámetros totales | 2.8T | Determinan el tamaño de los pesos y el mínimo de memoria de GPU necesario |
| Parámetros activados | 104B | Determinan el cómputo por token |
| Codificador visual | MoonViT-V2, 401M de parámetros | Multimodal nativo: no necesita componentes externos para comprender imágenes |
| Cuantización | Pesos MXFP4 / activaciones MXFP8, QAT | Baja precisión nativa, dependiente de la compatibilidad del hardware |
| Contexto | 1M tokens | Adecuado para documentos extensos y repositorios grandes, con una alta demanda de KV Cache |
| Casos de uso | Programación, creación 3D, investigación financiera, agentes | Orientado a tareas complejas y cadenas largas de invocaciones |
La ventana de contexto de 1M y las capacidades multimodales de Kimi K3.1 Pro
Una ventana de contexto de 1M tokens permite incluir de una sola vez un repositorio de código mediano, un conjunto completo de informes financieros o material de investigación extenso. Es justo lo que necesitan los agentes y los casos de investigación financiera. Su capacidad multimodal nativa también permite al modelo leer imágenes, capturas de pantalla y gráficos directamente, algo útil para tareas de creación 3D y programación.
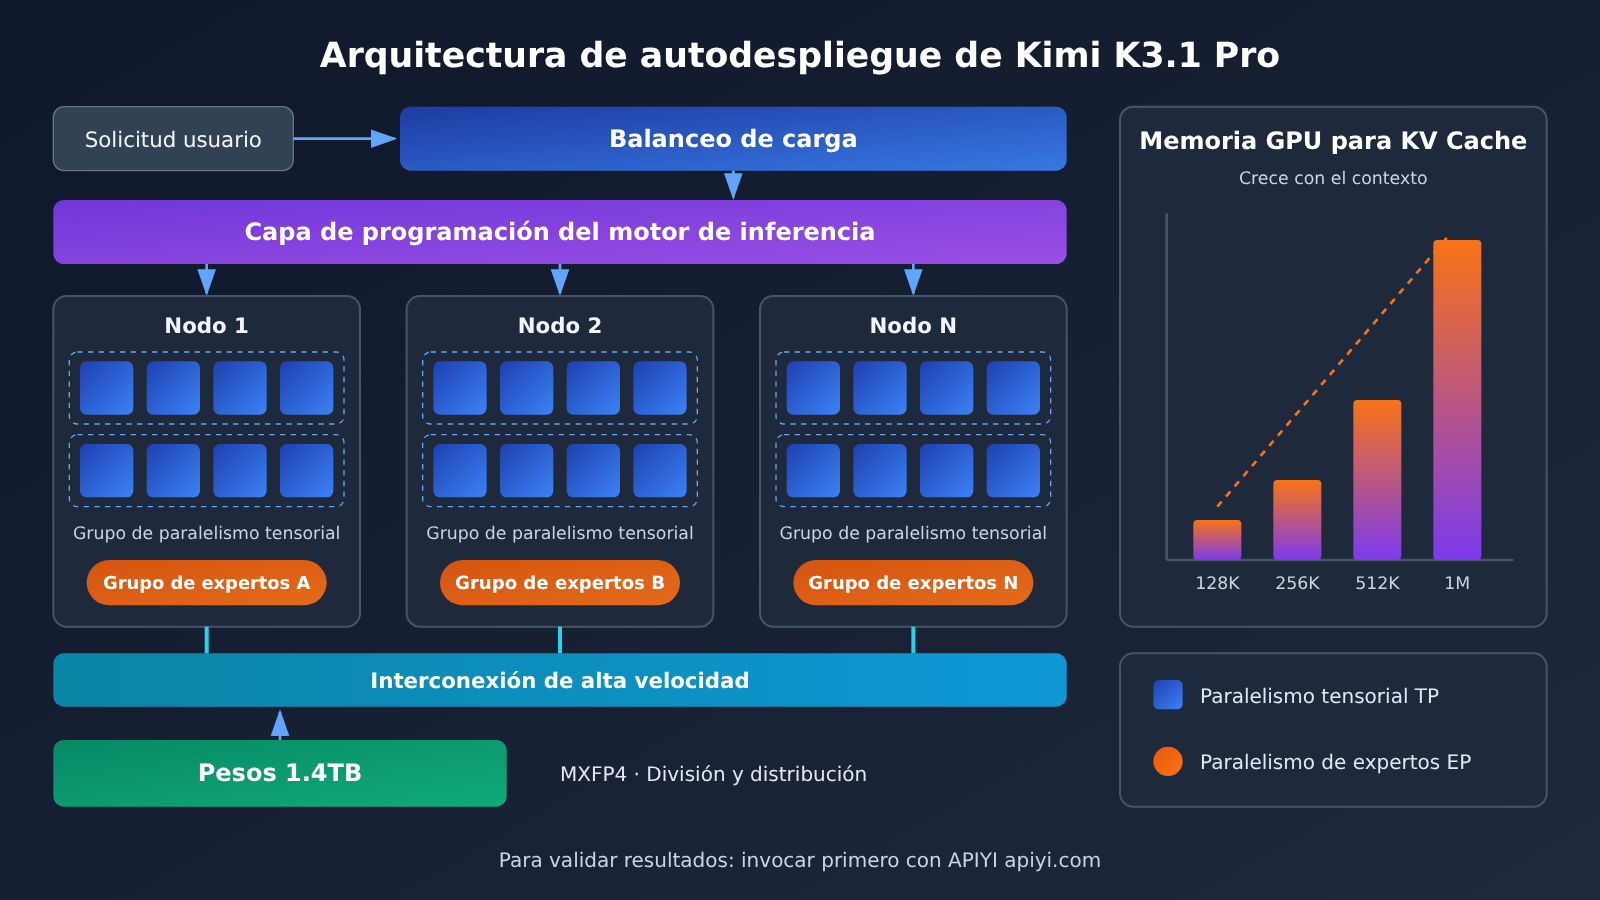
Pero ambas capacidades tienen un costo al desplegar el modelo por cuenta propia. Un contexto largo hace que la KV Cache crezca linealmente con la longitud de la secuencia, por lo que utilizar los 1M al completo puede consumir una cantidad considerable de memoria de GPU. El codificador visual en sí no es grande, pero el preprocesamiento de entradas multimodales y la planificación del procesamiento por lotes complican el servicio de inferencia. Si usas una API, el proveedor se encarga de todo eso y tú solo pagas por token.
Tamaño de los pesos de Kimi K3.1 Pro y requisitos de hardware
Estimación del tamaño de los pesos de Kimi K3.1 Pro
Antes de empezar: los siguientes tamaños se calculan a partir del número de parámetros; el tamaño real de los archivos dependerá de la publicación oficial. En MXFP4, cada parámetro ocupa aproximadamente 4 bits, es decir, 0,5 bytes. Para 2.8T de parámetros, eso equivale a unos 1.4TB. El formato MX también necesita espacio adicional para almacenar los factores de escala por bloque. Además, algunas partes, como el codificador visual y las capas de embeddings, pueden conservar una precisión mayor, por lo que los archivos reales suelen ser algo más grandes que el resultado del cálculo directo.
| Precisión supuesta | Bytes por parámetro | Tamaño estimado de los pesos de 2.8T | Nota |
|---|---|---|---|
| MXFP4 | Aproximadamente 0,5 bytes | Aproximadamente 1.4TB | Formato principal promovido oficialmente; no incluye el espacio adicional para los factores de escala |
| Nivel de 8 bits | Aproximadamente 1 byte | Aproximadamente 2.8TB | Solo como referencia; no es una recomendación oficial |
| BF16 | 2 bytes | Aproximadamente 5.6TB | Solo como referencia para ilustrar la importancia de QAT |
La conclusión de esta tabla es que, incluso con MXFP4, la opción que menos espacio ocupa, los pesos ya alcanzan la escala de los TB. Descargarlos, verificarlos y distribuirlos entre varias máquinas es un proyecto de ingeniería en sí mismo, por lo que conviene planificar con antelación tanto el almacenamiento como el ancho de banda de la red interna.
Requisitos de hardware para desplegar Kimi K3.1 Pro por cuenta propia
Si tomamos 1.4TB como estimación aproximada y usamos tarjetas aceleradoras con 80GB de memoria de video, harían falta cerca de 18 tarjetas solo para alojar los pesos. Y eso sin contar la KV Cache, las activaciones ni los recursos que consume el motor de inferencia. Un servidor convencional de 8 tarjetas claramente no basta. Incluso con tarjetas de nueva generación que tengan más memoria por unidad, un solo nodo apenas podría alojar los pesos y sería difícil reservar el margen necesario para contextos largos. Por eso, en la práctica, la solución pasa por usar varias tarjetas y varias máquinas, y dividir el modelo combinando paralelismo tensorial, paralelismo de expertos y paralelismo de pipeline.
Además del hardware, hay otros costos que es fácil subestimar:
- Motor de inferencia y estrategia de paralelismo: se necesita un framework de inferencia compatible con el paralelismo de expertos de MoE y el formato MX. Consulta la documentación oficial de despliegue para conocer los motores recomendados y las configuraciones de paralelismo.
- Interconexión entre nodos: el paralelismo de expertos genera un gran volumen de comunicación entre nodos. El ancho de banda y la latencia de la red afectan directamente al rendimiento.
- Centro de datos y electricidad: hay que planificar de antemano la alimentación eléctrica, la refrigeración y el espacio en racks para el clúster de GPU de varias máquinas.
- Capacidad para picos de demanda: los momentos de mayor demanda requieren capacidad adicional. Durante los períodos de menor actividad, esa capacidad de cómputo supone un costo de recursos inactivos.
- Personal de operaciones: las actualizaciones del modelo, la resolución de incidencias, la supervisión y las alertas requieren la dedicación continua de ingenieros familiarizados con clústeres de GPU.
Cabe destacar que las fuentes consultadas no incluyen datos oficiales de rendimiento y costos medidos, por lo que este artículo tampoco ofrece un presupuesto definitivo para un despliegue propio. Si decides poner en marcha el proyecto, toma como referencia la documentación oficial de despliegue y los resultados de tus propias pruebas de carga.
Licencia de Kimi K3.1 Pro: pesos abiertos no significa uso comercial sin restricciones
«Pesos abiertos» y «código abierto de libre uso comercial» son cosas distintas. Conviene comprobarlo antes de elegir un modelo. Las licencias de muchos modelos con pesos abiertos imponen condiciones al uso comercial, como límites de ingresos o de número de usuarios, o la obligación de indicar el origen en el producto. Para las condiciones comerciales, los límites de ingresos y las obligaciones de notificación de Kimi K3.1 Pro, la referencia definitiva es el texto de la licencia oficial.
Además del uso comercial directo, hay otras actividades que pueden estar sujetas a requisitos adicionales:
- Distribución: proporcionar los pesos o sus versiones derivadas a terceros.
- Modificación: determinar cómo se aplica la licencia a modelos ajustados, destilados o fusionados.
- Servicio alojado: ofrecer como API un modelo desplegado en infraestructura propia es una de las situaciones que las licencias suelen regular de forma específica.
Lo recomendable es que los responsables legales y técnicos revisen juntos la licencia, punto por punto, y documenten sus conclusiones antes de comprar hardware. Al invocar el modelo mediante la API oficial o una plataforma de terceros, se aplican principalmente los términos del servicio y, por lo general, no hay distribución de pesos. Aun así, hay que verificar que el tratamiento de datos y el alcance del uso cumplan las condiciones aplicables.
Precio de la API de Kimi K3.1 Pro: cómo calcular los $2/$10
El ID del modelo en la API oficial es kimi-k3.1-pro. Ofrece interfaces compatibles con OpenAI y Anthropic, por lo que requiere pocos cambios en proyectos existentes. Los precios se calculan por cada millón de tokens:
| Concepto | Versión estándar kimi-k3.1-pro |
Versión Highspeed | Detalles |
|---|---|---|---|
| Entrada | $2 |
$4 |
Por millón de tokens |
| Salida | $10 |
$20 |
Por millón de tokens |
| Acierto de caché | $0.20 |
Consultar información oficial | Los prefijos repetidos pueden reducir mucho el costo |
| Escritura en caché | $2 |
Consultar información oficial | Mismo precio que la entrada estándar |
| Velocidad | Referencia | Aproximadamente 3 veces mayor | Una opción para casos sensibles a la latencia |
Un ejemplo ayuda a entender el cálculo (no es una prueba real, solo una conversión de precios): con 100 millones de tokens de entrada y 20 millones de tokens de salida al mes, la versión estándar costaría aproximadamente 100 × $2 + 20 × $10 = $400. Si el 70 % de la entrada se encuentra en caché, el costo de entrada pasaría a ser 70 × $0.20 + 30 × $2 = $74, y el total bajaría a unos $274. Con la versión Highspeed, el mismo volumen costaría aproximadamente $800, sin contar la caché.
Estas cifras son reveladoras: incluso con cientos de millones de tokens al mes, la factura de la API queda muy por debajo de la depreciación mensual de un clúster GPU de varias máquinas, sumada al costo de electricidad y personal. En los escenarios con agentes, las indicaciones de sistema y las definiciones de herramientas suelen repetirse mucho, así que aprovechar el precio de los aciertos de caché es la forma más directa de reducir costos al usar la API.
Para integrarla, basta con que el cliente sea compatible con el protocolo de OpenAI: cambia base_url a https://api.apiyi.com/v1 e introduce el ID de modelo que proporciona la plataforma. No hace falta escribir una capa de adaptación adicional.
🚀 Inicio rápido: si tu equipo quiere comparar el rendimiento de Kimi, Claude, GPT y Gemini en una misma tarea, puede invocarlos con una sola clave API a través de APIYI apiyi.com y consultar la lista de modelos, el uso y los registros en la consola. Para saber si
kimi-k3.1-proestá disponible y cuál es su precio, consulta la información actualizada de la consola.
Kimi K3.1 Pro: diferencias clave entre el despliegue propio y la API
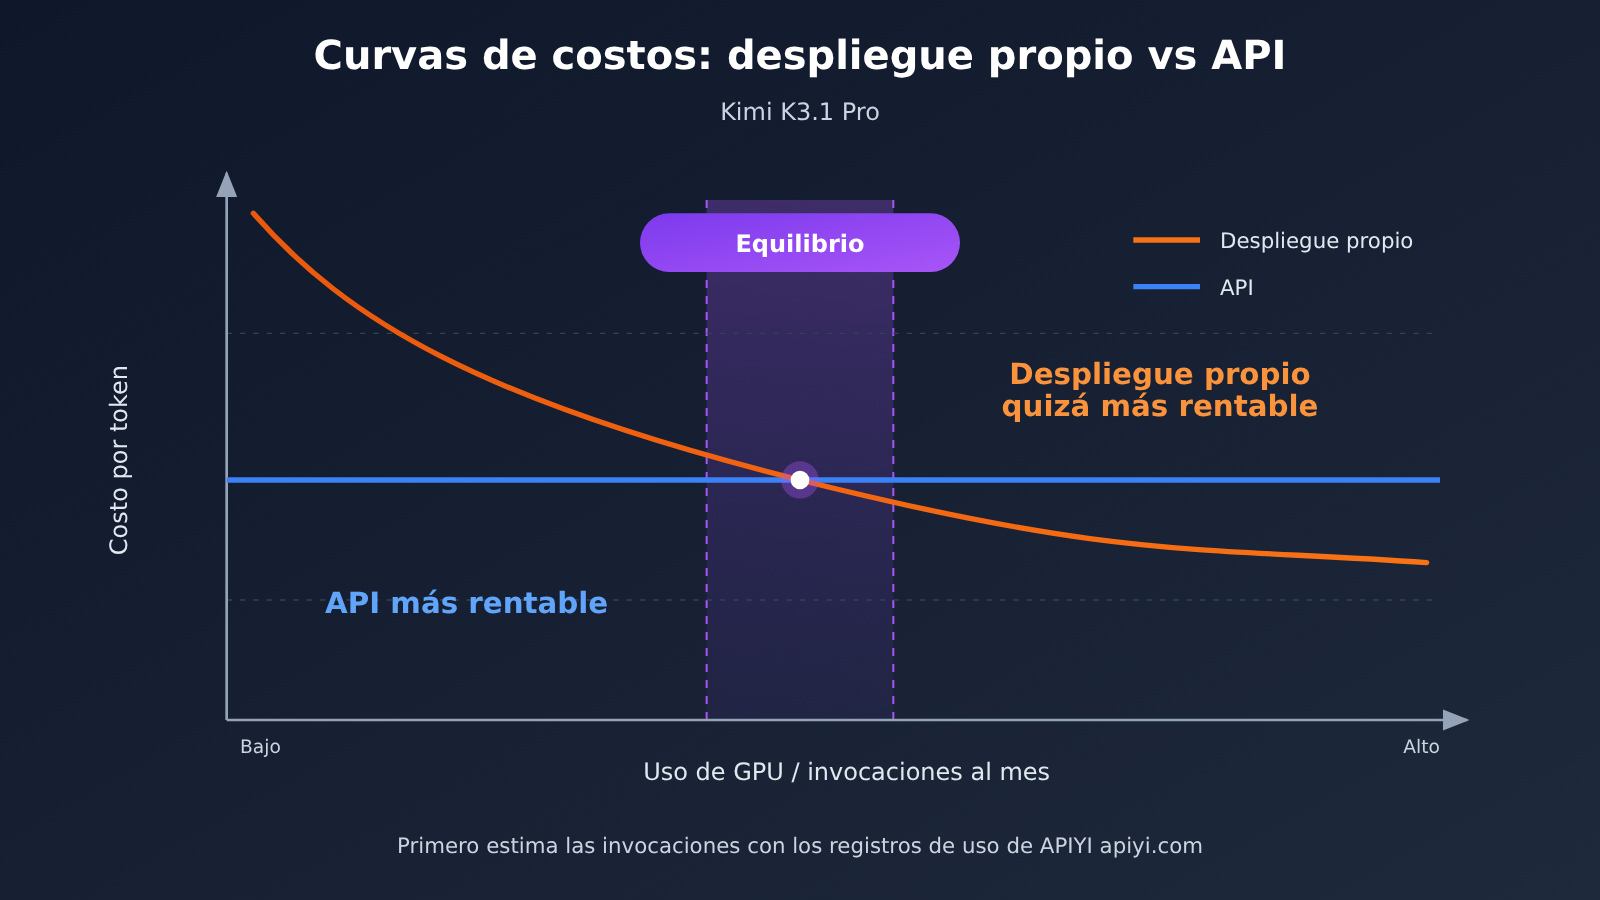
La diferencia fundamental entre el despliegue propio y la API está en la estructura de costes. La API supone un coste puramente variable: pagas por lo que usas y, si no la usas, no pagas. El despliegue propio combina costes fijos elevados con un coste marginal bajo: una vez que inviertes en hardware, infraestructura y personal, sigues pagando tanto si el clúster funciona a plena capacidad como si no. Por eso, la variable decisiva es la utilización: solo si el clúster mantiene una carga elevada durante un periodo prolongado, el coste por token, una vez amortizada la inversión, puede quedar por debajo del precio de la API.
| Criterio de decisión | Despliegue propio de Kimi K3.1 Pro | Uso de la API | Opción recomendada |
|---|---|---|---|
| Utilización | Requiere una carga elevada y sostenida para amortizar los costes | Pago por uso, sin costes por capacidad inactiva | API para uso de baja o media frecuencia |
| Cumplimiento normativo de datos | Los datos pueden permanecer por completo dentro del entorno propio | Los datos deben enviarse al proveedor del servicio | Despliegue propio para entornos muy regulados |
| Inversión inicial | Elevada: múltiples equipos con GPU, infraestructura y red | Prácticamente nula | API |
| Costes operativos | Requiere personal dedicado a la operación del clúster de GPU | Los asume el proveedor | API |
| Elasticidad ante picos | Hay que reservar capacidad adicional y la ampliación es lenta | Buena elasticidad, sujeta a límites de uso | API |
| Capacidad de personalización | Permite el ajuste fino y modificar la configuración de inferencia | Limitada a los parámetros de la interfaz | Despliegue propio para personalización avanzada |
| Tiempo de puesta en marcha | De semanas a meses | Cuestión de horas | API |
| Canal de acceso | Servicio de inferencia propio | API oficial, plataformas como APIYI apiyi.com, entre otras | Según las necesidades |
Análisis comparativo de la API: la API lleva ventaja en velocidad de puesta en marcha, elasticidad y coste total de propiedad. Sin embargo, los datos deben salir del entorno propio y los parámetros configurables de la interfaz son limitados. En comparación, el despliegue propio ofrece más control sobre los datos y mayores posibilidades de personalización, por lo que resulta más adecuado para equipos sujetos a regulaciones estrictas y con un volumen de llamadas muy alto.
Análisis comparativo del despliegue propio: el despliegue propio tiene potencial para mejorar el control y reducir el coste unitario, pero también implica una inversión inicial elevada, personal de operación y riesgo de capacidad inactiva. Cuando el volumen de llamadas fluctúa o no se cuenta con un equipo especializado en GPU, la API sigue siendo la opción más segura.
Casos recomendados y criterios para elegir Kimi K3.1 Pro
Equipos para los que conviene usar la API de Kimi K3.1 Pro
- Startups y equipos pequeños o medianos: si no tienen un clúster de GPU ni personal dedicado a operaciones, la API es la única opción razonable.
- Negocios con volumen de uso variable: con picos durante el día, menor actividad por la noche o aumentos repentinos durante campañas, el pago por uso evita mantener recursos sin utilizar.
- Proyectos que necesitan lanzarse rápido: durante la validación del producto, la velocidad es lo más importante; la integración puede completarse en unas horas.
- Evaluación paralela de varios modelos: si hay que comparar otros modelos en la misma tarea, una interfaz unificada simplifica mucho el trabajo frente a desplegarlos por separado.
Equipos para los que conviene desplegar Kimi K3.1 Pro en infraestructura propia
- Datos que no pueden salir del entorno interno: en sectores como finanzas, salud y administraciones públicas, los requisitos normativos pueden exigir que los datos permanezcan íntegramente en la red interna.
- Uso frecuente y estable: cargas altas y continuas las 24 horas del día, los 7 días de la semana, con una utilización que puede mantenerse elevada a largo plazo.
- Equipos que ya cuentan con clústeres de GPU y personal de operaciones: la inversión adicional es controlable y el modelo puede integrarse en la infraestructura existente.
- Necesidades de personalización profunda: cuando se requiere ajustar el modelo a partir de sus pesos abiertos u optimizar la inferencia para casos específicos, siempre que la licencia lo permita.
Enfoque híbrido
Hay otra opción que suele pasarse por alto: usar la API para crear prototipos y reevaluar el despliegue propio para producción. También se pueden combinar ambos enfoques: procesar los datos sensibles mediante un despliegue propio y enviar el tráfico general a la API. La primera opción permite sustituir las estimaciones a ojo por datos reales de uso; la segunda combina cumplimiento normativo y flexibilidad.
💡 Recomendación: antes de invertir en hardware, conviene procesar durante un tiempo tráfico real a través de APIYI apiyi.com. Usa los registros de la consola para calcular los tokens diarios, la relación entre picos y valles de tráfico y la tasa de aciertos de caché. Estos datos son la base más fiable para decidir si el despliegue propio compensa.
Preguntas frecuentes FAQ
Q1: ¿Se puede desplegar Kimi K3.1 Pro en un solo servidor propio?
Con MXFP4, se estima que los pesos ocupan alrededor de 1,4 TB, por lo que no caben en un servidor convencional de 8 GPU. Incluso en nodos con más memoria por GPU, es difícil dejar margen para la caché KV de una ventana de contexto de 1M. En la práctica, se necesitan varias GPU y varios servidores; consulta la documentación oficial para conocer la configuración concreta.
Q2: ¿Los 104B de parámetros activados significan que los requisitos de hardware se calculan solo sobre 104B?
No. Los parámetros activados determinan la carga de cálculo por token, pero los pesos de todos los expertos deben permanecer en la memoria de las GPU. Por eso, la memoria necesaria sigue calculándose sobre los 2,8T de parámetros totales. Esta es precisamente la característica de los modelos MoE: calculan rápido, pero necesitan almacenar muchos pesos.
Q3: ¿Se puede usar comercialmente en cuanto se publiquen los pesos?
No necesariamente. Los pesos abiertos no implican un uso comercial sin condiciones. Los umbrales de ingresos, las obligaciones de notificación y las restricciones sobre servicios alojados dependen del texto de la licencia oficial. Conviene que el equipo legal la revise antes de comprar hardware.
Q4: ¿Cómo probar la API de Kimi K3.1 Pro a bajo costo?
Puedes registrarte en APIYI apiyi.com y usar el crédito de prueba gratuito para nuevos usuarios. La interfaz compatible con OpenAI permite integrarla en proyectos existentes. Con una sola clave API de la plataforma puedes invocar modelos de la familia Kimi, además de Claude, GPT, Gemini y otros. Consulta la consola para confirmar si `kimi-k3.1-pro` está disponible y cuál es su precio.
Q5: ¿Cómo elegir entre la versión estándar y Highspeed?
Highspeed cuesta `$4/$20`, el doble que la versión estándar, y es aproximadamente 3 veces más rápida. Es adecuada para interacciones en tiempo real con usuarios y agentes sensibles a la latencia del primer carácter. Para procesamiento por lotes sin conexión y tareas en segundo plano, la versión estándar con caché resulta más económica.
Resumen: lista de comprobación para el autodespliegue de Kimi K3.1 Pro frente a la API
Que Kimi K3.1 Pro tenga pesos abiertos es una buena noticia: ofrece una opción totalmente controlable a los equipos que cuentan con los recursos necesarios. Pero sus 2.8T parámetros lo convierten en un modelo de nivel de clúster. El principal desafío del autodespliegue no es descargar los pesos, sino cuadrar cuatro cuentas: hardware, utilización, operaciones y licencia. Para la mayoría de los equipos, la opción de menor riesgo es empezar con la API a $2/$10 y después evaluar, con datos reales, si conviene desplegarlo por cuenta propia.
Puntos clave de Kimi K3.1 Pro
- Especificaciones: 2.8T parámetros totales, 104B activos, 93 capas MoE, multimodal nativo y ventana de contexto de 1M.
- Pesos: se estiman en unos 1.4TB con MXFP4; el tamaño real depende de los archivos oficiales y no cabe en una sola máquina.
- Hardware: requiere un despliegue paralelo con varias GPU y máquinas, además de reservar memoria de GPU para la caché KV de contextos largos.
- Licencia: pesos abiertos no significa que se puedan usar comercialmente sin restricciones; las condiciones dependen de la licencia oficial.
- Precios: versión estándar
$2/$10, aciertos de caché$0.20, Highspeed$4/$20. - Decisión: la utilización es la variable clave; para cargas de frecuencia baja o media y con grandes fluctuaciones, conviene priorizar la API.
Lista de comprobación: autodespliegue vs. API
| Aspecto | Señales para elegir la API | Señales para elegir el autodespliegue |
|---|---|---|
| Volumen de invocaciones | Volumen mensual bajo o con fluctuaciones importantes | Carga alta y sostenida las 24 horas, los 7 días de la semana |
| Cumplimiento de datos | Los datos se pueden enviar al proveedor | Los datos deben permanecer en la red interna |
| Capacidad de GPU | Sin clúster ni personal de operaciones dedicado | Ya se cuenta con un clúster de varias máquinas y un equipo de operaciones |
| Licencia | No se quieren gestionar las condiciones de distribución y alojamiento | El equipo legal ya confirmó las condiciones de uso comercial |
| Tiempo de lanzamiento | Hay que lanzar y validar cuanto antes | Se acepta un despliegue que tarde de semanas a meses |
| Datos de costes | Aún no hay estadísticas reales de invocaciones | Ya se calculó el punto de equilibrio con datos reales |
Si la mayoría de los aspectos de la lista encajan en la columna de la izquierda, basta con usar la API. Recomendamos acceder a la familia Kimi y a otros modelos principales con una sola clave a través de APIYI, apiyi.com. Los registros de uso de la consola permiten recopilar datos reales para evaluar el autodespliegue cuando el volumen de invocaciones y las necesidades de cumplimiento lo justifiquen.
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal de APIYI. Para más información sobre la integración, visita el centro de documentación en docs.apiyi.com.


