
Note de l’auteur : cet article compare les scores de benchmark, les spécifications de fenêtre de contexte et les prix d’entrée/sortie de Qwen4-Max et GPT-6 Astra, puis indique, par type de tâche, quel modèle est le plus rentable.
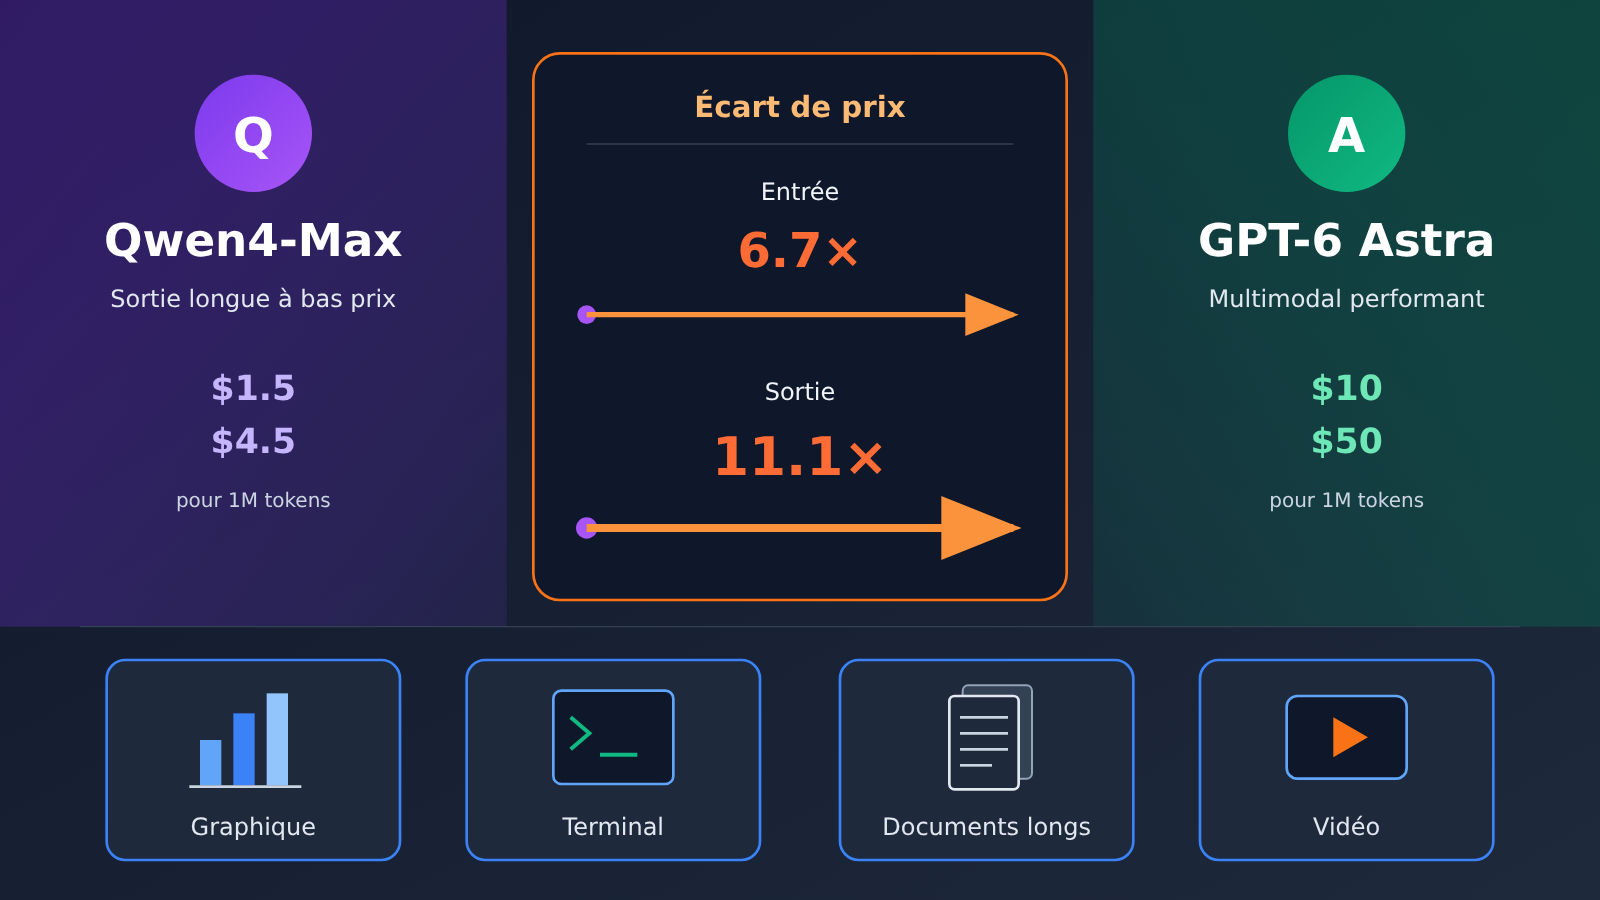
Conclusion d’abord : le prix d’entrée de GPT-6 Astra est environ 6.7 fois celui de Qwen4-Max, et son prix de sortie environ 11.1 fois. Ce surcoût achète des choses très concrètes : principalement de meilleurs scores sur trois familles de tâches — compréhension de graphiques, opérations dans le terminal et les dépôts de code, compréhension vidéo. En revanche, sur les agents bureautiques et certains benchmarks spécialisés, Qwen4-Max est devant.
Il ne s’agit pas d’un article « qui écrase complètement qui ». Les deux modèles ont chacun des points forts et des points faibles clairs. Cet article ne compare que ces deux versions. Les faits viennent de quatre sources : les comparaisons sur un même graphique communiquées par Qwen, le texte original de la documentation OpenAI, un instantané public du classement Arena (2026-11-14) et la grille tarifaire de la plateforme APIYI.
L’essentiel : après lecture, vous aurez un tableau de choix selon la tâche et le budget, vous saurez où va l’argent supplémentaire payé pour Astra, et vous saurez aussi comment se calcule la majoration appliquée à toute la requête lorsque l’entrée d’Astra dépasse 272K.
Qwen4-Max vs GPT-6 Astra : les différences clés
Commençons par les caractéristiques et les prix dans un même tableau. Les données techniques et tarifaires proviennent respectivement du tarif QwenCloud et de la documentation officielle OpenAI ; elles ont été relevées le 2026-11-16. Les prix sont exprimés pour 1M tokens.
| Critère | Qwen4-Max | GPT-6 Astra | Avantage |
|---|---|---|---|
| Architecture / positionnement | Tronc 2.4T / 71B activés + 328B N-gram Embedding, vision native | Le modèle généraliste le plus puissant actuellement en service chez OpenAI | Positionnements différents |
| Contexte | 1M | 1,050,000 | Quasi équivalent |
| Entrée maximale | 991K (983K en mode raisonnement) | 922K | Qwen4-Max |
| Sortie maximale | 393K (chaîne de raisonnement max 262K) | 128K | Qwen4-Max |
| Niveau de raisonnement | Mode raisonnement | reasoning.effort : low / medium / high / xhigh / max |
Astra plus granulaire |
| Prix d’entrée | $1.5 | $10 (×2 au-delà de 272K d’entrée) | Qwen4-Max |
| Prix de sortie | $4.5 | $50 (×1.5 au-delà de 272K d’entrée) | Qwen4-Max |
| Coupure des connaissances | Non indiqué dans les sources | 2026-04-30 | — |
Différences de contexte entre Qwen4-Max et GPT-6 Astra
Les deux modèles annoncent un contexte de l’ordre de 1M. La différence se joue dans la répartition entre entrée et sortie. Qwen4-Max peut produire jusqu’à 393K tokens en une seule fois, ce qui est utile pour générer de longs rapports, réécrire de gros blocs de code ou extraire des données structurées en lot. La limite de sortie d’Astra est de 128K : suffisant pour les tâches courantes, mais il faut découper les générations très longues.
Sur l’entrée maximale, Qwen4-Max (991K) dépasse aussi légèrement Astra (922K). Lors du choix, le point vraiment à surveiller est le seuil tarifaire d’Astra : dès que l’entrée dépasse 272K, le prix unitaire de toute la requête augmente. La partie sur les coûts ci-dessous détaille ce calcul.
Comparaison Qwen4-Max / GPT-6 Astra : le détail des benchmarks
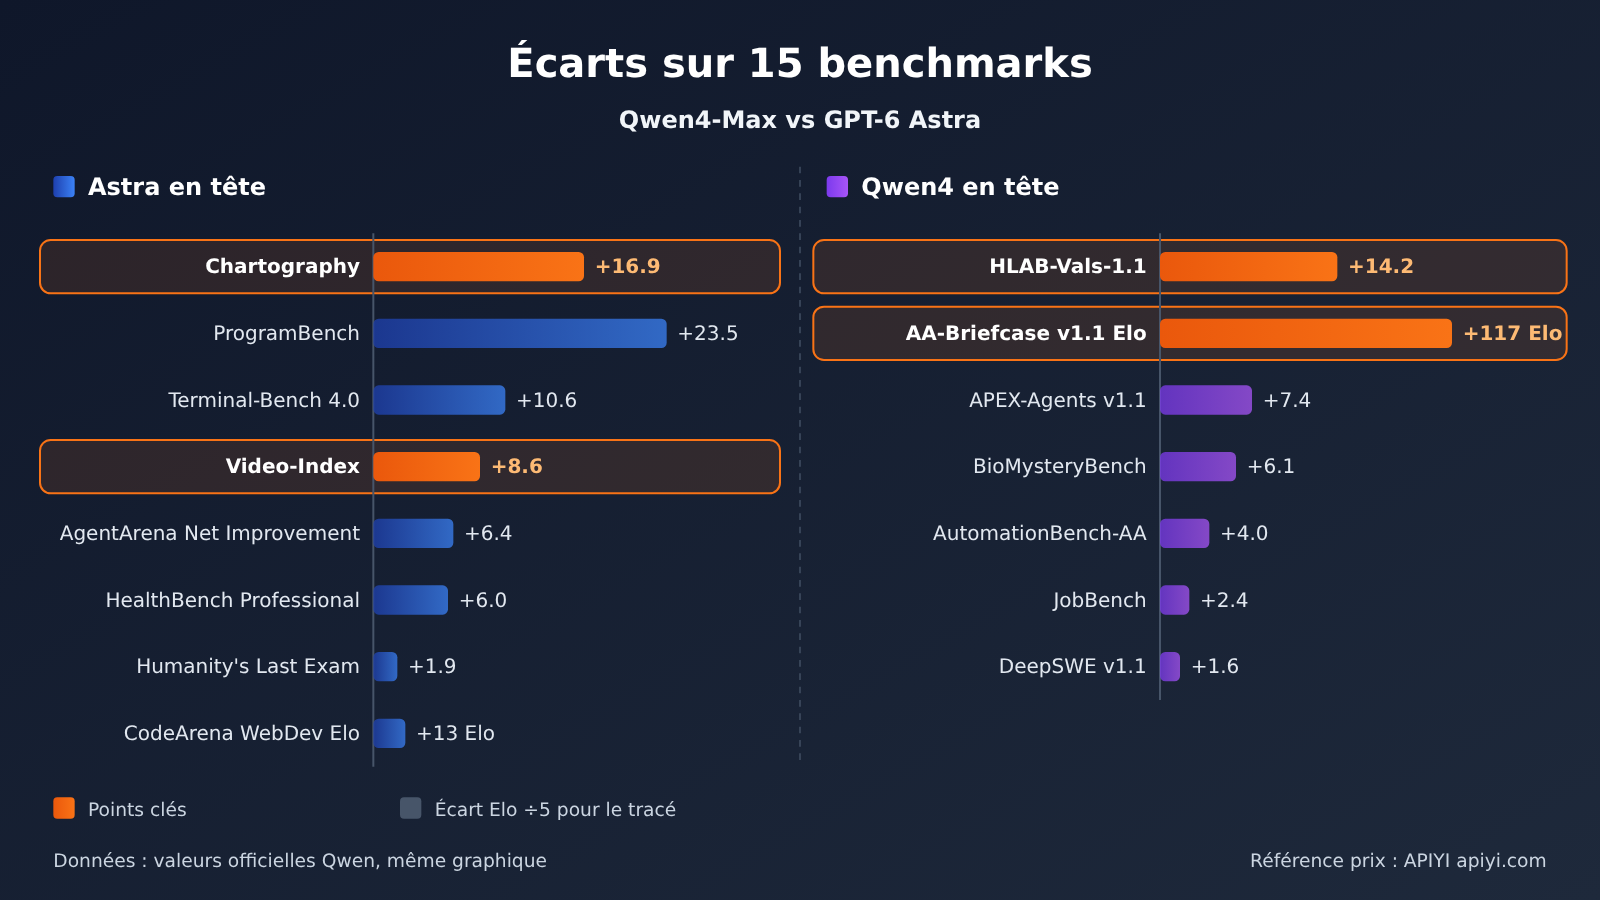
Les scores ci-dessous proviennent tous d’une comparaison côte à côte publiée par Qwen lui-même. Ce type de comparatif étant mis en avant par une seule des parties, il faut garder une certaine marge de recul. Cela dit, Qwen a lui-même listé plusieurs avantages nets d’Astra dans le tableau, ce qui rend l’ensemble relativement plus crédible.
| Benchmark | Qwen4-Max | GPT-6 Astra | Écart | En tête |
|---|---|---|---|---|
| Chartography | 54.2 | 71.1 | 16.9 | Astra |
| ProgramBench | 31.5 | 55.0 | 23.5 | Astra |
| Terminal-Bench 4.0 | 48.5 | 59.1 | 10.6 | Astra |
| Video-Index | 68.1 | 76.7 | 8.6 | Astra |
| AgentArena Net Improvement | 7.5 | 13.9 | 6.4 | Astra |
| HealthBench Professional | 60.0 | 66.0 | 6.0 | Astra |
| Humanity’s Last Exam | 51.7 | 53.6 | 1.9 | Astra |
| CodeArena WebDev Elo | 1750 | 1763 | 13 | Astra |
| HLAB-Vals-1.1 | 21.3 | 7.1 | 14.2 | Qwen4 |
| AA-Briefcase v1.1 Elo | 1686 | 1569 | 117 | Qwen4 |
| APEX-Agents v1.1 | 72.1 | 64.7 | 7.4 | Qwen4 |
| BioMysteryBench | 85.0 | 78.9 | 6.1 | Qwen4 |
| AutomationBench-AA | 72.5 | 68.5 | 4.0 | Qwen4 |
| JobBench | 68.5 | 66.1 | 2.4 | Qwen4 |
| DeepSWE v1.1 | 75.7 | 74.1 | 1.6 | Qwen4 |
Les vrais atouts de GPT-6 Astra : graphiques, terminal, vidéo
C’est sur la compréhension des graphiques que l’écart est le plus marqué. Sur Chartography, Astra obtient 71.1 et Qwen4-Max 54.2, soit 16.9 points d’écart. Si votre activité consiste à lire des graphiques financiers, des captures d’écran de tableaux de bord de supervision ou des graphiques scientifiques, cet écart se répercutera directement sur la précision d’extraction, et il sera difficile de le combler avec de simples invites.
Le deuxième volet concerne le terminal et le dépôt de code. Sur Terminal-Bench 4.0, l’écart est de 10.6 points ; sur ProgramBench, de 23.5 points. Ces deux benchmarks évaluent l’exécution de commandes en plusieurs étapes et la capacité à construire un programme complet, précisément les compétences les plus sollicitées dans un agent de codage. Sur DeepSWE, Qwen4-Max devance légèrement Astra de 1.6 point, ce qui montre que sa capacité à corriger une issue isolée n’est pas négligeable. Mais dès que la tâche consiste à « construire un projet de bout en bout dans le terminal », Astra se montre plus stable.
La compréhension vidéo ne doit pas être négligée. Sur Video-Index, Astra affiche 76.7 contre 68.1, soit 8.6 points d’avance. Qwen4-Max prend certes en charge la vision nativement, mais il reste à la traîne sur la compréhension vidéo. Les équipes qui ont besoin de modérer du contenu vidéo, de rechercher des segments ou de résumer des vidéos pédagogiques devraient placer ce critère en tête de leur liste de sélection.
Les vrais atouts de Qwen4-Max : agents bureautiques et évaluations professionnelles
HLAB-Vals-1.1 est le benchmark où Qwen4-Max domine le plus nettement : 21,3 contre 7,1, soit un écart absolu de 14,2 points, et près de trois fois en proportion. Sur AA-Briefcase v1.1, l’Elo devance de 117 points (1686 contre 1569). Ce type d’évaluation penche vers les documents d’affaires et les tâches d’agents liées aux flux bureautiques ; dans le système Elo, un écart de 117 points est vraiment marquant.
APEX-Agents (+7,4), AutomationBench-AA (+4,0), JobBench (+2,4) : là aussi, Qwen4-Max est en tête. En regardant ces résultats ensemble, la conclusion est claire : sur les scénarios d’automatisation de processus et d’agents bureautiques, Qwen4-Max n’est pas seulement moins cher, il obtient aussi de meilleurs scores.
Instantané du classement public Code Arena (2026-11-14)
Les classements tiers peuvent servir de référence croisée. Un instantané du classement public Code Arena WebDev d’arena.ai montre GPT-6 Astra (Max) à la 5e place avec 1763 points, 8 685 votes et un coût de $9.43 par tâche. Qwen4-Max (xHigh) est 6e avec 1750 points, marqué « Preliminary », 1 814 votes et un coût de $4.18 par tâche.
Un écart Elo de 13 points dans un scénario WebDev relève du même niveau, et pourtant le coût par tâche est plus du double. À noter que Qwen4-Max compte encore peu de votes : son rang pourrait continuer à bouger, il vaut donc mieux le suivre dans la durée.
Comparaison des tarifs d’entrée et de sortie entre Qwen4-Max et GPT-6 Astra
Le tableau des tarifs se divise en deux parties : les prix officiels et les prix actuels d’APIYI. Les prix officiels proviennent des documents originaux de QwenCloud et d’OpenAI, relevés le 2026-11-16, exprimés en dollars par million de tokens.
| Poste de facturation | Qwen4-Max (QwenCloud) | GPT-6 Astra (documentation OpenAI) | Multiplicateur |
|---|---|---|---|
| Entrée | $1.5 | $10 | 6,7× |
| Sortie | $4.5 | $50 | 11,1× |
| Lecture du cache | $0.075 | $1 | 13,3× |
| Écriture du cache | 5 minutes $1.875 / 1 heure $3 | $12.5 | 4,2–6,7× |
| Entrée au-delà de 272K | Pas de palier indiqué dans la documentation | Entrée et cache de toute la requête ×2, sortie ×1.5 | — |
Le piège de la double facturation de GPT-6 Astra au-delà de 272K d’entrée
La règle de la documentation OpenAI est la suivante : quand l’entrée d’une requête dépasse 272K, l’entrée et le cache de toute la requête sont facturés au double, et la sortie à 1,5 fois. Ce n’est pas seulement la portion au-delà de 272K qui est majorée : l’ensemble de la requête passe au tarif élevé. Beaucoup d’équipes estiment le coût d’un RAG sur de longs documents ou d’un contexte complet de dépôt de code sans remarquer cette règle.
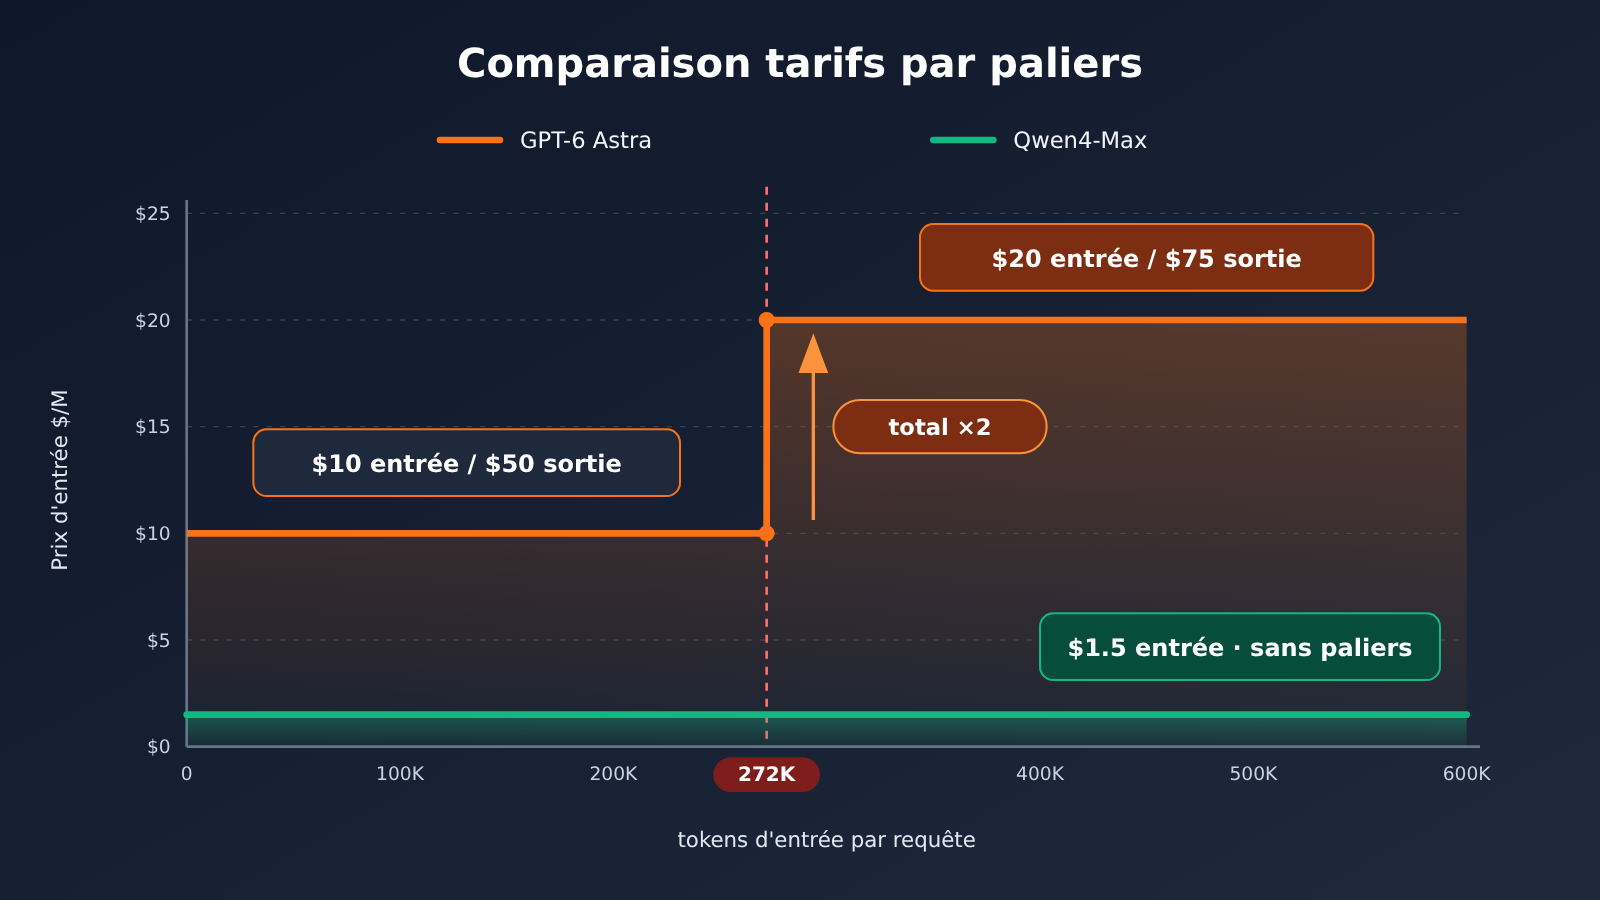
Faisons le calcul avec quelques requêtes typiques ci-dessous. Les prix sont ceux du tarif officiel standard, sans tenir compte du cache pour l’instant.
| Scénario | Qwen4-Max | GPT-6 Astra | Écart |
|---|---|---|---|
| Une requête de 270K d’entrée + 20K de sortie | env. $0.50 | env. $3.70 | env. 7,4× |
| Une requête de 400K d’entrée + 20K de sortie | env. $0.69 | env. $9.50 (règle des 272K déclenchée) | env. 13,8× |
| Mensuel : 100 M d’entrée + 10 M de sortie (toutes les requêtes sous 272K) | env. $195 | env. $1 500 | env. 7,7× |
| Idem, mais toutes les requêtes sont en contexte long au-delà de 272K | env. $195 (estimé au tarif standard) | env. $2 750 | env. 14× |
La deuxième ligne illustre parfaitement le problème. L’entrée passe de 270K à 400K, soit moins de 50 % de tokens en plus, mais le coût d’une requête Astra bondit de $3.70 à $9.50. Donc, quand on conçoit un flux à contexte long pour Astra, mieux vaut garder chaque requête sous 272K d’entrée. On peut d’abord effectuer un filtrage de la récupération ou un résumé par blocs, puis confier le résultat à Astra pour l’inférence finale.
Tarifs et disponibilité des modèles sur APIYI
Les tarifs actuels d’APIYI (au 2026-11-16) sont les suivants. En dernier ressort, c’est la liste des modèles de la plateforme qui fait foi.
gpt-6-astra: entrée $10, sortie $50, lecture du cache $1 ; sur la tranche 272,001–1,050,000 tokens, l’entrée passe à $20, conformément aux paliers officiels.qwen3.8-max: entrée $1.65, sortie $4.95, lecture du cache $0.20625.qwen4-max: pas encore disponible — nous mettrons ce modèle en ligne dès que possible. Une fois publié, l’ID du modèle et le tarif seront ceux de la liste des modèles sur apiyi.com.
💰 Conseil coût : avant la mise en ligne de
qwen4-max, vous pouvez déjà valider vos invites et vos workflows d’appel d’outils de la famille Qwen avecqwen3.8-max, puis basculer simplement le paramètremodelquand le nouveau modèle sera disponible. Les deux séries utilisent la même clé API sur APIYI apiyi.com, et la facturation se consulte au même endroit : pratique pour comparer directement le coût réel des deux côtés.
Choisir Qwen4-Max ou GPT-6 Astra selon la tâche
En croisant les benchmarks et les prix, on peut formuler des recommandations par type de tâche.
| Type de tâche | Recommandation | Justification | Plateformes disponibles |
|---|---|---|---|
| Compréhension de graphiques / captures d’écran | GPT-6 Astra | Chartography : 16.9 points d’avance | APIYI apiyi.com, OpenAI officiel |
| Opérations en terminal et construction d’un dépôt de code complet | GPT-6 Astra | Terminal-Bench +10.6, ProgramBench +23.5 | APIYI, OpenAI officiel |
| Compréhension vidéo | GPT-6 Astra | Video-Index : 8.6 points d’avance | APIYI, OpenAI officiel |
| Correction d’un issue unique / WebDev | Qwen4-Max (rapport qualité/prix) | DeepSWE légèrement devant, seulement 13 Elo d’écart sur WebDev, coût par tâche environ deux fois moindre | QwenCloud ; APIYI en attente de mise en ligne |
| Agent bureautique et automatisation des processus | Qwen4-Max | AA-Briefcase +117, APEX +7.4, HLAB-Vals +14.2 | QwenCloud ; APIYI en attente de mise en ligne |
| Traitement par lots à long contexte (>272K) | Qwen4-Max | Pas de majoration globale façon Astra, sortie maximale de 393K | QwenCloud ; APIYI en attente de mise en ligne |
| Questions-réponses médicales spécialisées | GPT-6 Astra | HealthBench Professional : 6.0 points d’avance | APIYI, OpenAI officiel |
Quand choisir GPT-6 Astra
- Contrôle qualité multimodal : graphiques, captures de tableaux de bord, extraits vidéo à interpréter avec une grande précision — le coût d’une erreur dépasse largement celui des tokens.
- Agent de codage autonome : exécuter des commandes sur de longues chaînes dans un terminal sandbox, construire un programme complet ; l’écart sur ProgramBench influence directement le taux de réussite des tâches.
- Requêtes peu fréquentes mais à forte valeur : volume d’appels modeste, mais chaque résultat pèse sur la décision ; dans ce cas, un prix de sortie 11 fois plus élevé reste marginal dans le budget total.
Quand choisir Qwen4-Max
- Tâches textuelles à haut débit : beaucoup de traitement de documents, de résumés et d’extractions chaque jour ; un écart de prix de sortie de 11,1 fois détermine directement la facture mensuelle.
- Agents bureautiques : circulation de formulaires, traitement de documents commerciaux, workflows automatisés — Qwen4-Max obtient déjà de meilleurs scores.
- Entrées très longues et sorties très longues : contrats de plusieurs centaines de K, revue intégrale d’un dépôt de code, ou rapports de plusieurs centaines de milliers de tokens à générer en une seule fois.
Recommandations de décision entre Qwen4-Max et GPT-6 Astra
Pour les équipes qui utilisent déjà Astra et dont le budget est serré, l’approche la plus raisonnable reste le routage hybride plutôt qu’un basculement global. Les trois types de requêtes — graphiques, terminal, vidéo — continuent d’aller à Astra, le reste (texte et Agents bureautiques) migre vers la gamme Qwen, et on ramène les requêtes à long contexte d’Astra sous 272K. On conserve ainsi ce sur quoi Astra est réellement en avance, tout en supprimant la part de coût où l’écart de prix est le plus fort.
Avant de changer de modèle, je vous conseille de vérifier trois points dans cet ordre :
- Vérifier le nom du modèle : dans la liste des modèles d’APIYI apiyi.com, confirmez que
gpt-6-astraetqwen3.8-maxsont disponibles, et surveillez le statut de mise en ligne deqwen4-max. Ne remplissez pas l’ID de modèle de mémoire. - Vérifier les tarifs : contrôlez les trois prix unitaires — entrée, sortie, lecture de cache — ainsi que le palier d’entrée à 20 $ d’Astra au-delà de 272 001 tokens. Recalculez votre facture mensuelle à partir de la distribution réelle des tokens dans vos logs.
- Vérifier le protocole : les deux modèles s’appellent via l’interface compatible OpenAI à l’adresse
https://api.apiyi.com/v1; il suffit de définirbase_urlsur cette adresse lors de l’initialisation du SDK. Astra prend en charge à la fois/v1/responseset/v1/chat/completions; si vous devez ajuster le niveau de raisonnement avecreasoning.effort, je vous recommande de valider d’abord le comportement des paramètres sur l’endpoint Responses.
💡 Conseil de sélection : envoyez un même échantillon de requêtes métier à
gpt-6-astraet à un modèle de la gamme Qwen, puis notez le taux de réponses correctes et le coût par requête — c’est plus fiable que de regarder les classements. Avec APIYI apiyi.com, une seule clé API et un changement du paramètremodelsuffisent pour faire la comparaison ; les nouveaux utilisateurs disposent en plus d’un quota de test gratuit pour commencer sur un petit échantillon.
FAQ – Questions fréquentes
Q1 : Comment se positionnent respectivement Qwen4-Max et GPT-6 Astra ?
Qwen4-Max est sorti le 16 novembre 2026, avec une architecture 2,4 T de paramètres totaux / 71 B activés, supportant la vision native et une fenêtre de contexte de 1 M. GPT-6 Astra est le modèle généraliste le plus puissant actuellement en service chez OpenAI, avec une fenêtre de contexte de 1 050 000 tokens et cinq niveaux de raisonnement, de low à max.
Q2 : Astra coûte bien plus cher – les points gagnés en plus valent-ils le coup ?
Tout dépend de la tâche. Sur la compréhension de graphiques (+16,9), ProgramBench (+23,5), Terminal-Bench (+10,6) et la compréhension vidéo (+8,6), l’avantage d’Astra est bien réel : pour ces tâches, le surcoût se justifie. En revanche, sur les agents bureautiques, HLAB-Vals et AA-Briefcase, Qwen4-Max obtient de meilleurs scores à un prix inférieur – payer Astra n’a alors aucun intérêt.
Q3 : Ces benchmarks sont-ils fiables ?
Les 15 benchmarks sont des comparaisons sur la même figure, rapportées par Qwen lui-même : ce sont des données de première main, à prendre avec un peu de recul. Le snapshot du classement public arena (14 novembre 2026) peut servir de référence croisée tierce, et l’écart entre les deux sur WebDev reste également limité à 13 Elo. À noter toutefois que Qwen4-Max est encore marqué « Preliminary » dans le classement, avec peu de votes.
Q4 : Comment fonctionne la règle d’Astra au-delà de 272 K d’entrée ?
Lorsqu’une requête dépasse 272 K tokens d’entrée, l’entrée et le cache de toute la requête sont facturés à 2×, et la sortie à 1,5×. Le surcoût s’applique à la requête entière, pas seulement à la partie excédentaire. Par exemple, 400 K d’entrée plus 20 K de sortie coûtent environ 9,50 $, soit environ 2,5× le prix d’une requête de 270 K d’entrée avec la même sortie.
Q5 : Peut-on déjà appeler Qwen4-Max via APIYI ?
Pour l’instant, `qwen4-max` n’est pas encore disponible au catalogue, mais nous allons l’ajouter dès que possible. En attendant, vous pouvez valider vos workflows de la famille Qwen avec `qwen3.8-max` (1,65 $ / 4,95 $ / lecture de cache 0,20625 $). `gpt-6-astra` est déjà disponible ; l’adresse d’accès unifiée est `https://api.apiyi.com/v1`, et les modèles exacts disponibles sont à vérifier dans la liste de modèles sur apiyi.com.
Q6 : Quelles sont les faiblesses reconnues de Qwen4-Max ?
La compréhension de graphiques, la compréhension vidéo, les longues chaînes d’opérations en terminal et ProgramBench sont nettement en retrait face à Astra, et HealthBench Professional est également 6 points en dessous. Si votre cœur de métier repose sur ces scénarios, passer à Qwen4-Max uniquement pour économiser risque de compenser les économies par un taux de réussite plus faible.
Qwen4-Max face à GPT-6 Astra : les points clés
- Écart tarifaire : le tarif d’entrée d’Astra est 6,7 fois celui de Qwen4-Max, le tarif de sortie 11,1 fois, et la lecture du cache 13,3 fois.
- Vrais atouts d’Astra : Chartography 71,1 contre 54,2 ; Video-Index 76,7 contre 68,1 ; il devance aussi Qwen4-Max sur le terminal et la construction de dépôts de code.
- Vrais atouts de Qwen4 : HLAB-Vals 21,3 contre 7,1 ; AA-Briefcase 1686 contre 1569 ; et une meilleure performance globale sur les agents bureautiques.
- Le piège du contexte long : lorsque l’entrée d’Astra dépasse 272K, toute la requête est majorée : entrée ×2, sortie ×1,5.
- Limite de sortie : Qwen4-Max peut produire jusqu’à 393K de sortie, contre 128K pour Astra.
- Pour démarrer : sur APIYI, utilisez la même clé API pour comparer
gpt-6-astraaux modèles de la gamme Qwen ;qwen4-maxest en cours de mise en catalogue.
En résumé
Comparer Qwen4-Max et GPT-6 Astra nous amène à trois conclusions principales :
- Le surcoût d’Astra correspond à trois capacités concrètes : la compréhension de graphiques, le terminal et la construction de dépôts de code, ainsi que la compréhension vidéo. Pour ces tâches, cela justifie de payer ce modèle plus cher.
- Qwen4-Max n’est pas qu’une option bon marché : il obtient de meilleurs scores sur les agents bureautiques et plusieurs évaluations spécialisées, avec en plus une limite de sortie plus élevée.
- Le contexte long mérite un calcul à part : le seuil de 272K d’Astra fait grimper le coût d’une requête. Réduire l’entrée sous ce seuil en tronquant les passages récupérés est le moyen le plus direct de faire des économies.
Pour la plupart des équipes, un routage mixte selon les tâches est plus rentable qu’un basculement complet. Je vous recommande de faire un test A/B sur APIYI (apiyi.com) avec de vrais échantillons métier, puis de décider de la répartition entre les différents types de requêtes.
📚 Références
- Documentation des modèles OpenAI – GPT-6 Astra : spécifications, contexte et niveaux de raisonnement
- Lien :
developers.openai.com/api/docs/models/gpt-6-astra -
Description : source originale pour la longueur de contexte, les limites d’entrée et de sortie maximales, et les niveaux de
reasoning.effort -
Page tarifaire OpenAI : prix standard et règles de facturation au-delà de 272K
- Lien :
developers.openai.com/api/docs/pricing -
Description : prix unitaires d’entrée, de sortie et de lecture/écriture du cache, ainsi que la règle de majoration appliquée à l’ensemble de la facture pour les contextes longs
-
Classement arena.ai Code Arena WebDev : classement public tiers (instantané du 2026-11-14)
- Lien :
arena.ai - Description : référence croisée des positions Elo, du nombre de votes et du coût par tâche
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, rendez-vous sur le centre de documentation docs.apiyi.com


