
Nota del autor: este artículo compara las puntuaciones de benchmark, las especificaciones de contexto y los precios de entrada y salida de Qwen4-Max y GPT-6 Astra, y explica qué modelo conviene más según el tipo de tarea.
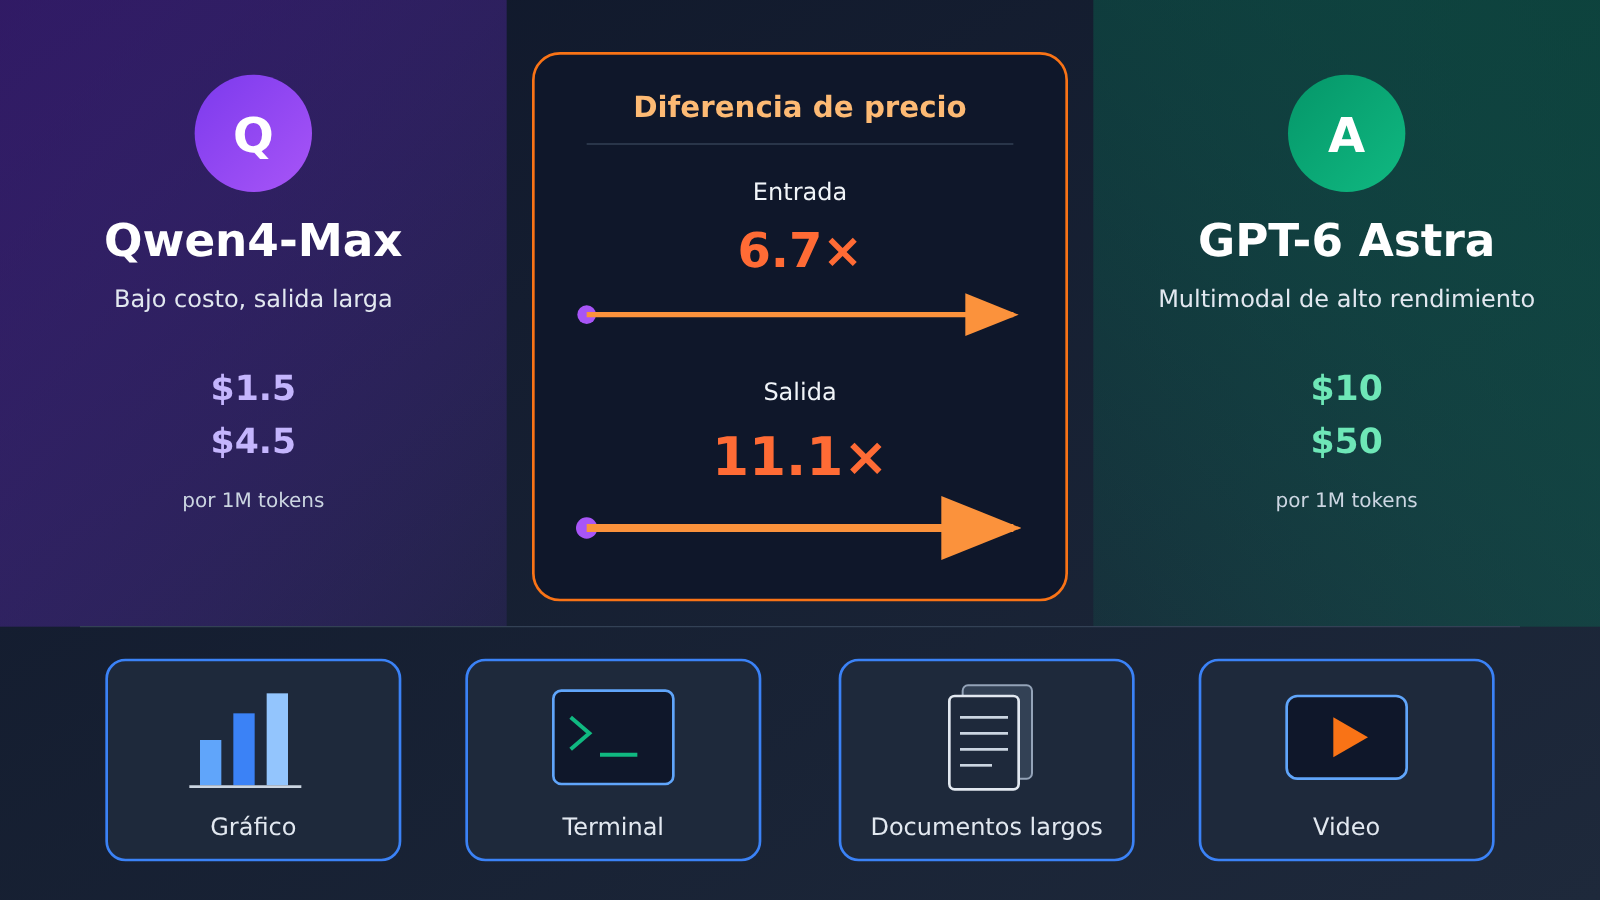
Vamos directo a la conclusión: el precio de entrada de GPT-6 Astra es aproximadamente 6,7 veces el de Qwen4-Max, y el de salida, unas 11,1 veces más alto. Esa prima de precio compra algo muy concreto: mejores puntuaciones sobre todo en tres tipos de tareas: comprensión de gráficos, manejo de terminal y repositorios de código, y comprensión de video. En agentes de ofimática y en algunas evaluaciones profesionales, Qwen4-Max va por delante.
Este no es un artículo de “quién aplasta a quién en todo”. Cada modelo tiene fortalezas claras y también debilidades claras. Aquí solo comparo estos dos modelos. Las fuentes de los datos se dividen en cuatro tipos: la comparación sobre el mismo gráfico reportada por la propia Qwen, la documentación original de OpenAI, una instantánea del ranking público de arena (2026-11-14) y la lista de precios de la plataforma APIYI.
El valor clave: después de leer este artículo tendrás una tabla de selección según la tarea y el presupuesto, sabrás en qué se traduce el dinero extra que pagas por Astra y también cómo se calcula la regla de recargo para toda la solicitud cuando la entrada de Astra supera los 272K.
Diferencias clave entre Qwen4-Max y GPT-6 Astra
Primero, pongamos las especificaciones y los precios en una sola tabla. Los datos de especificaciones y precios provienen, respectivamente, de la lista de precios de QwenCloud y del texto original de la documentación de OpenAI; la fecha de consulta es 2026-11-16, y las unidades de precio son por cada 1M tokens.
| Dimensión de comparación | Qwen4-Max | GPT-6 Astra | Ventaja |
|---|---|---|---|
| Arquitectura / posicionamiento | Tronco de 2.4T / 71B activos + 328B N-gram Embedding, visión nativa | El modelo generalista más potente actualmente en servicio de OpenAI | Cada uno con su propio posicionamiento |
| Contexto | 1M | 1,050,000 | Prácticamente empatados |
| Entrada máxima | 991K (983K en modo de pensamiento) | 922K | Qwen4-Max |
| Salida máxima | 393K (cadena de pensamiento máxima de 262K) | 128K | Qwen4-Max |
| Niveles de razonamiento | Modo de pensamiento | reasoning.effort: low / medium / high / xhigh / max |
Astra es más granular |
| Precio de entrada | $1.5 | $10 (el doble cuando la entrada supera 272K) | Qwen4-Max |
| Precio de salida | $4.5 | $50 (1.5 veces cuando la entrada supera 272K) | Qwen4-Max |
| Fecha de corte de conocimiento | No indicada en los materiales de referencia | 2026-04-30 | — |
Diferencia de contexto entre Qwen4-Max y GPT-6 Astra
Ambos declaran un contexto del orden de 1M; la diferencia está en el reparto entre entrada y salida. Qwen4-Max puede generar hasta 393K tokens de una sola vez, y ese límite resulta muy útil para la generación de informes largos, la reescritura de grandes bloques de código y la extracción estructurada por lotes. El límite de salida de Astra es de 128K, suficiente para tareas cotidianas, pero requiere segmentación cuando se trata de generaciones muy largas.
En cuanto a la entrada máxima, los 991K de Qwen4-Max también superan ligeramente los 922K de Astra. A la hora de elegir, lo que más merece la pena tener en cuenta es el umbral de facturación de Astra: en cuanto la entrada supera los 272K, el precio unitario de toda la solicitud sube. La sección de costes más abajo hará esa cuenta por separado.
Qwen4-Max vs. GPT-6 Astra: las puntuaciones, punto por punto
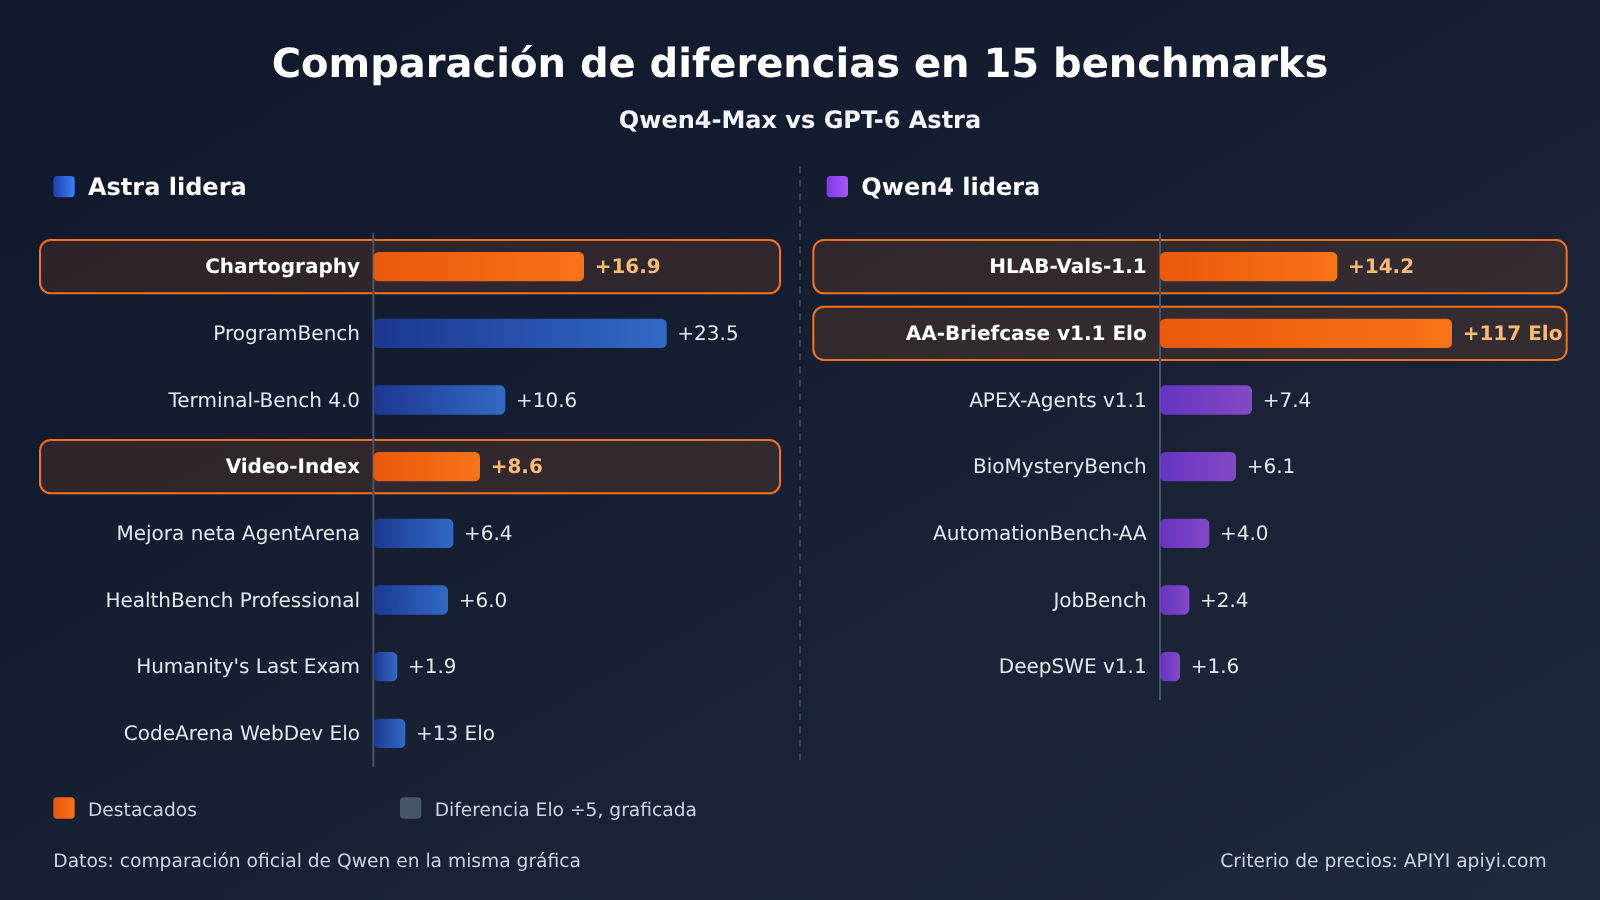
Las siguientes puntuaciones son todas comparaciones sobre el mismo gráfico autoinformadas por Qwen. Este tipo de comparación la publica una de las partes, así que conviene leerla con cierto margen. Aun así, el propio Qwen también enumera en la tabla varias ventajas claras de Astra, lo que les da una credibilidad relativamente mayor.
| Benchmark | Qwen4-Max | GPT-6 Astra | Diferencia | Líder |
|---|---|---|---|---|
| Chartography | 54.2 | 71.1 | 16.9 | Astra |
| ProgramBench | 31.5 | 55.0 | 23.5 | Astra |
| Terminal-Bench 4.0 | 48.5 | 59.1 | 10.6 | Astra |
| Video-Index | 68.1 | 76.7 | 8.6 | Astra |
| AgentArena Net Improvement | 7.5 | 13.9 | 6.4 | Astra |
| HealthBench Professional | 60.0 | 66.0 | 6.0 | Astra |
| Humanity’s Last Exam | 51.7 | 53.6 | 1.9 | Astra |
| CodeArena WebDev Elo | 1750 | 1763 | 13 | Astra |
| HLAB-Vals-1.1 | 21.3 | 7.1 | 14.2 | Qwen4 |
| AA-Briefcase v1.1 Elo | 1686 | 1569 | 117 | Qwen4 |
| APEX-Agents v1.1 | 72.1 | 64.7 | 7.4 | Qwen4 |
| BioMysteryBench | 85.0 | 78.9 | 6.1 | Qwen4 |
| AutomationBench-AA | 72.5 | 68.5 | 4.0 | Qwen4 |
| JobBench | 68.5 | 66.1 | 2.4 | Qwen4 |
| DeepSWE v1.1 | 75.7 | 74.1 | 1.6 | Qwen4 |
Las ventajas reales de GPT-6 Astra: gráficos, terminal y video
La mayor brecha está en la comprensión de gráficos. En Chartography, Astra obtiene 71.1 y Qwen4-Max 54.2, una diferencia de 16.9 puntos. Si tu negocio necesita leer gráficos de informes financieros, capturas de paneles de monitoreo o gráficos científicos, esta diferencia se notará directamente en la precisión de extracción, y no será fácil compensarla solo con indicaciones.
La terminal y el repositorio de código son el segundo bloque. En Terminal-Bench 4.0 la diferencia es de 10.6 puntos, y en ProgramBench de 23.5 puntos. Estas dos pruebas miden la ejecución de comandos en varios pasos y la capacidad de construir programas completos, que son justo los aspectos más exigentes para un agente de codificación. En DeepSWE, Qwen4-Max gana por poco, con 1.6 puntos de ventaja, lo que indica que su capacidad para resolver un issue individual no es débil. Cuando la tarea pasa a ser “montar un proyecto en la terminal mediante una cadena larga de pasos”, Astra es más sólido.
La comprensión de video no se puede pasar por alto. En Video-Index, Astra obtiene 76.7 frente a 68.1, una ventaja de 8.6 puntos. Aunque Qwen4-Max tiene soporte nativo para visión, en comprensión de video todavía se queda atrás. Los equipos que necesitan moderar contenido de video, buscar fragmentos o resumir videos educativos deberían poner este criterio al principio de su lista de selección.
Las ventajas reales de Qwen4-Max: agentes para tareas de oficina y evaluaciones especializadas
HLAB-Vals-1.1 es el punto en el que Qwen4-Max lidera de forma más clara: 21.3 frente a 7.1, una diferencia absoluta de 14.2 puntos y casi el triple en términos proporcionales. En AA-Briefcase v1.1 Elo, lidera por 117 puntos (1686 frente a 1569). Este tipo de evaluación favorece tareas de agentes centradas en documentos comerciales y procesos de oficina; en el sistema Elo, una diferencia de 117 puntos es bastante llamativa.
En APEX-Agents (+7.4), AutomationBench-AA (+4.0) y JobBench (+2.4), Qwen4-Max también va por delante. Si se miran en conjunto, la conclusión es clara: en escenarios de automatización de procesos y agentes para tareas de oficina, Qwen4-Max no solo es más barato; también obtiene mejores puntuaciones.
Instantánea del ranking público de Code Arena (2026-11-14)
Los rankings de terceros pueden servir como referencia cruzada. La instantánea del ranking público de Code Arena WebDev de arena.ai muestra que GPT-6 Astra (Max) ocupa el 5.º puesto con 1.763 puntos, 8.685 votos y un coste por tarea de $9,43. Qwen4-Max (xHigh) ocupa el 6.º puesto con 1.750 puntos, marcado como Preliminary, 1.814 votos y un coste por tarea de $4,18.
Una diferencia de 13 puntos Elo en el escenario WebDev corresponde al mismo nivel, pero el coste por tarea es más del doble. Cabe señalar que Qwen4-Max aún tiene menos votos y su posición puede seguir fluctuando, por lo que conviene observarlo de forma continua.
Comparación de precios de entrada y salida entre Qwen4-Max y GPT-6 Astra
La tabla de precios se divide en dos partes: precio oficial y precio actual de APIYI. Los precios oficiales provienen de los documentos originales de QwenCloud y OpenAI, con fecha de extracción 2026-11-16, en unidades por 1M tokens.
| Concepto de facturación | Qwen4-Max (QwenCloud) | GPT-6 Astra (documento original de OpenAI) | Múltiplo |
|---|---|---|---|
| Entrada | $1.5 | $10 | 6.7× |
| Salida | $4.5 | $50 | 11.1× |
| Lectura de caché | $0.075 | $1 | 13.3× |
| Escritura de caché | 5 minutos $1.875 / 1 hora $3 | $12.5 | 4.2–6.7× |
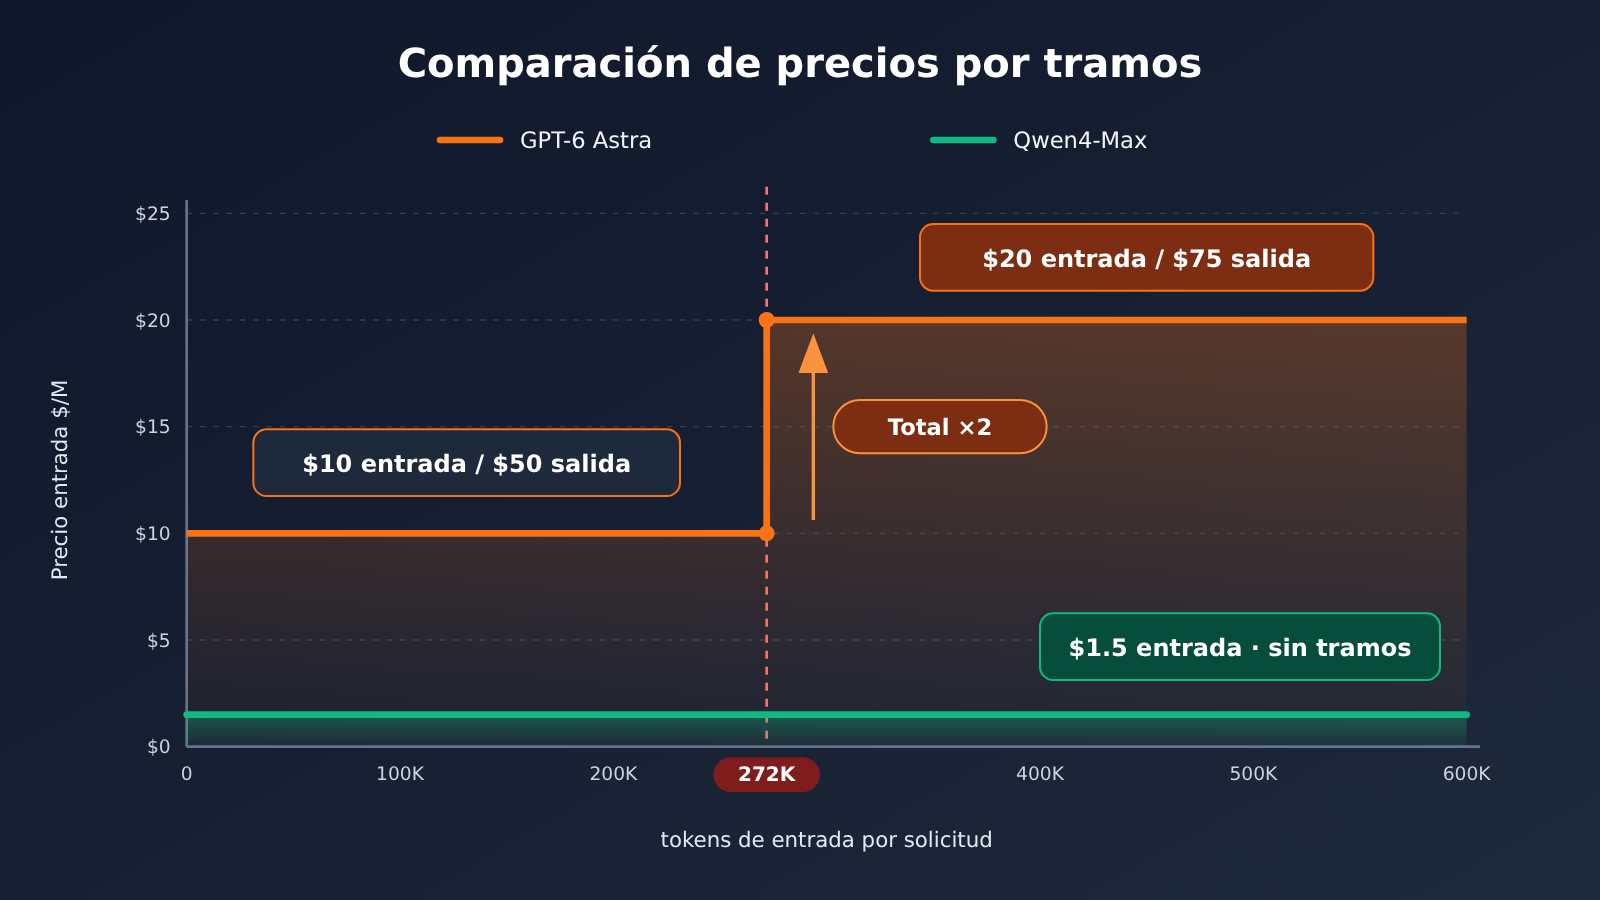
| Entrada superior a 272K | La referencia no detalla escalonamiento | Pedido completo: entrada y caché ×2, salida ×1.5 | — |
GPT-6 Astra: la trampa del doble precio con entradas que superan 272K
La regla en la documentación de OpenAI es clara: cuando la entrada de una sola solicitud supera los 272K, toda la solicitud se factura con la entrada y el caché al doble, y la salida a 1.5 veces. Aquí el recargo no se aplica solo a la parte que excede los 272K, sino que toda la solicitud se cobra a precio alto. Muchos equipos, al estimar el costo de RAG sobre documentos largos o del contexto completo de un repositorio de código, suelen pasar por alto esta regla.
Hagamos el cálculo con algunos tipos de solicitud típicos. Usamos el precio estándar oficial y, por ahora, no contamos el caché.
| Escenario | Qwen4-Max | GPT-6 Astra | Diferencia |
|---|---|---|---|
| 270K de entrada + 20K de salida en una sola solicitud | ~$0.50 | ~$3.70 | ~7.4× |
| 400K de entrada + 20K de salida en una sola solicitud | ~$0.69 | ~$9.50 (ya activa la regla de 272K) | ~13.8× |
| 100 millones de entrada + 10 millones de salida mensuales (todas las solicitudes dentro de 272K) | ~$195 | ~$1,500 | ~7.7× |
| Igual que arriba, pero todas las solicitudes son de contexto largo por encima de 272K | ~$195 (estimado a precio estándar) | ~$2,750 | ~14× |
La segunda fila es la que mejor ilustra el problema. La entrada pasa de 270K a 400K, los tokens aumentan menos de la mitad, pero el costo por solicitud de Astra salta de $3.70 a $9.50. Por eso, al diseñar un flujo de contexto largo para Astra, conviene mantener la entrada de cada solicitud por debajo de 272K. Se puede hacer primero un recorte por recuperación o un resumen por fragmentos, y luego pasar el resultado a Astra para la inferencia final.
Precios actuales y disponibilidad de modelos en APIYI
Esta es la lista de precios actual de APIYI (2026-11-16). La referencia definitiva es siempre el catálogo de modelos de la plataforma.
gpt-6-astra: entrada $10, salida $50, lectura de caché $1; la entrada en el tramo de 272,001–1,050,000 tokens cuesta $20, igual que la escala oficial.qwen3.8-max: entrada $1.65, salida $4.95, lectura de caché $0.20625.qwen4-max: aún no disponible; lo publicaremos lo antes posible. Cuando esté disponible, el ID del modelo y el precio se consultan en la lista de modelos de apiyi.com.
💰 Consejo de costes: antes de que
qwen4-maxesté disponible, puedes usarqwen3.8-maxpara validar las indicaciones y el flujo de invocación de herramientas de la familia Qwen; cuando llegue el nuevo modelo, basta cambiar el parámetromodel. Ambas familias usan la misma clave en APIYI apiyi.com y la factura se consulta en el mismo sitio, así que comparar el gasto real de cada lado es muy sencillo.
Cómo elegir entre Qwen4-Max y GPT-6 Astra según la tarea
Poniendo los benchmarks y los precios sobre la mesa, podemos dar recomendaciones según el tipo de tarea.
| Tipo de tarea | Recomendación | Base | Plataformas disponibles |
|---|---|---|---|
| Comprensión de gráficos / capturas | GPT-6 Astra | Lidera Chartography por 16.9 puntos | APIYI apiyi.com, OpenAI oficial |
| Operación de terminal y construcción de repositorios completos | GPT-6 Astra | Terminal-Bench +10.6, ProgramBench +23.5 | APIYI, OpenAI oficial |
| Comprensión de vídeo | GPT-6 Astra | Lidera Video-Index por 8.6 puntos | APIYI, OpenAI oficial |
| Corrección de un solo issue / WebDev | Qwen4-Max (mejor relación calidad-precio) | DeepSWE gana por poco, WebDev solo difiere 13 Elo, coste por tarea de aproximadamente la mitad | QwenCloud; APIYI (pendiente de publicación) |
| Agentes de oficina y automatización de procesos | Qwen4-Max | AA-Briefcase +117, APEX +7.4, HLAB-Vals +14.2 | QwenCloud; APIYI (pendiente de publicación) |
| Procesamiento por lotes con contexto largo (>272K) | Qwen4-Max | Sin el recargo de Astra sobre el total, salida máxima de 393K | QwenCloud; APIYI (pendiente de publicación) |
| Consultas médicas especializadas | GPT-6 Astra | Lidera HealthBench Professional por 6.0 | APIYI, OpenAI oficial |
Cuándo conviene elegir GPT-6 Astra
- Control de calidad multimodal: gráficos, capturas de dashboards y fragmentos de vídeo que exigen una interpretación muy precisa; el coste de un error supera con mucha diferencia el gasto en tokens.
- Agentes de código autónomos: cuando hay que ejecutar comandos en cadenas largas dentro de una terminal sandbox y montar un programa completo, la diferencia en ProgramBench afecta directamente la tasa de éxito.
- Solicitudes poco frecuentes pero de alto valor: el volumen de invocaciones es bajo, pero cada resultado influye en las decisiones; aquí el precio de salida 11 veces mayor representa una parte limitada del presupuesto total.
Cuándo conviene elegir Qwen4-Max
- Tareas de texto de alto volumen: procesamiento diario de muchos documentos, resúmenes y extracción; la diferencia de 11.1 veces en el precio de salida decide directamente la factura mensual.
- Agentes de oficina: circulación de formularios, gestión de documentos comerciales y flujos automatizados; de hecho, Qwen4-Max ya obtiene mejores puntuaciones.
- Entradas y salidas muy largas: contratos de varios centenares de K, revisión completa de repositorios de código e informes que deben generarse de una vez con cientos de miles de tokens.
Recomendaciones de decisión entre Qwen4-Max y GPT-6 Astra
Para los equipos que ya usan Astra y tienen el presupuesto ajustado, la opción más sensata es el enrutamiento híbrido, en lugar de un cambio total de modelo. Las tres categorías de solicitudes —gráficos, terminal y video— se siguen enviando a Astra; el resto de las solicitudes de texto y de agentes de oficina se migran a la familia Qwen, y las solicitudes de contexto largo de Astra se recortan a un máximo de 272K. Así se conservan las capacidades en las que Astra realmente lidera y se elimina la parte del gasto donde la diferencia de precio es mayor.
Antes de cambiar de modelo, conviene verificar estos tres pasos:
- Revisar los identificadores: en la lista de modelos de APIYI apiyi.com, confirma si
gpt-6-astrayqwen3.8-maxestán disponibles, y presta atención al estado de publicación deqwen4-max; no rellenes el ID del modelo de memoria. - Comparar precios: revisa los tres precios unitarios —entrada, salida y lectura de caché— y también el tramo de entrada de $20 de Astra para más de 272,001 tokens. Calcula la factura mensual usando la distribución real de tokens de tus propios logs.
- Revisar el protocolo: ambos modelos se pueden invocar mediante la interfaz compatible con OpenAI en
https://api.apiyi.com/v1; basta con establecerbase_urla esa dirección al inicializar el SDK. Astra admite a la vez los endpoints/v1/responsesy/v1/chat/completions; cuando necesites ajustar el nivel de razonamiento conreasoning.effort, se recomienda validar primero el comportamiento de los parámetros en el endpoint Responses.
💡 Recomendación de elección: enviar el mismo lote de muestras de negocio a
gpt-6-astray a los modelos de la familia Qwen, registrando la tasa de acierto y el costo por solicitud, es más fiable que mirar los rankings. Con APIYI apiyi.com basta cambiar el parámetromodelcon una sola clave API para hacer la comparación; además, los usuarios nuevos tienen cuota de prueba gratuita para correr primero una muestra pequeña.
Preguntas frecuentes
Q1: ¿Cuál es el posicionamiento de Qwen4-Max y de GPT-6 Astra?
Qwen4-Max se lanzó el 2026-11-16, con una arquitectura de 2.4T parámetros totales / 71B activos, visión nativa y 1M de contexto. GPT-6 Astra es el modelo generalista más potente de OpenAI en la actualidad, con una ventana de contexto de 1,050,000 tokens y cinco niveles de esfuerzo de razonamiento, de low a max.
Q2: Astra cuesta bastante más, ¿merece la pena pagar por esa diferencia de puntuación?
Depende de la tarea. En comprensión de gráficos (+16.9), ProgramBench (+23.5), Terminal-Bench (+10.6) y comprensión de vídeo (+8.6), la ventaja de Astra es real y sólida, y para estas tareas vale la pena pagar el sobreprecio. En cambio, en agentes de ofimática, HLAB-Vals y AA-Briefcase, Qwen4-Max obtiene mejor puntuación a menor precio, así que pagar más por Astra deja de tener sentido.
Q3: ¿Son fiables estas puntuaciones de benchmarks?
Los 15 benchmarks son comparaciones sobre el mismo gráfico reportadas por el propio equipo de Qwen, es decir, datos de parte interesada, así que conviene leerlos dejando margen. El snapshot del ranking público de arena (2026-11-14) sirve como referencia cruzada de terceros, y la diferencia en WebDev también es de solo 13 Elo. Aun así, Qwen4-Max sigue marcado como Preliminary en el ranking y tiene menos votos.
Q4: ¿Cómo se calcula la regla de Astra para entradas de más de 272K?
Cuando la entrada de una sola petición supera 272K, la entrada y la caché de toda la petición se facturan al doble, y la salida a 1.5 veces. El recargo se aplica a la petición completa, no solo a la parte que excede el límite. Por ejemplo, 400K de entrada más 20K de salida cuesta unos $9.50, aproximadamente 2.5 veces lo que costaría con 270K de entrada y la misma salida.
Q5: ¿Se puede llamar ya a Qwen4-Max a través de APIYI?
Por ahora `qwen4-max` todavía no está disponible en el catálogo; lo publicaremos lo antes posible. Mientras tanto, puedes usar `qwen3.8-max` ($1.65 / $4.95 / lectura de caché $0.20625) para validar tus flujos de trabajo de la familia Qwen. `gpt-6-astra` ya está disponible, y la dirección de acceso unificada es `https://api.apiyi.com/v1`; consulta la lista de modelos en apiyi.com para ver los identificadores concretos.
Q6: ¿Qué puntos débiles claros tiene Qwen4-Max?
Va claramente por detrás de Astra en comprensión de gráficos, comprensión de vídeo, operaciones de cadena larga en terminal y ProgramBench, y también queda 6 puntos por debajo en HealthBench Professional. Si el núcleo de tu negocio cae en estos escenarios, cambiar a Qwen4-Max solo para ahorrar podría acabar compensando el ahorro con una tasa de éxito más baja.
Qwen4-Max frente a GPT-6 Astra: puntos clave
- Diferencia de precio: el precio de entrada de Astra es 6,7 veces el de Qwen4-Max; el de salida, 11,1 veces; y la lectura de caché, 13,3 veces.
- Ventajas reales de Astra: Chartography 71,1 frente a 54,2; Video-Index 76,7 frente a 68,1; también lidera en terminal y construcción de repositorios de código.
- Ventajas reales de Qwen4: HLAB-Vals 21,3 frente a 7,1; AA-Briefcase 1686 frente a 1569; el agente de oficina en conjunto es más potente.
- La trampa del contexto largo: cuando la entrada de Astra supera 272K, se aplica un recargo a toda la solicitud: entrada ×2, salida ×1,5.
- Límite de salida: Qwen4-Max puede generar hasta 393K; Astra, 128K.
- Cómo empezar: en APIYI apiyi.com, usa la misma clave API para comparar
gpt-6-astracon modelos de la familia Qwen;qwen4-maxestá en proceso de publicación.
Resumen
Al comparar Qwen4-Max con GPT-6 Astra, hay tres conclusiones principales:
- El sobreprecio de Astra corresponde a tres capacidades reales: comprensión de gráficos, construcción en terminal y repositorios de código, y comprensión de video. Son tareas que justifican pagar por él.
- Qwen4-Max no es solo barato: obtiene mejores puntuaciones en agentes de oficina y varias evaluaciones profesionales, además de tener un límite de salida mayor.
- El contexto largo hay que calcularlo aparte: el umbral de 272K de Astra hace que el coste por solicitud se dispare. Recortar la entrada mediante recuperación para dejarla por debajo de ese umbral es la forma más directa de ahorrar.
Para la mayoría de los equipos, enrutar de forma mixta según la tarea sale más rentable que migrar por completo. Recomendamos hacer una comparación A/B con muestras reales de negocio en APIYI apiyi.com y, después, decidir qué proporción de cada tipo de solicitud asignar.
📚 Referencias
- Documentación del modelo OpenAI – GPT-6 Astra: especificaciones, contexto y niveles de razonamiento
- Enlace:
developers.openai.com/api/docs/models/gpt-6-astra -
Descripción: fuente original de la longitud de contexto, entrada/salida máxima y los niveles de
reasoning.effort -
Página de precios de OpenAI: precio estándar y reglas de facturación por encima de 272K
- Enlace:
developers.openai.com/api/docs/pricing -
Descripción: precios unitarios de entrada, salida, lectura/escritura de caché, y la regla de recargo sobre el total de la factura para contextos largos
-
Clasificación Code Arena WebDev de arena.ai: clasificación pública de terceros (fecha de instantánea: 2026-11-14)
- Enlace:
arena.ai - Descripción: referencia cruzada de clasificación Elo, número de votos y coste por tarea
Autor: equipo técnico de APIYI
Contacto técnico: puedes contactarnos desde la página principal del sitio de APIYI; para más materiales, visita el centro de documentación en docs.apiyi.com


