
著者注:本記事では Qwen4-Max と GPT-6 Astra のベンチマークスコア、コンテキスト仕様、入力・出力価格を比較し、タスク種別ごとにどちらが割安かを説明します。
先に結論:GPT-6 Astra の入力価格は Qwen4-Max の約 6.7倍、出力価格は約 11.1倍 です。この割高分で得られるものは具体的で、主にグラフ理解、ターミナルとコードリポジトリ操作、動画理解という3種類のタスクでより高いスコアを取れます。一方、オフィス系 Agent と一部の専門評価では、Qwen4-Max が逆にリードしています。
これは「どちらが全面的に圧勝するか」を論じる記事ではありません。2つのモデルにはそれぞれ明確な強みがあり、明確な弱みもあります。本記事ではこの2モデルだけを比較し、事実の出典は次の4種類です。Qwen 公式の自己申告による同一図表中の比較、OpenAI ドキュメントの原文、arena 公開ランキングのスナップショット(2026-11-14)、そして APIYI プラットフォームの価格表です。
本記事の価値:読み終えると、タスクと予算別に整理したモデル選定表が手に入り、Astra に多く支払う分がどこに使われているのか、そして Astra の入力が 272K を超えた後にリクエスト全体へ追加料金がかかるルールの計算方法も分かります。
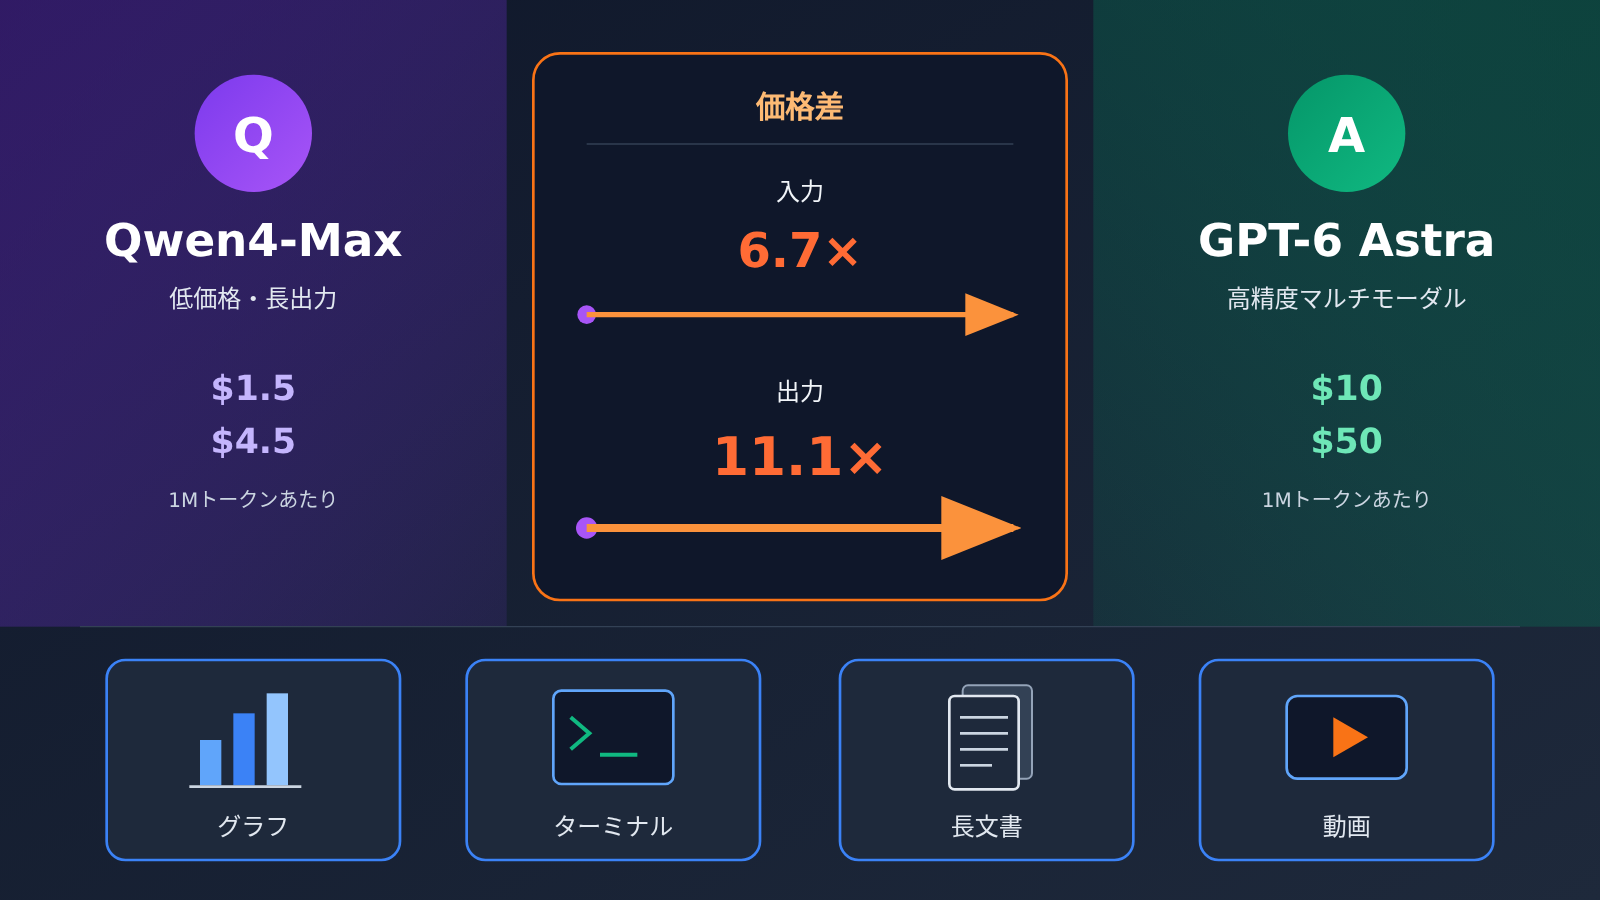
Qwen4-Max と GPT-6 Astra の核心的な違い
まず仕様と価格を1つの表にまとめます。仕様と価格のデータはそれぞれ QwenCloud の価格表と OpenAI のドキュメント原文から取得し、取得日は 2026-11-16、価格の単位はいずれも 1M tokens あたりです。
| 比較項目 | Qwen4-Max | GPT-6 Astra | 優位な側 |
|---|---|---|---|
| アーキテクチャ / 位置づけ | 2.4T バックボーン / 71B アクティブ + 328B N-gram Embedding、ネイティブ視覚 | OpenAI 現行最強の汎用モデル | それぞれに位置づけあり |
| コンテキスト | 1M | 1,050,000 | ほぼ同等 |
| 最大入力 | 991K(思考モード 983K) | 922K | Qwen4-Max |
| 最大出力 | 393K(最大推論チェーン 262K) | 128K | Qwen4-Max |
| 推論段階 | 思考モード | reasoning.effort:low / medium / high / xhigh / max |
Astra のほうが細かい |
| 入力価格 | $1.5 | $10(入力が 272K を超えると 2 倍) | Qwen4-Max |
| 出力価格 | $4.5 | $50(入力が 272K を超えると 1.5 倍) | Qwen4-Max |
| 知識カットオフ | 参考資料に記載なし | 2026-04-30 | — |
Qwen4-Max と GPT-6 Astra のコンテキストの違い
両モデルの公称コンテキストはどちらも 1M 規模で、違いは入力と出力の配分にあります。Qwen4-Max は1回で最大 393K tokens を出力でき、この上限は長いレポートの生成、大量のコードの書き換え、バッチでの構造化抽出に役立ちます。Astra の出力上限は 128K で、日常的なタスクには十分ですが、超長文の生成では分割が必要です。
最大入力については、Qwen4-Max の 991K が Astra の 922K よりやや多くなっています。実際のモデル選定でより注目すべきなのは Astra の課金しきい値です。入力が 272K を超えると、リクエスト全体の単価が上がります。この点は後述のコストのセクションで別途計算します。
Qwen4-Max と GPT-6 Astra のベンチマークを項目別に比較
以下のスコアはすべて Qwen 公式が自己申告した同一図面での対照結果 です。この種の同一図面比較は一方が公開したものなので、読む際には多少の余裕を持って解釈する必要があります。ただし、表の中で Astra が明らかに優位な項目については、Qwen 公式自身も記載しているため、相対的に信頼度は高いと言えます。
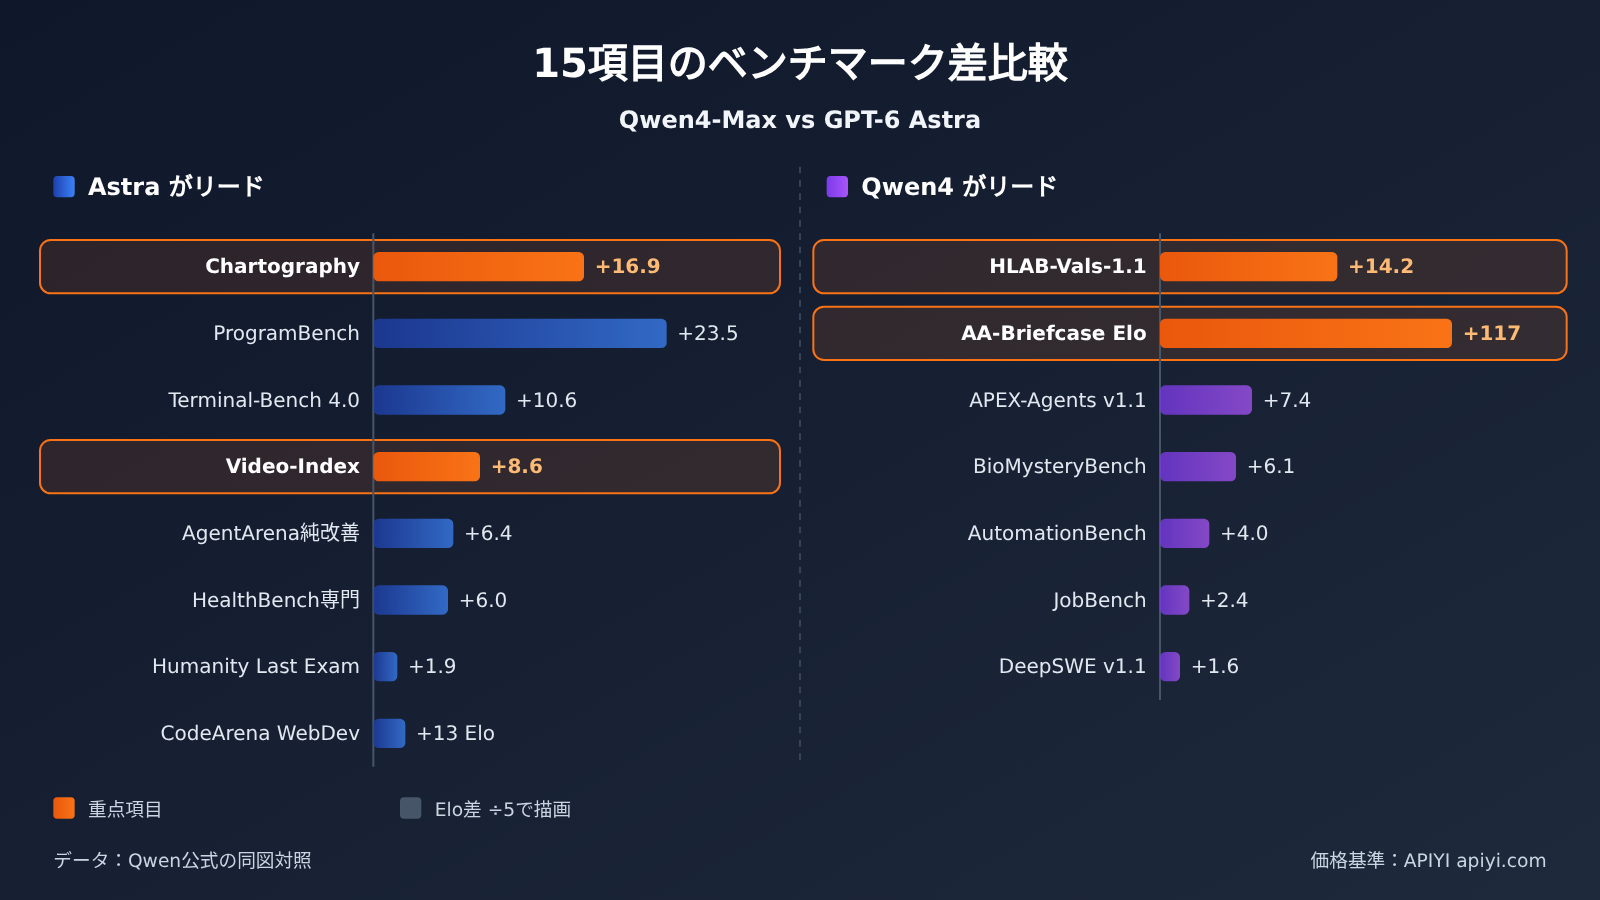
| ベンチマーク | Qwen4-Max | GPT-6 Astra | 差分 | リード側 |
|---|---|---|---|---|
| Chartography | 54.2 | 71.1 | 16.9 | Astra |
| ProgramBench | 31.5 | 55.0 | 23.5 | Astra |
| Terminal-Bench 4.0 | 48.5 | 59.1 | 10.6 | Astra |
| Video-Index | 68.1 | 76.7 | 8.6 | Astra |
| AgentArena Net Improvement | 7.5 | 13.9 | 6.4 | Astra |
| HealthBench Professional | 60.0 | 66.0 | 6.0 | Astra |
| Humanity’s Last Exam | 51.7 | 53.6 | 1.9 | Astra |
| CodeArena WebDev Elo | 1750 | 1763 | 13 | Astra |
| HLAB-Vals-1.1 | 21.3 | 7.1 | 14.2 | Qwen4 |
| AA-Briefcase v1.1 Elo | 1686 | 1569 | 117 | Qwen4 |
| APEX-Agents v1.1 | 72.1 | 64.7 | 7.4 | Qwen4 |
| BioMysteryBench | 85.0 | 78.9 | 6.1 | Qwen4 |
| AutomationBench-AA | 72.5 | 68.5 | 4.0 | Qwen4 |
| JobBench | 68.5 | 66.1 | 2.4 | Qwen4 |
| DeepSWE v1.1 | 75.7 | 74.1 | 1.6 | Qwen4 |
GPT-6 Astra の真の強み:チャート、ターミナル、動画
チャート理解の差が最も大きい。 Chartography では Astra が 71.1、Qwen4-Max が 54.2 で、16.9 点の差があります。決算資料のグラフ、監視ダッシュボードのスクリーンショット、研究用チャートを読む業務がある場合、この差は抽出精度に直接表れます。しかも、プロンプトで簡単に取り返せるものではありません。
ターミナルとコードリポジトリが2つ目の領域です。 Terminal-Bench 4.0 では 10.6 点、ProgramBench では 23.5 点の差があります。この2項目が測るのは、多段階のコマンド実行と、プログラム全体を構築する能力です。まさにコーディング Agent にとって最も重要な部分といえます。DeepSWE では Qwen4-Max が 1.6 点上回っており、単一の issue を修正する能力は決して弱くありません。ただし、ターミナル上で長い手順を踏んで1つのプロジェクトを構築する、といったタスクになると、Astra のほうが安定します。
動画理解も外せません。 Video-Index では Astra が 76.7、Qwen4-Max が 68.1 で、8.6 点リードしています。Qwen4-Max は視覚をネイティブにサポートしていますが、動画理解では依然として一歩後れを取っています。動画コンテンツの審査、シーン検索、教育動画の要約に取り組むチームは、モデル選定のチェックリストでこの項目を上位に置くべきです。
Qwen4-Max の真の強み:オフィス Agent と専門評価
HLAB-Vals-1.1 は、Qwen4-Max が最も明確にリードしている項目です。21.3 対 7.1 で、絶対スコア差は 14.2、比率にすると約3倍に達します。AA-Briefcase v1.1 の Elo でも 117 点リードしています(1686 対 1569)。こうした評価はビジネス文書やオフィス業務フロー系の Agent タスクに寄っており、Elo の評価体系において 117 点の差はかなり明白です。
APEX-Agents(+7.4)、AutomationBench-AA(+4.0)、JobBench(+2.4)も Qwen4-Max がリードしています。これらをまとめて見ると、結論は次のとおりです。プロセス自動化やオフィス系 Agent の場面では、Qwen4-Max は安いだけでなく、スコアも高いのです。
Code Arena 公開ランキングのスナップショット(2026-11-14)
サードパーティのランキングは相互参照として活用できます。arena.ai Code Arena WebDev の公開ランキングのスナップショットでは、GPT-6 Astra(Max)が1763点で5位、投票数8,685、タスクあたりのコストは$9.43です。Qwen4-Max(xHigh)は1750点で6位、Preliminary(暫定)と表記され、投票数は1,814、タスクあたりのコストは$4.18です。
WebDevシナリオにおける13点のElo差は同一水準に属しますが、タスクあたりのコストは2倍以上異なります。なお、Qwen4-Maxは投票数がまだ少ないため、順位は今後も変動する可能性があり、継続的に観察するのに適しています。
Qwen4-Max と GPT-6 Astra の入力・出力価格比較
価格表は公式価格と APIYI の現在価格の2部構成です。公式価格は QwenCloud と OpenAI のドキュメント原文に基づくもので、取得日は 2026-11-16、単位は 1M tokens あたりです。
| 課金項目 | Qwen4-Max(QwenCloud) | GPT-6 Astra(OpenAI ドキュメント原文) | 倍率 |
|---|---|---|---|
| 入力 | $1.5 | $10 | 6.7× |
| 出力 | $4.5 | $50 | 11.1× |
| キャッシュ読み | $0.075 | $1 | 13.3× |
| キャッシュ書き | 5分 $1.875 / 1時間 $3 | $12.5 | 4.2–6.7× |
| 272K を超える入力 | 参考資料に段階設定の記載なし | リクエスト全体の入力とキャッシュ ×2、出力 ×1.5 | — |
GPT-6 Astra で 272K を超える入力にかかる2倍課金の落とし穴
OpenAI のドキュメントでは、1回のリクエストの入力が 272K を超えると、リクエスト全体の入力とキャッシュが2倍、出力が1.5倍で課金されると規定されています。ここで割増されるのは 272K を超えた部分だけではなく、リクエスト全体が高い料金で計算されます。長文ドキュメントの RAG やコードリポジトリ全体のコンテキストのコストを見積もる際、多くのチームがこの点を見落としがちです。
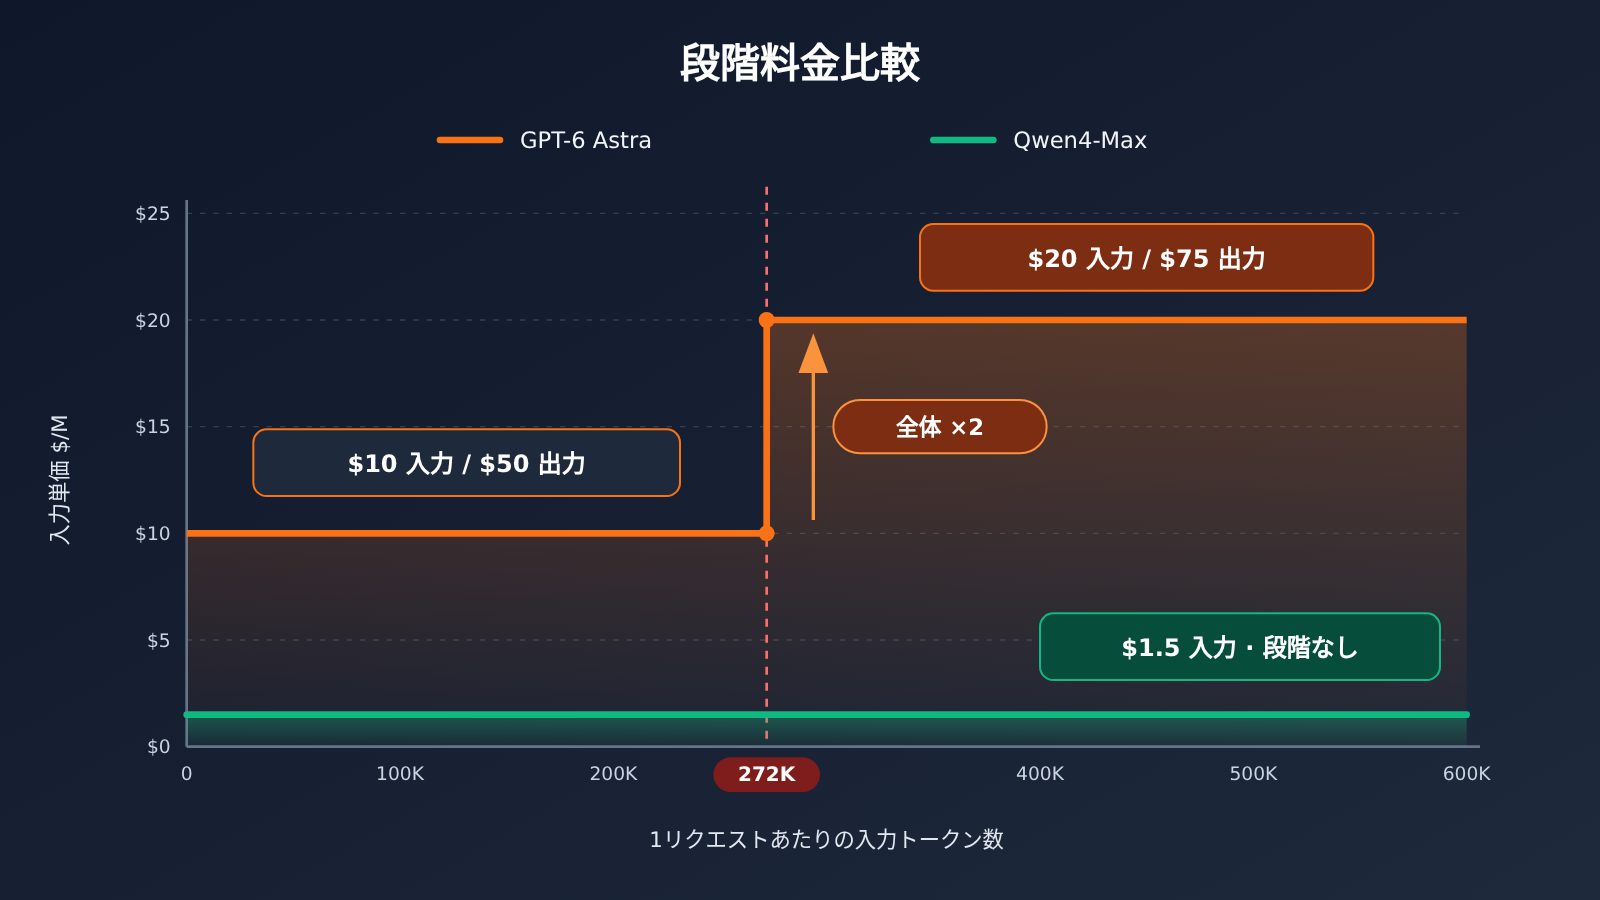
以下のようないくつかの典型的なリクエストで計算してみます。価格は公式の標準価格を用い、キャッシュは一旦考慮しません。
| シナリオ | Qwen4-Max | GPT-6 Astra | 差 |
|---|---|---|---|
| 1回 270K 入力 + 20K 出力 | 約 $0.50 | 約 $3.70 | 約 7.4× |
| 1回 400K 入力 + 20K 出力 | 約 $0.69 | 約 $9.50(272K ルール適用済み) | 約 13.8× |
| 月間 1億入力 + 1000万出力(すべて 272K 以内のリクエスト) | 約 $195 | 約 $1,500 | 約 7.7× |
| 同上、ただしすべて 272K 以上の長コンテキストリクエスト | 約 $195(標準価格で試算) | 約 $2,750 | 約 14× |
2行目が最も問題点をよく表しています。入力が 270K から 400K に増えても tokens は半分弱しか増えていないのに、Astra の1回あたりの費用は $3.70 から $9.50 へと跳ね上がります。そのため、Astra 向けに長コンテキストのフローを設計する際は、1回の入力を 272K 以内に収めるのがよいでしょう。まず検索結果の絞り込みやチャンク単位の要約を行い、その結果を Astra に渡して最終推論をさせる方法があります。
APIYI の現在価格とモデル掲載状況
APIYI の現在(2026-11-16)の価格は以下のとおりです。最終的にはプラットフォームのモデル一覧を基準とします。
gpt-6-astra:入力 $10、出力 $50、キャッシュ読み $1;272,001–1,050,000 tokens の区間の入力は $20 で、公式の段階料金と一致します。qwen3.8-max:入力 $1.65、出力 $4.95、キャッシュ読み $0.20625。qwen4-max:まだ未掲載です。このモデルはできるだけ早く掲載します。掲載後のモデル ID と価格は apiyi.com のモデル一覧を基準にしてください。
💰 コストに関する提案:
qwen4-maxが掲載される前に、まずqwen3.8-maxで Qwen 系のプロンプトとツール呼び出しのフローを一通り動作確認しておき、新しいモデルが公開されたらmodelパラメータを切り替えるだけで移行できます。両シリーズは APIYI apiyi.com 上で同じ Key を使用し、請求も同じ場所で確認できるため、双方の実際のコストを直接比較しやすくなります。
タスク別に Qwen4-Max か GPT-6 Astra を選ぶ
ベンチマークスコアと価格を並べて比較すると、タスクの種類ごとに推奨事項を提示できます。
| タスクの種類 | 推奨 | 根拠 | 利用可能なプラットフォーム |
|---|---|---|---|
| グラフ / スクリーンショットの理解 | GPT-6 Astra | Chartography で 16.9 点上回る | APIYI apiyi.com、OpenAI 公式 |
| ターミナル操作と完全なコードリポジトリの構築 | GPT-6 Astra | Terminal-Bench +10.6、ProgramBench +23.5 | APIYI、OpenAI 公式 |
| 動画理解 | GPT-6 Astra | Video-Index で 8.6 点上回る | APIYI、OpenAI 公式 |
| 単一 issue の修正 / WebDev | Qwen4-Max(コストパフォーマンス) | DeepSWE でわずかに優位、WebDev はわずか 13 Elo 差、1 タスクあたりのコストは約半分 | QwenCloud;APIYI は掲載待ち |
| オフィス業務とワークフロー自動化 Agent | Qwen4-Max | AA-Briefcase +117、APEX +7.4、HLAB-Vals +14.2 | QwenCloud;APIYI は掲載待ち |
| 長いコンテキストのバッチ処理(>272K) | Qwen4-Max | Astra のような一括追加料金はなく、最大出力 393K | QwenCloud;APIYI は掲載待ち |
| 医療専門の質疑応答 | GPT-6 Astra | HealthBench Professional で 6.0 点上回る | APIYI、OpenAI 公式 |
GPT-6 Astra を選ぶべきシーン
- マルチモーダル品質チェック:グラフ、ダッシュボードのスクリーンショット、動画クリップを高い精度で解釈する必要があり、誤りのコストがトークン費用をはるかに上回る場合。
- 自律型コーディング Agent:サンドボックスのターミナルで長いチェーンでコマンドを実行し、完全なプログラムを構築する必要がある場合、ProgramBench の差がタスク成功率に直接影響します。
- 低頻度・高価値のリクエスト:呼び出し量は多くないものの、毎回の結果が意思決定に影響する場合、11 倍の出力価格が総予算に占める割合は限定的です。
Qwen4-Max を選ぶべきシーン
- 高スループットのテキストタスク:毎日大量の文書処理、要約、抽出を行う場合、出力価格の 11.1 倍の差が月額請求額を直接左右します。
- オフィス系 Agent:フォームの回付、ビジネス文書の処理、自動化ワークフローでは、Qwen4-Max のスコア自体がより高くなっています。
- 超長入力と超長出力:数百 K の契約書、コードリポジトリ全体のレビュー、そして一度に数十万トークンのレポートを生成する必要がある場合。
Qwen4-Max と GPT-6 Astra の選択アドバイス
すでに Astra を使っていて、予算が厳しいチームにとって比較的堅実なのは、全面的に切り替えるのではなくハイブリッドルーティングを行うことです。グラフ・ターミナル・動画の3種類のリクエストは引き続き Astra に任せ、それ以外のテキスト系およびオフィス系 Agent のリクエストは Qwen 系へ移行し、さらに Astra の長いコンテキストのリクエストは 272K 以内に抑えます。こうすることで、Astra が本当に優れている能力を残しつつ、価格差が最も大きい部分のコストを削減できます。
モデルを切り替える前に、次の3ステップで確認することをおすすめします。
- モデルを確認する:APIYI apiyi.com のモデル一覧で
gpt-6-astra、qwen3.8-maxが利用可能か確認し、qwen4-maxの公開状況にも注意してください。記憶に頼ってモデル ID を入力しないようにしましょう。 - 価格を突き合わせる:入力・出力・キャッシュ読み取りの3つの単価、および Astra の 272,001 tokens 以上における $20 の入力料金帯を確認します。自分のログにある実際の token 分布に基づいて月額コストを計算してみてください。
- プロトコルを確認する:どちらのモデルも
https://api.apiyi.com/v1の OpenAI 互換インターフェース経由で呼び出せます。SDK の初期化時にbase_urlをこのアドレスに設定するだけです。Astra は/v1/responsesと/v1/chat/completionsの両方のエンドポイントをサポートしており、reasoning.effortで推論レベルを調整する必要がある場合は、Responses エンドポイントでパラメータの挙動を検証することを優先するとよいでしょう。
💡 選択のヒント:同じ業務サンプルを
gpt-6-astraと Qwen 系モデルのそれぞれに送り、正答率と1件あたりのコストを記録するほうが、ベンチマーク一覧を見るより信頼できます。APIYI apiyi.com なら1つの Key でmodelパラメータを切り替えるだけで比較でき、新規ユーザーには無料のテスト枠もあるので、まず小さなサンプルで試せます。
よくある質問(FAQ)
Q1:Qwen4-Max と GPT-6 Astra はそれぞれどんな位置づけですか?
Qwen4-Max は 2026-11-16 にリリースされ、2.4T のバックボーン/71B のアクティブ構造を採用し、ネイティブ視覚と 1M コンテキストをサポートします。GPT-6 Astra は OpenAI の現行最強の汎用モデルで、コンテキストは 1,050,000 tokens、推論レベルは low から max までの 5 段階です。
Q2:Astra はこれだけ高いですが、その差額分のスコアには価値がありますか?
タスク次第です。チャート理解(+16.9)、ProgramBench(+23.5)、Terminal-Bench(+10.6)、動画理解(+8.6)といった項目では、Astra の優位性は確かなもので、これらのタスクではプレミアムを払う価値があります。一方、オフィス Agent、HLAB-Vals、AA-Briefcase では Qwen4-Max のほうがスコアが高く価格も安いので、Astra に追加でお金を払うのは割に合いません。
Q3:これらのベンチマークスコアは信頼できますか?
15 項目のベンチマークはいずれも Qwen 公式が自ら報告した同一画像での比較で、ベンダー側のデータに該当するため、読む際には余裕をもって解釈してください。arena の公開ランキングのスナップショット(2026-11-14)は第三者によるクロスチェックとして利用でき、両者の WebDev での差も同様にわずか 13 Elo です。ただし Qwen4-Max はランキング上まだ Preliminary と表示され、票数も少なくなっています。
Q4:Astra の 272K 入力を超えた場合のルールはどう計算しますか?
1 回のリクエストの入力が 272K を超えると、リクエスト全体の入力とキャッシュが 2 倍、出力が 1.5 倍で課金され、加价は超過部分だけでなくリクエスト全体に適用されます。たとえば 400K 入力+20K 出力の場合、費用は約 $9.50 で、270K 入力で同じ出力の場合の約 2.5 倍になります。
Q5:現在 APIYI を通じて Qwen4-Max を呼び出せますか?
現時点では `qwen4-max` はまだ上架されていませんが、できるだけ早く上架します。それまでは `qwen3.8-max`($1.65 / $4.95 / キャッシュ読み込み $0.20625)で Qwen 系のワークフローを検証できます。`gpt-6-astra` はすでに利用可能で、接続先は統一して `https://api.apiyi.com/v1` です。具体的なモデル名は apiyi.com のモデル一覧をご確認ください。
Q6:Qwen4-Max にはどんな明確な弱点がありますか?
チャート理解、動画理解、ターミナルでの長いチェーン操作、ProgramBench はいずれも Astra に大きく劣り、HealthBench Professional も 6 点低くなっています。ビジネスの中核がこれらのシーンにある場合、コスト削減のためだけに Qwen4-Max に切り替えると、低い成功率が節約した費用を打ち消してしまう可能性があります。
Qwen4-Max と GPT-6 Astra の比較 重要ポイント(Key Takeaways)
- 価格差:Astra の入力価格は Qwen4-Max の 6.7 倍、出力価格は 11.1 倍、キャッシュ読み取りは 13.3 倍です。
- Astra の真の強み:Chartography 71.1 対 54.2、Video-Index 76.7 対 68.1、ターミナルとコードリポジトリ構築でもリードしています。
- Qwen4 の真の強み:HLAB-Vals 21.3 対 7.1、AA-Briefcase 1686 対 1569 で、オフィス Agent 全体としてはより強力です。
- 長コンテキストの罠:Astra は入力が 272K を超えるとリクエスト全体が割増になり、入力 ×2、出力 ×1.5 となります。
- 出力上限:Qwen4-Max の最大出力は 393K、Astra は 128K です。
- 始め方:APIYI で同じ Key を使い、
gpt-6-astraと Qwen 系モデルを比較できます。qwen4-maxは現在公開準備中です。
まとめ
Qwen4-Max と GPT-6 Astra を比較した結論は、次の3点です。
- Astra の割高な価格には3つの実力が対応している:グラフ・チャート理解、ターミナルとコードリポジトリ構築、動画理解。これらのタスクにはお金を払う価値があります。
- Qwen4-Max は安いだけではない:オフィス Agent や複数の専門ベンチマークでスコアが高く、出力上限も大きくなっています。
- 長いコンテキストは別途コスト計算が必要:Astra の 272K というしきい値を超えると1回あたりの費用が跳ね上がるため、検索によるトリミングで入力をしきい値以下に抑えるのが最も直接的なコスト削減策です。
多くのチームにとっては、全体を切り替えるよりもタスクごとにハイブリッドルーティングする方がコスト効率が良いでしょう。APIYI(apiyi.com)で実際の業務サンプルを使って一度 A/B 比較を行い、そのうえで各リクエストの配分比率を決めることをおすすめします。
📚 参考資料
- OpenAI モデルドキュメント – GPT-6 Astra:仕様、コンテキスト、推論レベル
- リンク:
developers.openai.com/api/docs/models/gpt-6-astra -
説明:コンテキスト長、最大入力・出力、
reasoning.effortレベルの原文出典 -
OpenAI 料金ページ:標準料金と 272K を超える場合の課金ルール
- リンク:
developers.openai.com/api/docs/pricing -
説明:入力・出力・キャッシュ読み書きの単価、および長コンテキスト時の注文全体への追加料金ルール
-
arena.ai Code Arena WebDev ランキング:サードパーティの公開ランキング(スナップショット日 2026-11-14)
- リンク:
arena.ai - 説明:Elo ランキング、投票数、タスクあたりのコストの相互参照
作者:APIYI 技術チーム
技術的なお問い合わせ:APIYI のウェブサイトトップページからお気軽にご連絡ください。その他の資料は docs.apiyi.com ドキュメントセンターでご覧いただけます。


