
Note de l’auteur : tous deux flagships de classe 2.4T, Qwen4-Max affiche un prix catalogue en baisse de 25 %, une limite de sortie presque triplée et 20 à 30 % de tokens en moins pour une même tâche. Cet article décortique l’architecture, les benchmarks auto-déclarés par l’éditeur et les prix catalogue des deux générations, puis fournit une check-list de migration depuis qwen3.8-max.
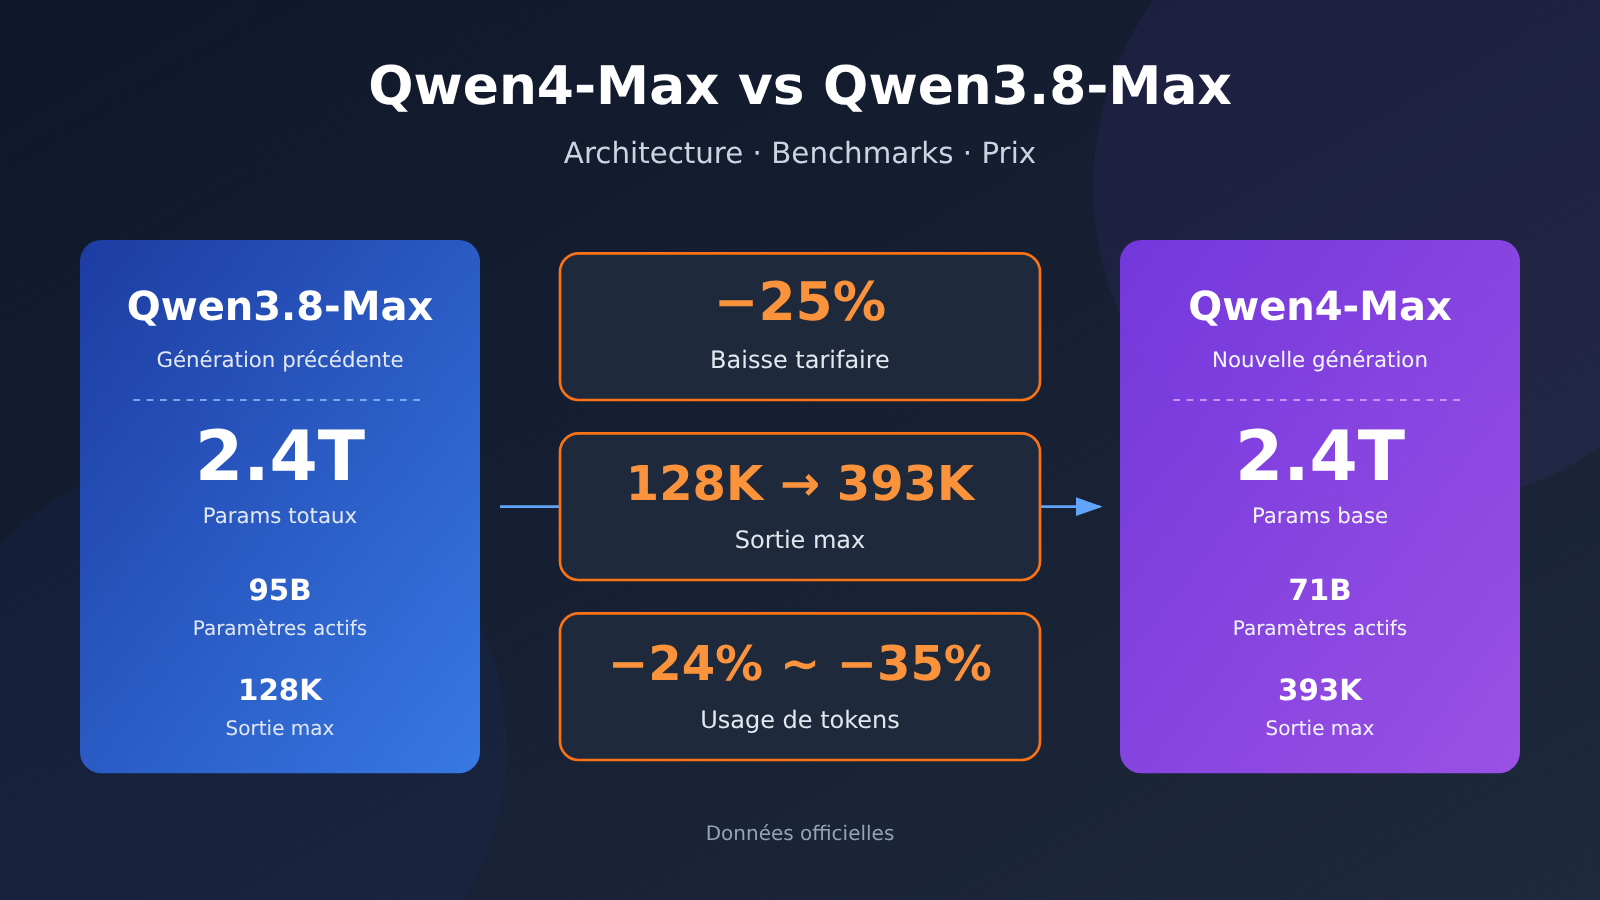
Le 16 novembre 2026, Alibaba a publié Qwen4-Max. Commençons par la conclusion : par rapport à Qwen3.8-Max, la nouvelle génération abaisse de 25 % le prix catalogue de l’entrée et de la sortie, fait passer la sortie maximale de 128K à 393K, soit environ le triple, et dans l’évaluation Work360 officielle, elle consomme 20 à 30 % de tokens en moins pour une même tâche. Pour les équipes qui font déjà tourner qwen3.8-max en production, cette mise à niveau mérite une évaluation sérieuse, mais il n’est pas nécessaire de tout reconstruire.
Ce n’est pas un communiqué façon « la nouvelle génération écrase tout ». Ci-dessous, tous les scores sont explicitement signalés comme auto-déclarés par l’éditeur, et les classements tiers comme des instantanés de leaderboards publics (14 novembre 2026). Les deux chiffres faciles à gonfler — la baisse de 62 % du coût par tâche et la 6e place sur Arena — seront traités séparément.
L’essentiel : à la fin de votre lecture, vous saurez trancher trois questions : quelle part des économies annoncées est réelle, quels benchmarks progressent nettement et lesquels ne bougent presque pas, et ce qu’il faut modifier lors de la migration en plus de l’ID du modèle. Par ailleurs, si vous appelez via APIYI apiyi.com, sachez qu’au 16 novembre 2026 à 11 h 00, la plateforme n’a pas encore référencé qwen4-max : en attendant, continuez simplement avec qwen3.8-max, nous publierons ce modèle dès que possible.
Qwen4-Max vs Qwen3.8-Max : les différences clés en un coup d’œil
Les deux générations de modèles se situent dans la même catégorie en termes de taille totale, mais Qwen4-Max a ajusté les paramètres activés, la limite de sortie et le niveau de raisonnement par défaut. Le tableau ci-dessous regroupe d’abord les différences au niveau des spécifications ; le prix est traité séparément dans la section sur les coûts plus loin.
| Critère de comparaison | Qwen3.8-Max | Qwen4-Max | Changement |
|---|---|---|---|
| Taille des paramètres | 2.4T de paramètres totaux | 2.4T de tronc principal + 328B d’embedding N-gram | Tronc principal équivalent, ajout d’une table d’embedding |
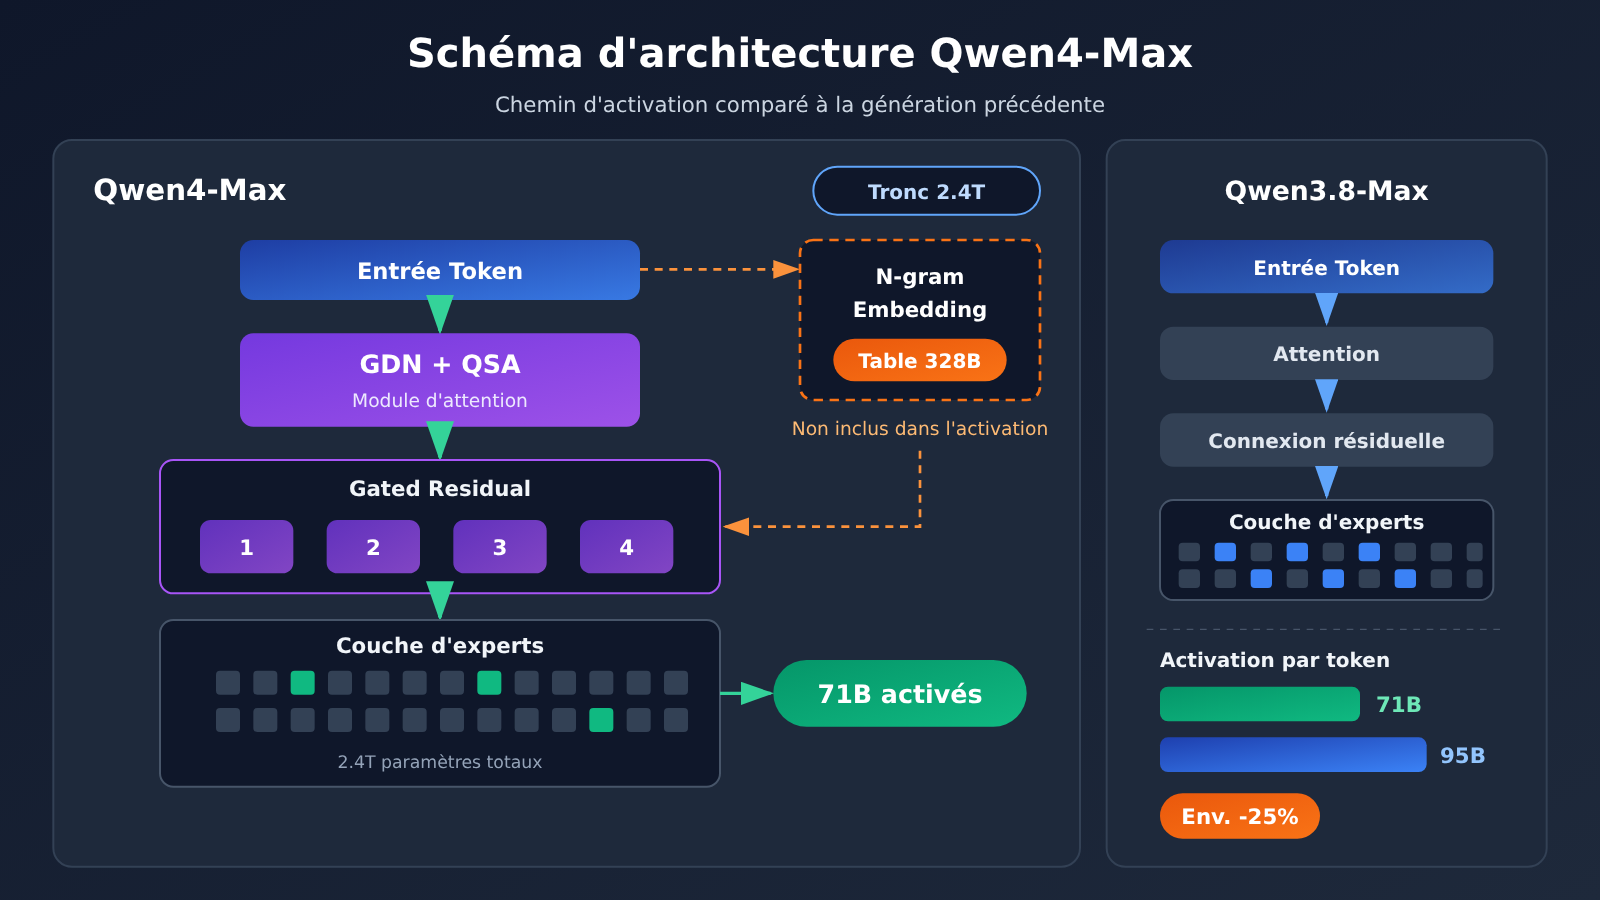
| Paramètres activés à chaque exécution | 95B | 71B | Environ 25 % de moins |
| Contexte | 1M | 1M (entrée maximale 991K, mode raisonnement 983K) | Limite d’entrée légèrement resserrée |
| Sortie maximale | 128K | 393K | Environ 3 fois plus |
| Chaîne de pensée maximale | Non précisée séparément par la documentation officielle | 262K | Nouvelle limite explicite |
| reasoning_effort par défaut | xhigh | high | Niveau par défaut abaissé d’un cran |
| Capacités visuelles | Prend en charge les images en entrée | Vision native | La vision devient une capacité native |
| Poids ouverts | Qwen3.8-2.4T-A95B | Non mentionné dans les sources | — |
Ce tableau montre la logique de cette mise à niveau : la taille totale reste inchangée, chaque exécution coûte moins cher en calcul, et l’espace de sortie est élargi. La baisse des paramètres activés de 95B à 71B est la condition de base qui permet de réduire le prix affiché ; porter la sortie maximale à 393K change directement la faisabilité de tâches comme les longs rapports ou la génération de gros blocs de code.
À noter : le reasoning_effort par défaut passe de xhigh à high. Si votre code ne définit pas explicitement ce paramètre, le niveau de raisonnement réellement utilisé changera après le passage au nouveau modèle ID ; ce point sera à nouveau souligné dans la liste de migration.
Modifications d’architecture de Qwen4-Max : trois changements et ce qu’ils impliquent
Le blog officiel résume les changements d’architecture de Qwen4-Max en trois points : GDN + QSA, les quatre branches Gated Residual, et le N-gram Embedding. Pour un utilisateur de l’API, pas besoin de comprendre couche par couche les détails d’implémentation : il faut surtout savoir ce que chacun de ces trois changements impacte concrètement.
GDN + QSA : un changement au niveau de l’attention
Il s’agit d’un ajustement de la structure d’attention. La présentation officielle le place aux côtés du contexte de 1M et de la sortie maximale de 393K ; notre lecture, c’est qu’il sert avant tout l’efficacité de calcul sur les longues séquences. Pour l’appelant, le résultat directement perceptible est simple : à fenêtre de contexte de 1M identique, Qwen4-Max génère des sorties plus longues, et à un prix unitaire plus bas.
Les quatre branches Gated Residual
Les connexions résiduelles sont étendues en quatre branches avec gating. Ce type de modification joue en général sur la stabilité de l’entraînement et sur la circulation de l’information entre les différentes capacités, ce qui finit par se voir dans le comportement du modèle. L’impact concret : même avec une invite strictement identique, le style de sortie de Qwen4-Max ou la longueur de ses étapes de raisonnement peut différer de la génération précédente. Les invites affinées pour Qwen3.8-Max ont donc besoin de passer par des tests de non-régression.
N-gram Embedding : 328B de paramètres ne veut pas dire 328B de calcul
La notation des paramètres de Qwen4-Max est « backbone 2.4T / 71B activés + 328B N-gram Embedding ». Selon la conception habituelle, ce type d’embedding relève de paramètres de type table de correspondance : ils n’entrent pas dans le calcul d’activation du backbone pour chaque token. On ne peut donc pas ajouter simplement les 328B aux paramètres activés pour faire la comparaison. Ce qui compte vraiment pour le coût d’inférence, c’est 71B contre 95B, autrement dit environ 25 % d’activation en moins à chaque fois.
Côté pré-entraînement, l’équipe officielle indique que Qwen4-Max-Base obtient les meilleurs scores — les plus bas — en BPB (bits par octet, plus bas c’est mieux) sur les quatre catégories d’évaluation interne : connaissances, code, questions-réponses et STEM, avec environ 5–13 % de mieux que Qwen3.8-Max-Base. Ce sont des évaluations internes à l’éditeur, mais elles montrent au moins que la base elle-même progresse : les gains observés ensuite sur les benchmarks ne reposent pas uniquement sur le post-entraînement.
Comparaison des scores de Qwen4-Max : ce qui progresse vraiment, ce qui bouge à peine
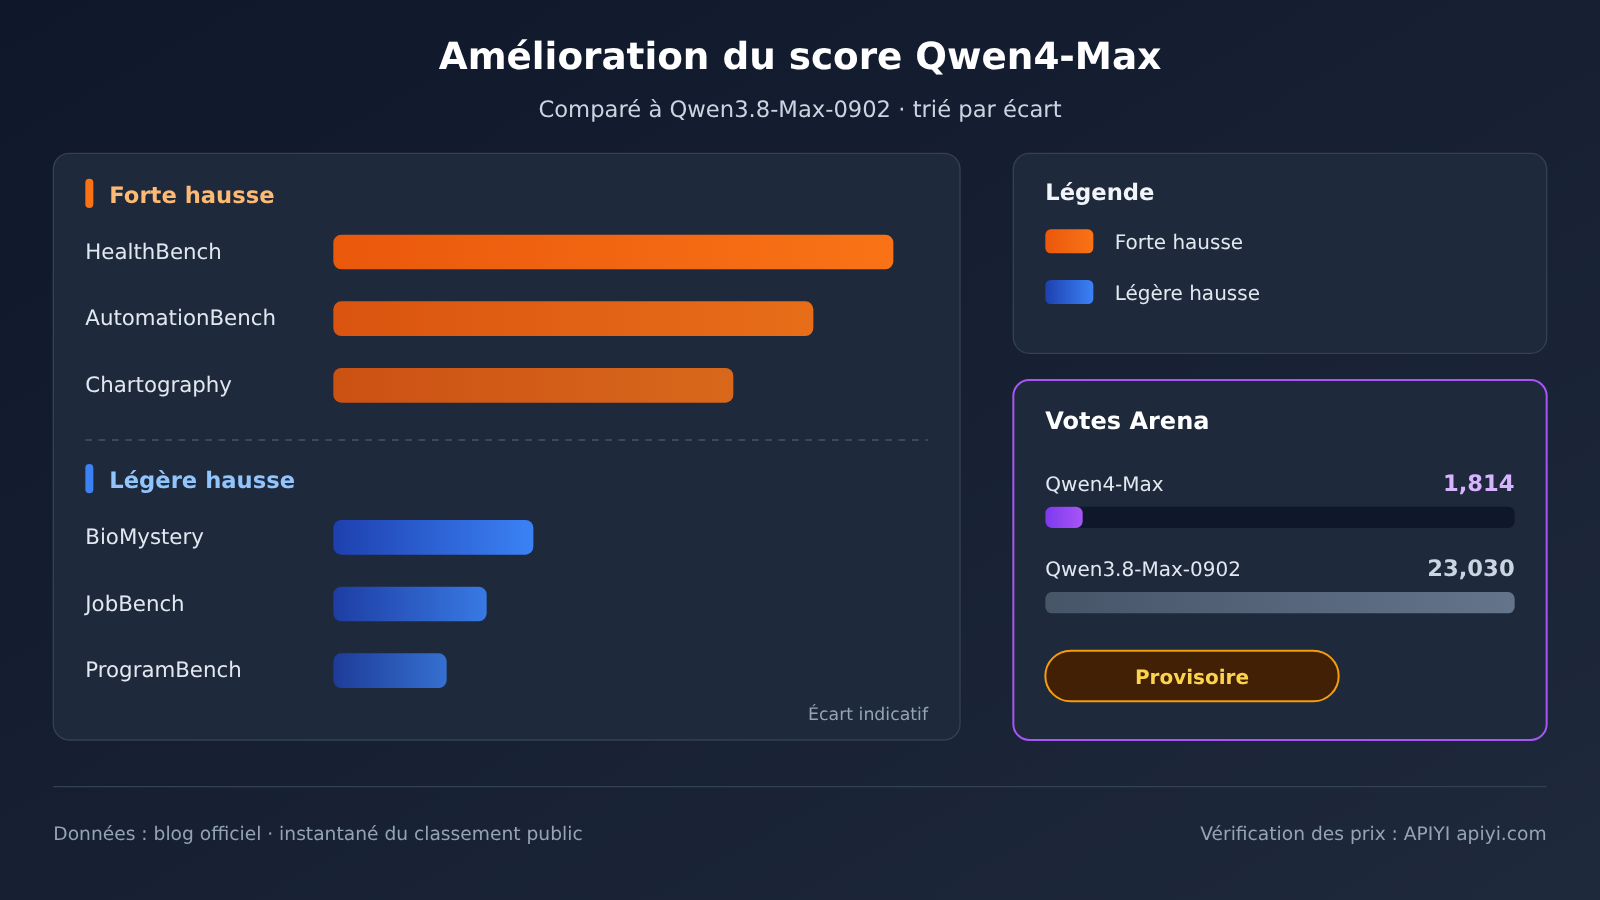
Toutes les données ci-dessous proviennent du même tableau comparatif publié par Alibaba et sont auto-déclarées par l’éditeur. La référence est Qwen3.8-Max-0902 (la version rafraîchie de septembre). Nous les avons classées par ordre décroissant de progression, histoire de voir d’un coup d’œil où se concentre réellement le gain de la mise à niveau.
| Benchmark (auto-déclarés) | Qwen3.8-Max-0902 | Qwen4-Max | Écart | Ampleur de la progression |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | Nette |
| CodeArena | 1676 | 1750 | +74 | Nette |
| HealthBench | 39.6 | 60.0 | +20.4 | Très nette |
| AutomationBench | 56.2 | 72.5 | +16.3 | Très nette |
| Chartography | 42.0 | 54.2 | +12.2 | Nette |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | Nette |
| APEX-Agents | 63.3 | 72.1 | +8.8 | Nette |
| HLE | 43.9 | 51.7 | +7.8 | Nette |
| DeepSWE | 69.3 | 75.7 | +6.4 | Moyenne |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | Moyenne |
| Video-Index | 63.2 | 68.1 | +4.9 | Moyenne |
| ProgramBench | 28.0 | 31.5 | +3.5 | Faible |
| JobBench | 65.3 | 68.5 | +3.2 | Faible |
| BioMystery | 84.1 | 85.0 | +0.9 | Quasi nulle |
Les gains les plus marqués concernent les tâches d’agents et d’appel d’outils : AutomationBench +16.3, Terminal-Bench +9.6, APEX-Agents +8.8. Si votre activité repose sur des appels d’outils en plusieurs tours, des opérations en terminal ou des workflows automatisés, c’est là que la mise à niveau rapporte le plus. HealthBench passe de 39.6 à 60.0 et Chartography gagne 12.2, ce qui montre que les questions-réponses médicales et la compréhension de graphiques figurent aussi parmi les priorités de cette génération.
À l’autre extrémité, BioMystery ne gagne que 0.9, tandis que JobBench et ProgramBench progressent d’un peu plus de 3 points. Sur ces types de tâches, le gain marginal de la mise à niveau reste limité : si votre scénario principal s’en rapproche, les scores seuls ne suffisent pas à justifier une migration — il vaut mieux regarder le coût. L’éditeur donne par ailleurs Work360 à 52.69 contre 47.74, soit 4.95 de mieux, ce qui reste une progression moyenne.
Côté sécurité, les chiffres officiels indiquent que le taux de double réussite au niveau fonction de Last Secure Code Bench passe de 22.0 % à 31.8 %, et que la sécurité simultanée sur les trois granularités grimpe de 8 % à 14.7 %. En valeur absolue, cela reste bas : le code généré doit toujours passer une revue de sécurité, mais la progression relative est nette.
Classement tiers Arena : la position « Preliminary » avec 1,814 votes
Les 1750 points officiels de CodeArena se retrouvent aussi dans le classement tiers arena.ai Code Arena WebDev. Voici un instantané du classement public, 2026-11-14 :
- Qwen4-Max (xHigh) : 1750 points, 6e place, marqué Preliminary, 1,814 votes, $4.18/tâche
- Qwen3.8-Max (0902) : 1676 points, 16e place, 23,030 votes, $1.91/tâche
- Qwen3.8-Max : 1670 points, 18e place
Deuxième endroit où l’on risque d’exagérer : Qwen4-Max ne compte que 1,814 votes, contre 23,030 pour la version 0902 de la génération précédente, soit environ 12 fois plus. La mention Preliminary signifie que le classement est encore en cours de convergence : la 6e place bougera encore, et il vaut mieux écrire aujourd’hui « 6e place provisoire ».
Un autre détail mérite l’attention dans cet instantané : Qwen4-Max concourt dans le palier xHigh, à $4.18 par tâche, contre $1.91 pour Qwen3.8-Max 0902. Cela ne contredit pas le discours officiel sur « la baisse du coût par tâche », car les paliers et les types de tâches mesurés ne sont pas les mêmes — mais cela rappelle que, au palier de raisonnement le plus élevé, Qwen4-Max n’est pas forcément plus économique.
Tarification et coûts de Qwen4-Max : quelle part des économies est réelle
Passer à un nouveau modèle, c’est avant tout changer de modèle, et il faut comparer les prix avant de décider. Le tableau ci-dessous présente les tarifs officiels affichés des deux générations ainsi que le prix actuel de qwen3.8-max vendu sur APIYI, en dollars par million de tokens, avec des données au 2026-11-16.
| Poste de facturation (par 1M tokens) | Qwen3.8-Max officiel (région Singapour) | Qwen4-Max officiel | Qwen4-Max officiel en RMB | Prix actuel de qwen3.8-max sur APIYI |
|---|---|---|---|---|
| Entrée | $2 | $1.5 | ¥10 | $1.65 |
| Sortie | $6 | $4.5 | ¥30 | $4.95 |
| Lecture du cache | $0.25 | $0.075 | ¥0.5 | $0.20625 |
| Écriture du cache (5 minutes) | Non listé dans le blog officiel | $1.875 | ¥12.5 | Non listé séparément dans la documentation |
| Écriture du cache (1 heure) | Non listé dans le blog officiel | $3 | ¥20 | Non listé séparément dans la documentation |
L’entrée et la sortie baissent chacune de 25 %, et la lecture du cache passe de $0.25 à $0.075, soit une baisse d’environ 70 % : c’est le poste le plus impacté par cette nouvelle grille tarifaire. D’un autre côté, Qwen4-Max affiche clairement deux paliers de prix pour l’écriture du cache, à 5 minutes et à 1 heure ; les applications qui réutilisent intensivement de longs préfixes doivent intégrer ce coût d’écriture dans leur budget.
Économies de tokens : 20 à 30 % pour Work360, 40 à 50 % pour Terminal-Bench
Les chiffres officiels sur les économies de tokens se présentent en deux séries. Sur Work360, le niveau Xhigh économise 24 % et le niveau High 35 % : c’est de là que vient le « 20 à 30 % ». Sur Terminal-Bench 4.0, c’est encore plus spectaculaire, avec respectivement 48 % et 49 %.
Les économies sont nettement plus importantes sur les tâches de type terminal, ce qui s’explique peut-être par la réduction du nombre de tours d’outils dans ce genre de tâche. Pour établir un budget, mieux vaut tabler sur 20 à 30 % pour les tâches bureautiques générales ; les 40 à 50 % ne valent que pour des scénarios d’opérations en terminal comparables à Terminal-Bench.
Les 11 points qui ne collent pas entre 62 % et 51 %
C’est le premier endroit où l’on risque d’exagérer. Les données officielles font passer le coût par tâche de $4.43 à $1.67, soit environ 62 % de baisse en dollars ; la version en yuans indique ¥26.58 → ¥11.16, soit environ 58 % de baisse. Les deux séries de chiffres divergent déjà.
Si l’on recalcule avec les données de l’éditeur lui-même : 35 % de tokens en moins et 25 % de baisse du prix unitaire ne donnent, en multipliant, qu’une baisse d’environ 51 %, soit 0.65 × 0.75 ≈ 0.49. Les 11 points restants, l’officiel ne les explique pas. Nous supposons qu’ils viennent de la forte baisse du prix de lecture du cache (environ −70 %), qui apporte un gain sur les hits de cache, ainsi que de la réduction du nombre de tours d’appels d’outils — mais ce n’est qu’une supposition, pas une explication officielle.
La démarche prudente consiste à traiter 51 % comme la borne de référence « à taux de hits de cache égal », et à ne considérer 62 % comme approchable que dans des scénarios à fort taux de hits de cache et à nombreux tours d’outils. Pour votre activité concrète, la base la plus fiable reste une comparaison du coût par tâche menée sur du trafic réel.
Tarif actuel et disponibilité chez APIYI
APIYI propose actuellement qwen3.8-max, à $1.65 en entrée, $4.95 en sortie et $0.20625 pour la lecture du cache ; selon la documentation, c’est 17,5 % moins cher que les $2 / $6 d’Alibaba Cloud. Au même tarif, on trouve également qwen3.8-max-0902, et la version à poids ouverts qwen3.8-2.4t-a95b est facturée $1.72 / $5.16 / $0.215.
Lors de la vérification du 2026-11-16 à 11:00, qwen4-max n’apparaissait encore ni dans la documentation des modèles APIYI ni dans la liste des tarifs (284 modèles au total) : il n’est pas encore disponible. Nous mettrons ce modèle en ligne dès que possible ; le nom du modèle et le tarif feront foi d’après la liste des modèles de la plateforme APIYI (apiyi.com). Franchement, le prix catalogue officiel de Qwen4-Max est déjà inférieur au tarif actuel de qwen3.8-max sur la plateforme ; une fois qu’il sera disponible, il vaudra la peine de refaire les comptes.
De Qwen3.8-Max à Qwen4-Max : la liste de contrôle
Beaucoup pensent qu’une mise à niveau consiste simplement à changer un ID de modèle. En réalité, les paramètres par défaut, les limites de contexte et la facturation du cache changent aussi. La liste ci-dessous est classée par priorité : ce qui risque de poser problème si on n’y touche pas.
| Point de contrôle | État actuel sur Qwen3.8-Max | Après migration vers Qwen4-Max | Action recommandée |
|---|---|---|---|
| ID du modèle | qwen3.8-max / qwen3.8-max-0902 |
Se référer à la liste des modèles de la plateforme | Attendre la mise en ligne avant de basculer, faire d’abord un déploiement progressif |
| Valeur par défaut de reasoning_effort | xhigh | high | Indiquer explicitement le niveau pour éviter un changement de comportement discret |
| Plafond max_tokens | 128K | 393K | Vérifier la troncature en aval, le stockage et les paramètres de timeout |
| Entrée maximale | 1M | 991K (983K en mode réflexion) | Les entrées très longues proches de 1M doivent être tronquées |
| Facturation du cache | Lecture du cache à $0.25 | Lecture du cache à $0.075, plus un tarif d’écriture à 5 minutes / 1 heure | Réévaluer la stratégie de préfixe de cache et de TTL |
| Entrée visuelle | Entrée par image | Vision native | Refaire les tests de régression sur les cas d’usage liés aux images |
| Invite et format de sortie | Déjà optimisés pour la génération précédente | Changements d’architecture, comportement potentiellement différent | Faire une régression avec un jeu d’évaluation fixe |
| Suivi des coûts | Facturation au token | Tokens et prix unitaire en baisse simultanée | Suivre le coût par tâche plutôt que le prix unitaire |
Dans cette liste, le point le plus souvent négligé est reasoning_effort. Qwen3.8-Max utilise xhigh par défaut, Qwen4-Max utilise high. Si le code ne le définit pas explicitement, après le basculement vous pourriez consommer moins de tokens, mais aussi obtenir des résultats moins bons sur les tâches de raisonnement complexe. Les données officielles d’économie de tokens couvrent à la fois les niveaux Xhigh et High ; je vous conseille de tester les deux séparément avant de choisir celui à utiliser en production.
Le deuxième point est la longueur de sortie. La limite de 393K signifie qu’une réponse unique peut être bien plus longue qu’avant. Si votre système de logs, les champs de base de données ou les timeouts de passerelle ont été conçus pour une sortie de 128K, il faut les élargir à l’avance. L’entrée maximale passe de 1M à 991K (983K en mode réflexion) : les applications qui n’exploitent pas la limite tous les jours ne seront pas vraiment impactées, mais les scénarios où l’on remplit des documents jusqu’au plafond vont provoquer des erreurs directes.
Approche actuelle pour appeler via APIYI
Si vous passez actuellement par APIYI, avec un base_url https://api.apiyi.com/v1, le protocole compatible OpenAI, il suffit de renseigner qwen3.8-max dans le champ du modèle pour continuer en production. Si vous avez besoin de verrouiller le comportement de la version rafraîchie de septembre, vous pouvez utiliser qwen3.8-max-0902, au même prix.
Une fois qwen4-max disponible sur la plateforme, comme le protocole ne change pas, la migration au niveau du code consiste uniquement à modifier le champ model, puis à compléter reasoning_effort et max_tokens conformément à la liste ci-dessus. Je recommande de basculer d’abord 5 % à 10 % du trafic pour un déploiement progressif, de comparer le coût par tâche et les indicateurs métier, puis de passer à 100 %.
🚀 Conseil de migration : pour les projets qui passent actuellement par APIYI apiyi.com, continuez avec
qwen3.8-maxtout en préparant le jeu d’évaluation et l’interrupteur de déploiement progressif ; une foisqwen4-maxdisponible, changez l’ID. Vous éviterez ainsi une interruption d’activité en attendant le nouveau modèle.
Recommandations d’usage : Qwen4-Max vs Qwen3.8-Max
Scénarios où évaluer en priorité le passage à Qwen4-Max
- Appels d’outils multi-tours et automatisation : AutomationBench, Terminal-Bench et APEX-Agents progressent nettement, et les économies de tokens sont également les plus importantes sur les tâches de type terminal.
- Tâches à sortie très longue : pour générer en une seule fois des rapports, du code ou des documents de plus de 128K, seul Qwen4-Max et sa fenêtre de 393K peut répondre.
- Questions médicales et compréhension de graphiques : HealthBench +20.4 et Chartography +12.2, soit les domaines où cette génération progresse le plus.
- Exigences de sécurité du code : le taux de double validation en sécurité passe de 22.0% à 31.8%, mais il faut toujours l’accompagner d’un processus de revue.
- Applications à fort taux de réutilisation du cache : le prix de lecture du cache baisse d’environ 70 %, ce qui profite surtout aux longs prompts système et aux préfixes de base de connaissances fixes.
Scénarios où continuer avec Qwen3.8-Max
- Production déjà stable, invites finement optimisées : Qwen3.8-Max reste un modèle de production fiable ; inutile de migrer juste pour migrer.
- Tâches principales proches de BioMystery et JobBench : les gains y sont limités et le coût de migration peut dépasser les bénéfices.
- Besoin de poids ouverts et d’auto-hébergement : Qwen3.8-2.4T-A95B dispose de poids ouverts ; la documentation ne mentionne pas de version à poids ouverts pour Qwen4-Max.
- Appels via APIYI avec besoin de disponibilité immédiate : tant que
qwen4-maxn’est pas disponible,qwen3.8-maxreste le choix prêt à l’emploi.
| Votre situation | Recommandation |
|---|---|
| Agents et appels d’outils avant tout, avec recherche de réduction des coûts | Évaluer Qwen4-Max en priorité et mesurer le coût réel sur le palier High |
| Besoin d’une sortie unique de plus de 128K | Choisir Qwen4-Max uniquement |
| Production stable, surtout des questions-réponses générales | Garder Qwen3.8-Max et lancer des évaluations de régression pendant les périodes creuses |
| Besoin d’auto-héberger des poids ouverts | Continuer avec Qwen3.8-2.4T-A95B |
| Accès actuel via APIYI | Continuer avec qwen3.8-max, puis basculer progressivement après sa mise à disposition |
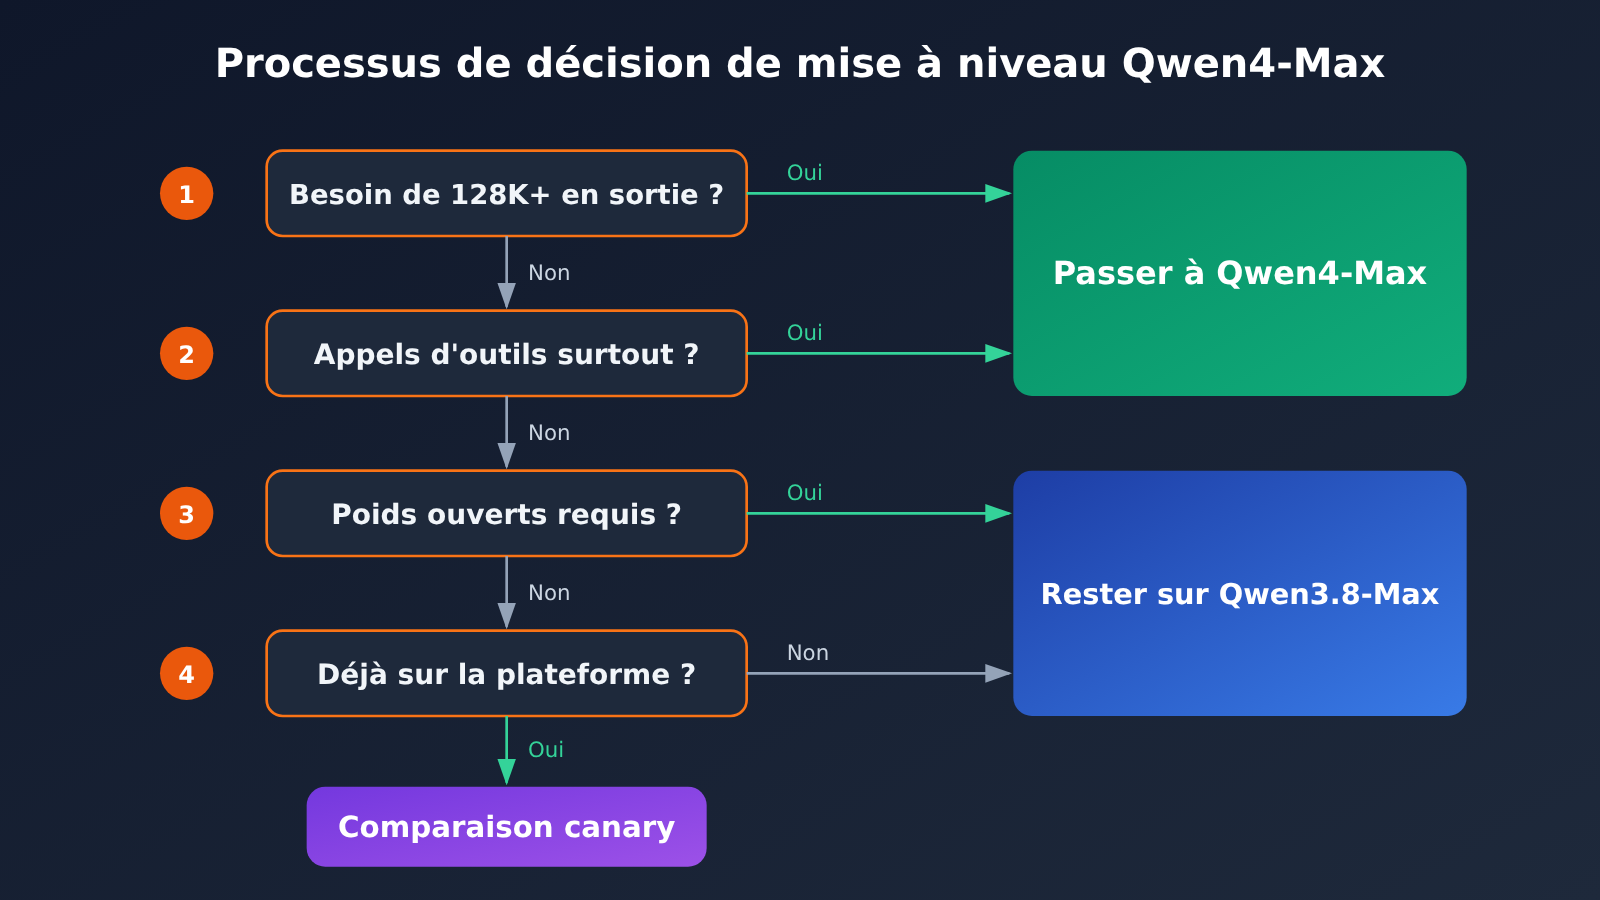
Qwen4-Max face à Qwen3.8-Max : conseils de décision
Si l’on doit retenir une seule phrase : les activités d’agents, de longues sorties et à forte intensité de cache méritent la mise à niveau ; les applications générales stables peuvent attendre. Parmi les trois avantages de la mise à niveau, la baisse de 25 % du prix unitaire est certaine ; les économies de tokens de 20 à 30 % correspondent à des chiffres officiels issus d’évaluations spécifiques ; quant à la réduction de 62 % par tâche, il faut que vos conditions de cache et de nombre de tours d’outils s’y prêtent pour espérer s’en approcher.
💡 Conseil de choix : avant de décider, je vous suggère de lancer une série de tests avec vos propres tâches réelles sur chaque modèle, puis de comparer le coût par tâche et la qualité des résultats, plutôt que de vous fier au seul tableau des scores. Avec APIYI (apiyi.com), vous pouvez utiliser la même clé API pour établir d’abord une base de référence avec
qwen3.8-max, puis comparer directement dans le même code dès queqwen4-maxest disponible.
FAQ — Questions fréquentes
Q1 : Quel est le rapport entre Qwen4-Max et Qwen3.8-Max ?
Les deux sont des flagships 2.4T de Tongyi Qianwen. Qwen3.8-Max est sorti le 2026-08-03, et 0902 est sa version rafraîchie de septembre ; Qwen4-Max est sorti le 2026-11-16, avec une architecture revue, des paramètres activés par passe passés de 95B à 71B, un plafond de sortie relevé à 393K et un prix catalogue en baisse de 25 %.
Q2 : Si j’économise 20 à 30 % de tokens, ma facture baisse-t-elle d’autant ?
Pas forcément, et pas nécessairement. Le prix unitaire baisse déjà de 25 %, et si on ajoute la réduction de tokens, le coût d’une même tâche peut théoriquement chuter d’environ 51 %. Mais les chiffres d’économie de tokens viennent du benchmark officiel Work360 : ce que votre activité économisera réellement, il faut le mesurer sur pièce. Et si vous utilisez le palier xhigh, comme le montre le snapshot Arena, le coût par tâche peut au contraire augmenter.
Q3 : Qwen4-Max est 6e sur Arena, ce classement est-il fiable ?
On ne peut le considérer que comme un résultat preliminaire. Dans le snapshot public du classement (2026-11-14), Qwen4-Max ne comptait que 1 814 votes et était marqué « Preliminary », alors que la génération précédente, 0902, en totalise 23 030 — soit environ 12 fois plus. Le score de 1750 correspond bien à ce que la firme annonce elle-même, mais le rang bougera encore à mesure que les votes s’accumuleront.
Q4 : Peut-on déjà appeler qwen4-max via APIYI ?
À ce jour (2026-11-16, 11h00), non : `qwen4-max` n’est pas encore référencé, mais nous ferons au plus vite pour l’ajouter. Pour l’instant, vous pouvez utiliser `qwen3.8-max`, `qwen3.8-max-0902` ainsi que la version à poids ouverts `qwen3.8-2.4t-a95b`. Pour les derniers modèles et les tarifs, référez-vous à la liste des modèles sur la plateforme APIYI apiyi.com ; les nouveaux utilisateurs peuvent lancer une baseline avec le quota de test gratuit.
Q5 : Pour migrer, suffit-il de changer l’ID du modèle ?
Non. Il faut au minimum définir explicitement `reasoning_effort` (la valeur par défaut passe de xhigh à high), élargir si besoin `max_tokens` et les limites de stockage en aval, vérifier les entrées très longues proches de 1M, et réévaluer le coût d’écriture du cache. Côté protocole, si vous passez par l’interface compatible OpenAI `https://api.apiyi.com/v1`, il suffit de modifier le champ `model` dans votre code.
Q6 : Qwen3.8-Max vaut-il encore la peine d’être utilisé ?
Oui. C’est toujours un flagship de classe 2.4T : contexte de 1M, sortie de 128K, modes réflexion et non-réflexion au complet, plus une version à poids ouverts. Qwen4-Max ne progresse que très peu sur des benchmarks comme BioMystery ou JobBench ; pour ce type d’activité, un Qwen3.8-Max qui tourne de façon stable peut parfaitement continuer à absorber le trafic de production.
Qwen4-Max face à Qwen3.8-Max : les points clés
- Même envergure, moins de paramètres activés : le backbone de 2.4T reste inchangé ; à chaque activation, on passe de 95B à 71B, soit environ 25 % de moins.
- Prix unitaire en baisse de 25 % : entrée $2→$1.5, sortie $6→$4.5, lecture du cache en baisse d’environ 70 %, facturation de l’écriture en cache ajoutée.
- Sortie environ triplée : sortie maximale 128K→393K, entrée maximale réduite à 991K.
- Les gains se concentrent sur les agents : AutomationBench, Terminal-Bench et HealthBench progressent nettement, BioMystery ne bouge presque pas.
- Deux points à ne pas exagérer : la baisse de coût de 62 % ne peut être justifiée qu’à hauteur d’environ 51 %, et la 6e place sur Arena ne repose que sur 1 814 votes, avec le statut Preliminary.
- La migration ne se limite pas à un changement d’ID : attention à la valeur par défaut de reasoning_effort, à la limite de max_tokens et à la stratégie de cache.
- État actuel chez APIYI :
qwen4-maxn’est pas encore disponible ; continuez d’utiliserqwen3.8-max, puis basculez progressivement après sa mise à disposition.
En résumé
Les conclusions clés de la comparaison entre Qwen4-Max et Qwen3.8-Max :
- Coût : la baisse de 25 % du prix unitaire est un gain sûr ; les économies de tokens de 20 à 30 % doivent être confirmées par des mesures sur votre propre activité ; sur la baisse de 62 %, environ 11 points restent inexpliqués.
- Capacités : nettes améliorations du côté des agents, de l’appel d’outils, de la santé et des graphiques ; certains benchmarks restent pratiquement inchangés ; tous les scores sont autodéclarés par l’éditeur.
- Migration : le protocole reste le même, mais le niveau de raisonnement par défaut, la limite de sortie et la facturation du cache ont changé ; à vérifier point par point avec une checklist.
Qwen3.8-Max reste un modèle de production fiable. La montée en version doit être une décision de déploiement progressif fondée sur des données, et non une bascule totale dès qu’une nouvelle version sort. Je recommande de commencer par établir une référence de coût et de qualité avec qwen3.8-max via APIYI (apiyi.com), puis de comparer directement qwen4-max sur la même interface dès qu’il sera disponible.
📚 Références
- Blog officiel Qwen3.8 : notes de version de Qwen3.8-Max, avec paramètres, fenêtre de contexte et tarification officielle
- Lien :
qwen.ai/blog?id=qwen3.8 -
Description : source des spécifications de la génération précédente et des tarifs pour la région de Singapour
-
Hugging Face – Qwen3.8-2.4T-A95B : version à poids ouverts de Qwen3.8
- Lien :
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
Description : fiche du modèle et téléchargement des poids nécessaires pour un auto-hébergement
-
Blog officiel Qwen : article de lancement de Qwen4-Max et comparaison des scores de benchmark sur un même graphique
- Lien :
qwen.ai/blog -
Description : source des modifications d’architecture, des scores de benchmark communiqués par l’éditeur, des données sur les tokens et du coût par tâche
-
arena.ai Code Arena WebDev : classement de confrontation de modèles tiers
- Lien :
arena.ai - Description : cet article cite un instantané du 2026-11-14 ; le classement évolue avec le nombre de votes
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; les modèles et les tarifs sont consultables dans le centre de documentation docs.apiyi.com


