
Anmerkung des Autors: Dieser Beitrag vergleicht Qwen4-Max und GPT-6 Astra bei Benchmark-Werten, Kontextspezifikationen sowie Eingabe- und Ausgabepreisen und zeigt nach Aufgabentyp, welche Seite sich eher lohnt.
Das Fazit vorweg: Der Eingabepreis von GPT-6 Astra liegt etwa beim 6.7-Fachen von Qwen4-Max, der Ausgabepreis etwa beim 11.1-Fachen. Was dieser Aufpreis konkret liefert, lässt sich klar benennen: vor allem höhere Werte bei drei Aufgabentypen – Diagrammverständnis, Terminal- und Repository-Operationen sowie Videoverständnis. Bei Office-Agenten und in bestimmten professionellen Benchmarks liegt Qwen4-Max dagegen vorn.
Dies ist kein Artikel darüber, wer wen in allem übertrumpft. Beide Modelle haben klar erkennbare Stärken und ebenso klare Schwächen. Verglichen werden ausschließlich diese beiden Modellvarianten. Die Fakten stammen aus vier Quellen: den von Qwen offiziell selbst gemeldeten Vergleichswerten im selben Diagramm, dem Originaltext der OpenAI-Dokumentation, einem öffentlichen Snapshot des Arena-Leaderboards (14.11.2026) sowie der Preisliste der APIYI-Plattform.
Der Kernnutzen: Nach der Lektüre halten Sie eine Auswahlmatrix nach Aufgabe und Budget in der Hand, wissen, wofür der Aufpreis bei Astra bezahlt wird, und kennen die Regel für den Zuschlag auf die gesamte Abrechnung, sobald der Astra-Input 272K überschreitet.
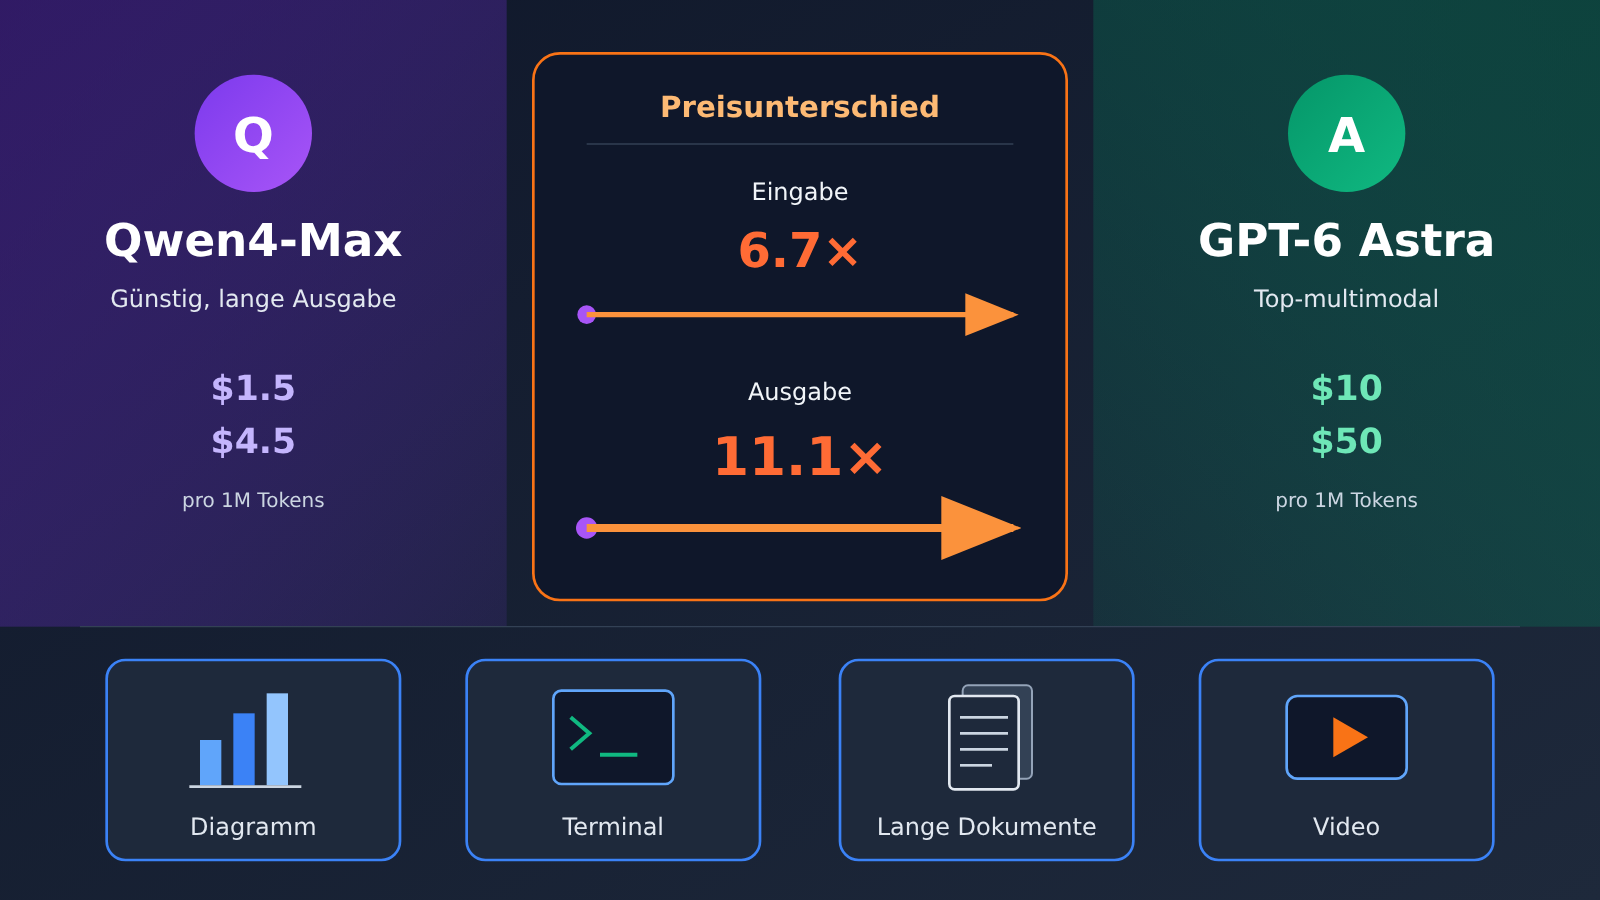
Kernunterschiede zwischen Qwen4-Max und GPT-6 Astra
Zuerst die Spezifikationen und Preise in einer Tabelle. Die Spezifikations- und Preisdaten stammen aus der QwenCloud-Preisliste und den Originaldokumenten von OpenAI; Datenstand ist der 2026-11-16. Alle Preise gelten pro 1M Tokens.
| Vergleichskriterium | Qwen4-Max | GPT-6 Astra | Vorteil |
|---|---|---|---|
| Architektur / Positionierung | 2.4T Backbone / 71B aktiv + 328B N-gram-Embedding, native Vision | Das derzeit stärkste universelle Modell von OpenAI | Jeweils eigene Positionierung |
| Kontextfenster | 1M | 1,050,000 | Nahezu gleichauf |
| Maximale Eingabe | 991K (Denkmodus 983K) | 922K | Qwen4-Max |
| Maximale Ausgabe | 393K (maximale Chain-of-Thought 262K) | 128K | Qwen4-Max |
| Reasoning-Stufe | Denkmodus | reasoning.effort: low / medium / high / xhigh / max |
Astra feiner abgestuft |
| Eingabepreis | $1.5 | $10 (bei mehr als 272K Eingabe: 2-fach) | Qwen4-Max |
| Ausgabepreis | $4.5 | $50 (bei mehr als 272K Eingabe: 1.5-fach) | Qwen4-Max |
| Wissensstand | In den Referenzmaterialien nicht angegeben | 2026-04-30 | — |
Kontextunterschiede zwischen Qwen4-Max und GPT-6 Astra
Beide geben ein Kontextfenster im 1M-Bereich an; der Unterschied liegt in der Aufteilung zwischen Eingabe und Ausgabe. Qwen4-Max kann in einem Durchgang bis zu 393K Tokens ausgeben. Dieses Limit ist für die Erstellung langer Berichte, das Umschreiben umfangreicher Codeabschnitte und die strukturierte Extraktion im Batch nützlich. Astra hat eine Ausgabegrenze von 128K, was für alltägliche Aufgaben reicht; bei sehr langen Generierungen muss man aufteilen.
Beim Kriterium maximale Eingabe liegt Qwen4-Max mit 991K ebenfalls leicht über Astrias 922K. Bei der tatsächlichen Auswahl ist jedoch die Preisgrenze von Astra interessanter: Sobald die Eingabe 272K überschreitet, steigen die Preise für die gesamte Anfrage. Der Kostenabschnitt weiter unten rechnet das separat durch.
Qwen4-Max im Vergleich zu GPT-6 Astra: Benchmark-Ergebnisse im Detail
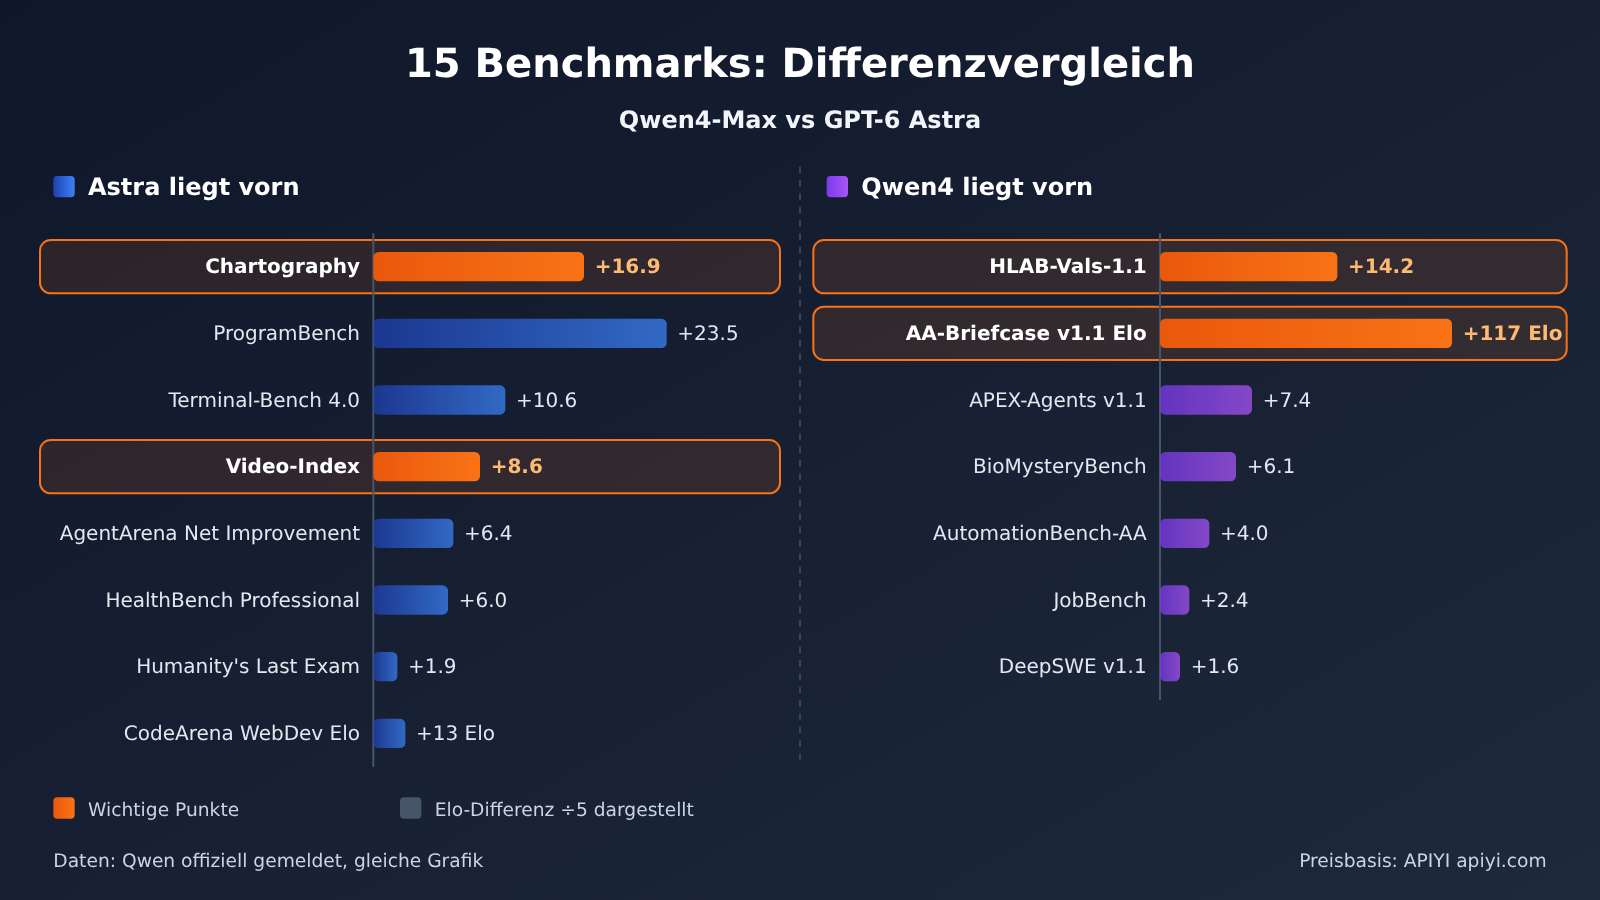
Alle folgenden Werte stammen aus Qwens offiziell selbst veröffentlichtem Vergleich auf derselben Messgrundlage. Solche von einer Seite veröffentlichten Vergleiche sollte man mit etwas Vorbehalt lesen. Die auffälligen Vorteile von Astra hat Qwen in der Tabelle allerdings selbst aufgeführt – hier ist die Aussagekraft entsprechend höher.
| Benchmark | Qwen4-Max | GPT-6 Astra | Differenz | Vorsprung |
|---|---|---|---|---|
| Chartography | 54.2 | 71.1 | 16.9 | Astra |
| ProgramBench | 31.5 | 55.0 | 23.5 | Astra |
| Terminal-Bench 4.0 | 48.5 | 59.1 | 10.6 | Astra |
| Video-Index | 68.1 | 76.7 | 8.6 | Astra |
| AgentArena Net Improvement | 7.5 | 13.9 | 6.4 | Astra |
| HealthBench Professional | 60.0 | 66.0 | 6.0 | Astra |
| Humanity’s Last Exam | 51.7 | 53.6 | 1.9 | Astra |
| CodeArena WebDev Elo | 1750 | 1763 | 13 | Astra |
| HLAB-Vals-1.1 | 21.3 | 7.1 | 14.2 | Qwen4 |
| AA-Briefcase v1.1 Elo | 1686 | 1569 | 117 | Qwen4 |
| APEX-Agents v1.1 | 72.1 | 64.7 | 7.4 | Qwen4 |
| BioMysteryBench | 85.0 | 78.9 | 6.1 | Qwen4 |
| AutomationBench-AA | 72.5 | 68.5 | 4.0 | Qwen4 |
| JobBench | 68.5 | 66.1 | 2.4 | Qwen4 |
| DeepSWE v1.1 | 75.7 | 74.1 | 1.6 | Qwen4 |
Die eigentlichen Stärken von GPT-6 Astra: Diagramme, Terminal, Video
Beim Diagrammverständnis ist der Abstand am größten. Auf Chartography erreicht Astra 71.1 Punkte, Qwen4-Max 54.2 – ein Unterschied von 16.9 Punkten. Wenn in Ihrem Geschäft Finanzberichtsdiagramme, Screenshots von Monitoring-Dashboards oder wissenschaftliche Diagramme ausgelesen werden müssen, schlägt sich diese Lücke direkt in der Extraktionsgenauigkeit nieder, und sie lässt sich kaum über Eingabeaufforderungen wieder ausgleichen.
Terminal und Code-Repository sind der zweite Bereich. Bei Terminal-Bench 4.0 beträgt der Unterschied 10.6 Punkte, bei ProgramBench 23.5 Punkte. In diesen beiden Benchmarks geht es um mehrstufige Befehlsausführung und die Fähigkeit, vollständige Programme zu erstellen – genau die Bereiche, die für Coding-Agenten am wichtigsten sind. Bei DeepSWE liegt Qwen4-Max mit 1.6 Punkten knapp vorn, was zeigt, dass es bei der Behebung einzelner Issues nicht schwach ist. Sobald die Aufgabe jedoch darin besteht, „im Terminal über eine lange Kette hinweg ein Projekt aufzubauen“, ist Astra stabiler.
Videoverständnis darf man nicht überspringen. Bei Video-Index steht Astra mit 76.7 gegen 68.1 – 8.6 Punkte Vorsprung. Qwen4-Max unterstützt zwar native visuelle Verarbeitung, liegt beim Videoverständnis aber weiter zurück. Teams, die Videoinhaltsprüfung, Segment-Retrieval oder Zusammenfassungen von Lehrvideos benötigen, sollten diesen Punkt ganz oben auf ihre Auswahlliste setzen.
Die wahren Stärken von Qwen4-Max: Office-Agenten und professionelle Benchmarks
HLAB-Vals-1.1 ist der Punkt, an dem Qwen4-Max am deutlichsten vorn liegt – 21.3 zu 7.1, eine absolute Differenz von 14.2 Punkten, anteilig fast das Dreifache. Im AA-Briefcase v1.1 Elo beträgt der Vorsprung 117 Punkte (1686 zu 1569). Diese Art von Benchmark tendiert zu Geschäftsdokumenten und Agent-Aufgaben aus dem Office-Workflow-Umfeld, und im Elo-System ist ein Abstand von 117 Punkten durchaus markant.
Auch bei APEX-Agents (+7.4), AutomationBench-AA (+4.0) und JobBench (+2.4) liegt Qwen4-Max vorne. Betrachtet man diese Punkte zusammen, lautet das Fazit: In Szenarien der Prozessautomatisierung und der Office-Agenten ist Qwen4-Max nicht nur günstiger, sondern erzielt auch höhere Werte.
Momentaufnahme der öffentlichen Code-Arena-Rangliste (2026-11-14)
Eine Drittanbieter-Rangliste taugt als Quervergleich. Die öffentliche Snapshot-Tabelle der Code Arena WebDev von arena.ai zeigt: GPT-6 Astra (Max) belegt mit 1763 Punkten Platz 5, bei 8.685 Stimmen und Kosten von $9.43 pro Aufgabe. Qwen4-Max (xHigh) kommt mit 1750 Punkten auf Platz 6, gekennzeichnet als Preliminary, mit 1.814 Stimmen und $4.18 pro Aufgabe.
Ein Elo-Abstand von 13 Punkten bedeutet im WebDev-Umfeld dieselbe Leistungsklasse – die Kosten pro Aufgabe unterscheiden sich jedoch um mehr als das Doppelte. Zu beachten ist, dass Qwen4-Max noch deutlich weniger Stimmen hat und die Platzierung weiter schwanken kann; es lohnt sich also, das Ganze im Auge zu behalten.
Qwen4-Max vs. GPT-6 Astra: Vergleich der Preise für Ein- und Ausgabe
Die Preistabelle besteht aus zwei Teilen: dem offiziellen Preis und dem aktuellen Preis bei APIYI. Die offiziellen Preise stammen aus den Originaldokumenten von QwenCloud und OpenAI, Stand 2026-11-16, angegeben in USD pro 1M tokens.
| Abrechnungsposten | Qwen4-Max (QwenCloud) | GPT-6 Astra (OpenAI-Dokumentation) | Faktor |
|---|---|---|---|
| Eingabe | $1.5 | $10 | 6.7× |
| Ausgabe | $4.5 | $50 | 11.1× |
| Cache-Lesen | $0.075 | $1 | 13.3× |
| Cache-Schreiben | 5 Minuten $1.875 / 1 Stunde $3 | $12.5 | 4.2–6.7× |
| Eingabe über 272K | In der Referenz ist keine Staffelung angegeben | Gesamte Anfrage Eingabe und Cache ×2, Ausgabe ×1.5 | — |
Die Doppelpreis-Falle bei GPT-6 Astra ab 272K Eingabe
Die Regel in der OpenAI-Dokumentation lautet: Übersteigt die Eingabe einer einzelnen Anfrage 272K, werden die gesamte Anfrage – Eingabe und Cache – mit dem 2-fachen berechnet, die Ausgabe mit dem 1.5-fachen. Teurer wird hier nicht nur der Teil oberhalb von 272K, sondern die komplette Anfrage wird zum hohen Tarif abgerechnet. Viele Teams übersehen diesen Punkt, wenn sie die Kosten für RAG über lange Dokumente oder den vollständigen Kontext eines Code-Repos schätzen.
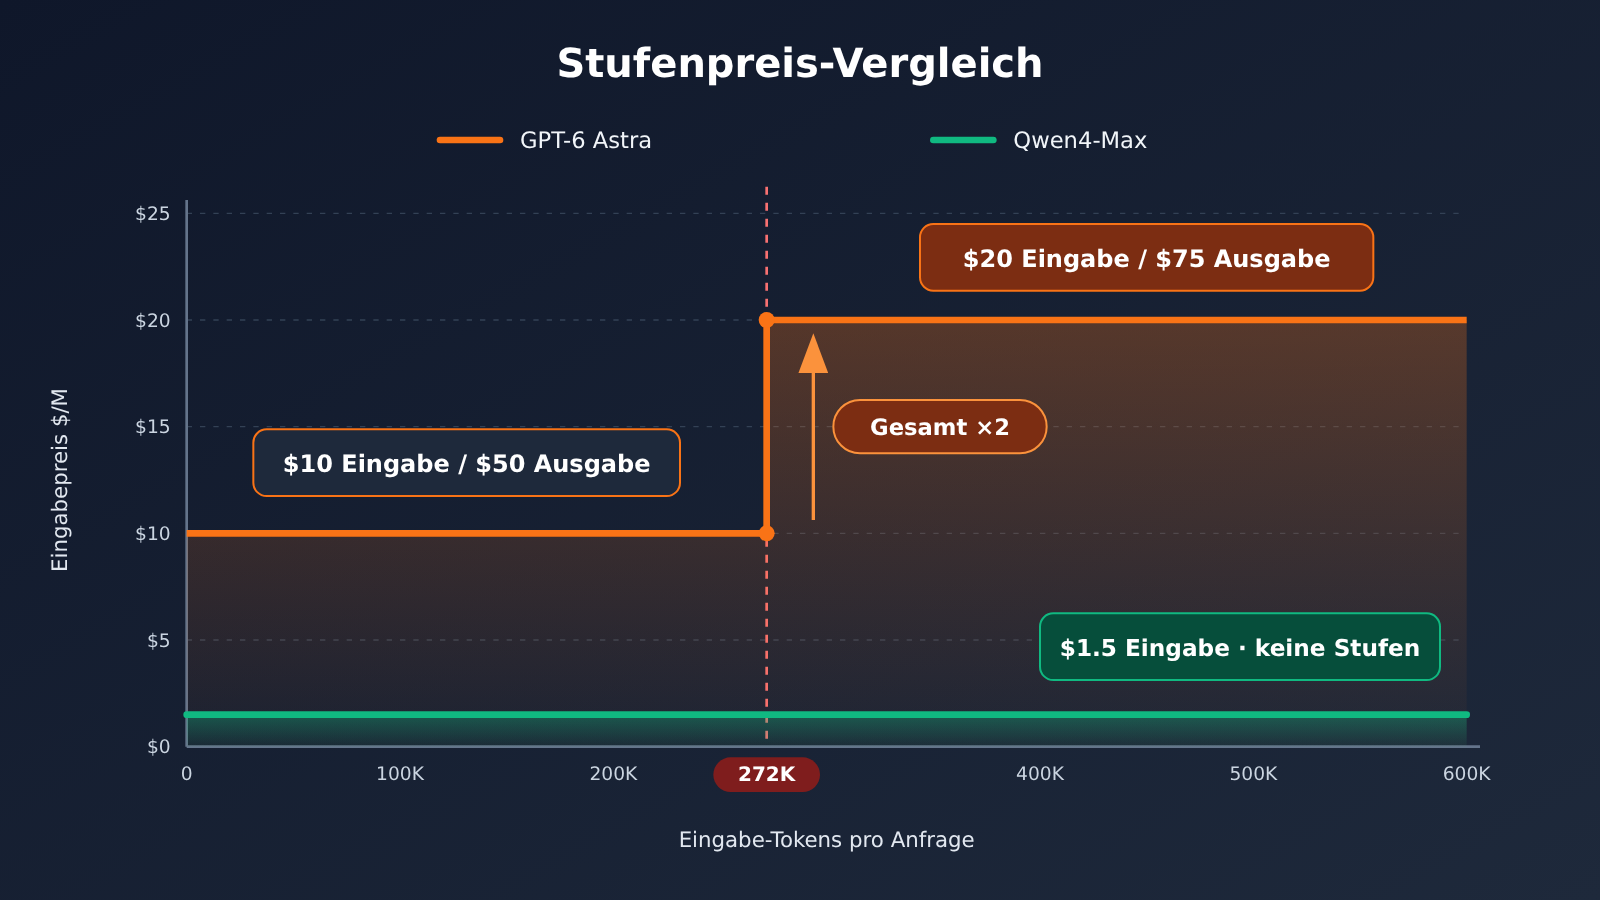
Rechnen wir das mit ein paar typischen Anfragen durch. Preise nach offiziellem Standardtarif, Cache zunächst nicht berücksichtigt.
| Szenario | Qwen4-Max | GPT-6 Astra | Unterschied |
|---|---|---|---|
| Einmalig 270K Eingabe + 20K Ausgabe | ca. $0.50 | ca. $3.70 | ca. 7.4× |
| Einmalig 400K Eingabe + 20K Ausgabe | ca. $0.69 | ca. $9.50 (272K-Regel bereits ausgelöst) | ca. 13.8× |
| Monatlich 100 Mio. Eingabe + 10 Mio. Ausgabe (alle Anfragen unter 272K) | ca. $195 | ca. $1,500 | ca. 7.7× |
| Wie oben, aber alle Anfragen mit langem Kontext über 272K | ca. $195 (geschätzt nach Standardtarif) | ca. $2,750 | ca. 14× |
Die zweite Zeile zeigt das Problem am deutlichsten. Die Eingabe steigt von 270K auf 400K, die Tokens wachsen also um weniger als die Hälfte – doch die Kosten pro Anfrage bei Astra springen von $3.70 auf $9.50. Wer einen Long-Context-Workflow für Astra entwirft, sollte die Eingabe pro Anfrage daher besser unter 272K halten. Man kann zuerst das Retrieval kürzen oder abschnittsweise zusammenfassen und das Ergebnis dann Astra zur finalen Inferenz übergeben.
Aktuelle Preise und Modellverfügbarkeit bei APIYI
Die aktuellen Preise bei APIYI (Stand 16.11.2026) sehen wie folgt aus. Maßgeblich ist letztlich die Modellliste der Plattform.
gpt-6-astra: Eingabe $10, Ausgabe $50, Cache-Lesen $1; im Bereich von 272,001–1,050,000 Tokens kostet die Eingabe $20 – identisch mit der offiziellen Staffelung.qwen3.8-max: Eingabe $1.65, Ausgabe $4.95, Cache-Lesen $0.20625.qwen4-max: noch nicht verfügbar – wir nehmen dieses Modell so schnell wie möglich auf. Die Modell-ID und der Preis nach der Aufnahme entnehmen Sie bitte der Modellliste auf apiyi.com.
💰 Kostentipp: Bevor
qwen4-maxverfügbar ist, können Sie mitqwen3.8-maxbereits die Prompt- und Tool-Calling-Abläufe der Qwen-Familie durchspielen und nach dem Start des neuen Modells einfach denmodel-Parameter austauschen. Beide Serien laufen bei APIYI apiyi.com über denselben Key, und die Abrechnung finden Sie an derselben Stelle – so lassen sich die tatsächlichen Kosten beider Modelle direkt vergleichen.
Qwen4-Max oder GPT-6 Astra – Auswahl nach Aufgabe
Wenn man Benchmark-Ergebnisse und Preise zusammen betrachtet, lassen sich je nach Aufgabentyp klare Empfehlungen geben.
| Aufgabentyp | Empfehlung | Begründung | Verfügbare Plattform |
|---|---|---|---|
| Diagramm- / Screenshot-Verständnis | GPT-6 Astra | Chartography führt mit 16,9 Punkten | APIYI apiyi.com, OpenAI offiziell |
| Terminal-Bedienung und Aufbau kompletter Code-Repositories | GPT-6 Astra | Terminal-Bench +10.6, ProgramBench +23.5 | APIYI, OpenAI offiziell |
| Videoverständnis | GPT-6 Astra | Video-Index führt mit 8,6 Punkten | APIYI, OpenAI offiziell |
| Einzelne Issue-Fixes / WebDev | Qwen4-Max (Preis-Leistung) | DeepSWE knapp vorn, WebDev nur 13 Elo Unterschied, Kosten pro Aufgabe etwa die Hälfte | QwenCloud; APIYI noch nicht verfügbar |
| Office- und Prozessautomatisierung (Agent) | Qwen4-Max | AA-Briefcase +117, APEX +7.4, HLAB-Vals +14.2 | QwenCloud; APIYI noch nicht verfügbar |
| Batch-Verarbeitung mit langem Kontext (>272K) | Qwen4-Max | Kein Astra-typischer Pauschalaufschlag, maximale Ausgabe 393K | QwenCloud; APIYI noch nicht verfügbar |
| Medizinische Fachfragen | GPT-6 Astra | HealthBench Professional führt mit 6,0 | APIYI, OpenAI offiziell |
Wann GPT-6 Astra die richtige Wahl ist
- Multimodale Qualitätskontrolle: Diagramme, Dashboard-Screenshots und Videoclips müssen mit hoher Genauigkeit interpretiert werden – ein Fehler kostet deutlich mehr als die Token-Gebühren.
- Autonome Coding-Agenten: Im Sandbox-Terminal über lange Ketten Befehle ausführen und komplette Programme aufbauen – der Unterschied bei ProgramBench wirkt sich direkt auf die Erfolgsquote aus.
- Seltene, aber wertvolle Anfragen: Wenige Aufrufe, doch jedes Ergebnis beeinflusst Entscheidungen. Dann machen die 11-fachen Ausgabekosten nur einen begrenzten Anteil am Gesamtbudget aus.
Wann Qwen4-Max die richtige Wahl ist
- Textaufgaben mit hohem Durchsatz: Jeden Tag viele Dokumente verarbeiten, zusammenfassen, extrahieren – der 11,1-fache Preisunterschied bei der Ausgabe entscheidet direkt über die Monatsrechnung.
- Office-Agenten: Formularläufe, Business-Dokumente, automatisierte Workflows – hier sind schon die Scores von Qwen4-Max besser.
- Sehr lange Eingaben und sehr lange Ausgaben: Verträge mit mehreren hundert K, vollständige Reviews ganzer Code-Repositories sowie Berichte, die auf einen Schlag Hunderttausende Tokens umfassen.
Entscheidungshilfe zu Qwen4-Max und GPT-6 Astra
Für Teams, die Astra bereits nutzen und mit einem knappen Budget arbeiten, ist hybrides Routing die sicherere Vorgehensweise als ein kompletter Umstieg. Anfragen der drei Typen Diagramm, Terminal und Video gehen weiterhin an Astra; die übrigen Text- und Office-Agent-Anfragen wandern in die Qwen-Familie. Zusätzlich sollten Sie die langen Kontextanfragen an Astra auf höchstens 272K begrenzen. So bleiben die Fähigkeiten erhalten, in denen Astra tatsächlich führend ist, während der Kostenblock mit der größten Preisdifferenz wegfällt.
Vor einem Modellwechsel sollten Sie die folgenden drei Punkte prüfen:
- Modellbezeichnung prüfen: Prüfen Sie in der Modellliste von APIYI apiyi.com, ob
gpt-6-astraundqwen3.8-maxverfügbar sind, und achten Sie auf den Verfügbarkeitsstatus vonqwen4-max. Tragen Sie die Modell-ID nicht aus dem Gedächtnis ein. - Preise prüfen: Prüfen Sie die drei Einzelpreise für Eingabe, Ausgabe und Cache-Read sowie die $20-Eingabestufe von Astra ab 272.001 Tokens. Berechnen Sie anhand der tatsächlichen Token-Verteilung in Ihren Logs die Monatsabrechnung.
- Protokoll prüfen: Beide Modelle lassen sich über die OpenAI-kompatible Schnittstelle unter
https://api.apiyi.com/v1aufrufen. Setzen Sie beim Initialisieren des SDK einfachbase_urlauf diese Adresse. Astra unterstützt sowohl/v1/responsesals auch/v1/chat/completions. Wenn Sie die Inferenzstufe mitreasoning.effortanpassen möchten, sollten Sie das Parameterverhalten vorzugsweise auf dem Responses-Endpunkt testen.
💡 Tipp zur Auswahl: Senden Sie dieselben Geschäftsbeispiele sowohl an
gpt-6-astraals auch an Modelle der Qwen-Familie und erfassen Sie Trefferquote und Kosten pro Anfrage. Das ist verlässlicher, als Leaderboards zu lesen. Bei APIYI apiyi.com genügt ein Key, um den Parametermodelumzuschalten und so den Vergleich durchzuführen. Neue Nutzer erhalten außerdem ein kostenloses Testkontingent, mit dem sie zunächst kleine Stichproben ausprobieren können.
Häufig gestellte Fragen (FAQ)
Q1: Was sind Qwen4-Max und GPT-6 Astra jeweils für Modelle?
Qwen4-Max wurde am 2026-11-16 veröffentlicht und basiert auf einer Struktur mit 2.4T Gesamtparametern und 71B aktiven Parametern; es unterstützt native Vision und ein 1M-Kontextfenster. GPT-6 Astra ist das derzeit stärkste Allzweckmodell von OpenAI, mit einem Kontextfenster von 1,050,000 Tokens und fünf Reasoning-Stufen von low bis max.
Q2: Astra ist so viel teurer – lohnen sich die zusätzlichen Punkte?
Das hängt von der Aufgabe ab. Bei Diagrammverständnis (+16.9), ProgramBench (+23.5), Terminal-Bench (+10.6) und Videoverständnis (+8.6) ist Asters Vorsprung handfest; für diese Aufgaben lohnt sich der Aufpreis. Bei Office-Agent, HLAB-Vals und AA-Briefcase erzielt Qwen4-Max höhere Werte bei niedrigerem Preis – dann ist es nicht sinnvoll, für Astra zu zahlen.
Q3: Sind diese Benchmark-Ergebnisse vertrauenswürdig?
Die 15 Benchmarks sind alle von Qwen offiziell selbst gemeldete Vergleichswerte im selben Diagramm und damit Anbieterdaten – beim Lesen sollte man etwas Reserve einplanen. Der öffentliche Arena-Leaderboard-Snapshot (2026-11-14) kann als unabhängige Gegenprobe dienen; auch dort beträgt der Unterschied bei WebDev nur 13 Elo. Allerdings ist Qwen4-Max im Leaderboard noch als Preliminary gekennzeichnet, und die Stimmenzahl ist ebenfalls geringer.
Q4: Wie wird bei Astra die Regel für Eingaben über 272K berechnet?
Sobald die Eingabe einer einzelnen Anfrage 272K überschreitet, werden die Eingabe und der Cache der gesamten Anfrage mit dem 2-fachen Preis berechnet, die Ausgabe mit dem 1,5-fachen. Der Aufschlag gilt für die gesamte Anfrage und nicht nur für den überschreitenden Teil. Beispiel: 400K Eingabe plus 20K Ausgabe kosten etwa $9.50 – rund das 2,5-fache von 270K Eingabe bei gleicher Ausgabe.
Q5: Kann man Qwen4-Max jetzt schon über APIYI aufrufen?
Derzeit ist `qwen4-max` noch nicht verfügbar; wir werden es so bald wie möglich in die Modellliste aufnehmen. Bis dahin können Sie mit `qwen3.8-max` ($1.65 / $4.95 / Cache-Lesen $0.20625) den Qwen-Workflow validieren. `gpt-6-astra` ist bereits verfügbar; die einheitliche Endpoint-Adresse lautet `https://api.apiyi.com/v1`. Die konkreten Modellvarianten entnehmen Sie der Modellliste auf apiyi.com.
Q6: Wo hat Qwen4-Max eindeutige Schwächen?
Bei Diagrammverständnis, Videoverständnis, langkettiger Terminal-Bedienung und ProgramBench liegt es deutlich hinter Astra zurück, bei HealthBench Professional sind es ebenfalls 6 Punkte weniger. Wenn Ihr Kerngeschäft in diesen Szenarien liegt, könnte ein Wechsel zu Qwen4-Max allein wegen der Kostenersparnis durch eine niedrigere Erfolgsquote die eingesparten Kosten wieder aufzehren.
Qwen4-Max vs. GPT-6 Astra: Die Kernpunkte (Key Takeaways)
- Preisunterschied: Astras Input-Preis liegt beim 6,7-Fachen von Qwen4-Max, der Output-Preis beim 11,1-Fachen und der Cache-Read beim 13,3-Fachen.
- Astras echte Stärken: Chartography 71,1 zu 54,2, Video-Index 76,7 zu 68,1 – auch beim Terminal- und Repository-Aufbau liegt es vorn.
- Qwen4s echte Stärken: HLAB-Vals 21,3 zu 7,1, AA-Briefcase 1686 zu 1569 – beim Office-Agent insgesamt stärker.
- Die Long-Context-Falle: Überschreitet der Astra-Input 272K, wird die gesamte Anfrage teurer – Input ×2, Output ×1,5.
- Output-Limit: Qwen4-Max liefert maximal 393K Output, Astra 128K.
- So legt man los: Bei APIYI vergleicht man mit demselben Key
gpt-6-astraund die Qwen-Modellreihe direkt;qwen4-maxwird gerade eingeführt.
Zusammenfassung
Der Vergleich von Qwen4-Max mit GPT-6 Astra liefert drei zentrale Erkenntnisse:
- Astras Preisaufschlag entspricht drei echten Fähigkeiten: Diagrammverständnis, Terminal- und Repository-Aufbau sowie Videoverständnis – für diese Aufgaben lohnt es sich zu zahlen.
- Qwen4-Max ist nicht nur günstig: Beim Office-Agent und in mehreren spezialisierten Benchmarks erzielt es höhere Werte und hat zudem ein größeres Output-Limit.
- Long Context muss man separat rechnen: Astras 272K-Schwelle lässt die Kosten pro Anfrage sprunghaft steigen. Den Input durch Retrieval-Kürzung unter die Schwelle zu drücken, ist der direkteste Weg, Geld zu sparen.
Für die meisten Teams ist ein aufgabenbasiertes gemischtes Routing rentabler als ein kompletter Wechsel. Es empfiehlt sich, bei APIYI (apiyi.com) mit echten Geschäftsbeispielen einen A/B-Vergleich durchzuführen und erst dann die Verteilung der einzelnen Request-Typen festzulegen.
📚 Referenzen
- OpenAI-Modelldokumentation – GPT-6 Astra: Spezifikationen, Kontextfenster und Reasoning-Stufen
- Link:
developers.openai.com/api/docs/models/gpt-6-astra -
Beschreibung: Originalquelle für Kontextlänge, maximale Ein- und Ausgabe sowie die
reasoning.effort-Stufen -
OpenAI-Preisseite: Standardpreise und Preisregeln für Kontexte über 272K
- Link:
developers.openai.com/api/docs/pricing -
Beschreibung: Einzelpreise für Eingabe, Ausgabe sowie Cache-Lesen und Cache-Schreiben, dazu der Zuschlag für lange Kontexte auf die gesamte Rechnung
-
arena.ai Code Arena WebDev-Rangliste: Öffentliche Drittanbieter-Rangliste (Snapshot-Datum 2026-11-14)
- Link:
arena.ai - Beschreibung: Quervergleich von Elo-Ranking, Stimmenzahl und Kosten pro Aufgabe
Autor: APIYI-Technikteam
Fachlicher Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com


