
ملاحظة المؤلف: تقارن هذه المقالة بين Qwen4-Max وGPT-6 Astra من حيث النتائج المعيارية ومواصفات نافذة السياق وسعري الإدخال والإخراج، وتوضح حسب نوع المهمة أيهما أكثر جدوى.
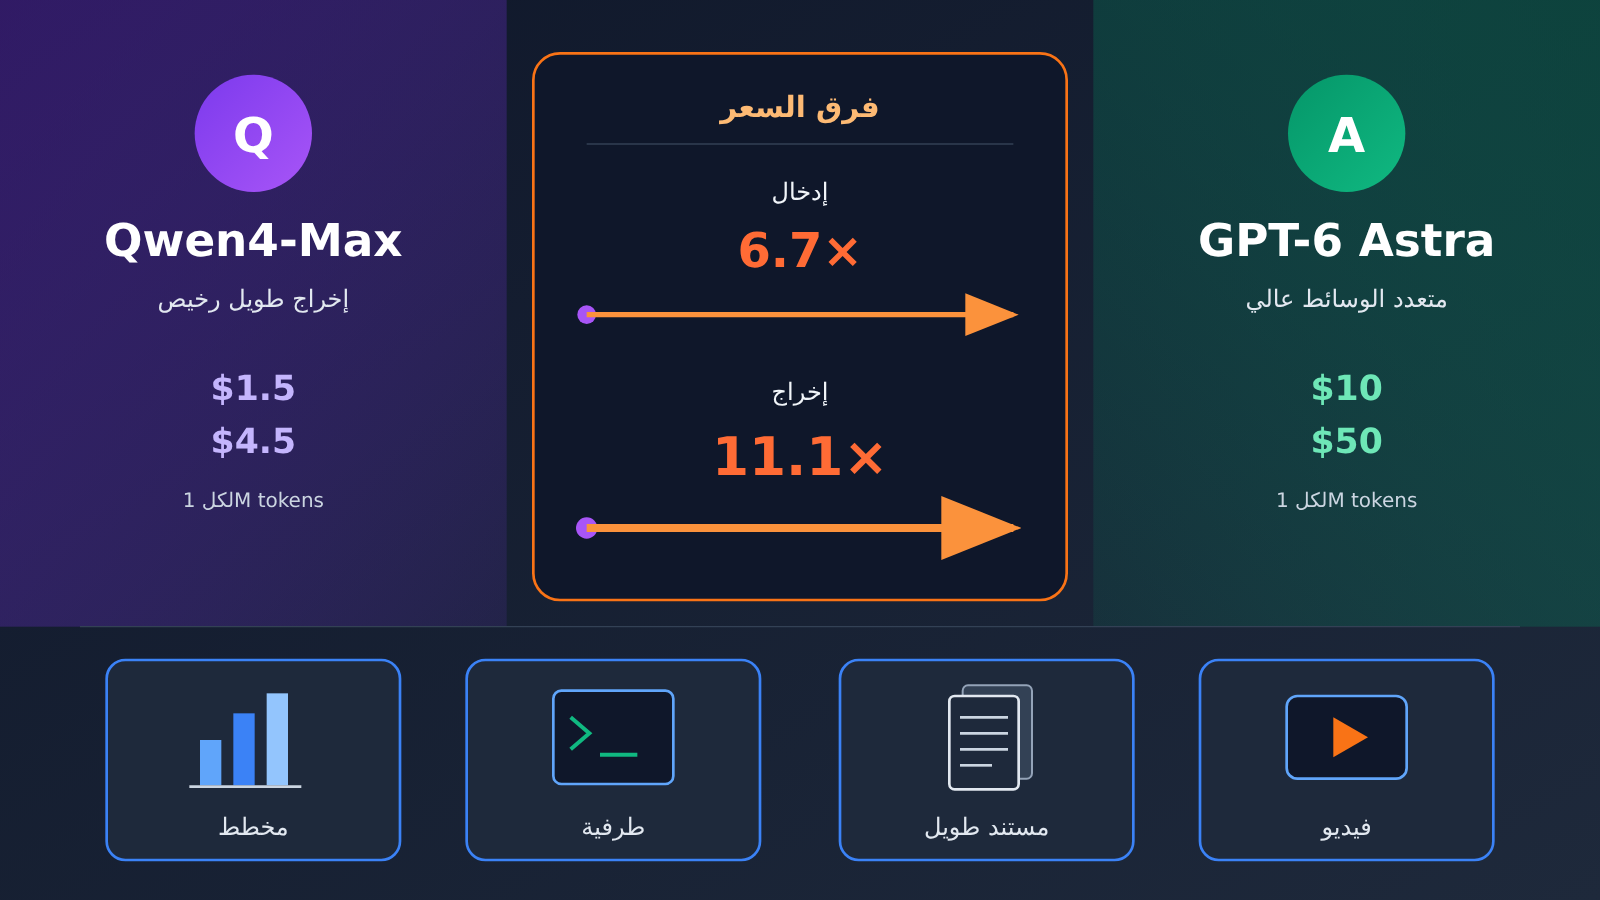
الخلاصة أولاً: سعر الإدخال لدى GPT-6 Astra يعادل نحو 6.7 مرة سعر Qwen4-Max، وسعر الإخراج نحو 11.1 مرة. هذه العلاوة السعرية تقابلها أشياء محددة للغاية، أبرزها درجات أعلى في ثلاث فئات من المهام: فهم المخططات، والعمل عبر الطرفية ومستودعات الشيفرة، وفهم الفيديو. أما في وكلاء المهام المكتبية وبعض التقييمات المتخصصة، فإن Qwen4-Max يتقدم بدوره.
هذه ليست مقالة من نوع «أي نموذج يتفوق على الآخر في كل شيء». لكل من النموذجين نقاط قوة واضحة ونقاط ضعف واضحة. تقتصر المقارنة هنا على هذين الطرازين، وتأتي الحقائق من أربعة مصادر: المقارنة الرسمية التي أعلنتها Qwen على المخطط نفسه، والنص الأصلي لوثائق OpenAI، ولقطة من لوحة الصدارة العامة لـ arena (2026-11-14)، وقائمة أسعار منصة APIYI.
القيمة الأساسية: بعد قراءة هذه المقالة، ستحصل على جدول لاختيار النموذج حسب المهمة والميزانية، وتعرف أين ذهبت الأموال الإضافية التي دفعتها مقابل Astra، وستعرف أيضًا كيف تُحسب قاعدة زيادة السعر على الطلب بأكمله عندما يتجاوز إدخال Astra 272K.
الفروق الجوهرية بين Qwen4-Max و GPT-6 Astra
لنبدأ بوضع المواصفات والأسعار في جدول واحد. بيانات المواصفات والأسعار مأخوذة من قائمة أسعار QwenCloud ونص وثائق OpenAI، بتاريخ 2026-11-16، وجميع الأسعار بالدولار لكل مليون tokens.
| معيار المقارنة | Qwen4-Max | GPT-6 Astra | الأكثر تفوقًا |
|---|---|---|---|
| البنية / التموضع | هيكل رئيسي 2.4T / 71B مُفعّلة + 328B N-gram Embedding، رؤية أصلية | أقوى نموذج عام في الخدمة لدى OpenAI | لكل منهما تموضعه |
| نافذة السياق | 1M | 1,050,000 | متساويان تقريبًا |
| أقصى إدخال | 991K (وضع التفكير 983K) | 922K | Qwen4-Max |
| أقصى إخراج | 393K (أقصى سلسلة تفكير 262K) | 128K | Qwen4-Max |
| مستويات الاستدلال | وضع التفكير | reasoning.effort: low / medium / high / xhigh / max |
Astra أكثر تفصيلًا |
| سعر الإدخال | $1.5 | $10 (يتضاعف عند تجاوز الإدخال 272K) | Qwen4-Max |
| سعر الإخراج | $4.5 | $50 (1.5 ضعف عند تجاوز الإدخال 272K) | Qwen4-Max |
| تاريخ انتهاء المعرفة | غير مذكور في المصادر المرجعية | 2026-04-30 | — |
الفرق في نافذة السياق بين Qwen4-Max و GPT-6 Astra
كلا الطرفين يعلنان نافذة سياق في حدود 1M، والفرق يكمن في توزيع الإدخال والإخراج. يستطيع Qwen4-Max في الطلب الواحد أن يُخرج حتى 393K tokens، وهذا السقف مفيد جدًا في توليد التقارير الطويلة، وإعادة كتابة أجزاء كبيرة من الشيفرة، والاستخراج المنظم بالجملة. أما سقف إخراج Astra فهو 128K، وهو كافٍ للمهام اليومية، لكنه يحتاج إلى تقسيم عند التوليد الطويل جدًا.
في بند أقصى إدخال، يتفوق Qwen4-Max أيضًا قليلًا بـ 991K مقابل 922K لدى Astra. عند الاختيار العملي، الجدير بالانتباه أكثر هو عتبة التسعير لدى Astra: بمجرد أن يتجاوز الإدخال 272K، يرتفع سعر الوحدة على الطلب كله. وسنحسب هذه الكلفة بشكل منفصل في قسم التكلفة لاحقًا.
نظرة تفصيلية على نتائج Qwen4-Max مقابل GPT-6 Astra في الاختبارات
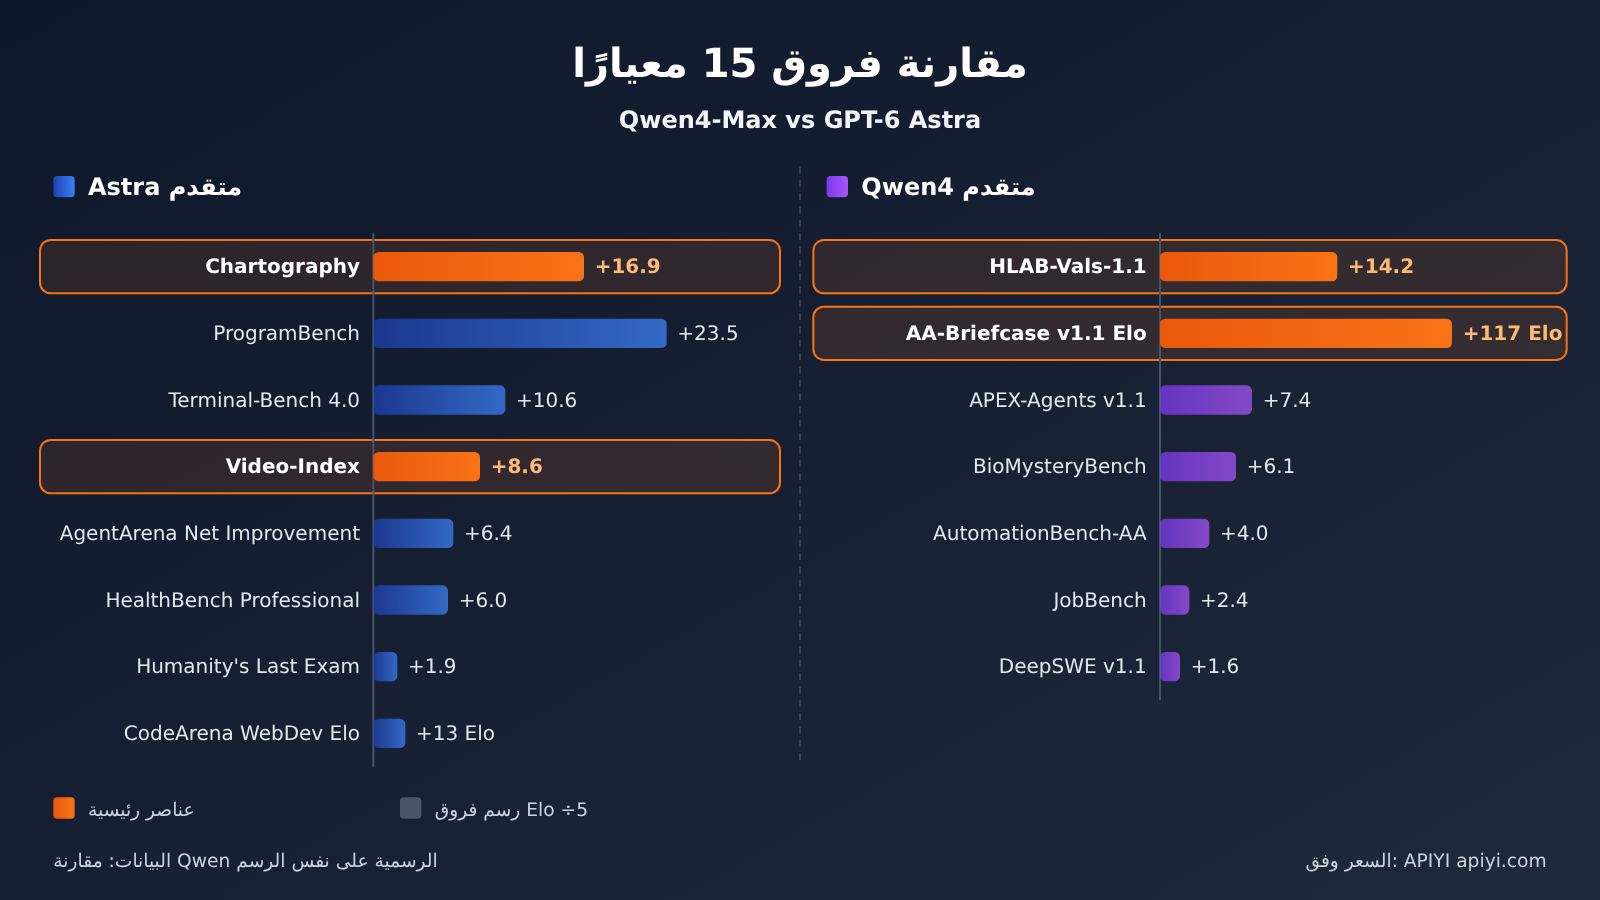
هذه الدرجات كلها مأخوذة من مقارنة على الرسم البياني نفسه أعلنتها Qwen رسميًا. وعندما ينشر أحد الأطراف هذا النوع من المقارنات، فمن الأفضل قراءتها بتحفّظ. لكن Qwen نفسها أدرجت أيضًا في الجدول بعض أوجه تفوق Astra الواضحة، ما يرفع المصداقية نسبيًا.
| الاختبار | Qwen4-Max | GPT-6 Astra | الفارق | المتفوق |
|---|---|---|---|---|
| Chartography | 54.2 | 71.1 | 16.9 | Astra |
| ProgramBench | 31.5 | 55.0 | 23.5 | Astra |
| Terminal-Bench 4.0 | 48.5 | 59.1 | 10.6 | Astra |
| Video-Index | 68.1 | 76.7 | 8.6 | Astra |
| AgentArena Net Improvement | 7.5 | 13.9 | 6.4 | Astra |
| HealthBench Professional | 60.0 | 66.0 | 6.0 | Astra |
| Humanity’s Last Exam | 51.7 | 53.6 | 1.9 | Astra |
| CodeArena WebDev Elo | 1750 | 1763 | 13 | Astra |
| HLAB-Vals-1.1 | 21.3 | 7.1 | 14.2 | Qwen4 |
| AA-Briefcase v1.1 Elo | 1686 | 1569 | 117 | Qwen4 |
| APEX-Agents v1.1 | 72.1 | 64.7 | 7.4 | Qwen4 |
| BioMysteryBench | 85.0 | 78.9 | 6.1 | Qwen4 |
| AutomationBench-AA | 72.5 | 68.5 | 4.0 | Qwen4 |
| JobBench | 68.5 | 66.1 | 2.4 | Qwen4 |
| DeepSWE v1.1 | 75.7 | 74.1 | 1.6 | Qwen4 |
المزايا الحقيقية لـ GPT-6 Astra: الرسوم البيانية والطرفية والفيديو
فجوة فهم الرسوم البيانية هي الأكبر. على Chartography، سجّل Astra نتيجة 71.1 مقابل 54.2 لـ Qwen4-Max، بفارق 16.9 نقطة. إذا كان عملك يتطلب قراءة رسوم التقارير المالية أو لقطات شاشة لوحات المراقبة أو الرسوم العلمية، فسيظهر هذا الفارق مباشرة في دقة الاستخراج، ومن الصعب تعويضه عبر الموجهات وحدها.
الطرفية ومستودعات الشيفرة هما المجال الثاني. على Terminal-Bench 4.0، بلغ الفارق 10.6 نقطة، وعلى ProgramBench بلغ 23.5 نقطة. يقيس هذان الاختباران القدرة على تنفيذ أوامر متعددة الخطوات وبناء برنامج كامل، وهما من أهم المهارات التي يعتمد عليها وكيل البرمجة. أما على DeepSWE، فقد تفوّق Qwen4-Max بفارق ضئيل بلغ 1.6 نقطة، ما يعني أن قدرته على إصلاح مشكلة واحدة ليست ضعيفة. لكن حين تتحول المهمة إلى «بناء مشروع داخل الطرفية عبر سلسلة طويلة من الخطوات»، يكون Astra أكثر ثباتًا.
لا يمكن تجاهل فهم الفيديو. على Video-Index، سجّل Astra نتيجة 76.7 مقابل 68.1، متقدمًا بـ 8.6 نقطة. ورغم أن Qwen4-Max يدعم الرؤية أصلاً، فإنه لا يزال متأخرًا بعض الشيء في فهم الفيديو. وينبغي للفرق التي تحتاج إلى مراجعة محتوى الفيديو أو استرجاع المقاطع أو تلخيص الفيديوهات التعليمية أن تضع هذا البند في مقدمة قائمة معايير اختيار النموذج.
الميزة الحقيقية لـ Qwen4-Max: وكلاء المكاتب والتقييمات المتخصصة
HLAB-Vals-1.1 هو البند الذي يتقدم فيه Qwen4-Max بأوضح فارق، 21.3 مقابل 7.1، بفارق مطلق 14.2، أي ما يقارب ثلاثة أضعاف نسبيًا. يتقدم في AA-Briefcase v1.1 Elo بمقدار 117 نقطة (1686 مقابل 1569). تتجه هذه التقييمات نحو مهام الوكلاء المرتبطة بالمستندات التجارية وسير العمل المكتبي، وفي نظام Elo يُعد فارق 117 نقطة واضحًا إلى حد كبير.
كما يتقدم Qwen4-Max في APEX-Agents (+7.4) وAutomationBench-AA (+4.0) وJobBench (+2.4). وبالنظر إلى هذه البنود مجتمعة، فإن الاستنتاج هو: في سيناريوهات أتمتة العمليات ومهام الوكلاء المكتبية، لا يقتصر تفوق Qwen4-Max على انخفاض التكلفة، بل يحقق نتائج أعلى أيضًا.
لقطة سريعة من لوحة Code Arena العامة (2026-11-14)
يمكن أن تكون لوحات التقييم المستقلة مرجعًا متقاطعًا. تُظهر لقطة اللوحة العامة لـ arena.ai Code Arena WebDev أن GPT-6 Astra (Max) يحتل المرتبة الخامسة بـ 1763 نقطة، بعدد أصوات 8,685، وتكلفة $9.43 لكل مهمة. ويحتل Qwen4-Max (xHigh) المرتبة السادسة بـ 1750 نقطة، مع وسم Preliminary، و1,814 صوتًا، وتكلفة $4.18 لكل مهمة.
يقع فارق 13 نقطة في Elo ضمن سيناريو WebDev في المستوى نفسه، لكن تكلفة المهمة الواحدة تختلف بأكثر من الضعف. وتجدر الإشارة إلى أن عدد أصوات Qwen4-Max لا يزال قليلًا، وقد يستمر ترتيبه في التذبذب، لذا فهو جدير بالمتابعة المستمرة.
مقارنة أسعار الإدخال والإخراج بين Qwen4-Max وGPT-6 Astra
تنقسم قائمة الأسعار إلى جزأين: السعر الرسمي، والسعر الحالي عبر APIYI. أُخذت الأسعار الرسمية من النصوص الأصلية في وثائق QwenCloud وOpenAI، بتاريخ 2026-11-16، والوحدة لكل مليون توكن.
| بند الفوترة | Qwen4-Max (QwenCloud) | GPT-6 Astra (نص وثائق OpenAI) | المضاعف |
|---|---|---|---|
| الإدخال | $1.5 | $10 | 6.7× |
| الإخراج | $4.5 | $50 | 11.1× |
| قراءة التخزين المؤقت | $0.075 | $1 | 13.3× |
| كتابة التخزين المؤقت | 5 دقائق $1.875 / ساعة $3 | $12.5 | 4.2–6.7× |
| عند تجاوز إدخال 272K | لم تذكر المواد المرجعية شرائح التسعير | الطلب بأكمله: الإدخال والتخزين المؤقت ×2، والإخراج ×1.5 | — |
فخ التسعير المضاعف في GPT-6 Astra عند تجاوز إدخال 272K
تقول قاعدة وثائق OpenAI: إذا تجاوز إدخال طلب واحد 272K، تُحسب مدخلات الطلب بأكمله وذاكرته المؤقتة بضعف السعر، ويُحسب الإخراج بـ1.5 ضعف. لا يقتصر ارتفاع السعر هنا على الجزء الذي يتجاوز 272K؛ بل يُحسب الطلب كله بالسعر الأعلى. وكثير من الفرق تفوّت هذه النقطة عند تقدير تكلفة RAG للمستندات الطويلة أو السياق الكامل لمستودع الشيفرة.
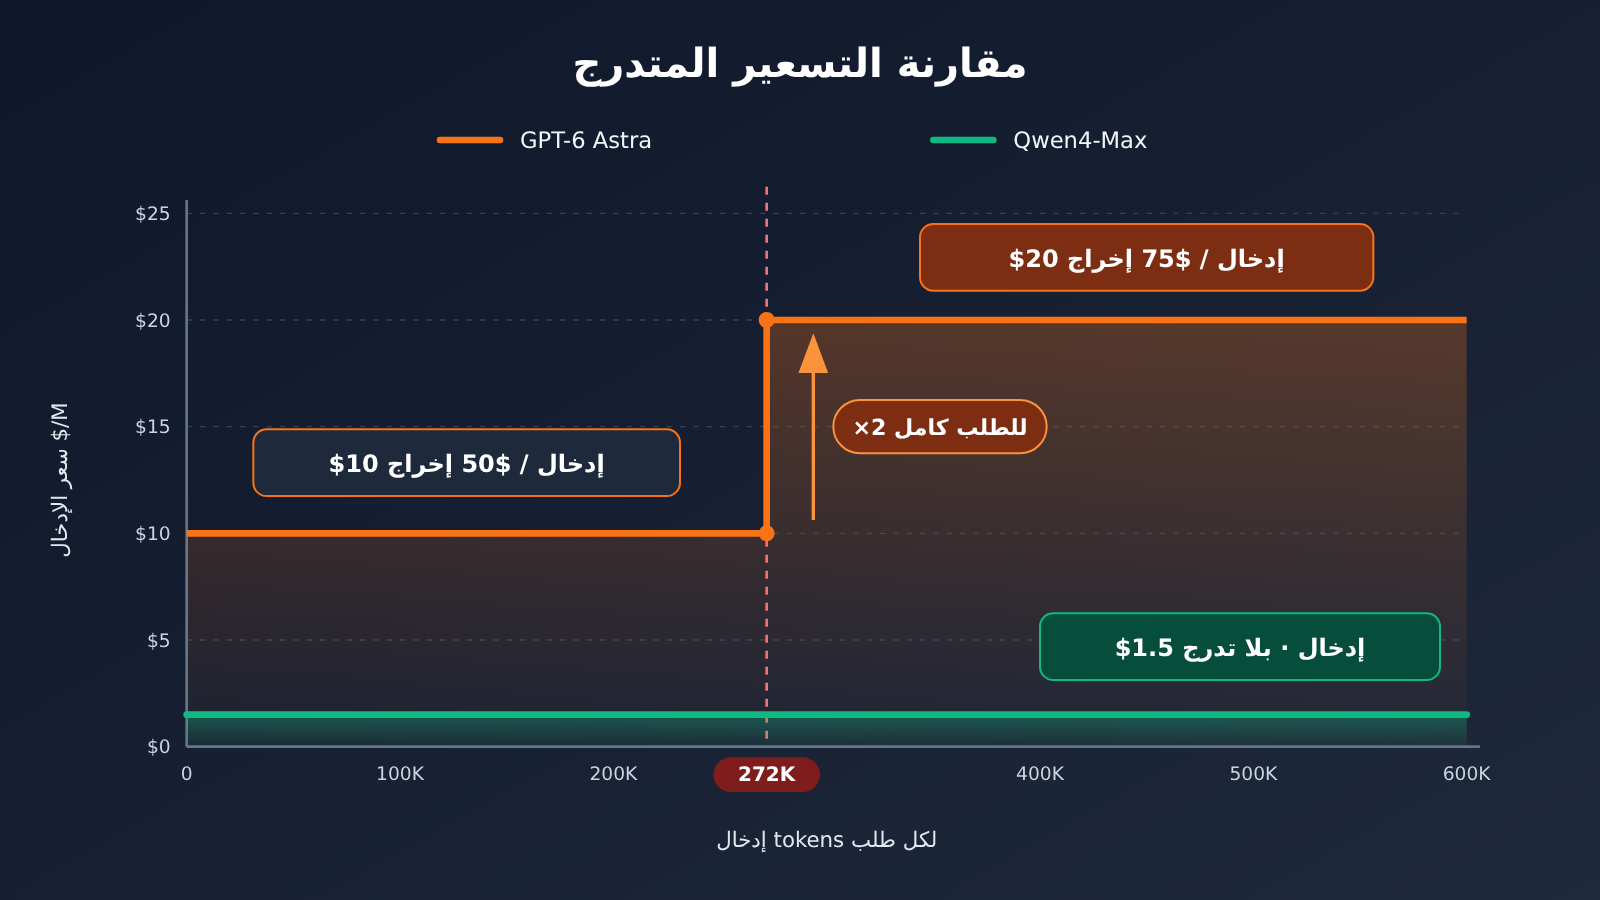
لنحسب ذلك باستخدام عدة طلبات نموذجية. الأسعار وفق السعر الرسمي القياسي، ومن دون احتساب التخزين المؤقت حاليًا.
| السيناريو | Qwen4-Max | GPT-6 Astra | الفارق |
|---|---|---|---|
| طلب واحد: 270K إدخال + 20K إخراج | نحو $0.50 | نحو $3.70 | نحو 7.4× |
| طلب واحد: 400K إدخال + 20K إخراج | نحو $0.69 | نحو $9.50 (بعد تفعيل قاعدة 272K) | نحو 13.8× |
| شهريًا: 100 مليون إدخال + 10 ملايين إخراج (كل الطلبات ضمن 272K) | نحو $195 | نحو $1,500 | نحو 7.7× |
| كما سبق، لكن كل الطلبات سياق طويل يتجاوز 272K | نحو $195 (بحسب السعر القياسي) | نحو $2,750 | نحو 14× |
الصف الثاني يوضح الفكرة أفضل من غيره. عندما يرتفع الإدخال من 270K إلى 400K، يزداد عدد التوكنات بأقل من النصف، ومع ذلك يقفز سعر الطلب الواحد لدى Astra من $3.70 إلى $9.50. لذا عند تصميم تدفق سياق طويل لـ Astra، من الأفضل إبقاء إدخال الطلب الواحد ضمن 272K. يمكن أولاً تقليم نتائج الاسترجاع أو تلخيصها على شكل كتل، ثم تمرير النتيجة إلى Astra للاستدلال النهائي.
أسعار APIYI الحالية وحالة إتاحة النماذج
فيما يلي أسعار APIYI الحالية (2026-11-16). والمرجع النهائي هو قائمة النماذج على المنصة.
gpt-6-astra: الإدخال $10، والإخراج $50، وقراءة الذاكرة المؤقتة $1؛ أما الإدخال ضمن نطاق 272,001–1,050,000 tokens فسعره $20، بما يتوافق مع الشرائح الرسمية.qwen3.8-max: الإدخال $1.65، والإخراج $4.95، وقراءة الذاكرة المؤقتة $0.20625.qwen4-max: لم تتم إضافته بعد، وسنضيف هذا النموذج في أقرب وقت. بعد إضافته، يُرجى الاعتماد على قائمة النماذج في apiyi.com لمعرفة معرف النموذج وسعره.
💰 نصيحة بشأن التكلفة: قبل إتاحة
qwen4-max، يمكنك أولاً استخدامqwen3.8-maxلاختبار موجهات Qwen وتدفق استدعاء الأدوات، ثم بعد إطلاق النموذج الجديد غيّر معاملmodelمباشرة. تستخدم السلسلتان مفتاح API نفسه على APIYI apiyi.com، وتظهر الفاتورة في المكان نفسه، ما يسهّل مقارنة التكلفة الفعلية لكل منهما مباشرة.
اختر Qwen4-Max أم GPT-6 Astra حسب المهمة
عندما نجمع نتائج الاختبارات والأسعار في مكان واحد، يمكننا تقديم توصيات حسب نوع المهمة.
| نوع المهمة | الموصى به | السبب | المنصات المتاحة |
|---|---|---|---|
| فهم الرسوم البيانية / لقطات الشاشة | GPT-6 Astra | Chartography يتقدم بـ 16.9 نقطة | APIYI apiyi.com، OpenAI الرسمي |
| عمليات الطرفية وبناء مستودع كود كامل | GPT-6 Astra | Terminal-Bench +10.6، ProgramBench +23.5 | APIYI، OpenAI الرسمي |
| فهم الفيديو | GPT-6 Astra | Video-Index يتقدم بـ 8.6 نقطة | APIYI، OpenAI الرسمي |
| إصلاح مشكلة واحدة / WebDev | Qwen4-Max (الأفضل من حيث القيمة مقابل السعر) | DeepSWE يتفوق بقفزة صغيرة، وWebDev متأخر بـ 13 Elo فقط، وتكلفة المهمة الواحدة نحو النصف | QwenCloud؛ APIYI قيد الإطلاق |
| وكلاء الأتمتة المكتبية وسير العمل | Qwen4-Max | AA-Briefcase +117، APEX +7.4، HLAB-Vals +14.2 | QwenCloud؛ APIYI قيد الإطلاق |
| المعالجة الدفعية للسياق الطويل (>272K) | Qwen4-Max | لا توجد زيادة سعرية على الطلب الكامل كما في Astra، والحد الأقصى للإخراج 393K | QwenCloud؛ APIYI قيد الإطلاق |
| الأسئلة الطبية التخصصية | GPT-6 Astra | HealthBench Professional يتقدم بـ 6.0 | APIYI، OpenAI الرسمي |
متى يناسبك GPT-6 Astra
- فحص الجودة متعدد الوسائط: عندما تحتاج إلى تفسير عالي الدقة للرسوم البيانية ولقطات شاشة لوحات المعلومات ومقاطع الفيديو، ويكون ثمن الخطأ أعلى بكثير من تكلفة الـ tokens.
- وكيل برمجة مستقل: عندما تحتاج إلى تنفيذ أوامر عبر سلسلة طويلة في طرفية معزولة وبناء برنامج كامل، فإن الفارق في ProgramBench سيؤثر مباشرة على معدل نجاح المهمة.
- طلبات منخفضة التكرار وعالية القيمة: حجم الاستدعاءات ليس كبيرًا، لكن كل نتيجة تؤثر على القرار، وهنا يمثل سعر الإخراج الأعلى بـ 11 ضعفًا نسبة محدودة من إجمالي الميزانية.
متى يناسبك Qwen4-Max
- مهام نصية عالية الإنتاجية: معالجة كميات كبيرة من المستندات والتلخيص والاستخلاص يوميًا، حيث يحدد فارق سعر الإخراج البالغ 11.1 ضعفًا فاتورتك الشهرية مباشرة.
- وكلاء المهام المكتبية: تدفق النماذج، ومعالجة مستندات الأعمال، وسير العمل الآلي، فنتائج Qwen4-Max نفسها أعلى في هذه المجالات.
- مدخلات فائقة الطول ومخرجات فائقة الطول: مراجعة عقود بحجم مئات K أو مستودعات كود كاملة، وكذلك الحاجة إلى توليد مئات الآلاف من الـ tokens في تقرير واحد دفعة واحدة.
توصيات الاختيار بين Qwen4-Max وGPT-6 Astra
بالنسبة إلى الفرق التي تستخدم Astra بالفعل وتواجه ضغطًا في الميزانية، فإن النهج الأكثر أمانًا هو التوجيه الهجين بدلًا من التبديل الكامل. اترك طلبات المخططات والطرفية والفيديو لـ Astra، وانقل بقية طلبات النماذج النصية ووكلاء المكاتب إلى نماذج Qwen، ثم قلّص طلبات السياق الطويل على Astra إلى أقل من 272K. بهذه الطريقة تحافظ على القدرات التي يتفوق فيها Astra فعلًا، وتتخلص من الجزء الأكبر من فرق التكلفة.
قبل تغيير النموذج، يُنصح بالتحقق من الخطوات الثلاث التالية:
- تحقق من الطراز: في قائمة النماذج على APIYI apiyi.com، تأكد من توفر
gpt-6-astraوqwen3.8-max، وانتبه إلى حالة إدراجqwen4-max، ولا تكتب معرّف الطراز اعتمادًا على الذاكرة. - تحقق من الأسعار: راجع أسعار الوحدات الثلاثة: الإدخال والإخراج وقراءة التخزين المؤقت، وكذلك شريحة سعر الإدخال $20 لدى Astra عند تجاوز 272,001 tokens. واحسب فاتورة الشهر بناءً على توزيع tokens الفعلي في سجلاتك.
- تحقق من البروتوكول: يمكن استدعاء كلا النموذجين عبر واجهة متوافقة مع OpenAI على
https://api.apiyi.com/v1، ويكفي ضبطbase_urlعلى هذا العنوان عند تهيئة SDK. يدعم Astra أيضًا نقطتي النهاية/v1/responsesو/v1/chat/completions؛ وعند الحاجة إلى ضبط مستوى الاستدلال باستخدامreasoning.effort، يُستحسن التحقق أولًا من سلوك المعاملات على نقطة النهاية Responses.
💡 توصية الاختيار: أرسل الدفعة نفسها من عينات العمل إلى
gpt-6-astraوإلى أحد طرازات Qwen كلٌّ على حدة، وسجّل معدل الإجابات الصحيحة والتكلفة لكل طلب؛ فهذا أكثر موثوقية من الاعتماد على قوائم التصنيف. عبر APIYI apiyi.com يمكنك تبديل المعاملmodelباستخدام مفتاح واحد لإتمام المقارنة، كما أن المستخدمين الجدد لديهم حصة اختبار مجانية تتيح لهم تشغيل عينة صغيرة أولًا.
الأسئلة الشائعة
س1: ما هو موقع كل من Qwen4-Max وGPT-6 Astra؟
صدر Qwen4-Max في 2026-11-16، بهيكل أساسي بسعة 2.4T ومُفعَّل بـ 71B، ويدعم الرؤية الأصلية وسياقًا يبلغ 1M. أما GPT-6 Astra فهو أقوى نموذج عام في الخدمة حاليًا لدى OpenAI، بنافذة سياق تبلغ 1,050,000 tokens، ومستويات استدلال من low إلى max بخمس درجات.
س2: Astra أغلى بكثير، فهل تستحق الفروق في النقاط هذا السعر؟
يعتمد الأمر على المهمة. في فهم الرسوم البيانية (+16.9)، وProgramBench (+23.5)، وTerminal-Bench (+10.6)، وفهم الفيديو (+8.6)، تفوّق Astra حقيقي وتستحق دفع فرق السعر من أجل هذه المهام. أما في وكيل المهام المكتبية، وHLAB-Vals، وAA-Briefcase، فإن Qwen4-Max يحصل على نقاط أعلى بسعر أقل، ولا يكون دفع مبلغ إضافي مقابل Astra مجديًا.
س3: هل يمكن الوثوق بنتائج هذه الاختبارات؟
جميع الاختبارات المعيارية الخمسة عشر هي مقارنات على الرسم البياني نفسه أعلنتها Qwen رسميًا، وهي بذلك بيانات من طرف أول، لذا يُستحسن قراءتها ببعض التحفّظ. ويمكن اعتبار لقطة لوحة Arena العامة (2026-11-14) مرجعًا مستقلًا للتحقق المتقاطع، والفارق بينهما في WebDev هو نفسه 13 نقطة Elo فقط. لكن Qwen4-Max ما يزال مُعلَّمًا على اللوحة بوصفه Preliminary، وعدد الأصوات قليل أيضًا.
س4: كيف تُحسب قاعدة Astra لما يتجاوز 272K من المدخلات؟
عندما يتجاوز حجم المدخلات في الطلب الواحد 272K، تُحسب مدخلات الطلب بأكمله وذاكرة التخزين المؤقت بضعف السعر، وتُحسب المخرجات بمعامل 1.5، ويغطي فرق السعر الطلب بأكمله لا الجزء الزائد فقط. فمثلًا، طلب بمدخلات 400K ومخرجات 20K تبلغ تكلفته نحو $9.50، أي حوالي 2.5 ضعف تكلفة طلب بمدخلات 270K ونفس المخرجات.
س5: هل يمكنني الآن استدعاء Qwen4-Max عبر APIYI؟
حاليًا لم يُدرج `qwen4-max` بعد، وسنوفّر الإدراج في أقرب وقت ممكن. وقبل ذلك يمكنك استخدام `qwen3.8-max` ($1.65 / $4.95 / قراءة من ذاكرة التخزين المؤقت $0.20625) للتحقق من سير العمل الخاص بعائلة Qwen. أما `gpt-6-astra` فهو متاح بالفعل، وعنوان الوصول موحّد وهو `https://api.apiyi.com/v1`، ويُرجع إلى قائمة النماذج على apiyi.com لتحديد الطُرز الدقيقة.
س6: ما هي نقاط الضعف الواضحة في Qwen4-Max؟
إنه متأخر بوضوح عن Astra في فهم الرسوم البيانية، وفهم الفيديو، والعمليات الطويلة عبر الطرفية، وProgramBench، كما أنه أقل بـ 6 نقاط في HealthBench Professional. وإذا كان جوهر عملك يتركّز في هذه السيناريوهات، فإن الانتقال إلى Qwen4-Max لمجرد التوفير قد يقايض المال الذي توفره بانخفاض معدل النجاح.
أبرز النقاط في مقارنة Qwen4-Max وGPT-6 Astra
- فرق السعر: سعر الإدخال في Astra يبلغ 6.7 أضعاف نظيره في Qwen4-Max، وسعر الإخراج 11.1 ضعفًا، وقراءة الذاكرة المؤقتة 13.3 ضعفًا.
- الميزة الحقيقية لـ Astra: Chartography بنتيجة 71.1 مقابل 54.2، وVideo-Index بنتيجة 76.7 مقابل 68.1، كما يتقدم في الطرفية وبناء مستودعات الشيفرة.
- الميزة الحقيقية لدى Qwen4: HLAB-Vals بنتيجة 21.3 مقابل 7.1، وAA-Briefcase بنتيجة 1686 مقابل 1569، ووكيل المهام المكتبية أقوى إجمالًا.
- فخ السياق الطويل: عندما يتجاوز الإدخال لدى Astra حد 272K، تُفرض زيادة على الطلب بالكامل: الإدخال ×2 والإخراج ×1.5.
- الحد الأقصى للإخراج: يبلغ أقصى إخراج لدى Qwen4-Max 393K، مقابل 128K لدى Astra.
- طريقة البدء: على APIYI، استخدم مفتاح API نفسه لمقارنة
gpt-6-astraمع طرازات عائلة Qwen؛ وqwen4-maxقيد الإتاحة حاليًا.
الخلاصة
عند مقارنة Qwen4-Max بـ GPT-6 Astra، ثمة ثلاث نتائج رئيسية:
- الزيادة السعرية لدى Astra تقابلها ثلاث قدرات حقيقية: فهم الرسوم البيانية، والعمل في الطرفية وبناء مستودعات الشيفرة، وفهم الفيديو. وهذه المهام تستحق أن تدفع مقابلها.
- Qwen4-Max ليس مجرد خيار رخيص: فهو يسجل درجات أعلى في وكيل المهام المكتبية وفي عدة اختبارات تخصصية، كما أن الحد الأقصى للإخراج لديه أكبر.
- السياق الطويل يحتاج إلى حسابات منفصلة: عتبة 272K لدى Astra ترفع تكلفة الطلب الواحد بشكل مفاجئ. وضغط الإدخال عبر تقليم نتائج الاسترجاع إلى ما دون العتبة هو أكثر الطرق مباشرة لتقليل التكلفة.
بالنسبة لمعظم الفرق، يكون التوجيه المختلط حسب المهمة أكثر جدوى من التبديل الكامل. نوصي بإجراء مقارنة A/B على APIYI عبر apiyi.com باستخدام عينات أعمال حقيقية، ثم تحديد نسبة توزيع كل نوع من الطلبات.
📚 المراجع
- وثائق نماذج OpenAI – GPT-6 Astra: المواصفات والسياق ومستويات الاستدلال
- الرابط:
developers.openai.com/api/docs/models/gpt-6-astra -
الوصف: المصدر الأصلي لطول السياق، والحد الأقصى للمدخلات والمخرجات، ومستويات
reasoning.effort -
صفحة أسعار OpenAI: الأسعار القياسية وقواعد التسعير لما يتجاوز 272K
- الرابط:
developers.openai.com/api/docs/pricing -
الوصف: أسعار الوحدة للمدخلات والمخرجات وقراءة/كتابة ذاكرة التخزين المؤقت، إضافة إلى قاعدة زيادة السعر الإجمالي للطلبات ذات السياق الطويل
-
لوحة صدارة Code Arena WebDev على arena.ai: لوحة صدارة عامة من طرف ثالث (تاريخ اللقطة 2026-11-14)
- الرابط:
arena.ai - الوصف: مرجع متقاطع لترتيب Elo وعدد الأصوات وتكلفة المهمة الواحدة
المؤلف: فريق APIYI التقني
التواصل التقني: يسعدنا أن تتواصل معنا عبر الصفحة الرئيسية لموقع APIYI؛ ولمزيد من المواد يمكنك زيارة مركز وثائق docs.apiyi.com


