
Note de l’auteur : les agents multi-projets ont besoin de contextes indépendants, d’un état persistant, d’un ordonnancement des tâches et de mécanismes de reprise. C’est à ce prix que le travail parallèle reste traçable et que les projets ne se marchent pas dessus.
Un assistant IA peut-il faire avancer plusieurs projets en même temps ? Quatre éléments sont décisifs : chaque chantier dispose d’un contexte indépendant, l’état d’exécution est conservé durablement, un ordonnanceur gère les priorités et la concurrence, et une interruption peut être reprise à partir d’un point de contrôle. Appeler plusieurs modèles en parallèle n’a rien de difficile ; le difficile, c’est que chaque appel se souvienne de ce qu’il est en train de faire. Dots, publié par OpenAI le 29 septembre 2026, suit ce modèle. La documentation officielle indique qu’un Dot peut gérer plusieurs responsabilités et répartir le travail entre des agents d’arrière-plan qui l’exécutent en parallèle. Chaque nouvelle tâche possède son propre contexte de conversation et n’hérite pas automatiquement de tout l’historique d’échanges entre l’utilisateur et le Dot. Les développeurs peuvent bâtir un système comparable de gestion multi-projets avec un Checkpointer, un Store, une file de tâches et une machine à états.
La suite s’appuie d’abord sur les documents officiels pour décortiquer le mécanisme multitâche et mémoriel de Dots, puis utilise un exemple de gestion de projet fil rouge pour concevoir successivement une structure de tâches à quatre niveaux, l’ordonnancement parallèle, la reprise après interruption, le suivi de l’exécution et les limites de coût. Les « dix projets » du titre ne sont qu’une façon d’illustrer le mode de travail : ni Dots ni un système maison ne font tourner dix projets en parallèle de façon fixe, et l’on ne peut pas non plus paralléliser à l’infini. Le code d’agent maison présenté ici relève d’une proposition de conception ; il n’est accompagné d’aucun résultat d’exécution inventé.
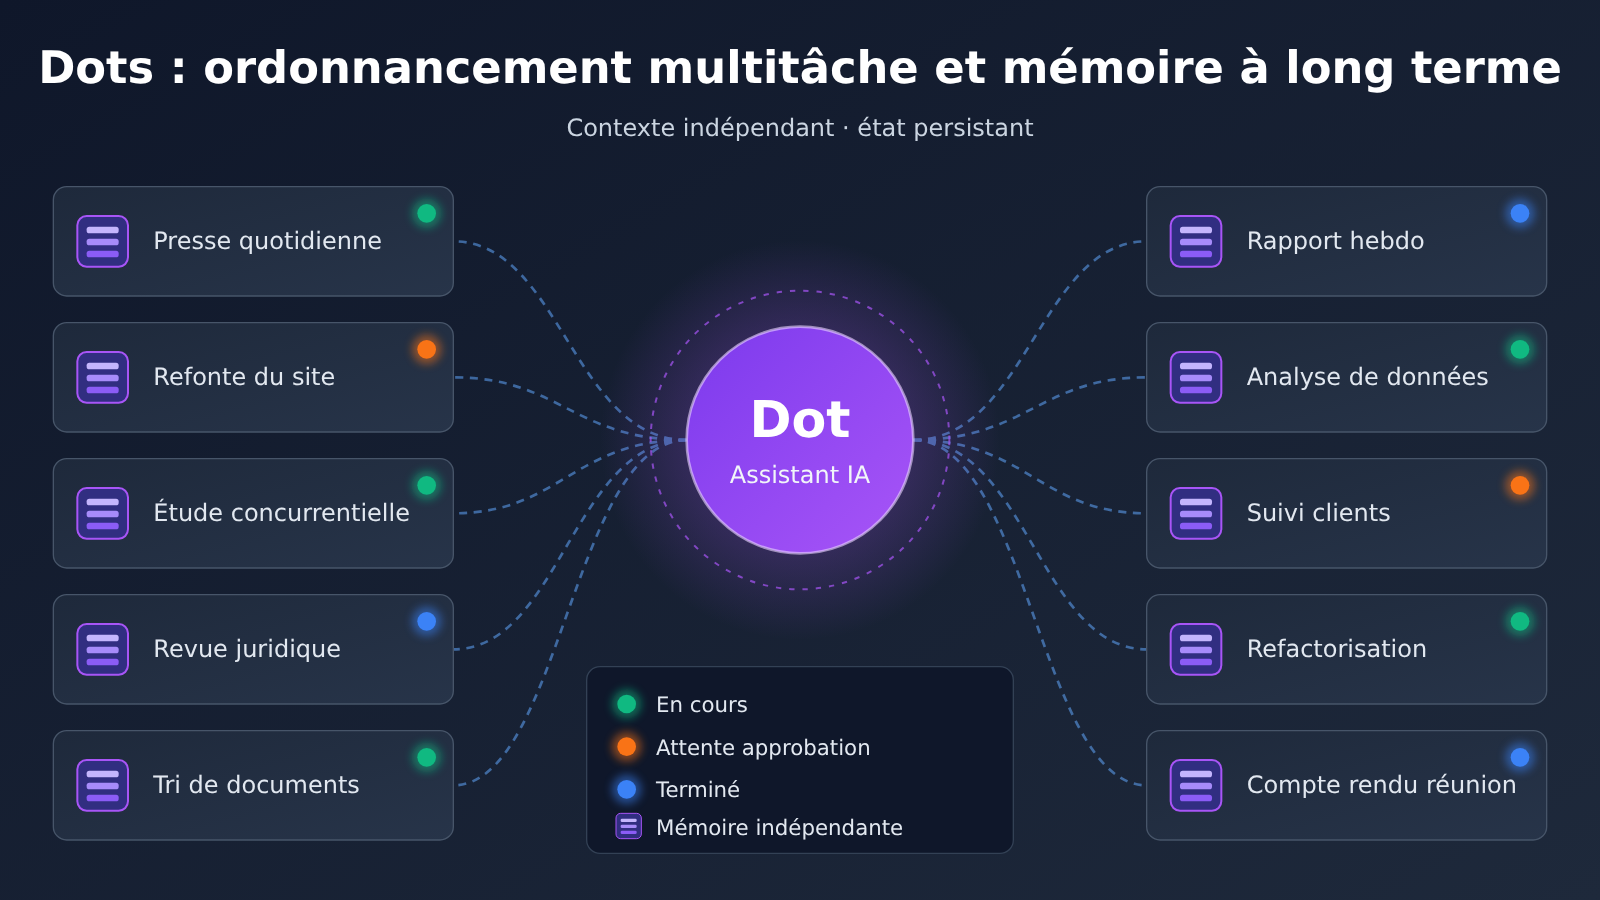
À savoir : Termes liés à l’ordonnancement multitâche de Dots
| Terme | Explication |
|---|---|
| Workspace | Espace de travail qui organise les projets et les permissions, correspondant généralement à un utilisateur ou à une équipe. |
| Project | Unité de projet, comprenant les objectifs, les ressources et les tâches associées. |
| Task | Un travail avec un objectif clair, par exemple « rechercher les actualités OpenAI du jour ». |
| Run | Enregistrement d’une exécution réelle d’une tâche ; une même Task peut être exécutée de nombreuses fois. |
| Agent d’arrière-plan | L’exécuteur que Dot envoie pour traiter des sous-tâches en parallèle et qui rend compte à Dot une fois le travail terminé. |
| Checkpointer | Composant qui enregistre les points de contrôle de l’exécution des tâches et qui gère la reprise après interruption. |
| Store | Composant de stockage qui conserve les informations à long terme entre les tâches et qui assure la continuité du contexte du projet. |
| Machine à états | Mécanisme qui gère les transitions entre les différentes phases d’une tâche selon des règles, par exemple en attente d’exécution, en cours d’exécution, en attente d’approbation. |
| Limite de concurrence | Nombre maximum de tâches exécutées simultanément, contraint par le quota API, les ressources serveur et les coûts. |
| Tracing | Capacité de tracer les appels aux modèles, les appels aux outils et le processus de passation. |
| Proactive Research | Recherche en arrière-plan en lecture seule que Dots effectue sur les sources de données autorisées lorsqu’il n’y a pas de nouveau message. |
1 Ordonnancement multitâche de Dots : pourquoi un seul Dot peut assumer plusieurs responsabilités à la fois
1.1 Les capacités multi-projets officiellement annoncées par Dots
Selon la présentation officielle, Dots est un Agent personnel résident. Il dispose de son propre ordinateur cloud et de son navigateur, et peut continuer à faire avancer le travail qui lui a été confié même après le départ de l’utilisateur. En matière de multitâche, la documentation « Tasks and memory » liste les capacités suivantes :
- conserver simultanément l’état de plusieurs éléments de travail et passer d’une tâche à l’autre dans une même conversation ;
- l’utilisateur peut à tout moment ajouter des informations et ajuster les priorités ;
- découper une tâche complexe en plusieurs parties et les confier à des Agents en arrière-plan pour un traitement parallèle ;
- créer des fils de tâches visibles et indépendants, puis collecter et synthétiser les résultats de chaque tâche ;
- demander l’intervention de l’utilisateur lorsqu’un travail est bloqué, l’utilisateur pouvant continuer à envoyer des messages pendant l’exécution des tâches en arrière-plan.
Prises ensemble, ces capacités rapprochent le rôle assumé par Dot de celui d’un coordinateur de projet. Il décide quelle chose faire en premier, laquelle déléguer, laquelle rendre à l’utilisateur ; l’exécution concrète d’une tâche individuelle peut être assurée par un Agent en arrière-plan, une tâche ChatGPT Work ou une tâche Codex.
1.2 Différences entre multi-conversation, multitâche et multi-Agent
Ces trois concepts sont souvent confondus, alors qu’ils répondent à des problèmes différents. Prenons un exemple unifié : imaginons que l’espace de travail de l’utilisateur contienne trois projets, AI Radar (une revue de presse quotidienne sur l’IA), Website (une refonte de site web) et Research (une étude de la concurrence).
| Mode | Fonctionnement | Illustration dans l’exemple | Problème résolu |
|---|---|---|---|
| Multi-conversation | L’utilisateur ouvre une fenêtre de chat pour chaque projet | L’utilisateur doit se rappeler où en est Research | Isoler le contenu des échanges, tout en laissant la progression gérée par l’humain |
| Multitâche | Un coordinateur maintient l’état de plusieurs tâches | Dot enregistre la progression et la priorité de chacun des trois projets | Ordonnancement unifié et suivi de l’état |
| Multi-Agent | Le coordinateur délègue des sous-tâches à plusieurs exécutants | Un Agent en arrière-plan collecte les informations, un autre exécutant rédige le rapport | Exécution parallèle et division spécialisée du travail |
Dots cumule les trois : l’utilisateur communique avec Dot depuis un point d’entrée unique, Dot maintient plusieurs tâches et dépêche des Agents en arrière-plan selon les besoins. Pour reproduire cet effet avec un système maison, il faut implémenter les trois couches de capacités ; ouvrir simplement plusieurs fenêtres de chat est très loin du compte.
1.3 L’observation d’un utilisateur à propos du parallélisme
Sur Reddit, un utilisateur a raconté une journée de tests. Il a confié à Dot l’examen de centaines de PDF et de milliers de pages de documents, tout en lançant une tâche de recherche juridique. Il a observé trois processus d’exécution simultanés : l’ordinateur cloud de Dot traitait la tâche A, une machine Linux à laquelle il était connecté traitait la tâche B, et un autre Agent de recherche en arrière-plan traitait la tâche C. Il mentionne aussi qu’au moment de lancer une tâche de recherche juridique indépendante, il a rencontré un environnement d’exécution indisponible, et que la distribution n’a abouti qu’après la connexion de l’ordinateur local.
Cette observation personnelle montre que l’ordinateur cloud de Dot, l’ordinateur local et les environnements Work/Codex constituent des ressources d’exécution distinctes. L’auteur lui-même précise qu’il n’a pas vérifié si ces voies disposaient d’un quota indépendant et illimité. Ce test ne permet donc de conclure que Dots peut répartir le travail entre différents environnements, et non de déduire que chaque utilisateur Pro bénéficie de la même échelle de parallélisme.
2 Mémoire à long terme de Dots : pourquoi une tâche a besoin d’une mémoire indépendante
2.1 Les limites du contexte d’une nouvelle tâche
La documentation officielle le dit noir sur blanc : chaque nouvelle tâche possède son propre contexte conversationnel et n’hérite pas automatiquement de l’intégralité de l’historique des échanges entre Dot et l’utilisateur. Dot peut fouiller dans les conversations ChatGPT passées pour retrouver du contexte, mais ce qu’il en extrait ne sert que de cadre au travail en cours.
Cette conception est très pragmatique. Si chaque tâche rechargeait tout l’historique, le rapport sur la concurrence du projet Research risquerait d’être parasité par les discussions de refonte du projet Website, et le contexte deviendrait toujours plus long et toujours plus coûteux. Un projet de long terme exige de gérer explicitement « ce que cette tâche doit savoir », ce qu’un simple fil de discussion qui s’allonge sans fin ne permet pas.
2.2 Les quatre couches de données de la mémoire de Dots
D’après les informations officielles, le contexte de Dot provient de quatre sources distinctes :
- ChatGPT Memory : Dot peut lire les souvenirs pertinents et les conversations récentes de ChatGPT ;
- Les notes propres à Dot : elles accumulent les préférences de l’utilisateur, ses habitudes de travail, les décisions de projet et les responsabilités de long terme ;
- Le contexte de la tâche en cours : les instructions de cette conversation, les fichiers, les résultats de recherche et les résultats d’exécution des outils ;
- Les données des applications connectées : Dot lit les données des applications autorisées et peut, par une recherche proactive, en tirer de la mémoire.
Ces couches ont des cycles de vie très différents. ChatGPT Memory et les notes de Dot appartiennent à des couches de données distinctes : désactiver le partage de ChatGPT Memory ne supprime pas automatiquement les informations que Dot a déjà récupérées, et déconnecter une extension ne fait que stopper les nouveaux accès. Au 16 novembre 2026, l’utilisateur ne peut pas encore consulter, modifier ou supprimer une à une les mémoires indépendantes de Dot ; supprimer Dot déclenche la suppression de son propre contexte. Quand on conçoit une couche mémoire dans un système maison, on peut s’inspirer de cette approche en couches, tout en ajoutant une interface d’administration où consulter et supprimer les entrées.
3 Checkpointer et Store : les deux types de mémoire d’un agent multitâche
La documentation de persistance de LangGraph classe la mémoire d’un agent en deux catégories, et ce découpage correspond exactement au « contexte de tâche » et aux « notes de long terme » de Dots. On garde ici le projet Research et son rapport concurrentiel mensuel comme fil conducteur.
3.1 Checkpointer : se souvenir où en est le travail
Le Checkpointer enregistre un instantané de l’exécution d’un seul thread de tâche : l’étape courante, les outils déjà appelés, les résultats qu’ils ont renvoyés et l’étape qui attend une validation humaine. Dans notre exemple, la tâche de rapport mensuel avait déjà récupéré les pages tarifaires de 6 concurrents et s’apprêtait à passer à l’analyse quand le service a redémarré. Grâce au point de contrôle, la tâche reprend à l’étape « analyse » sans avoir à récupérer une seconde fois les données déjà collectées.
Le support de stockage détermine si les points de contrôle survivent à un redémarrage. Une implémentation en mémoire convient au développement et aux tests, mais l’état est perdu dès que le processus redémarre ; pour une persistance locale, SQLite fait l’affaire, tandis qu’un service déployé sur la durée préférera PostgreSQL. Les points de contrôle grossissent en continu, donc un système en production doit aussi définir une stratégie de nettoyage des anciens états.
3.2 Store : se souvenir du contexte du projet
Le Store conserve des informations de long terme, transverses aux tâches et aux sessions : préférences utilisateur, contexte du projet, décisions passées et connaissances partagées entre plusieurs tâches. Dans l’exemple, « les lecteurs du rapport sont l’équipe produit », « ne suivre que les tarifs et les évolutions fonctionnelles de l’API », « le mois dernier, on a décidé d’arrêter de suivre tel concurrent qui ne publie plus rien » relèvent tous du Store. Quand on crée une nouvelle tâche de rapport le mois suivant, elle lit ces décisions et l’utilisateur n’a pas à les répéter.
3.3 Comparaison des responsabilités entre Checkpointer et Store
| Dimension | Checkpointer | Store |
|---|---|---|
| Portée | Un seul thread de tâche | Plusieurs tâches, inter-threads |
| Contenu stocké | Instantané de l’état d’exécution | Informations et faits de long terme |
| Valeur principale | Reprendre le travail après une interruption | Perpétuer le contexte du projet dans une nouvelle tâche |
| Exemple de contenu | « 6 pages tarifaires récupérées, prochaine étape : analyse » | « les lecteurs du rapport sont l’équipe produit » |
| Cycle de vie | Suit l’état de la tâche, nettoyable une fois terminée | Conservé et mis à jour selon la stratégie de mémoire long terme |
Les deux rôles sont bien distincts et indissociables. Avec seulement un Checkpointer, chaque nouvelle tâche ressemble à l’arrivée d’un nouvel employé ; avec seulement un Store, la moindre interruption oblige à repartir de zéro.
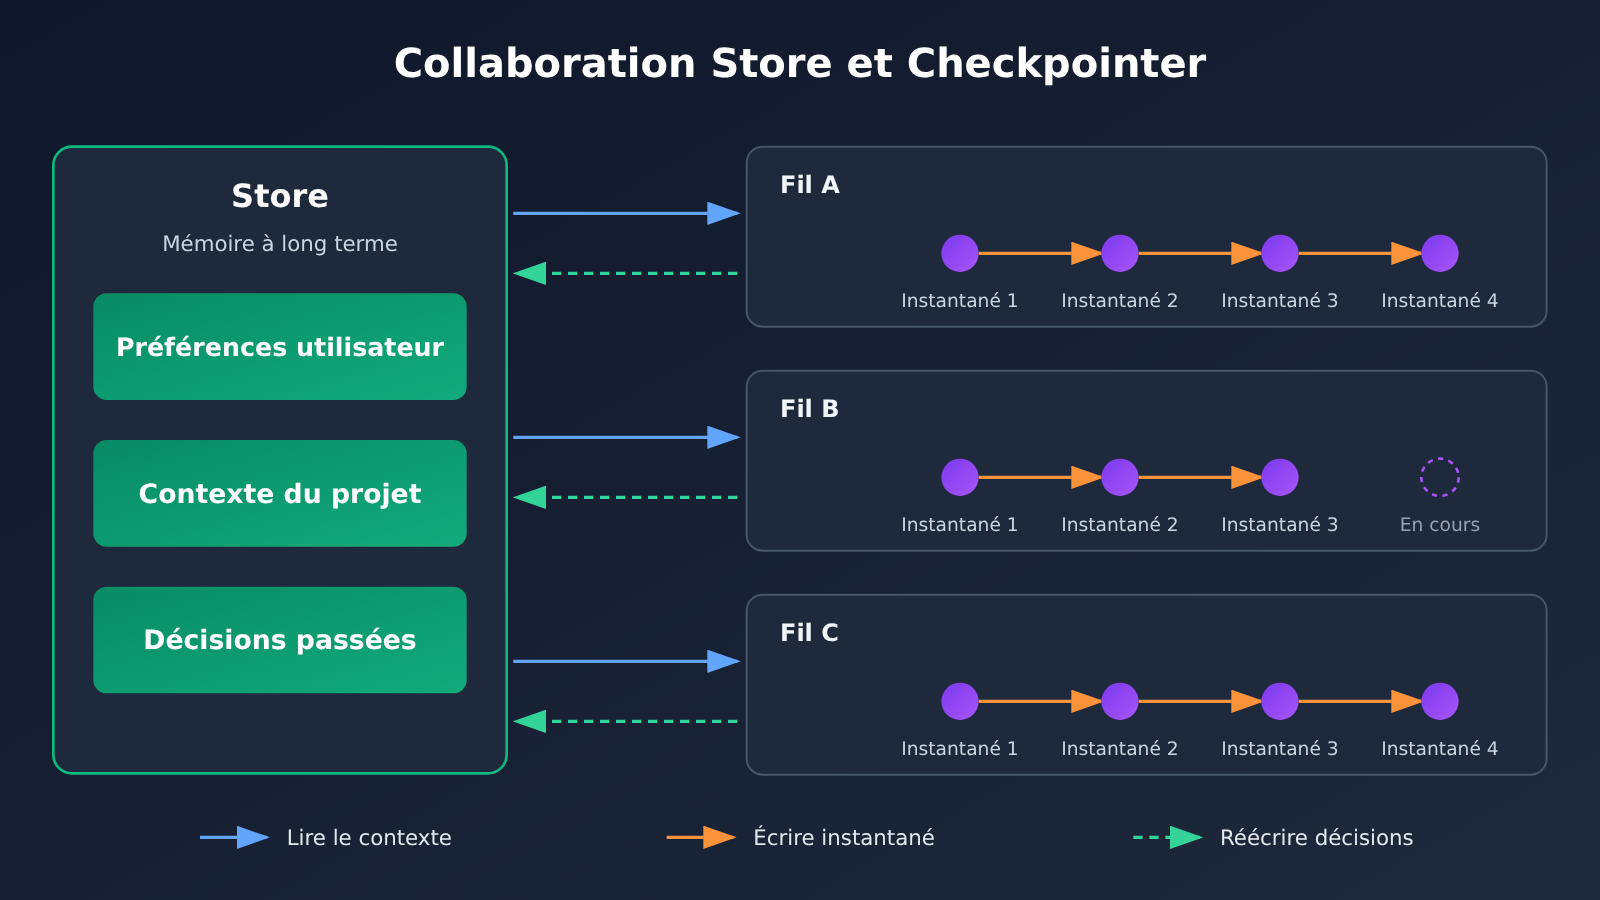
Le cycle « lire le contexte — écrire un instantané — réécrire les décisions » du schéma ci-dessus se retrouve directement dans le code de la section 6. L’exemple de code appelle le modèle via l’interface compatible OpenAI d’APIYI apiyi.com ; pour changer de modèle, il suffit de modifier le nom du modèle.
4 Conception d’un système de gestion de tâches multi-projets : Workspace, Project, Task, Run
4.1 Structure à quatre niveaux et identifiants indépendants
Pour un agent multi-projets auto-hébergé, mieux vaut adopter une structure à quatre niveaux, chacun doté de son propre identifiant :
| Niveau | Rôle | Exemple |
|---|---|---|
| Workspace | Gère l’espace de travail et les permissions d’un utilisateur | regulus |
| Project | Gère les objectifs et les ressources d’un projet indépendant | AI Radar, Website, Research |
| Task | Gère une tâche précise | Daily News, Monthly Report |
| Run | Enregistre une exécution réelle | l’exécution de Daily News le 2026-11-16 à 09:00 |
Voici l’arborescence correspondante :
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Le point clé, c’est de consigner séparément les Task et les Run. Daily News s’exécute une fois par jour, et chaque Run possède ses propres entrées, sorties, durée et statut : en cas de problème, on peut donc identifier précisément une exécution donnée, un jour donné.
4.2 Portée d’accès à la mémoire et isolation des projets
Quand un agent gère plusieurs projets, les fichiers de chaque projet ne doivent pas, par défaut, pouvoir être lus par les autres. Je recommande de découper la portée d’accès à la mémoire par niveau :
- Préférences générales de l’utilisateur (par exemple des rapports en chinois, la conclusion en premier) : lisibles par tous les projets autorisés ;
- Contexte du projet (par exemple les lecteurs et le périmètre de veille de Research) : lisibles uniquement par les tâches de ce projet ;
- Enregistrement d’une tâche ponctuelle : lisible uniquement par la tâche en cours et par les tâches liées explicitement autorisées ;
- Données de clients entreprises : lisibles uniquement par les projets clients désignés ;
- Identifiants sensibles : placés dans un stockage sécurisé séparé, ils n’entrent jamais dans le contexte du modèle.
Lorsqu’on partage des ressources entre projets, il faut consigner la source et la portée de l’autorisation. C’est cohérent avec l’approche de Dots : la documentation officielle indique que le contexte de Dot ne conserve ni identifiants, ni images, ni captures d’écran, et que les limites de permissions sont contrôlées conjointement par les autorisations des plugins et les Custom Rules.
5 Ordonnancement multitâche : comment faire tourner les tâches en parallèle sans qu’elles se perturbent
5.1 Séparer l’ordonnanceur du raisonnement de l’Agent
Mieux vaut confier le « quand faire » et le « comment faire » à deux composants distincts. L’ordonnanceur gère le moment du lancement, la sélection du projet, le nombre d’exécutions en cours, la priorité, les délais d’expiration et les nouvelles tentatives ; l’Agent se charge de comprendre la tâche, de définir les étapes, de choisir les outils, d’analyser les résultats et de livrer le travail. Ainsi, les règles d’ordonnancement s’exécutent de manière déterministe, et le modèle ne traite que la partie qui demande du raisonnement.
Pour le choix technique, on peut s’appuyer sur cette combinaison : APScheduler pour gérer les tâches périodiques, Celery comme file de tâches en arrière-plan, Redis pour les messages et la coordination à court terme, PostgreSQL pour conserver les projets et l’état d’exécution, et un framework comme LangGraph pour gérer le flux de l’Agent et la persistance de son état. Pour un prototype à petite échelle, asyncio de Python avec SQLite suffit aussi ; le code de la section 6 est conçu de cette façon.
5.2 Trois façons de paralléliser
Un Agent multitâche peut au moins paralléliser de trois manières :
- Tâches indépendantes en parallèle : les actualités quotidiennes d’AI Radar et le rapport mensuel de Research ne dépendent pas l’un de l’autre et peuvent tourner en même temps ;
- Sous-tâches en parallèle : un projet est découpé en sous-tâches menées séparément, comme la collecte d’informations, la vérification des faits, etc. ;
- Rôles de modèles en parallèle : différents modèles se chargent de travaux spécialisés différents, puis on consolide le tout.
Les contraintes qui déterminent si l’on peut paralléliser incluent le quota de concurrence de l’API, les ressources serveur, les dépendances entre tâches, la contention en écriture sur la base de données, le coût des modèles, les conflits de résultats et les exécutions en double.
5.3 Exemple : collecte d’informations, analyse de données et génération de rapport
Le rapport mensuel du projet Research est découpé en trois sous-tâches. La collecte d’informations peut tourner en parallèle des actualités quotidiennes d’AI Radar ; l’analyse de données dépend des résultats de la collecte et doit attendre qu’elle soit terminée ; la génération du rapport dépend des conclusions de l’analyse et, une fois terminée, passe à l’état d’attente de validation : la livraison n’est effective qu’après confirmation par l’utilisateur.
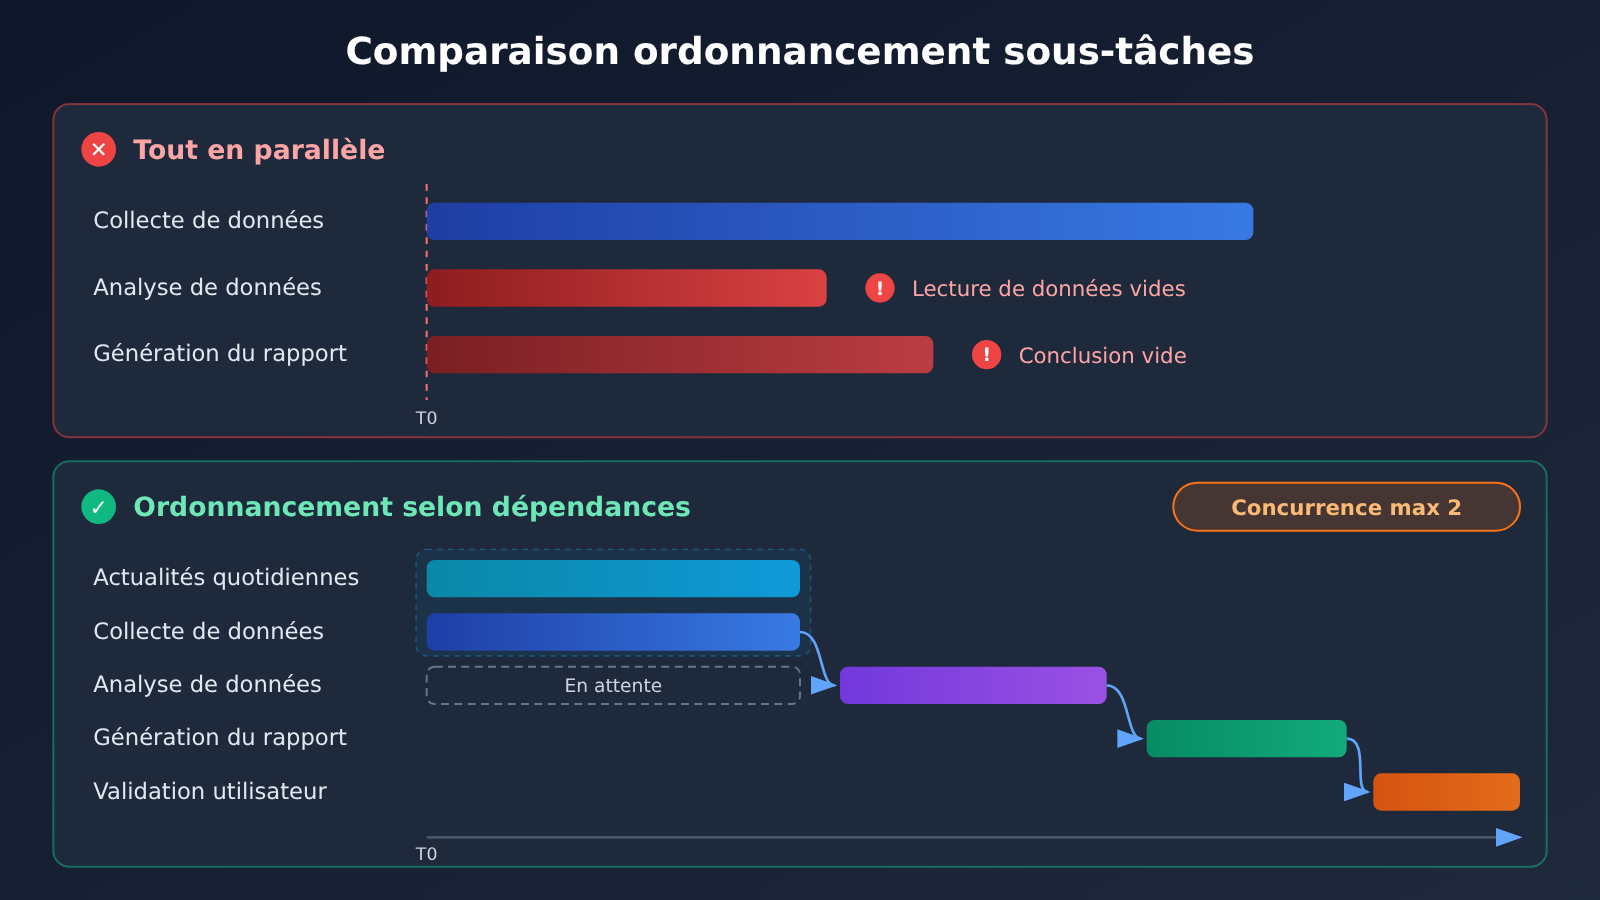
Démarrer les trois sous-tâches en même temps peut sembler plus rapide, mais l’analyse de données risque de produire des conclusions vides faute d’informations, voire d’inventer des données. Les dépendances déterminent quelles tâches doivent s’exécuter en série, et la limite de concurrence détermine combien peuvent tourner simultanément. Ces deux règles doivent être intégrées à l’ordonnanceur ; les confier au jugement du modèle en temps réel est une source d’erreurs fréquente.
5.4 Répartition des rôles entre modèles
| Sous-tâche | Type de modèle recommandé | Raison du choix | Plateforme disponible |
|---|---|---|---|
| Collecte d’informations et résumé | Modèle léger et rapide | Volume d’appels élevé, sensible au coût | APIYI apiyi.com, API officielle |
| Analyse de données | Modèle doté de fortes capacités de raisonnement | Nécessite des comparaisons et des calculs en plusieurs étapes | APIYI apiyi.com, API officielle |
| Génération de rapport | Modèle performant en rédaction de textes longs | Exigences élevées sur la structure et la qualité d’expression | APIYI apiyi.com, API officielle |
| Vérification des faits | Modèle différent de celui de la rédaction | Validation croisée pour réduire les erreurs de même source | APIYI apiyi.com, API officielle |
Les modèles précis sont à choisir selon la liste actuelle des modèles de la plateforme. Quand une clé API donne accès à plusieurs modèles, la répartition des rôles peut être ajustée par configuration, sans modifier la structure du code.
6 Prise en main rapide : construire un prototype d’agent multitâche avec une interface unifiée
6.1 Exemple ultra-simple : injecter le contexte du projet dans la tâche
Le code ci-dessous illustre le point le plus essentiel : avant d’exécuter une tâche, on ne récupère depuis la mémoire à long terme que le contexte du projet concerné.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

# Store : contexte à long terme isolé par projet
project_memory = {
    "research": "读者:产品团队;只跟踪 API 价格与功能更新;报告结论先行",
    "ai-radar": "每日 09:00 汇总 OpenAI、Anthropic、Google 官方动态",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"项目背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "列出本月需要关注的竞品更新清单"))
6.2 Plan de conception complet : machine à états, points de contrôle, dépendances et concurrence
Le code ci-dessous est une proposition de conception couvrant le Store, les Checkpoints, la machine à états, l’ordonnancement des dépendances, la limitation de concurrence, les tentatives de reprise, les délais d’attente et les enregistrements d’exécution, destinée à illustrer la manière dont ces composants collaborent. Il n’a pas été validé en environnement de production, et aucun résultat d’exécution fictif n’est fourni dans cet article.
Afficher le code complet de la proposition de conception
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, une seule clé pour basculer entre plusieurs modèles
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """Lit uniquement les scopes autorisés : user et project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"长期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游结果:\n{upstream or '无'}"},
    ]
    async with sem:  # limite de concurrence
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # délai dépassé ou erreur d'API : nouvel essai après un backoff exponentiel
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # tâche préalable échouée, en attente d'approbation ou dépendance circulaire
            print("阻塞任务:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "汇总今日 AI 官方动态", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月竞品 API 价格与功能变更", "gpt-4.1-mini"),
    Task("analyze", "research", "对比变更并归纳趋势", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度竞品报告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
Plusieurs éléments du code correspondent à la conception décrite plus haut. store_get ne lit que l’utilisateur et la portée du projet courant, ce qui garantit l’isolation entre projets ; la table checkpoint enregistre chaque étape run par run, et s’appuie sur la table runs pour consigner les Token et l’état final ; schedule décide de la sérialisation à partir des dépendances et limite la concurrence avec un sémaphore. Un système réel devra encore ajouter l’appel d’outils, les callbacks d’approbation et un point d’entrée pour la reprise.
🚀 Démarrage rapide : au stade du prototypage, je vous conseille de récupérer un quota de test gratuit via APIYI apiyi.com, puis d’utiliser la même clé pour configurer des modèles différents sur les trois rôles — collecte, analyse et rédaction — afin de comparer les résultats et les coûts avant de figer la répartition.
7 Comment un agent multi-tâches gère les interruptions, les échecs et les approbations humaines
7.1 La machine à états des tâches
La progression d’une tâche doit être consignée par des états explicites ; la progression que le modèle décrit dans le chat ne sert que de référence. Le flux principal recommandé est Pending (à exécuter) → Running (en cours) → Waiting (en attente d’une condition externe) ou Approval (en attente d’approbation) → Completed (terminé), auxquels s’ajoutent trois états de fin ou de pause : Failed, Cancelled et Paused. Chaque transition d’état est écrite en base de données, et le planificateur ne prend ses décisions qu’à partir des états présents en base.
7.2 Nouvelles tentatives, timeouts et reprise après pause
- Nouvelle tentative : en cas d’erreur d’API ou de timeout, on réessaie avec un backoff exponentiel et on enregistre
retry_count, ce qui aide à repérer les étapes qui échouent souvent ; - Timeout : chaque Run dispose d’une limite d’exécution ; en cas de dépassement, il passe à Failed avec une alerte, pour éviter qu’une tâche bloquée ne monopolise durablement une place de concurrence ;
- Reprise après pause : on sauvegarde un checkpoint lors de la mise en pause, et à la reprise on continue depuis le dernier checkpoint — les appels d’outils déjà terminés n’ont pas besoin d’être rejoués ;
- Idempotence : pour les étapes à effet de bord, comme l’envoi d’un e-mail ou l’écriture en base, on vérifie avant de réessayer si l’opération a déjà été effectuée, afin d’éviter les doublons.
La documentation officielle de Dots contient un détail intéressant : arrêter une tâche en cours d’exécution et annuler une planification périodique déjà créée sont deux choses distinctes ; lorsqu’on met un Dot en pause, les Work, Codex et tâches planifiées indépendants peuvent continuer à tourner. Un système que vous développez vous-même devrait donc concevoir « arrêter ce Run », « mettre la Task en pause » et « annuler la planification périodique » comme trois opérations distinctes.
7.3 Approbation humaine : s’inspirer des Custom Rules de Dots
Dots utilise ses Custom Rules pour classer les comportements en quatre niveaux : exécution directe sans rien demander, exécution après autorisation préalable, demande avant exécution, remise à l’utilisateur. Les opérations du type changer un mot de passe ou transférer des fonds doivent obligatoirement repasser par l’utilisateur ; la suppression définitivement de données ou l’installation de logiciels peuvent exiger une approbation à chaque fois. L’approbation de l’utilisateur ne permet pas non plus de contourner les limites de sécurité fondamentales.
Un système maison peut s’en inspirer pour étiqueter les outils. La recherche en lecture seule s’exécute directement ; la rédaction d’un rapport passe en Approval une fois terminée ; l’envoi vers l’extérieur, les paiements et les suppressions sont systématiquement remis à une personne. Dans l’exemple, la tâche de rapport définit needs_approval=True : elle s’arrête en état d’approbation après génération, et ne passe à Completed qu’après confirmation de l’utilisateur.
8 Suivi de l’exécution d’un Agent multitâche : tracing et journaux
Quand plusieurs projets tournent en parallèle, la question qu’on nous pose le plus souvent est : « mais qu’est-ce qu’il a fait au juste ? ». Le tracing du SDK OpenAI Agents permet d’enregistrer quel Agent a été appelé, quel modèle a été utilisé, quels appels d’outils ont eu lieu, où s’est produit un handoff, quels contrôles de sécurité ont été déclenchés, et comment la tâche s’est finalement terminée.
Le tracing excelle pour reconstituer une exécution unique ; les statistiques à l’échelle du projet demandent en revanche un complément de journaux métier. Pour chaque Run, je recommande d’enregistrer au minimum project_id, task_id, run_id, model_id, input_tokens, output_tokens, tool_calls, duration, retry_count et final_status. Avec ces champs, on peut répondre à des questions de gestion du type « combien de Tokens le projet Research a-t-il consommés ce mois-ci », « quelle étape a été relancée le plus souvent », « quel modèle dépasse le plus fréquemment le délai sur les tâches d’analyse ». La table runs de la section 6 constitue l’implémentation minimale de cet ensemble de champs.
9 Coûts et frontières de gestion d’un Agent multitâche
9.1 La structure de coûts de Dots
Au 16 novembre 2026, les utilisateurs individuels peuvent accéder à Dots via les trois paliers d’abonnement ChatGPT Pro 100, Pro 200 et Pro 500, pour respectivement 100, 200 et 500 dollars par mois. La documentation officielle ne mentionne pas de tarif mensuel distinct pour Dot dans les explications Dots de Pro individuel. Les tâches ChatGPT Work ou Codex déléguées par Dot sont facturées selon les quotas et règles du produit correspondant ; la consommation dépend du modèle, du contexte, du raisonnement, des appels d’outils et de la recherche. L’usage de Pro individuel est en outre soumis à des restrictions d’âge (18 ans et plus) et de région, l’Espace économique européen, le Royaume-Uni et la Suisse étant exclus.
La facturation des espaces de travail d’entreprise fonctionne différemment. La documentation officielle actuelle indique que les espaces de travail d’entreprise éligibles peuvent opter pour un tarif fixe par type de travail ou pour une facturation à l’usage ; la période de prévisualisation est gratuite, et la facturation des Dots déjà activés commence le 18 novembre 2026 ; les tâches déléguées à Work ou Codex sont facturées séparément. Les montants précis dépendent de l’offre réellement applicable à l’espace de travail.
9.2 Les sources de coût d’un système auto-hébergé
Le coût d’un Agent multitâche auto-hébergé provient principalement de quatre postes :
- Lecture répétée du contexte : chaque tâche injecte le contexte du projet ; plus ce contexte est long, plus l’entrée en Tokens augmente à chaque appel, et le contenu du Store doit être périodiquement allégé ;
- Relances et échecs : une tâche d’analyse qui échoue renvoie une nouvelle fois les données amont au modèle ;
- Choix du modèle : utiliser le modèle le plus puissant pour toutes les sous-tâches fait grimper les coûts de façon exponentielle ;
- Quota de concurrence : les limites de débit de l’API déterminent le nombre de parallélismes réellement disponibles.
9.3 Nombre de parallélismes et travail utile
Nombre de parallélismes et travail utile sont deux choses distinctes. Lancer trop tôt une tâche dont les dépendances ne sont pas satisfaites ne produit que des résultats inutiles ; des conclusions contradictoires doivent être fusionnées à la main ; et une donnée erronée d’un projet qui se propage à un autre via la mémoire partagée fait grimper le coût de reprise. La bonne approche consiste à garantir d’abord l’isolation des projets et la justesse des dépendances, puis à augmenter progressivement la limite de concurrence en s’appuyant sur les données de supervision.
10 Questions fréquentes (FAQ)
Q1 : Qu’est-ce que l’orchestration multi-tâches de Dots ?
Un seul Dot gère simultanément plusieurs responsabilités. L’utilisateur peut changer de tâche et ajuster les priorités ; Dot décompose alors le travail complexe et le confie à des Agents en arrière-plan qui le traitent en parallèle, puis rassemble les résultats et les rend à l’utilisateur au moment où une décision est nécessaire.
Q2 : La mémoire à long terme de Dots retient-elle toutes les conversations passées ?
Non, elle ne charge pas tout. Une nouvelle tâche dispose de son propre contexte de conversation ; Dot s’appuie sur ChatGPT Memory, ses propres notes, le contexte de la tâche en cours et les données des applications connectées, puis va rechercher dans les conversations passées seulement lorsque c’est nécessaire.
Q3 : Checkpointer et Store peuvent-ils se substituer l’un à l’autre ?
Leurs rôles sont différents. Checkpointer conserve l’instantané d’exécution d’une tâche unique, pour reprendre après une interruption ; Store conserve le contexte du projet et les décisions d’un projet à l’autre, pour que les nouvelles tâches prolongent le contexte existant. Sur un projet de long terme, les deux sont nécessaires.
Q4 : Combien de tâches Dots peut-il exécuter en parallèle ?
La documentation officielle ne publie pas de nombre de tâches simultanées fixe. Dots prend en charge le parallélisme, mais l’environnement d’exécution et les quotas d’utilisation ont leurs limites. Des utilisateurs de Reddit affirment avoir observé trois exécutions simultanées ; ce n’est toutefois que le résultat de leurs propres tests.
Q5 : Comment appeler rapidement plusieurs modèles dans un Agent multi-projets auto-construit ?
Vous pouvez passer par une interface d’agrégation compatible OpenAI. Après avoir créé un compte sur APIYI apiyi.com pour obtenir une clé API et un crédit d’essai gratuit, définissez le `base_url` du code de cet article sur `https://api.apiyi.com/v1` : le même code vous permet alors de configurer GPT, Claude, Gemini et d’autres modèles pour les différentes sous-tâches.
Q6 : Comment maîtriser le coût des modèles d’un Agent multi-tâches ?
Répartissez les modèles par rôle : un modèle léger pour la collecte d’informations, un modèle puissant pour l’analyse et la rédaction ; allégez le contexte de projet stocké dans le Store ; utilisez la table `runs` pour compter les tokens de chaque projet. Avec la facturation à l’usage d’APIYI apiyi.com, vous pouvez tester à petite échelle avant de fixer les quotas.
Q7 : Quelles précautions de sécurité prendre avec Dots et les systèmes auto-construits ?
L’Agent peut mal interpréter une tâche, mal évaluer une information ou subir une injection d’invite (Prompt Injection) ; l’équipe officielle reconnaît d’ailleurs que les protections actuelles ne permettent pas d’éliminer tous les risques. Les opérations touchant aux comptes, aux fonds ou à des envois vers l’extérieur devraient passer par une validation humaine, et les identifiants sensibles ne doivent jamais entrer dans le contexte du modèle.
11 Dots : ordonnancement multitâche et mémoire à long terme — Points clés
- Difficulté centrale : pour un Agent multitâche, l’essentiel réside dans des contextes indépendants, un état persistant, l’ordonnancement et la reprise.
- Mécanisme Dots : un Dot coordonne plusieurs tâches, les Agents en arrière-plan s’exécutent en parallèle, et les contextes des nouvelles tâches sont indépendants les uns des autres.
- Deux types de mémoire : le Checkpointer assure la reprise de l’exécution, le Store assure la continuité du contexte du projet.
- Structure à quatre niveaux : Workspace, Project, Task et Run disposent chacun d’un ID propre, et les projets sont isolés les uns des autres.
- Principes d’ordonnancement : les dépendances déterminent la sérialisation, la limite de concurrence détermine l’échelle, et les règles sont inscrites dans l’ordonnanceur.
- Traçabilité : chaque Run enregistre le modèle, les tokens, la durée, le nombre de tentatives et l’état final.
- Pour démarrer : via l’interface unifiée d’APIYI apiyi.com, configurer différents modèles pour différentes sous-tâches.
12 Conclusion
Dots illustre une forme de produit où un Agent personnel gère plusieurs projets à long terme : exécution permanente, contextes de tâches indépendants, mémoire sauvegardée en couches, Agents en arrière-plan s’exécutant en parallèle, opérations à risque rendues à l’utilisateur. Sa capacité multi-projets repose sur la gestion d’état ; augmenter simplement le nombre de tâches parallèles ne suffit pas.
Pour construire un système similaire, on peut suivre l’ordre de cet article : d’abord implémenter l’isolation des projets avec la structure à quatre niveaux et la division des portées, puis résoudre respectivement « se souvenir du contexte » et « pouvoir reprendre » avec le Store et le Checkpointer, ensuite gérer les dépendances et la concurrence avec l’ordonnanceur, et enfin rendre chaque étape contrôlable et vérifiable avec la machine à états, les approbations et les journaux d’exécution. En phase de prototype, il est recommandé de valider rapidement via APIYI apiyi.com l’efficacité de différents modèles sur les différents rôles, puis d’ajuster la répartition des tâches et la concurrence en fonction des données des journaux.
Références
- OpenAI : Introducing dots : annonce de lancement du produit
- Lien :
openai.com/index/introducing-dots - Description : positionnement du produit, ordinateur dans le cloud et exécution multi-projets
- ChatGPT Learn : Tasks and memory : documentation sur les tâches et la mémoire de Dots
- Lien :
learn.chatgpt.com/docs/dots/tasks-and-memory - Description : agent en arrière-plan, contexte indépendant par tâche, recherche proactive
- OpenAI Help Center : Dots privacy, security, and safety FAQs : informations sur la confidentialité et la sécurité
- Lien :
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - Description : autorisations, approbations, suppression de la mémoire et conservation des données
- ChatGPT Learn : Dots admin guide : administration et facturation de l’édition entreprise
- Lien :
learn.chatgpt.com/docs/enterprise/dots-admin-guide - Description : mode de facturation des espaces de travail d’entreprise et date de début de facturation
- About ChatGPT Pro tiers : description des niveaux d’abonnement Pro
- Lien :
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - Description : règles de tarification et de quotas des offres Pro 100, 200 et 500
- Documentation LangGraph Persistence : Checkpointer et Store
- Lien :
github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx - Description : distinction entre l’état d’exécution à court terme et la mémoire à long terme
- OpenAI Agents SDK : Tracing et workflows
- Lien :
developers.openai.com/api/docs/guides/agents/sdk - Description : traçage et débogage de l’exécution des agents
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com.


