
Note de l’auteur : décryptage de Qwen4-Max, 6e du classement Code Arena WebDev — la composition du top 6, les écarts entre modèles chinois, la distance avec les modèles de tête, et la bonne façon de lire le nombre de votes et le coût par tâche.
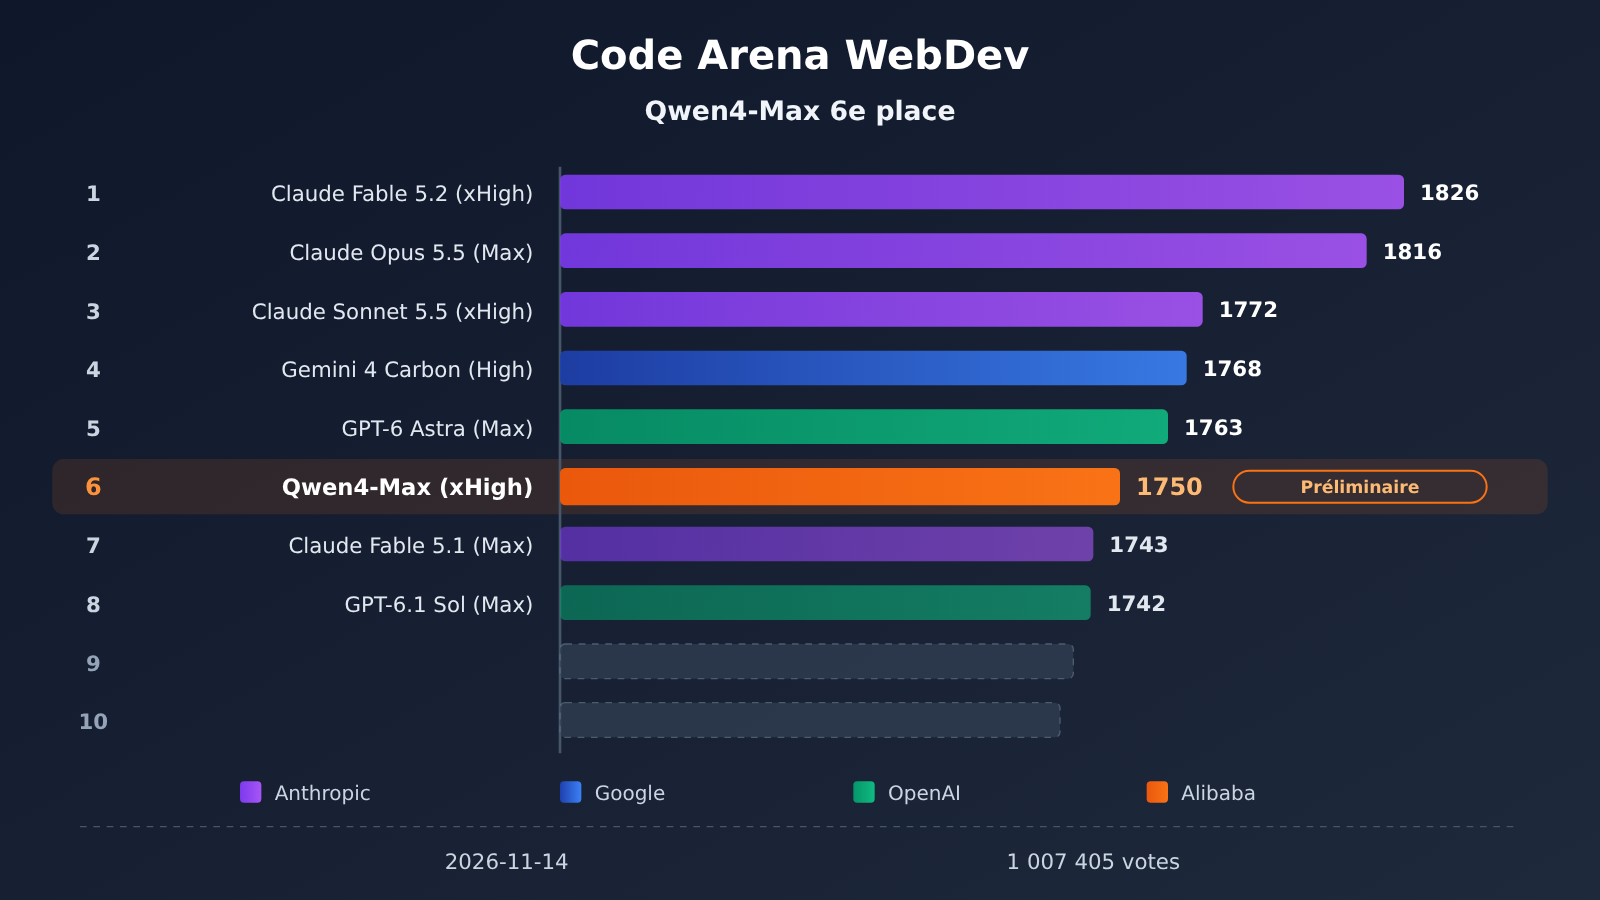
Commençons par la conclusion : sur le classement Code Arena WebDev d’arena.ai (catégorie Overall, date indiquée sur la page : 2026-11-14), Qwen4-Max (xHigh) occupe la 6e place avec 1 750 points. C’est la première fois qu’un modèle chinois entre dans le top 6 de ce classement, et c’est aussi le seul modèle du top 6 qui ne soit pas issu d’un laboratoire américain.
Il ne s’agit pas d’un communiqué qui présente la 6e place comme une première place. Qwen4-Max porte la mention Preliminary sur le classement, avec seulement 1 814 votes : son rang peut encore bouger. Dans le même visuel officiel d’Alibaba, il reste nettement derrière Opus 5.5 et GPT-6 Astra sur Terminal-Bench et ProgramBench.
L’essentiel : après lecture, vous aurez une fiche de métadonnées du classement que vous pourrez vérifier vous-même, et vous saurez ce que la 6e place de Qwen4-Max permet — ou non — d’affirmer.
Qwen4-Max Code Arena WebDev : les points clés de la 6e place
Avant de parler du rang, posons d’abord les métadonnées du classement. Toute affirmation du type « il est Xe » devrait être vérifiée à la lumière de la date, du nombre de votes et du nombre de modèles évalués — sinon, difficile de savoir si ce rang tient vraiment la route.
| Point clé | Donnée (données publiques du même classement) | Comment le lire |
|---|---|---|
| Classement et catégorie | arena.ai Code Arena WebDev, Overall | Représente uniquement la préférence en test à l’aveugle pour le développement web |
| Date de la page | 2026-11-14 | Le rang évolue en continu au fil des votes |
| Total des votes / nombre de modèles | 1,007,405 votes / 159 modèles | Échantillon volumineux, mais le nombre de votes par modèle varie énormément |
| Rang et score de Qwen4-Max | 6e, 1750 points | Le seul modèle non américain du top six |
| Votes et marqueur de Qwen4-Max | 1,814 votes, Preliminary | Toujours en phase d’évaluation préliminaire |
| Coût par tâche P50 | $4.18 | Médiane statistique du classement, pas le prix unitaire du modèle |
Le détail de la méthodologie du classement Qwen4-Max
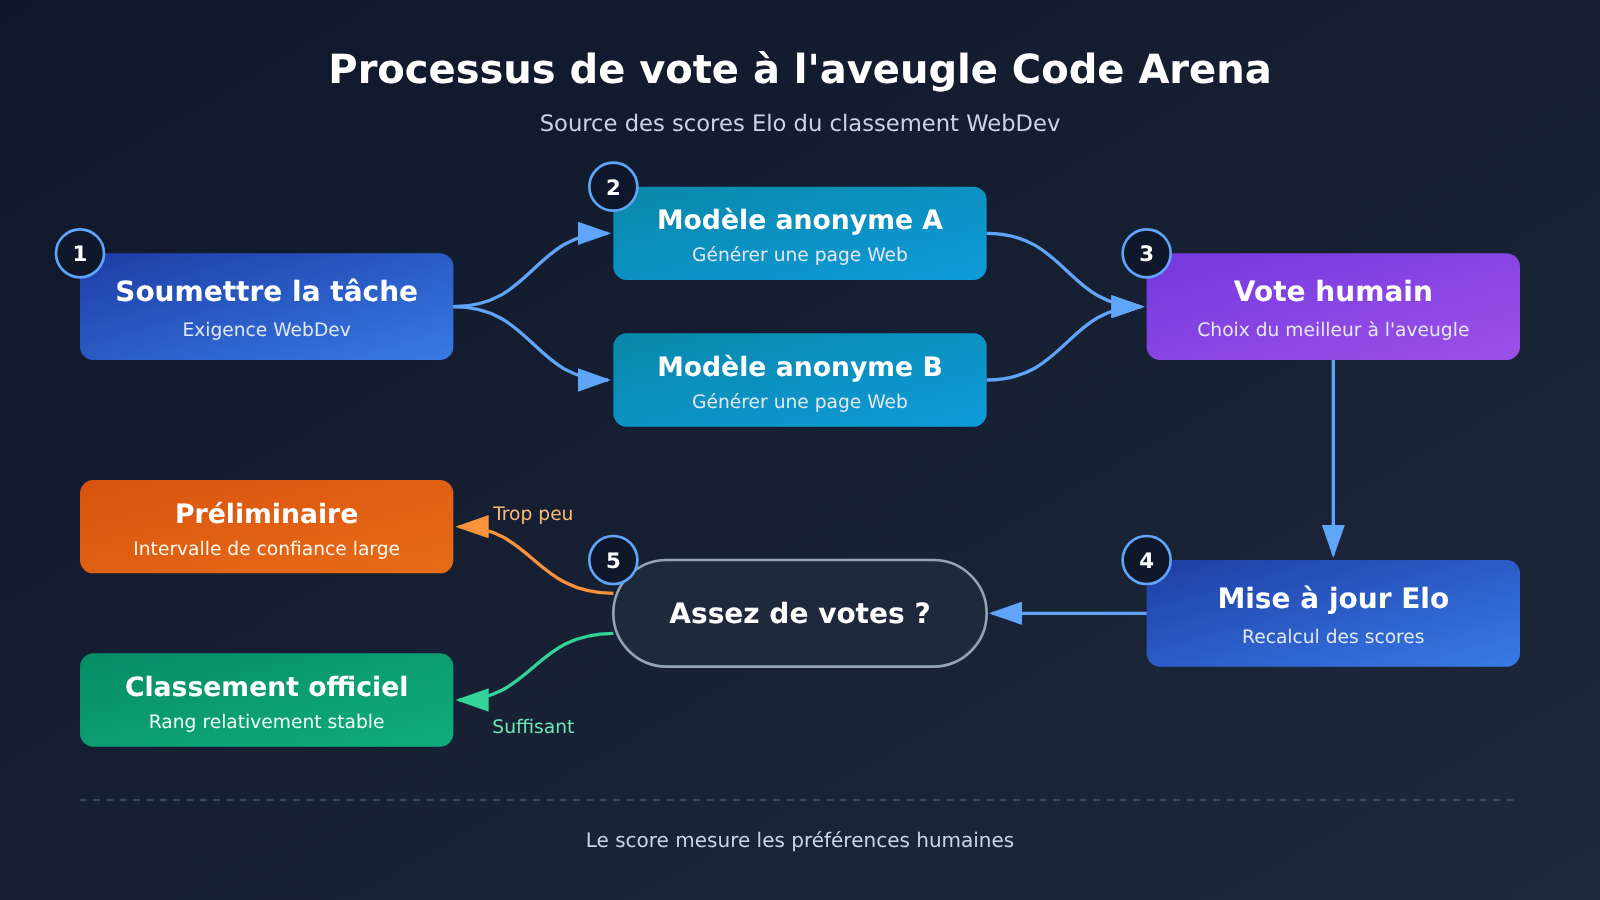
Le score Elo de Code Arena provient de votes humains en test à l’aveugle : l’utilisateur soumet une même tâche de développement web, observe les productions de deux modèles anonymes, puis vote pour celle qu’il juge meilleure. Le score reflète donc « qui fait la meilleure page web aux yeux des évaluateurs humains » ; il mesure une préférence, pas une note globale de productivité.
Il faut aussi bien comprendre ce que signifie le marqueur Preliminary. Il indique que le modèle n’a pas encore livré assez de duels, ce qui élargit son intervalle de confiance. Le modèle Gemini 4 Carbon (High), 4e du même classement, porte lui aussi ce marqueur : dans le segment allant de la 4e à la 6e place, un échange de positions dans les prochaines semaines n’aurait donc rien d’étonnant.
Qui sont les six premiers de Code Arena WebDev : le paysage concurrentiel de Qwen4-Max
En listant le top 10 dans son intégralité, on voit plus directement où se situe Qwen4-Max. Les cinq premières places sont toutes occupées par trois laboratoires américains, et Anthropic en rafle à lui seul trois.
| Rang | Modèle | Score | Laboratoire | Remarque |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | En tête |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | P50 par tâche : $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Préliminaire | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | P50 par tâche : $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | Alibaba | Préliminaire, 1,814 votes |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
Ce que le top 5 implique pour Qwen4-Max
Dans le top 6, Anthropic occupe 3 places (Fable 5.2, Opus 5.5, Sonnet 5.5), Google et OpenAI 1 chacune, Alibaba 1. Autrement dit, Qwen4-Max s’est glissé à une place entre les modèles phares de trois laboratoires de premier plan, plutôt que d’avoir décroché un rang dans un classement peu relevé.
Un autre détail intéressant : les 6e à 8e places sont très serrées : 1750, 1743, 1742, moins de 10 points d’écart entre les trois. L’écart qui sépare Qwen4-Max de GPT-6 Astra (13 points) est plus important que son avance sur Claude Fable 5.1 et GPT-6.1 Sol. Il faudra attendre que le nombre de votes augmente pour juger de la stabilité du classement.
Position de Qwen4-Max parmi les modèles chinois
Si l’on s’en tient au camp chinois, l’avance de Qwen4-Max est assez nette. C’est le seul modèle chinois à entrer dans le top 10, et son premier poursuivant n’apparaît qu’à la 13e place.
| Rang national | Modèle | Score | Rang au classement | Écart avec Qwen4-Max |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | 6e | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | 13e | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | 16e | −74 |
| 4 | Qwen3.8-Max | 1670 | 18e | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | 18e | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | 19e | −89 |
| 7 | Kimi K3 (Max) | 1658 | 20e | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | 26e | −111 |
| 9 | Hy4 preview | 1632 | 27e | −118 |
| 10 | GLM-5.3 (Max) | 1622 | 31e | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | 33e | −129 |
Deux niveaux de lecture pour les écarts au sein du camp chinois
Le premier niveau, c’est le bond générationnel. Qwen4-Max devance de 74 points son propre prédécesseur Qwen3.8-Max (0902), et passe de la 16e à la 6e place. À classement identique et mécanisme de vote identique, la progression est assez considérable.
Le deuxième niveau, c’est la distance avec le numéro deux chinois. Qwen4-Max devance Kimi K3.1 Pro de 64 points, un écart proche des 66 points qui le séparent d’Opus 5.5. Autrement dit, Qwen4-Max occupe pour l’instant une position intermédiaire entre le camp chinois et le sommet mondial : il a creusé l’écart avec ses rivaux nationaux, mais il lui reste du chemin à faire pour rejoindre la tête du classement.
Une remarque s’impose : les modèles chinois classés de la 2e à la 7e place se tiennent entre 1686 et 1658 points, avec des écarts très faibles. S’appuyer sur ce classement pour les départager n’a pas grand intérêt.
Quel écart entre Qwen4-Max et les leaders mondiaux ?
Les écarts de score sur Code Arena WebDev
Lister les écarts entre Qwen4-Max et les modèles de tête, puis estimer grossièrement le « taux de victoire en duel » avec la formule Elo générale (échelle de 400 points), permet de mieux comprendre ce que ces écarts représentent concrètement. La méthode statistique précise d’Arena peut différer de l’Elo standard ; les taux de victoire ci-dessous ne donnent qu’un repère intuitif :
- Face au 5e, GPT-6 Astra : 1750 vs 1763, soit 13 points d’écart, avec un taux de victoire en duel estimé à environ 48 %, donc globalement à égalité.
- Face au 2e, Opus 5.5 : 66 points d’écart, taux estimé à environ 41 %.
- Face au 1er, Fable 5.2 : 76 points d’écart, taux estimé à environ 39 %.
- Face au deuxième modèle chinois, Kimi K3.1 Pro : 64 points d’avance, taux estimé à environ 59 %.
L’ensemble du classement s’étend de 1071 à 1826. À cette échelle, l’écart de 76 points avec le sommet n’est pas énorme, mais il montre tout de même que, sur les préférences en développement web, les modèles de tête d’Anthropic restent plus appréciés des évaluateurs.
Les autres benchmarks de la même figure : un Elo élevé ne signifie pas de bonnes performances sur les tâches en terminal
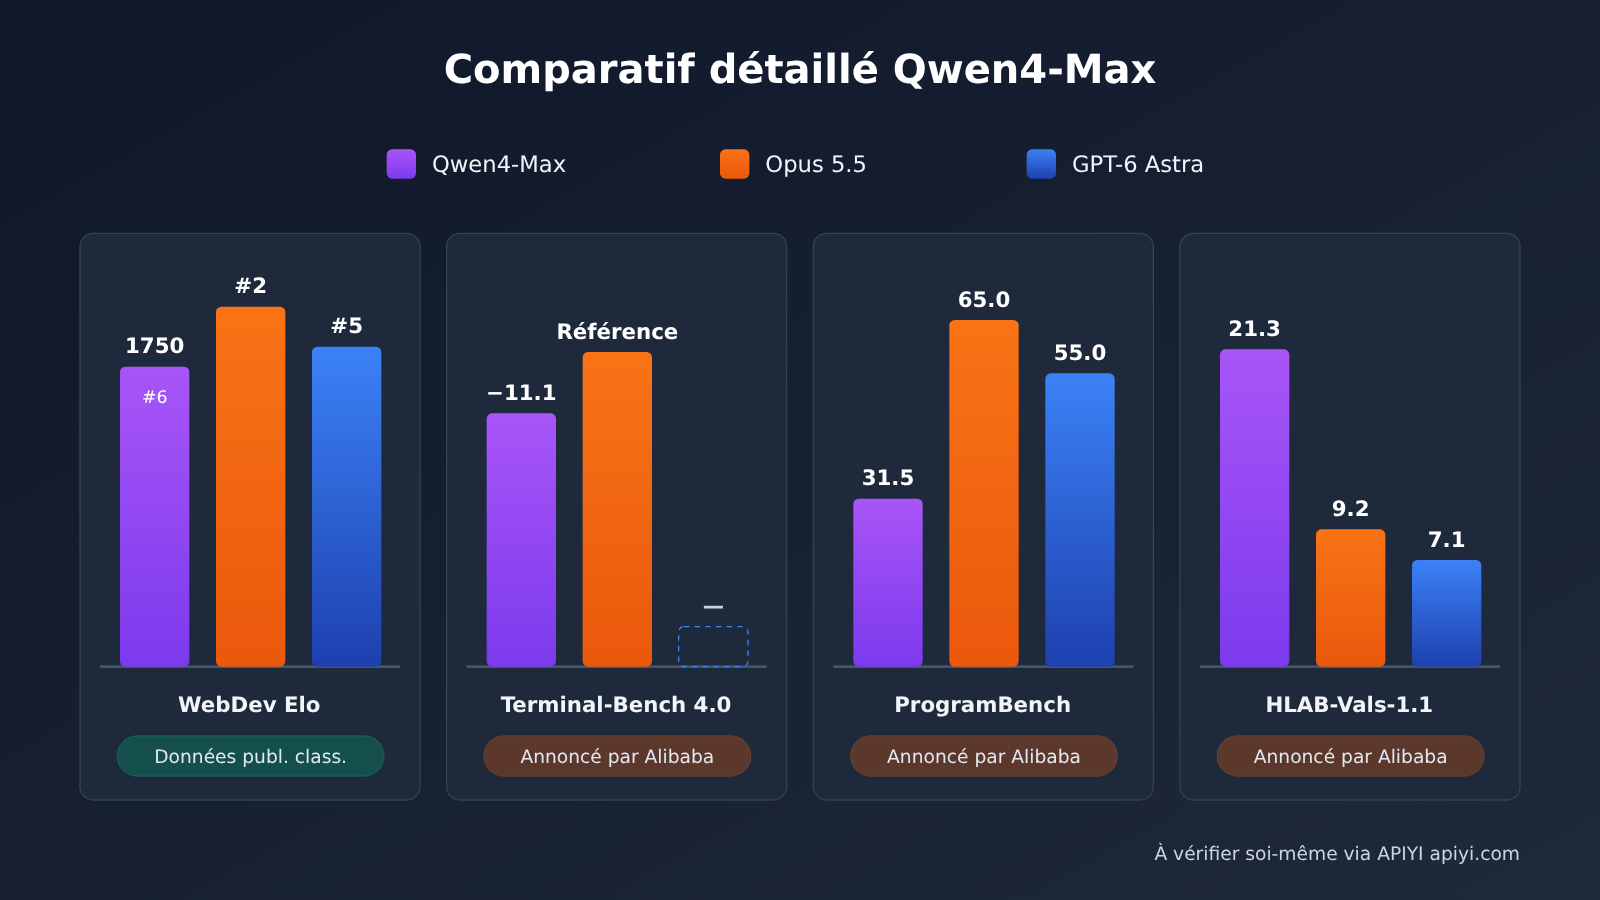
Lors de la publication de Qwen4-Max, Alibaba a utilisé une figure regroupant plusieurs benchmarks. Les données ci-dessous sont toutes déclarées par Alibaba ; elles ne proviennent ni du classement Arena ni d’une reproduction par un tiers.
| Benchmark (données déclarées par Alibaba) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | Autres |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
Ce tableau met en évidence un point clé : Qwen4-Max obtient un très bon score dans le test à l’aveugle en développement web, mais les écarts restent nets sur les benchmarks d’opérations en terminal et de programmation d’ingénierie. Sur Terminal-Bench 4.0, il est 11.1 points en dessous d’Opus 5.5, et le 67.2 du modèle Kimi sur la figure est encore plus élevé ; sur ProgramBench, son 31.5 ne représente même pas la moitié de celui d’Opus 5.5.
Il a aussi des domaines où il mène nettement. Sur HLAB-Vals-1.1, Qwen4-Max obtient 21.3, bien au-dessus des 9.2 d’Opus 5.5 et des 7.1 de GPT-6 Astra ; sur AA-Briefcase, il dépasse également GPT-6 Astra. Autrement dit, Qwen4-Max n’est pas « globalement proche » des modèles de tête : la répartition de ses capacités est différente.
Comment lire les votes et les coûts de Qwen4-Max
Votes : que signifient 1 814 votes ?
La capacité à conserver sa place dépend en grande partie du nombre de votes. Les 1 814 votes de Qwen4-Max représentent moins de 0,2 % d’un total d’environ 1 million de votes, et c’est également beaucoup moins que plusieurs modèles chinois du même classement.
| Modèle | Rang | Votes | Coût par tâche P50 | Statut |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 6e | 1 814 | 4,18 $ | Preliminary |
| Kimi K3.1 Pro (Max) | 13e | 5 215 | 0,89 $ | — |
| Qwen3.8-Max (0902) | 16e | 23 030 | 1,91 $ | — |
| Claude Opus 5.5 (Max) | 2e | Données publiques du même classement | 8,99 $ | — |
| GPT-6 Astra (Max) | 5e | Données publiques du même classement | 9,43 $ | — |
Qwen3.8-Max compte environ 12,7 fois plus de votes que Qwen4-Max, et son score se rapproche davantage d’une « valeur stable ». Le score de 1 750 points de Qwen4-Max ressemble pour l’instant à une lecture préliminaire : il pourrait être revu à la hausse ou à la baisse par la suite. Si vous citez ce rang, mieux vaut indiquer systématiquement ces trois qualificatifs : « Preliminary », « 1 814 votes » et « 2026-11-14 ».
Coût P50 par tâche : ce n’est pas le prix unitaire du modèle
Le coût P50 par tâche affiché dans le classement correspond à la dépense médiane pour une tâche unique, sur les tâches de ce classement. Il dépend fortement de la longueur de sortie du modèle et du niveau d’intensité de raisonnement (xHigh, Max, etc.) : il ne faut donc pas le comparer au prix unitaire du modèle pour un million de tokens.
Vu comme ça, les $4.18 de Qwen4-Max représentent environ 46 % des $8.99 d’Opus 5.5 et 44 % des $9.43 de GPT-6 Astra — mais aussi environ 4,7 fois les $0.89 de Kimi K3.1 Pro, et 2,2 fois les $1.91 de la génération précédente, Qwen3.8-Max. Si votre cas d’usage est sensible au coût par appel, notez que Kimi K3.1 Pro décroche 1686 points pour environ un cinquième du coût : cela mérite aussi d’entrer dans votre évaluation.
Prix officiel de Qwen4-Max et tarif actuel chez APIYI
Voici les prix pour 1M tokens, relevés le 2026-11-16 :
- Prix officiel Qwen4-Max : entrée $1.5, sortie $4.5, lecture de cache $0.075.
- Modèle Qwen phare vendu sur APIYI,
qwen3.8-max: entrée $1.65, sortie $4.95, lecture de cache $0.20625.
À préciser : APIYI ne propose pas encore qwen4-max, mais nous ferons de notre mieux pour le mettre en ligne rapidement. Il s’agit de deux modèles différents, donc les prix ci-dessus ne se comparent pas directement. Pour les modèles réellement disponibles et leurs tarifs, fiez-vous à la liste des modèles de la plateforme APIYI apiyi.com.
Trois étapes : revérifier le classement, comparer les prix et changer de point d’accès
Après la lecture d’un classement, les développeurs font généralement trois choses : vérifier les rangs, vérifier les prix et essayer d’intégrer le modèle dans leur propre projet. Je vous conseille de suivre l’ordre ci-dessous :
- Revérifier le classement : ouvrez la page Code Arena WebDev d’arena.ai et vérifiez si la date, le nombre de votes et le marqueur Preliminary ont changé.
- Comparer les prix : dans la liste des modèles d’APIYI apiyi.com, consultez les modèles Qwen actuellement commercialisés et leurs tarifs en temps réel, et vérifiez si
qwen4-maxest déjà disponible au catalogue. - Changer de point d’accès : dans votre SDK compatible OpenAI actuel, remplacez le base_url par
https://api.apiyi.com/v1, renseignez d’abord l’ID du modèleqwen3.8-max, puis, une fois le nouveau modèle disponible, passez àqwen4-maxpour comparer.
🚀 Conseil pour démarrer rapidement : si vous voulez vérifier sur vos propres tâches WebDev l’écart entre la série Qwen et Claude, GPT, Gemini, vous pouvez passer par APIYI apiyi.com pour appeler plusieurs modèles avec une seule clé API. Les nouveaux utilisateurs bénéficient d’un quota de test gratuit, ce qui est pratique pour exécuter d’abord un petit lot d’échantillons avant de choisir le modèle.
Analyse des avantages et des limites de Qwen4-Max
Les points forts de Qwen4-Max
- Score de préférence en développement web en tête des modèles chinois : 1750 points, soit 64 points de plus que le deuxième modèle chinois et 74 points de plus que la génération précédente.
- L’écart avec une partie du peloton de tête est déjà faible : seulement 13 points du 5e, GPT-6 Astra, et quasiment à égalité avec les 7e et 8e places.
- Coût par tâche inférieur à celui des modèles phares du haut du classement : P50 $4.18, moins de la moitié d’Opus 5.5 et de GPT-6 Astra.
- Certains benchmarks présentent un avantage spécifique : sur HLAB-Vals-1.1, le score déclaré par l’éditeur dépasse nettement celui d’Opus 5.5 et de GPT-6 Astra.
Les limites de Qwen4-Max
- Classement pas encore stabilisé : marquage Preliminary et 1 814 votes ; il faut préciser les conditions de lecture quand on le cite.
- En retrait sur les benchmarks de terminal et de programmation d’ingénierie : sur Terminal-Bench 4.0 et ProgramBench, Qwen4-Max est nettement inférieur à Opus 5.5 et GPT-6 Astra. Pour les tâches d’agent ou l’automatisation en ligne de commande, il faut l’évaluer séparément.
- Coût par tâche supérieur à certains modèles chinois : nettement plus cher que Kimi K3.1 Pro et Qwen3.8-Max, donc pas forcément rentable dans les scénarios sensibles aux coûts.
Quand ne pas se fier uniquement au classement Code Arena WebDev
Si vos principaux cas d’usage sont les opérations en terminal, les modifications de code sur de longues chaînes ou les tâches d’agent en plusieurs étapes, regarder uniquement l’Elo WebDev surestimera les performances réelles de Qwen4-Max. Dans ce cas, des benchmarks comme Terminal-Bench correspondent mieux à vos besoins. De même, si le budget est une contrainte stricte, il faut regarder le coût par tâche en même temps que le score, plutôt que de ne viser que le classement. La question à laquelle ce classement répond le mieux est : « Du point de vue d’évaluateurs humains, qui produit les meilleures pages web ? »
Questions fréquentes (FAQ)
Q1 : La 6e place de Qwen4-Max au classement Code Arena WebDev est-elle un vrai rang ?
C’est le rang réel affiché sur la page du classement (2026-11-14, catégorie Overall, 1750 points). Mais il porte la mention Preliminary, avec seulement 1 814 votes, et le rang pourrait donc encore bouger. Si vous le citez, pensez à préciser ces conditions.
Q2 : Quel écart entre Qwen4-Max, GPT-6 Astra et Opus 5.5 ?
Sur Code Arena WebDev, Qwen4-Max est 13 points en dessous de GPT-6 Astra, 66 points en dessous d’Opus 5.5 et 76 points en dessous de Fable 5.2, qui est en tête du classement. En revanche, sur Terminal-Bench 4.0 et ProgramBench, les chiffres publiés par Alibaba elle-même, l’écart avec ces deux modèles est nettement plus grand.
Q3 : De combien Qwen4-Max devance-t-il les autres modèles chinois ?
C’est le seul modèle chinois à entrer dans le top 10 : il devance de 64 points le deuxième modèle chinois, Kimi K3.1 Pro (13e, 1686 points), et de 74 points son propre prédécesseur, Qwen3.8-Max (0902).
Q4 : Dans quels cas Qwen4-Max est-il le plus adapté ?
Si l’on s’en tient à ce classement, il est plutôt taillé pour les tâches WebDev : génération de front-end web, landing pages, prototypes interactifs. Pour l’automatisation de terminal ou les modifications de code à grande échelle, je vous conseille de regarder plutôt des benchmarks orientés terminal et de valider vous-même sur vos propres échantillons.
Q5 : Comment appeler les modèles de la série Qwen via API pour faire des tests comparatifs ?
Vous pouvez vous inscrire sur APIYI apiyi.com et récupérer une clé API. Dans le SDK compatible OpenAI, définissez `base_url` sur `https://api.apiyi.com/v1` et renseignez l’ID de modèle `qwen3.8-max`. `qwen4-max` n’est pas encore disponible pour le moment ; nous le mettrons en ligne dès que possible, et il suffira alors de changer l’ID de modèle pour basculer sur cette comparaison.
Q6 : Le coût de $4.18 par tâche correspond-il au prix de Qwen4-Max ?
Non. Les $4.18 correspondent au coût médian par tâche (P50) calculé par le classement, et dépendent de la longueur de sortie et du niveau de raisonnement. Pour le prix unitaire d’un modèle, il faut regarder les tarifs d’entrée, de sortie et de lecture de cache pour 1M tokens ; les prix à jour sont disponibles dans la liste des modèles sur APIYI apiyi.com.
Qwen4-Max Code Arena WebDev — Points clés à retenir
- Classement : 6e du classement du 14 novembre 2026, avec 1 750 points ; c’est la première fois qu’un modèle chinois entre dans le top 6.
- Paysage : les cinq premières places sont réparties entre Anthropic (trois), Google (une) et OpenAI (une).
- Stabilité : avec la mention « Preliminary » et 1 814 votes, le classement peut encore évoluer.
- Écart avec les autres modèles chinois : 64 points d’avance sur Kimi K3.1 Pro et 74 points sur la génération précédente.
- Limites de capacités : sur Terminal-Bench et ProgramBench, les chiffres auto-déclarés par l’éditeur restent en retrait face aux leaders.
- Base de coût : le P50 à 4,18 $ correspond à la médiane par tâche, pas au prix unitaire du modèle.
- Pour démarrer : vous pouvez d’abord mettre en place un workflow de comparaison avec
qwen3.8-maxsur APIYI, puis basculer vers le nouveau modèle quand il sera disponible.
En résumé
La performance de Qwen4-Max dans le classement Code Arena WebDev peut se résumer en trois points :
- Première entrée dans le top 6 : 1 750 points, le seul modèle non issu d’un laboratoire américain du top 6, à seulement 13 points de la 5e place.
- Un rang encore provisoire : mention « Preliminary », 1 814 votes ; si vous citez ce résultat, précisez la date et le nombre de votes.
- L’Elo ne signifie pas une supériorité globale : sur les benchmarks de type terminal et d’ingénierie logicielle auto-déclarés par l’éditeur, le modèle reste derrière Opus 5.5 et GPT-6 Astra.
Si vous faites un choix de modèle, je vous conseille de prendre ce classement comme une dimension de référence parmi d’autres — celle des « préférences en développement web » — puis de le croiser avec vos propres échantillons de tâches et votre budget. Je recommande de passer par APIYI (apiyi.com) pour comparer les modèles candidats sur un même lot de tâches via une interface unifiée, et de tirer vos conclusions à partir de vos propres données.
📚 Références
- Classement Code Arena WebDev d’arena.ai : source du rang, du score, des votes et du coût par tâche cités dans cet article
- Lien :
arena.ai -
Remarque : la page affiche la date du 2026-11-14, catégorie Overall ; vous pouvez y vérifier vous-même le rang le plus récent et le marqueur Preliminary
-
Image de lancement officielle d’Alibaba Qwen4-Max : source des scores aux benchmarks Terminal-Bench 4.0, ProgramBench, etc.
- Lien : se référer aux canaux de publication officiels de Qwen
- Remarque : les données concernées dans l’article sont toutes déclarées par l’équipe officielle, sans reproduction par un tiers
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour les informations sur la mise en ligne des modèles et leur intégration, consultez le centre de documentation docs.apiyi.com


