
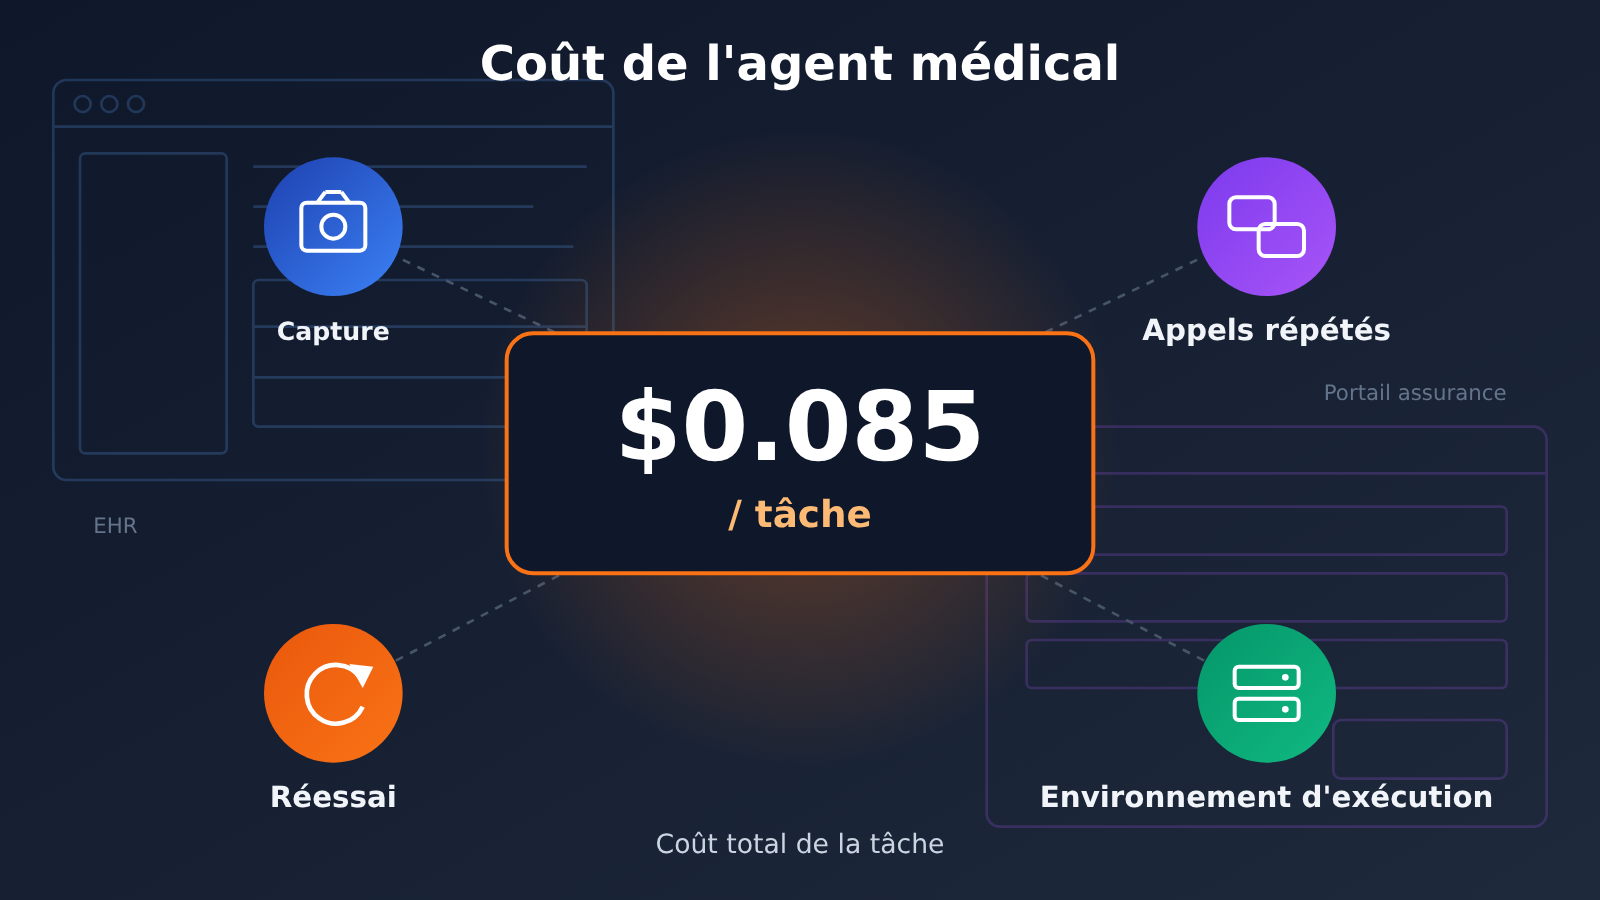
Oui, sous certaines conditions — mais en production, il ne faut pas reprendre ce chiffre tel quel. Le 16 novembre 2026, OpenAI a révélé que le coût par tâche de GPT-6 Luna sur HealthAdminBench, un benchmark d’administration médicale, s’élevait à 0,085 dollar, soit 98 % de moins que GPT-6 Astra. Ce chiffre provient d’un benchmark, pas d’un devis de déploiement hospitalier en production.
Le coût d’un Agent ne se convertit pas non plus simplement à partir du prix unitaire par million de tokens. Une tâche Computer Use comprend plusieurs cycles d’invocation du modèle, des entrées de captures d’écran, l’exécution d’outils, les nouvelles tentatives en cas d’échec et l’environnement d’exécution. Ce qu’il faut réellement comptabiliser, c’est le coût complet de la tâche. Pour les développeurs, une stratification raisonnable des modèles, la mise en cache, la consolidation des workflows et le suivi des coûts comptent davantage que le choix du modèle au prix unitaire le plus bas.
Que vous apprendra cet article sur les coûts d’un Agent médical ?
- Dans quelles conditions de test les 8,5 cents ont-ils été obtenus, et quelles valeurs sont officiellement divulguées ou estimées par calcul inverse
- De quoi se compose le coût complet d’une tâche d’Agent médical, et comment les captures d’écran, les invocations multiples et les nouvelles tentatives font grimper la facture
- Comment stratifier les modèles, et comment estimer le budget de son projet d’Agent à l’aide de formules et du volume mensuel de tâches
Index de cet article : par où commencer pour lire le bilan de coûts d’un agent médical
Commençons par les faits : à quoi correspondent les 8,5 cents, selon quel référentiel de notation, puis pourquoi le prix unitaire des tokens ne peut pas représenter le coût d’une tâche. Ensuite, nous décomposons les six catégories de sources de coûts d’une tâche d’agent, en nous appuyant sur le CUA Agent Kit open source de CVS Health pour expliquer pourquoi un processus fixe n’a pas besoin d’appeler un grand modèle à chaque fois. Dans la partie analyse et jugement, nous discutons de la répartition entre modèles à forte capacité et modèles à faible coût, nous donnons une formule budgétaire directement applicable et des scénarios de calcul, et enfin nous expliquons ce que la gestion de l’usage au niveau de l’API peut résoudre, et ce qu’elle ne peut pas résoudre.
À savoir : concepts liés aux coûts des agents médicalaux
| Concept | Brève explication |
|---|---|
| Computer Use | Capacité à accomplir une tâche en observant l’interface logicielle et en effectuant des clics et des saisies |
| EHR | Système de dossier de santé électronique, c’est-à-dire le système de dossiers médicalaux utilisé par les hôpitaux |
| MCP | Protocole standard pour découvrir et appeler des outils externes |
| RPA | Automatisation qui exécute des processus répétitifs selon des règles ou scripts préconfigurés |
| Rubric points | Points de score obtenus selon des règles d’évaluation, mesurant l’atteinte de certaines exigences |
| Taux de réussite de bout en bout | Proportion de tâches complètes satisfaisant toutes les conditions de succès, plus strict que la proportion de points de score |
| Trace | Preuve de traçage enregistrant le déroulement de l’exécution, les actions effectuées et l’état de l’interface |
| Maximum Reasoning Effort | Niveau de raisonnement le plus élevé du modèle, qui consomme généralement plus de tokens de raisonnement |
| Entrée en cache | Mécanisme où un préfixe d’entrée répété est facturé à un prix unitaire réduit |
Impact en bref : ce que le coût d’un agent médical signifie pour chacun
- Développeurs et responsables techniques : impossible de bâtir un budget directement à partir des chiffres de référence officiels. Il faut valider le mécanisme d’exécution, le taux de complétion de bout en bout et le coût complet sur ses propres tâches, en intégrant dans les statistiques le volume de captures d’écran, le nombre de tours d’appel et le taux de nouvelle tentative.
- Établissements de santé et responsables de workflow : il convient de distinguer les démonstrations synthétiques, les évaluations fournisseurs, les pilotes et les cas de production. Un faible coût par tâche ne remplace pas la mise en place d’une approbation humaine, du moindre privilège et des journaux d’audit — ces mesures de gouvernance ont elles-mêmes un coût.
Faits objectifs : les données derrière les 8,5 cents d’un agent médical
Quelles tâches d’agent médical peut-on accomplir pour 8,5 cents ?
Les 8,5 cents proviennent de l’annonce d’un agent médical Computer Use publiée par OpenAI le 16 novembre 2026. OpenAI a évalué deux modèles avec HealthAdminBench, un benchmark proposé par le Shah Lab de Stanford, tous deux réglés sur l’intensité de raisonnement maximale. Dans un environnement simulé comprenant un dossier médical électronique (EHR), des portails de payeurs d’assurance et des systèmes de fax, ce benchmark évalue des tâches administratives telles que la vérification de l’admissibilité à l’assurance, les demandes de préautorisation, la commande d’équipement médical et le traitement de documents entre systèmes.
| Élément | GPT-6 Luna | GPT-6 Astra | Nature des données |
|---|---|---|---|
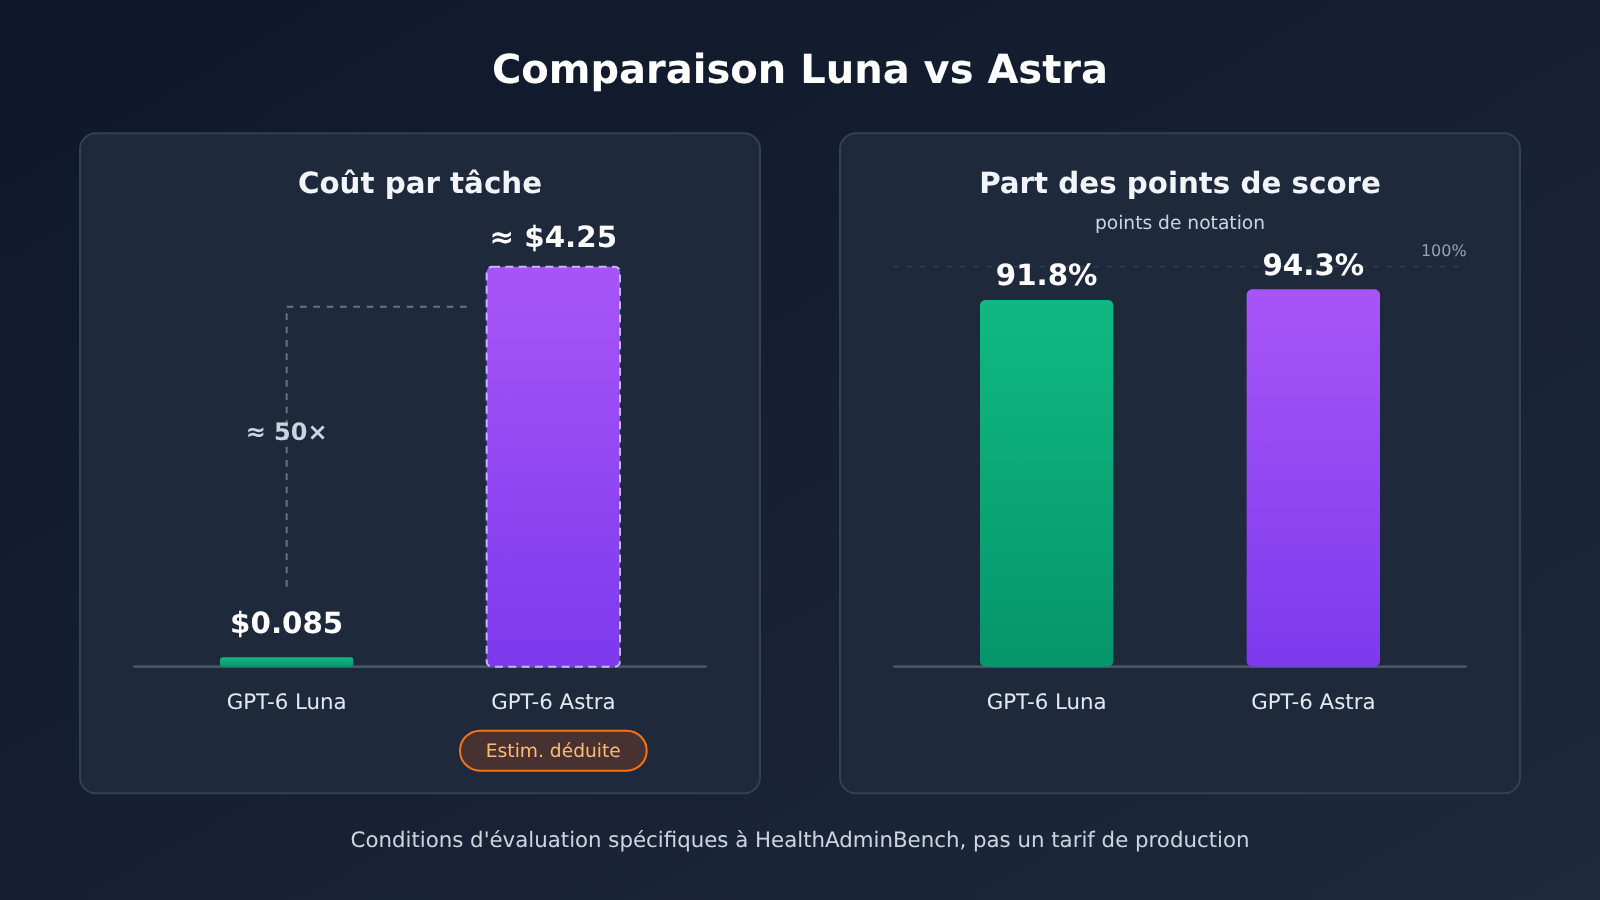
| Score au HealthAdminBench | 91,8 % | 94,3 % | Données officielles, part des points de grille (rubric points) |
| Coût par tâche | 0,085 $ | environ 4,25 $ | Luna : officiel ; Astra : déduit d’une baisse de 98 % |
| Coût pour 1 000 tâches | 85 $ | environ 4 250 $ | Conversion linéaire dans le cadre du benchmark, pas un tarif de production |
| Prix d’entrée (par million de tokens) | 0,10 $ | 10,00 $ | Prix Standard officiel pour contexte court, consulté le 2026-11-17 |
| Prix de sortie (par million de tokens) | 0,50 $ | 50,00 $ | Idem |
| Entrée mise en cache (par million de tokens) | 0,01 $ | 1,00 $ | Idem |
Les quelque 4,25 dollars d’Astra viennent du calcul 0,085 ÷ (1 − 0,98) ; il s’agit d’une approximation, et non d’un prix publié séparément par OpenAI. Les 94,3 % et 91,8 % ne sont pas non plus des taux de réussite sur des tâches complètes. Ils correspondent à la proportion des points de notation disponibles. On ne peut donc pas écrire que « 94,3 % des tâches administratives hospitalières sont déjà entièrement automatisées ».
Il existe plusieurs versions publiques de HealthAdminBench, et il faut distinguer leurs périmètres. La version de l’article 2604.09937v1 comporte 135 tâches et 1 698 sous-tâches, dont 1 177 sont évaluées par des règles déterministes et 521 par un modèle-juge. Dans l’article, le taux de réussite de 36,3 % sur les tâches complètes est celui de Claude Opus 4.6 CUA, tandis que les 82,8 % de réussite sur les sous-tâches sont ceux de GPT-5.4 CUA. Une ancienne page web du Shah Lab décrit une version à 70 tâches et 947 points de notation ; elle ne vaut que comme repère historique. Les résultats obtenus avec des modèles, des dates, des conditions d’exécution et des métriques différents ne peuvent pas être alignés dans un même classement.
Pourquoi le coût d’une tâche d’agent médical ne se résume pas au prix unitaire du token ?
À la lecture du tableau tarifaire, les prix d’entrée, de sortie et d’entrée mise en cache des deux modèles diffèrent d’un facteur 100. Si l’on applique la baisse de 98 %, le coût par tâche des deux modèles ne diffère plus que d’environ 50 fois. On en déduit que la consommation réelle des deux modèles sur un même benchmark n’est pas identique. Le nombre de tours d’appel, les tokens d’entrée et de sortie, la consommation liée au raisonnement et le nombre de tentatives peuvent tous varier : le coût par tâche ne peut donc être calculé qu’à partir de l’usage réel.
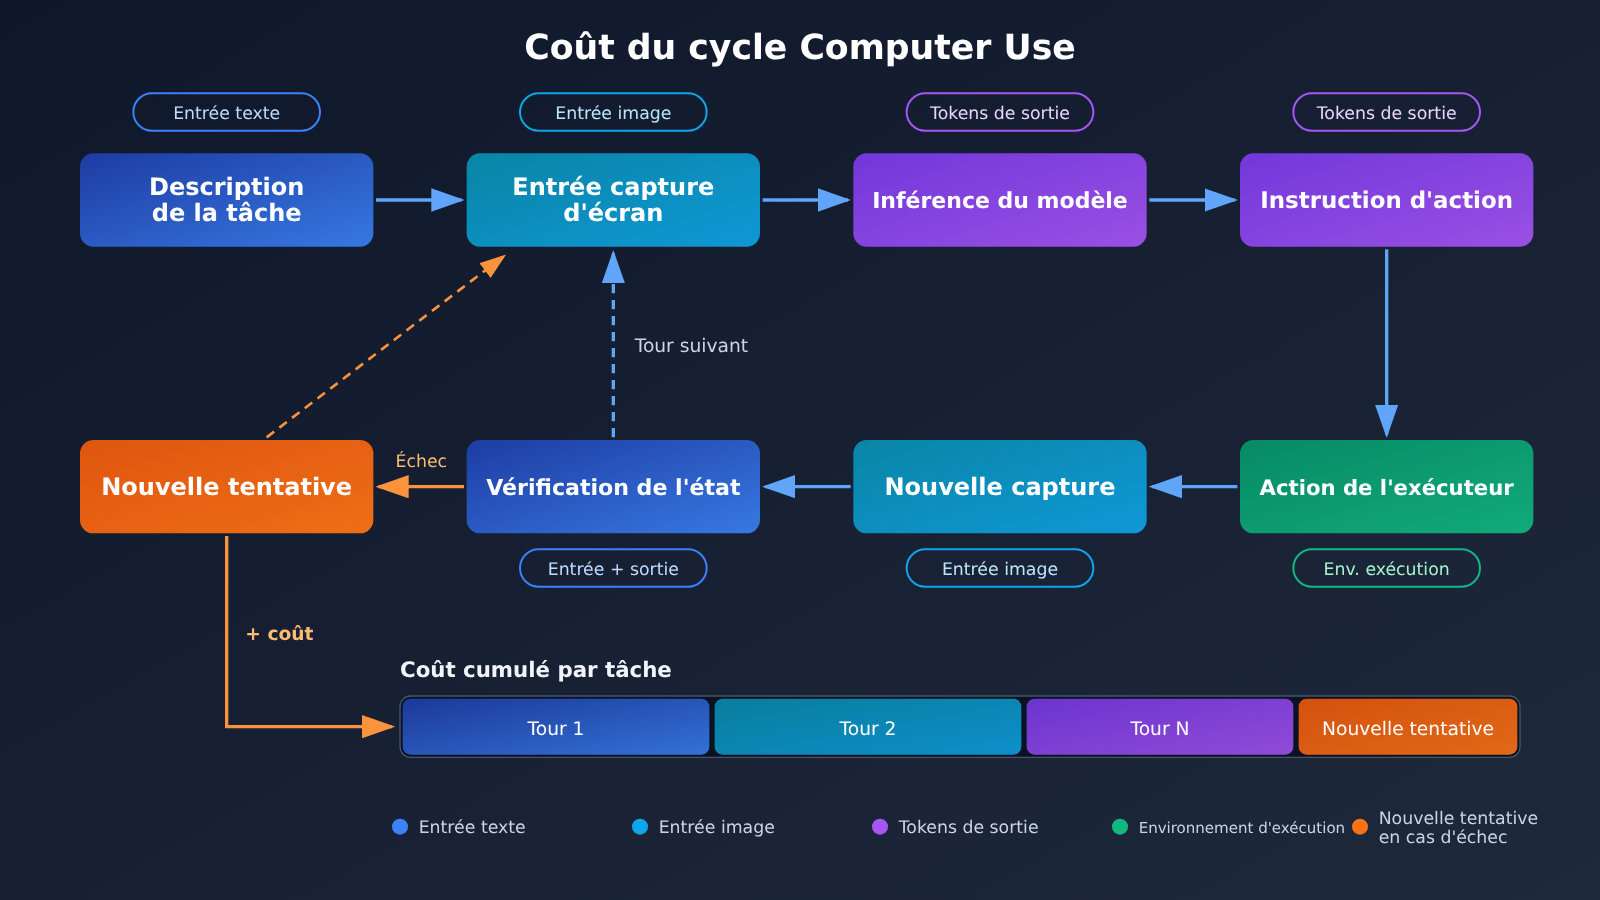
La raison profonde tient au mode d’exécution de Computer Use. D’après la documentation développeur d’OpenAI, une boucle typique se déroule ainsi : recevoir la tâche, observer la capture d’écran, générer l’instruction d’action, l’application exécute le clic ou la saisie, renvoie une nouvelle capture, le modèle évalue l’étape suivante, et ainsi de suite jusqu’à l’achèvement ou à une demande de validation humaine. À chaque étape, la description de la tâche, le contexte historique et la nouvelle capture peuvent être réinjectés dans le modèle.
Une simple question-réponse ne demande souvent qu’un seul appel, alors qu’un flux d’autorisation préalable entre systèmes peut enchaîner une dizaine de cycles « observation, action, vérification ». Les captures d’écran sont des entrées d’image : elles génèrent des frais de tokens visuels à part, et elles réapparaissent à chaque tour, ce qui explique qu’on les sous-estime si facilement. Autre point à garder en tête : le fait que le modèle ait généré une instruction d’action ne signifie pas que l’action a abouti. L’application doit l’exécuter et vérifier le résultat — et cette vérification consomme elle aussi des appels.
Où part réellement l’argent d’une tâche d’agent médical ?
En découpant une tâche, on peut la répartir en six catégories de coûts directs. La maintenance technique relève d’un investissement continu, qu’il vaut mieux comptabiliser séparément.
| Catégorie de coût | Cause | Points de comptage |
|---|---|---|
| Tokens d’entrée | Invite système, description de la tâche, contexte historique, retours d’outils | Cumuler tour par tour, distinguer la partie pouvant être mise en cache |
| Tokens de sortie | Instructions d’action, code généré, décisions et raisonnement | Une intensité de raisonnement élevée augmente nettement la sortie |
| Entrée visuelle | Captures d’écran à chaque tour et compréhension de l’interface | À comptabiliser séparément selon les règles de facturation des images propres au modèle |
| Appels d’outils | Outils intégrés, navigateur hébergé, exécution de code | Les tokens consommés par les outils intégrés sont facturés selon le modèle correspondant |
| Environnement d’exécution | Navigateur, machine virtuelle, conteneur | À inclure uniquement en cas d’utilisation effective du service concerné |
| Nouvelle tentative après échec | Anomalies de chargement de page, échec de localisation, erreurs d’action | Si les tokens de nouvelle tentative sont déjà inclus dans le total, ne pas les ajouter une deuxième fois |
Les coûts d’environnement d’exécution varient fortement. La page de tarification d’OpenAI indique, pour les conteneurs Hosted Shell et Code Interpreter : 1 GB pendant 20 minutes pour 0.03 USD, 4 GB pour 0.12 USD, 16 GB pour 0.48 USD et 64 GB pour 1.92 USD. Le stockage des fichiers et images téléversés est facturé 0.10 USD/GB-jour. Si le développeur exécute Playwright ou un exécuteur de bureau sur son propre serveur, cette part devient un coût d’infrastructure propre, avec une structure totalement différente.
Il faut donc distinguer trois niveaux lors du calcul : le coût du modèle correspond au traitement des entrées et sorties, le coût d’exécution couvre l’infrastructure (navigateur, serveur, conteneur, etc.), et le coût d’ingénierie représente le temps humain consacré à la conception du flux de travail, aux tests, à la surveillance et à la maintenance. Si l’on ne regarde que le premier niveau, le budget sera forcément sous-estimé.
Pourquoi certains agents médicaux ne devraient-ils pas solliciter le grand modèle de langage à chaque fois ?
CVS Health a présenté dans son annonce des cas observés en production. Un agent a, pendant un week-end, traité un arriéré de plusieurs mois de tâches d’envoi de fichiers ; un autre agent exécute chaque jour des dizaines de milliers d’étapes d’opération système liées à des consultations spécialisées. Les « dizaines de milliers de fois » désignent ici des étapes d’opération, et non des décisions cliniques réalisées indépendamment par l’IA. Le système est également doté de contrôles de validation, d’une supervision humaine, ainsi que de vérifications d’état fondées sur des captures d’écran et des enregistrements d’actions.
Ce qui mérite davantage l’attention des développeurs, c’est le CUA Agent Kit open source de CVS (licence Apache-2.0). Il divise l’automatisation en deux phases : d’abord, OpenAI Computer Use Agent exécute une tâche selon une instruction en langage naturel et enregistre les captures d’écran, les actions, les positions cibles et la Trace ; ensuite, Codex Skill se base sur les trajectoires réussies pour générer ou mettre à jour du code de workflow déterministe, qui est examiné par un ingénieur. Le README précise que la phase d’exécution déterministe ne nécessite pas de clé API de modèle.
Cette conception vise directement le problème de coût : lorsqu’on explore un processus inconnu, il faut l’inférence d’un grand modèle ; lorsqu’on répète un processus connu, on confie l’exécution à du code classique. Tant que le processus reste stable, une exécution isolée ne génère plus de frais d’entrée visuelle ni d’inférence, et les fluctuations de résultats diminuent aussi. L’un des arguments centraux du projet est que « découvrir comment accomplir une tâche » et « la répéter de manière stable sur la durée » sont deux problèmes différents.
On peut aussi comprendre le rapport entre RPA traditionnel et agents sous cet angle. Dans une étude comparative sur la RPA (DOI : 10.1080/23311975.2026.2724760), les tâches P2 et P3 ont été exécutées 10 fois pour chaque technologie ; pour la tâche P1, l’agent n’a été exécuté qu’une seule fois et a échoué, il n’a donc pas été intégré aux statistiques ultérieures. On ne peut donc pas dire de façon générale que « toutes les tâches ont été exécutées 10 fois ». L’étude s’appuie sur une configuration d’outils de 2025 et ne doit pas être considérée comme une performance directe des modèles de 2026. Elle met toutefois en évidence un point : lorsqu’on évalue une solution d’automatisation, la stabilité des exécutions répétées est aussi importante que la réussite d’une exécution unique.
Analyse et décision : comment établir le bilan des coûts d’un agent médical
Comment répartir les rôles entre modèles à forte capacité et modèles à faible coût dans un agent médical ?
Les données de référence montrent que la part des points de score de Luna est inférieure de 2,5 points de pourcentage à celle d’Astra, alors que son coût ne représente qu’environ 2 % de celui d’Astra. Cela indique que, dans les tâches administratives très structurées, les modèles à faible coût disposent déjà d’une capacité d’exécution notable. Mais un écart sur les points de score ne signifie pas forcément un écart de taux de réussite de bout en bout : si les points perdus tombent précisément sur des étapes critiques comme l’envoi de fichiers ou la mise à jour de statut, le résultat métier peut être totalement différent. C’est notre appréciation, et elle doit être vérifiée avec les données de vos propres tâches.
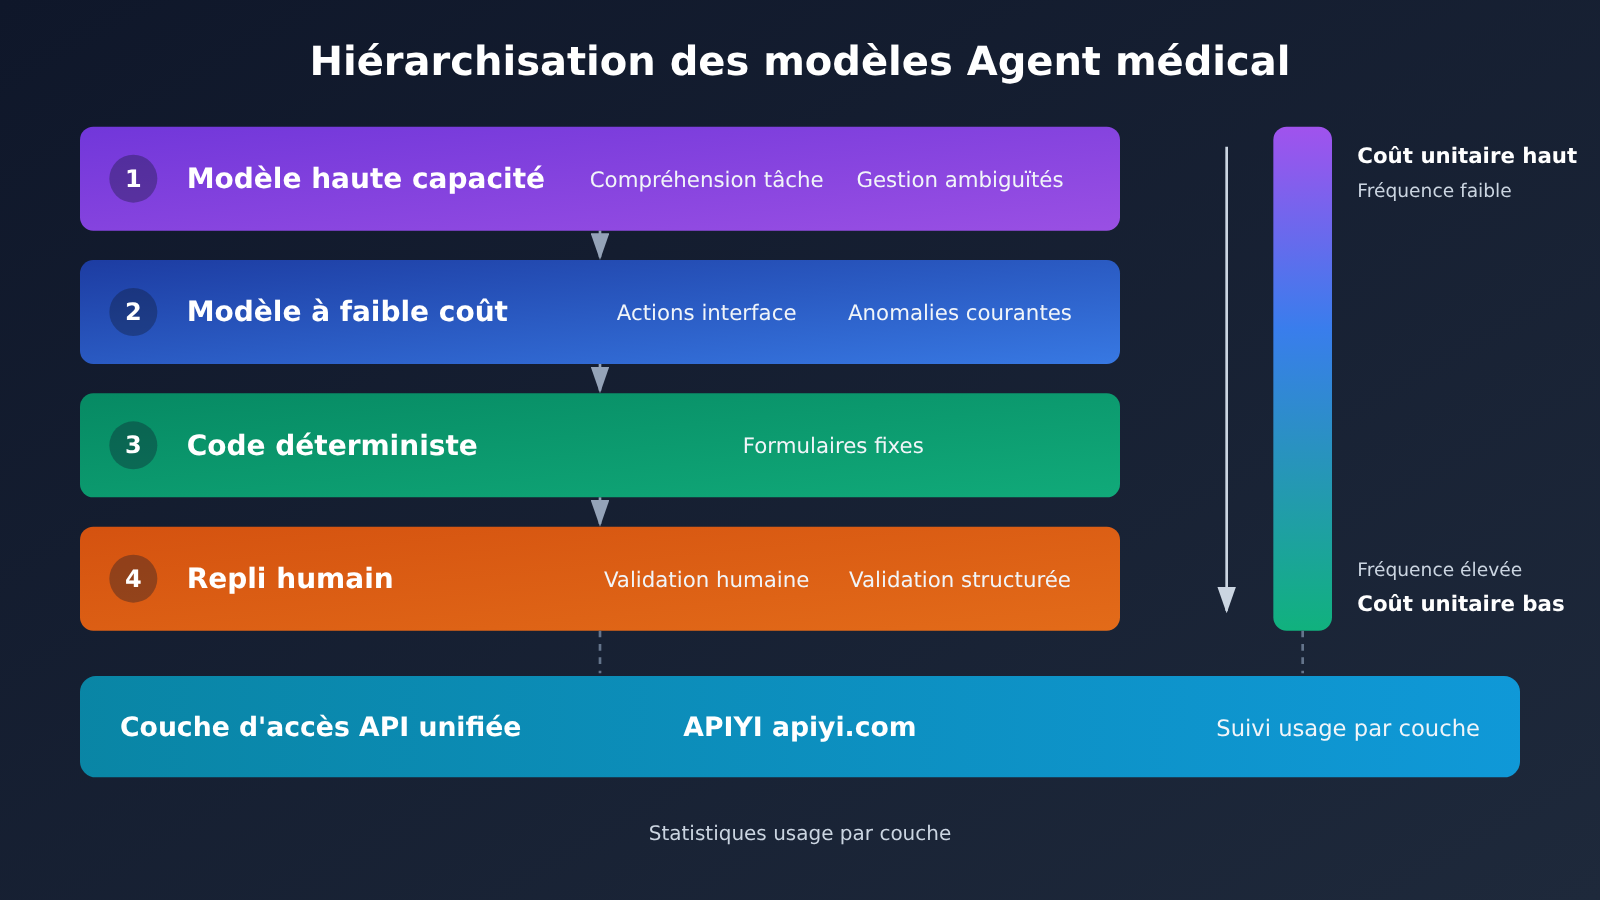
Une approche plus sûre consiste à répartir les rôles par étape, plutôt que d’utiliser un seul modèle pour toute la tâche :
| Étape de travail | Acteur recommandé | Raison |
|---|---|---|
| Comprendre une tâche complexe et la décomposer en étapes | Modèle à forte capacité | Le coût d’une erreur est élevé, le nombre d’appels est faible |
| Traiter les ambiguïtés et les informations floues du dossier médical | Modèle à fort raisonnement + validation humaine | La solution d’Ambience s’arrête en cas d’ambiguïté et demande au médecin |
| Opérations d’interface courantes | Modèle à faible coût | Nombre d’appels élevé, sensibilité maximale au prix unitaire |
| Remplissage répété de formulaires fixes | Code déterministe | En s’inspirant de la logique de code déterministe du CUA Agent Kit |
| Traitement des anomalies courantes | Modèle à faible coût ou règles | Schémas fixes, pouvant être progressivement transformés en règles |
| Validation des opérations critiques | Humain | Les actions comme soumettre, envoyer ou signer conservent une autorisation humaine finale |
| Vérification du résultat final | Contrôle structuré + échantillonnage humain | Se fier à l’état du système, et non à la déclaration « terminé » du modèle |
L’intérêt de cette stratification est que les modèles à prix unitaire élevé n’apparaissent que dans les étapes peu fréquentes et à forte valeur, tandis que les étapes fréquentes sont confiées à des modèles à faible coût ou à du code. Lorsque plusieurs modèles coexistent, une interface d’appel unifiée réduit les coûts de bascule. Par exemple, avec une passerelle compatible OpenAI comme APIYI apiyi.com, les développeurs peuvent comparer différents modèles en ne changeant que le paramètre model. Les modèles réellement disponibles dépendent de la liste actuelle de modèles de la plateforme et des autorisations du compte.
Comment calculer le budget de son projet d’agent médical ?
Je vous conseille d’adopter le cadre de coût par tâche ci-dessous. Ici, T désigne le nombre réel de tokens et P le prix par million de tokens :
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (la partie mise en cache est comptée séparément au tarif de cache)
C_output = T_output × P_output / 1,000,000
C_image  = selon les règles de facturation visuelle du modèle, à compter séparément pour chaque tour avec capture d'écran
C_retry  = on ne compte ici que les coûts de nouvelle tentative non encore intégrés aux totaux de tokens ci-dessus

coût d'une tâche réussie = coût total de toutes les tâches ÷ nombre de tâches réussies
budget mensuel = coût d'une tâche réussie × objectif mensuel de tâches réussies + investissement en maintenance technique
Ce qui détermine vraiment la justesse du budget, ce sont ces quelques indicateurs mesurés : nombre moyen de tours d’appel par tâche, nombre moyen de captures d’écran, taux de nouvelles tentatives en cas d’échec, taux d’intervention humaine et taux de réussite de bout en bout. Prendre le « coût d’une tâche réussie » plutôt que le « coût d’une exécution » comme dénominateur permet d’intégrer la consommation des échecs.
Le tableau ci-dessous est un scénario budgétaire que nous avons construit nous-mêmes : tous les volumes d’usage sont hypothétiques et servent uniquement à illustrer la méthode de calcul. Les prix unitaires reprennent les tarifs officiels Standard cités plus haut :
| Hypothèses de scénario (auto-construites, non mesurées) | Modèle à bas coût (tarif Luna) | Modèle haute capacité (tarif Astra) |
|---|---|---|
| 15 tours par tâche, 20 000 tokens d’entrée visuelle et texte par tour | 300 000 × $0.10/M = $0.030 | 300 000 × $10/M = $3.00 |
| 500 tokens de sortie par tour | 7,500 × $0.50/M ≈ $0.004 | 7,500 × $50/M = $0.375 |
| Coût du modèle pour une exécution | environ $0.034 | environ $3.38 |
| Coût d’une tâche réussie en supposant un taux de réussite de bout en bout de 80 % | environ $0.042 | environ $4.22 |
| Coût modèle pour 10 000 tâches réussies par mois | environ $420 | environ $42,200 |
| Conteneur managé (4 GB, 4 tâches en série toutes les 20 minutes) | environ $300/mois | environ $300/mois |
Ce scénario met en évidence un phénomène facile à négliger : quand le modèle est suffisamment bon marché, le coût de l’environnement d’exécution peut se retrouver au même niveau que celui du modèle, voire au-dessus. La direction de l’optimisation change alors : au lieu de « passer à un modèle moins cher », on cherche à « réduire les tours avec capture d’écran, réutiliser les conteneurs et transformer les étapes fixes en code ». C’est un jugement issu de la simulation ; les proportions réelles dépendront de vos propres mesures.
La façon la plus directe de collecter l’usage réel est d’enregistrer le champ usage après chaque appel au modèle. Voici l’exemple le plus simple :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # interface compatible OpenAI d'APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # se référer à la liste des modèles du back-office APIYI
    messages=[{"role": "user", "content": "根据以下字段生成预授权申请核对清单:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
Voir le code complet d’implémentation du coût cumulé par tâche
from dataclasses import dataclass, field
from openai import OpenAI

# Prix officiels Standard « contexte court » du 2026-11-17 (USD par million de tokens) ;
# la facturation réelle suit le palier tarifaire correspondant
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Accès unifié ; le tableau de bord permet de recouper les tokens et les coûts
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # Les tokens des tentatives de reprise sont déjà cumulés dans record(),
        # on ne les ajoute donc pas une seconde fois ici
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 Conseil budget : commencez par un essai à petite échelle sur 20 à 50 échantillons de tâches réelles, puis passez au calcul mensuel. En passant par l’accès unifié d’APIYI (apiyi.com), vous pouvez recouper vos propres mesures avec les journaux de consommation de tokens et de coûts du tableau de bord ; le crédit de test gratuit réservé aux nouveaux utilisateurs suffit largement pour cette étape.
Des prix des modèles à la gestion des coûts API : ce que peut faire une passerelle pour agents médicaux
Quand un projet d’agent passe au multi-modèles, la dérive des coûts vient rarement du prix unitaire. Le plus souvent, personne ne sait dire quel maillon du processus, quel modèle a consommé combien. L’intérêt d’API Gateway est justement de rassembler les appels dispersés en un seul endroit : clés et points de terminaison unifiés, journaux d’usage ventilés par modèle, détail des coûts traçable. C’est à partir de là que l’équipe peut repérer une étape qui fait trop de captures d’écran, ou tel type d’anomalie qui déclenche sans arrêt des nouvelles tentatives.
Prenons APIYI. D’après sa documentation de démarrage rapide, l’intégration consiste à créer un compte, à récupérer une clé API sur la page Token, puis à remplacer l’Endpoint OpenAI par https://api.apiyi.com ; certaines applications doivent ajouter /v1 après l’adresse. Les SDK officiels et les exemples de code sont directement utilisables. La console permet de consulter les modèles, la consommation de tokens et les journaux de coûts. La page indique que les tarifs OpenAI et Claude sont identiques aux tarifs officiels, et qu’il est possible d’obtenir une facture. Pour les équipes qui doivent organiser plusieurs modèles en couches et les comparer, APIYI apiyi.com fournit une couche d’accès facturée à l’usage, avec une mesure unifiée.
Ses limites doivent aussi être claires. Une passerelle API sert à connecter et à mesurer les invocations de modèles, pas à exécuter les agents : les environnements navigateur et bureau, la collecte de captures d’écran, le contrôle des autorisations métier, les processus de validation humaine et la maintenance des workflows restent à la charge des développeurs. Dans le domaine médical, la conformité HIPAA dépend aussi de l’éligibilité du produit concerné, d’un BAA, de la configuration de sécurité et de la gouvernance des données ; elle ne devient pas automatique parce qu’on change de mode d’accès. Et la possibilité d’appeler effectivement tel ou tel modèle GPT-6 dépend de la liste des modèles actuellement proposée par la plateforme.
Revenons au chiffre de 8,5 cents : il démontre le potentiel des modèles à faible coût dans l’automatisation administrative à haute fréquence, mais il ne dit pas combien coûtera votre workflow. La réponse ne peut venir que de vos propres échantillons de tâches, de votre propre taux de réussite et de vos propres journaux d’usage. Comme le dit le proverbe anglais :
The proof of the pudding is in the eating.
(C’est en mangeant le pudding qu’on en connaît la qualité ; seul l’usage réel permet de juger.)
Références
- Annonce d’OpenAI sur les agents Computer Use en santé : source originale des scores HealthAdminBench et du coût par tâche
- Lien :
openai.com/index/advancing-computer-use-for-healthcare-teams
- Lien :
- Page de tarification de l’API OpenAI : prix des tokens GPT-6 Astra et GPT-6 Luna, ainsi que les frais de conteneur
- Lien :
developers.openai.com/api/docs/pricing
- Lien :
- Documentation pour développeurs OpenAI Computer Use : boucle d’exécution, et les deux approches Computer Tool et Code Execution
- Lien :
developers.openai.com/api/docs/guides/tools-computer-use
- Lien :
- Article HealthAdminBench v1 : version précise avec 135 tâches et 1 698 sous-tâches
- Lien :
arxiv.org/html/2604.09937v1
- Lien :
- CVS Health CUA Agent Kit : implémentation open source de l’exploration par IA et de la consolidation en code
- Lien :
github.com/cvs-health/cua-agent-kit
- Lien :
- Étude comparative sur les RPA : conception des exécutions répétées et précisions sur les exceptions
- Lien :
doi.org/10.1080/23311975.2026.2724760
- Lien :
- Vérification de la définition du proverbe : Cambridge Dictionary
- Lien :
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com ; vous trouverez plus de détails sur l’intégration dans le centre de documentation docs.apiyi.com


