
Да, при определённых условиях — но переносить эту цифру один в один в продакшен нельзя. 16 ноября 2026 года OpenAI сообщила, что стоимость одной задачи GPT-6 Luna в медицинском административном бенчмарке HealthAdminBench составляет 0.085 доллара — на 98% меньше, чем у GPT-6 Astra. Это цифра из бенчмарка, а не коммерческое предложение для реального развёртывания в больнице.
Стоимость агента тоже нельзя просто пересчитывать по цене за миллион токенов. Одна задача Computer Use включает несколько раундов вызова модели, передачу скриншотов, выполнение инструментов, повторные попытки после сбоев и саму среду выполнения — считать нужно полную стоимость задачи. Для разработчика разумное разделение моделей по уровням, кэширование, закрепление рабочих процессов и мониторинг затрат важнее, чем погоня за моделью с самой низкой ценой за токен.
Что вы узнаете о стоимости медицинского агента из этой статьи?
- При каких условиях тестирования получены 8,5 цента, какие значения официально раскрыты, а какие — получены обратным расчётом
- Из каких частей складывается стоимость полной задачи медицинского агента; как скриншоты, многораундовые вызовы и повторные попытки увеличивают расходы
- Как разделить модели по уровням и как с помощью формулы и месячного объёма задач оценить бюджет собственного Agent-проекта
Содержание: с чего начать разбираться в расходах медицинского агента
В части с объективными фактами сначала разберём, какому бенчмарку соответствуют 8,5 цента и по каким критериям оценивается результат, а затем объясним, почему цена за токен ещё не отражает стоимость задачи. После этого разложим полную стоимость одной задачи агента на шесть категорий источников затрат и на примере открытого CUA Agent Kit от CVS Health покажем, почему для фиксированного процесса не обязательно каждый раз вызывать большую модель. В аналитической части обсудим разделение ролей между высокопроизводительными и недорогими моделями, дадим готовую формулу бюджета и сценарии расчёта, а в конце объясним, что может и что не может решить управление расходом на уровне API.
Что нужно знать: понятия, связанные с затратами медицинского агента
| Понятие | Краткое объяснение |
|---|---|
| Computer Use | Способность выполнять задачи, наблюдая за интерфейсом программ, выполняя клики, ввод данных и другие действия |
| EHR | Электронная система медицинских записей, то есть электронная медицинская карта, используемая в больницах |
| MCP | Стандартный протокол для обнаружения и вызова внешних инструментов |
| RPA | Способ автоматизации повторяющихся процессов по заранее заданным правилам или скриптам |
| Rubric points | Баллы, получаемые по правилам оценки; отражают, насколько выполнены отдельные требования |
| Сквозная успешность | Доля задач, полностью удовлетворяющих всем условиям успеха; более строгий показатель, чем доля набранных баллов |
| Trace | Трассировка: свидетельства о ходе выполнения, действиях и состоянии интерфейса |
| Maximum Reasoning Effort | Максимальный уровень интенсивности рассуждений модели; обычно требует больше токенов на рассуждение |
| Кэшированный ввод | Механизм, при котором повторяющийся входной префикс оплачивается по более низкому тарифу |
Кратко о влиянии: что стоимость медицинского агента означает для разных участников
- Разработчики и технические руководители: нельзя просто брать официальные цифры из бенчмарков и сразу закладывать их в бюджет. Нужно проверять механизм выполнения, долю успешно завершённых сквозных задач и полную стоимость на собственных задачах, а также учитывать в расчётах количество скриншотов, число раундов вызовов и долю повторных попыток.
- Медицинские организации и ответственные за рабочие процессы: нужно различать синтетические демонстрации, вендорские оценки, пилотные проекты и реальные кейсы в продакшене. Низкая стоимость одной задачи не отменяет настройку ручного утверждения, минимальных привилегий и журналов аудита — эти меры управления сами по себе тоже требуют затрат.
Объективные факты: данные, стоящие за 8.5 центами медицинского агента
Какие задачи медицинского агента закрывают 8.5 цента?
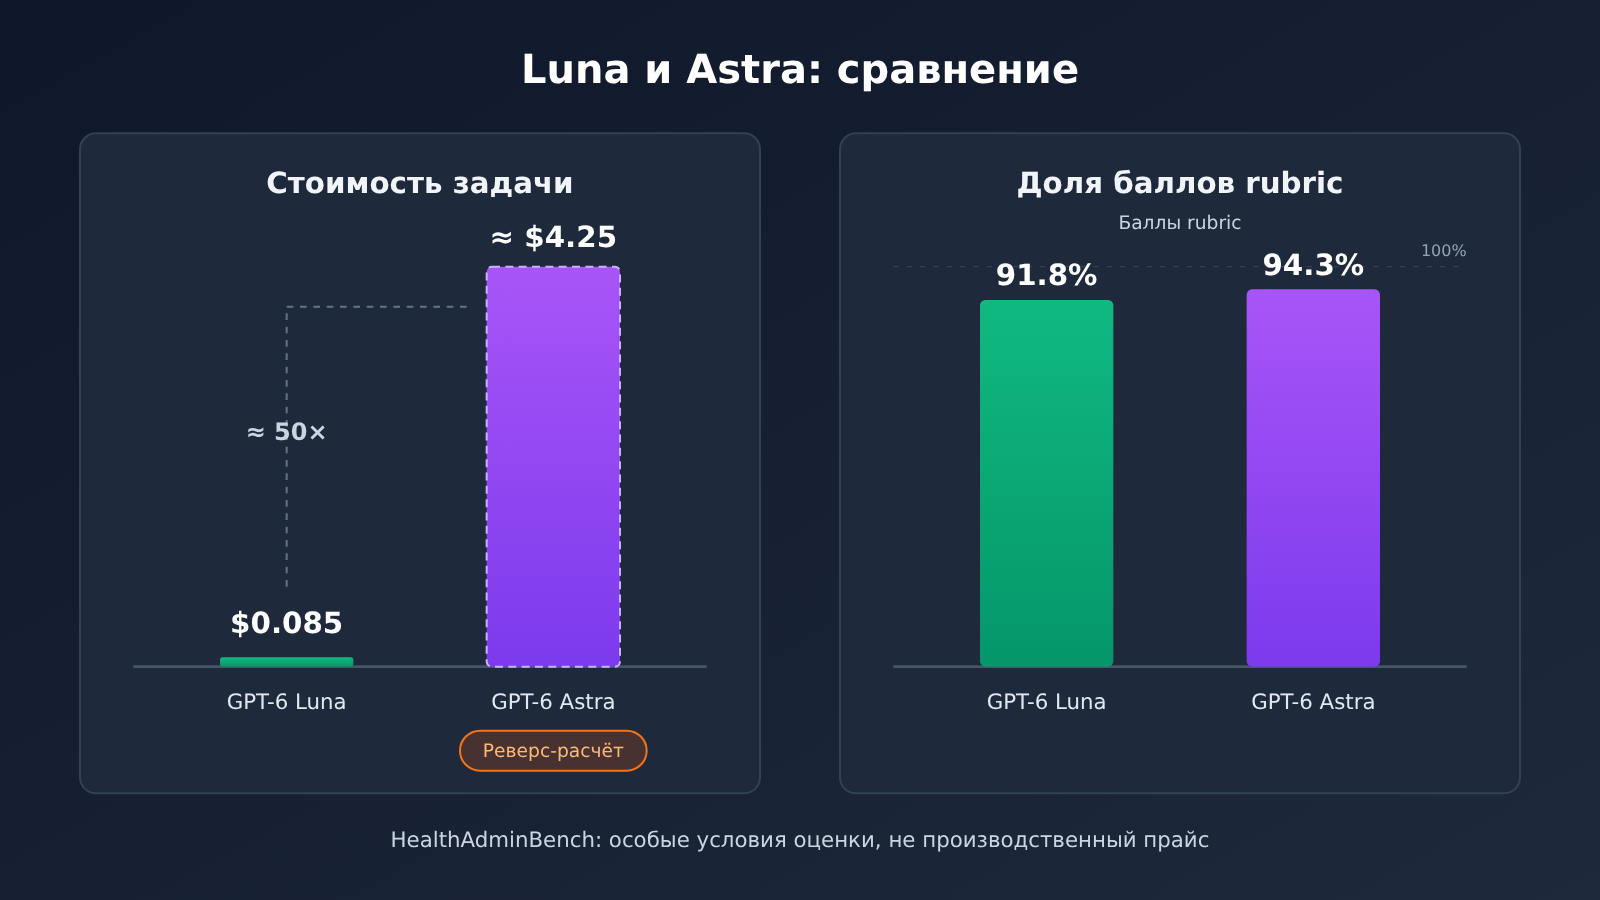
Цифра 8.5 цента взята из анонса медицинского Computer Use Agent, который OpenAI опубликовала 16 ноября 2026 года. OpenAI оценила две модели на HealthAdminBench, предложенном Shah Lab при Стэнфорде, — обе работали с максимальным уровнем рассуждений. Этот бенчмарк проверяет административные задачи — проверку страхового права, заявки на предварительное согласование, заказ медицинского оборудования и обработку документов между системами — в имитируемых EHR, порталах страховых плательщиков и факсимильных системах.
| Показатель | GPT-6 Luna | GPT-6 Astra | Характер данных |
|---|---|---|---|
| Оценка HealthAdminBench | 91.8% | 94.3% | Официально раскрыто, доля rubric points |
| Стоимость одной задачи | $0.085 | около $4.25 | Для Luna — официально раскрыто, для Astra — обратный расчёт от снижения на 98% |
| Стоимость 1 000 задач | $85 | около $4 250 | Линейный пересчёт в рамках методики бенчмарка, а не цена для продакшена |
| Цена ввода (за миллион Token) | $0.10 | $10.00 | Официальная цена Standard для короткого контекста, проверено 2026-11-17 |
| Цена вывода (за миллион Token) | $0.50 | $50.00 | То же |
| Кэшированный ввод (за миллион Token) | $0.01 | $1.00 | То же |
Примерно $4.25 для Astra получаются из расчёта 0.085 ÷ (1 − 0.98); это приближённое значение, а не цена, которую OpenAI публиковала отдельно. 94.3% и 91.8% — тоже не полная доля успешно выполненных задач. Они считают долю доступных для оценки баллов, и на их основе нельзя написать «94.3% больничной административной работы уже полностью автоматизированы».
У HealthAdminBench есть несколько публичных версий, и их методики нужно различать. Версия из статьи 2604.09937v1 включает 135 задач и 1698 подзадач, из которых 1177 определяются детерминированными правилами, а 521 оцениваются моделью-судьёй. В статье 36.3% полных успешных задач относятся к Claude Opus 4.6 CUA, а 82.8% успешных подзадач — к GPT-5.4 CUA. Более ранняя версия на веб-странице Shah Lab описывала 70 задач и 947 оценочных баллов — её можно использовать только как историческое сравнение. Результаты, полученные на разных моделях, в разные даты, при разных условиях выполнения и по разным метрикам, нельзя выстраивать в один общий рейтинг.
Почему в задачах медицинского агента нельзя смотреть только на цену за токен?
Если посмотреть на таблицу цен, стоимость входных, выходных и кэшированных входных токенов у двух моделей различается в 100 раз. При снижении на 98% стоимость одной задачи у них отличается примерно в 50 раз. Отсюда можно сделать вывод, что фактический расход двух моделей на одном и том же бенчмарке неодинаков. Количество раундов вызова, число входных и выходных токенов, расход на инференс и число повторных попыток могут различаться, поэтому стоимость одной задачи можно рассчитать только по реальному использованию.
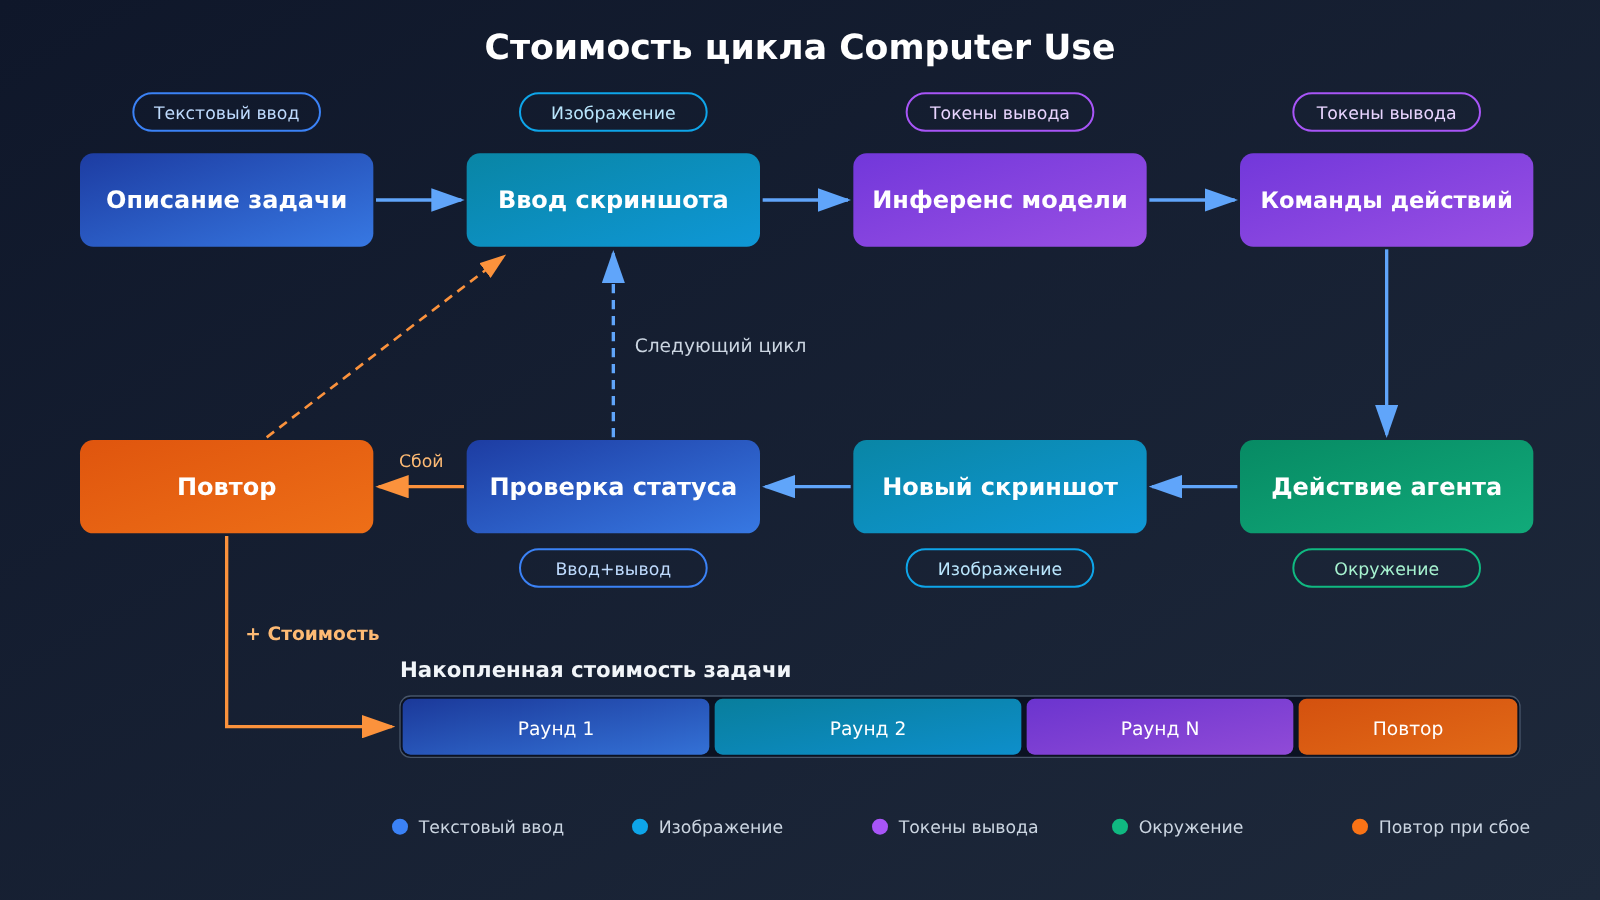
Корень проблемы — в том, как выполняется Computer Use. Согласно документации OpenAI для разработчиков, типичный цикл выглядит так: получить задачу, просмотреть скриншот экрана, сгенерировать команды действий, приложение выполняет клик или ввод, возвращает новый скриншот, модель оценивает следующий шаг — и так до завершения или запроса ручного подтверждения. На каждом шаге описание задачи, история контекста и новый скриншот могут заново передаваться в модель.
Обычный вопрос-ответ может требовать всего одного вызова, а межсистемный процесс предварительного согласования может подряд проходить через десяток с лишним раундов «наблюдение — действие — проверка». Скриншоты относятся к визуальному вводу, отдельно создают расходы на визуальные токены и появляются на каждом раунде, поэтому их проще всего недооценить. Кроме того, важно понимать: то, что модель сгенерировала команду действия, не означает, что действие уже выполнено успешно. Приложение должно выполнить его и проверить результат, а сама проверка тоже расходует вызовы.
Куда на самом деле уходят деньги при выполнении одной задачи медицинского агента?
Если разобрать одну задачу, можно выделить шесть категорий прямых затрат. Инженерное сопровождение — это постоянные вложения, и его лучше учитывать отдельно.
| Категория затрат | Причина возникновения | Что учитывать |
|---|---|---|
| Входные токены | Системный промпт, описание задачи, история контекста, ответы инструментов | Суммировать по раундам, отдельно выделять кэшируемую часть |
| Выходные токены | Команды действий, сгенерированный код, решения и рассуждения | Высокая интенсивность рассуждений заметно увеличивает объём выхода |
| Визуальный ввод | Скриншоты на каждом раунде и понимание интерфейса | Считать отдельно по правилам тарификации изображений конкретной модели |
| Вызовы инструментов | Встроенные инструменты, хостируемый браузер, выполнение кода | Токены, которые расходуют встроенные инструменты, тарифицируются по соответствующей модели |
| Среда выполнения | Браузер, виртуальная машина, контейнер | Учитывать только когда соответствующий сервис действительно используется |
| Неудачные повторы | Ошибки загрузки страницы, неудачное определение элементов, ошибки действий | Если токены повторов уже входят в общий объём, не прибавляйте их повторно |
Тарифы на среду выполнения сильно различаются. На странице цен OpenAI для контейнеров Hosted Shell и Code Interpreter указано: 1 ГБ за 20 минут — 0,03 доллара, 4 ГБ — 0,12 доллара, 16 ГБ — 0,48 доллара, 64 ГБ — 1,92 доллара. Хранение загруженных файлов и изображений стоит 0,10 доллара/ГБ-день. Если разработчик запускает Playwright или десктопный исполнитель на своём сервере, эта часть превращается в стоимость собственной инфраструктуры, и структура затрат получается совсем другой.
Поэтому при расчёте нужно разделять три уровня: стоимость модели — это плата за обработку входа и выхода; стоимость выполнения — расходы на инфраструктуру вроде браузера, сервера и контейнера; инженерная стоимость — человеческие усилия на проектирование рабочих процессов, тестирование, мониторинг и поддержку. Если смотреть только на первый уровень, бюджет точно окажется заниженным.
Почему некоторым медицинским агентам не стоит каждый раз обращаться к большой языковой модели?
CVS Health раскрыла в официальном сообщении кейсы из продакшена. Один агент за выходные разобрал накопившийся за несколько месяцев бэклог задач по отправке файлов, другой ежедневно обрабатывает десятки тысяч шагов работы с системой при консультациях узких специалистов. Здесь «десятки тысяч» — это шаги операций, а не клинические решения, которые ИИ принимает сам. При этом в системе есть проверки валидации, человеческий надзор и сверка состояния по скриншотам и журналам действий.
Разработчикам стоит присмотреться к CUA Agent Kit от CVS с открытым исходным кодом (лицензия Apache-2.0). Проект делит автоматизацию на два этапа: сначала OpenAI Computer Use Agent выполняет задачу, описанную на естественном языке, и записывает скриншоты, действия, целевые позиции и Trace; затем Codex Skill по успешной траектории генерирует или обновляет код детерминированного рабочего процесса, который проверяют инженеры. В README указано, что на этапе детерминированного выполнения API-ключ модели не нужен.
Такая схема напрямую решает проблему стоимости: чтобы исследовать неизвестный процесс, нужен инференс большой языковой модели, а для повторного выполнения уже известного процесса достаточно обычного кода. Если процесс стабилен, за один запуск больше не нужно платить за визуальный ввод и инференс, да и разброс результатов уменьшается. Одна из ключевых мыслей проекта: «понять, как выполнить задачу» и «долго и стабильно повторять её выполнение» — это две разные задачи.
Отношения между традиционным RPA и агентами тоже можно понять с этой точки зрения. В одном сравнительном исследовании RPA (DOI: 10.1080/23311975.2026.2724760) в задачах P2 и P3 каждая технология запускалась по 10 раз, а агент в задаче P1 — только один раз, и запуск завершился неудачей, поэтому его не включили в последующую статистику. Так что нельзя обобщать: «все задачи выполнялись по 10 раз». В исследовании использовалась конфигурация инструментов 2025 года, и его результаты нельзя считать прямым результатом моделей 2026 года. Но оно подсказывает важную вещь: при оценке решений автоматизации стабильность повторных запусков так же важна, как и единичный успех.
Анализ и выводы: как рассчитывать экономику затрат медицинского агента
Как высокопроизводительные и малозатратные модели разделяют роли в медицинском агенте?
Базовые данные показывают: доля оценочных пунктов у Luna на 2,5 процентного пункта ниже, чем у Astra, а стоимость — лишь около 2% от стоимости Astra. Это говорит о том, что в достаточно структурированных административных задачах малозатратные модели уже обладают заметной способностью выполнять работу. Но разрыв в оценочных пунктах не равен разрыву в успешности сквозного процесса: если недостающие баллы приходятся как раз на ключевые шаги — загрузку документов или обновление статуса, — бизнес-результат может оказаться совершенно другим. Это наше суждение, и его нужно проверить на собственных данных задач.
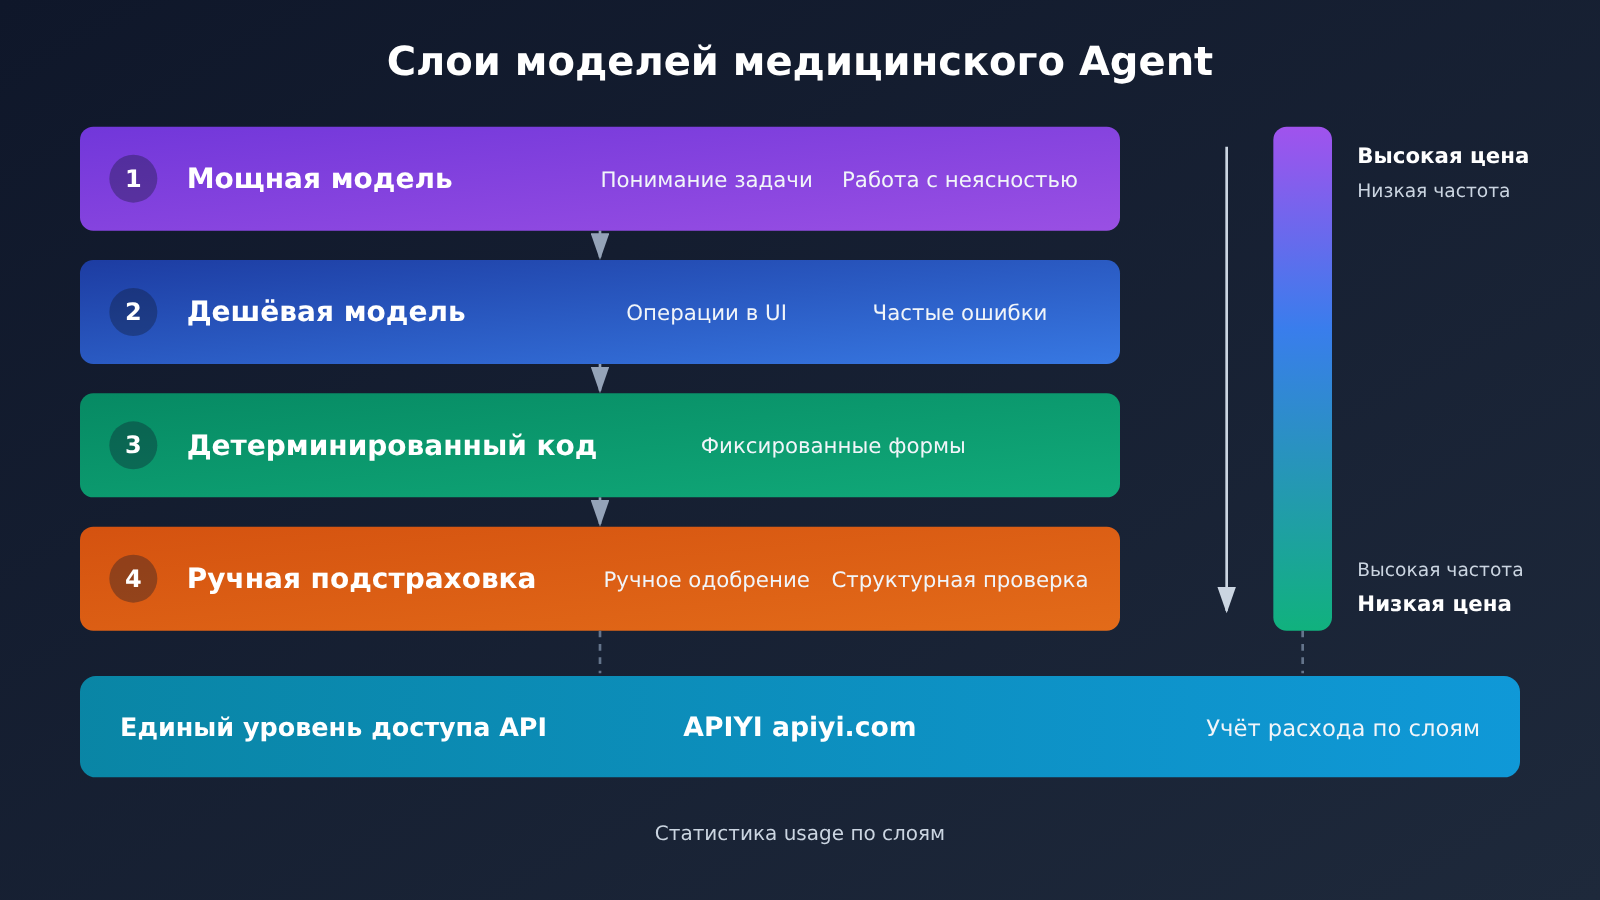
Более надёжный подход — распределять роли по этапам, а не использовать одну модель на всю задачу:
| Этап работы | Рекомендуемый исполнитель | Причина |
|---|---|---|
| Понимание сложной задачи, декомпозиция шагов | Высокопроизводительная модель | Высокая цена ошибки, малое число вызовов |
| Обработка неоднозначности медкарт, размытой информации | Модель с сильным рассуждением + подтверждение человеком | Решение Ambience при неоднозначности останавливается и спрашивает врача |
| Обычные операции в интерфейсе | Малозатратная модель | Много вызовов, наиболее чувствительно к цене за единицу |
| Повторное заполнение фиксированных форм | Детерминированный код | Опираться на подход закрепления логики в коде из CUA Agent Kit |
| Обработка частых исключений | Малозатратная модель или правила | Паттерны фиксированы, можно постепенно превращать их в правила |
| Согласование ключевых операций | Человек | Для отправки, публикации, подписания и подобных действий сохраняется окончательное право человека |
| Проверка итогового результата | Структурированная проверка + выборочная проверка человеком | Ориентироваться на состояние системы, а не на заявление модели «выполнено» |
Выгода такой слоистой схемы в том, что дорогая модель появляется только на низкочастотных, высокоценных участках, а высокочастотные участки передаются малозатратной модели или коду. Когда сосуществуют несколько моделей, единый интерфейс вызова снижает затраты на переключение. Например, через OpenAI-совместимый шлюз вроде APIYI apiyi.com разработчик может сравнивать разные модели, меняя только параметр model. Конкретный список доступных моделей определяется текущим списком моделей платформы и правами аккаунта.
Как разработчику посчитать бюджет своего проекта с медицинским агентом?
Предлагаем такую схему расчёта стоимости одной задачи. Здесь T — фактическое число Token, P — цена за миллион Token:
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (кэшируемая часть считается отдельно по цене кэша)
C_output = T_output × P_output / 1,000,000
C_image  = по правилам биллинга визуальных возможностей модели, каждый скриншот считается отдельно по каждому раунду
C_retry  = учитываются только затраты на повторы, ещё не включённые в указанные выше объёмы Token

Стоимость одной успешной задачи = общая стоимость всех задач ÷ число успешных задач
Месячный бюджет = стоимость одной успешной задачи × целевое число успешных задач за месяц + затраты на инженерную поддержку
Точность бюджета на самом деле определяют вот эти измеренные показатели: среднее число раундов вызова на задачу, среднее число скриншотов, доля повторных попыток после сбоя, доля ручного вмешательства и сквозная успешность. Если брать в знаменатель «стоимость одной успешной задачи», а не «стоимость одного запуска», в расчёт попадут и затраты на неудачные попытки.
В таблице ниже — бюджетный сценарий, который мы построили сами; все объёмы потребления здесь гипотетические и нужны только для демонстрации метода расчёта. Цены за единицу взяты из официального прайса Standard, о котором шла речь выше:
| Сценарные допущения (наши, не измерения) | Дешёвая модель (цена Luna) | Высокопроизводительная модель (цена Astra) |
|---|---|---|
| 15 раундов на задачу, по 20 тыс. Token визуального и текстового ввода на раунд | 300 тыс. × $0.10/M = $0.030 | 300 тыс. × $10/M = $3.00 |
| 500 Token вывода на раунд | 7,500 × $0.50/M ≈ $0.004 | 7,500 × $50/M = $0.375 |
| Стоимость модели за один запуск | около $0.034 | около $3.38 |
| Стоимость одной успешной задачи при сквозной успешности 80% | около $0.042 | около $4.22 |
| Стоимость модели при 10,000 успешных задач в месяц | около $420 | около $42,200 |
| Управляемый контейнер (4 ГБ, 4 задачи последовательно за 20 минут) | около $300/мес. | около $300/мес. |
Этот сценарий вскрывает один легко упускаемый эффект: когда модель достаточно дешёвая, стоимость среды выполнения может оказаться того же порядка, что и стоимость модели, или даже выше. Направление оптимизации тогда меняется: вместо «взять модель подешевле» — «сократить число раундов со скриншотами, переиспользовать контейнеры, перевести фиксированные шаги в код». Это вывод из моделирования сценария; реальные пропорции определяйте по своим измерениям.
Самый прямой способ собрать реальное потребление — записывать поле usage после каждого вызова модели. Вот минимальный пример:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # ориентируйтесь на список моделей в панели APIYI
    messages=[{"role": "user", "content": "根据以下字段生成预授权申请核对清单:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
Посмотреть полный код реализации подсчёта затрат по задачам
from dataclasses import dataclass, field
from openai import OpenAI

# Официальные цены Standard для короткого контекста на 2026-11-17 (доллары США за миллион токенов);
# фактически ориентируйтесь на соответствующий тарифный уровень
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Единая точка подключения; в панели можно сверять логи токенов и расходов
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # Токены повторных раундов уже учтены в record, здесь повторно не добавляются
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 Совет по бюджету: для начала возьмите 20–50 реальных примеров задач и прогоните их в небольшом тестовом запуске, а уже потом считайте месячные затраты. При едином подключении через APIYI apiyi.com можно сверять собственные измерения с логами расхода токенов и затрат в панели — бесплатной тестовой квоты для новых пользователей как раз хватит, чтобы пройти этот шаг.
От цен на модели к управлению расходами на API: что может API-шлюз для медицинских Agent
Когда Agent-проект переходит на этап работы с несколькими моделями, расходы выходят из-под контроля обычно не из-за высокой цены за единицу, а потому что никто не может внятно сказать, какой этап и какая модель сколько потребляют. Ценность API-шлюза в том, что он собирает разрозненные вызовы в одном месте: единые ключи и эндпоинты, журналы использования с разбивкой по моделям, отслеживаемая детализация затрат. Только так команда может заметить, что на каком-то шаге делается слишком много скриншотов или что определённый тип ошибок снова и снова вызывает повторные попытки.
На примере APIYI: согласно документации быстрого старта, подключение выглядит так — регистрируете аккаунт, получаете API-ключ на странице Token, затем заменяете исходный эндпоинт OpenAI на https://api.apiyi.com; некоторым приложениям нужно добавить /v1 после адреса. Официальный SDK и примеры кода можно использовать напрямую; в панели управления доступны модели, расход токенов и журналы затрат; на странице указано, что тарифы OpenAI и Claude совпадают с официальными, а также поддерживается выставление счетов. Для команд, которым нужно разделять модели по уровням и сравнивать их, APIYI (apiyi.com) предлагает слой доступа с оплатой по фактическому использованию и единым учётом.
Но важно чётко обозначить и его границы. API-шлюз решает задачи подключения и учёта вызовов моделей, а не является исполнителем Agent: браузерные и десктопные среды, сбор скриншотов, контроль прав доступа к бизнес-процессам, процессы ручного согласования и поддержку рабочих процессов по-прежнему должен строить разработчик самостоятельно. В медицинских сценариях соответствие HIPAA также зависит от того, подходит ли продукт, от BAA, настроек безопасности и управления данными; оно не появится автоматически только из-за смены способа подключения. А то, можно ли вызывать конкретную модель GPT-6, тоже нужно сверять с актуальным списком моделей на платформе.
Возвращаясь к цифре 8,5 цента: она доказывает потенциал недорогих моделей в высокочастотной административной автоматизации, но не отвечает на вопрос, сколько будет стоить именно ваш рабочий процесс. Ответ может дать только собственная выборка задач, собственная доля успешных выполнений и собственные журналы использования. Как говорит английская пословица:
The proof of the pudding is in the eating.
(Пудинг познаётся по вкусу; реальный результат проверяется практикой.)
Справочные материалы
- Анонс OpenAI о Computer Use Agent для медицины: первоисточник оценок HealthAdminBench и стоимости одной задачи
- Ссылка:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Ссылка:
- Страница тарифов OpenAI API: цены на токены GPT-6 Astra и GPT-6 Luna, а также стоимость контейнеров
- Ссылка:
developers.openai.com/api/docs/pricing
- Ссылка:
- Документация OpenAI для разработчиков по Computer Use: цикл выполнения и два пути — Computer Tool и Code Execution
- Ссылка:
developers.openai.com/api/docs/guides/tools-computer-use
- Ссылка:
- Статья HealthAdminBench v1: явная версия с 135 задачами и 1698 подзадачами
- Ссылка:
arxiv.org/html/2604.09937v1
- Ссылка:
- CVS Health CUA Agent Kit: открытая реализация для исследования с помощью ИИ и закрепления кода
- Ссылка:
github.com/cvs-health/cua-agent-kit
- Ссылка:
- Сравнительное исследование RPA: дизайн повторных запусков и описание исключений
- Ссылка:
doi.org/10.1080/23311975.2026.2724760
- Ссылка:
- Проверка толкования поговорки: Cambridge Dictionary
- Ссылка:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Ссылка:
Автор: техническая команда APIYI
Связаться по техническим вопросам: пишите нам на главной странице APIYI apiyi.com — там же найдёте подробности о подключении, а в центре документации docs.apiyi.com больше инструкций по интеграции


