
Unter bestimmten Bedingungen ja – aber in der Produktionsumgebung lässt sich diese Zahl nicht einfach übernehmen. Am 16. November 2026 hat OpenAI offengelegt, dass die Kosten pro Aufgabe für GPT-6 Luna im HealthAdminBench, einem Benchmark für medizinische Verwaltung, 0,085 US-Dollar betragen – 98 % weniger als bei GPT-6 Astra. Diese Zahl stammt aus einem Benchmark-Test und ist kein Angebot für den Produktionseinsatz in einem Krankenhaus.
Auch die Kosten eines Agenten lassen sich nicht einfach anhand des Preises pro Million Token umrechnen. Eine Computer-Use-Aufgabe umfasst mehrere Modellaufrufe, Screenshot-Eingaben, Tool-Ausführungen, fehlgeschlagene Wiederholungsversuche und die Laufzeitumgebung. Was tatsächlich berechnet werden muss, sind die vollständigen Aufgabenkosten. Für Entwickler sind eine sinnvolle Modellschichtung, Caching, Workflow-Standardisierung und Kostenüberwachung wichtiger als die Wahl des Modells mit dem niedrigsten Stückpreis.
Was erfahren Sie in diesem Artikel über die Kosten medizinischer Agenten?
- Unter welchen Testbedingungen die 8,5 US-Cent zustande kommen, welche Werte offiziell veröffentlicht und welche rückgerechnet geschätzt sind
- Aus welchen Bestandteilen sich die Kosten einer vollständigen Aufgabe eines medizinischen Agenten zusammensetzen und wie Screenshots, mehrere Aufrufe und Wiederholungen die Kosten in die Höhe treiben
- Wie Sie eine Modellschichtung aufbauen und mit Formeln und dem monatlichen Aufgabenvolumen das Budget für Ihr eigenes Agentenprojekt schätzen
Artikelindex: Wo man bei der Kostenrechnung für medizinische Agenten ansetzt
Im Fakten-Teil wird zuerst geklärt, auf welchen Benchmark sich die 8,5 US-Cent beziehen und welcher Bewertungsmaßstab gilt. Danach wird erklärt, warum der Token-Preis nicht die Aufgabenkosten widerspiegelt. Anschließend werden die sechs Kostenquellen einer Agent-Aufgabe einzeln aufgeschlüsselt. Am Open-Source-CUA-Agent-Kit von CVS Health wird gezeigt, warum fest definierte Abläufe nicht bei jedem Durchlauf ein großes Sprachmodell aufrufen müssen. Im analytischen Teil geht es um die Arbeitsteilung zwischen leistungsfähigen und kostengünstigen Modellen. Dazu kommen eine direkt anwendbare Budgetformel und Berechnungsszenarien. Zum Schluss wird erläutert, was Nutzungsverwaltung auf API-Ebene lösen kann und was nicht.
To Know: Begriffe rund um die Kosten medizinischer Agenten
| Begriff | Kurze Erklärung |
|---|---|
| Computer Use | Die Fähigkeit, Aufgaben zu erledigen, indem die Softwareoberfläche beobachtet und Aktionen wie Klicken und Eingeben ausgeführt werden |
| EHR | Elektronisches Gesundheitsaktensystem, also das in Krankenhäusern verwendete elektronische Patientenaktensystem |
| MCP | Ein Standardprotokoll zum Auffinden und Aufrufen externer Werkzeuge |
| RPA | Eine Automatisierungsmethode, bei der wiederkehrende Abläufe nach vorkonfigurierten Regeln oder Skripten ausgeführt werden |
| Rubric points | Bewertungspunkte nach Evaluierungsregeln, die messen, inwieweit Teilanforderungen erfüllt sind |
| End-to-End-Erfolgsrate | Der Anteil vollständiger Aufgaben, die alle Erfolgsbedingungen erfüllen; strenger als der Anteil der Bewertungspunkte |
| Trace | Nachweisliche Aufzeichnung des Ausführungsablaufs, der Aktionen und der Oberflächenzustände |
| Maximum Reasoning Effort | Die höchste Stufe der Inferenzintensität eines Modells, die in der Regel mehr Reasoning-Token verbraucht |
| Cache-Eingabe | Ein Mechanismus, bei dem wiederkehrende Eingabe-Präfixe zu einem niedrigeren Stückpreis abgerechnet werden |
Auswirkungen im Überblick: Was die Kosten medizinischer Agenten für wen bedeuten
- Entwickler und technische Verantwortliche: Offizielle Benchmark-Zahlen lassen sich nicht direkt zur Budgetplanung heranziehen. Sie müssen Ausführungsmechanismen, End-to-End-Abschlussrate und Gesamtkosten anhand der eigenen Aufgaben validieren und dabei die Anzahl der Screenshots, die Aufrufrunden und die Wiederholungsrate in die Kostenrechnung einbeziehen.
- Medizinische Einrichtungen und Workflow-Verantwortliche: Sie müssen zwischen synthetischen Demos, Anbieter-Benchmarks, Pilotprojekten und Produktionsfällen unterscheiden. Niedrige Kosten pro Aufgabe ersetzen nicht die Einrichtung manueller Freigaben, minimaler Berechtigungen und Audit-Logs; auch diese Governance-Maßnahmen verursachen Kosten.
Faktenlage: Was hinter den 8,5 US-Cent für medizinische Agenten steckt
8.5 Welche Aufgaben kann ein medizinischer Agent für 8,5 Cent erledigen?
Die 8,5 Cent stammen aus der Ankündigung eines medizinischen Computer-Use-Agenten, die OpenAI am 16. November 2026 veröffentlicht hat. OpenAI hat damit zwei Modelle anhand von HealthAdminBench evaluiert, das vom Shah Lab der Stanford University vorgeschlagen wurde; beide liefen mit maximalem Reasoning-Aufwand. Der Benchmark prüft in simulierten EHR-Systemen, Portalen der Kostenträger und Faxsystemen administrative Aufgaben wie die Prüfung der Versicherungsanspruchsberechtigung, Anträge auf Vorabgenehmigung, die Bestellung von Medizingeräten und systemübergreifende Dokumentenverarbeitung.
| Kennzahl | GPT-6 Luna | GPT-6 Astra | Art der Angabe |
|---|---|---|---|
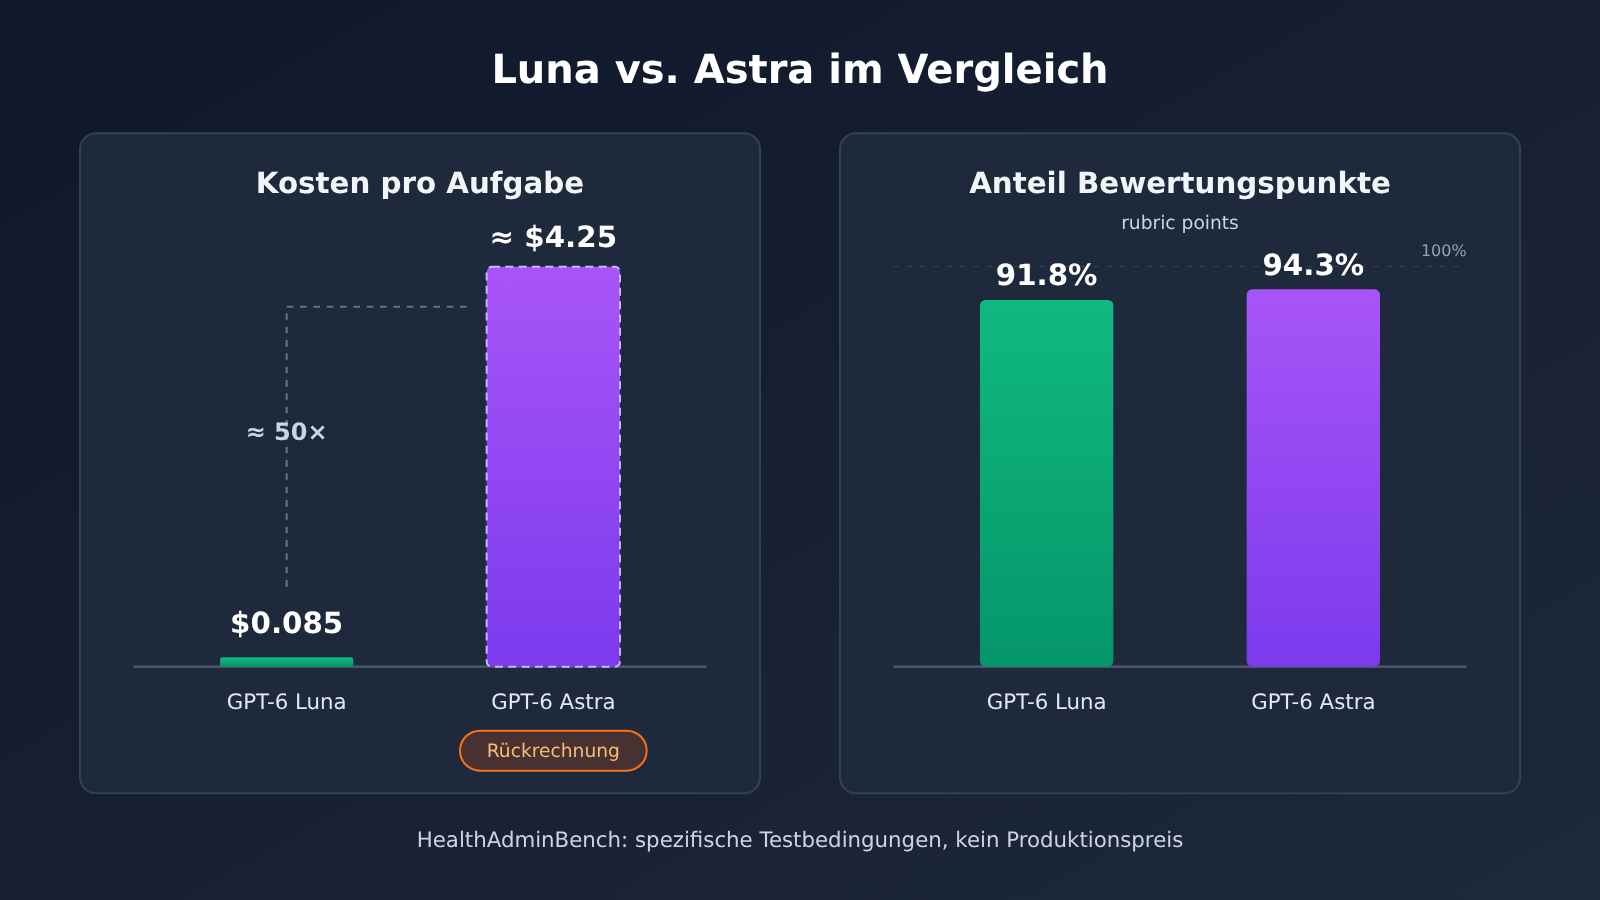
| HealthAdminBench-Ergebnis | 91,8 % | 94,3 % | Offizielle Angabe; Anteil der Rubrik-Punkte |
| Kosten pro Aufgabe | 0,085 $ | ca. 4,25 $ | Luna offiziell angegeben; Astra aus einer Senkung um 98 % zurückgerechnet |
| Kosten für 1.000 Aufgaben | 85 $ | ca. 4.250 $ | Lineare Umrechnung nach Benchmark-Logik, kein Produktionspreis |
| Eingabepreis (pro Million Token) | 0,10 $ | 10,00 $ | Offizieller Standardpreis für kurzen Kontext, abgefragt am 17.11.2026 |
| Ausgabepreis (pro Million Token) | 0,50 $ | 50,00 $ | Wie oben |
| Cache-Eingabe (pro Million Token) | 0,01 $ | 1,00 $ | Wie oben |
Die rund 4,25 US-Dollar für Astra ergeben sich aus der Rechnung 0,085 ÷ (1 − 0,98). Das ist ein Näherungswert und kein von OpenAI separat veröffentlichter Preis. Auch 94,3 % und 91,8 % sind keine Erfolgsquoten für vollständige Aufgaben. Sie erfassen den Anteil der erreichbaren Bewertungspunkte. Daraus darf man nicht die Aussage machen: „94,3 % der Krankenhausverwaltung laufen bereits vollautomatisch.“
HealthAdminBench gibt es in mehreren öffentlichen Versionen, deren Messgrundlage man auseinanderhalten muss. Die Paper-Version 2604.09937v1 enthält 135 Aufgaben und 1698 Unteraufgaben; 1177 davon werden durch deterministische Regeln bewertet, 521 durch einen Modell-Judge. Die im Paper genannte Erfolgsquote für vollständige Aufgaben von 36,3 % entfällt auf Claude Opus 4.6 CUA, die Erfolgsquote auf Unteraufgabenebene von 82,8 % auf GPT-5.4 CUA. Die frühere Shah-Lab-Webseite beschreibt eine Version mit 70 Aufgaben und 947 Bewertungspunkten; sie taugt nur als historischer Vergleich. Ergebnisse unterschiedlicher Modelle, Zeitpunkte, Ausführungsbedingungen und Metriken lassen sich nicht in eine gemeinsame Rangliste bringen.
Warum man bei medizinischen Agent-Aufgaben nicht nur den Token-Preis betrachten sollte
Laut der Preistabelle unterscheiden sich die Stückpreise der beiden Modelle für Eingabe, Ausgabe und gecachte Eingabe um den Faktor 100. Rechnet man mit einem Rückgang von 98 %, liegen die Kosten pro Aufgabe bei beiden nur noch etwa um den Faktor 50 auseinander. Daraus lässt sich schließen, dass die beiden Modelle im selben Benchmark nicht dieselbe tatsächliche Verbrauchsmenge haben. Anzahl der Aufrufrunden, Anzahl der Eingabe- und Ausgabe-Tokens, Reasoning-Verbrauch und Anzahl der Wiederholungsversuche können alle unterschiedlich ausfallen – die Kosten pro Aufgabe lassen sich daher nur anhand des realen Verbrauchs berechnen.
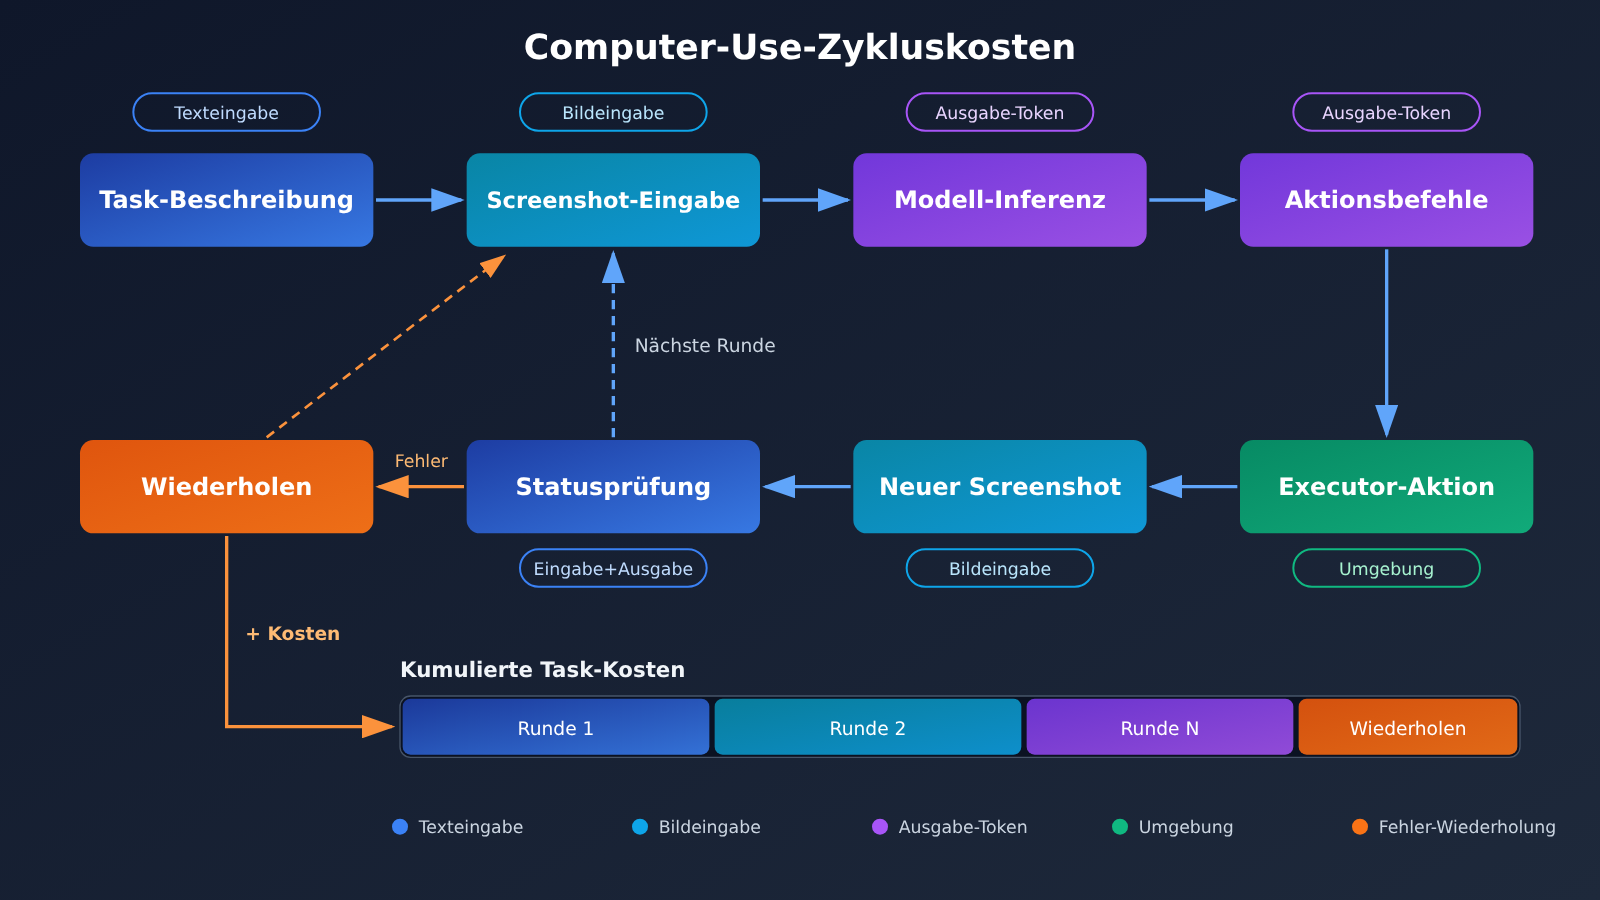
Der eigentliche Grund dafür liegt in der Art und Weise, wie Computer Use ausgeführt wird. Nach der OpenAI-Entwicklerdokumentation sieht ein typischer Zyklus so aus: Aufgabe entgegennehmen, Screenshot beobachten, Bedienanweisung erzeugen, die Anwendung führt den Klick oder die Eingabe aus, ein neuer Screenshot wird zurückgegeben, das Modell entscheidet über den nächsten Schritt – bis die Aufgabe erledigt ist oder eine Freigabe durch einen Menschen angefordert wird. Bei jedem Schritt können Aufgabenbeschreibung, bisheriger Kontext und der neue Screenshot erneut in das Modell eingegeben werden.
Eine gewöhnliche Frage-Antwort-Runde braucht möglicherweise nur einen einzigen Aufruf, während ein systemübergreifender Vorabgenehmigungsprozess durchaus mehr als ein Dutzend Runden aus „Beobachten, Handeln, Verifizieren“ durchlaufen kann. Screenshots sind Bild-Eingaben und verursachen separat Kosten für visuelle Tokens; da sie in jeder Runde anfallen, werden sie am häufigsten unterschätzt. Außerdem gilt: Wenn das Modell eine Bedienanweisung erzeugt hat, heißt das noch lange nicht, dass die Aktion erfolgreich war. Die Anwendung muss sie ausführen und das Ergebnis verifizieren – und auch die Verifikation selbst verbraucht Aufrufe.
Wofür genau wird das Geld bei einer medizinischen Agent-Aufgabe ausgegeben?
Zerlegt man eine Aufgabe, lassen sich die direkten Kosten in sechs Kategorien einordnen. Die laufende Wartung ist eine dauerhafte Investition und lässt sich klarer separat abrechnen.
| Kostenkategorie | Entstehungsgrund | Statistik-Hinweise |
|---|---|---|
| Eingabe-Token | System-Prompt, Aufgabenbeschreibung, historischer Kontext, Tool-Rückgaben | Kumulativ pro Runde, cachebare Anteile separat ausweisen |
| Ausgabe-Token | Operationsanweisungen, generierter Code, Entscheidungen und Reasoning | Hohe Reasoning-Intensität erhöht die Ausgabe deutlich |
| Visuelle Eingabe | Screenshots pro Runde und UI-Verständnis | Nach den Bild-Abrechnungsregeln des jeweiligen Modells separat erfassen |
| Tool-Aufrufe | Integrierte Tools, gehosteter Browser, Code-Ausführung | Von integrierten Tools verbrauchte Token werden nach dem jeweiligen Modell abgerechnet |
| Laufzeitumgebung | Browser, virtuelle Maschine, Container | Nur anrechnen, wenn der jeweilige Dienst tatsächlich genutzt wird |
| Fehlgeschlagene Wiederholungen | Seitenladefehler, fehlgeschlagene Lokalisierung, Bedienfehler | Wenn Retry-Token bereits in der Gesamtsumme enthalten sind, nicht doppelt addieren |
Die Abrechnung der Laufzeitumgebung unterscheidet sich stark. Auf der OpenAI-Preisseite sind für Hosted Shell und Code Interpreter folgende Container-Kosten aufgeführt: 1 GB kostet 0,03 US-Dollar pro 20 Minuten, 4 GB 0,12 US-Dollar, 16 GB 0,48 US-Dollar und 64 GB 1,92 US-Dollar. Speicher für hochgeladene Dateien und Bilder wird mit 0,10 US-Dollar pro GB und Tag berechnet. Läuft Playwright oder ein Desktop-Executor auf dem eigenen Server des Entwicklers, wird dieser Teil zu eigenen Infrastrukturkosten – die Struktur ist dann völlig anders.
Für die Kostenrechnung muss man daher drei Ebenen auseinanderhalten: Die Modellkosten sind die Gebühren für die Verarbeitung von Ein- und Ausgaben, die Laufzeitkosten sind Infrastrukturgebühren für Browser, Server, Container usw., und die Engineering-Kosten sind der Personalaufwand für Workflow-Design, Tests, Monitoring und Wartung. Wer nur die erste Ebene betrachtet, wird sein Budget garantiert zu niedrig ansetzen.
Warum manche medizinischen Agenten nicht jedes Mal ein großes Sprachmodell aufrufen sollten
CVS Health hat in einer Ankündigung Fälle aus dem Produktivbetrieb offengelegt. Ein Agent hat an einem Wochenende einen monatelangen Rückstau bei Dateiversand-Aufgaben abgearbeitet, ein anderer Agent verarbeitet täglich Zehntausende Systembedienschritte im Rahmen von Facharztkonsultationen. Die „Zehntausende“ beziehen sich dabei auf Bedienschritte, nicht auf klinische Entscheidungen, die die KI eigenständig trifft. Das System verfügt zugleich über Validierungsprüfungen, menschliche Aufsicht sowie eine Statusprüfung anhand von Screenshots und Aktionsprotokollen.
Für Entwickler interessanter ist das von CVS als Open Source veröffentlichte CUA Agent Kit (Apache-2.0-Lizenz). Es teilt die Automatisierung in zwei Phasen: Zunächst führt der OpenAI Computer Use Agent Aufgaben nach natürlicher Sprache aus und protokolliert Screenshots, Aktionen, Zielpositionen und Traces; anschließend erzeugt oder aktualisiert der Codex Skill auf Basis erfolgreicher Trajektorien deterministischen Workflow-Code, der von Ingenieuren geprüft wird. Laut README benötigt die deterministische Ausführungsphase keinen Modell-API-Schlüssel.
Dieses Design adressiert direkt das Kostenproblem: Beim Erkunden unbekannter Abläufe ist Inferenz durch ein großes Sprachmodell nötig, beim wiederholten Ausführen bekannter Abläufe übernimmt gewöhnlicher Code. Solange der Ablauf stabil ist, fallen pro Lauf keine Kosten mehr für visuelle Eingaben und Inferenz an, und auch die Ergebnisstreuung nimmt ab. Ein Kernpunkt des Projekts: „Herauszufinden, wie eine Aufgabe erledigt wird“ und „sie langfristig stabil zu wiederholen“ sind zwei verschiedene Probleme.
Auch das Verhältnis zwischen klassischer RPA und Agenten lässt sich aus dieser Perspektive verstehen. In einer RPA-Vergleichsstudie (DOI: 10.1080/23311975.2026.2724760) wurden die beiden Aufgaben P2 und P3 mit jeder Technologie je 10 Mal ausgeführt; der Agent für Aufgabe P1 lief nur ein einziges Mal und scheiterte, weshalb er nicht in die weitere Auswertung einfloss. Man kann also nicht pauschal sagen, „alle Aufgaben seien 10 Mal ausgeführt worden“. Die Studie nutzte die Werkzeugkonfiguration von 2025 und taugt nicht als direkte Leistungsbilanz für Modelle von 2026. Sie weist aber auf einen Punkt hin: Bei der Bewertung von Automatisierungslösungen sind die Stabilität bei wiederholter Ausführung und der Erfolg beim einzelnen Lauf gleichermaßen wichtig.
Analyse und Einschätzung: Wie man die Kostenrechnung für medizinische Agenten aufstellt
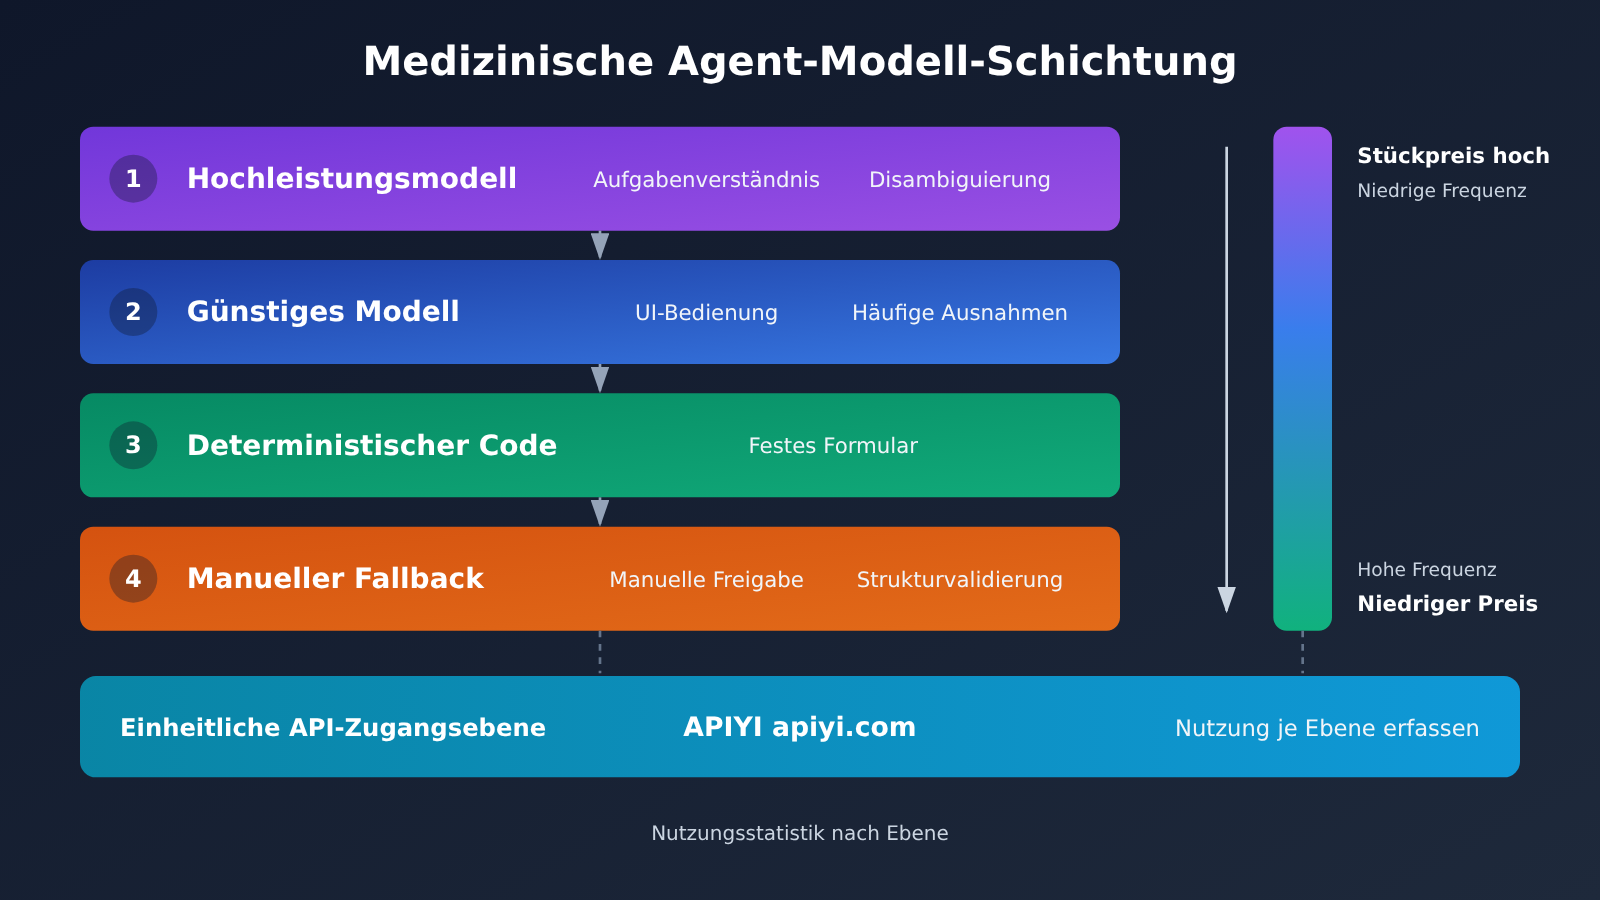
Wie teilen sich leistungsstarke und kostengünstige Modelle die Arbeit in einem medizinischen Agenten auf?
Die Benchmark-Daten zeigen: Lunas Anteil an den Bewertungspunkten liegt 2,5 Prozentpunkte unter dem von Astra, während die Kosten nur etwa 2 % der Kosten von Astra betragen. Das bedeutet, dass kostengünstige Modelle bei administrativen Aufgaben mit hohem Strukturierungsgrad bereits eine beachtliche Ausführungsfähigkeit besitzen. Doch ein Unterschied bei den Bewertungspunkten ist nicht gleichbedeutend mit einem Unterschied bei der End-to-End-Erfolgsrate. Wenn die fehlenden Punkte genau auf kritische Schritte wie Datei-Upload oder Statusaktualisierung entfallen, kann das Geschäftsergebnis völlig anders ausfallen. Das ist unsere Einschätzung; sie muss mit den eigenen Aufgabendaten überprüft werden.
Eine robustere Vorgehensweise ist die Zuweisung nach Phasen, statt für die gesamte Aufgabe nur ein Modell einzusetzen:
| Arbeitsphase | Empfohlene Zuständigkeit | Begründung |
|---|---|---|
| Komplexe Aufgaben verstehen und in Schritte zerlegen | Leistungsstarkes Modell | Hohe Fehlerkosten, wenige Aufrufe |
| Mehrdeutigkeiten und unklare Informationen in Krankenakten behandeln | Modell mit hoher Inferenzleistung + menschliche Bestätigung | Ambiences Ansatz stoppt bei Mehrdeutigkeit und fragt den Arzt |
| Routinemäßige Bedienung der Benutzeroberfläche | Kostengünstiges Modell | Viele Aufrufe, besonders empfindlich gegenüber dem Preis pro Aufruf |
| Wiederholtes Ausfüllen fester Formulare | Deterministischer Code | Angelehnt an den Ansatz der Code-Verfestigung im CUA Agent Kit |
| Behandlung häufiger Ausnahmen | Kostengünstiges Modell oder Regeln | Feste Muster, die schrittweise zu Regeln verdichtet werden können |
| Freigabe kritischer Vorgänge | Mensch | Bei Aktionen wie Einreichen, Senden und Unterzeichnen liegt die finale Entscheidungsgewalt beim Menschen |
| Verifizierung des Endergebnisses | Strukturierte Prüfung + manuelle Stichprobenkontrolle | Maßgeblich ist der Systemstatus, nicht die „erledigt“-Behauptung des Modells |
Der Nutzen dieser Schichtung liegt darin, dass Modelle mit hohem Preis pro Aufruf nur in seltenen, hochwertigen Schritten zum Einsatz kommen, während häufige Schritte von kostengünstigen Modellen oder Code übernommen werden. Wenn mehrere Modelle zum Einsatz kommen, senkt eine einheitliche Aufrufschnittstelle die Wechselkosten. Über ein OpenAI-kompatibles Gateway wie APIYI apiyi.com können Entwickler beispielsweise nur den Parameter model ändern, um verschiedene Modelle zu vergleichen. Welche Modelle konkret verfügbar sind, richtet sich nach der aktuellen Modellliste der Plattform und den Berechtigungen des jeweiligen Kontos.
Wie berechnen Entwickler das Budget für ihr eigenes medizinisches Agent-Projekt?
Empfohlen wird das folgende Kostenmodell pro Aufgabe. Dabei steht T für die tatsächliche Token-Anzahl und P für den Preis pro Million Token:
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (cachebarer Anteil separat zum Cache-Preis ausweisen)
C_output = T_output × P_output / 1,000,000
C_image  = nach den visuellen Abrechnungsregeln des Modells, Screenshots werden pro Runde einzeln gezählt
C_retry  = nur Retry-Kosten, die noch nicht in den obigen Token-Summen enthalten sind

Kosten einer erfolgreichen Aufgabe = Gesamtkosten aller Aufgaben ÷ Anzahl erfolgreicher Aufgaben
Monatsbudget = Kosten pro erfolgreicher Aufgabe × monatliches Ziel erfolgreicher Aufgaben + Aufwand für Engineering und Wartung
Was die Genauigkeit des Budgets wirklich bestimmt, sind diese gemessenen Kennzahlen: durchschnittliche Anzahl der Aufrufrunden pro Aufgabe, durchschnittliche Screenshot-Anzahl, Fehler-/Retry-Rate, Quote manueller Eingriffe und End-to-End-Erfolgsquote. Wenn man die „Kosten pro erfolgreicher Aufgabe“ statt der „Kosten pro Lauf“ als Nenner nimmt, fließt auch der Verbrauch durch fehlgeschlagene Versuche mit ein.
Die folgende Tabelle ist ein von uns selbst zusammengestelltes Budgetszenario. Alle Verbrauchswerte sind Annahmen und dienen nur der Demonstration der Rechenmethode. Als Stückpreise werden die offiziellen Standard-Preise aus dem vorigen Abschnitt verwendet:
| Szenario-Annahmen (selbst erstellt, nicht gemessen) | Kostengünstiges Modell (Luna-Preis) | Leistungsstarkes Modell (Astra-Preis) |
|---|---|---|
| 15 Runden pro Aufgabe, pro Runde 20.000 Token visuelle + textuelle Eingabe | 300.000 × $0.10/M = $0.030 | 300.000 × $10/M = $3.00 |
| 500 Token Ausgabe pro Runde | 7.500 × $0.50/M ≈ $0.004 | 7.500 × $50/M = $0.375 |
| Modellkosten pro Lauf | ca. $0.034 | ca. $3.38 |
| Kosten pro erfolgreicher Aufgabe bei angenommener End-to-End-Erfolgsquote von 80 % | ca. $0.042 | ca. $4.22 |
| Modellkosten bei 10.000 erfolgreichen Aufgaben pro Monat | ca. $420 | ca. $42.200 |
| Gehosteter Container (4 GB, 4 Aufgaben seriell alle 20 Minuten) | ca. $300/Monat | ca. $300/Monat |
Dieses Szenario macht ein leicht zu übersehendes Phänomen sichtbar: Ist das Modell günstig genug, können die Kosten für die Laufzeitumgebung in derselben Größenordnung wie die Modellkosten liegen – oder sogar darüber. Damit verschiebt sich die Optimierungsrichtung: weg von „ein günstigeres Modell nehmen“ hin zu „weniger Screenshot-Runden, Container wiederverwenden, feste Schritte durch Code ersetzen“. Das ist eine Schlussfolgerung aus der Szenariorechnung; die tatsächlichen Anteile richten sich nach Ihren gemessenen Daten.
Der direkteste Weg, echte Verbrauchswerte zu erfassen, ist, nach jedem Modellaufruf das Feld usage zu protokollieren. Hier ein minimales Beispiel:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # maßgeblich ist die Modellliste im APIYI-Backend
    messages=[{"role": "user", "content": "根据以下字段生成预授权申请核对清单:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
Vollständigen Implementierungscode für die kumulierten Kosten pro Aufgabe anzeigen
from dataclasses import dataclass, field
from openai import OpenAI

# 2026-11-17 offizielle Standard-Preise für kurzen Kontext (USD pro Million Token), maßgeblich ist die jeweilige Abrechnungsstufe
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # einheitlicher Zugang, im Backend lassen sich Token- und Kostenprotokolle abgleichen
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # Die Token der Wiederholungsrunden sind bereits in record aufsummiert und werden hier nicht erneut addiert
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 Budget-Tipp: Wählen Sie zunächst 20 bis 50 echte Aufgabenbeispiele für einen kleinen Testlauf aus und führen Sie danach die Monatskalkulation durch. Wenn Sie über APIYI apiyi.com einheitlich anbinden, können Sie Ihre eigene Messung mit dem Token-Verbrauch und den Kostenprotokollen im Backend abgleichen – das kostenlose Testkontingent für neue Nutzer reicht für diesen Schritt aus.
Von Modellpreisen zu API-Kostenmanagement: Was ein Gateway für medizinische Agenten leisten kann
Wenn ein Agent-Projekt in die Multi-Modell-Phase eintritt, geraten die Kosten oft nicht wegen hoher Stückpreise außer Kontrolle, sondern weil niemand genau sagen kann, welcher Schritt und welches Modell wie viel verbraucht hat. Der Wert eines API Gateways liegt darin, verstreute Aufrufe an einer Stelle zu bündeln: einheitliche Keys und Endpoints, nach Modellen aufgeschlüsselte Nutzungsprotokolle und nachvollziehbare Kostenaufstellungen. Erst auf dieser Basis kann das Team erkennen, dass ein bestimmter Schritt zu viele Screenshots erzeugt oder dass eine bestimmte Art von Fehlern immer wieder Retries auslöst.
Am Beispiel von APIYI: Laut der Schnellstart-Dokumentation besteht der Anschluss darin, ein Konto zu registrieren, auf der Token-Seite den API-Schlüssel zu holen und anschließend den ursprünglichen OpenAI-Endpoint durch https://api.apiyi.com zu ersetzen; bei manchen Anwendungen muss /v1 an die Adresse angehängt werden. Die offiziellen SDKs und Codebeispiele lassen sich direkt nutzen, im Backend sind Modelle, Token-Verbrauch und Kostenprotokolle einsehbar; laut Seite entsprechen die Tarife für OpenAI und Claude den offiziellen Preisen, und Rechnungsstellung wird unterstützt. Für Teams, die mehrere Modelle in Schichten und Vergleichen einsetzen wollen, bietet APIYI unter apiyi.com eine Zugriffsebene mit nutzungsbasierter Abrechnung und einheitlicher Messung.
Auch die Grenzen sollten klar benannt sein. Ein API-Gateway löst den Zugang zu Modellaufrufen und deren Messung, nicht die Rolle des Agent-Ausführers: Browser- und Desktop-Umgebungen, Screenshot-Erfassung, geschäftliche Berechtigungssteuerung, manuelle Freigabeprozesse und die Pflege der Workflows muss der Entwickler weiterhin selbst bauen. Im medizinischen Kontext hängt HIPAA-Konformität außerdem von der Produktqualifikation, einem BAA, der Sicherheitskonfiguration und der Data Governance ab – sie stellt sich nicht automatisch ein, nur weil man den Zugangsweg wechselt. Ob sich ein bestimmtes GPT-6-Modell aufrufen lässt, richtet sich ebenfalls nach der aktuellen Modellliste der Plattform.
Zurück zu den 8,5 Cent: Sie belegen das Potenzial kostengünstiger Modelle in der hochfrequenten administrativen Automatisierung, beantworten aber nicht, was Ihr eigener Workflow kosten wird. Die Antwort kann nur aus den eigenen Aufgabenbeispielen, der eigenen Erfolgsquote und den eigenen Nutzungsprotokollen kommen. Wie das englische Sprichwort sagt:
The proof of the pudding is in the eating.
(Ob der Pudding gut ist, zeigt sich beim Essen; den tatsächlichen Nutzen muss die Praxis erweisen.)
Referenzen
- OpenAI-Ankündigung zum Computer Use Agent im Gesundheitswesen: Originalquelle für die HealthAdminBench-Ergebnisse und die Kosten pro Aufgabe
- Link:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Link:
- OpenAI API-Preisseite: Token-Preise für GPT-6 Astra und GPT-6 Luna sowie Containergebühren
- Link:
developers.openai.com/api/docs/pricing
- Link:
- OpenAI Computer Use-Entwicklerdokumentation: Ausführungsschleife, Computer Tool und Code Execution als zwei Wege
- Link:
developers.openai.com/api/docs/guides/tools-computer-use
- Link:
- HealthAdminBench-Paper v1: exakte Version mit 135 Aufgaben und 1698 Teilaufgaben
- Link:
arxiv.org/html/2604.09937v1
- Link:
- CVS Health CUA Agent Kit: Open-Source-Implementierung für KI-Exploration und Code-Fixierung
- Link:
github.com/cvs-health/cua-agent-kit
- Link:
- Vergleichsstudie zu RPA: Design mit wiederholten Durchläufen und Hinweise zu Ausnahmen
- Link:
doi.org/10.1080/23311975.2026.2724760
- Link:
- Überprüfung der Sprichwortbedeutung: Cambridge Dictionary
- Link:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Link:
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI apiyi.com; weitere Integrationshinweise finden Sie im Dokumentationszentrum unter docs.apiyi.com


