
نعم، في ظروف محددة، لكن لا يمكن نقل هذا الرقم كما هو إلى بيئة الإنتاج. في 16 نوفمبر 2026، كشفت OpenAI أن تكلفة المهمة الواحدة للنموذج GPT-6 Luna في معيار HealthAdminBench الإداري الطبي بلغت 0.085 دولار، أي أقل بنسبة 98% من GPT-6 Astra. هذا الرقم مأخوذ من اختبار معياري، وليس عرض سعر لنشر فعلي في مستشفى.
ولا يمكن أيضًا حساب تكلفة الوكيل ببساطة انطلاقًا من سعر المليون رمز (Token). فمهمة Computer Use الواحدة تتضمن عدة جولات من استدعاء النموذج، وإدخال لقطات الشاشة، وتنفيذ الأدوات، وإعادة المحاولة بعد الفشل، وبيئة التشغيل؛ وما يحتاج حقًا إلى حسابه هو التكلفة الكاملة للمهمة. وبالنسبة للمطورين، فإن التقسيم المعقول للنماذج، والتخزين المؤقت، وتثبيت سير العمل، ومراقبة التكاليف، أهم من اختيار النموذج صاحب أقل سعر للوحدة.
ماذا ستتعرف عن تكاليف الوكيل الطبي بعد قراءة هذا المقال؟
- تحت أي ظروف اختبار جرى التوصل إلى 8.5 سنت، وما القيم التي أعلنتها الجهات الرسمية وما القيم التقديرية المستنتجة عكسيًا
- مِمَّ تتكوّن تكلفة المهمة الكاملة لوكيل طبي، وكيف تؤدي لقطات الشاشة والاستدعاءات متعددة الجولات وإعادة المحاولات إلى رفع الفاتورة
- كيف يتم تقسيم النماذج إلى طبقات، وكيف تستخدم صيغة حسابية وحجم المهام الشهري لتقدير ميزانية مشروع الوكيل الخاص بك
فهرس المقال: من أين نبدأ قراءة حساب تكاليف الوكيل الطبي
يعرض الجزء المخصص للوقائع الموضوعية أولاً المعيار الذي يقابله 8.5 سنت ومنهجية التقييم المستخدمة، ثم يوضح لماذا لا يمكن لسعر وحدة الـ Token أن يمثّل تكلفة المهمة. بعد ذلك نفكّك المصادر الستة للتكلفة في مهمة وكيل واحدة، ونستخدم CUA Agent Kit مفتوح المصدر من CVS Health لنوضح لماذا لا يحتاج سير العمل الثابت إلى استدعاء نموذج لغة كبير في كل مرة. أما الجزء التحليلي فيناقش توزيع الأدوار بين النماذج عالية القدرة والنماذج منخفضة التكلفة، ويقدّم صيغة ميزانية قابلة للتطبيق المباشر وسيناريوهات تقديرية، ثم يختتم بتوضيح ما يمكن أن تحلّه إدارة الاستخدام على مستوى API وما لا يمكنها حلّه.
معرفة أساسية: مفاهيم التكلفة المرتبطة بوكلاء المهام الطبية
| المفهوم | شرح موجز |
|---|---|
| Computer Use | القدرة على إنجاز المهام عبر ملاحظة واجهة البرنامج وتنفيذ النقر والكتابة وغيرها من العمليات |
| EHR | نظام السجلات الصحية الإلكترونية، أي نظام السجل الطبي الإلكتروني المستخدم في المستشفيات |
| MCP | بروتوكول معياري لاكتشاف الأدوات الخارجية واستدعائها |
| RPA | أسلوب أتمتة ينفّذ العمليات المتكررة وفق قواعد أو نصوص برمجية مُعدّة مسبقًا |
| Rubric points | نقاط التقييم الممنوحة وفق قواعد التقييم، وتقيس مدى تحقّق جزء من المتطلبات |
| معدل النجاح من البداية إلى النهاية | نسبة المهام الكاملة التي تستوفي جميع شروط النجاح، وهو معيار أصرم من نسبة نقاط التقييم |
| Trace | سجل التتبع، أي دليل المسار الذي يوثّق عملية التنفيذ وأفعال التشغيل وحالة الواجهة |
| Maximum Reasoning Effort | أعلى مستوى لكثافة الاستدلال في النموذج، وعادةً يستهلك رموز استدلال أكثر |
| المدخلات المخزّنة مؤقتًا | آلية تُحاسَب فيها البادئة المتكررة من المدخلات بسعر وحدة أقل |
نظرة سريعة على التأثير: ماذا تعني تكلفة الوكيل الطبي لكل طرف
- المطوّرون ومسؤولو التقنية: لا يمكن الاعتماد على أرقام المعايير الرسمية مباشرةً لإعداد الميزانية. بل يجب التحقق من آلية التنفيذ ومعدل الإنجاز من البداية إلى النهاية والتكلفة الكاملة بحسب مهامك الخاصة، مع إدخال حجم لقطات الشاشة وعدد دورات الاستدعاء ومعدل إعادة المحاولة في الإحصاء.
- المؤسسات الصحية ومسؤولو سير العمل: يجب التمييز بين العروض التوضيحية الاصطناعية وتقييمات المورّدين وحالات التجارب والإنتاج. فانخفاض تكلفة المهمة الواحدة لا يعوّض عن الموافقة البشرية والحد الأدنى من الصلاحيات وسجلات التدقيق، فهذه الإجراءات الحوكمية نفسها تترتّب عليها تكلفة.
حقيقة موضوعية: البيانات التي تقف خلف تكلفة 8.5 سنتًا لمهمة وكيل طبي
ما المهام الطبية التي يمكن إنجازها بـ 8.5 سنت؟
رقم 8.5 سنت مأخوذ من إعلان OpenAI عن وكيل Computer Use الطبي، المنشور في 16 نوفمبر 2026. استخدمت OpenAI معيار HealthAdminBench الذي اقترحه مختبر Shah في جامعة ستانفورد لتقييم نموذجين، وكلاهما بأعلى كثافة استدلال. يقيس هذا المعيار — داخل بيئة محاكاة لنظام السجلات الصحية الإلكترونية EHR وبوابات دفع شركات التأمين وأنظمة الفاكس — مهام إدارية مثل التحقق من أهلية التأمين، وتقديم طلبات التصريح المسبق، وطلب الأجهزة الطبية، ومعالجة المستندات بين الأنظمة المختلفة.
| البند | GPT-6 Luna | GPT-6 Astra | طبيعة البيانات |
|---|---|---|---|
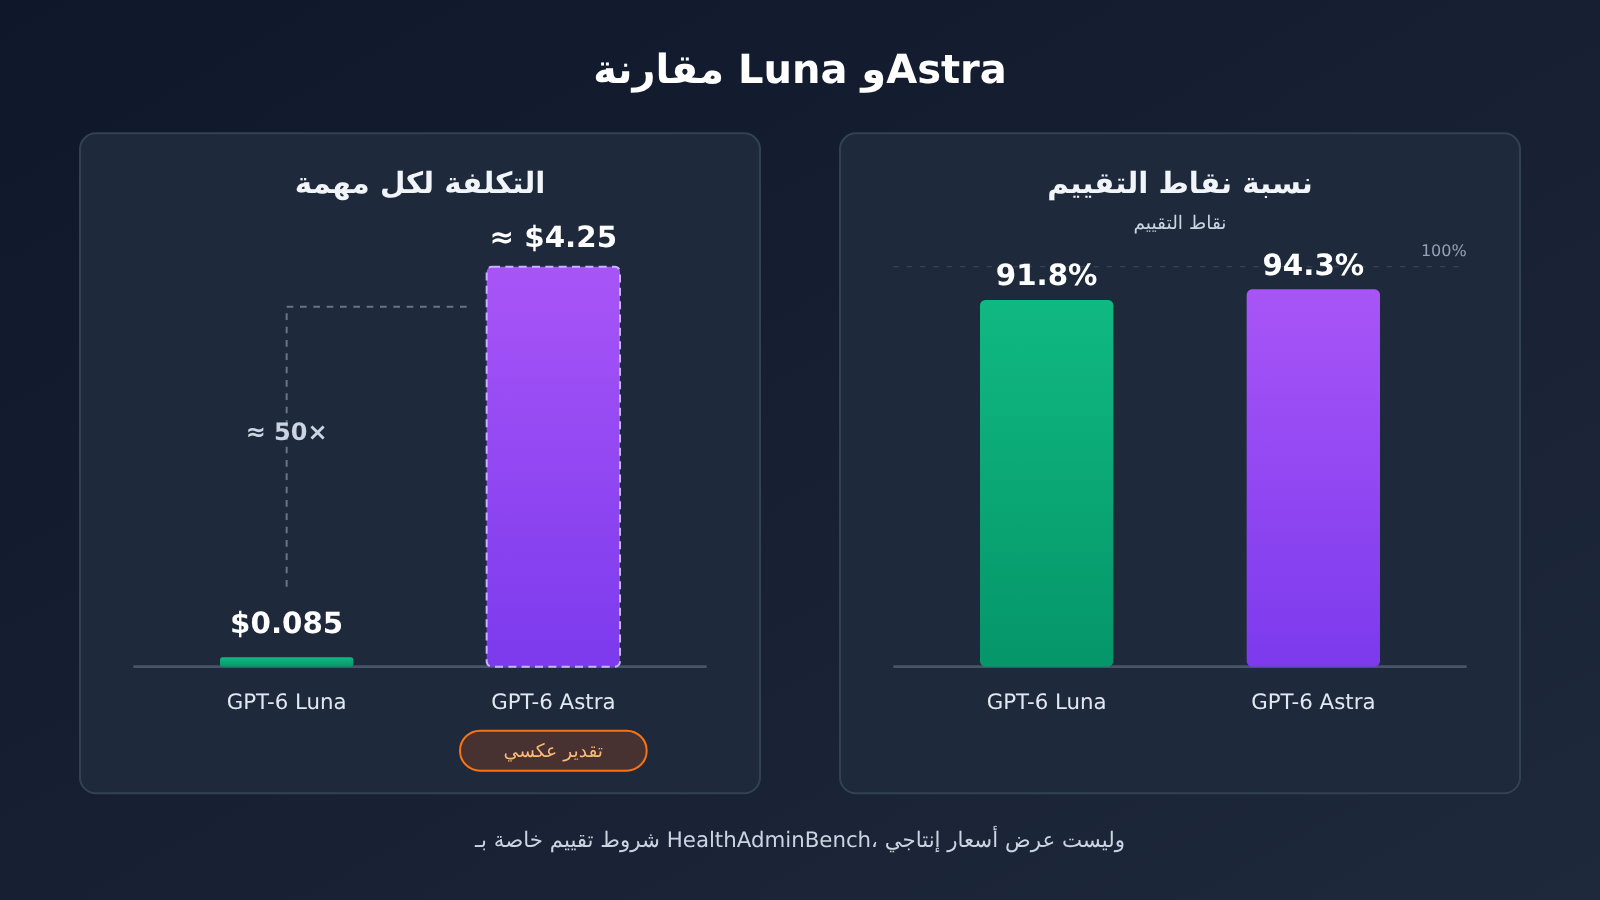
| نتيجة HealthAdminBench | 91.8% | 94.3% | معلنة رسميًا، وتمثل نسبة نقاط التقييم (rubric points) |
| تكلفة المهمة الواحدة | $0.085 | نحو $4.25 | Luna معلنة رسميًا، أما Astra فمستنتجة من نسبة تخفيض 98% |
| تكلفة 1,000 مهمة | $85 | نحو $4,250 | تحويل خطي وفق أساس المعيار، وليس عرض سعر إنتاجي |
| سعر الإدخال (لكل مليون Token) | $0.10 | $10.00 | السعر الرسمي Standard للسياق القصير، استُعلم عنه بتاريخ 2026-11-17 |
| سعر الإخراج (لكل مليون Token) | $0.50 | $50.00 | كما سبق |
| الإدخال المخزّن مؤقتًا (لكل مليون Token) | $0.01 | $1.00 | كما سبق |
رقم Astra البالغ نحو 4.25 دولار ناتج عن حساب 0.085 ÷ (1 − 0.98)، وهو قيمة تقريبية وليست سعرًا أعلنته OpenAI بشكل منفصل. كذلك فإن 94.3% و91.8% ليستا نسبة نجاح كاملة للمهام. فهما تقيسان نسبة نقاط التقييم المتاحة التي حصل عليها النموذج، ولا يجوز كتابتهما على أنهما تعنيان أن “94.3% من الأعمال الإدارية في المستشفيات أصبحت مؤتمتة بالكامل”.
ولمعيار HealthAdminBench عدة إصدارات منشورة، ولا بد من التمييز بينها. نسخة الورقة البحثية 2604.09937v1 تضم 135 مهمة و1698 مهمة فرعية، منها 1177 يحكم عليها بقواعد حتمية و521 يقيّمها نموذج محكّم. نسبة نجاح المهام الكاملة البالغة 36.3% في الورقة تخص Claude Opus 4.6 CUA، ونسبة نجاح المهام الفرعية البالغة 82.8% تخص GPT-5.4 CUA. أما الوصف الأقدم على موقع مختبر Shah فيشير إلى نسخة بـ 70 مهمة و947 نقطة تقييم، ولا يصلح إلا كمقارنة تاريخية. ونتائج نماذج وتواريخ وظروف تنفيذ ومؤشرات مختلفة لا يمكن جمعها في لوحة ترتيب واحدة.
لماذا لا يمكن تقييم مهام الوكيل الطبي بسعر الرمز (Token) وحده؟
بالنظر إلى جدول الأسعار، نجد أن سعر الوحدة للمدخلات والمخرجات والمدخلات المخزّنة مؤقتًا (cached input) يختلف بين النموذجين بمعامل 100 مرة. وعند حساب انخفاض بنسبة 98%، يصبح الفارق في تكلفة المهمة الواحدة بينهما نحو 50 مرة فقط. ومن هذا نستنتج أن الاستهلاك الفعلي للنموذجين داخل الاختبار المرجعي نفسه ليس متساويًا. فعدد جولات الاستدعاء، وعدد رموز المدخلات والمخرجات، واستهلاك الاستدلال، وعدد مرات إعادة المحاولة، كلها قد تختلف؛ لذلك لا يمكن حساب تكلفة المهمة الواحدة إلا بناءً على الاستخدام الحقيقي.
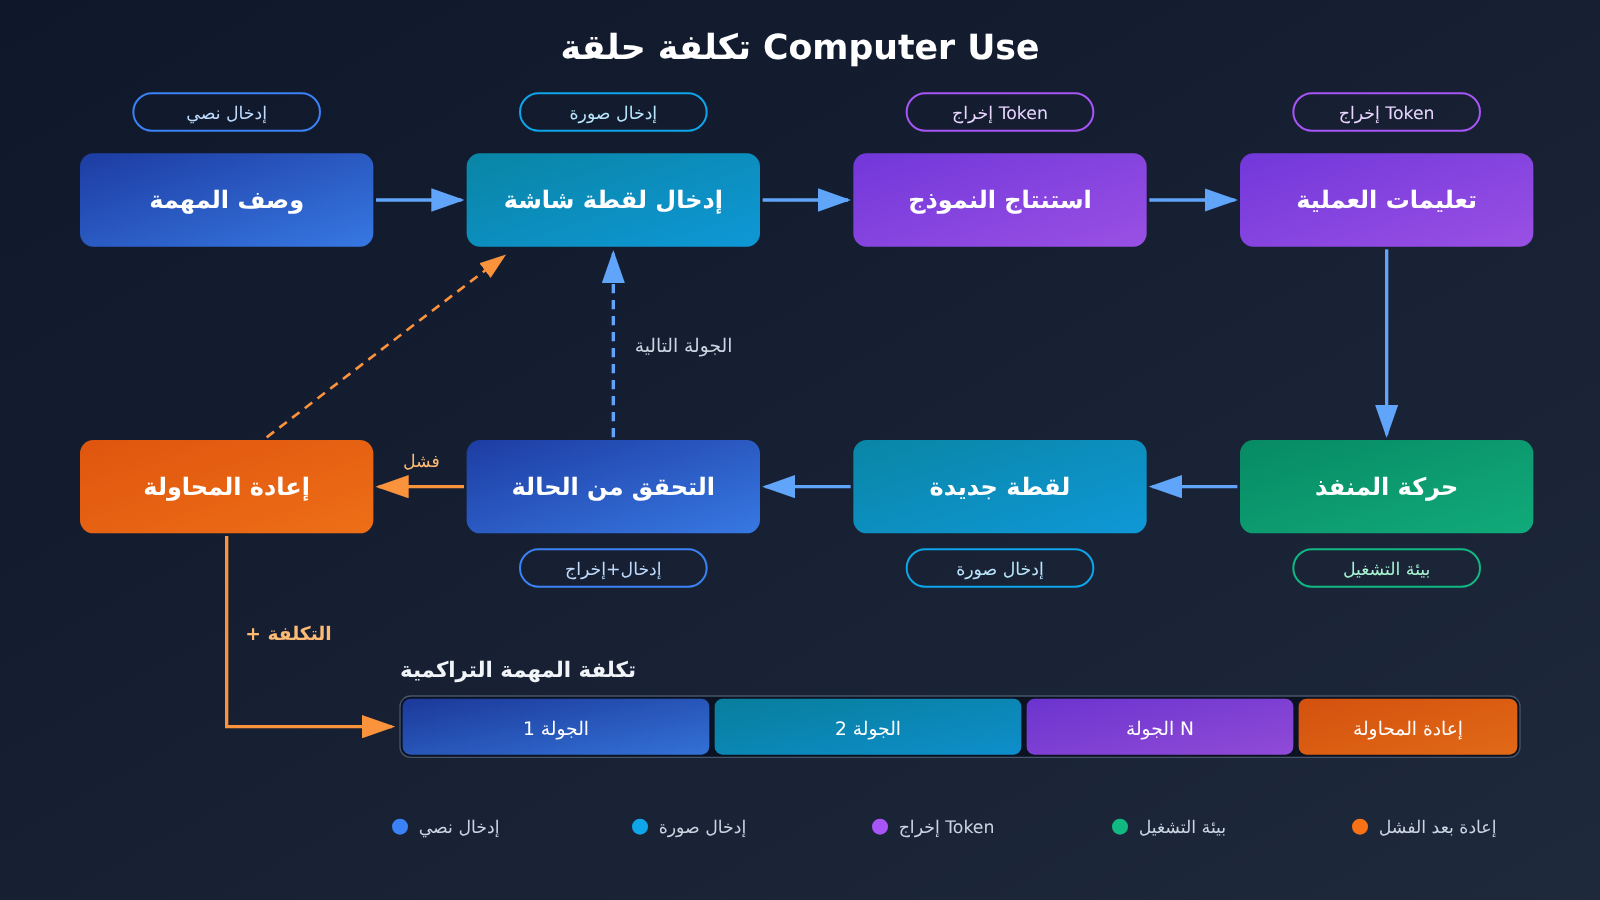
السبب الجذري يعود إلى طريقة تنفيذ Computer Use. فوفقًا لوثائق مطوّري OpenAI، تبدو الحلقة النموذجية هكذا: يستقبل النموذج المهمة، ثم يلاحظ لقطة الشاشة، فيولّد تعليمات تنفيذ، فتنفّذ التطبيقات النقر أو الكتابة، ثم تُعاد لقطة شاشة جديدة، ليقيّم النموذج الخطوة التالية، وهكذا حتى تكتمل المهمة أو يُطلب تدخّل بشري للموافقة. ومع كل خطوة، قد يُعاد إدخال وصف المهمة والسياق التاريخي ولقطة الشاشة الجديدة إلى النموذج من جديد.
السؤال والجواب العادي قد يحتاج إلى استدعاء واحد فقط، أما سير العمل الذي يمتد عبر أنظمة متعددة ويحتاج إلى تفويض مسبق، فقد يمرّ بعشرات الجولات المتتالية من “الملاحظة، ثم التنفيذ، ثم التحقق”. ولقطات الشاشة تُعدّ مدخلات صور، وتُحتسب لها رسوم رموز بصرية بشكل منفصل، وهي تظهر في كل جولة، ولهذا فهي الأكثر عرضة للاستهلاك المقلّل في التقدير. ومن الضروري أيضًا الانتباه إلى أن النموذج عندما يولّد تعليمات تنفيذ فهذا لا يعني أن العملية قد نجحت؛ إذ يجب على التطبيق أن ينفّذها ويتحقق من نتيجتها، والتحقق نفسه يستهلك استدعاءات إضافية.
أين تذهب تكلفة مهمة وكيل طبي واحدة فعلاً؟
إذا فكّكنا المهمة الواحدة، يمكن تصنيفها ضمن ست فئات من التكاليف المباشرة. أما الصيانة الهندسية فهي استثمار مستمر، وحسابها بشكل منفصل أوضح.
| فئة التكلفة | سبب التكوّن | نقاط الاحتساب |
|---|---|---|
| رموز الإدخال | موجه النظام، وتعليمات المهمة، والسياق التاريخي، وما تعيده الأدوات | تُجمع حسب الجولات، مع تمييز الجزء القابل للتخزين المؤقت |
| رموز الإخراج | التعليمات التشغيلية، والكود المولّد، والقرارات والاستدلال | ارتفاع مستوى الاستدلال يزيد الإخراج بشكل ملحوظ |
| المدخلات البصرية | لقطات الشاشة في كل جولة وفهم الواجهة | تُحتسب على حدة وفق قواعد تسعير الصور الخاصة بكل نموذج |
| استدعاءات الأدوات | الأدوات المدمجة، والمتصفح المستضاف، وتنفيذ الكود | الرموز التي تستهلكها الأدوات المدمجة تُحتسب وفق النموذج المقابل |
| بيئة التشغيل | المتصفح، والآلة الافتراضية، والحاوية | تُحتسب فقط عند الاستخدام الفعلي للخدمة المقابلة |
| إعادة المحاولة عند الفشل | أخطاء تحميل الصفحة، وفشل تحديد العنصر، وأخطاء العمليات | إذا كانت رموز إعادة المحاولة محسوبة ضمن الإجمالي، فلا تُضفها مرة أخرى |
تختلف فاتورة بيئة التشغيل اختلافًا كبيرًا. فصفحة تسعير OpenAI تذكر رسوم حاويات Hosted Shell وCode Interpreter على النحو التالي: 1 GB لكل 20 دقيقة مقابل 0.03 دولار، و4 GB مقابل 0.12 دولار، و16 GB مقابل 0.48 دولار، و64 GB مقابل 1.92 دولار. وتُحتسب تكلفة تخزين الملفات والصور المرفوعة بواقع 0.10 دولار لكل غيغابايت في اليوم. وإذا كان المطوّر يشغّل Playwright أو منفّذ سطح المكتب على خوادمه الخاصة، فإن هذا الجزء يتحول إلى تكلفة بنية تحتية خاصة به، وببنية مختلفة تمامًا.
لذلك، عند الحساب يجب التمييز بين ثلاثة مستويات: تكلفة النموذج هي تكلفة معالجة المدخلات والمخرجات، وتكلفة التشغيل هي تكاليف البنية التحتية مثل المتصفح والخوادم والحاويات، وتكلفة الهندسة هي الجهد البشري المبذول في تصميم سير العمل والاختبار والمراقبة والصيانة. وإذا نظرت إلى المستوى الأول فقط، فستكون الميزانية منخفضة بالتأكيد.
لماذا لا ينبغي لبعض وكلاء الذكاء الاصطناعي الطبيين استدعاء نموذج لغة كبير في كل مرة؟
كشفت CVS Health في إعلانها عن حالات من بيئة الإنتاج. تمكن أحد الوكلاء خلال عطلة نهاية أسبوع من إنهاء تراكم مهام إرسال الملفات الذي استمر لعدة أشهر، ويتعامل وكيل آخر يوميًا مع عشرات الآلاف من خطوات العمليات النظامية في الاستشارات الطبية التخصصية. تشير “عشرات الآلاف” هنا إلى خطوات العمليات، وليس إلى قرارات سريرية يتخذها الذكاء الاصطناعي بشكل مستقل. ويرافق النظام فحوصات تحقق وإشراف بشري وفحص للحالة يعتمد على لقطات الشاشة وسجلات العمليات.
ما يستحق اهتمام المطورين أكثر هو CUA Agent Kit مفتوح المصدر من CVS (رخصة Apache-2.0). فهو يقسم الأتمتة إلى مرحلتين: أولاً ينفذ OpenAI Computer Use Agent المهام وفق اللغة الطبيعية، ويسجل لقطات الشاشة والإجراءات ومواقع الهدف وTrace؛ ثم يقوم Codex Skill، بناءً على المسارات الناجحة، بتوليد أو تحديث شيفرة سير عمل حتمية تتم مراجعتها من قبل المهندسين. يوضح README أن مرحلة التشغيل الحتمية لا تحتاج إلى مفتاح API للنموذج.
يعالج هذا التصميم مشكلة التكلفة مباشرة: استكشاف العمليات غير المعروفة يتطلب استدلال نموذج لغة كبير، بينما يُوكَل التنفيذ المتكرر للعمليات المعروفة إلى شيفرة عادية. وطالما ظل سير العمل مستقرًا، فإن التشغيل الواحد لا يدفع بعد ذلك تكاليف الإدخال البصري والاستدلال، كما تقل تذبذبات النتائج. وتؤكد فكرة أساسية في المشروع أن “اكتشاف كيفية إنجاز المهمة” و”تكرار تنفيذها باستقرار على المدى الطويل” مسألتان مختلفتان.
يمكن فهم العلاقة بين RPA التقليدي والوكيل من هذه الزاوية أيضًا. في دراسة مقارنة حول RPA (DOI: 10.1080/23311975.2026.2724760)، شُغّلت مهمتا P2 وP3 عشر مرات لكل تقنية، بينما شُغّل وكيل مهمة P1 مرة واحدة فقط وفشل، ولم يُدرَج في الإحصاءات اللاحقة؛ لذلك لا يمكن القول بشكل عام إن “كل المهام نُفذت 10 مرات”. استخدمت الدراسة أدوات بإعدادات عام 2025، ولا يمكن اعتبارها نتيجة مباشرة لنماذج عام 2026. لكنها تشير إلى نقطة مهمة: عند تقييم حل أتمتة، فإن استقرار التشغيل المتكرر لا يقل أهمية عن النجاح في مرة واحدة.
التحليل والحكم: كيف نحسب تكلفة الوكيل الطبي؟
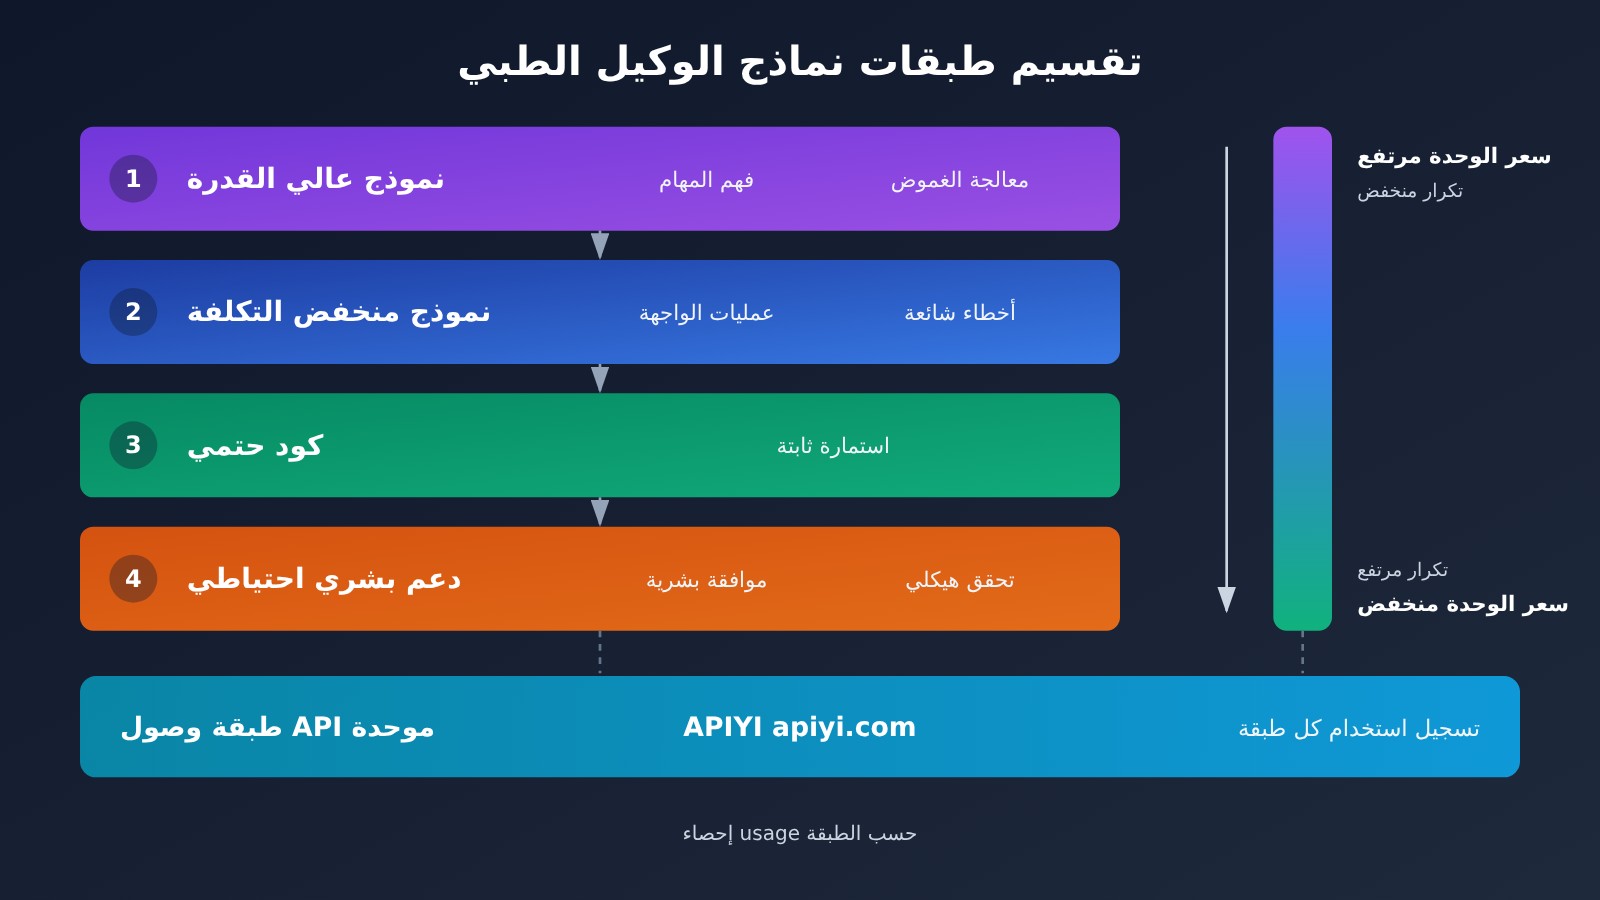
كيف نتقاسم العمل بين نموذج عالي القدرة ونموذج منخفض التكلفة داخل الوكيل الطبي؟
تُظهر بيانات المعايير أن نسبة نقاط التقييم لدى Luna أقل بـ2.5 نقطة مئوية من Astra، بينما لا تتجاوز تكلفتها نحو 2% من تكلفة Astra. وهذا يعني أن النماذج منخفضة التكلفة أصبحت قادرة فعليًا على تنفيذ مهام إدارية ذات درجة عالية من التنظيم. لكن الفجوة في نقاط التقييم لا تعني بالضرورة فجوة في معدل النجاح من البداية إلى النهاية؛ فإذا وقعت النقاط الناقصة تحديدًا عند خطوات حساسة مثل رفع الملفات أو تحديث الحالة، فقد تختلف النتيجة التجارية تمامًا. هذا حكمنا، ويحتاج إلى تحقق باستخدام بيانات مهامنا الخاصة.
النهج الأكثر أمانًا هو التوزيع حسب المرحلة، لا استخدام نموذج واحد للمهمة بأكملها:
| مرحلة العمل | المنفّذ المقترح | السبب |
|---|---|---|
| فهم المهام المعقدة وتفكيك الخطوات | نموذج عالي القدرة | تكلفة الخطأ مرتفعة، وعدد الاستدعاءات قليل |
| التعامل مع غموض السجلات الطبية والمعلومات غير الواضحة | نموذج عالي الاستدلال + تأكيد بشري | حل Ambience يتوقف ويسأل الطبيب عند وجود غموض |
| عمليات الواجهة الروتينية | نموذج منخفض التكلفة | عدد الاستدعاءات كبير، والأكثر حساسية لسعر الوحدة |
| ملء النماذج الثابتة المتكررة | شفرة حتمية | بالاستناد إلى فكرة تثبيت الشفرة في CUA Agent Kit |
| معالجة الاستثناءات الشائعة | نموذج منخفض التكلفة أو قواعد | الأنماط ثابتة، ويمكن ترسيخها تدريجيًا كقواعد |
| اعتماد العمليات الحساسة | بشري | الإرسال والرفع والتوقيع وغيرها تحتفظ بإذن بشري نهائي |
| التحقق من النتيجة النهائية | فحص منظم + مراجعة بشرية بالعينة | المرجع هو حالة النظام، لا إعلان النموذج بأنه “أنجز” |
ميزة هذا التوزيع الطبقي أن النماذج ذات سعر الوحدة المرتفع لا تظهر إلا في المراحل منخفضة التكرار وعالية القيمة، بينما تُسلّم المراحل عالية التكرار إلى نماذج منخفضة التكلفة أو إلى الشفرة. وعند تعدد النماذج، تساعد واجهة الاستدعاء الموحدة على تقليل تكلفة التبديل. فمثلًا عبر بوابة متوافقة مع OpenAI مثل APIYI apiyi.com، يستطيع المطورون مقارنة نماذج مختلفة بمجرد تغيير معامل model. أما النماذج المتاحة فعليًا فتحددها قائمة النماذج الحالية على المنصة وصلاحيات الحساب.
كيف يحسب المطورون ميزانية مشروع Agent طبي؟
نقترح استخدام إطار تكلفة المهمة الواحدة التالي. حيث T هو عدد الـ Token الفعلي، وP هو السعر لكل مليون Token:
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (تُحسب الأجزاء القابلة للتخزين المؤقت بشكل منفصل بسعر التخزين المؤقت)
C_output = T_output × P_output / 1,000,000
C_image  = وفق قواعد فوترة الرؤية لدى النموذج، تُحتسب لقطات الشاشة لكل جولة على حدة
C_retry  = تُحتسب فقط تكاليف إعادة المحاولة التي لم تُدمج بعد في إجمالي الـ Token أعلاه

تكلفة المهمة الناجحة الواحدة = إجمالي تكلفة جميع المهام ÷ عدد المهام الناجحة
الميزانية الشهرية = تكلفة المهمة الناجحة الواحدة × هدف المهام الناجحة الشهري + الاستثمار في الصيانة الهندسية
ما يحدد دقة الميزانية فعلاً هو هذه المؤشرات المقاسة: متوسط عدد جولات الاستدعاء لكل مهمة، ومتوسط عدد لقطات الشاشة، ومعدل إعادة المحاولة بعد الفشل، ومعدل التدخل البشري، ومعدل النجاح من البداية إلى النهاية. واستخدام «تكلفة المهمة الناجحة الواحدة» بدلاً من «تكلفة التشغيل الواحد» كمقام يسمح باحتساب الاستهلاك الناتج عن المحاولات الفاشلة.
يلخص الجدول التالي سيناريو ميزانية أنشأناه بأنفسنا، وجميع الاستخدامات افتراضية ولا تُستخدم إلا لعرض طريقة الحساب. وتستخدم أسعار الوحدة السعر الرسمي لفئة Standard المذكور سابقًا:
| افتراضات السيناريو (مُعدّة داخليًا، غير مقاسة فعليًا) | نموذج منخفض التكلفة (سعر Luna) | نموذج عالي القدرة (سعر Astra) |
|---|---|---|
| 15 جولة لكل مهمة، ومدخلات الرؤية + النص 20,000 Token في كل جولة | 300,000 × $0.10/M = $0.030 | 300,000 × $10/M = $3.00 |
| إخراج 500 Token في كل جولة | 7,500 × $0.50/M ≈ $0.004 | 7,500 × $50/M = $0.375 |
| تكلفة النموذج للتشغيل الواحد | حوالي $0.034 | حوالي $3.38 |
| تكلفة المهمة الناجحة الواحدة بعد افتراض معدل نجاح من البداية إلى النهاية 80% | حوالي $0.042 | حوالي $4.22 |
| تكلفة النموذج عند 10,000 مهمة ناجحة شهريًا | حوالي $420 | حوالي $42,200 |
| حاوية مستضافة (4 GB، 4 مهام متسلسلة كل 20 دقيقة) | حوالي $300/شهر | حوالي $300/شهر |
يكشف هذا السيناريو عن ظاهرة يسهل تجاهلها: عندما يصبح النموذج رخيصًا بما يكفي، فقد تكون تكلفة بيئة التشغيل في نفس رتبة تكلفة النموذج أو حتى أعلى. وبالتالي يتغير اتجاه التحسين، من «استبدال النموذج بنموذج أرخص» إلى «تقليل جولات لقطات الشاشة، وإعادة استخدام الحاويات، وتحويل الخطوات الثابتة إلى كود». هذا حكم مستخلص من سيناريو افتراضي، ويجب أن تعتمد النسب الفعلية على بيانات القياس الفعلية لديك.
الطريقة الأكثر مباشرة لجمع الاستخدام الفعلي هي تسجيل حقل usage بعد كل استدعاء للنموذج. فيما يلي أبسط مثال:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # وفقًا لقائمة النماذج في لوحة تحكم APIYI
    messages=[{"role": "user", "content": "根据以下字段生成预授权申请核对清单:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
عرض الكود الكامل لحساب التكلفة التراكمية لكل مهمة
from dataclasses import dataclass, field
from openai import OpenAI

# أسعار الواجهة الرسمية Standard للسياق القصير بتاريخ 2026-11-17 (دولار/مليون توكن)، والمرجع الفعلي هو فئة الفوترة المقابلة
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # وصول موحّد، ويمكن مقارنة سجلات التوكن والتكلفة من لوحة التحكم
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # توكنات دورات الإعادة تم تجميعها بالفعل داخل record، لذلك لا نضيفها مرة أخرى هنا
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 توصية للميزانية: ابدأ باختيار 20 إلى 50 عينة مهمة حقيقية لإجراء تجربة تشغيل صغيرة الحجم، ثم قم بالحساب الشهري. عند الوصول الموحّد عبر APIYI apiyi.com، يمكنك مقارنة استهلاك التوكن وسجلات التكلفة في لوحة التحكم للتحقق من نتائج القياس الخاصة بك، والحصة التجريبية المجانية للمستخدمين الجدد كافية لإتمام هذه الخطوة.
من سعر النموذج إلى إدارة تكاليف API: ماذا يمكن لبوابة Agent الطبية أن تفعل
بعد أن تدخل مشاريع Agent مرحلة تعدّد النماذج، غالبًا لا يكون انفجار التكاليف ناتجًا عن ارتفاع سعر الوحدة، بل لأن لا أحد يستطيع أن يوضح أي مرحلة أو أي نموذج استهلك كم. وتكمن قيمة بوابة API (API Gateway) في جمع الاستدعاءات المتشتتة في مكان واحد: مفتاح ونقطة نهاية موحدان، وسجلات استخدام مفصّلة حسب النموذج، وتفاصيل تكاليف قابلة للتتبع؛ وعندها فقط يستطيع الفريق أن يكتشف أن خطوة معينة تلتقط عددًا كبيرًا من لقطات الشاشة، أو أن نوعًا من الأخطاء يتكرر فيُستدعى إعادة المحاولة مرارًا.
وباعتبار APIYI مثالًا، فوفقًا لوثائق البدء السريع لديها، تتمثل طريقة الربط في تسجيل حساب، والحصول على مفتاح API من صفحة Token، ثم استبدال نقطة نهاية OpenAI الأصلية بـ https://api.apiyi.com، مع حاجة بعض التطبيقات إلى إضافة /v1 بعد العنوان. يمكن استخدام SDK الرسمي وأمثلة الشيفرة مباشرةً، ويمكن من لوحة التحكم عرض سجلات النموذج واستهلاك Token والتكاليف، كما تشير الصفحة إلى أن أسعار OpenAI وClaude مطابقة للأسعار الرسمية، وتدعم إصدار الفواتير. وبالنسبة للفرق التي تحتاج إلى توزيع الطبقات والمقارنة بين عدة نماذج، توفر APIYI (apiyi.com) طبقة ربط موحدة للقياس والفوترة حسب الاستخدام.
غير أن حدودها تحتاج أيضًا إلى توضيح. فبوابة API تحل مشكلة الربط والقياس الخاصين باستدعاء النماذج، وليست منفّذ Agent: فبيئة المتصفح وسطح المكتب، والتقاط لقطات الشاشة، والتحكم في صلاحيات الأعمال، وعمليات الموافقة البشرية، وصيانة سير العمل، كلها ما زالت بحاجة إلى أن يبنيها المطوّر بنفسه. وفي السيناريو الطبي، يعتمد الامتثال لـ HIPAA أيضًا على مؤهل المنتج المعني، واتفاقية BAA، والإعدادات الأمنية، وحوكمة البيانات، ولن يتحقق تلقائيًا بمجرد تغيير طريقة الربط. كما أن إمكانية استدعاء نموذج GPT-6 معيّن تحديدًا تخضع لقائمة النماذج الحالية على المنصة.
ولو رجعنا إلى رقم 8.5 سنت، فهو يثبت إمكانات النماذج منخفضة التكلفة في الأتمتة الإدارية عالية التكرار، لكنه لا يجيب عن سؤال: كم سيكلّف سير العمل الخاص بك؟ الإجابة لا يمكن أن تأتي إلا من عينات مهامك، ومعدل نجاحك، وسجلات استخدامك. وكما يقول المثل الإنجليزي:
The proof of the pudding is in the eating.
(البرهان على البودنغ هو أكله؛ أي أن النتيجة الفعلية لا تُعرف إلا بالتجربة العملية.)
المراجع
- إعلان OpenAI حول Computer Use Agent للرعاية الصحية: المصدر الأصلي لدرجات HealthAdminBench وتكلفة المهمة الواحدة
- الرابط:
openai.com/index/advancing-computer-use-for-healthcare-teams
- الرابط:
- صفحة تسعير OpenAI API: أسعار Token لنموذجي GPT-6 Astra وGPT-6 Luna ورسوم الحاويات
- الرابط:
developers.openai.com/api/docs/pricing
- الرابط:
- وثائق مطوري Computer Use من OpenAI: حلقة التنفيذ ومسارَي Computer Tool وCode Execution
- الرابط:
developers.openai.com/api/docs/guides/tools-computer-use
- الرابط:
- ورقة HealthAdminBench الإصدار v1: الإصدار المحدد الذي يضم 135 مهمة و1698 مهمة فرعية
- الرابط:
arxiv.org/html/2604.09937v1
- الرابط:
- CVS Health CUA Agent Kit: تنفيذ مفتوح المصدر لاستكشاف الذكاء الاصطناعي وتثبيت الشيفرة
- الرابط:
github.com/cvs-health/cua-agent-kit
- الرابط:
- دراسة مقارنة حول RPA: تصميم التشغيل المتكرر وملاحظات الاستثناءات
- الرابط:
doi.org/10.1080/23311975.2026.2724760
- الرابط:
- التحقق من معنى المثل: Cambridge Dictionary
- الرابط:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: مرحبًا بكم للتواصل معنا عبر الصفحة الرئيسية لـ APIYI على apiyi.com، ولمزيد من إرشادات الوصول يمكنكم زيارة مركز وثائق docs.apiyi.com


