
特定の条件下ではそうですが、本番環境でこの数字をそのまま当てはめることはできません。2026年11月16日、OpenAIはGPT-6 LunaのHealthAdminBench(医療行政ベンチマーク)における1タスクあたりのコストが0.085ドルで、GPT-6 Astraより98%低いと公表しました。この数字はベンチマークテストから得られたものであり、病院の本番導入における見積もりではありません。
エージェントのコストも、100万トークンあたりの単価で単純に換算することはできません。1回のComputer Useタスクには、複数回のモデル呼び出し、スクリーンショット入力、ツール実行、失敗時のリトライ、実行環境が含まれます。本当に試算すべきなのは、タスク全体のコストです。開発者にとっては、適切なモデルの階層化、キャッシュ、ワークフローの定型化、コスト監視のほうが、単価が最も低いモデルを選ぶことより重要です。
この記事を読むと、医療エージェントのコストについて何が分かる?
- 8.5セントがどのようなテスト条件で導かれたのか、どこまでが公式開示値でどこからが逆算による推定値なのか
- 医療エージェントの1タスク全体のコストは何で構成されるのか、スクリーンショット、複数回の呼び出し、リトライがどのように費用を押し上げるのか
- モデルの階層化をどう行うか、計算式と月間タスク数から自分のエージェントプロジェクトの予算をどう見積もるか
本記事の索引:医療Agentのコスト計算をどこから読み始めるか
客観的な事実の部分では、まず8.5セントがどのベンチマークに対応し、どのような評価基準なのかを説明し、そのうえでToken単価がなぜタスクコストを代表できないのかを解説します。その後、1回のAgentタスクにかかる6種類のコスト源を分解し、CVS Healthがオープンソース化したCUA Agent Kitを例に、定型フローではなぜ毎回大規模言語モデルを呼び出す必要がないのかを説明します。分析・判断の部分では、高性能モデルと低コストモデルの役割分担を論じ、そのまま適用できる予算計算式と試算シナリオを示し、最後にAPIレイヤーでの利用量管理が解決できることと、解決できないことを説明します。
To Know:医療Agentのコストに関連する概念
| 概念 | 簡単な説明 |
|---|---|
| Computer Use | ソフトウェアの画面を観察し、クリックや入力などの操作を実行してタスクを完了する能力 |
| EHR | 電子健康記録システム、すなわち病院で使用される電子カルテシステム |
| MCP | 外部ツールを発見・呼び出すための標準プロトコル |
| RPA | あらかじめ設定されたルールやスクリプトに従って定型業務を実行する自動化方式 |
| Rubric points | 評価ルールに基づいて得られる採点ポイント。要求の一部が達成されているかを測るもの |
| エンドツーエンド成功率 | タスク全体がすべての成功条件を満たす割合。採点ポイントの比率よりも厳しい基準 |
| Trace | 実行プロセス、操作アクション、画面状態を記録した軌跡の証拠 |
| Maximum Reasoning Effort | モデルの最高推論強度の設定。通常、より多くの推論Tokenを消費する |
| キャッシュ入力 | 繰り返し出現する入力プレフィックスをより低い単価で課金する仕組み |
影響の概要:医療Agentのコストは誰にとって何を意味するか
- 開発者と技術責任者:公式のベンチマーク数値をそのまま予算に反映することはできません。自社のタスクに合わせて実行メカニズム、エンドツーエンドの完了率、完全なコストを検証する必要があり、同時にスクリーンショットの量、呼び出しラウンド数、再試行率も統計に含めなければなりません。
- 医療機関とワークフロー責任者:合成デモ、ベンダー評価、パイロット、本番事例を区別する必要があります。低いタスク単価は、人手による承認、最小権限、監査ログの設定に代わるものではありません。これらのガバナンス措置自体もコストを生じさせます。
客観的事実:医療Agentの8.5セントの裏側にあるデータ
8.5セントでどんな医療Agentタスクがこなせるのか?
この8.5セントという数字は、OpenAIが2026年11月16日に公開した医療向けComputer Use Agentの発表に由来します。OpenAIはスタンフォードのShah Labが提唱したHealthAdminBenchを使い、2つのモデルを評価しました。どちらも最高の推論強度で実行されています。このベンチマークは、模擬的なEHR、保険支払者ポータル、FAXシステムの環境で、保険資格の確認、事前承認申請、医療機器の発注、システムをまたぐ文書処理といった事務タスクを検証するものです。
| 項目 | GPT-6 Luna | GPT-6 Astra | データの性質 |
|---|---|---|---|
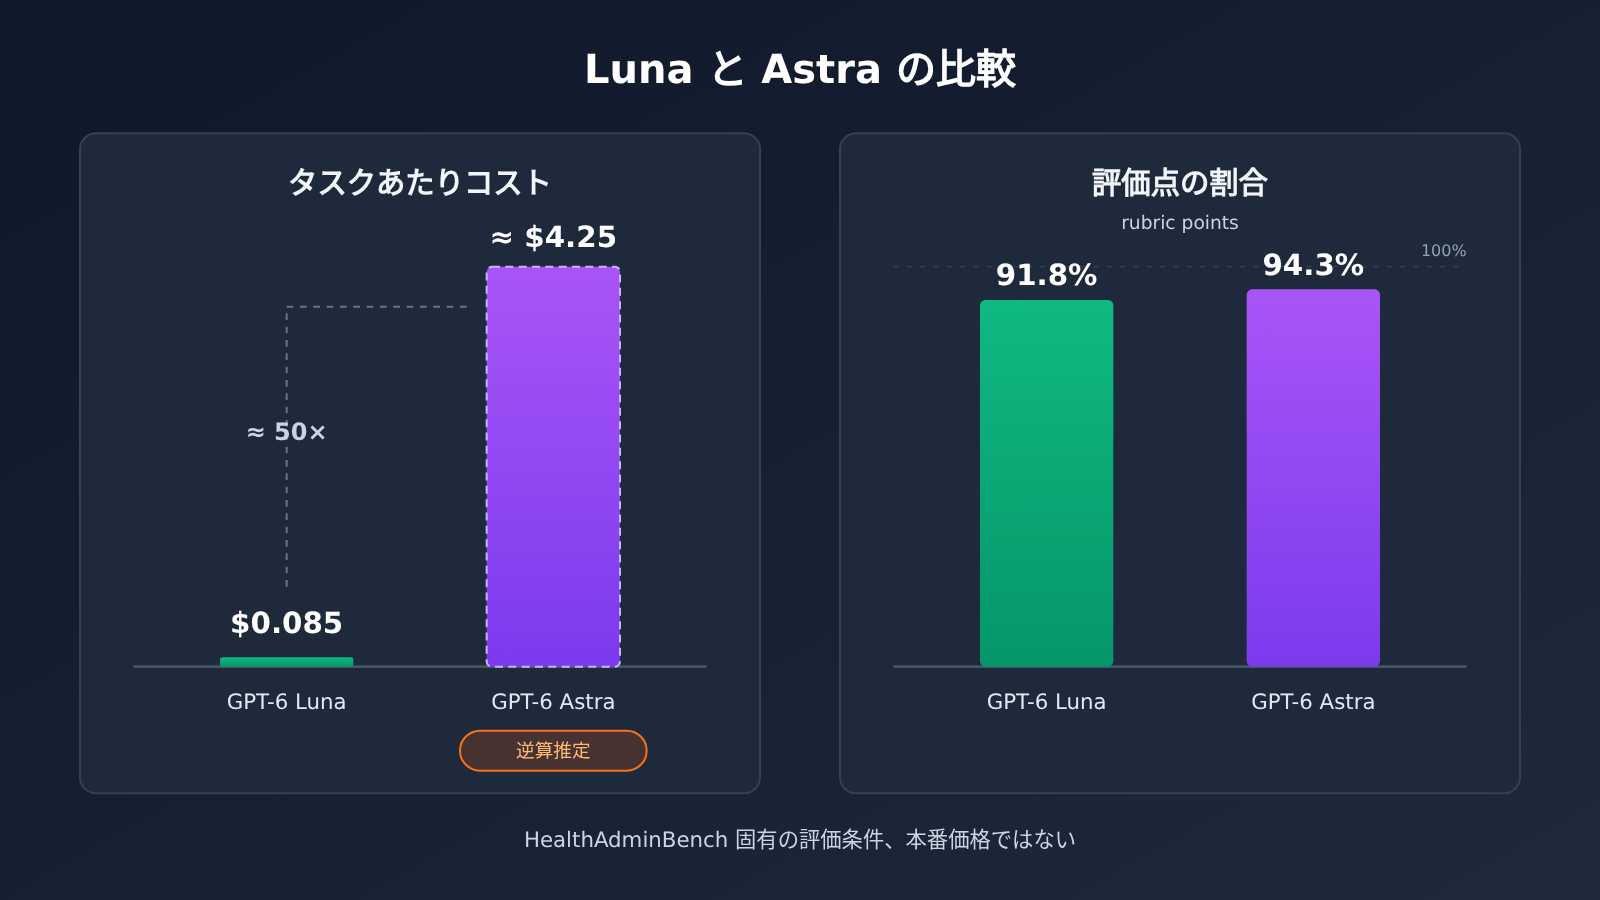
| HealthAdminBench スコア | 91.8% | 94.3% | 公式開示、rubric points の割合 |
| タスクあたりのコスト | $0.085 | 約 $4.25 | Luna は公式開示、Astra は98%の値下げ幅から逆算 |
| 1,000タスクあたりのコスト | $85 | 約 $4,250 | ベンチマーク基準での線形換算であり、本番見積もりではない |
| 入力価格(100万Tokenあたり) | $0.10 | $10.00 | 公式のStandard短コンテキスト価格、2026-11-17時点で確認 |
| 出力価格(100万Tokenあたり) | $0.50 | $50.00 | 同上 |
| キャッシュ入力(100万Tokenあたり) | $0.01 | $1.00 | 同上 |
Astraの約4.25ドルは、0.085 ÷(1 − 0.98)という計算から導いた近似値であり、OpenAIが単独で公表した価格ではありません。また、94.3%と91.8%も完全なタスク成功率を示す数字ではありません。これらは取得可能な評価点のうち何割を獲得したかを数えたものであり、「病院の事務作業の94.3%がすでに全自動化された」と書くことはできません。
HealthAdminBenchには複数の公開バージョンがあるため、その基準を区別する必要があります。論文版2604.09937v1は135のタスクと1698のサブタスクを含み、そのうち1177が決定論的ルールで判定され、521がモデルジャッジによって採点されています。論文に登場する36.3%という完全タスク成功率はClaude Opus 4.6 CUAのもので、82.8%というサブタスク成功率はGPT-5.4 CUAのものです。初期のShah LabのWebページが説明していたのは70タスク・947評価点のバージョンで、これはあくまで歴史的な比較対象として扱えます。モデル、日付、実行条件、指標がそれぞれ異なる結果を、同じランキングに並べることはできません。
なぜ医療エージェントのタスクはトークン単価だけで判断できないのか?
価格表を見ると、2つのモデルの入力・出力・キャッシュ入力の単価はいずれも100倍の差があります。98%の削減率で計算すると、両者の1タスクあたりのコスト差は約50倍に過ぎません。このことから、2つのモデルは同じベンチマーク内での実際の消費量が異なると推測できます。呼び出し回数、入出力トークン数、推論消費、リトライ回数がそれぞれ異なる可能性があるため、1タスクあたりのコストは実際の使用量に基づいてのみ算出できます。
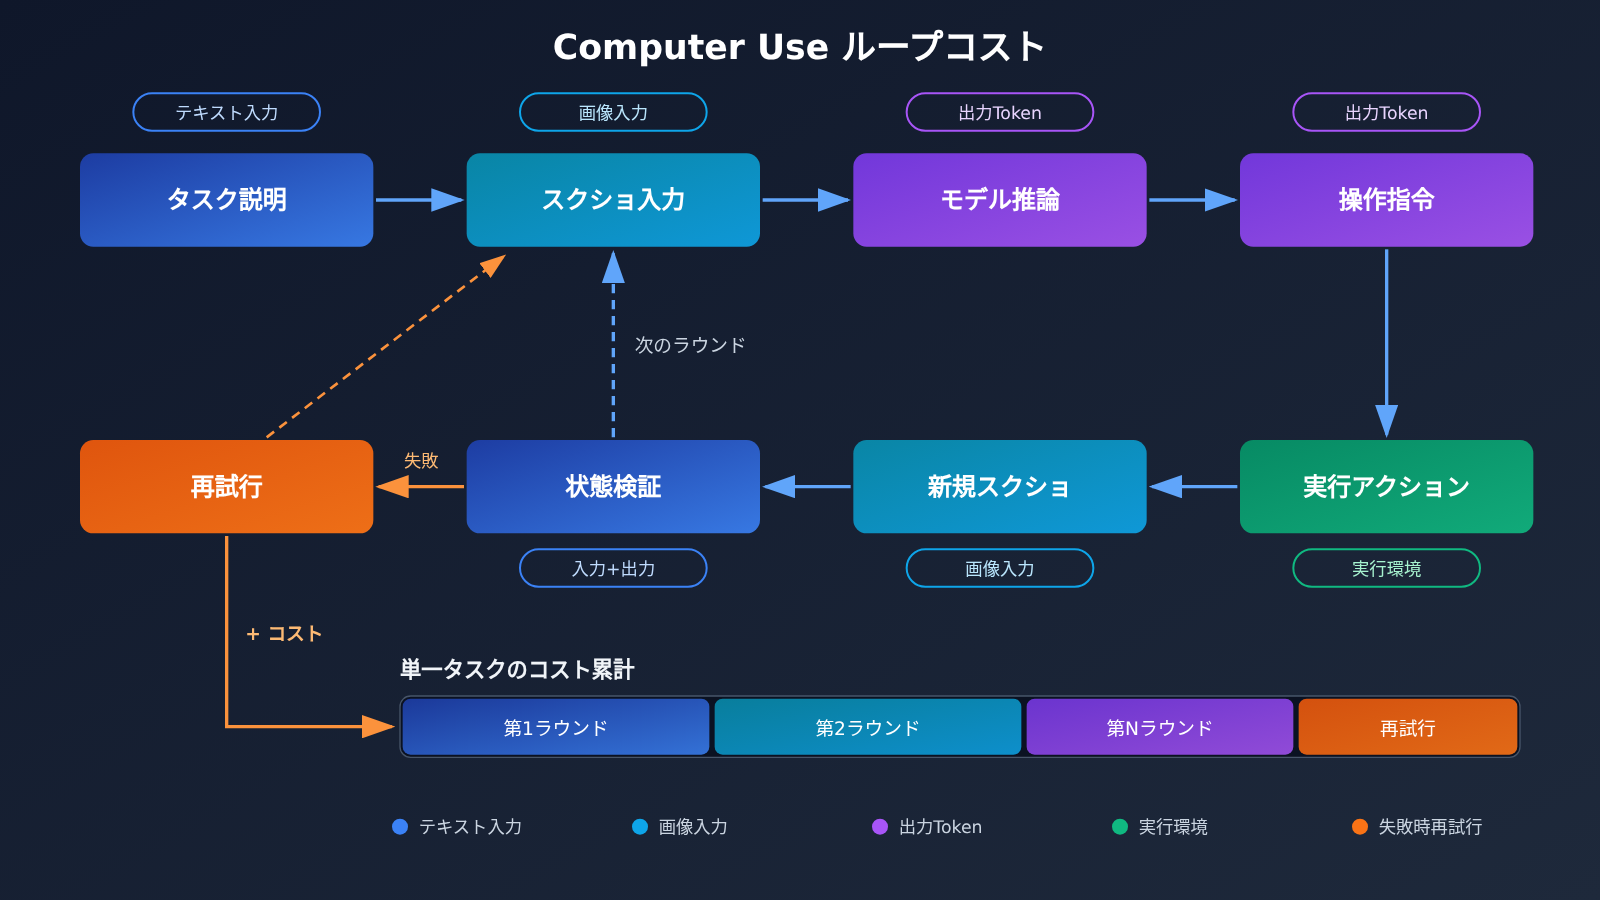
根本的な原因はComputer Useの実行方式にあります。OpenAIの開発者ドキュメントによると、典型的なループは次のとおりです。タスクを受け取り、画面のスクリーンショットを観察し、操作命令を生成し、アプリがクリックや入力を実行し、新しいスクリーンショットを返し、モデルが次のステップを判断します。これを完了するか、人手による承認を求めるまで繰り返します。各ステップで、タスク説明、履歴コンテキスト、新しいスクリーンショットがモデルに再入力される可能性があります。
通常のQ&Aは1回の呼び出しで済むかもしれませんが、システム横断的な事前承認フローでは、「観察、操作、検証」を十数ラウンド連続で経験する可能性があります。スクリーンショットは画像入力に該当し、視覚トークンの費用が別途発生します。しかも毎ラウンド発生するため、最も過小評価されやすい項目です。また注意すべき点として、モデルが操作命令を生成しても、操作が成功したことを意味するわけではありません。アプリは操作を実行し、結果を検証する必要があり、検証自体も呼び出しを消費します。
医療エージェントの1タスクのコストは、いったいどこにかかっているのか?
1回のタスクを分解すると、6種類の直接コストに分類できます。エンジニアリング保守は継続的な投入なので、別枠で計上したほうが実態がはっきりします。
| コスト分類 | 発生原因 | 集計のポイント |
|---|---|---|
| 入力Token | システムプロンプト、タスク指示、履歴コンテキスト、ツールの戻り値 | ターンごとに累計し、キャッシュ可能な部分を切り分ける |
| 出力Token | 操作指示、生成されたコード、意思決定と推論 | 推論強度が高いと出力が大幅に増える |
| 視覚入力 | 各ターンのスクリーンショットと画面理解 | モデルの画像課金ルールに従って個別に集計する |
| ツール呼び出し | 組み込みツール、ホスト型ブラウザ、コード実行 | 組み込みツールが消費するTokenは、対応するモデルの料金で計算される |
| 実行環境 | ブラウザ、仮想マシン、コンテナ | 該当サービスを実際に使ったときだけ計上する |
| 失敗リトライ | ページ読み込みエラー、要素の特定失敗、操作ミス | リトライ分のTokenがすでに総量に含まれているなら二重計上しない |
実行環境の課金は大きく幅があります。OpenAIの料金ページに記載されているHosted ShellとCode Interpreterコンテナの費用は、1 GBあたり20分で0.03ドル、4 GBが0.12ドル、16 GBが0.48ドル、64 GBが1.92ドルです。ファイルと画像のアップロード保存は0.10ドル/GB-dayで課金されます。開発者が自前のサーバー上でPlaywrightやデスクトップ実行ツールを動かす場合、この部分は自社インフラのコストになり、構造はまったく別物になります。
つまり、コスト計算では3つの層を区別する必要があります。モデルコストは入出力の処理費用、実行コストはブラウザやサーバー、コンテナといったインフラ費用、エンジニアリングコストはワークフロー設計・テスト・監視・保守に投じる人件費です。第1層だけを見ていると、予算は必ず低めに出てしまいます。
なぜ一部の医療エージェントは毎回大規模言語モデルを呼び出すべきではないのか?
CVS Health は発表の中で本番環境の事例を公開しました。あるエージェントは週末の間に数か月分滞留していたファイル送信タスクを処理し、別のエージェントは専門医会診におけるシステム操作ステップを1日数万回処理しています。ここでの「数万回」は操作ステップを指し、AIが独立して下した臨床判断ではありません。また、システムには検証チェック、人による監督、スクリーンショットと操作記録に基づく状態確認も組み込まれています。
開発者にとってさらに注目すべきは、CVSがオープンソース化したCUA Agent Kit(Apache-2.0ライセンス)です。これは自動化を2つの段階に分けています。まずOpenAI Computer Use Agentが自然言語に従ってタスクを実行し、スクリーンショット、アクション、対象位置、Traceを記録します。次にCodex Skillが成功した軌跡に基づいて決定論的ワークフローコードを生成または更新し、エンジニアによるレビューを経ます。READMEには、決定論的実行フェーズではモデルのAPIキーが不要であると記載されています。
この設計はコスト課題に直接対応しています。未知のフローを探索する際には大規模言語モデルの推論が必要ですが、既知のフローを繰り返し実行する際は通常のコードに任せられます。フローが安定していれば、1回の実行ごとに視覚入力と推論のコストを支払う必要がなくなり、結果のばらつきも低減します。このプロジェクトの中心的な見解の一つは、「タスクの完了方法を発見すること」と「長期的に安定して繰り返し実行すること」は別の問題だという点です。
従来のRPAとエージェントの関係も、この観点から理解できます。RPA比較研究(DOI: 10.1080/23311975.2026.2724760)では、P2とP3の2つのタスクについて各技術を10回ずつ実行しました。一方、P1タスクのエージェントは1回だけ実行して失敗し、その後の統計には含まれていません。そのため、「すべてのタスクを10回実行した」と一概に言うことはできません。この研究は2025年のツール構成を使用しており、2026年モデルの直接の成績として扱うことはできません。ただし、次の点は示唆しています。自動化ソリューションを評価する際には、繰り返し実行の安定性と1回の実行での成功が同様に重要です。
分析と判断:医療エージェントのコスト計算をどう考えるか
高性能モデルと低コストモデルは医療エージェント内でどう役割分担するか?
ベンチマークデータによると、Luna の評価ポイント占有率は Astra より 2.5 ポイント低いものの、コストは Astra の約 2% にとどまります。これは、構造化度の高い事務タスクにおいて、低コストモデルがすでに無視できない実行能力を備えていることを示しています。ただし、評価ポイントの差はエンドツーエンドの成功率の差とは限りません。失った点数がファイルアップロードやステータス更新といった重要なステップに該当する場合、業務結果はまったく異なる可能性があります。これは私たちの判断であり、自社のタスクデータで検証する必要があります。
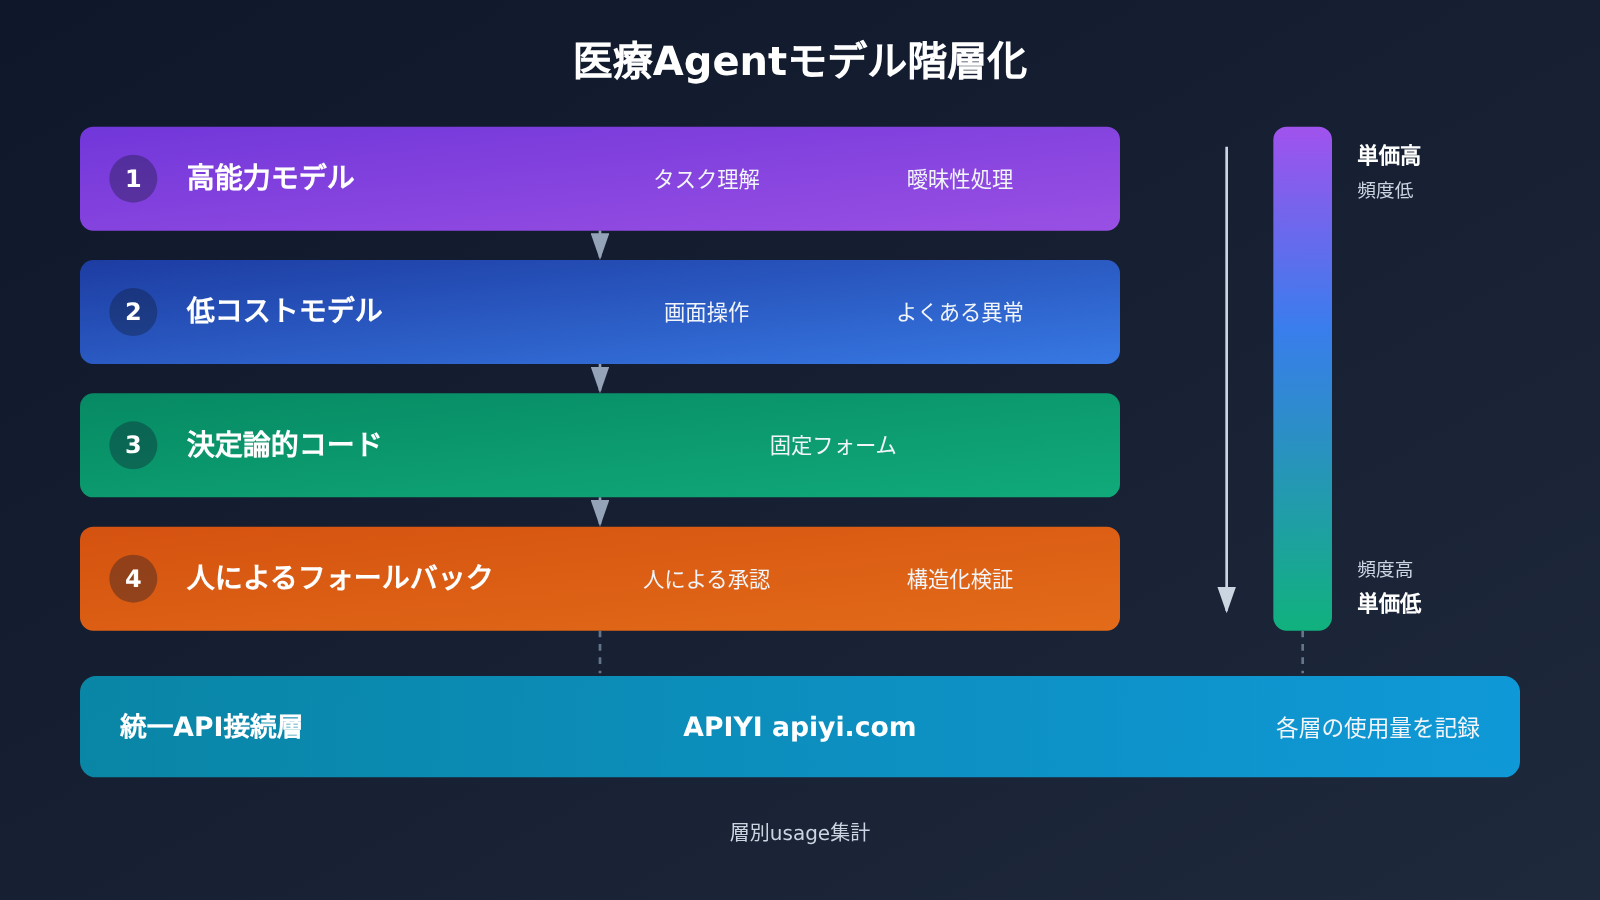
より確実な方法は、タスク全体を1つのモデルで処理するのではなく、フェーズごとに割り当てることです:
| 作業フェーズ | 推奨される担当 | 理由 |
|---|---|---|
| 複雑なタスクの理解とステップ分解 | 高性能モデル | ミスのコストが高く、呼び出し回数は少ない |
| カルテの曖昧さや不明瞭な情報の処理 | 高推論モデル + 人手による確認 | Ambience の方式は曖昧な場合に停止し、医師に確認する |
| 定型的な画面操作 | 低コストモデル | 呼び出し回数が多く、単価に最も敏感 |
| 固定フォームの繰り返し入力 | 決定論的コード | CUA Agent Kit のコード固定化の考え方を参照 |
| よくある例外処理 | 低コストモデルまたはルール | パターンが固定されており、段階的にルール化できる |
| 重要操作の承認 | 人 | 送信、送付、署名などの操作は人間が最終権限を保持 |
| 最終結果の検証 | 構造化チェック + 人手による抜き取り確認 | モデルの「完了」宣言ではなく、システムの状態を基準にする |
このような階層化の利点は、高単価モデルを低頻度・高価値の工程にのみ登場させ、高頻度の工程は低コストモデルやコードに任せられることです。複数のモデルが併存する場合、統一された呼び出しインターフェースによって切り替えコストを抑えられます。たとえば APIYI apiyi.com のような OpenAI 互換ゲートウェイを介すれば、開発者は model パラメータを変えるだけで異なるモデルを比較できます。具体的に利用可能なモデルは、プラットフォームの現在のモデルリストとアカウント権限に準じます。
開発者は自分の医療Agentプロジェクトの予算をどう計算すればよいですか?
以下のシングルタスクコストのフレームワークを採用することをおすすめします。ここで、Tは実際のToken数、Pは100万Tokenあたりの価格です:
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (キャッシュ可能な部分はキャッシュ価格で別途計上)
C_output = T_output × P_output / 1,000,000
C_image  = モデルのビジョン課金ルールに従い、ラウンドごとのスクリーンショットを個別に集計
C_retry  = 上記のToken合計にまだ含まれていないリトライ費用のみを計上

単一成功タスクのコスト = 全タスクの総コスト ÷ 成功タスク数
月間予算 = 単一成功タスクのコスト × 月間成功タスク目標 + エンジニアリング保守への投入
予算の精度を実際に左右するのは、次の実測指標です:1タスクあたりの平均呼び出しラウンド数、平均スクリーンショット数、失敗時のリトライ率、人手介入率、エンドツーエンドの成功率。分母に「1回の実行コスト」ではなく「単一成功タスクのコスト」を使うことで、失敗分の消費も織り込むことができます。
次の表は私たちが独自に構築した予算シナリオで、すべての使用量は仮定値であり、計算方法を示すためのデモにすぎません。単価は前掲の公式 Standard 価格を採用しています:
| シナリオの仮定(自社構築、実測値ではない) | 低コストモデル(Luna 単価) | 高能力モデル(Astra 単価) |
|---|---|---|
| 1タスク15ラウンド、各ラウンドでビジョン+テキスト入力2万Token | 30万 × $0.10/M = $0.030 | 30万 × $10/M = $3.00 |
| 各ラウンドの出力500 Token | 7,500 × $0.50/M ≈ $0.004 | 7,500 × $50/M = $0.375 |
| 1回の実行あたりのモデルコスト | 約 $0.034 | 約 $3.38 |
| エンドツーエンド成功率80%を仮定した単一成功タスクのコスト | 約 $0.042 | 約 $4.22 |
| 月間成功タスク10,000回のモデルコスト | 約 $420 | 約 $42,200 |
| マネージドコンテナ(4 GB、20分ごとに4タスクを直列処理) | 約 $300/月 | 約 $300/月 |
このシナリオは、見落とされがちな現象を明らかにしています。モデルが十分に安くなると、実行環境の費用がモデル費用と同じ水準、あるいはそれ以上になる可能性があるのです。それに伴って最適化の方向も変わり、「もっと安いモデルに乗り換える」から「スクリーンショットのラウンド数を減らし、コンテナを再利用し、固定ステップをコード化する」へと移っていきます。これはシナリオ推演から得られた判断であり、実際の比率はお客様の実測データに基づく必要があります。
実際の使用量を収集する最も直接的な方法は、モデル呼び出しのたびに usage フィールドを記録することです。以下は最もシンプルな例です:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI の OpenAI 互換インターフェース
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # APIYI 管理画面のモデル一覧を参照
    messages=[{"role": "user", "content": "以下の項目に基づいて事前承認申請のチェックリストを生成してください:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
タスクごとの累計コストを集計する完全な実装コードを見る
from dataclasses import dataclass, field
from openai import OpenAI

# 2026-11-17 公式 Standard 短コンテキスト価格(米ドル/百万トークン)。実際の料金は該当する課金ティアに準拠します
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # 統合接続。管理画面でトークンと費用ログを照合できます
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # リトライ分のトークンは record で累計済みのため、ここでは重複して加算しません
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 予算の目安:まず 20〜50 件の実際のタスクサンプルを選んで小規模に試行し、そのうえで月次の試算を行います。APIYI(apiyi.com)で統合接続する場合は、管理画面のトークン消費量と費用ログを照合して、自身の計測結果を検証できます。新規ユーザー向けの無料テスト枠は、このステップを完了するのに十分です。
モデル価格からAPIコスト管理へ:医療Agentゲートウェイにできること
Agent プロジェクトがマルチモデルの段階に入ると、コストが制御不能になる原因は単価の高さではなく、どの工程で、どのモデルがどれだけ消費したのかを誰も明確に説明できないことにある場合がほとんどです。API Gateway の価値は、分散した呼び出しを一か所に集約する点にあります。統一された Key と Endpoint、モデル別に分割された使用量ログ、追跡可能な費用明細。これらがあって初めてチームは、特定のステップでスクリーンショットが多すぎる、あるいは特定の異常が繰り返しリトライを引き起こしているといった問題を発見できます。
APIYI を例に見てみましょう。同社のクイックスタートドキュメントによれば、接続方法はアカウントを登録し、Token ページで APIキーを取得して、元の OpenAI Endpoint を https://api.apiyi.com に置き換えるだけです。一部のアプリケーションでは、アドレスの後ろに /v1 を追加する必要があります。公式 SDK とコードサンプルはそのまま利用でき、管理画面でモデル、Token 消費量、費用ログを確認できます。ページには OpenAI と Claude の料率が公式と一致するとの記載があり、請求書の発行にも対応しています。複数のモデル間で階層分けや比較を行いたいチームにとって、APIYI apiyi.com は従量課金・統一計測の接続レイヤーを提供します。
ただし、その適用範囲も明確にしておく必要があります。API ゲートウェイが解決するのはモデル呼び出しの接続と計測であり、Agent の実行基盤ではありません。ブラウザやデスクトップ環境、スクリーンショットの収集、業務権限の制御、人手による承認フロー、ワークフローの保守は、開発者が自ら構築する必要があります。医療の現場では、HIPAA 準拠は適用製品の資格、BAA、セキュリティ設定、データガバナンスによって決まり、接続方法を変えたからといって自動的に満たされるものではありません。特定の GPT-6 モデルを呼び出せるかどうかも、プラットフォームが現在公開しているモデルリストに基づいて判断する必要があります。
8.5セントという数字に話を戻すと、それは低コストモデルが高頻度の事務自動化において持つ可能性を示していますが、あなたのワークフローにいくらかかるかという問いには答えられません。その答えは、自分のタスクサンプル、自分の成功率、自分の使用量ログからしか導けません。あの英語のことわざが言うとおりです:
The proof of the pudding is in the eating.
(プディングの良し悪しは食べてみてわかる。実際の効果は実践で検証するしかない。)
参考資料
- OpenAI 医療 Computer Use Agent のお知らせ:HealthAdminBench のスコアとタスクあたりコストの原典
- リンク:
openai.com/index/advancing-computer-use-for-healthcare-teams
- リンク:
- OpenAI API 料金ページ:GPT-6 Astra、GPT-6 Luna のトークン価格およびコンテナ料金
- リンク:
developers.openai.com/api/docs/pricing
- リンク:
- OpenAI Computer Use 開発者ドキュメント:実行ループ、Computer Tool と Code Execution の2つのパス
- リンク:
developers.openai.com/api/docs/guides/tools-computer-use
- リンク:
- HealthAdminBench 論文 v1:135 タスク、1698 サブタスクという明確なバージョン
- リンク:
arxiv.org/html/2604.09937v1
- リンク:
- CVS Health CUA Agent Kit:AI による探索とコード化のオープンソース実装
- リンク:
github.com/cvs-health/cua-agent-kit
- リンク:
- RPA 比較研究:反復実行の設計と例外の説明
- リンク:
doi.org/10.1080/23311975.2026.2724760
- リンク:
- ことわざの意味の確認:Cambridge Dictionary
- リンク:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- リンク:
作者: APIYI 技術チーム
技術交流: APIYI apiyi.com のトップページからお気軽にお問い合わせください。詳しい接続方法は docs.apiyi.com ドキュメントセンターをご覧ください


