
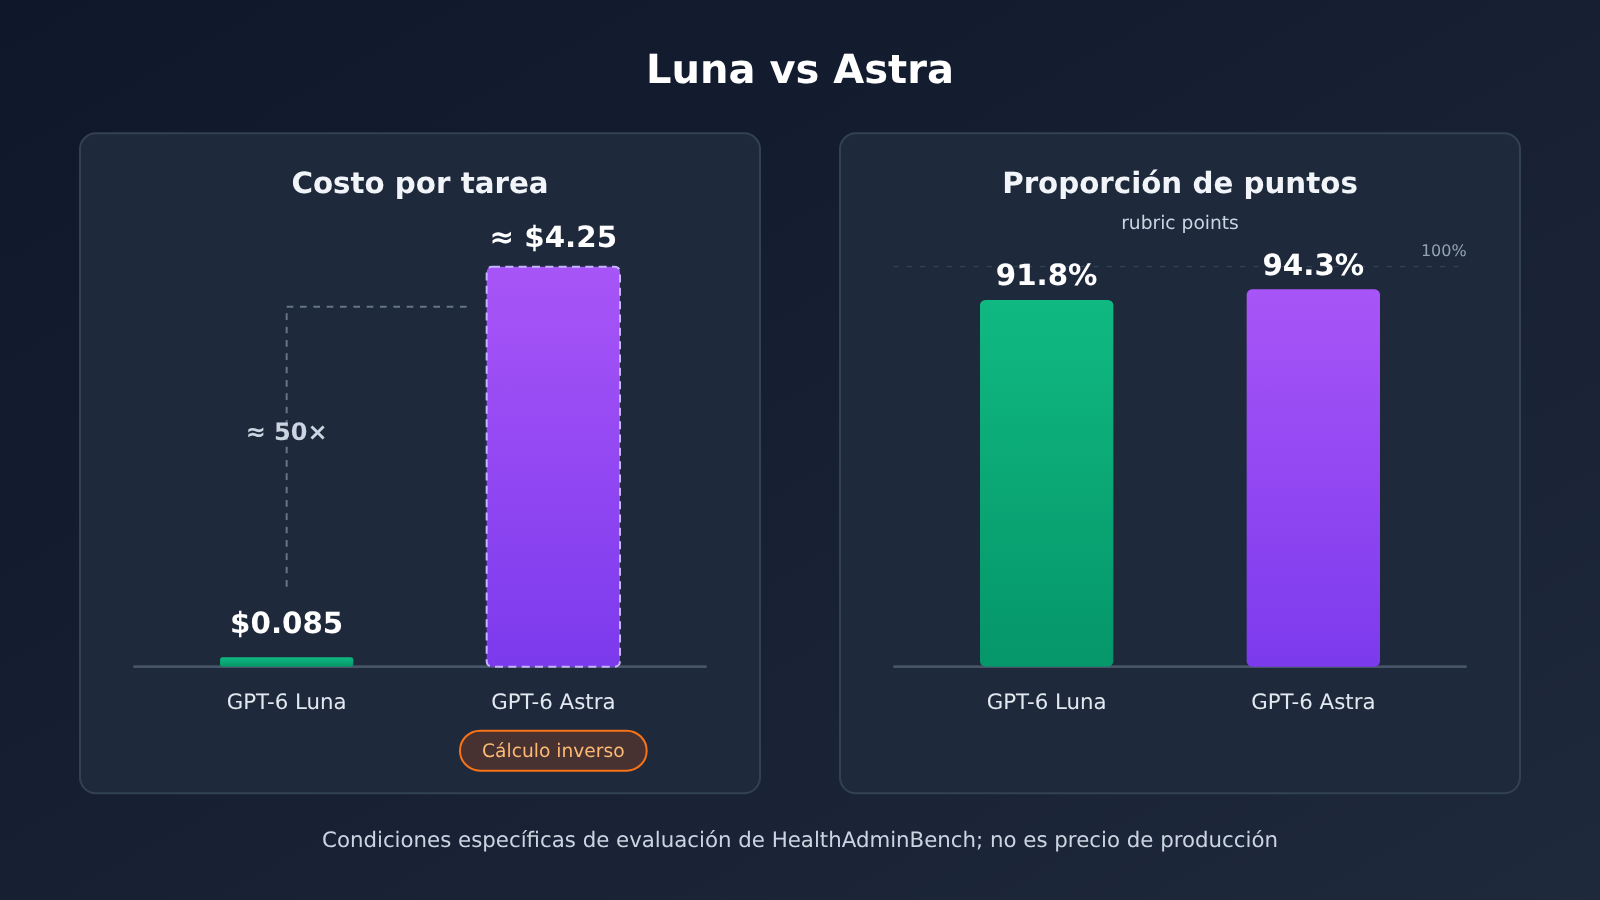
Bajo condiciones específicas, sí, pero no puedes trasladar esa cifra tal cual a un entorno de producción. El 16 de noviembre de 2026, OpenAI reveló que el costo por tarea de GPT-6 Luna en HealthAdminBench, el benchmark de administración sanitaria, es de 0.085 dólares, un 98% menos que GPT-6 Astra. Esa cifra proviene de una prueba de referencia, no de una cotización para un despliegue hospitalario real.
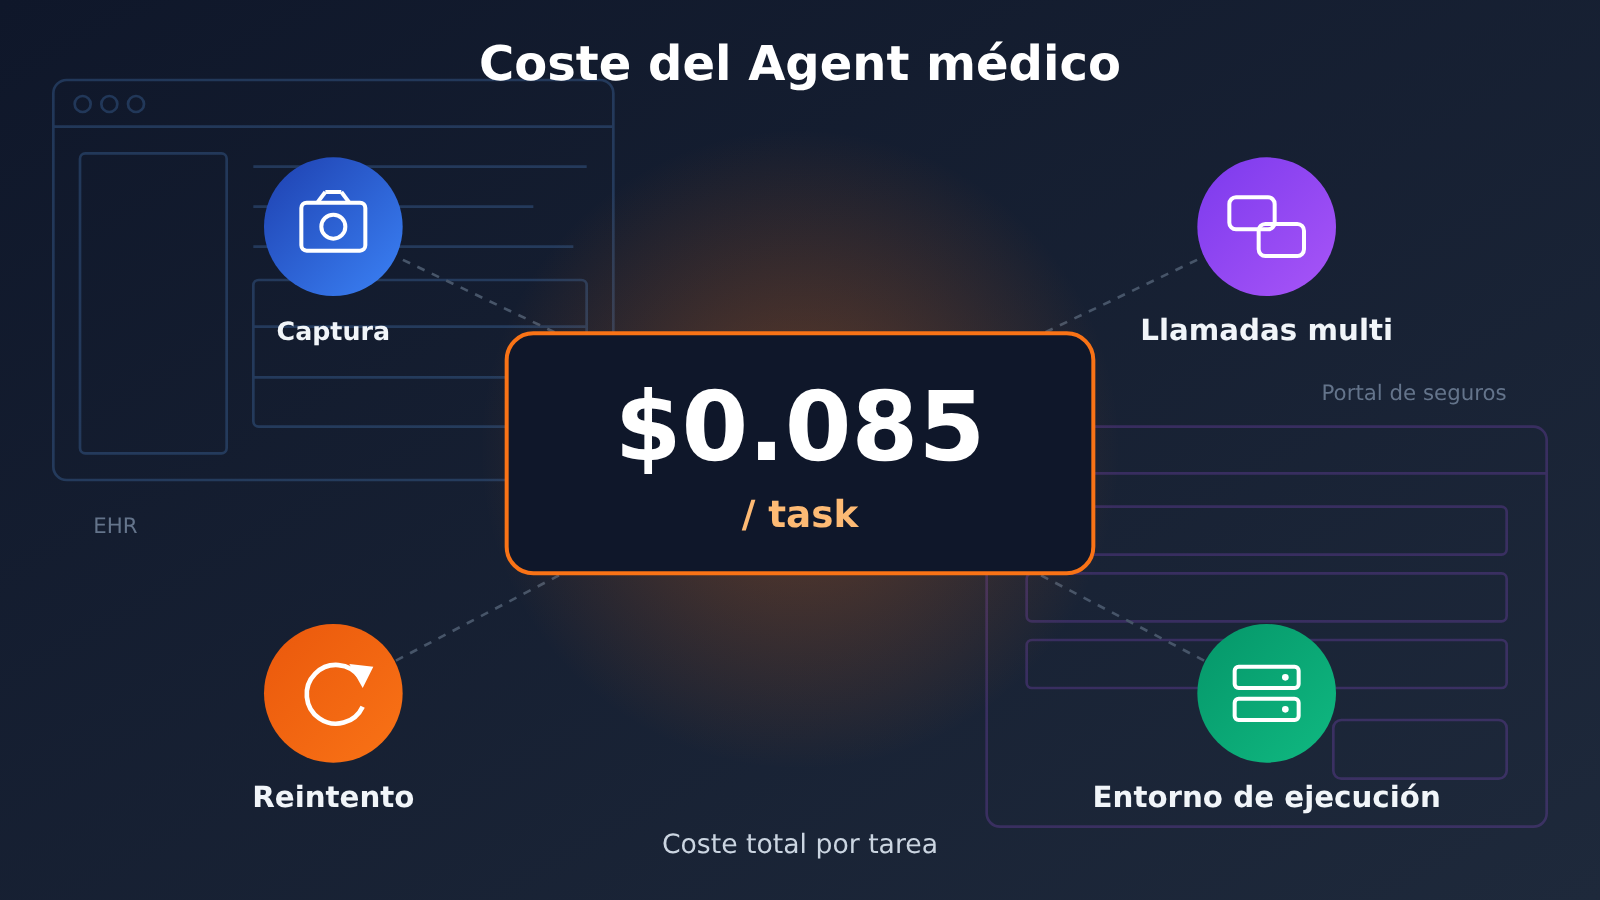
El costo de un Agent tampoco se puede convertir simplemente usando el precio por millón de tokens. Una tarea de Computer Use incluye múltiples rondas de invocación del modelo, entradas de capturas de pantalla, ejecución de herramientas, reintentos fallidos y entorno de ejecución; lo que realmente hay que calcular es el costo completo de la tarea. Para los desarrolladores, una estratificación razonable de modelos, caché, consolidación de flujos de trabajo y monitoreo de costos importan más que elegir el modelo con el precio unitario más bajo.
¿Qué preguntas sobre los costos del Agent médico podrás responder tras leer este artículo?
- ¿Bajo qué condiciones de prueba se obtuvieron los 8.5 centavos, qué cifras fueron divulgadas oficialmente y cuáles son estimaciones derivadas?
- ¿De qué partes se compone el costo de una tarea completa de Agent médico, y cómo las capturas de pantalla, las múltiples rondas de llamadas y los reintentos inflan el gasto?
- ¿Cómo estratificar modelos y cómo estimar el presupuesto de tu propio proyecto de Agent con fórmulas y el volumen mensual de tareas?
Índice de este artículo: por dónde empezar a leer la cuenta de costes de los agentes médicos
La parte de hechos objetivos explica primero a qué benchmark corresponden los 8,5 centavos y con qué criterio de puntuación, y después por qué el precio unitario por token no puede representar el coste de una tarea. A continuación desglosa las seis fuentes de coste de una tarea de agente y, con el CUA Agent Kit de código abierto de CVS Health, explica por qué los flujos fijos no necesitan invocar el Modelo de Lenguaje Grande cada vez. La parte de análisis y juicio discute la división del trabajo entre modelos de alta capacidad y modelos de bajo coste, ofrece una fórmula de presupuesto directamente aplicable y escenarios de cálculo, y finalmente explica qué puede y qué no puede resolver la gestión del uso a nivel de API.
Para saber: conceptos relacionados con el coste de los agentes médicos
| Concepto | Breve explicación |
|---|---|
| Computer Use | Capacidad de completar tareas observando la interfaz del software y ejecutando acciones como clics y entradas de texto |
| EHR | Sistema de historia clínica electrónica, es decir, el sistema de registros médicos electrónicos que utilizan los hospitales |
| MCP | Protocolo estándar para descubrir e invocar herramientas externas |
| RPA | Forma de automatización que ejecuta procesos repetitivos según reglas o scripts preconfigurados |
| Puntos de rúbrica | Puntos de puntuación obtenidos según las reglas de evaluación, que miden el grado de cumplimiento de una parte de los requisitos |
| Tasa de éxito de extremo a extremo | Proporción de tareas completas que cumplen todas las condiciones de éxito, más estricta que la proporción de puntos de rúbrica |
| Traza (Trace) | Evidencia del recorrido que registra el proceso de ejecución, las acciones realizadas y el estado de la interfaz |
| Máximo esfuerzo de razonamiento | El nivel más alto de intensidad de razonamiento del modelo, que normalmente consume más tokens de razonamiento |
| Entrada en caché | Mecanismo por el que los prefijos de entrada que se repiten se facturan a un precio unitario más bajo |
Resumen de impacto: qué implica el costo de los agentes médicos y para quién
- Desarrolladores y responsables técnicos: no conviene tomar las cifras de referencia oficiales y llevarlas directamente al presupuesto. Hay que validar, según las tareas propias, el mecanismo de ejecución, la tasa de finalización de extremo a extremo y el costo completo, e incorporar en el cálculo el volumen de capturas de pantalla, el número de rondas de invocación y la tasa de reintentos.
- Instituciones médicas y responsables de flujos de trabajo: es necesario distinguir entre demostraciones sintéticas, evaluaciones de proveedores, pilotos y casos en producción. Un bajo costo por tarea no sustituye la configuración de aprobación humana, privilegios mínimos y registros de auditoría, ya que estas medidas de gobernanza también generan costos.
Hechos objetivos: los datos detrás de los 8.5 centavos por agente médico
8.5 ¿Qué tareas de agente médico se pueden completar con 8,5 centavos?
Los 8,5 centavos vienen del anuncio del Agente de Uso de Computadora (Computer Use Agent) para el ámbito médico que OpenAI publicó el 16 de noviembre de 2026. OpenAI evaluó dos modelos con HealthAdminBench, el benchmark propuesto por el Shah Lab de Stanford, y en ambos casos con el nivel máximo de esfuerzo de razonamiento. Ese benchmark recrea EHR, portales de aseguradoras y sistemas de fax simulados para medir tareas administrativas como la verificación de elegibilidad del seguro, la solicitud de autorización previa, el pedido de dispositivos médicos y el procesamiento de documentos entre sistemas.
| Concepto | GPT-6 Luna | GPT-6 Astra | Naturaleza del dato |
|---|---|---|---|
| Puntuación en HealthAdminBench | 91,8 % | 94,3 % | Divulgado oficialmente; porcentaje de rubric points |
| Costo por tarea | $0,085 | unos $4,25 | Luna: dato oficial; Astra: estimado a partir de una reducción del 98 % |
| Costo de 1.000 tareas | $85 | unos $4.250 | Conversión lineal según el criterio del benchmark, no es una cotización de producción |
| Precio de entrada (por millón de tokens) | $0,10 | $10,00 | Precio oficial Standard de contexto corto, consultado el 2026-11-17 |
| Precio de salida (por millón de tokens) | $0,50 | $50,00 | Igual que arriba |
| Entrada en caché (por millón de tokens) | $0,01 | $1,00 | Igual que arriba |
Los ~4,25 dólares de Astra salen del cálculo 0,085 ÷ (1 − 0,98). Es un valor aproximado, no un precio que OpenAI haya publicado por separado. Tampoco 94,3 % y 91,8 % son tasas de éxito de tareas completas: lo que miden es la proporción de puntos de rúbrica obtenidos, así que no se pueden leer como «el 94,3 % del trabajo administrativo hospitalario ya está totalmente automatizado».
HealthAdminBench tiene varias versiones públicas y hay que distinguir el criterio de cada una. La versión del paper 2604.09937v1 incluye 135 tareas y 1.698 subtareas, de las cuales 1.177 se evalúan con reglas deterministas y 521 con un modelo juez. En el paper, el 36,3 % de éxito en tareas completas corresponde a Claude Opus 4.6 CUA, y el 82,8 % de éxito en subtareas corresponde a GPT-5.4 CUA. La primera descripción en la web del Shah Lab hablaba de una versión con 70 tareas y 947 puntos de evaluación, que solo sirve como referencia histórica. Resultados de modelos, fechas, condiciones de ejecución e indicadores distintos no se pueden alinear en una misma tabla de clasificación.
¿Por qué las tareas de un agente médico no pueden evaluarse solo por el precio unitario de los tokens?
Si nos fijamos en la tabla de precios, los precios unitarios de entrada, salida y entrada en caché de los dos modelos difieren en un factor de 100. Si aplicamos una reducción del 98%, el coste por tarea de ambos modelos solo difiere en un factor de aproximadamente 50. De ello se deduce que el consumo real de los dos modelos dentro de un mismo benchmark no es el mismo. El número de rondas de invocación, la cantidad de tokens de entrada y salida, el consumo de razonamiento y el número de reintentos pueden variar, por lo que el coste por tarea solo puede calcularse a partir del uso real.
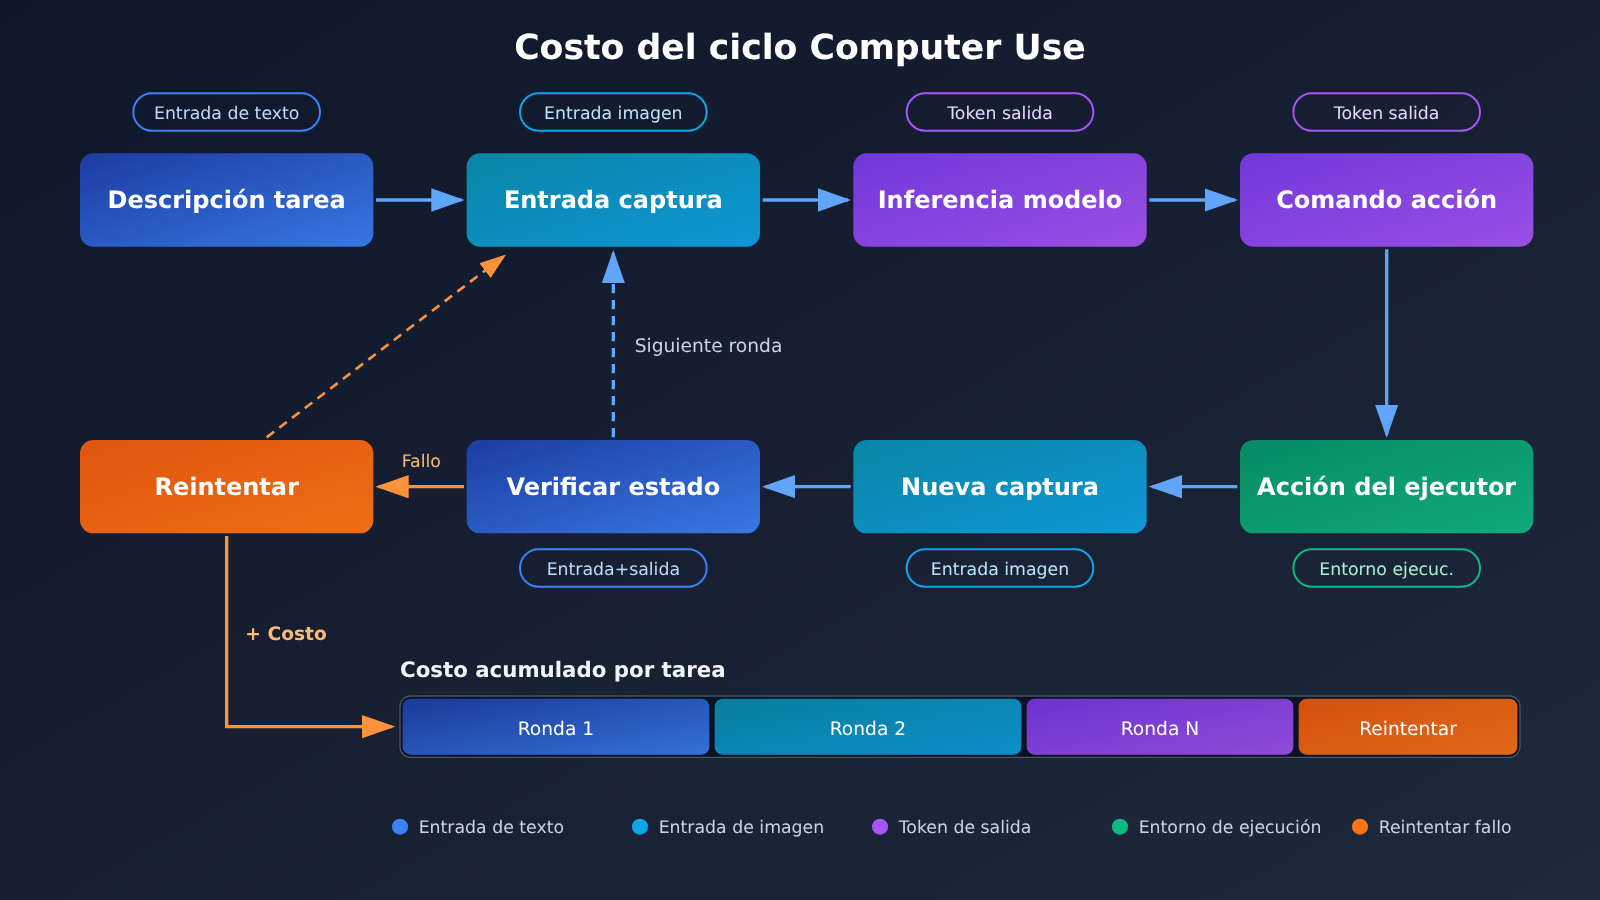
El motivo de fondo está en cómo se ejecuta Computer Use. Según la documentación para desarrolladores de OpenAI, un bucle típico consiste en: recibir la tarea, observar la captura de pantalla, generar instrucciones de acción, hacer que la aplicación ejecute un clic o una entrada, devolver una nueva captura de pantalla y que el modelo decida el siguiente paso, hasta completar la tarea o solicitar aprobación humana. En cada paso, la descripción de la tarea, el contexto histórico y la nueva captura de pantalla pueden volver a introducirse en el modelo.
Una pregunta y respuesta normal puede requerir solo una invocación, mientras que un flujo de preautorización entre sistemas puede pasar por más de una docena de rondas consecutivas de «observar, actuar y verificar». Las capturas de pantalla son entradas de imagen y generan por separado un coste de tokens visuales, y aparecen en cada ronda, por lo que son lo que más fácilmente se subestima. Además, hay que tener en cuenta que el hecho de que el modelo genere instrucciones de acción no significa que la acción ya se haya realizado correctamente: la aplicación debe ejecutarla y verificar el resultado, y esa verificación también consume invocaciones.
¿En qué se gasta realmente el dinero en una tarea de agente médico?
Si desglosamos una tarea, los costos directos se pueden agrupar en seis categorías. El mantenimiento de ingeniería es una inversión continua, y conviene contabilizarlo aparte para que quede más claro.
| Categoría de costo | Por qué se genera | Puntos clave para el cálculo |
|---|---|---|
| Tokens de entrada | Indicación del sistema, descripción de la tarea, contexto previo, resultados de las herramientas | Se acumulan por turno; distingue qué parte se puede almacenar en caché |
| Tokens de salida | Instrucciones de operación, código generado, decisiones y razonamiento | Una intensidad de razonamiento alta aumenta bastante la salida |
| Entrada visual | Capturas de pantalla de cada turno y comprensión de la interfaz | Se calcula por separado según las reglas de facturación de imágenes del modelo |
| Llamadas a herramientas | Herramientas integradas, navegador alojado, ejecución de código | Los tokens que consumen las herramientas integradas se facturan según el modelo correspondiente |
| Entorno de ejecución | Navegador, máquina virtual, contenedor | Solo se contabiliza cuando se usa realmente el servicio correspondiente |
| Reintentos por fallos | Errores al cargar la página, fallos de localización de elementos, errores de operación | Si los tokens de reintento ya están incluidos en el total, no los sumes de nuevo |
La forma de facturar el entorno de ejecución varía mucho según el caso. En la página de precios de OpenAI, las tarifas de los contenedores Hosted Shell y Code Interpreter aparecen así: 1 GB durante 20 minutos cuesta 0,03 USD; 4 GB, 0,12 USD; 16 GB, 0,48 USD; y 64 GB, 1,92 USD. El almacenamiento de archivos e imágenes subidos se factura a 0,10 USD/GB-día. Si el desarrollador ejecuta Playwright o un ejecutor de escritorio en sus propios servidores, esta partida pasa a ser un costo de infraestructura propia y la estructura cambia por completo.
Por eso, al calcular costos hay que distinguir tres niveles: el costo del modelo es el gasto de procesar entradas y salidas; el costo de ejecución abarca la infraestructura, como navegadores, servidores y contenedores; y el costo de ingeniería es el esfuerzo humano dedicado al diseño de flujos de trabajo, pruebas, monitorización y mantenimiento. Si solo miras el primer nivel, el presupuesto se quedará corto con seguridad.
¿Por qué algunos agentes de salud no deberían invocar el Modelo de Lenguaje Grande en cada ejecución?
CVS Health reveló casos en producción en su comunicado. Un agente se encargó, durante un fin de semana, de vaciar una cola de tareas de envío de documentos acumulada durante meses; otro agente procesa cada día decenas de miles de pasos de operación de sistemas en consultas de especialistas. Ese «decenas de miles de veces» se refiere a pasos de operación, no a decisiones clínicas tomadas de forma autónoma por la IA. El sistema incorpora además verificaciones de validación, supervisión humana y comprobación de estado basada en capturas de pantalla y registros de operaciones.
Lo que más debería interesar a quien desarrolla es el CUA Agent Kit que CVS publicó como código abierto (licencia Apache-2.0). Divide la automatización en dos fases: primero, OpenAI Computer Use Agent ejecuta la tarea a partir de lenguaje natural y registra capturas de pantalla, acciones, posición de los objetivos y el Trace; después, Codex Skill genera o actualiza, a partir de las trayectorias exitosas, código de flujo de trabajo determinista, que además pasa por revisión de ingenieros. El README indica que la fase de ejecución determinista no necesita una clave API del modelo.
Este diseño ataca directamente el problema de costes: explorar procesos desconocidos exige razonamiento del Modelo de Lenguaje Grande, mientras que repetir procesos ya conocidos se delega a código convencional. Siempre que el proceso sea estable, cada ejecución deja de pagar por entrada visual y razonamiento, y la variabilidad de los resultados también disminuye. Una de las ideas centrales del proyecto es que «descubrir cómo completar una tarea» y «ejecutarla de forma repetida y estable a lo largo del tiempo» son dos problemas distintos.
La relación entre RPA tradicional y los agentes también se puede entender desde este ángulo. En un estudio comparativo sobre RPA (DOI: 10.1080/23311975.2026.2724760), las tareas P2 y P3 se ejecutaron 10 veces con cada tecnología, mientras que el agente de la tarea P1 solo se ejecutó una vez y falló, por lo que no se incluyó en los estadísticos posteriores; así que no se puede afirmar en términos generales que «todas las tareas se ejecutaron 10 veces». El estudio utilizó configuraciones de herramientas de 2025, de modo que no debe tomarse como resultado directo de los modelos de 2026. Aun así, deja una advertencia: al evaluar una solución de automatización, la estabilidad en ejecuciones repetidas importa tanto como el éxito de una sola ejecución.
Análisis y criterio: cómo calcular la cuenta de costos de un agente médico
¿Cómo se reparten el trabajo los modelos de alta capacidad y los modelos de bajo costo en un agente médico?
Los datos de referencia muestran que el porcentaje de puntos de evaluación de Luna es 2.5 puntos porcentuales inferior al de Astra, pero su costo es solo aproximadamente 2% del de Astra. Esto indica que, en tareas administrativas con un alto grado de estructuración, los modelos de bajo costo ya tienen una capacidad de ejecución considerable. Sin embargo, una diferencia en los puntos de evaluación no equivale a una diferencia en la tasa de éxito de extremo a extremo. Si la parte de la puntuación que no obtuvieron recae justamente en pasos críticos como la carga de archivos o la actualización de estado, el resultado del negocio podría ser completamente distinto. Este es nuestro criterio, y debe verificarse con los datos de nuestras propias tareas.
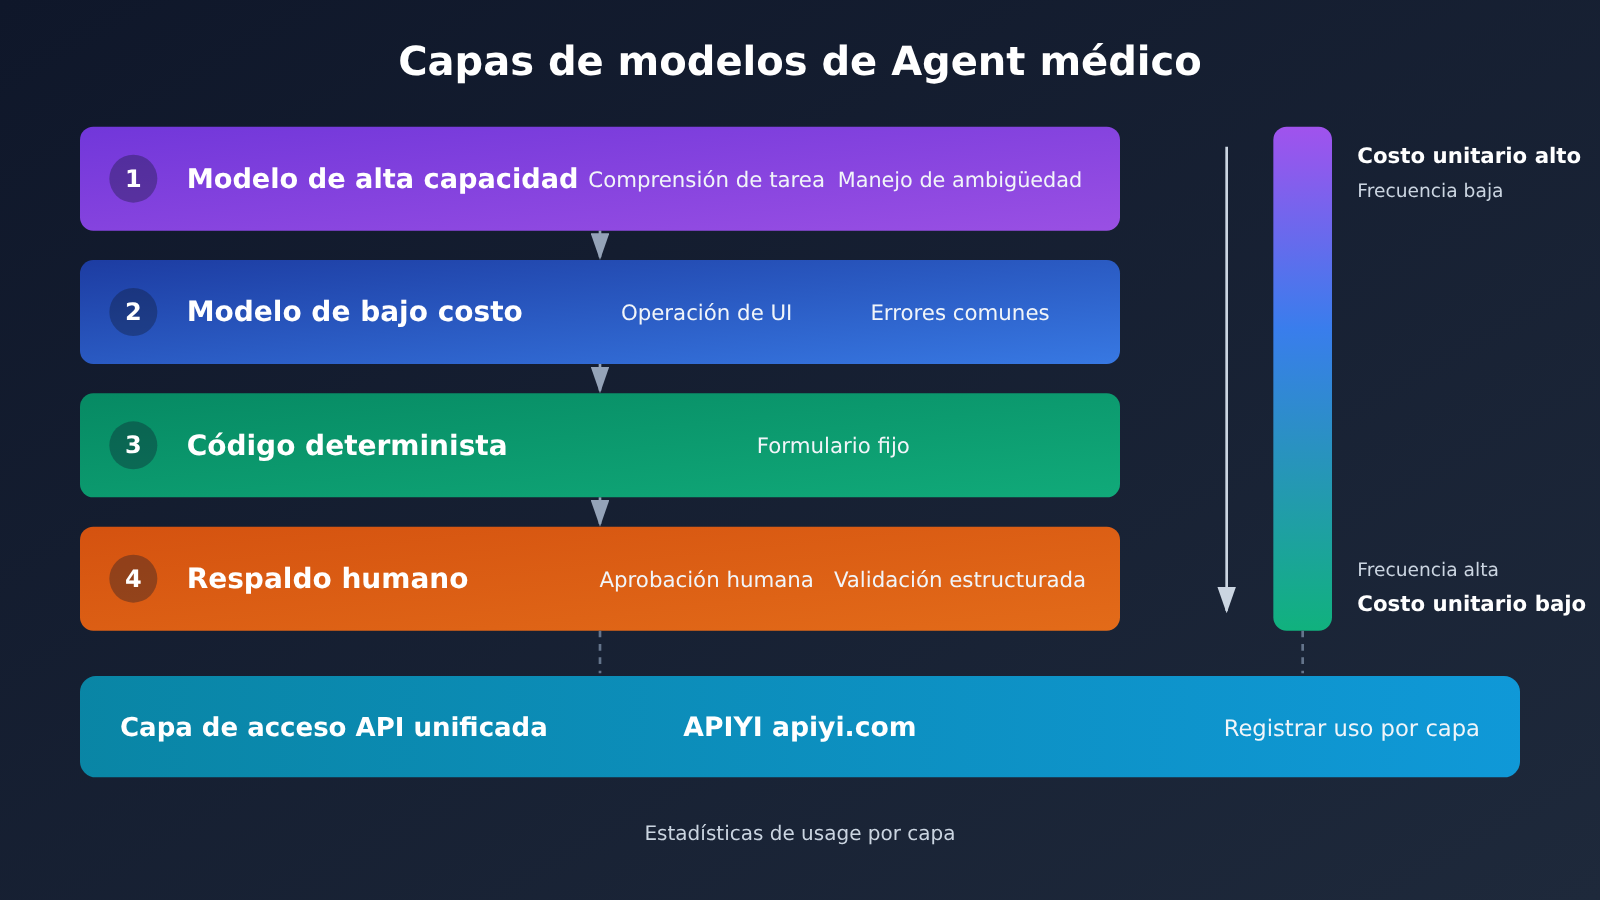
Un enfoque más prudente es distribuir por etapas, en lugar de usar un solo modelo para toda la tarea:
| Fase de trabajo | Responsable sugerido | Motivo |
|---|---|---|
| Comprender tareas complejas y descomponer pasos | Modelo de alta capacidad | El costo de error es alto y el número de invocaciones es bajo |
| Resolver ambigüedades e información imprecisa en la historia clínica | Modelo de alta capacidad de razonamiento + confirmación humana | La solución de Ambience se detiene ante ambigüedades y pregunta al médico |
| Operaciones rutinarias de interfaz | Modelo de bajo costo | Muchas invocaciones y máxima sensibilidad al precio unitario |
| Rellenar repetidamente formularios fijos | Código determinista | Basado en la idea de CUA Agent Kit de fijar estas partes en código |
| Gestión de excepciones habituales | Modelo de bajo costo o reglas | Patrones fijos que pueden convertirse gradualmente en reglas |
| Aprobación de operaciones críticas | Humano | Acciones como presentar, enviar o firmar conservan la aprobación humana final |
| Verificación del resultado final | Comprobación estructurada + revisión manual por muestreo | Se basa en el estado del sistema, no en la declaración de «completado» del modelo |
La ventaja de esta estratificación es que el modelo de precio unitario alto aparece solo en etapas de baja frecuencia y alto valor, mientras que las etapas de alta frecuencia se encomiendan a modelos de bajo costo o a código. Cuando coexisten varios modelos, una interfaz de invocación unificada reduce el costo de cambiar entre ellos. Por ejemplo, con una pasarela compatible con OpenAI como APIYI apiyi.com, los desarrolladores pueden comparar distintos modelos cambiando solo el parámetro model. Los modelos concretos disponibles dependen de la lista actual de modelos de la plataforma y de los permisos de la cuenta.
¿Cómo calcula un desarrollador el presupuesto de su proyecto de Agent médico?
Te sugerimos usar el siguiente marco de coste por tarea. Donde T es el número real de tokens y P es el precio por millón de tokens:
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (la parte cacheable se calcula aparte a precio de caché)
C_output = T_output × P_output / 1,000,000
C_image  = según las reglas de facturación visual del modelo, contando cada captura de pantalla por turno
C_retry  = solo los reintentos cuyo coste aún no está incluido en el total de tokens anterior

coste de una tarea exitosa = coste total de todas las tareas ÷ número de tareas exitosas
presupuesto mensual = coste de una tarea exitosa × objetivo mensual de tareas exitosas + inversión en mantenimiento de ingeniería
Lo que realmente determina la precisión del presupuesto son estas métricas medidas en la práctica: número medio de invocaciones por tarea, número medio de capturas de pantalla, tasa de reintentos fallidos, tasa de intervención humana y tasa de éxito end-to-end. Usar el «coste por tarea exitosa» en lugar del «coste por ejecución» como denominador te permite absorber el consumo de los fallos.
La tabla siguiente es un escenario de presupuesto que construimos nosotros mismos; todas las cifras de uso son supuestos y solo sirven para demostrar el método de cálculo. Los precios unitarios usan los precios oficiales Standard mencionados antes:
| Supuestos del escenario (construcción propia, no medidos) | Modelo de bajo coste (precio Luna) | Modelo de alta capacidad (precio Astra) |
|---|---|---|
| 15 turnos por tarea, 20 mil tokens de entrada visual + texto por turno | 300 mil × $0.10/M = $0.030 | 300 mil × $10/M = $3.00 |
| 500 tokens de salida por turno | 7,500 × $0.50/M ≈ $0.004 | 7,500 × $50/M = $0.375 |
| Coste de modelo por ejecución | ≈ $0.034 | ≈ $3.38 |
| Coste por tarea exitosa suponiendo una tasa de éxito end-to-end del 80% | ≈ $0.042 | ≈ $4.22 |
| Coste de modelo para 10,000 tareas exitosas al mes | ≈ $420 | ≈ $42,200 |
| Contenedor gestionado (4 GB, 4 tareas en serie cada 20 minutos) | ≈ $300/mes | ≈ $300/mes |
Este escenario revela algo que se pasa por alto fácilmente: cuando el modelo es lo bastante barato, el coste del entorno de ejecución puede quedar en el mismo orden de magnitud que el del modelo, o incluso ser mayor. La dirección de la optimización cambia entonces: de «cambiar a un modelo más barato» a «reducir los turnos de captura de pantalla, reutilizar contenedores y convertir los pasos fijos en código». Esto es una conclusión que sale del ejercicio de escenarios; la proporción real dependerá de tus datos medidos.
La forma más directa de recoger el uso real es registrar el campo usage después de cada invocación del modelo. Aquí tienes el ejemplo más simple:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # Consulte la lista de modelos del panel de APIYI
    messages=[{"role": "user", "content": "根据以下字段生成预授权申请核对清单:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
Ver el código completo de implementación para acumular costes por tarea
from dataclasses import dataclass, field
from openai import OpenAI

# Precios oficiales Standard de contexto corto al 2026-11-17 (USD por millón de tokens); los cargos reales dependen del tramo de facturación correspondiente
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Acceso unificado; en el panel puedes contrastar los registros de tokens y costos
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # Los tokens de las rondas reintentadas ya se acumularon en record; aquí no se vuelven a sumar
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 Consejo de presupuesto: primero elige entre 20 y 50 muestras de tareas reales para hacer una prueba a pequeña escala y luego realiza el cálculo mensual. Si usas el acceso unificado de APIYI apiyi.com, puedes contrastar el consumo de tokens y los registros de costos del panel para validar tus propias mediciones; la cuota de prueba gratuita para nuevos usuarios es suficiente para completar este paso.
Del precio del modelo a la gestión de costos de API: qué puede hacer un gateway para agentes médicos
Cuando un proyecto de agentes entra en la fase multimodelo, los costos se descontrolan no tanto porque el precio unitario sea alto, sino porque nadie sabe explicar qué eslabón o qué modelo consumió cuánto. El valor de una API Gateway está en reunir las llamadas dispersas en un solo punto: clave y endpoint unificados, registros de uso desglosados por modelo, detalles de costos rastreables. Solo con esa base el equipo puede detectar que un paso genera demasiadas capturas de pantalla, o que cierto tipo de anomalía dispara reintentos una y otra vez.
Tomemos APIYI como ejemplo. Según su documentación de inicio rápido, la integración consiste en registrar una cuenta, obtener la clave API en la página Token y luego reemplazar el endpoint original de OpenAI por https://api.apiyi.com; algunas aplicaciones requieren añadir /v1 al final de la dirección. Los SDK oficiales y los ejemplos de código se pueden usar directamente, y en el panel de administración se pueden consultar los modelos, el consumo de tokens y los registros de costos. La página indica que las tarifas de OpenAI y Claude coinciden con las oficiales, y admite la emisión de facturas. Para los equipos que necesitan estratificar y comparar entre varios modelos, APIYI, en apiyi.com, ofrece una capa de acceso con facturación por consumo y medición unificada.
También conviene dejar claros sus límites. Un gateway de API resuelve la conexión y la medición de la invocación del modelo, pero no es un ejecutor de agentes: el entorno de navegador y escritorio, la captura de pantallas, el control de permisos de negocio, los procesos de aprobación manual y el mantenimiento del flujo de trabajo siguen siendo responsabilidad del desarrollador. En escenarios médicos, el cumplimiento de HIPAA también depende de la elegibilidad del producto correspondiente, del BAA, de la configuración de seguridad y de la gobernanza de datos; no se cumple de forma automática solo porque se cambie la forma de acceso. Que un modelo GPT-6 concreto se pueda invocar o no también depende de la lista de modelos vigente en la plataforma.
Volvamos a la cifra de 8.5 centavos: demuestra el potencial de los modelos de bajo costo en la automatización administrativa de alta frecuencia, pero no responde a cuánto costará su flujo de trabajo. La respuesta solo puede venir de sus propias muestras de tareas, de su propia tasa de éxito y de sus propios registros de uso. Como dice ese proverbio en inglés:
The proof of the pudding is in the eating.
(Para saber si el pudding está bueno hay que probarlo; los resultados reales se comprueban en la práctica.)
Referencias
- Anuncio de OpenAI sobre el agente de Computer Use para el sector sanitario: fuente original de las puntuaciones de HealthAdminBench y del costo por tarea individual
- Enlace:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Enlace:
- Página de precios de la API de OpenAI: precios por token de GPT-6 Astra y GPT-6 Luna, y costos de contenedores
- Enlace:
developers.openai.com/api/docs/pricing
- Enlace:
- Documentación para desarrolladores sobre Computer Use de OpenAI: los dos caminos de ejecución, Computer Tool y Code Execution
- Enlace:
developers.openai.com/api/docs/guides/tools-computer-use
- Enlace:
- Artículo de HealthAdminBench v1: versión específica con 135 tareas y 1698 subtareas
- Enlace:
arxiv.org/html/2604.09937v1
- Enlace:
- CVS Health CUA Agent Kit: implementación de código abierto para exploración con IA y consolidación de código
- Enlace:
github.com/cvs-health/cua-agent-kit
- Enlace:
- Estudio comparativo sobre RPA: diseño de ejecuciones repetidas y aclaraciones sobre excepciones
- Enlace:
doi.org/10.1080/23311975.2026.2724760
- Enlace:
- Verificación del significado del refrán: Cambridge Dictionary
- Enlace:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: puedes ponerte en contacto con nosotros desde la página principal de APIYI apiyi.com; para más instrucciones de integración, visita la documentación en docs.apiyi.com


