
Ya, dalam kondisi tertentu — tetapi lingkungan produksi tidak bisa begitu saja meniru angka ini. Pada 16 November 2026, OpenAI mengungkapkan bahwa biaya per tugas GPT-6 Luna pada benchmark administrasi medis HealthAdminBench adalah 0.085 dolar, 98% lebih rendah daripada GPT-6 Astra. Angka ini berasal dari pengujian benchmark, bukan dari harga penawaran untuk penerapan produksi di rumah sakit.
Biaya Agent juga tidak bisa dihitung secara sederhana berdasarkan harga satuan per juta Token. Satu tugas Computer Use mencakup beberapa putaran pemanggilan model, input tangkapan layar, eksekusi alat, percobaan ulang saat gagal, dan lingkungan runtime; yang benar-benar perlu dihitung adalah biaya tugas secara keseluruhan. Bagi pengembang, stratifikasi model yang wajar, cache, pemantapan alur kerja, dan pemantauan biaya jauh lebih penting daripada memilih model dengan harga satuan terendah.
Apa saja yang bisa Anda pahami tentang biaya Agent medis setelah membaca artikel ini?
- Dalam kondisi pengujian seperti apa 8.5 sen diperoleh, mana yang merupakan nilai resmi yang diungkapkan, dan mana yang merupakan estimasi hasil perhitungan balik
- Bagian apa saja yang membentuk biaya satu tugas Agent medis secara lengkap, dan bagaimana tangkapan layar, pemanggilan multi-putaran, serta percobaan ulang menaikkan biaya
- Bagaimana melakukan stratifikasi model, dan bagaimana memperkirakan anggaran proyek Agent Anda dengan rumus serta volume tugas bulanan
Indeks Artikel: Dari Mana Mulai Membaca Rincian Biaya Agent Medis
Bagian fakta objektif terlebih dahulu menjelaskan 8.5 sen AS itu mengacu pada benchmark yang mana dan memakai standar penilaian seperti apa, lalu menguraikan mengapa harga satuan Token tidak bisa mewakili biaya tugas. Setelah itu, artikel membedah enam sumber biaya dalam satu tugas Agent dan menggunakan CUA Agent Kit open source dari CVS Health untuk menunjukkan mengapa alur yang sudah tetap tidak perlu memanggil Model Bahasa Besar setiap kali. Bagian analisis dan penilaian membahas pembagian kerja antara model berkapabilitas tinggi dan model berbiaya rendah, memberikan rumus anggaran serta skenario perhitungan yang bisa langsung diterapkan, dan terakhir menjelaskan apa yang dapat dan tidak dapat diselesaikan oleh pengelolaan penggunaan di tingkat API.
Perlu Diketahui: Konsep Terkait Biaya Agent Medis
| Konsep | Penjelasan singkat |
|---|---|
| Computer Use | Kemampuan menyelesaikan tugas dengan mengamati antarmuka perangkat lunak serta melakukan klik dan input |
| EHR | Sistem rekam medis elektronik, yaitu sistem rekam medis yang digunakan rumah sakit |
| MCP | Protokol standar untuk menemukan dan memanggil alat eksternal |
| RPA | Cara otomasi yang menjalankan proses berulang sesuai aturan atau skrip yang telah dikonfigurasi |
| Rubric points | Poin penilaian yang diperoleh berdasarkan aturan evaluasi, mengukur sejauh mana sebagian persyaratan terpenuhi |
| Tingkat keberhasilan end-to-end | Proporsi tugas utuh yang memenuhi seluruh kondisi keberhasilan, lebih ketat daripada rasio poin penilaian |
| Trace | Bukti jejak yang mencatat proses eksekusi, tindakan operasi, dan status antarmuka |
| Maximum Reasoning Effort | Tingkat upaya penalaran tertinggi model, yang biasanya menghabiskan lebih banyak Token penalaran |
| Input cache | Mekanisme ketika prefiks input yang berulang ditagih dengan harga satuan yang lebih rendah |
Ringkasan Dampak: Apa Arti Biaya Agen Medis bagi Berbagai Pihak
- Pengembang dan pemimpin teknis: Angka benchmark resmi tidak bisa langsung dipakai untuk menyusun anggaran. Mekanisme eksekusi, tingkat penyelesaian end-to-end, dan biaya total perlu divalidasi berdasarkan tugas masing-masing, sekaligus memasukkan jumlah tangkapan layar, jumlah putaran pemanggilan, dan tingkat percobaan ulang ke dalam perhitungan.
- Institusi medis dan penanggung jawab alur kerja: Perlu membedakan demo sintetis, evaluasi vendor, pilot, dan kasus produksi. Biaya per tugas yang rendah tidak bisa menggantikan persetujuan manusia, hak akses minimum, dan konfigurasi log audit; langkah tata kelola ini sendiri juga menimbulkan biaya.
Fakta Objektif: Data di Balik 8,5 Sen Agen Medis
8.5 Apa Saja Tugas Agen Medis yang Bisa Diselesaikan dengan 8,5 Sen?
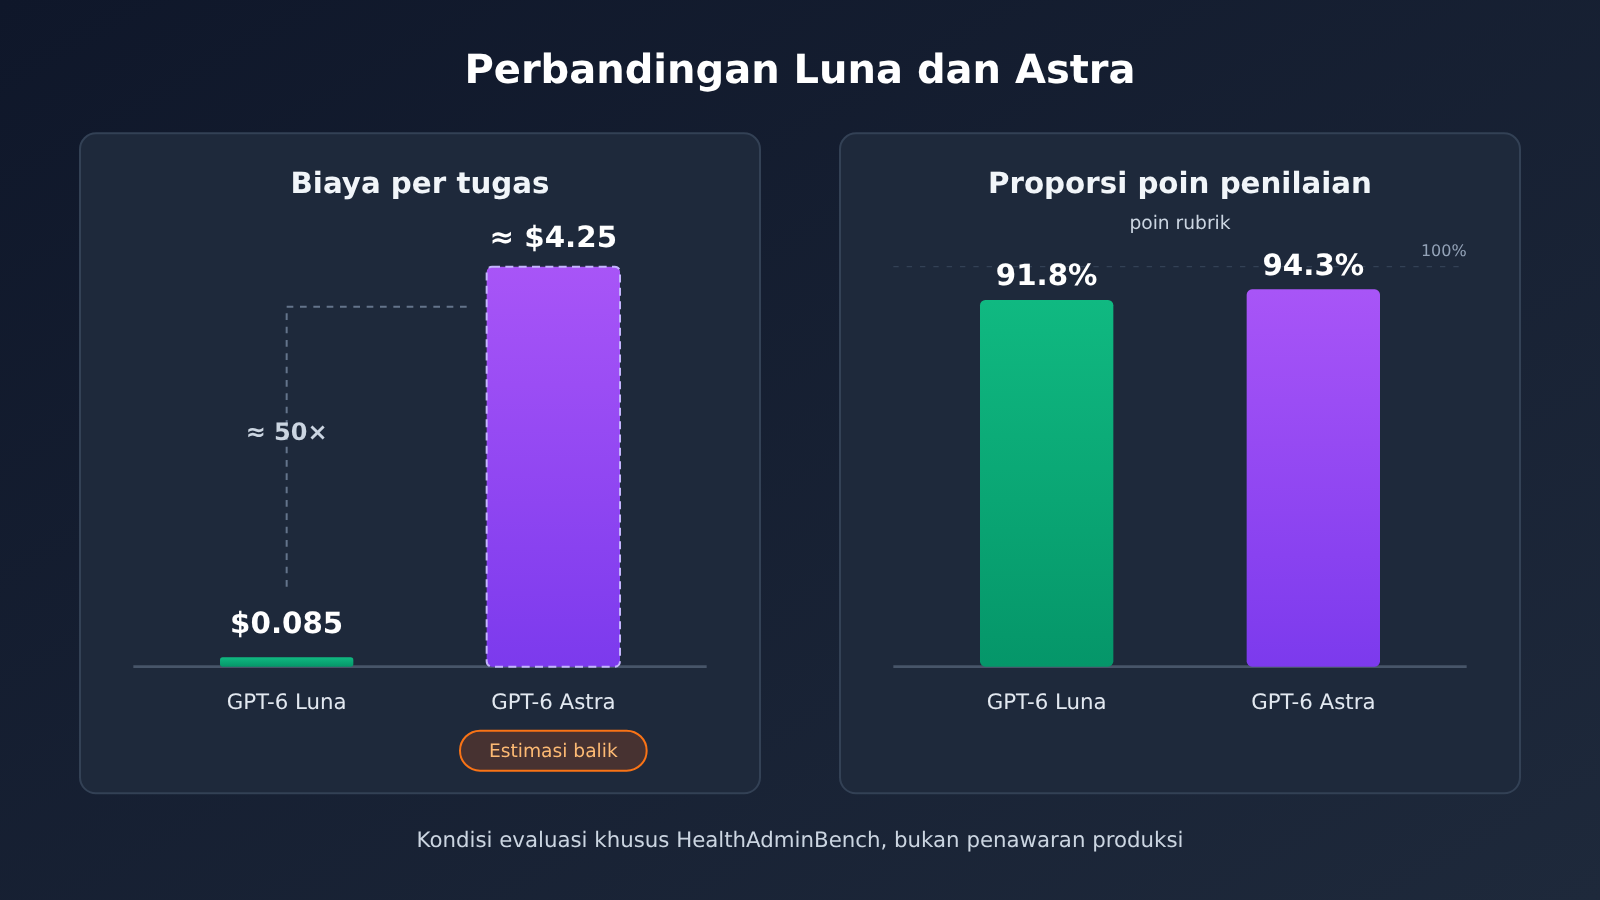
Angka 8,5 sen berasal dari pengumuman Computer Use Agent untuk medis yang dirilis OpenAI pada 16 November 2026. OpenAI mengevaluasi dua model dengan HealthAdminBench yang diperkenalkan Shah Lab Stanford; keduanya memakai tingkat penalaran tertinggi. Benchmark ini menguji tugas administratif seperti verifikasi kelayakan asuransi, pengajuan otorisasi pra-layanan, pemesanan peralatan medis, dan pemrosesan dokumen lintas sistem di lingkungan simulasi EHR, portal pembayar asuransi, dan sistem faks.
| Item | GPT-6 Luna | GPT-6 Astra | Sifat data |
|---|---|---|---|
| Skor HealthAdminBench | 91,8% | 94,3% | Diungkapkan resmi, proporsi poin rubrik |
| Biaya per tugas | $0,085 | sekitar $4,25 | Luna diungkapkan resmi; Astra diestimasi dari penurunan 98% |
| Biaya 1.000 tugas | $85 | sekitar $4.250 | Konversi linear berdasarkan basis benchmark; bukan penawaran produksi |
| Harga input (per juta Token) | $0,10 | $10,00 | Harga resmi Standard konteks pendek, dicek pada 2026-11-17 |
| Harga output (per juta Token) | $0,50 | $50,00 | Sama seperti di atas |
| Input cache (per juta Token) | $0,01 | $1,00 | Sama seperti di atas |
Nilai sekitar $4,25 untuk Astra berasal dari perhitungan 0,085 ÷ (1 − 0,98); itu adalah angka perkiraan, bukan harga yang diumumkan OpenAI secara terpisah. Angka 94,3% dan 91,8% juga bukan tingkat keberhasilan tugas penuh. Keduanya mengukur proporsi poin penilaian yang tersedia, jadi tidak boleh ditulis sebagai “94,3% pekerjaan administrasi rumah sakit sudah sepenuhnya otomatis”.
HealthAdminBench punya beberapa versi publik, jadi basis pengukurannya perlu dibedakan. Versi makalah 2604.09937v1 mencakup 135 tugas dan 1.698 subtugas; 1.177 di antaranya ditentukan oleh aturan deterministik, sedangkan 521 dinilai oleh model penilai. Dalam makalah, tingkat keberhasilan tugas penuh 36,3% dimiliki oleh Claude Opus 4.6 CUA, sedangkan tingkat keberhasilan subtugas 82,8% dimiliki oleh GPT-5.4 CUA. Versi yang dideskripsikan di halaman web awal Shah Lab mencakup 70 tugas dan 947 poin penilaian; versi itu hanya bisa dipakai sebagai pembanding historis. Hasil dari model, tanggal, kondisi eksekusi, dan metrik yang berbeda tidak bisa disusun menjadi satu daftar peringkat yang sama.
Mengapa tugas Agent medis tidak bisa hanya melihat harga satuan Token?
Dari tabel harga terlihat bahwa harga satuan input, output, dan input cache kedua model berbeda 100 kali. Dengan perhitungan penurunan 98%, biaya per tugas keduanya hanya berbeda sekitar 50 kali. Dari sini dapat disimpulkan bahwa konsumsi aktual kedua model dalam benchmark yang sama tidaklah identik. Jumlah putaran pemanggilan, jumlah Token input dan output, konsumsi inferensi, serta jumlah percobaan ulang bisa saja berbeda, sehingga biaya per tugas hanya bisa dihitung berdasarkan penggunaan nyata.
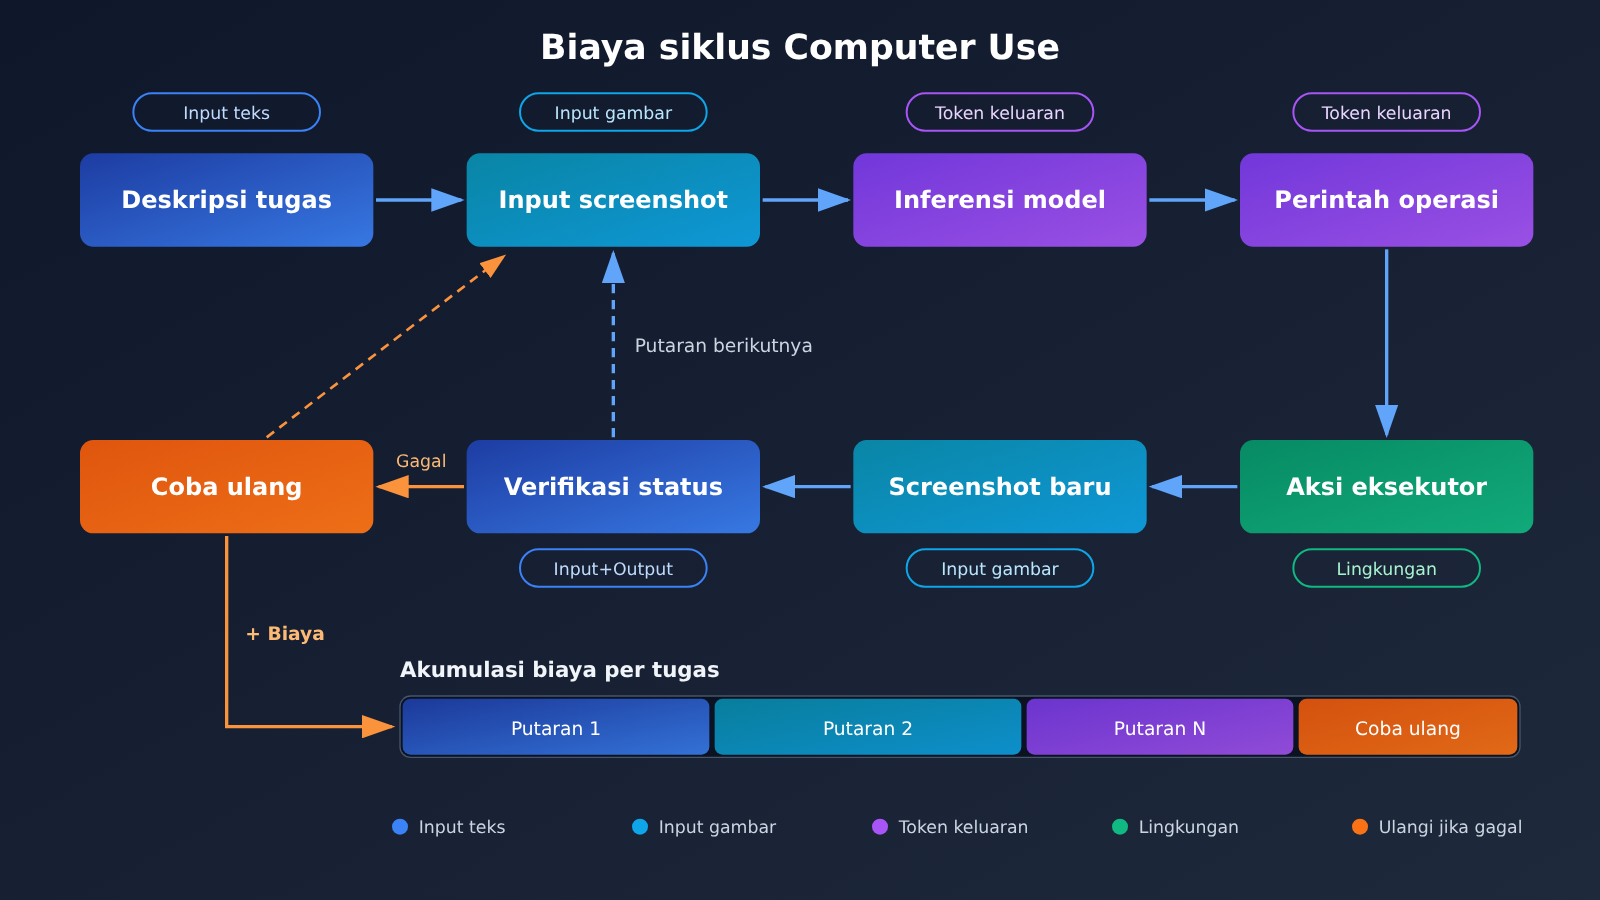
Alasan mendasarnya terletak pada cara eksekusi Computer Use. Menurut dokumentasi pengembang OpenAI, siklus tipikalnya adalah: menerima tugas, mengamati tangkapan layar, menghasilkan instruksi operasi, aplikasi mengeksekusi klik atau input, mengembalikan tangkapan layar baru, lalu model menilai langkah berikutnya, hingga tugas selesai atau meminta persetujuan manusia. Di setiap langkah, deskripsi tugas, konteks historis, dan tangkapan layar baru berpotensi dimasukkan kembali ke model.
Tanya jawab biasa mungkin hanya memerlukan satu pemanggilan, sedangkan alur pra-otorisasi lintas sistem bisa saja melewati belasan putaran “observasi, operasi, verifikasi” secara berurutan. Tangkapan layar termasuk input gambar yang menimbulkan biaya Token visual tersendiri, dan muncul di setiap putaran, sehingga paling mudah diremehkan. Perlu diingat juga: model yang menghasilkan instruksi operasi belum tentu berarti operasinya berhasil. Aplikasi harus mengeksekusi dan memverifikasi hasilnya, dan verifikasi itu sendiri juga mengonsumsi pemanggilan.
Di manakah uang untuk satu tugas Agent medis sebenarnya dihabiskan?
Jika satu tugas diuraikan, biayanya dapat dikelompokkan ke dalam enam kategori biaya langsung. Pemeliharaan engineering merupakan investasi berkelanjutan, sehingga lebih jelas jika dihitung secara terpisah.
| Kategori biaya | Penyebab | Poin pencatatan |
|---|---|---|
| Token input | Petunjuk sistem, deskripsi tugas, konteks historis, hasil yang dikembalikan alat | Diakumulasikan per giliran, bedakan bagian yang dapat di-cache |
| Token output | Instruksi operasi, kode yang dihasilkan, keputusan dan penalaran | Intensitas penalaran yang tinggi akan meningkatkan output secara signifikan |
| Input visual | Tangkapan layar setiap giliran dan pemahaman antarmuka | Dihitung terpisah berdasarkan aturan penagihan gambar model |
| Pemanggilan alat | Alat bawaan, browser terkelola, eksekusi kode | Token yang dikonsumsi alat bawaan ditagih sesuai model terkait |
| Lingkungan runtime | Browser, mesin virtual, kontainer | Hanya dihitung saat layanan terkait benar-benar digunakan |
| Percobaan ulang gagal | Anomali pemuatan halaman, kegagalan pelacakan elemen, kesalahan operasi | Jika Token percobaan ulang sudah masuk ke total, jangan dihitung dua kali |
Penagihan lingkungan runtime sangat bervariasi. Halaman harga OpenAI mencantumkan biaya kontainer Hosted Shell dan Code Interpreter sebagai berikut: 1 GB per 20 menit 0.03 dolar AS, 4 GB 0.12 dolar AS, 16 GB 0.48 dolar AS, 64 GB 1.92 dolar AS. Penyimpanan unggahan file dan gambar ditagih sebesar 0.10 dolar AS per GB-hari. Jika pengembang menjalankan Playwright atau eksekutor desktop di server mereka sendiri, bagian ini berubah menjadi biaya infrastruktur milik sendiri, dengan struktur yang sepenuhnya berbeda.
Oleh karena itu, saat menghitung perlu membedakan tiga lapisan: biaya model adalah biaya pemrosesan input dan output, biaya operasional adalah biaya infrastruktur seperti browser, server, dan kontainer, sedangkan biaya engineering adalah investasi tenaga kerja untuk desain alur kerja, pengujian, pemantauan, dan pemeliharaan. Jika hanya melihat lapisan pertama, anggaran pasti terlalu rendah.
Mengapa sebagian Agent medis tidak perlu memanggil Model Bahasa Besar setiap kali?
CVS Health mengungkapkan kasus di lingkungan produksi dalam pengumumannya. Sebuah Agent membersihkan tugas pengiriman file yang menumpuk selama beberapa bulan hanya dalam satu akhir pekan, sementara Agent lain setiap hari menangani puluhan ribu langkah operasi sistem dalam konsultasi spesialis. “Puluhan ribu kali” di sini merujuk pada langkah operasi, bukan keputusan klinis yang diselesaikan secara mandiri oleh AI. Sistem ini juga dilengkapi dengan pemeriksaan validasi, pengawasan manusia, serta verifikasi status berdasarkan tangkapan layar dan catatan operasi.
Yang lebih patut diperhatikan pengembang adalah CUA Agent Kit yang dirilis sebagai open source oleh CVS (lisensi Apache-2.0). Kit ini membagi otomatisasi menjadi dua tahap: pertama, OpenAI Computer Use Agent menjalankan tugas sesuai bahasa alami, merekam tangkapan layar, aksi, posisi target, dan Trace; kemudian Codex Skill, berdasarkan lintasan yang berhasil, menghasilkan atau memperbarui kode alur kerja deterministik, yang kemudian ditinjau oleh engineer. README menjelaskan bahwa tahap eksekusi deterministik tidak memerlukan kunci API model.
Desain ini langsung menyasar masalah biaya: saat mengeksplorasi alur yang belum diketahui, diperlukan penalaran Model Bahasa Besar; saat mengeksekusi alur yang sudah diketahui secara berulang, tugas diserahkan kepada kode biasa. Selama alur stabil, satu kali eksekusi tidak lagi membayar biaya input visual dan penalaran, dan fluktuasi hasil juga mengecil. Salah satu pandangan inti proyek ini adalah bahwa “menemukan cara menyelesaikan tugas” dan “mengeksekusi secara berulang dengan stabil dalam jangka panjang” adalah dua masalah yang berbeda.
Hubungan antara RPA tradisional dan Agent juga dapat dipahami dari sudut pandang ini. Dalam sebuah studi perbandingan RPA (DOI: 10.1080/23311975.2026.2724760), tugas P2 dan P3 masing-masing dijalankan 10 kali untuk setiap teknologi, sedangkan Agent pada tugas P1 hanya dijalankan 1 kali dan gagal, sehingga tidak dimasukkan dalam statistik selanjutnya. Oleh karena itu, tidak bisa dikatakan secara umum bahwa “semua tugas dijalankan 10 kali”. Studi tersebut menggunakan konfigurasi alat dari tahun 2025, sehingga tidak dapat dianggap sebagai hasil langsung dari model tahun 2026. Namun, studi ini memberikan satu petunjuk: ketika mengevaluasi solusi otomatisasi, stabilitas eksekusi berulang sama pentingnya dengan keberhasilan satu kali eksekusi.
Analisis dan penilaian: bagaimana menghitung biaya Agent medis
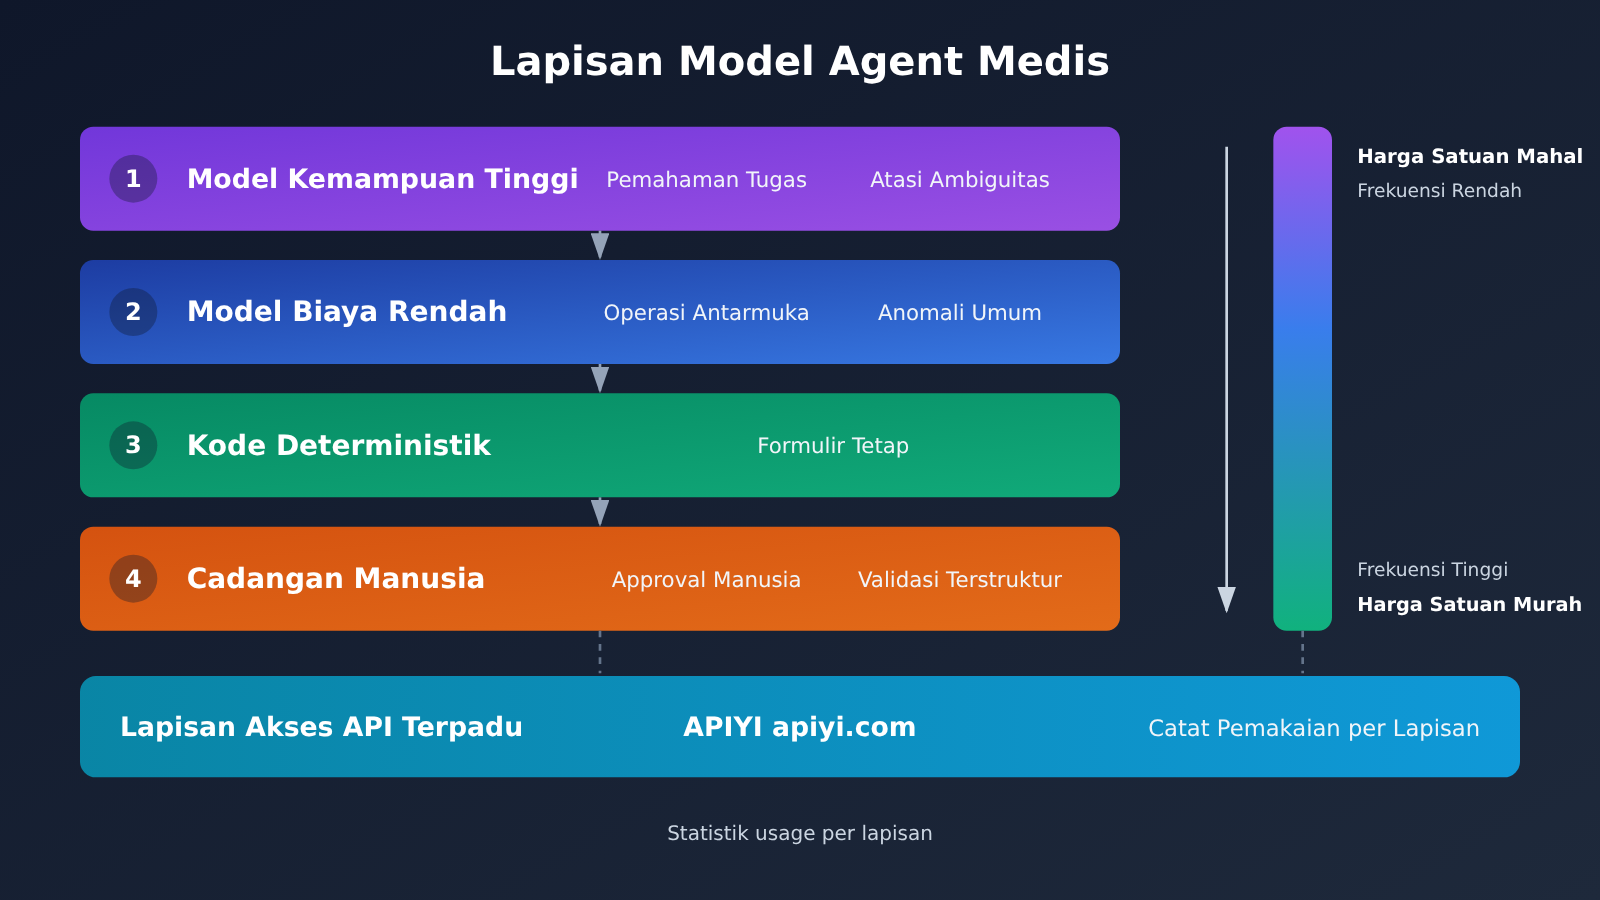
Bagaimana model berkemampuan tinggi dan model berbiaya rendah membagi peran dalam Agent medis?
Data tolok ukur menunjukkan bahwa proporsi poin penilaian Luna sekitar 2,5 poin persentase lebih rendah daripada Astra, tetapi biayanya hanya sekitar 2% dari biaya Astra. Ini menunjukkan bahwa pada tugas administratif yang tingkat strukturnya tinggi, model berbiaya rendah sudah memiliki kemampuan eksekusi yang cukup memadai. Namun, selisih poin penilaian tidak sama dengan selisih tingkat keberhasilan end-to-end; jika poin yang hilang justru jatuh pada langkah-langkah kunci seperti unggah berkas atau pembaruan status, hasil bisnisnya bisa sangat berbeda. Ini adalah penilaian kami, dan perlu diverifikasi dengan data tugas kita sendiri.
Pendekatan yang lebih aman adalah membagi peran berdasarkan tahapan, bukan memakai satu model saja untuk seluruh tugas:
| Tahap kerja | Pihak yang disarankan | Alasan |
|---|---|---|
| Memahami tugas kompleks, menguraikan langkah | Model berkemampuan tinggi | Biaya kesalahan tinggi, jumlah pemanggilan sedikit |
| Menangani ambiguitas rekam medis dan informasi kabur | Model penalaran tinggi + konfirmasi manusia | Solusi Ambience berhenti dan bertanya kepada dokter saat ada ambiguitas |
| Operasi antarmuka rutin | Model berbiaya rendah | Jumlah pemanggilan banyak, paling sensitif terhadap harga satuan |
| Pengisian formulir tetap secara berulang | Kode deterministik | Mengacu pada pendekatan pengkodean CUA Agent Kit |
| Penanganan anomali umum | Model berbiaya rendah atau aturan | Polanya tetap, bisa diendapkan menjadi aturan secara bertahap |
| Persetujuan operasi kunci | Manusia | Aksi seperti submit, kirim, dan tanda tangan tetap menyimpan otorisasi akhir pada manusia |
| Verifikasi hasil akhir | Pemeriksaan terstruktur + sampling manusia | Berpatokan pada status sistem, bukan klaim “selesai” dari model |
Keuntungan dari pelapisan ini adalah model dengan harga satuan tinggi hanya muncul pada segmen frekuensi rendah yang bernilai tinggi, sementara segmen frekuensi tinggi diserahkan kepada model berbiaya rendah atau kode. Ketika beberapa model digunakan bersamaan, antarmuka pemanggilan yang terpadu dapat menurunkan biaya peralihan. Misalnya, melalui gateway kompatibel OpenAI seperti APIYI apiyi.com, pengembang hanya perlu mengubah parameter model untuk membandingkan berbagai model. Model yang tersedia secara spesifik mengikuti daftar model dan izin akun platform saat ini.
Bagaimana developer menghitung anggaran proyek Agent medis mereka sendiri?
Sebaiknya gunakan kerangka biaya per tugas berikut. Di sini T adalah jumlah Token aktual, dan P adalah harga per juta Token:
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (bagian yang dapat di-cache dicatat terpisah dengan harga cache)
C_output = T_output × P_output / 1,000,000
C_image  = sesuai aturan penagihan visual model, dihitung terpisah untuk setiap putaran tangkapan layar
C_retry  = hanya menghitung biaya retry yang belum dimasukkan ke total Token di atas

Biaya per tugas sukses = total biaya seluruh tugas ÷ jumlah tugas sukses
Anggaran bulanan = biaya per tugas sukses × target tugas sukses bulanan + investasi pemeliharaan rekayasa
Yang benar-benar menentukan akurasi anggaran adalah beberapa metrik hasil pengukuran ini: rata-rata jumlah putaran pemanggilan per tugas, rata-rata jumlah tangkapan layar, tingkat retry gagal, tingkat keterlibatan manusia, dan tingkat keberhasilan end-to-end. Dengan memakai “biaya per tugas sukses” alih-alih “biaya per sekali jalan” sebagai penyebut, konsumsi dari tugas yang gagal ikut terhitung.
Tabel berikut adalah skenario anggaran yang kami susun sendiri; semua angka penggunaan hanyalah asumsi, semata-mata untuk mendemonstrasikan cara perhitungannya. Harga satuan memakai harga resmi Standard dari artikel sebelumnya:
| Asumsi skenario (buatan sendiri, bukan hasil pengukuran) | Model berbiaya rendah (harga satuan Luna) | Model berkemampuan tinggi (harga satuan Astra) |
|---|---|---|
| 15 putaran per tugas, setiap putaran input visual + teks 20 ribu Token | 300 ribu × $0.10/M = $0.030 | 300 ribu × $10/M = $3.00 |
| Output 500 Token per putaran | 7.500 × $0.50/M ≈ $0.004 | 7.500 × $50/M = $0.375 |
| Biaya model per sekali jalan | sekitar $0.034 | sekitar $3.38 |
| Biaya per tugas sukses setelah asumsi tingkat keberhasilan end-to-end 80% | sekitar $0.042 | sekitar $4.22 |
| Biaya model untuk 10.000 tugas sukses per bulan | sekitar $420 | sekitar $42.200 |
| Kontainer terkelola (4 GB, 4 tugas serial setiap 20 menit) | sekitar $300/bulan | sekitar $300/bulan |
Skenario ini memperlihatkan satu fenomena yang mudah terlewat: ketika model sudah cukup murah, biaya lingkungan runtime bisa berada pada orde yang sama dengan biaya model, bahkan lebih tinggi. Arah optimasi pun ikut berubah, dari “ganti ke model yang lebih murah” menjadi “kurangi putaran tangkapan layar, gunakan ulang kontainer, ubah langkah-langkah tetap menjadi kode”. Ini adalah penilaian yang diperoleh dari simulasi skenario; proporsi sebenarnya harus mengacu pada data pengukuran Anda sendiri.
Cara paling langsung untuk mengumpulkan penggunaan nyata adalah mencatat field usage setelah setiap pemanggilan model. Berikut contoh paling sederhana:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # antarmuka kompatibel OpenAI APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # sesuai daftar model di dasbor APIYI
    messages=[{"role": "user", "content": "根据以下字段生成预授权申请核对清单:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
Lihat kode implementasi lengkap untuk akumulasi biaya per tugas
from dataclasses import dataclass, field
from openai import OpenAI

# Harga resmi Standard konteks pendek per 2026-11-17 (USD/juta Token); tagihan aktual mengikuti tier penagihan yang berlaku
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Akses terpadu; log Token dan biaya bisa dicek di dasbor
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # Token dari ronde percobaan ulang sudah terakumulasi di record, jadi tidak dihitung ulang di sini
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 Saran anggaran: mulailah dengan memilih 20 sampai 50 sampel tugas nyata untuk uji coba skala kecil, lalu lakukan perhitungan bulanan. Saat mengakses secara terpadu lewat APIYI apiyi.com, Anda bisa mencocokkan konsumsi Token dan log biaya di dasbor untuk memverifikasi hasil pengukuran Anda sendiri — kuota uji gratis untuk pengguna baru sudah cukup untuk menyelesaikan langkah ini.
Dari harga model hingga pengelolaan biaya API: apa yang bisa dilakukan gateway Agent medis
Setelah proyek Agent masuk ke tahap multi-model, biaya yang membengkak biasanya bukan karena harga satuannya tinggi, melainkan karena tidak ada yang bisa menjelaskan dengan gamblang bagian mana dan model mana yang menghabiskan berapa banyak. Nilai API Gateway terletak pada kemampuannya menyatukan panggilan yang tersebar ke satu tempat: Key dan Endpoint yang seragam, log penggunaan yang dipecah per model, serta rincian biaya yang dapat dilacak kembali. Dengan begitu, tim dapat menemukan bahwa suatu langkah mengambil tangkapan layar terlalu banyak, atau suatu jenis anomali berulang kali memicu percobaan ulang.
Sebagai contoh, APIYI—berdasarkan dokumentasi panduan memulai cepatnya—cara integrasinya adalah mendaftarkan akun, mendapatkan kunci API di halaman Token, lalu mengganti Endpoint OpenAI asli dengan https://api.apiyi.com; sebagian aplikasi perlu menambahkan /v1 setelah alamat tersebut. SDK resmi dan contoh kode dapat langsung digunakan. Di dasbor, model, konsumsi Token, dan log biaya dapat dilihat; halaman tersebut mencantumkan tarif OpenAI dan Claude yang sesuai dengan tarif resmi, serta mendukung penerbitan faktur. Bagi tim yang perlu melakukan pelapisan dan perbandingan antar beberapa model, APIYI apiyi.com menyediakan lapisan akses dengan penagihan sesuai pemakaian dan pengukuran terpadu.
Batasannya juga perlu dijelaskan dengan jelas. API gateway menyelesaikan masalah akses dan pengukuran pemanggilan model, bukan sebagai eksekutor Agent: lingkungan browser dan desktop, pengambilan tangkapan layar, kontrol izin bisnis, alur persetujuan manual, dan pemeliharaan alur kerja tetap harus dibangun sendiri oleh pengembang. Dalam konteks medis, kepatuhan HIPAA juga bergantung pada kelayakan produk yang berlaku, BAA, konfigurasi keamanan, dan tata kelola data; hal itu tidak otomatis terpenuhi hanya karena jalur integrasinya berubah. Apakah model GPT-6 tertentu dapat dipanggil juga harus mengacu pada daftar model platform saat ini.
Kembali ke angka 8.5 sen: angka itu membuktikan potensi model berbiaya rendah dalam otomasi administratif berfrekuensi tinggi, tetapi tidak bisa menjawab berapa biaya yang akan dikeluarkan alur kerja Anda. Jawabannya hanya bisa berasal dari sampel tugas Anda sendiri, tingkat keberhasilan Anda sendiri, dan log penggunaan Anda sendiri. Seperti kata pepatah Inggris:
The proof of the pudding is in the eating.
(Puding enak atau tidak baru ketahuan setelah dimakan; hasil nyata perlu diuji melalui praktik.)
Referensi
- Pengumuman Computer Use Agent OpenAI untuk Layanan Kesehatan: sumber asli skor HealthAdminBench dan biaya per tugas
- Tautan:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Tautan:
- Halaman harga OpenAI API: harga Token GPT-6 Astra dan GPT-6 Luna serta biaya kontainer
- Tautan:
developers.openai.com/api/docs/pricing
- Tautan:
- Dokumentasi pengembang OpenAI Computer Use: loop eksekusi serta dua jalur, yaitu Computer Tool dan Code Execution
- Tautan:
developers.openai.com/api/docs/guides/tools-computer-use
- Tautan:
- Makalah HealthAdminBench v1: versi eksplisit dengan 135 tugas dan 1.698 subtugas
- Tautan:
arxiv.org/html/2604.09937v1
- Tautan:
- CVS Health CUA Agent Kit: implementasi sumber terbuka untuk eksplorasi AI dan pemantapan kode
- Tautan:
github.com/cvs-health/cua-agent-kit
- Tautan:
- Studi perbandingan RPA: desain eksekusi berulang dan penjelasan pengecualian
- Tautan:
doi.org/10.1080/23311975.2026.2724760
- Tautan:
- Pemeriksaan makna peribahasa: Cambridge Dictionary
- Tautan:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda APIYI apiyi.com. Untuk petunjuk integrasi lebih lanjut, kunjungi pusat dokumentasi docs.apiyi.com


