
Sim, sob certas condições — mas não dá para simplesmente copiar esse número no ambiente de produção. Em 16 de novembro de 2026, a OpenAI divulgou que o custo por tarefa do GPT-6 Luna no benchmark de administração em saúde HealthAdminBench é de US$ 0,085, ou 98% menos que o GPT-6 Astra. Esse número vem de um benchmark, e não de um orçamento para implantação em produção num hospital.
O custo de um Agente também não pode ser calculado simplesmente pelo preço unitário por milhão de tokens. Uma tarefa de Computer Use envolve múltiplas invocações do modelo, entrada de capturas de tela, execução de ferramentas, novas tentativas em caso de falha e o ambiente de execução; o que realmente precisa ser contabilizado é o custo completo da tarefa. Para quem desenvolve, ter uma estratificação de modelos bem feita, cache, consolidação de fluxos de trabalho e monitoramento de custos importa mais do que escolher o modelo com o menor preço unitário.
O que você vai descobrir sobre os custos de Agentes médicos neste artigo?
- Sob que condições de teste os 8,5 centavos foram obtidos, quais valores são divulgações oficiais e quais são estimativas por engenharia reversa
- Quais partes compõem o custo de uma tarefa completa de um Agente médico e como capturas de tela, múltiplas invocações e novas tentativas inflam a conta
- Como fazer a estratificação de modelos e como estimar o orçamento do seu projeto de Agente usando fórmulas e o volume mensal de tarefas
Índice deste artigo: por onde começar a entender o custo de um agente médico
A parte de fatos objetivos começa explicando a qual benchmark correspondem os 8,5 centavos de dólar e qual é o critério de pontuação; em seguida, mostra por que o preço unitário de um token não representa o custo da tarefa. Depois, decompomos as seis categorias de custo de uma tarefa de Agent e usamos o CUA Agent Kit, código aberto da CVS Health, para explicar por que um fluxo fixo não precisa invocar o Modelo de Linguagem Grande a cada execução. A parte de análise e julgamento discute a divisão de trabalho entre modelos de alta capacidade e modelos de baixo custo, apresenta uma fórmula de orçamento pronta para aplicar e cenários de estimativa e, por fim, explica o que a gestão de uso no nível da API resolve — e o que não resolve.
To Know: conceitos de custo de agentes médicos
| Conceito | Explicação breve |
|---|---|
| Computer Use | Capacidade de concluir tarefas observando a interface do software e realizando ações como cliques e entrada de dados |
| EHR | Sistema de registro eletrônico de saúde; na prática, o sistema de prontuário eletrônico usado por hospitais |
| MCP | Protocolo padrão para descobrir e chamar ferramentas externas |
| RPA | Automação que executa processos repetitivos com base em regras ou scripts previamente configurados |
| Rubric points | Pontos atribuídos conforme as regras de avaliação, que medem o cumprimento de parte dos requisitos |
| Taxa de sucesso ponta a ponta | Proporção de tarefas concluídas que atendem a todas as condições de sucesso; é mais rigorosa do que a proporção de pontos de avaliação |
| Trace | Evidência de rastreamento que registra o processo de execução, as ações realizadas e o estado da interface |
| Maximum Reasoning Effort | Nível máximo de esforço de raciocínio do modelo, que costuma consumir mais tokens de raciocínio |
| Entrada em cache | Mecanismo pelo qual prefixos de entrada repetidos são cobrados a um preço unitário menor |
Visão rápida do impacto: o que o custo do Agente médico significa para quem
- Desenvolvedores e líderes técnicos: não dá para pegar os números de referência oficiais e reportar orçamento diretamente. É preciso validar o mecanismo de execução, a taxa de conclusão ponta a ponta e o custo completo com base nas suas próprias tarefas — e incluir na conta o volume de capturas de tela, o número de rodadas de invocação e a taxa de repetição.
- Instituições de saúde e responsáveis por fluxos de trabalho: é fundamental distinguir demonstrações sintéticas, avaliações de fornecedores, pilotos e casos em produção. Um custo baixo por tarefa não substitui a aprovação humana, o princípio do menor privilégio e a configuração de logs de auditoria — essas próprias medidas de governança também geram custos.
Fatos objetivos: os dados por trás dos 8,5 centavos de dólar do Agente médico
O que 8,5 centavos de dólar podem fazer em tarefas de agente médico?
Os 8,5 centavos vêm do anúncio do Computer Use Agent médico da OpenAI, publicado em 16 de novembro de 2026. A OpenAI avaliou dois modelos com o HealthAdminBench, proposto pelo Shah Lab de Stanford, ambos com o nível máximo de esforço de raciocínio. Esse benchmark examina, em EHRs simulados, portais de operadoras de planos de saúde e sistemas de fax, tarefas administrativas como verificação de elegibilidade do seguro, solicitações de pré-autorização, pedidos de equipamentos médicos e processamento de documentos entre sistemas.
| Item | GPT-6 Luna | GPT-6 Astra | Natureza dos dados |
|---|---|---|---|
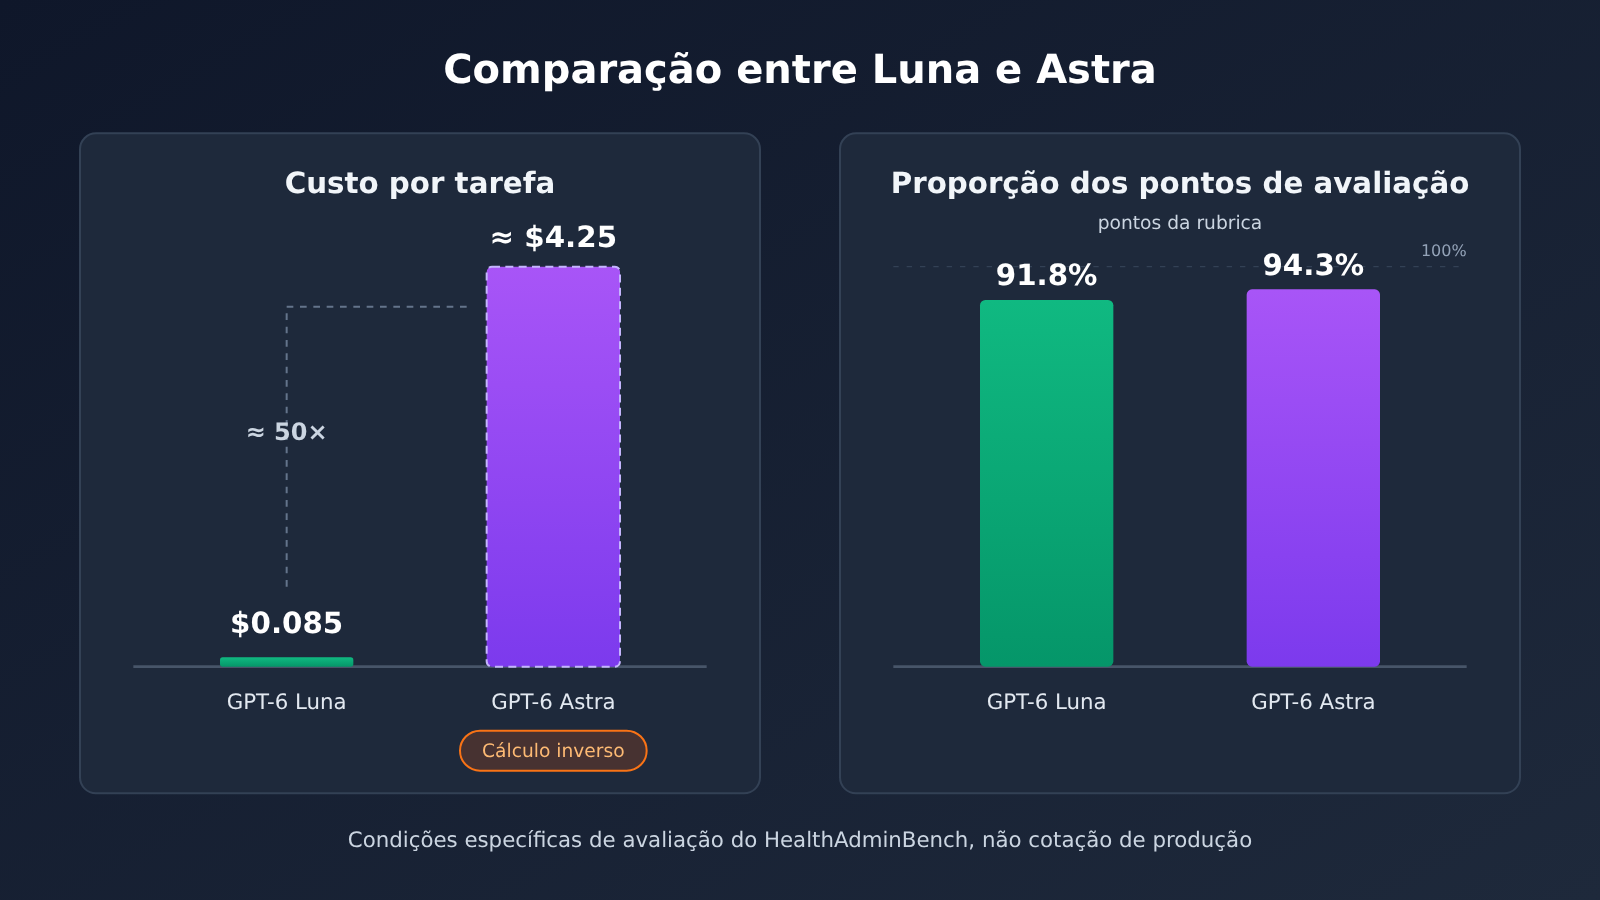
| Pontuação no HealthAdminBench | 91,8% | 94,3% | Divulgado oficialmente; proporção de pontos de rubrica |
| Custo por tarefa | US$ 0,085 | cerca de US$ 4,25 | Luna divulgado oficialmente; Astra inferido a partir de uma redução de 98% |
| Custo para 1.000 tarefas | US$ 85 | cerca de US$ 4.250 | Conversão linear nas condições do benchmark; não é uma cotação de produção |
| Preço de entrada (por milhão de tokens) | US$ 0,10 | US$ 10,00 | Preço oficial Standard de contexto curto, consultado em 17/11/2026 |
| Preço de saída (por milhão de tokens) | US$ 0,50 | US$ 50,00 | Idem |
| Entrada em cache (por milhão de tokens) | US$ 0,01 | US$ 1,00 | Idem |
O valor de cerca de US$ 4,25 do Astra vem do cálculo 0,085 ÷ (1 − 0,98). É um valor aproximado, e não um preço publicado separadamente pela OpenAI. Já 94,3% e 91,8% também não são taxas de sucesso em tarefas completas. Eles medem a proporção dos pontos de rubrica disponíveis que foram obtidos, e não podem ser descritos como “94,3% do trabalho administrativo hospitalar já está totalmente automatizado”.
O HealthAdminBench tem várias versões públicas, e é preciso distinguir os critérios de avaliação. A versão 2604.09937v1 do artigo inclui 135 tarefas e 1.698 subtarefas, das quais 1.177 são decididas por regras determinísticas e 521 são pontuadas por um modelo na função de juiz. No artigo, a taxa de sucesso em tarefas completas de 36,3% pertence ao Claude Opus 4.6 CUA, e a taxa de sucesso em subtarefas de 82,8% pertence ao GPT-5.4 CUA. A descrição inicial na página do Shah Lab se refere a uma versão com 70 tarefas e 947 pontos de avaliação, que serve apenas como comparação histórica. Resultados de modelos, datas, condições de execução e métricas diferentes não podem ser reunidos em um mesmo ranking.
Por que as tarefas de um Agente Médico não podem ser avaliadas apenas pelo preço unitário de Token?
Olhando a tabela de preços, os preços unitários de entrada, saída e entrada em cache dos dois modelos diferem por um fator de 100. Considerando uma queda de 98%, o custo por tarefa dos dois difere em apenas cerca de 50 vezes. Disso dá para inferir que o consumo real dos dois modelos num mesmo benchmark não é igual. O número de rodadas de invocação, a quantidade de Tokens de entrada e saída, o consumo de raciocínio e o número de novas tentativas podem variar, então o custo por tarefa só pode ser calculado com base no uso real.
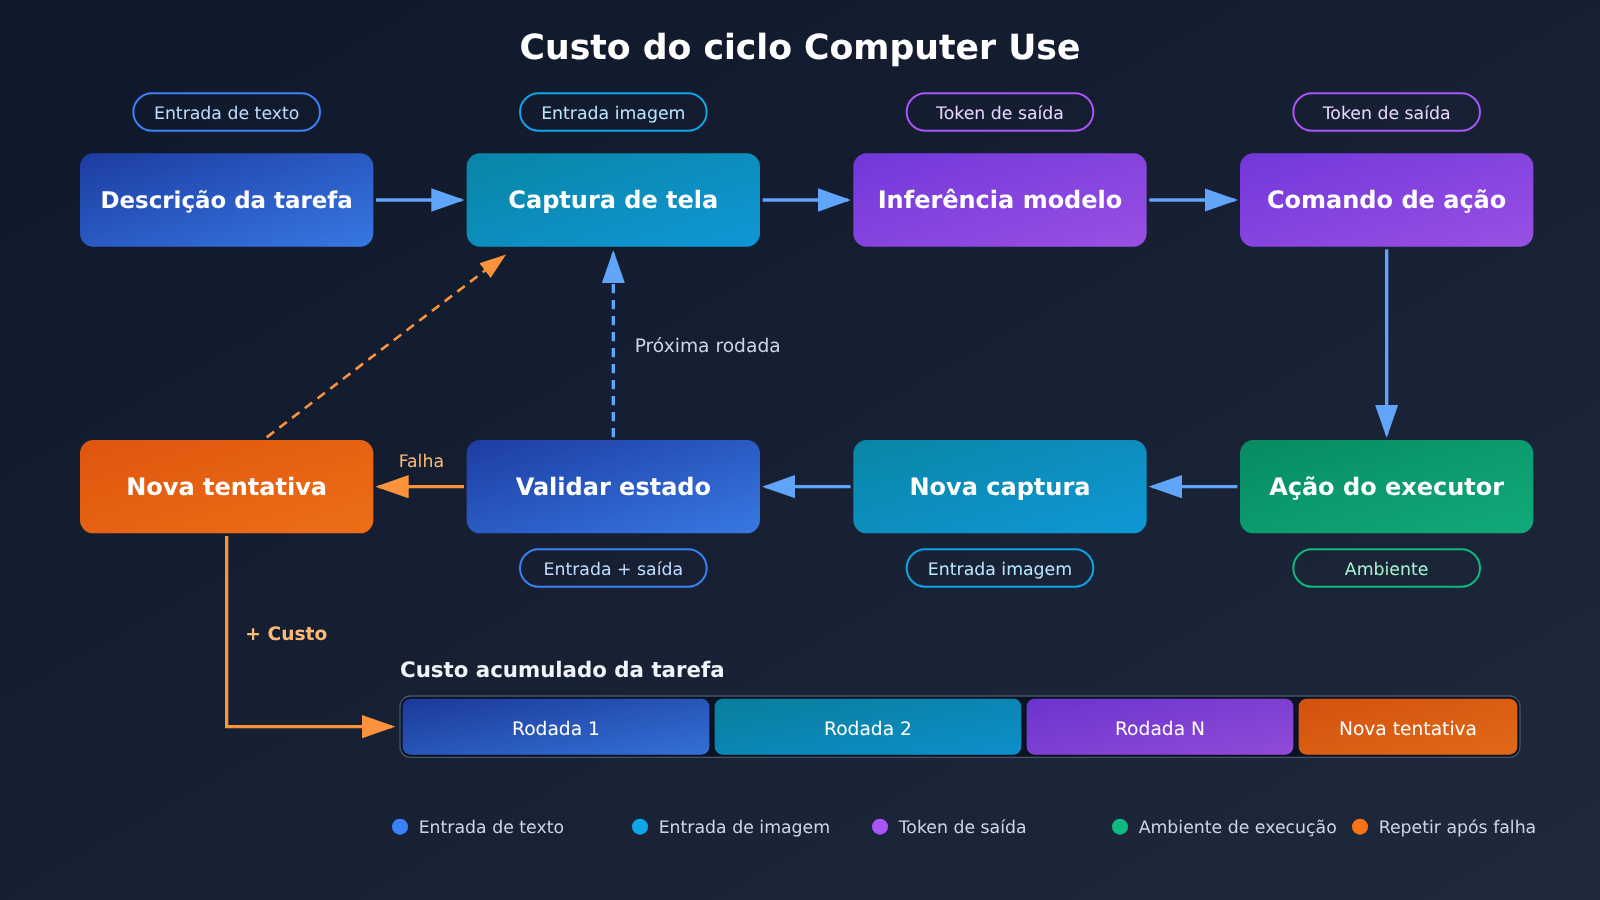
A razão de fundo está na forma como o Computer Use é executado. Segundo a documentação para desenvolvedores da OpenAI, um ciclo típico é: receber a tarefa, observar a captura de tela, gerar a instrução de operação, deixar o aplicativo executar o clique ou a digitação, devolver uma nova captura de tela, e o modelo então decide o próximo passo, até concluir ou pedir aprovação humana. A cada passo, a descrição da tarefa, o contexto histórico e a nova captura de tela podem ser reinseridos no modelo.
Uma pergunta e resposta comum pode precisar de apenas uma invocação, enquanto um fluxo de pré-autorização entre sistemas pode passar por mais de uma dúzia de rodadas consecutivas de “observar, operar, verificar”. A captura de tela é uma entrada de imagem, gera custo separado de Tokens visuais e aparece em todas as rodadas, por isso é o item mais fácil de subestimar. Vale notar também que o fato de o modelo ter gerado a instrução de operação não significa que a operação deu certo: o aplicativo precisa executar e verificar o resultado, e a verificação em si também consome invocações.
Onde exatamente vai o dinheiro de uma tarefa de Agente médico?
Se destrinchar uma tarefa, dá para encaixar tudo em seis categorias de custo direto. A manutenção de engenharia é um investimento contínuo, e fica mais claro quando contabilizada à parte.
| Categoria de custo | Por que acontece | Ponto de atenção na contabilização |
|---|---|---|
| Token de entrada | Comando do sistema, descrição da tarefa, contexto histórico, retorno das ferramentas | Acumular por rodada, separando a parte que pode ir para cache |
| Token de saída | Instruções de operação, código gerado, decisões e raciocínio | Raciocínio mais intenso aumenta bastante a saída |
| Entrada visual | Captura de tela a cada rodada e compreensão da interface | Contabilizar separadamente conforme a regra de cobrança de imagens do modelo |
| Chamada de ferramentas | Ferramentas nativas, navegador gerenciado, execução de código | Os Tokens gastos por ferramentas nativas são cobrados conforme o modelo correspondente |
| Ambiente de execução | Navegador, máquina virtual, contêiner | Só entrar na conta quando você realmente usa o serviço correspondente |
| Retentativas por falha | Erro no carregamento da página, falha de localização, erro de operação | Se os Tokens de retentativa já estão no total, não some de novo |
A cobrança do ambiente de execução varia bastante. Na página de preços da OpenAI, os valores do Hosted Shell e do contêiner do Code Interpreter são: 1 GB por 20 minutos a US$ 0,03, 4 GB a US$ 0,12, 16 GB a US$ 0,48 e 64 GB a US$ 1,92. O armazenamento de arquivos e imagens enviados é cobrado a US$ 0,10/GB-dia. Se o desenvolvedor rodar Playwright ou um executor de desktop no próprio servidor, essa parte passa a ser custo de infraestrutura própria, com uma estrutura completamente diferente.
Por isso, na hora de contabilizar é preciso separar três camadas: o custo de modelo é a despesa de processar entrada e saída, o custo de execução é a despesa com infraestrutura (navegador, servidor, contêiner), e o custo de engenharia é o esforço humano com design de fluxo de trabalho, testes, monitoramento e manutenção. Olhar só a primeira camada deixa o orçamento baixo, sem dúvida.
Por que alguns Agents médicos não deveriam chamar o Modelo de Linguagem Grande a cada vez?
A CVS Health divulgou casos de ambiente de produção em seu anúncio. Um Agent, em um fim de semana, limpou tarefas de envio de documentos acumuladas por vários meses; outro Agent processa, todos os dias, dezenas de milhares de etapas de operação de sistema em consultas de especialidade. Aqui, “dezenas de milhares de vezes” refere-se a etapas de operação, e não a decisões clínicas realizadas de forma autônoma pela IA. O sistema conta também com verificações de validação, supervisão humana e checagem de estado baseada em capturas de tela e registros de operação.
O que merece mais atenção dos desenvolvedores é o CUA Agent Kit, de código aberto da CVS (licença Apache-2.0). Ele divide a automação em duas fases: primeiro, o OpenAI Computer Use Agent executa tarefas em linguagem natural, registrando capturas de tela, ações, posições-alvo e o Trace; em seguida, o Codex Skill, com base nas trajetórias bem-sucedidas, gera ou atualiza código de workflow determinístico, que passa por revisão de engenheiros. O README explica que a fase de execução determinística não precisa de chave API do modelo.
Esse design ataca diretamente o problema de custo: explorar processos desconhecidos exige raciocínio do Modelo de Linguagem Grande; repetir processos já conhecidos fica a cargo de código comum. Desde que o processo seja estável, uma única execução deixa de pagar pelos custos de entrada visual e de raciocínio, e a variabilidade dos resultados também diminui. Um dos pontos centrais do projeto é que “descobrir como concluir a tarefa” e “repetir de forma estável ao longo do tempo” são dois problemas distintos.
A relação entre RPA tradicional e Agents também pode ser entendida sob esse ângulo. Em um estudo comparativo de RPA (DOI: 10.1080/23311975.2026.2724760), as tarefas P2 e P3 foram executadas 10 vezes para cada tecnologia; já a tarefa P1 com Agent foi executada apenas 1 vez e falhou, não entrando nas estatísticas posteriores — portanto, não se pode afirmar de forma genérica que “todas as tarefas foram executadas 10 vezes”. O estudo utilizou configurações de ferramentas de 2025 e não pode ser tomado como resultado direto dos modelos de 2026. Ainda assim, ele sugere um ponto: ao avaliar soluções de automação, a estabilidade em execuções repetidas importa tanto quanto o sucesso em uma única execução.
Análise e julgamento: como calcular a conta de custos de um Agente médico
Como modelos de alta capacidade e modelos de baixo custo dividem o trabalho em Agentes médicos?
Os dados de benchmark mostram que a proporção de pontos de avaliação obtidos pelo Luna é 2,5 pontos percentuais menor que a do Astra, mas o custo é de apenas cerca de 2% do Astra. Isso indica que, em tarefas administrativas com alto grau de estruturação, os modelos de baixo custo já possuem capacidade de execução considerável. Porém, a diferença nos pontos de avaliação não equivale à diferença na taxa de sucesso ponta a ponta: se os pontos perdidos recaírem justamente em etapas críticas como upload de arquivos ou atualização de status, o resultado de negócio pode ser completamente diferente. Esse é o nosso julgamento e precisa ser validado com os dados das nossas próprias tarefas.
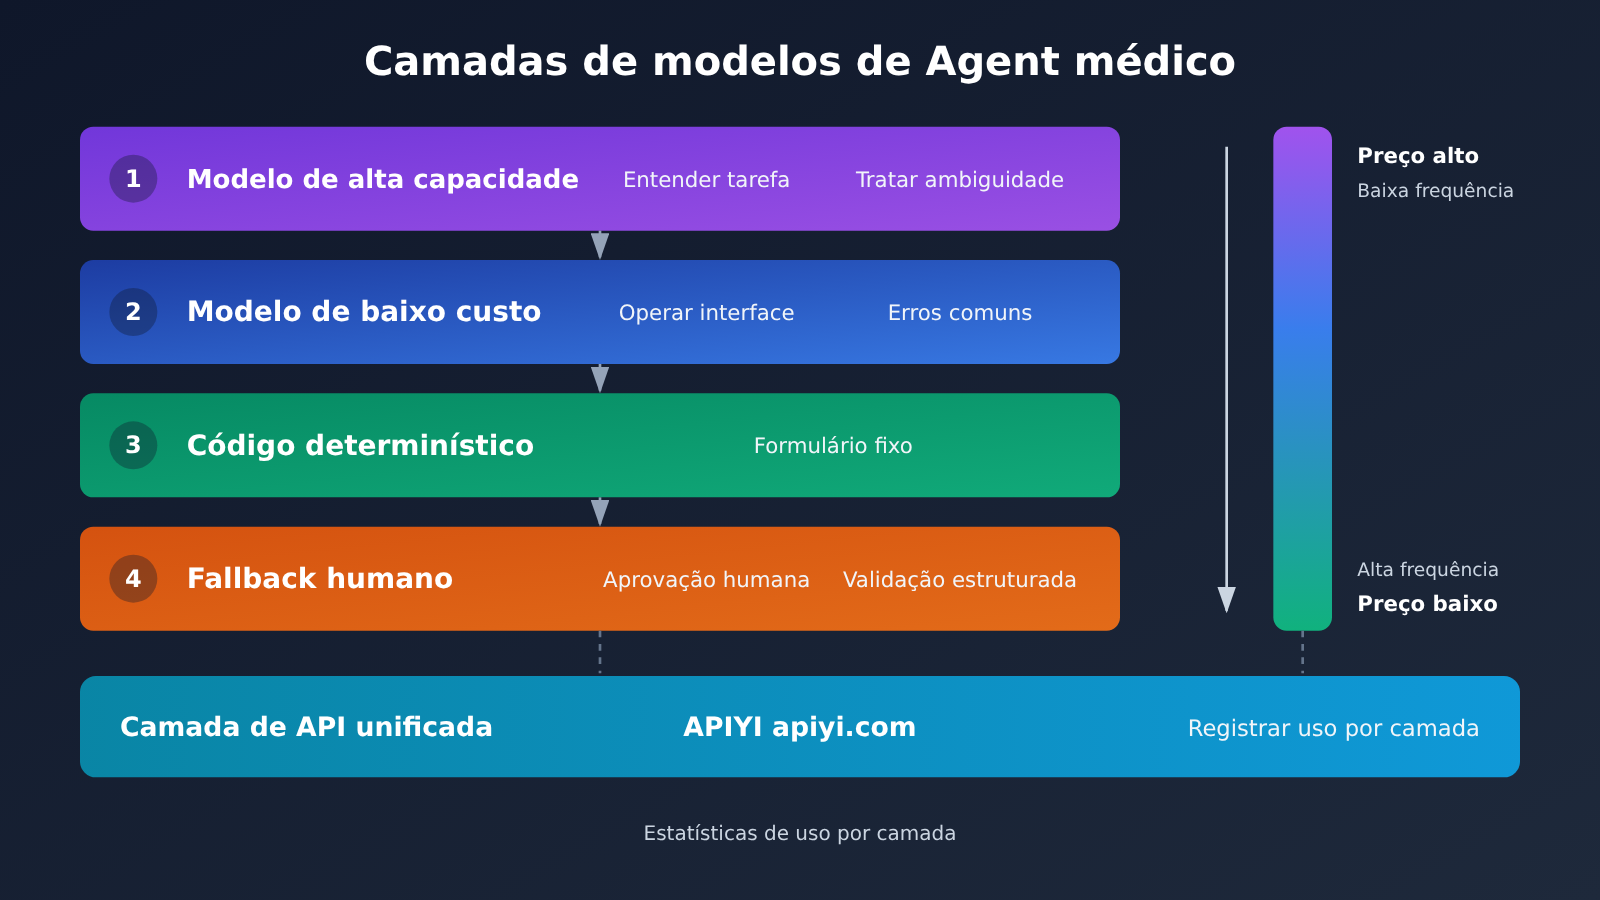
A abordagem mais segura é alocar por etapa, em vez de usar apenas um modelo para toda a tarefa:
| Etapa do trabalho | Responsável sugerido | Motivo |
|---|---|---|
| Entender tarefas complexas e decompor etapas | Modelo de alta capacidade | Custo de erro alto, poucas invocações |
| Lidar com ambiguidades e informações difusas em prontuários | Modelo de raciocínio avançado + confirmação humana | A solução da Ambience para e pergunta ao médico quando há ambiguidade |
| Operações rotineiras de interface | Modelo de baixo custo | Muitas invocações, mais sensível ao preço unitário |
| Preenchimento repetitivo de formulários fixos | Código determinístico | Referência à ideia de cristalização em código do CUA Agent Kit |
| Tratamento de exceções comuns | Modelo de baixo custo ou regras | Padrões fixos, podem ser gradualmente consolidados em regras |
| Aprovação de operações críticas | Humano | Ações como enviar, submeter e assinar mantêm a autoridade final humana |
| Verificação do resultado final | Verificação estruturada + amostragem humana | Basear-se no estado do sistema, e não na declaração de “concluído” do modelo |
O ganho desse particionamento em camadas está em usar modelos de preço unitário alto apenas em etapas de baixa frequência e alto valor, deixando as etapas de alta frequência para modelos de baixo custo ou código. Quando vários modelos coexistem, uma interface de invocação unificada reduz o custo de troca. Por exemplo, por meio de um gateway compatível com OpenAI como o APIYI apiyi.com, o desenvolvedor pode comparar modelos diferentes apenas alterando o parâmetro model. Os modelos efetivamente disponíveis dependem da lista atual de modelos da plataforma e das permissões da conta.
Como os desenvolvedores podem calcular o orçamento do próprio projeto de agente médico?
Sugerimos adotar a seguinte estrutura de custo por tarefa. Aqui, T é o número real de tokens e P é o preço por milhão de tokens:
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (a parte cacheável é listada separadamente pelo preço de cache)
C_output = T_output × P_output / 1,000,000
C_image  = conforme as regras de cobrança visual do modelo; capturas de tela são contabilizadas separadamente a cada rodada
C_retry  = considera apenas a despesa de nova tentativa que ainda não foi incorporada ao total de tokens acima

Custo por tarefa bem-sucedida = custo total de todas as tarefas ÷ número de tarefas bem-sucedidas
Orçamento mensal = custo por tarefa bem-sucedida × meta mensal de tarefas bem-sucedidas + investimento em manutenção de engenharia
O que realmente determina a precisão do orçamento são estas métricas medidas na prática: número médio de rodadas de invocação por tarefa, número médio de capturas de tela, taxa de novas tentativas por falha, taxa de intervenção humana e taxa de sucesso ponta a ponta. Usar o “custo por tarefa bem-sucedida” em vez do “custo por execução” como denominador permite incluir o consumo das falhas.
A tabela abaixo mostra um cenário de orçamento construído por nós. Todos os volumes são hipotéticos e servem apenas para demonstrar o método de cálculo. Os preços unitários usam os preços oficiais Standard do texto anterior:
| Premissas do cenário (construção própria, não medição real) | Modelo de baixo custo (preço unitário do Luna) | Modelo de alta capacidade (preço unitário do Astra) |
|---|---|---|
| 15 rodadas por tarefa, 20 mil tokens de entrada visual + texto por rodada | 300 mil × $0,10/M = $0,030 | 300 mil × $10/M = $3,00 |
| 500 tokens de saída por rodada | 7.500 × $0,50/M ≈ $0,004 | 7.500 × $50/M = $0,375 |
| Custo do modelo por execução | cerca de $0,034 | cerca de $3,38 |
| Custo por tarefa bem-sucedida assumindo taxa de sucesso ponta a ponta de 80% | cerca de $0,042 | cerca de $4,22 |
| Custo de modelo para 10.000 tarefas bem-sucedidas por mês | cerca de $420 | cerca de $42.200 |
| Container gerenciado (4 GB, 4 tarefas em série a cada 20 minutos) | cerca de $300/mês | cerca de $300/mês |
Este cenário revela um fenômeno facilmente ignorado: quando o modelo é suficientemente barato, o custo do ambiente de execução pode ficar na mesma ordem de magnitude do custo do modelo, ou até maior. A direção da otimização muda junto: de “trocar por um modelo mais barato” para “reduzir rodadas de captura de tela, reutilizar containers e transformar etapas fixas em código”. Essa é uma conclusão da simulação de cenário; a proporção real deve se basear nos seus dados medidos.
A forma mais direta de coletar o uso real é registrar o campo usage após cada invocação do modelo. Segue um exemplo mínimo:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # Consulte a lista de modelos no painel da APIYI
    messages=[{"role": "user", "content": "根据以下字段生成预授权申请核对清单:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
Ver o código de implementação completo para acumular custos por tarefa
from dataclasses import dataclass, field
from openai import OpenAI

# Preços oficiais Standard para contexto curto em 2026-11-17 (USD/milhão de tokens); na prática, vale o nível de cobrança correspondente
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Acesso unificado; no painel, é possível conferir os logs de tokens e custos
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # Os tokens das rodadas de retry já foram acumulados em record; aqui não os somamos novamente
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 Sugestão de orçamento: comece com uma amostra de 20 a 50 tarefas reais para um teste em pequena escala e depois faça a estimativa mensal. Ao usar o acesso unificado via APIYI apiyi.com, você pode comparar os logs de consumo de tokens e custos no painel para validar suas próprias medições; a cota gratuita de teste para novos usuários é suficiente para concluir esta etapa.
Do preço dos modelos ao gerenciamento de custos de API: o que um gateway de Agent médico pode fazer
Quando um projeto de Agent entra na fase de múltiplos modelos, o custo sair do controle raramente acontece por causa do preço unitário — acontece porque ninguém consegue explicar com clareza qual etapa e qual modelo consumiram quanto. O valor de um API Gateway está justamente em concentrar as chamadas dispersas em um único ponto: chave e endpoint unificados, logs de uso separados por modelo, detalhamento de custos rastreável. Só com isso a equipe consegue descobrir que determinada etapa tirou capturas de tela demais, ou que certo tipo de exceção dispara retentativas repetidamente.
Tomando a APIYI como exemplo, segundo sua documentação de início rápido, a integração consiste em criar uma conta, obter a chave API na página de Token e então substituir o endpoint original da OpenAI por https://api.apiyi.com; em alguns aplicativos é preciso acrescentar /v1 ao endereço. Os SDKs oficiais e exemplos de código podem ser usados diretamente; no painel é possível consultar logs de modelos, consumo de Token e custos, e a página informa que as tarifas da OpenAI e da Claude são iguais às oficiais, além de oferecer suporte a emissão de nota fiscal. Para equipes que precisam estratificar e comparar vários modelos, a APIYI (apiyi.com) oferece uma camada de integração com cobrança por consumo e medição unificada.
Mas também é preciso deixar claros os limites. O API Gateway resolve o acesso e a medição das invocações de modelos — não é o executor do Agent: ambientes de navegador e desktop, coleta de capturas de tela, controle de permissões de negócio, fluxos de aprovação humana e manutenção de workflows continuam a cargo do desenvolvedor. Em cenários médicos, a conformidade com HIPAA ainda depende da elegibilidade do produto aplicável, do BAA, da configuração de segurança e da governança de dados — não basta trocar a forma de acesso para ela ser atendida automaticamente. E se um modelo GPT-6 específico pode ou não ser invocado também depende da lista atual de modelos da plataforma.
Voltando ao número de 8,5 centavos: ele prova o potencial dos modelos de baixo custo na automação administrativa de alta frequência, mas não responde quanto o seu fluxo de trabalho vai custar. A resposta só pode vir das suas próprias amostras de tarefas, da sua própria taxa de sucesso e dos seus próprios logs de uso. Como diz o provérbio em inglês:
The proof of the pudding is in the eating.
(A prova do pudim está em comê-lo; o resultado real só se conhece na prática.)
Referências
- Anúncio do OpenAI Medical Computer Use Agent: fonte original da pontuação no HealthAdminBench e do custo por tarefa
- Link:
openai.com/index/advancing-computer-use-for-healthcare-teams
- Link:
- Página de preços da OpenAI API: preços por token do GPT-6 Astra e GPT-6 Luna e custos de contêiner
- Link:
developers.openai.com/api/docs/pricing
- Link:
- Documentação para desenvolvedores do OpenAI Computer Use: o loop de execução e os dois caminhos, Computer Tool e Code Execution
- Link:
developers.openai.com/api/docs/guides/tools-computer-use
- Link:
- Paper HealthAdminBench v1: versão específica com 135 tarefas e 1698 subtarefas
- Link:
arxiv.org/html/2604.09937v1
- Link:
- CVS Health CUA Agent Kit: implementação open-source de exploração por IA e consolidação em código
- Link:
github.com/cvs-health/cua-agent-kit
- Link:
- Estudo comparativo de RPA: design de execução repetida e explicação de exceções
- Link:
doi.org/10.1080/23311975.2026.2724760
- Link:
- Verificação da definição do provérbio: Cambridge Dictionary
- Link:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para nos contatar pela página inicial da APIYI apiyi.com. Para mais instruções de integração, acesse o centro de documentação em docs.apiyi.com


