
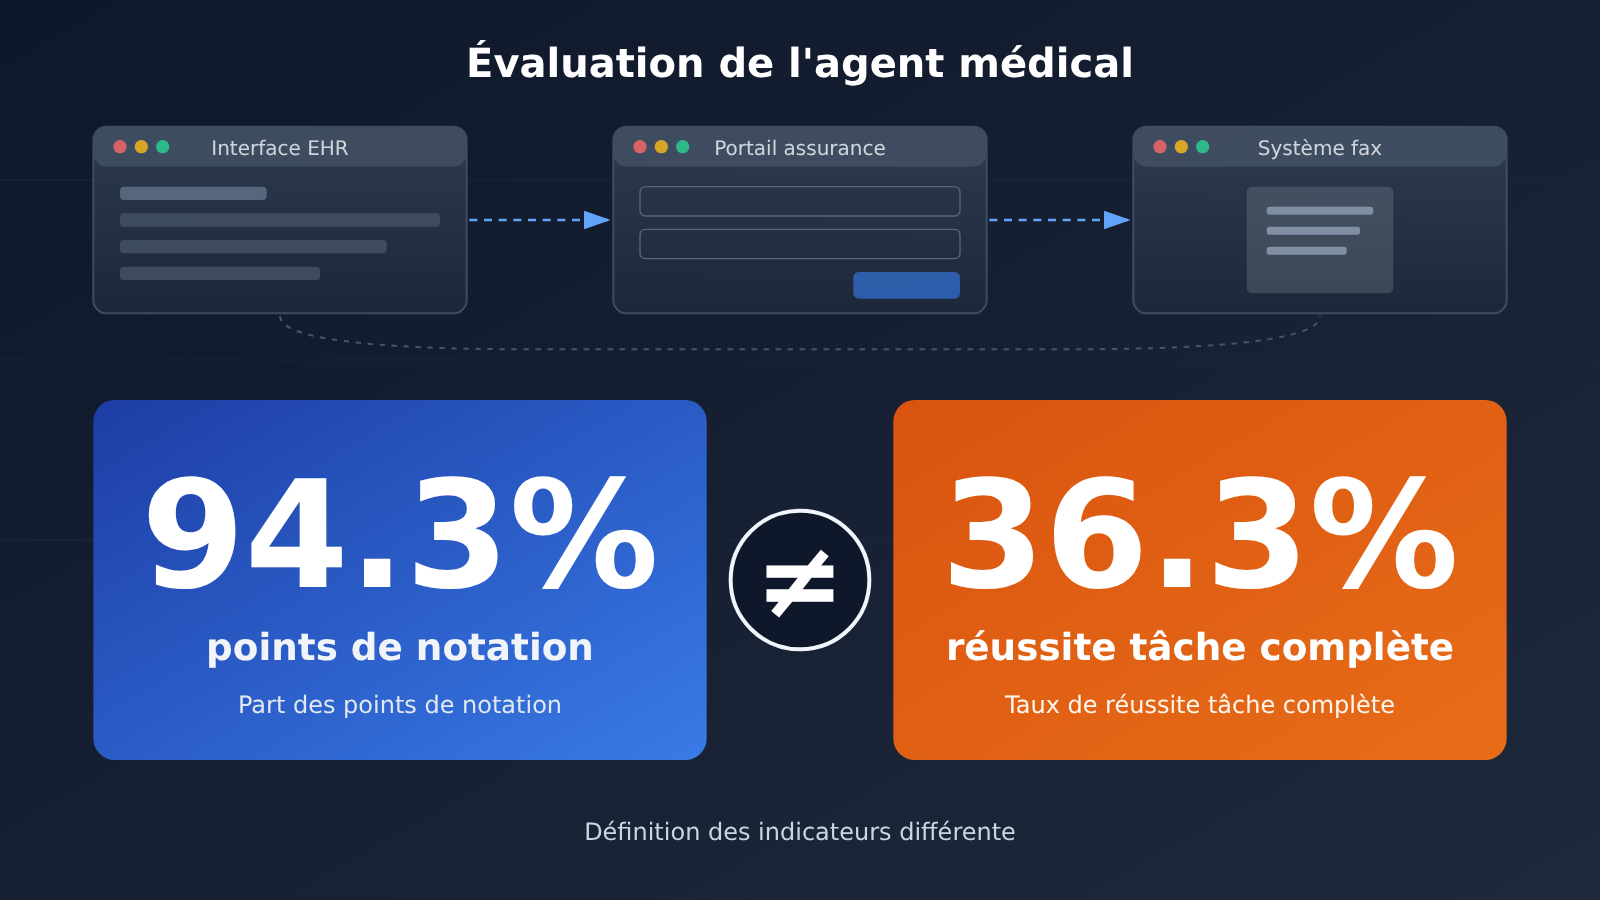
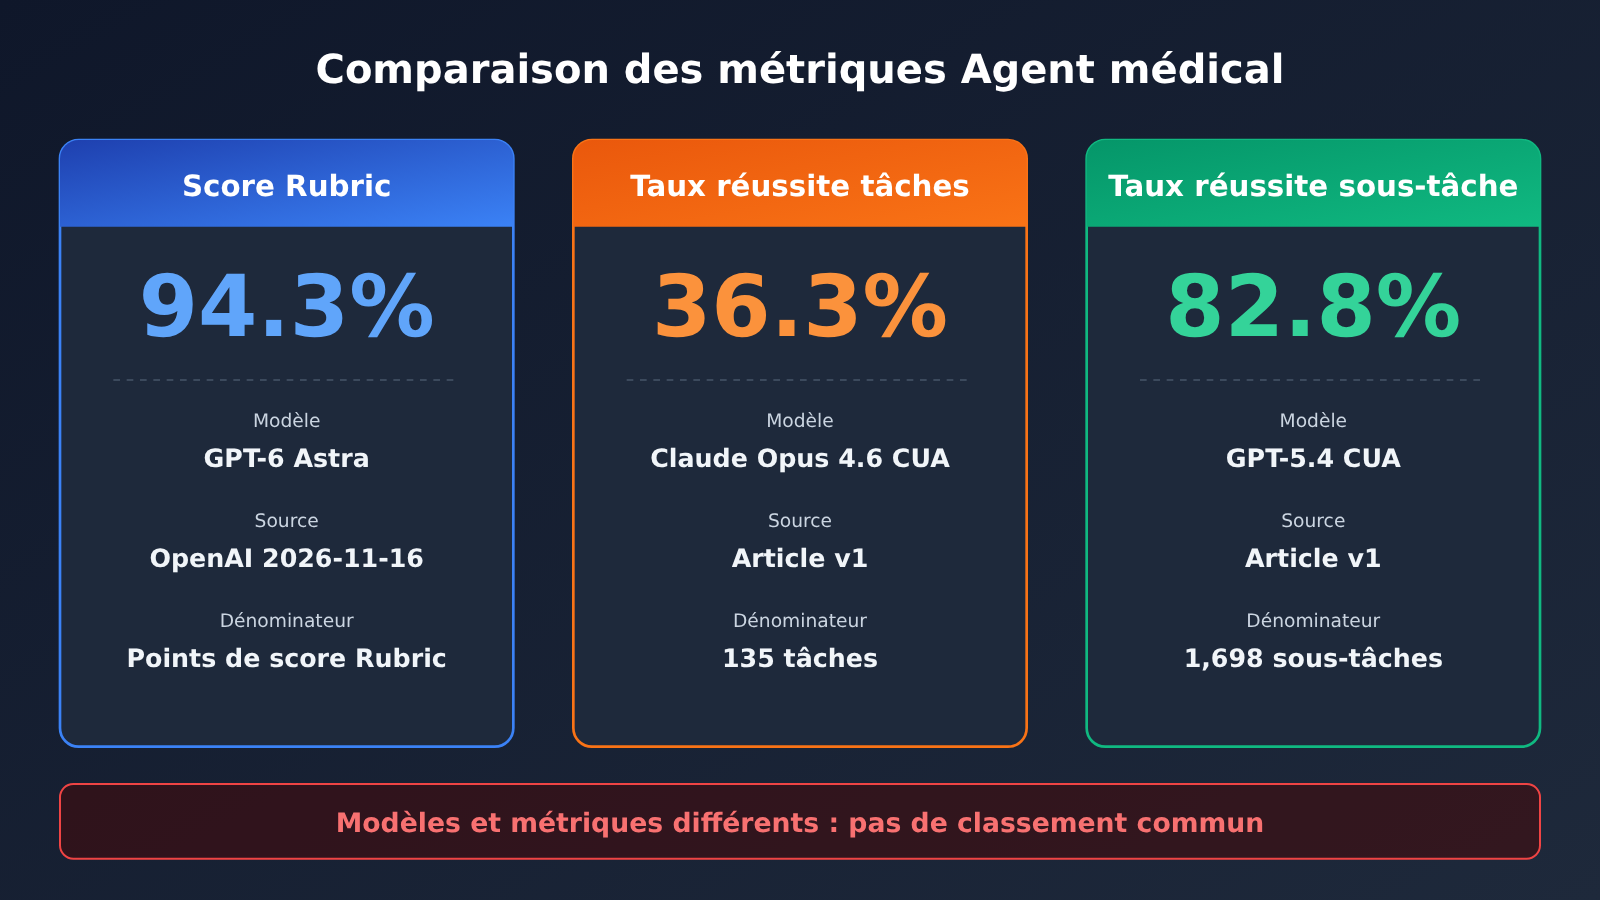
94.3% ne signifie pas que 94.3% des tâches administratives médicales ont été entièrement menées à bien. Les 94.3% du GPT-6 Astra publiés par OpenAI le 16 novembre 2026 correspondent à la proportion de points de notation (rubric points) obtenue dans HealthAdminBench ; les 36.3% du Claude Opus 4.6 CUA dans l’article du Shah Lab de Stanford correspondent au taux de réussite de la tâche complète (full-task success). Le premier indicateur mesure « combien de points de notation ont été satisfaits », le second « combien de tâches remplissent toutes les conditions de réussite » : ce ne sont pas les mêmes métriques, et elles ne peuvent pas figurer dans le même classement.
Un agent médical peut très bien réussir des opérations isolées comme la recherche d’informations, le traitement de documents ou le remplissage de formulaires, tout en restant incapable d’accomplir de manière fiable un processus métier qui traverse plusieurs systèmes. Pour déterminer si un agent a de la valeur en production, il faut regarder à la fois la performance sur les sous-tâches, le taux de réussite de bout en bout, les types d’erreurs, le coût d’exécution et les interventions humaines : aucun score isolé ne suffit.
Que retiendrez-vous de cet article ?
- Ce que mesurent respectivement 94.3% et 36.3%, et pourquoi ils ne sont pas directement comparables
- La composition des tâches de HealthAdminBench, l’origine des points de notation et ses deux mécanismes de validation
- Une grille de dimensions d’évaluation pensée pour la production et transposable à d’autres agents d’entreprise
Sommaire : la partie factuelle explique successivement pourquoi le score de 94.3% a attiré l’attention, ce que mesure réellement HealthAdminBench, la différence entre la réussite d’une sous-tâche et celle de la tâche complète, les étapes où un agent médical échoue le plus souvent, et pourquoi un même modèle peut se comporter différemment selon le cadre d’exécution ; la partie analyse, elle, aborde la construction d’un cadre d’évaluation global, le calcul des coûts et les arbitrages qu’une entreprise doit faire en pratique.
To Know : comprendre les 7 concepts de l’évaluation des agents médicaux
| Concept | Brève explication |
|---|---|
| Computer Use | Capacité à accomplir une tâche en observant l’interface logicielle et en simulant des clics, des saisies de texte, des défilements, etc. |
| EHR | Système de dossier de santé électronique, le logiciel central dans lequel l’hôpital stocke les informations de diagnostic et de traitement des patients |
| MCP | Protocole standard pour découvrir et invoquer des outils externes |
| RPA | Mode d’automatisation de processus répétitifs au moyen de règles ou de scripts préconfigurés |
| Rubric points | Points de score attribués selon une grille d’évaluation, servant à mesurer l’atteinte de certains critères partiels |
| Taux de réussite de bout en bout | Proportion de tâches complètes satisfaisant l’ensemble des conditions de succès ; l’échec d’une seule condition critique suffit à faire échouer la tâche |
| Trace | Preuve de trajectoire enregistrant le déroulement de l’exécution, les actions effectuées et l’état de l’interface |
Aperçu des implications de l’évaluation des agents médicaux
- Développeurs et responsables techniques : inutile de se fonder uniquement sur un score unique publié par un fournisseur pour choisir une solution. Il faut valider sur ses propres tâches le mécanisme d’exécution, le taux de complétion de bout en bout, ainsi que le coût complet — captures d’écran, nouvelles tentatives et environnement d’exécution compris.
- Établissements de santé et responsables de workflow : il convient de distinguer quatre types de preuves — démonstration en environnement synthétique, évaluation de référence, pilote institutionnel et cas de production — et de mettre en place, au moment du déploiement, une validation humaine, le principe de moindre privilège et un audit des opérations.
Faits objectifs : l’évaluation des agents médicaux derrière 94.3 % et 36.3 %
Pourquoi le score de 94.3 % attire-t-il l’attention ?
Le 16 novembre 2026, OpenAI a publié des avancées sur un agent informatique destiné aux équipes médicales et a divulgué plusieurs séries de données d’évaluation. GPT-6 Astra obtient un score de 94.3 % sur HealthAdminBench et GPT-6 Luna de 91.8 %, tous deux évalués avec l’effort de raisonnement maximal (maximum reasoning effort). OpenAI indique également que le coût par tâche de Luna est de 0.085 dollar, soit 98 % de moins que celui d’Astra.
Ces chiffres retiennent l’attention parce que les résultats HealthAdminBench publiés auparavant par Stanford étaient nettement plus faibles. Il faut souligner que les 94.3 % et 91.8 % publiés par OpenAI correspondent à la proportion de points de rubrique (rubric points) obtenus, et non à un taux indépendant de réussite sur des tâches complètes. Les deux autres séries de données de la même annonce proviennent elles aussi d’étapes d’évaluation différentes, avec des dénominateurs distincts :
| Indicateur | Valeur | Dénominateur / base de calcul | Ce que cela ne représente pas |
|---|---|---|---|
| Score HealthAdminBench (Astra) | 94.3 % | proportion de points de rubrique | taux de réussite de tâches complètes |
| Score HealthAdminBench (Luna) | 91.8 % | proportion de points de rubrique | taux de réussite de tâches complètes |
| Sécurité des tâches cliniques (Astra) | 99 % | 325 tâches examinées | précision du diagnostic médical |
| Part de forte approbation des médecins (Astra) | 93 % | 646 évaluations de médecins | taux de réussite des tâches, et ne correspond pas non plus à 646 médecins |
| Coût par tâche de Luna | $0.085 | coût par tâche dans des conditions d’évaluation spécifiques | tarif de déploiement en production |
Ces trois jeux de données ont des dénominateurs différents et ne peuvent pas être fusionnés en un « taux de précision global ». En outre, le texte de l’annonce d’OpenAI ne publie pas les résultats tâche par tâche, la configuration expérimentale complète, les intervalles de confiance ni l’ensemble des cas d’échec ; pour l’heure, des tiers ne peuvent pas vérifier indépendamment la composition du score de 94.3 %. Le coût par tâche d’Astra est d’environ 4.25 dollars ; il s’agit d’une estimation calculée à partir d’une baisse de 98 %, et non d’un prix directement annoncé par OpenAI.
Que mesure réellement HealthAdminBench ?
HealthAdminBench a été proposé par le Shah Lab de l’université Stanford pour évaluer spécifiquement les performances des agents d’opération informatique dans les tâches administratives médicales. La version publique présente des différences selon les époques : la page de recherche initiale décrivait 70 tâches, 947 points d’évaluation et 6 agents ; la version 2604.09937v1 de l’article étend le tout à 135 tâches, 1,698 sous-tâches vérifiables et 7 configurations de modèles. Cet article se base sur la version de l’article ; les données de la page initiale ne servent que de comparaison historique.
Les quatre environnements GUI simulés de la version de l’article sont respectivement EHR, le portail de paiement d’assurance A, le portail de paiement d’assurance B et le portail de fax. Les 135 tâches se répartissent en trois types de workflows administratifs :
| Type de tâche | Nombre | Contenu principal |
|---|---|---|
| Prior Authorization (préautorisation) | 60 | Vérification de l’éligibilité à l’assurance, collecte des dossiers médicaux, soumission de la demande de préautorisation |
| Appeals and Denials Management (gestion des recours et des refus) | 60 | Examen des refus, collecte des justificatifs, préparation et soumission des recours |
| DME Order Processing (commandes de matériel médical) | 15 | Collecte des informations sur le matériel médical, soumission de la commande, enregistrement des résultats |
Les 1,698 points d’évaluation sont générés par deux mécanismes. 1,177 utilisent des vérifications déterministes, s’appuyant sur des moyens structurés comme JMESPath pour contrôler l’état du système : par exemple, le bon patient a-t-il été trouvé, les champs spécifiés ont-ils été remplis, la commande correcte a-t-elle été générée — une approche proche des tests logiciels classiques. Les 521 autres sont confiés à un LLM Judge, qui évalue principalement si le contenu des documents est suffisant, si les éléments soumis répondent aux exigences, etc., autant d’aspects difficiles à vérifier directement par des règles.
Toutes les tâches utilisent des données de patients synthétiques, et non des dossiers de patients réels. Cela signifie que ce benchmark fournit un environnement de test reproductible ; il ne s’agit pas de tests réalisés dans un système de production d’un hôpital réel, et il ne mesure pas directement les résultats des soins aux patients.
Quelle est la différence entre le succès d’une sous-tâche et le succès d’une tâche complète ?
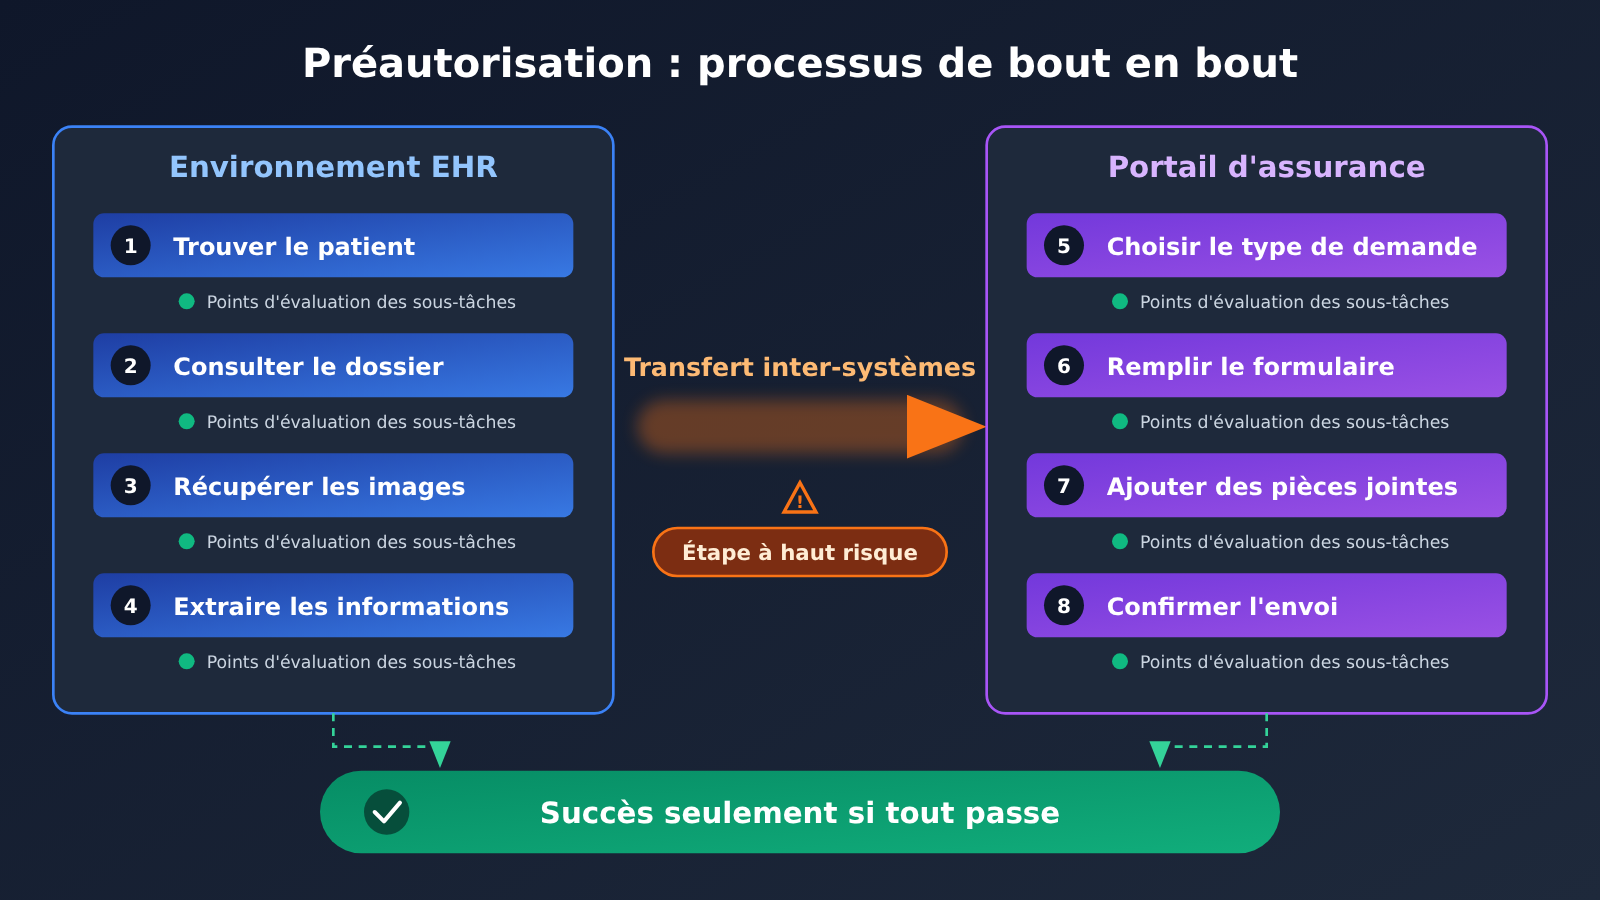
C’est avec un processus de demande de préautorisation qu’on voit le plus facilement la différence entre les deux. D’après les documents de recherche, une tâche de préautorisation peut demander à l’agent d’enchaîner :
- Trouver le bon patient dans l’EHR
- Consulter l’historique des soins du patient
- Retrouver les examens d’imagerie et les documents des traitements antérieurs
- Déterminer quels justificatifs la demande d’assurance exige
- Extraire du dossier médical les informations nécessaires
- Accéder au portail de prise en charge de l’assurance
- Choisir le bon type de demande
- Remplir le formulaire de demande
- Joindre les documents requis
- Soumettre la demande et confirmer son statut
Ces dix étapes sont fortement interdépendantes. Si l’on se trompe de patient à l’étape 1, toutes les étapes suivantes ont beau être impeccables, elles restent fausses. Les neuf premières étapes peuvent être toutes correctes : si l’étape 9 oublie une pièce jointe ou si l’étape 10 ne soumet pas réellement la demande, la tâche est quand même jugée comme un échec. Le taux de réussite des sous-tâches mesure « combien d’étapes sur dix ont été correctement réalisées » ; le taux de réussite des tâches complètes mesure « si les dix étapes ont toutes été correctement réalisées ».
Les chiffres du papier illustrent clairement cet écart : le taux de réussite des sous-tâches de GPT-5.4 CUA atteint 82.8 %, tandis que le taux de réussite des tâches complètes de Claude Opus 4.6 CUA est de 36.3 %. Ces deux chiffres proviennent de modèles différents et ne peuvent pas davantage être comparés directement, mais ensemble ils disent une même chose : accomplir des actions locales et mener à bien tout un processus métier relèvent de deux capacités distinctes.
Une page de recherche plus ancienne rapportait déjà un écart similaire : le meilleur taux de réussite sur tâche complète de Claude Opus 4.5 était de 22.9 %, et le taux de réussite des sous-tâches de Gemini 3 de 76.4 %. Comme l’échelle des tâches et les versions diffèrent, ces chiffres ne servent qu’à observer une tendance : on ne peut pas les mettre dans le même classement que la version du papier ou les résultats d’OpenAI.
Dans quelles étapes un agent médical échoue-t-il le plus souvent ?
L’étude présente les résultats de deux configurations CUA, par catégorie de sous-tâche :
| Catégorie de sous-tâche | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| Recherche d’informations | 96,5 % | 96,1 % |
| Rédaction de documents | 74,3 % | 84,4 % |
| Remplissage de formulaires | 88,9 % | 84,9 % |
| Résolution de tâches | 70,7 % | 66,2 % |
| Traitement de documents | 92,3 % | 94,3 % |
| Raisonnement clinique | 61,3 % | 77,0 % |
Un point important à souligner : les 94,3 % de GPT-5.4 CUA en traitement de documents dans ce tableau et le total de rubric points de 94,3 % annoncé par OpenAI pour GPT-6 Astra ne sont qu’une coïncidence numérique. Les modèles, les métriques et les sources sont totalement différents.
Si l’on regarde le détail par sous-tâche, la recherche d’informations est déjà proche de la saturation, tandis que le raisonnement clinique, la résolution de tâches et la rédaction de documents restent relativement faibles. L’étude souligne aussi que le traitement de documents (Document Handling) et le transfert de données entre systèmes (Cross-system Data Transfer) sont les principaux problèmes à l’origine des échecs de bout en bout. Une première version de la page web indiquait que cinq des six modèles avaient une précision inférieure à 20 % sur la sous-tâche de traitement de documents, mais il s’agissait d’une configuration de tâche propre à une autre version : ces chiffres ne peuvent pas être comparés directement au tableau ci-dessus.
Pourquoi le transfert entre systèmes est-il particulièrement propice aux erreurs ? Dans le processus de préautorisation, la même information doit être lue dans le dossier médical électronique (EHR), conservée dans le contexte de l’agent, puis écrite dans une autre structure de formulaire sur le portail de l’assurance ; les pièces jointes peuvent aussi transiter par un portail fax. Chaque transfert représente une possibilité d’erreur, et une erreur en amont est recopiée telle quelle dans le système en aval. Parmi les risques recensés dans les documents d’OpenAI, on trouve aussi « la propagation d’informations erronées d’un système à un autre » et « le signalement à tort qu’une tâche est terminée alors que l’état du système n’est pas clair ».
Pourquoi un même modèle peut-il se comporter différemment selon le cadre d’exécution ?
L’étude a mené des expériences d’ablation sur les modalités de prompt et d’observation. Trois principaux résultats ressortent :
- Fournir des Portal Guidance (instructions d’utilisation du portail) donne généralement de meilleurs résultats qu’une simple description de la tâche.
- L’observation via l’Accessibility Tree (arbre d’accessibilité) est généralement meilleure que l’observation par simple capture d’écran.
- Lorsque les instructions d’utilisation du portail sont associées à des informations de page structurées, les performances de bout en bout sont généralement meilleures.
L’étude souligne aussi qu’un environnement de production réel ne fournit pas nécessairement un Accessibility Tree complet. Autrement dit, les performances de l’agent dépendent non seulement du modèle sous-jacent, mais aussi du cadre d’exécution (Harness), de la méthode d’observation de la page, des invites et de la description de la tâche.
La documentation développeur d’OpenAI illustre également ces différences de parcours d’exécution. Le guide officiel décrit séparément ComputerToolset, BrowserToolset et le point d’entrée du navigateur hébergé ; pour GPT-6 Astra, la documentation actuelle recommande l’approche Code Execution, où le modèle génère du code, par exemple Playwright, pour piloter l’interface, Computer Tool restant une option. La documentation insiste aussi sur un point : le fait que le modèle génère des instructions d’opération ne signifie pas que l’opération a été menée avec succès ; l’application doit d’abord les exécuter, puis vérifier le résultat au moyen d’une nouvelle capture d’écran ou par un autre moyen.
Le CUA Agent Kit open source de CVS Health (Apache-2.0) propose une autre approche d’ingénierie. Le mécanisme décrit dans son README est le suivant : un Computer-use Agent explore d’abord le workflow et enregistre les captures d’écran, les actions et les traces comme preuves ; puis Codex Skill transforme la trajectoire réussie en code déterministe, après revue par un ingénieur ; les exécutions déterministes suivantes n’ont plus besoin d’une clé de modèle. Cette approche dissocie deux questions : « comment découvrir la marche à suivre » et « comment la répéter de façon stable ».
Analyse et évaluation : comment évaluer un agent médical réellement utilisable
Comment évaluer un agent réellement utilisable ?
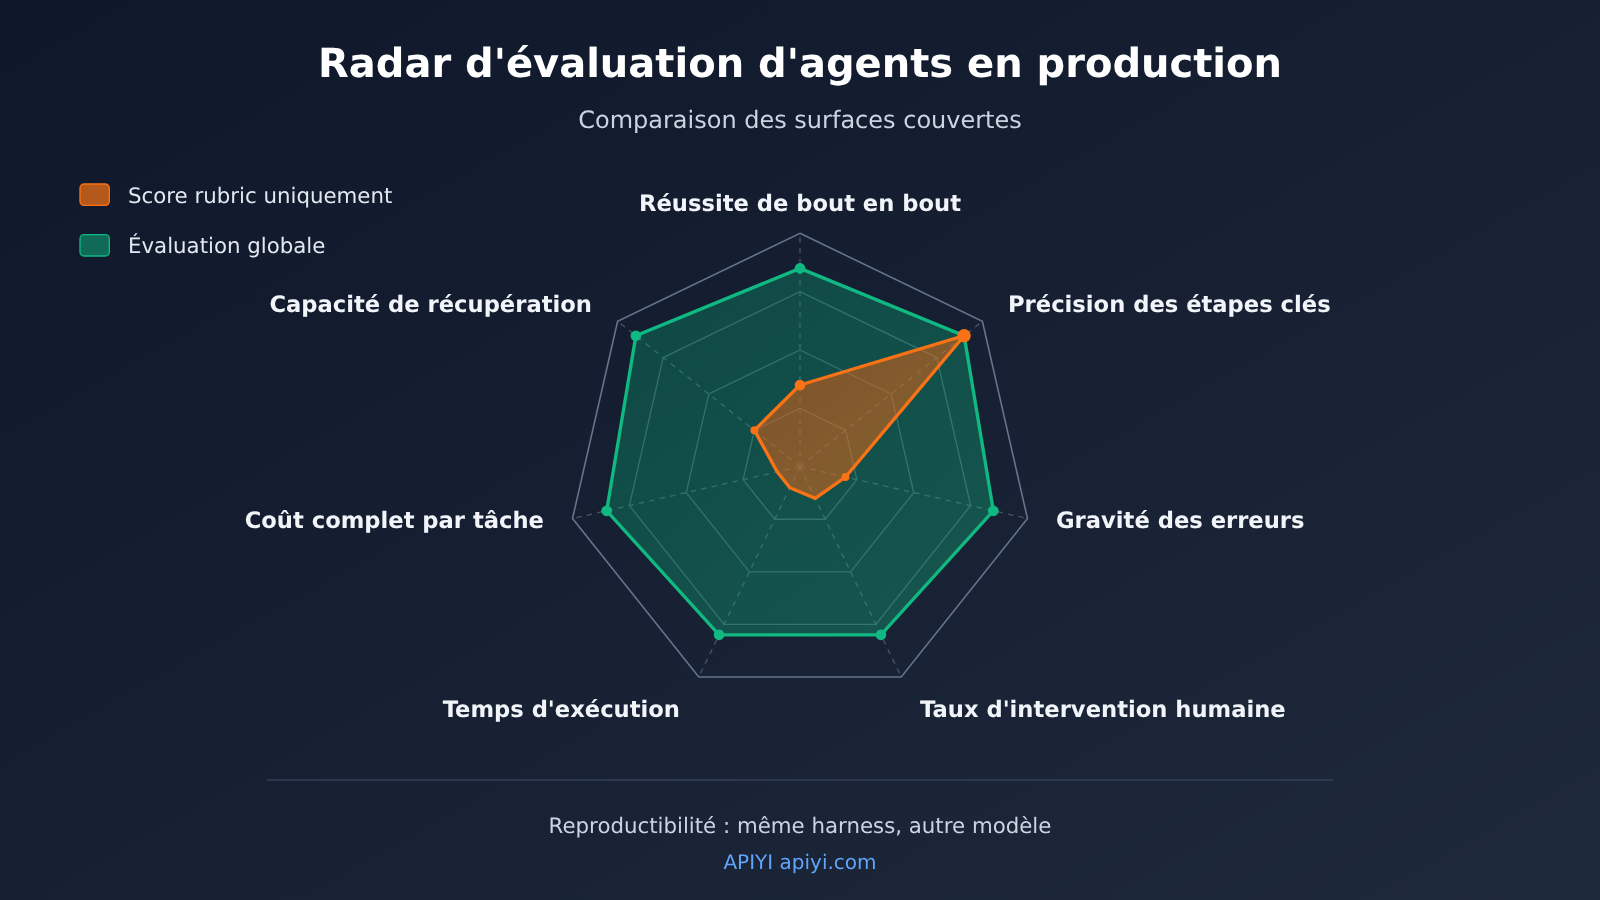
Voici le jugement de cet article, et non le standard officiel d’une institution quelconque. Nous pensons que des scores de type rubric points comme 94.3 % conviennent pour répondre à la question « de combien les capacités locales du modèle ont-elles progressé », mais pas à celle « peut-on l’intégrer dans un flux de production ». Cette dernière question exige un ensemble d’indicateurs qui se contrebalancent :
| Dimension d’évaluation | Ce que l’on mesure | Pourquoi c’est nécessaire | Source des données |
|---|---|---|---|
| Taux de réussite de bout en bout | Proportion de tâches complètes qui remplissent toutes les conditions de réussite | Le métier ne reconnaît que le résultat final | Vérification de l’état final du système |
| Exactitude des étapes critiques | Taux de correction des nœuds critiques : sélection du patient, soumission, téléversement de pièces jointes, etc. | Une erreur sur une étape critique compromet tout | Contrôles déterministes |
| Gravité des erreurs | L’échec est-il un oubli récupérable, une donnée mal écrite ou un message envoyé par erreur ? | À taux d’échec identique, le risque peut varier énormément | Revue humaine + étiquettes de gravité |
| Taux d’intervention humaine | Proportion nécessitant une reprise en main humaine ou une correction après approbation | Détermine les effectifs réellement économisés | Journaux d’approbation |
| Temps d’exécution | Durée par tâche et durée de la longue traîne | Influe sur le débit et la file d’attente | Horodatages des traces |
| Coût complet par tâche | Somme des coûts du modèle, des captures d’écran, des nouvelles tentatives, de l’environnement d’exécution et de la maintenance | Le prix unitaire du token ne représente pas le coût réel | Facturation + journaux d’exécution |
| Capacité de récupération après anomalie | Capacité à s’arrêter ou à revenir en arrière en cas d’ambiguïté, de délai dépassé ou de changement de page | Dans un contexte médical, il faut savoir « s’arrêter » | Tests par injection de fautes |
Le cœur de ce cadre consiste à présenter séparément « combien d’étapes ont été correctement réalisées » et « combien de choses ont été menées à bien », puis à corriger les deux à l’aide de la gravité des erreurs et du taux d’intervention humaine. La solution présentée par Ambience illustre justement cette dimension de « récupération après anomalie » : lorsqu’un dossier médical comporte une ambiguïté, l’agent s’arrête pour interroger le médecin et ne soumet la demande de préautorisation qu’après son approbation. Il s’agit seulement du dispositif de gouvernance montré par cette entreprise ; cela ne signifie pas que tous les agents médicaux disposent par défaut de la même configuration.
La taille de l’échantillon et le nombre de répétitions doivent également être publiés. Une étude comparant RPA et agent (DOI: 10.1080/23311975.2026.2724760) a exécuté 10 fois chaque technologie sur les processus P2 et P3, mais sur P1 l’agent n’a été exécuté qu’une seule fois et a échoué, sans être inclus dans les statistiques ultérieures ; cette étude utilise une configuration d’outils de 2025 et ne peut pas être considérée comme un résultat direct des modèles de 2026. Cet exemple montre que, face aux conclusions d’une évaluation, il faut d’abord regarder combien de fois chaque chiffre a été obtenu et quels résultats ont été exclus.
Évaluer un agent médical en pratique : faire tourner ses propres tests dans le même Harness
Pour une équipe de développement, l’approche la plus concrète consiste à figer le cadre d’exécution et à mesurer en parallèle, sur son propre jeu de tâches, deux séries d’indicateurs : ceux des sous-tâches et ceux de bout en bout. L’exemple ci-dessous utilise un LLM Judge (juge LLM) pour noter les éléments soumis par l’agent ; l’interface est compatible avec le SDK OpenAI :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, permet de changer de modèle juge
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
Voir l’implémentation complète : calculer à la fois le taux de réussite des sous-tâches et celui de bout en bout
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # Indique s'il s'agit d'une étape critique (un échec fait échouer toute la tâche)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # Inclut déjà les tokens des tentatives répétées, ne pas les additionner à nouveau

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """Utilise un LLM Judge pour les sous-tâches difficiles à formaliser en règles"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 Conseil technique : mieux vaut présenter côte à côte le score des sous-tâches et le taux de réussite de bout en bout, sur le même Harness et le même lot de tâches. Grâce à l’interface compatible OpenAI d’APIYI apiyi.com, une seule clé API suffit pour passer d’OpenAI à Claude, Gemini ou à un autre modèle, côté modèle d’exécution comme côté modèle juge, ce qui limite les variables parasites liées aux différences d’intégration.
Estimation des coûts des agents médicaux et hiérarchisation des modèles
Le prix unitaire du token ne représente que le point de départ. Selon les tarifs Standard pour contexte court publiés par OpenAI le 17 novembre 2026, GPT-6 Astra facture respectivement 10, 50 et 1 dollar par million de tokens pour l’entrée, la sortie et l’entrée mise en cache, tandis que GPT-6 Luna facture 0.10, 0.50 et 0.01 dollar. La vitesse de traitement, la longueur du contexte et la région influencent aussi la facturation réelle. Computer Use fonctionne par appels multi-tours : chaque capture d’écran compte comme une entrée visuelle. Il faut donc, lors du calcul, comptabiliser séparément les entrées visuelles et texte ainsi que les sorties facturables de chaque tour, puis ajouter les outils, l’environnement d’exécution et la maintenance d’ingénierie. Si les tokens consommés par les nouvelles tentatives sont déjà inclus dans le total, il ne faut pas les ajouter une deuxième fois.
Compte tenu de l’écart entre 0.085 dollar et environ 4.25 dollars, la hiérarchisation des modèles deviendra probablement la norme : confier les tâches complexes qui exigent un raisonnement poussé aux modèles les plus performants, réserver les tâches très structurées et fréquentes aux modèles à faible coût, et figer les processus fixes déjà éprouvés sous forme de code déterministe, à la manière de l’approche CVS. Il faut préciser que ces coûts par tâche proviennent de conditions de référence particulières et ne peuvent pas servir de tarif de production.
💰 Optimisation des coûts : avant de choisir une hiérarchisation, il est conseillé de mesurer d’abord, sur un petit lot de tâches réelles, le taux de réussite de bout en bout et le coût complet par tâche de chaque modèle. APIYI apiyi.com pratique la facturation à l’usage et offre un quota d’essai gratuit aux nouveaux utilisateurs, ce qui permet de réaliser ce type d’expérience comparative à faible coût dès la phase de cadrage du projet.
Des agents médicaux aux agents d’entreprise : une démarche d’évaluation transférable
La particularité de l’administration de santé réside dans le risque élevé et la réglementation stricte, mais les problèmes qu’elle expose existent aussi dans les processus d’entreprise tels que le traitement des sinistres d’assurance, le rapprochement financier ou les documents de la chaîne d’approvisionnement : multiplicité des systèmes, fortes dépendances et transferts de données entre systèmes. Notre conviction est que les quatre principes suivants peuvent être transposés directement :
- Séparer les rapports : les scores des sous-tâches et le taux de réussite de bout en bout doivent être présentés séparément ; ne jamais remplacer le second par le premier
- Qualifier le niveau de preuve : démonstration en environnement synthétique, auto-évaluation du fournisseur, benchmark tiers, pilote en entreprise et cas de production doivent être classés distinctement, sans mélange
- Figer le harness avant de comparer : dès que la méthode d’observation, les invites ou les consignes du portail changent, les résultats ne sont plus comparables
- La gouvernance avant les scores : le moindre privilège, l’approbation humaine des actions critiques, la vérification de l’état après opération, la journalisation complète des traces (Trace) et les mécanismes d’arrêt en cas d’anomalie doivent figurer parmi les critères d’acceptation avant la mise en production
Lors d’un PoC en interne, on peut étiqueter le jeu de tâches selon les « étapes critiques », établir d’abord une base de référence de bout en bout, puis introduire progressivement les consignes du portail, une observation structurée ou une formalisation dans le code, afin d’observer la contribution réelle de chaque modification au taux de réussite global. S’il faut reproduire rapidement le même lot de tâches sur plusieurs modèles, un accès unifié via APIYI apiyi.com réduit le coût d’ingénierie d’une comparaison transversale.
Parmi les évolutions à suivre de près : si OpenAI publiera les résultats tâche par tâche et la configuration expérimentale derrière les 94.3 %, si les prochaines versions de HealthAdminBench publieront, selon le même protocole, les taux de réussite sur les tâches complètes de nouveaux modèles, et si davantage d’organisations pourront divulguer le taux d’intervention humaine et les données de classification des erreurs en environnement de production réel. Tant que ces informations ne seront pas disponibles, toute affirmation selon laquelle « l’administration de santé peut être entièrement automatisée » relève de la spéculation.
Le chiffre de 94.3 % atteste un progrès significatif du modèle sur les points de notation, tandis que les 36.3 % rappellent que la capacité d’un processus métier à être exécuté de manière fiable doit en dernier ressort être vérifiée sur des tâches complètes, dans un système réel et sous supervision humaine. Comme le dit le proverbe anglais : « The proof of the pudding is in the eating. » (C’est en mangeant le pudding qu’on sait s’il est bon ; l’efficacité réelle se vérifie dans la pratique.)
Références
- OpenAI : Advancing computer-use agents for healthcare teams : données d’évaluation telles que 94.3 %, 91.8 %, 99 %, 93 % et exemples de collaboration
- Lien :
openai.com/index/advancing-computer-use-for-healthcare-teams/
- Lien :
- Article HealthAdminBench 2604.09937v1 : 135 tâches, 1,698 sous-tâches, résultats détaillés et expériences d’ablation
- Lien :
arxiv.org/html/2604.09937v1
- Lien :
- Page du projet HealthAdminBench et dépôt de code : environnement de référence et implémentation de l’évaluation
- Lien :
som-shahlab.github.io/health-admin-bench-website/ - Lien :
github.com/som-shahlab/health-admin-bench
- Lien :
- Ancienne page de recherche du Shah Lab de Stanford : version historique avec 70 tâches et 947 points de notation
- Lien :
shahlab.stanford.edu/doku.php?id=healthadminbench
- Lien :
- Documentation développeur et tarifs de l’API OpenAI Computer Use : parcours d’exécution et tarif Standard
- Lien :
developers.openai.com/api/docs/guides/tools-computer-use - Lien :
developers.openai.com/api/docs/pricing
- Lien :
- CVS Health CUA Agent Kit : mécanismes d’exploration, de preuve, de figement du code et de revue par les ingénieurs
- Lien :
github.com/cvs-health/cua-agent-kit
- Lien :
- Étude comparative RPA et Agent : nombre d’exécutions répétées et précisions sur l’exception P1
- Lien :
doi.org/10.1080/23311975.2026.2724760
- Lien :
- Cambridge Dictionary : définition du proverbe « proof of the pudding is in the eating »
- Lien :
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- Lien :
Auteur : l’équipe technique APIYI
Échanges techniques : venez sur APIYI apiyi.com discuter avec nous des pratiques d’évaluation d’agents ; pour plus de détails sur l’intégration, consultez le centre de documentation docs.apiyi.com.


