
Cet article confronte Qwen4-Max et GPT-6 Luna sur les indicateurs d’un même classement, les tarifs en contexte long et les modalités d’entrée, pour transformer un score global en critères d’acceptation et en arbitrage de coûts propres à une tâche donnée.
D’abord la conclusion, ensuite les conditions. Si la tâche impose une entrée vidéo, les fiches techniques des deux modèles ne laissent qu’une seule option : Qwen4-Max, et GPT-6 Luna ne figure même pas parmi les candidats. S’il s’agit de texte pur ou d’une tâche texte + image, avec un coût par appel et un volume d’invocations comme contraintes strictes, le tarif affiché de GPT-6 Luna est bien plus bas et mérite le rôle de choix par défaut. Pour les tâches très complexes, de type automatisation multi-étapes, Qwen4-Max devance nettement sur certaines sous-catégories d’Artificial Analysis et peut servir de candidat pour un routage à haute complexité. Le palier à retenir en définitive dépend du taux de réussite aux critères d’acceptation et du coût par tâche conforme, mesurés sur votre propre jeu de tâches.
Trois conditions peuvent modifier cette conclusion. Premièrement, selon le palier de raisonnement retenu pour Luna, l’écart d’indice et de coût par tâche peut passer d’environ 22 fois à environ 77 fois. Deuxièmement, au-delà de 272 000 tokens en entrée, Luna fait basculer toute la requête vers le palier supérieur, conformément à la grille tarifaire d’OpenAI. Troisièmement, sur une tâche précise, l’écart par sous-catégorie peut être minime : sur FrontierCode-AA 2.0, par exemple, les deux modèles ne sont séparés que de 1,3 point de pourcentage.
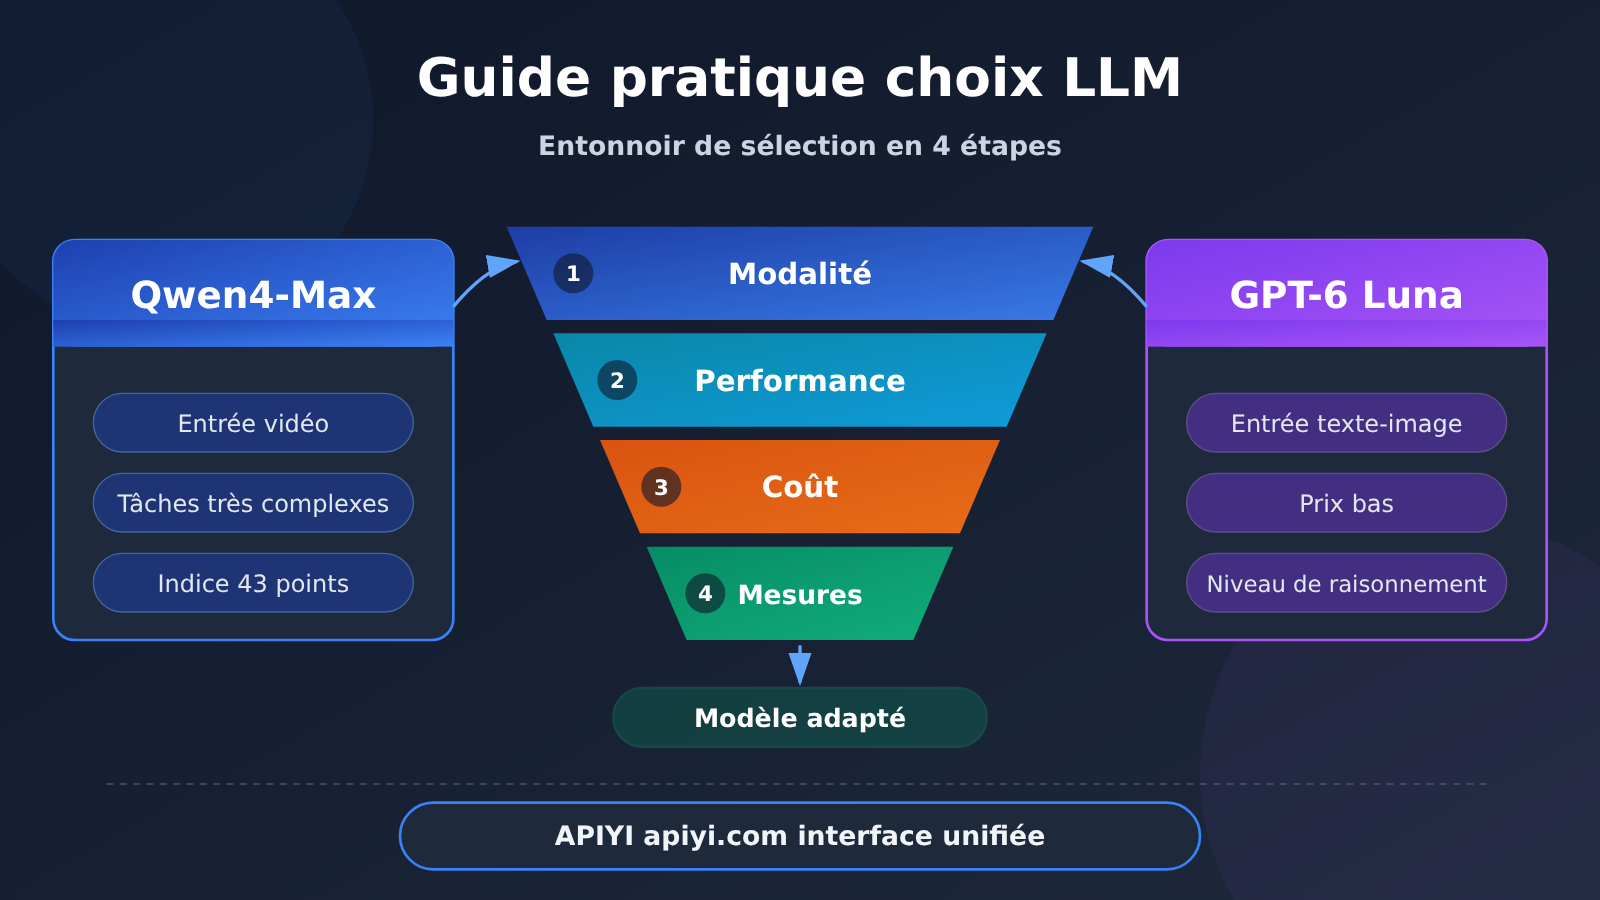
Aperçu comparatif pour le choix d’un grand modèle de langage : Qwen4-Max face à GPT-6 Luna
Le tableau ci-dessous ne présente que les dimensions qui influencent réellement le choix. Les scores proviennent de l’Intelligence Index v5.0.1 d’Artificial Analysis, et les prix des tarifs publics des éditeurs ou du catalogue APIYI. Toutes ces informations étaient publiques à la date de vérification de cet article, le 20 novembre 2026 ; il ne s’agit pas de nos propres mesures payantes.
| Dimension de comparaison | Qwen4-Max | GPT-6 Luna | Ce que signifie la différence |
|---|---|---|---|
| Modalités d’entrée (fiche modèle de l’éditeur) | Texte, image, vidéo | Texte, image | Luna est d’office éliminé pour les tâches vidéo |
| Modalités de sortie | Texte | Texte | Ni l’un ni l’autre ne génère d’image ni de voix |
| Intelligence Index v5.0.1 | 43 points | Niveau Medium : 18 points ; niveau Max : 28 points | Les niveaux diffèrent, donc les écarts aussi |
| Coût par tâche de l’indice | $3.27 | Niveau Medium : $0.0422 ; niveau Max : $0.15 | Valable uniquement pour cette charge de travail de l’indice |
| Tarif éditeur (par million de Token, contexte court) | Alibaba Cloud Singapour : entrée $1.50, sortie $4.50 | OpenAI standard : entrée $0.10, sortie $0.50 | Environ 15 contre 1 en entrée, 9 contre 1 en sortie |
| Tarification des entrées longues | Des sources tierces évoquent un tarif unique sur toute la fenêtre | Au-delà de 272 000 Token, toute la requête passe au niveau supérieur | Les scénarios de documents longs doivent être calculés à part |
| Endpoints du catalogue APIYI | chat, responses, messages | Chat Completions, Responses | Le choix du protocole influence le coût de migration |
| Plateformes disponibles | APIYI apiyi.com, Alibaba Cloud Model Studio, etc. | APIYI apiyi.com, OpenAI officiel, etc. | Une même clé facilite les tests comparatifs en alternance |
Le corps de l’article suit l’ordre des dépendances du choix. La section 1 vérifie d’abord la possibilité de connexion, car si les modalités ou les endpoints ne conviennent pas, les scores et les prix qui suivent n’ont plus aucune valeur. La section 2 compare les performances sur un même benchmark, la section 3 décompose, pour un même volume d’usage, le prix de l’éditeur, celui du catalogue et le montant réellement débité du compte, et la section 4 transforme les conclusions précédentes en étapes reproductibles sur votre propre activité. Les lecteurs uniquement préoccupés par le coût peuvent sauter directement à la section 3, mais il est conseillé de lire d’abord les critères d’élimination de la section 1.
Termes à connaître avant de choisir un grand modèle de langage (To Know)
| Terme | Signification dans cet article |
|---|---|
| Intelligence Index | Score agrégé des performances sur plusieurs tâches dans une version donnée d’Artificial Analysis ; nous utilisons ici la v5.0.1 |
| Coût par tâche de l’indice | Estimation de la dépense pour exécuter une tâche de ce benchmark ; le niveau de raisonnement et les volumes d’entrée/sortie en modifient le résultat |
| Niveau de raisonnement | Intensité de réflexion demandée au modèle, par exemple Medium et Max pour Luna ; il faut toujours le préciser lors d’une comparaison |
| Modalités d’entrée | Types de contenu acceptés par le modèle, par exemple texte, image ou vidéo |
| Tarification par paliers de contexte | Au-delà d’un certain seuil d’entrée, une autre grille tarifaire s’applique ; il faut vérifier si seul le dépassement est facturé ou toute la requête |
| Lecture de cache | Poste de facturation correspondant à la réutilisation d’entrées existantes ; à comptabiliser selon la grille tarifaire et les hits réellement enregistrés |
| Latence du premier Token de réponse visible | Temps entre l’envoi de la requête et l’apparition du premier segment de réponse exploitable ; pour les modèles de raisonnement, il faut la distinguer du « premier événement » |
| P50 / P95 | Médiane et 95e percentile de la distribution des latences, qui reflètent respectivement le cas typique et les requêtes lentes |
| Coût par tâche conforme | Coût intégrant les échecs, les relectures et les reprises, ramené à chaque résultat réellement conforme |
1. Première étape du choix d’un grand modèle de langage : éliminer d’emblée les combinaisons inadaptées selon les contraintes de la tâche
L’action la plus économique lors du choix d’un modèle consiste d’abord à éliminer. Même si un modèle obtient un excellent score, s’il n’accepte pas votre type d’entrée ou votre protocole d’appel, il faut l’abandonner. À l’inverse, un modèle bon marché qui ne satisfait pas aux contraintes strictes n’a pas non plus besoin d’être évalué sous l’angle du coût par la suite.
1.1 Utiliser les fiches modèle pour distinguer les modalités d’entrée
La fiche modèle d’Alibaba Cloud Model Studio indique que Qwen4-Max accepte des entrées texte, image et vidéo, et produit une sortie texte. Celle de GPT-6 Luna chez OpenAI indique des entrées texte et image, avec une sortie texte ; la synthèse d’OrcaRouter précise également que Luna ne prend pas en charge la génération d’images, la génération vocale, la transcription et la traduction. C’est la différence la plus nette entre les deux, et elle détermine que, pour les tâches vidéo, Qwen4-Max est le seul candidat.
Il faut noter que les fiches modèle des fournisseurs décrivent les capacités du modèle lui-même. Pour un fournisseur d’accès ou un endpoint donné, il faut vérifier séparément si les paramètres vidéo peuvent être transmis. Par exemple, la page de modèle de Together AI mentionne explicitement les entrées texte et image, mais je n’ai pas trouvé d’indication sur la vidéo pour la même route ; on ne peut donc écrire « Together mentionne explicitement le texte et l’image », sans en déduire qu’il prend en charge la vidéo.
1.2 Vérifier les ID, les groupes et les endpoints dans le catalogue APIYI
APIYI a annoncé la mise en ligne de qwen4-max le 2026-11-17. Le registre public des modèles généré le 2026-11-20 indique ses endpoints chat, responses et messages, ainsi que les groupes ClaudeCode, CodexResponses, default et svip. Dans la grille tarifaire, gpt-6-luna figure avec les groupes Default et SVIP, ainsi que les entrées Chat Completions et Responses. L’affirmation précédente du blog selon laquelle « Qwen4-Max n’est pas encore disponible » doit être remplacée par les dernières annonces et le registre.
Le catalogue ne prouve que la prise en charge du modèle et des endpoints par la plateforme ; le groupe auquel appartient votre compte et les permissions du jeton déterminent si vous pouvez réellement l’appeler. Je recommande, après avoir créé un jeton dans la console APIYI apiyi.com, de commencer par une requête minimale pour confirmer que l’ID exact du modèle et l’endpoint sont disponibles, avant de passer à la comparaison des résultats.
1.3 Les contraintes non négociables propres à chacun des trois scénarios
| Scénario | Contrainte non négociable | Résultat de l’élimination | Point clé pour la suite |
|---|---|---|---|
| Mise en forme de comptes rendus textuels (comptes rendus de réunion, archivage de tickets) | Format de sortie stable, faible coût par appel, volume d’appels élevé | Les deux modèles restent candidats | Comparer le taux de conformité au format et le coût unitaire |
| Compréhension vidéo (contrôle qualité d’enregistrements d’écran, résumé de vidéos) | Doit accepter une entrée vidéo | GPT-6 Luna est éliminé d’après sa fiche modèle | Vérifier si l’endpoint et le jeton prennent en charge les paramètres vidéo |
| Processus complexes (automatisation multi-étapes, opérations inter-systèmes) | Taux de réussite élevé sur plusieurs étapes, coût d’échec important | Les deux modèles restent candidats | Se concentrer sur le taux de réussite à l’acceptation plutôt que sur le prix unitaire |
La mise en forme de comptes rendus textuels est un scénario typiquement sensible au coût : la tâche elle-même n’est pas difficile, et l’essentiel réside dans le coût moyen de chaque résultat lors d’appels en grand volume. La compréhension vidéo est en revanche une question de seuil de capacité : si la modalité ne correspond pas, il n’y a pas lieu de comparer. Dans les processus complexes, un échec implique souvent une reprise manuelle ; si un modèle bon marché échoue plusieurs fois, le coût réel peut au contraire être plus élevé. Ce point sera calculé concrètement dans les sections 3 et 4.
2. Deuxième étape du choix du grand modèle de langage : comparer les gains sur une même base de référence
Une fois l’élimination terminée, on regarde les résultats. On utilise ici uniquement les données d’une même page de comparaison publiée par Artificial Analysis, car les jeux de tâches et les méthodes de notation diffèrent d’un classement à l’autre ; mélanger les classements n’a aucun sens.
2.1 Le score global et le coût par tâche doivent être lus avec le palier
| Configuration | Intelligence Index v5.0.1 | Coût par tâche de l’indice | Multiple de coût par rapport à Qwen4-Max |
|---|---|---|---|
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna (Medium, palier par défaut) | 18 | $0.0422 | env. 1/77 |
| GPT-6 Luna (palier Max) | 28 | $0.15 | env. 1/22 |
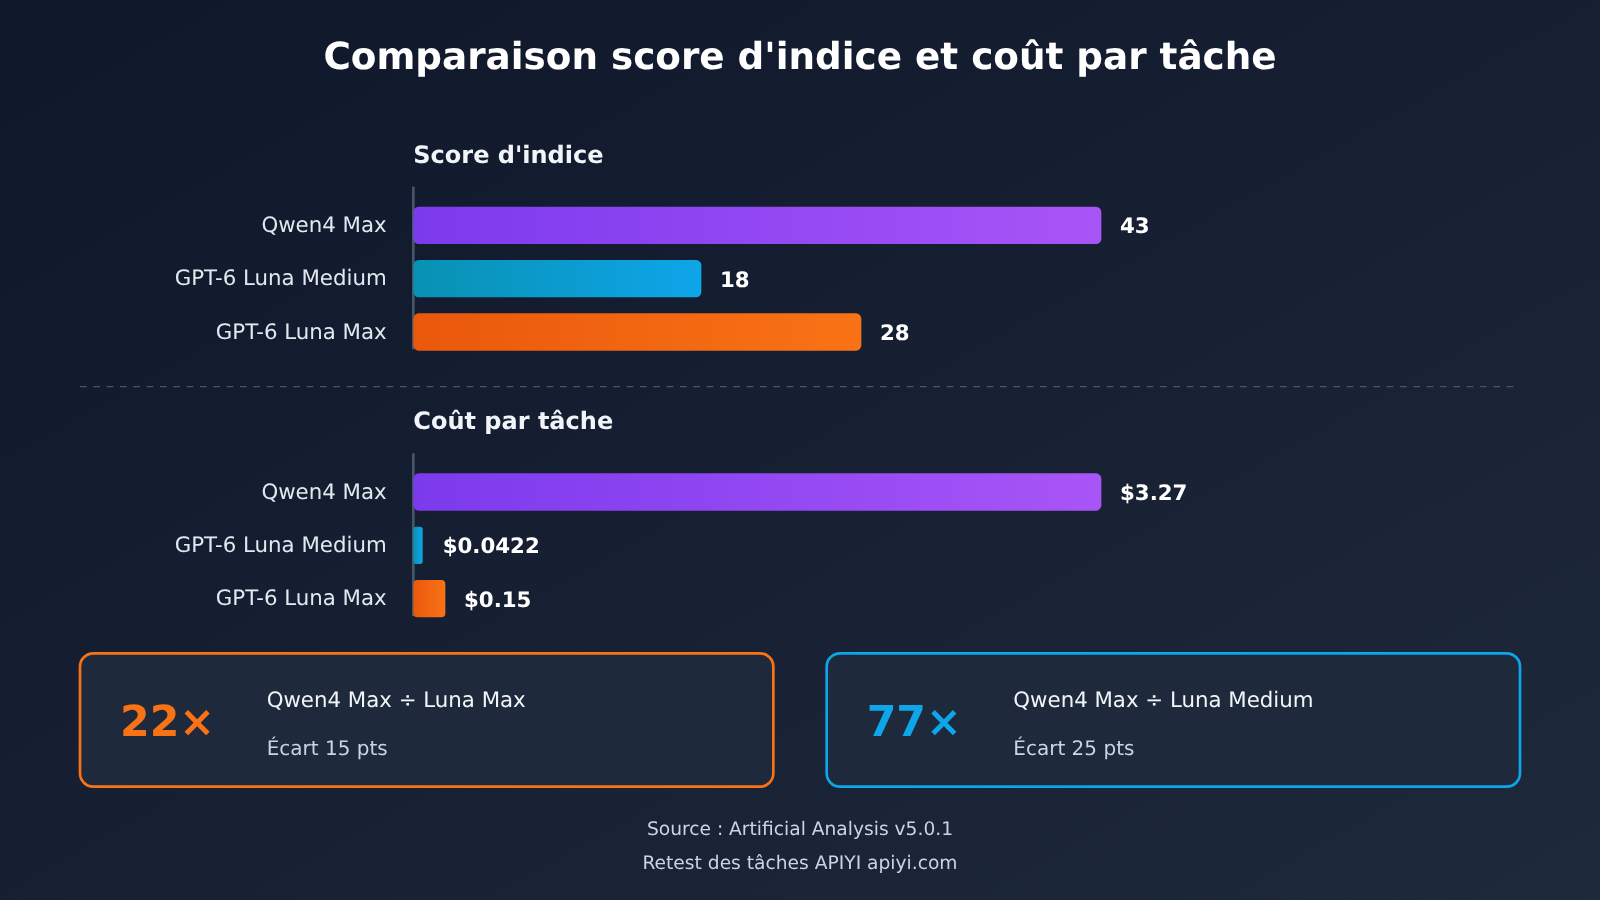
Le « environ 22 fois » souvent cité provient de $3.27 ÷ $0.15 et compare Qwen4 Max avec le palier Max de Luna ; l’écart de score est alors de 15 points. Si l’on compare avec le palier Medium par défaut de Luna, le multiple de coût est d’environ 77 fois, pour un écart de 25 points. Dire simplement « 22 fois plus cher » n’est donc pas complet : il faut préciser le palier et le type de charge de travail.
Un autre détail concerne la complétude des données. OrcaRouter fait remarquer que le classement ne publie qu’un seul score pour Qwen4-Max, sans données par palier ; Luna, en revanche, expose toute la hiérarchie des paliers. Pour faire des prévisions de coûts, une hiérarchie complète permet de voir le point d’inflexion où « le score continue-t-il d’augmenter quand on monte de palier ? », une information parfois plus utile qu’un score unique plus élevé.
2.2 L’écart par sous-tâche varie selon la tâche
L’indice global ne permet pas de prédire le gain sur une tâche précise. Sur AutomationBench-AA, Qwen4 Max atteint 72,6 % et Luna Max 53,2 %, soit environ 19 points de pourcentage d’écart ; sur FrontierCode-AA 2.0, ils sont respectivement à 26,5 % et 25,2 %, soit seulement 1,3 point de pourcentage d’écart.
Si on les replace dans les scénarios de la section 1, les processus complexes sont plus proches des tâches d’automatisation multi-étapes du type AutomationBench, où l’avance de Qwen4-Max peut se traduire par moins de retouches. Si vos tâches sont plutôt du côté de FrontierCode, l’écart entre les deux est très faible alors que l’écart de prix unitaire reste important, ce qui rend le rapport qualité-prix de Luna plus avantageux. Il ne s’agit là que d’une orientation ; il faut bien sûr vérifier sur votre propre jeu de tâches.
3. Troisième étape du choix d’un grand modèle de langage : calculer séparément les prix fournisseur, les prix catalogue et les frais de compte
Les coûts sont souvent mélangés. Cette section les divise en trois niveaux : le prix public affiché par le fournisseur, le prix catalogue APIYI, et le montant réellement payé sur le compte après une recharge avec bonus. Ces trois éléments ne relèvent pas de la même logique et ne peuvent pas se substituer les uns aux autres.
3.1 Exemple de calcul au tarif fournisseur pour une même requête à entrée longue
Supposons qu’une requête contienne 400 000 tokens en entrée et facture 8 000 tokens en sortie, sans lecture depuis le cache ni frais d’outils supplémentaires.
| Élément | Qwen4-Max (prix standard d’Alibaba Cloud International à Singapour) | GPT-6 Luna (prix standard OpenAI, entrée longue) |
|---|---|---|
| Tarif des tokens d’entrée | $1.50 / million de tokens | $0.20 / million de tokens (au-delà de 272 000, toute la requête passe au palier supérieur) |
| Tarif des tokens de sortie | $4.50 / million de tokens | $0.75 / million de tokens |
| Calcul | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| Coût par requête | $0.636 | $0.086 |
Le rapport entre les deux est d’environ 7.40, soit environ la moitié de l’écart de 15 contre 1 que l’on observe sur le prix unitaire des tokens d’entrée en contexte court. La raison tient à la règle de changement de palier de Luna. Selon le tarif OpenAI, le passage au palier pour entrée longue s’applique à toute la requête, et non uniquement à la portion qui dépasse le seuil : pour une invite de 300 000 tokens, les 300 000 sont facturés au tarif élevé, et pas seulement les 28 000 derniers. Une synthèse d’OrcaRouter indique que Qwen4-Max facture au même tarif sur toute la fenêtre d’un million de tokens, sans paliers à 32K ou 128K.
Les prix fournisseur varient également selon la région et le canal. OrcaRouter indique pour Qwen4-Max, dans la région Global, une entrée à $1.413 et une sortie à $4.24, différents de Singapour. La page Pricing officielle de Together AI indique Qwen4 Max en promotion, avec un tarif limité dans le temps de $1.05 en entrée, $3.15 en sortie et $0.0525 pour la lecture du cache, soit exactement 70 % du prix de Singapour. La page précise une validité jusqu’au 2026-11-23, sans indiquer le fuseau horaire ; sa page de détail du modèle affiche cependant une autre grille : $1.43, $4.28, $0.0713. Quand vous citez ce genre de prix, indiquez la page source et la date ; la facturation réelle dépend de la consommation du compte.
3.2 Le prix catalogue d’APIYI se calcule à partir des tarifs catalogue et des journaux d’utilisation
Dans le catalogue APIYI, qwen4-max est facturé $1.50 par million de tokens en entrée, $4.50 en sortie et $0.075 pour la lecture du cache ; pour gpt-6-luna, en contexte court, l’entrée est à $0.10, la sortie à $0.50 et la lecture du cache à $0.01. La grille tarifaire précise que, lorsque l’entrée dépasse 272,000 tokens, le tarif d’entrée passe à $0.20.
Si l’on reprend la même requête qu’en 3.1, qwen4-max revient également à $0.636 au prix catalogue. Pour gpt-6-luna, la part d’entrée est de 0.4 × 0.20 = $0.08 ; la grille tarifaire vérifiée cette fois-ci ne précise que l’augmentation du palier d’entrée. Pour savoir quel tarif s’applique à la sortie en contexte long, référez-vous à la grille tarifaire et aux journaux d’utilisation en vigueur. Le vrai chiffre de coût doit venir des journaux d’utilisation de votre compte, pas de la formule ci-dessus.
💰 Conseil pour le calcul des coûts : depuis le même compte sur APIYI apiyi.com, appelez les deux modèles séparément. Les journaux d’utilisation enregistrent, pour chaque requête, les tokens d’entrée, de sortie et de cache ; ces relevés sont plus proches de la facture réelle qu’une estimation basée sur les tarifs publics.
3.3 Le bonus de recharge joue sur la conversion en principal, pas sur le prix unitaire du modèle
La FAQ actuelle d’APIYI présente les paliers de bonus pour une recharge unique : de $100 à moins de $500, bonus de 10 % ; de $500 à moins de $1,000, bonus de 12 % ; de $1,000 à moins de $3,000, bonus de 15 % ; à partir de $3,000, bonus de 20 %. Les recharges en ligne et les recharges par compte d’entreprise y sont éligibles, et le bonus est versé automatiquement. La possibilité de cumuler un ajustement tarifaire négocié séparément avec le service commercial reste à confirmer. Les nouveaux utilisateurs bénéficient en outre de $1 pour leur première recharge, et les utilisateurs du secteur éducatif disposant d’un e-mail scolaire vérifié de $2 ; ce bonus doit être obtenu en contactant le service client. Le solde rechargé est utilisé selon la règle des 365 jours indiquée dans la documentation.
| Palier de recharge | Solde crédité | Équivalent en principal de recharge pour 1 $ de journal | Réduction du coût en principal |
|---|---|---|---|
| Recharge unique de $100 | $110 | Environ $0.909 | Environ 9.09 % |
| Recharge unique à partir de $3,000 | Montant rechargé × 1.2 | Environ $0.833 | Environ 16.67 % |
Le calcul suppose que le solde bonus est intégralement consommé. En appliquant le palier de 10 %, les $0.636 de frais de journal pour une requête en 3.1 correspondent à environ $0.578 de principal de recharge. Attention : le bonus s’applique uniformément au solde de toute la plateforme. Il réduit le principal nécessaire pour chaque dollar de journal, et non le prix d’un modèle en particulier. Lorsque vous comparez des modèles, utilisez le même coefficient de conversion des deux côtés ; sinon, la comparaison sera faussée.
4. Étape 4 du choix du grand modèle de langage : transformer les conditions en étapes de test comparables
Les trois premières sections reposent sur des informations publiques. Ce qui détermine réellement le modèle à choisir, ce sont le taux de réussite, la latence et le coût de vos propres tâches dans des conditions identiques. À ce jour, nous ne disposons pas, sur la plateforme APIYI, de données de taux de réussite, de latence et de facturation pour les deux modèles exécutant la même tâche dans le même groupe. Voici donc une méthodologie de comparaison que vous pouvez mettre en œuvre vous-même.
4.1 Variables contrôlées et champs à enregistrer
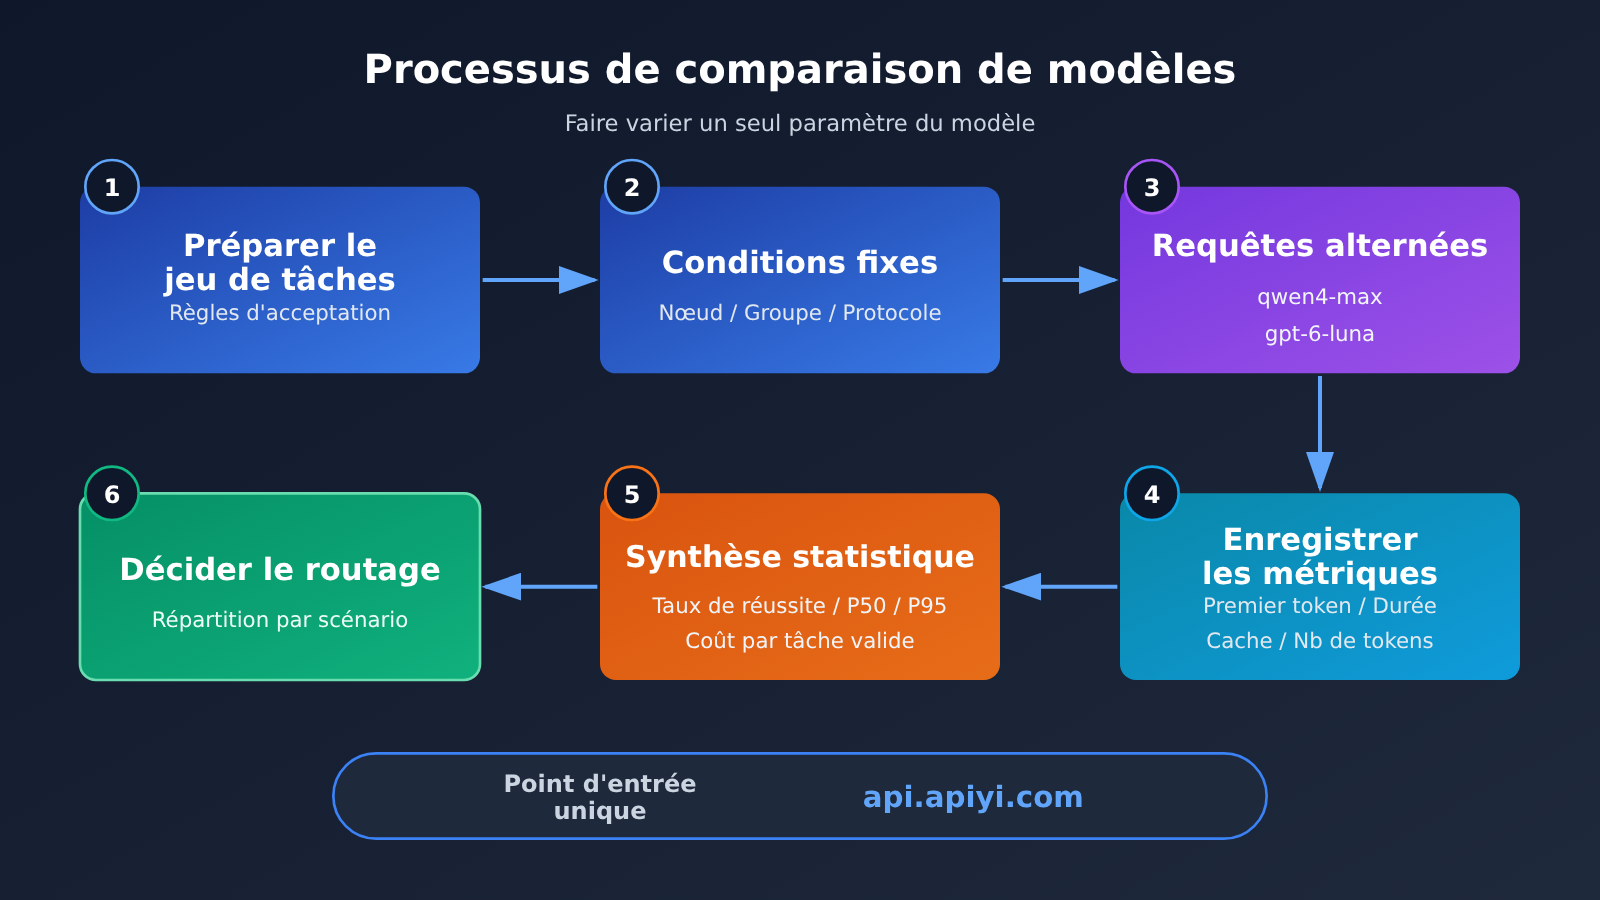
Le test comparatif doit faire varier autant que possible un seul paramètre : le « modèle ». Concrètement, utilisez le même nœud situé en Chine continentale et le même opérateur, le même groupe et le même protocole APIYI, le même jeu d’entrées et la même limite de sortie, puis alternez les requêtes vers les deux modèles avec la même concurrence. Cela évite le biais temporel qui apparaîtrait si vous faisiez tourner entièrement un modèle avant l’autre.
| Champ enregistré | Utilité |
|---|---|
| Acceptation réussie ? | Calculer le taux de réussite et le coût par tâche conforme |
| Statut HTTP, ID de requête | Diagnostiquer les échecs et rapprocher des journaux d’usage |
| Latence du premier Token de réponse visible | Mesurer l’expérience interactive ; pour les modèles de raisonnement, à distinguer du premier événement |
| Durée totale | Mesurer le débit de traitement par lots |
| Connexion froide/chaude, succès du cache | Expliquer les variations de latence et de coût |
| Nombre de Tokens d’entrée et de sortie | Vérifier l’usage réellement facturé |
Il est préférable d’enregistrer séparément les durées DNS, TCP et TLS. Lors de la présentation, indiquez clairement le nombre d’échantillons, le taux de réussite, P50 et P95 ; pour une comparaison publique externe, vous pouvez vous référer aux définitions du taux de réussite, de la latence du premier mot et du débit figurant dans le rapport de l’Académie chinoise des technologies de l’information et des communications (CAICT).
4.2 Script minimal de comparaison alternée
Le script ci-dessous appelle alternativement deux modèles via l’interface compatible OpenAI, en utilisant la sortie en streaming pour mesurer le token de première réponse visible et la durée totale. La fonction de validation doit être remplacée selon votre tâche ; si vous devez définir un niveau de raisonnement, vérifiez d’abord le nom du paramètre dans la documentation APIYI avant de l’ajouter, et mentionnez-le dans vos notes.
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, les deux modèles partagent une seule clé
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["Transforme le compte rendu de réunion suivant en JSON :...", "..."]  # Remplacez par votre jeu de tâches

def passed(task, answer):
    return answer.strip().startswith("{")  # Remplacez par la vraie règle de validation

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # Requêtes alternées pour réduire le biais temporel
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # Les deux modèles utilisent la même limite de sortie
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # Token de première réponse visible
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "échantillons", n, "taux de réussite", sum(r["ok"] for r in rs) / n,
          "P50 premier token", statistics.median(ttfts) if ttfts else None,
          "P95 premier token", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
Pour l’utilisation des tokens et les coûts, je recommande de les agréger directement depuis les journaux d’utilisation de la plateforme, par ID de requête, puis de les reporter dans la formule ci-dessous.
4.3 Coût d’une tâche conforme et routage par paliers
Le coût d’une tâche conforme = l’ensemble des frais d’appel (y compris les échecs et les nouvelles tentatives) + le coût de la vérification humaine et des reprises, divisé par le nombre de tâches finalement acceptées. Si un modèle à prix unitaire bas a un taux de réussite faible, le dénominateur diminue et le numérateur augmente : son coût par tâche conforme peut alors dépasser celui d’un modèle plus cher. À l’inverse, si les taux de réussite des deux modèles sont proches, l’écart de prix unitaire se retrouve presque tel quel dans le résultat.
On peut donc router selon la complexité de la tâche : les tâches ordinaires passent par défaut par gpt-6-luna, les tâches très complexes ou les tâches vidéo par qwen4-max. Avant d’activer une route, on vérifie d’abord si son taux d’acceptation sur l’ensemble de tâches concerné atteint le seuil, puis on regarde le coût par tâche conforme. Comme les deux modèles sont accessibles via la même interface compatible OpenAI d’APIYI apiyi.com, changer de route ne demande que de modifier le champ model.
🎯 Conseil pour le comparatif : les nouveaux utilisateurs peuvent d’abord faire tourner le script avec le quota d’essai offert à l’inscription, listé sur la page de démarrage rapide d’APIYI apiyi.com, puis recharger leur compte selon la taille de leur ensemble de tâches pour lancer le comparatif officiel.
4.4 Les données de sondage d’entrée ne décrivent que les limites de la mesure
Le tableau de surveillance public de Lingjian AI a échantillonné le domaine d’APIYI depuis des nœuds en Chine continentale : les trois enregistrements HTTP 200 du 2026-11-05 au 11-06 affichent des durées de 429, 569 et 565 ms. Ce type de sondage ne reflète que la connectivité de l’entrée ; la page compte en outre certains HTTP 404 comme normaux, et elle ne précise ni la charge des requêtes ni le mode d’authentification. On ne peut donc pas en déduire la latence de génération ni le taux de réussite des modèles. Le temps jusqu’au premier token d’Artificial Analysis ne représente lui aussi que son propre environnement de test : les résultats dans vos conditions de réseau et de concurrence doivent être mesurés séparément avec la méthode du 4.1.
Pour revenir à la question du titre : l’entrée vidéo est un seuil incontournable, et seul Qwen4-Max le franchit. Sur les tâches purement textuelles et image-texte, l’avantage de prix affiché de GPT-6 Luna est maximal en contexte court, et se réduit une fois que l’entrée dépasse 272 000 tokens ; sur les tâches à plusieurs étapes très complexes, l’avance de Qwen4-Max sur certaines sous-métriques peut compenser l’écart de prix unitaire. Ces trois conclusions dépendent du palier, de la longueur d’entrée et du type de tâche ; en dernier ressort, c’est le coût par tâche conforme sur votre propre ensemble de tâches qui tranche. Si vous avez besoin d’un point d’entrée unique pour des comparatifs en alternance, vous pouvez appeler les deux modèles avec une seule clé via APIYI apiyi.com.
Références
- Artificial Analysis – Comparaison des lancements de Qwen4 Max et GPT-6 Luna : Intelligence Index v5.0.1 et données détaillées par critère
- Lien :
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- Lien :
- Alibaba Cloud Model Studio – Fiche modèle et grille tarifaire de Qwen4-Max : modalités d’entrée et tarifs standard pour Singapour
- Lien :
alibabacloud.com/help/en/model-studio/model-pricing
- Lien :
- OpenAI – GPT-6 Luna Model : modalités d’entrée et tarification du contexte long
- Lien :
developers.openai.com/api/docs/models/gpt-6-luna
- Lien :
- OrcaRouter – Qwen4-Max vs GPT-6 Luna : ratio des prix unitaires, explication du passage de palier à 272 000 tokens
- Lien :
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- Lien :
- Together AI – Pricing : prix promotionnel à durée limitée sur Qwen4 Max
- Lien :
together.ai/pricing
- Lien :
- APIYI – Tableau récapitulatif des prix des modèles, registre des modèles et FAQ sur les promotions de recharge : prix catalogue, groupes d’endpoints et paliers de bonus
- Lien :
docs.apiyi.com/models
- Lien :
- CAICT (Académie chinoise des technologies de l’information et des communications) et al. – Rapport de suivi des performances des services de tokens pour grands modèles de langage (2026) : taux de réussite, latence du premier token, définitions du débit
- Lien :
caict.ac.cn
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI apiyi.com ; vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com


