
Neste artigo, uso as métricas de Qwen4-Max e GPT-6 Luna no mesmo ranking, os preços para contexto longo e as modalidades de entrada para fazer uma rodada de seleção de Modelo de Linguagem Grande — e transformar a pontuação composta em critérios de aceitação e avaliação de custo para tarefas específicas.
Primeiro a conclusão, depois as condições. Se a tarefa exigir entrada de vídeo, pelas fichas técnicas dos dois modelos só dá para considerar o Qwen4-Max; o GPT-6 Luna nem entra como candidato. Se for uma tarefa somente de texto ou de texto com imagem, e o custo por chamada e o volume de chamadas forem restrições rígidas, o preço tabelado do GPT-6 Luna é bem menor, então vale usá-lo como opção padrão. Se for uma tarefa de alta complexidade, como automação de múltiplas etapas, o Qwen4-Max lidera claramente em alguns subindicadores do Artificial Analysis e pode ser candidato para roteamento de alta complexidade. No fim, qual opção usar depende da taxa de aprovação nos critérios de aceitação e do custo por tarefa aprovada no seu próprio conjunto de tarefas.
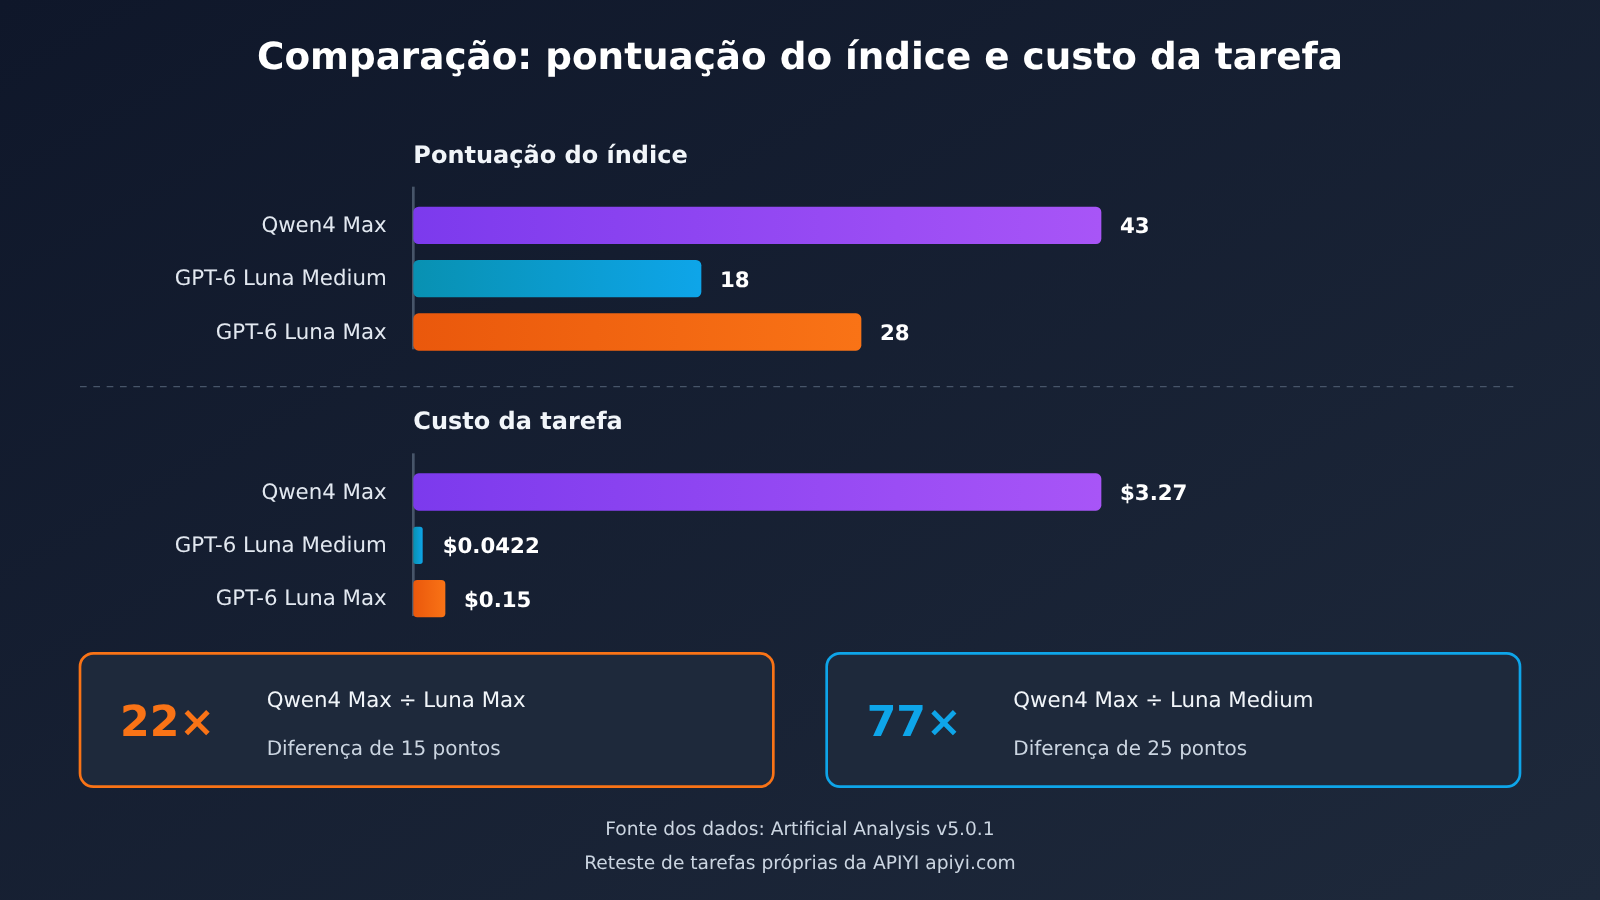
A conclusão muda com três condições. Primeiro, com o nível de raciocínio do Luna diferente, a diferença na pontuação do índice e no custo por tarefa pode passar de cerca de 22 vezes para cerca de 77 vezes. Segundo, quando a entrada passa de 272.000 tokens, o Luna sobe de faixa para a requisição inteira conforme a tabela de preços da OpenAI. Terceiro, em uma tarefa específica, a diferença em um subindicador pode ser bem pequena. No FrontierCode-AA 2.0, por exemplo, os dois ficam a apenas 1,3 ponto percentual de distância.
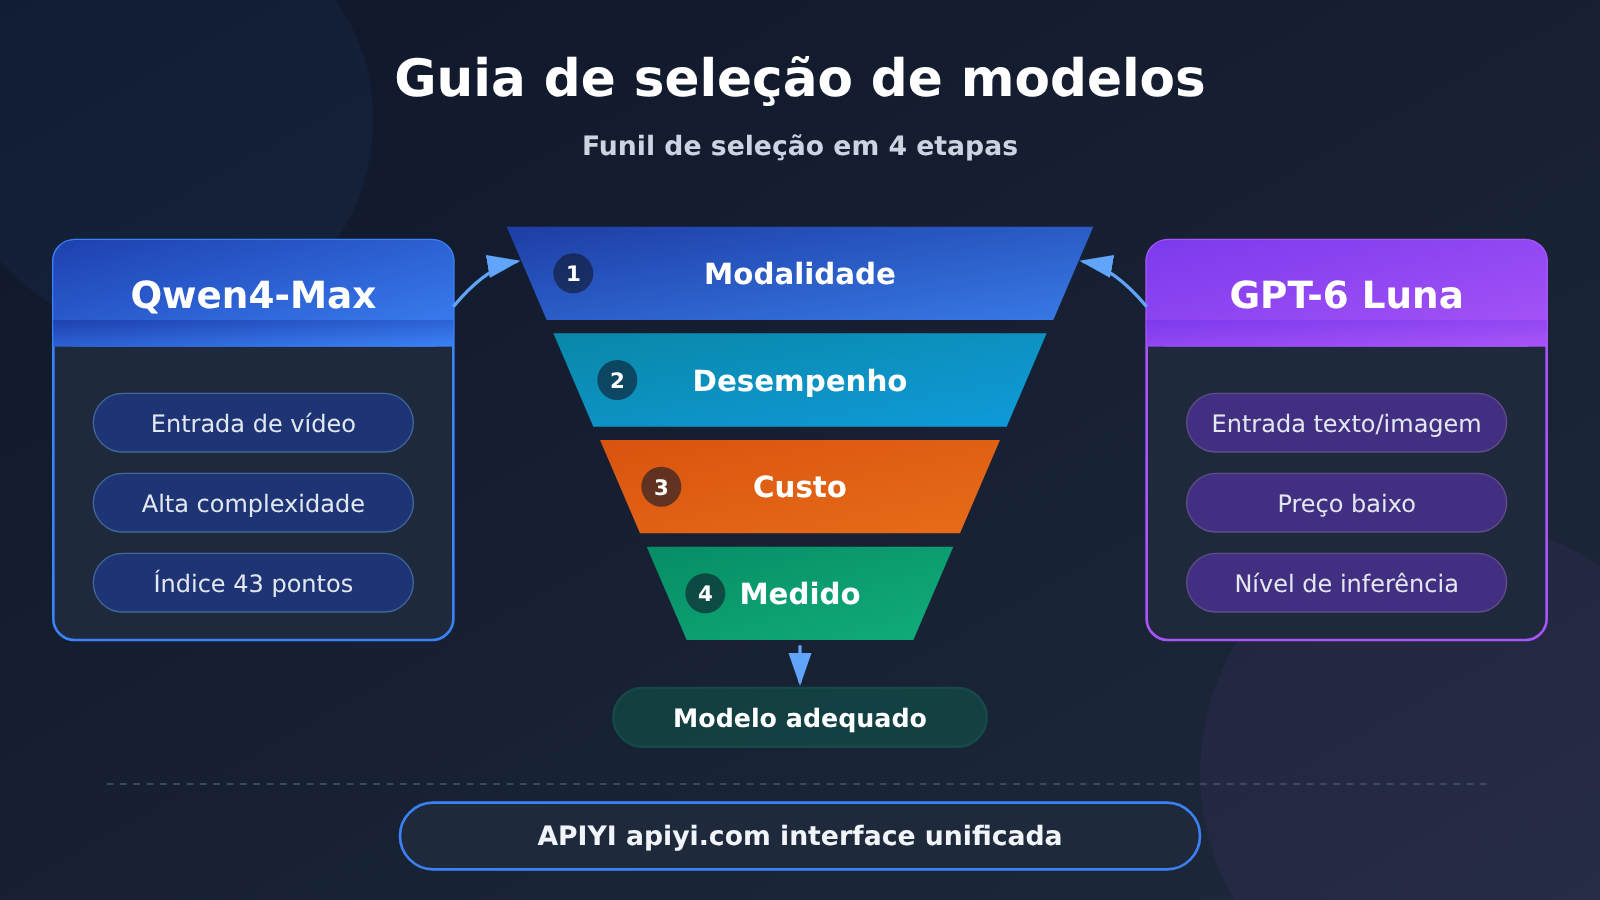
Comparação rápida para escolha de modelo: Qwen4-Max e GPT-6 Luna
A tabela abaixo lista apenas as dimensões que influenciam a escolha do modelo. As pontuações vêm do Intelligence Index v5.0.1 do Artificial Analysis; os preços vêm da lista pública dos fabricantes ou do catálogo da APIYI. Todas são informações públicas na data de verificação deste artigo, 2026-11-20, e não medições pagas feitas por nós.
| Dimensão de comparação | Qwen4-Max | GPT-6 Luna | O que a diferença significa |
|---|---|---|---|
| Modalidades de entrada (ficha do modelo do fabricante) | Texto, imagem, vídeo | Texto, imagem | Tarefas com vídeo eliminam o Luna de cara |
| Modalidades de saída | Texto | Texto | Nenhum dos dois gera imagens ou áudio |
| Intelligence Index v5.0.1 | 43 pontos | nível Medium: 18 pontos; nível Max: 28 pontos | A diferença varia conforme o nível |
| Custo por tarefa do índice | $3.27 | nível Medium: $0.0422; nível Max: $0.15 | Válido apenas para essa carga de trabalho do índice |
| Preço de tabela do fabricante (por milhão de tokens, contexto curto) | Alibaba Cloud Singapura: entrada $1.50, saída $4.50 | OpenAI padrão: entrada $0.10, saída $0.50 | A entrada custa cerca de 15 vezes mais; a saída, 9 vezes mais |
| Precificação de entradas longas | Fontes de terceiros afirmam que há uma tarifa única para toda a janela de contexto | Acima de 272,000 tokens, a requisição inteira passa para uma faixa superior | Em cenários de documentos longos, é preciso calcular separadamente |
| Endpoints no catálogo da APIYI | chat, responses, messages | Chat Completions, Responses | A escolha do protocolo afeta o custo de migração |
| Plataformas disponíveis | APIYI apiyi.com, Alibaba Cloud Model Studio, etc. | APIYI apiyi.com, OpenAI oficial, etc. | Usar a mesma chave API facilita a comparação alternada |
O texto segue a ordem de dependência para a escolha. A seção 1 confirma primeiro se é possível integrar, porque, se as modalidades ou os endpoints não atenderem aos requisitos, as pontuações e os preços seguintes perdem o sentido. A seção 2 compara o desempenho sob o mesmo benchmark; a seção 3 separa, com o mesmo volume de uso, o preço do fabricante, o preço do catálogo e o valor efetivamente pago na conta; a seção 4 transforma as conclusões anteriores em etapas que você pode retestar no seu próprio negócio. Quem só se preocupa com custo pode ir direto para a seção 3, mas recomendo ver antes os critérios de eliminação da seção 1.
Termos que você precisa conhecer antes de escolher um modelo de linguagem grande (To Know)
| Termo | O que significa neste artigo |
|---|---|
| Intelligence Index | Pontuação agregada do Artificial Analysis para o desempenho em várias tarefas em uma versão específica; neste artigo, usamos a v5.0.1 |
| Custo por tarefa do índice | Estimativa de consumo para concluir uma tarefa nesse benchmark; o nível de raciocínio e o volume de entrada e saída alteram o resultado |
| Nível de raciocínio | Controla a intensidade de raciocínio investida pelo modelo, como Medium e Max no Luna; é obrigatório indicar qual foi usado na comparação |
| Modalidade de entrada | Tipo de conteúdo que o modelo recebe, como texto, imagem ou vídeo |
| Precificação escalonada por contexto | Quando a entrada ultrapassa determinado limite, outra tabela de tarifas passa a valer; é preciso confirmar se ela incide apenas sobre o excedente ou sobre a requisição inteira |
| Leitura de cache | Item de cobrança pelo reaproveitamento de entradas já existentes; deve ser contabilizado conforme a tabela de preços e os registros reais de acerto de cache |
| Latência até o primeiro token visível da resposta | Tempo entre o envio da requisição e o aparecimento do primeiro trecho de resposta utilizável; em modelos de raciocínio, é preciso distingui-lo do “primeiro evento” |
| P50 / P95 | Mediana e 95º percentil da distribuição de latência, que refletem, respectivamente, o valor típico e as requisições lentas |
| Custo por tarefa qualificada | O custo total de falhas, revisões e refações distribuído por cada resultado que realmente atende ao critério |
1. Primeiro passo na seleção do Modelo de Linguagem Grande: eliminar combinações inadequadas pelas restrições da tarefa
A ação que mais economiza dinheiro na seleção é eliminar primeiro. Não importa quão alta seja a pontuação de um modelo: se ele não aceita seu tipo de entrada ou protocolo de chamada, só resta descartá-lo; por outro lado, se um modelo barato não atende às restrições rígidas, também não adianta calcular o custo depois.
1.1 Usar o cartão do modelo para distinguir as modalidades de entrada
O cartão de modelo do Alibaba Cloud Model Studio lista que o Qwen4-Max aceita entrada de texto, imagem e vídeo, com saída em texto. O cartão de modelo da OpenAI lista que o GPT-6 Luna aceita entrada de texto e imagem, com saída em texto; a compilação do OrcaRouter também menciona que o Luna não oferece geração de imagens, geração de voz, transcrição e tradução. Essa é a diferença mais rígida entre os dois e determina que, para tarefas de vídeo, o Qwen4-Max é o único candidato.
Vale notar que o cartão de modelo do fabricante descreve a capacidade do próprio modelo; para um integrador ou endpoint específico, é preciso verificar à parte se os parâmetros de vídeo podem ser passados. Por exemplo, a página de modelos da Together AI lista explicitamente entrada de texto e imagem, mas não encontramos uma descrição de vídeo na mesma rota; nesse caso, só podemos dizer que “a Together AI lista explicitamente texto e imagem”, sem concluir que ela suporta vídeo.
1.2 Verificar ID, grupo e endpoint no catálogo da APIYI
Em 2026-11-17, a APIYI anunciou o lançamento do qwen4-max; o registro público de modelos gerado em 2026-11-20 lista seus endpoints como chat, responses e messages, e seus grupos como ClaudeCode, CodexResponses, default e svip. O gpt-6-luna aparece na tabela de preços com os grupos Default e SVIP e entradas de Chat Completions e Responses. A afirmação anterior do blog de que “o Qwen4-Max ainda não estava disponível” deve ser atualizada conforme o anúncio e o registro mais recentes.
O catálogo só comprova que a plataforma suporta esse modelo e esse endpoint; o grupo da sua conta e as permissões do token afetam se você realmente consegue chamar. Recomendo que, depois de criar um token no console da APIYI apiyi.com, você confirme com uma requisição mínima se o ID exato do modelo e o endpoint estão disponíveis, e só então passe para a comparação de resultados.
1.3 Restrições não negociáveis de cada um dos três cenários
| Cenário | Restrições não negociáveis | Resultado da eliminação | Próximo foco |
|---|---|---|---|
| Organização de registros de texto (atas de reunião, arquivamento de tickets) | Formato de saída estável, custo por chamada baixo, grande volume de chamadas | Ambos podem entrar | Comparar taxa de aprovação de formato e custo unitário |
| Compreensão de vídeo (inspeção de qualidade de gravações de tela, resumo de vídeo) | Precisa aceitar entrada de vídeo | GPT-6 Luna eliminado conforme o cartão do modelo | Verificar se o endpoint e o token suportam parâmetros de vídeo |
| Fluxos complexos (automação em várias etapas, operações entre sistemas) | Alta taxa de sucesso na execução de várias etapas; o custo de falha é alto | Ambos podem entrar | Priorizar a taxa de aprovação na validação, não o preço unitário |
A organização de registros de texto é um cenário tipicamente sensível a custo. A tarefa em si não é difícil; o ponto principal está no gasto médio por resultado quando há chamadas em grande volume. Já a compreensão de vídeo é uma questão de barreira de capacidade: se a modalidade não corresponde, não há por que comparar. Falhas em fluxos complexos muitas vezes significam retrabalho manual; se um modelo barato falha várias vezes, o custo real pode acabar sendo maior. Isso será calculado em detalhes nas seções 3 e 4.
2. Segundo passo na escolha do Modelo de Linguagem Grande: comparar o retorno sob o mesmo benchmark
Depois de concluir a eliminação, aí sim vamos olhar os resultados. Aqui uso apenas os dados da mesma página de comparação de lançamento do Artificial Analysis, porque rankings diferentes têm conjuntos de tarefas e métodos de pontuação diferentes — misturar tudo numa única classificação não faz sentido.
2.1 A pontuação geral e o custo por tarefa precisam ser lidos junto com o nível
| Configuração | Intelligence Index v5.0.1 | Custo por tarefa do índice | Multiplicador de custo em relação ao Qwen4-Max |
|---|---|---|---|
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna (Medium, nível padrão) | 18 | $0.0422 | cerca de 1/77 |
| GPT-6 Luna (nível Max) | 28 | $0.15 | cerca de 1/22 |
O famoso “cerca de 22 vezes” vem de $3.27 ÷ $0.15, comparando o Qwen4 Max com o nível Max do Luna, e nesse caso a diferença de pontuação é de 15 pontos. Se compararmos com o nível Medium padrão do Luna, o multiplicador de custo fica em cerca de 77 vezes, com diferença de 25 pontos. Então dizer apenas “é 22 vezes mais caro” não conta a história toda — é preciso também dizer qual nível e qual carga de trabalho.
Outro detalhe é a completude dos dados. O OrcaRouter aponta que o ranking divulgou apenas uma pontuação do Qwen4-Max, sem dados por nível; já o Luna publicou toda a escada de níveis. Ao fazer previsão de custos, uma escada completa mostra o ponto de inflexão em que “subir de nível ainda faz a pontuação crescer”, e esse tipo de informação às vezes é mais útil do que uma única pontuação mais alta.
2.2 As diferenças por item variam conforme a tarefa
A pontuação agregada não consegue prever o retorno de uma tarefa específica. No AutomationBench-AA, o Qwen4 Max fica em 72.6% e o Luna Max em 53.2%, uma diferença de cerca de 19 pontos percentuais; já no FrontierCode-AA 2.0, os dois ficam em 26.5% e 25.2%, respectivamente, apenas 1.3 ponto percentual de diferença.
Voltando aos cenários da seção 1, um fluxo complexo se parece mais com tarefas de automação em múltiplas etapas, como as do AutomationBench, e a liderança do Qwen4-Max pode se traduzir em menos retrabalho. Se a sua tarefa estiver mais próxima do estilo FrontierCode, a diferença entre os dois é pequena enquanto a diferença de preço unitário continua grande, o que deixa o custo-benefício do Luna bem mais evidente. Isso é só uma avaliação de direção — na prática, ainda é preciso validar no seu próprio conjunto de tarefas.
3. Terceira etapa da seleção de Modelos de Linguagem Grande: separar o preço do fornecedor, o preço de catálogo e os custos da conta
O custo é a parte que mais facilmente acaba sendo tratada de forma misturada. Esta seção divide o assunto em três camadas: o preço público do fornecedor, o preço de catálogo da APIYI e o valor efetivamente pago na conta após o bônus de recarga. Os três pertencem a categorias diferentes e não podem substituir uns aos outros.
3.1 Exemplo de cálculo com o preço do fornecedor para a mesma solicitação de entrada longa
Suponha uma solicitação com 400 mil tokens de entrada, 8.000 tokens de saída cobrados, sem acerto de cache e sem custos adicionais de ferramentas.
| Item | Qwen4-Max (preço padrão do Alibaba Cloud International em Singapura) | GPT-6 Luna (preço padrão da OpenAI, entrada longa) |
|---|---|---|
| Tarifa de entrada | $1,50 / milhão | $0,20 / milhão (acima de 272.000, a faixa mais alta se aplica à solicitação inteira) |
| Tarifa de saída | $4,50 / milhão | $0,75 / milhão |
| Cálculo | 0,4 × 1,50 + 0,008 × 4,50 | 0,4 × 0,20 + 0,008 × 0,75 |
| Custo por solicitação | $0,636 | $0,086 |
A proporção entre os dois é de cerca de 7,40 vezes, aproximadamente metade da diferença de 15 para 1 observada no preço unitário de entrada em contexto curto. A razão está na regra de mudança de faixa da Luna. Segundo a tabela da OpenAI, no caso de entrada longa a mudança de faixa se aplica à solicitação inteira, e não apenas à parte que ultrapassa o limite: em um comando de 300 mil tokens, todos os 300 mil são cobrados pela tarifa mais alta, não apenas os últimos 28.000. Uma compilação do OrcaRouter afirma que o Qwen4-Max é cobrado pela mesma tarifa em toda a janela de 1 milhão, sem faixas de 32K ou 128K.
O preço do fornecedor também muda conforme a região e o canal. O OrcaRouter lista o Qwen4-Max na região Global com entrada a $1,413 e saída a $4,24, diferente de Singapura. A página oficial de Pricing da Together AI marca o Qwen4 Max como promoção, com preço por tempo limitado de $1,05 para entrada, $3,15 para saída e $0,0525 para leitura de cache — exatamente 70% do preço de Singapura. A página indica validade até 2026-11-23, mas não informa o fuso horário; já a página de detalhes do modelo mostra outra faixa: $1,43, $4,28 e $0,0713. Ao citar esse tipo de preço, deixe claro a página de origem e a data; a cobrança efetiva segue o uso da conta.
3.2 Preço de catálogo da APIYI calculado pela tarifa de catálogo e pelo log de uso
No catálogo da APIYI, o qwen4-max custa $1,50 por milhão de tokens de entrada, $4,50 de saída e $0,075 de leitura de cache; o gpt-6-luna custa $0,10 de entrada com contexto curto, $0,50 de saída e $0,01 de leitura de cache, com a tabela de preços indicando que a entrada sobe para $0,20 quando passa de 272.000 tokens.
Aplicando a mesma requisição de 3.1, o qwen4-max também fica em $0,636 pela tarifa de catálogo. No gpt-6-luna, a parte de entrada fica em 0,4 × 0,20 = $0,08; a tabela de preços verificada nesta rodada só especifica o aumento da tarifa de entrada, então a tarifa aplicada à parte de saída em contexto longo deve ser conferida na tabela de preços vigente e no log de uso. O número real de custo deve vir do log de uso da sua conta, e não das fórmulas acima.
💰 Sugestão de apuração de custos: chame os dois modelos na mesma conta da APIYI (apiyi.com) e o log de uso registrará os tokens de entrada, saída e cache de cada requisição, o que chega mais perto da fatura real do que uma estimativa baseada nos preços públicos.
3.3 O bônus de recarga afeta a conversão do principal, não o preço unitário do modelo
O FAQ atual da APIYI lista as faixas de bônus por recarga individual: de $100 a menos de $500 ganha 10% de bônus, de $500 a menos de $1.000 ganha 12%, de $1.000 a menos de $3.000 ganha 15%, e a partir de $3.000 ganha 20%. Recargas online e por transferência corporativa podem participar, e o bônus é creditado automaticamente; se um ajuste de preço individual feito pelo time comercial pode acumular com isso, é preciso confirmar à parte. Usuários comuns recebem ainda $1 na primeira recarga, e usuários educacionais com e-mail institucional verificado recebem $2, que precisa ser solicitado ao atendimento; o saldo recarregado segue a regra de 365 dias indicada na documentação.
| Faixa de recarga | Saldo creditado | Principal de recarga equivalente a $1 de log | Redução do custo de principal |
|---|---|---|---|
| $100 em uma recarga | $110 | cerca de $0,909 | cerca de 9,09% |
| A partir de $3.000 em uma recarga | valor recarregado × 1,2 | cerca de $0,833 | cerca de 16,67% |
A premissa aqui é que todo o saldo de bônus seja usado. Na faixa de 10%, o custo de log de $0,636 em 3.1 corresponde a cerca de $0,578 de principal de recarga. Vale notar que o bônus vale para todo o saldo do site: ele reduz o principal correspondente a cada $1 de limite de log, e não deve ser entendido como um desconto extra em um modelo específico; ao comparar opções, use o mesmo coeficiente de conversão dos dois lados, senão a comparação fica distorcida.
4. Quarta etapa da seleção do Modelo de Linguagem Grande: transformar as condições em passos comparáveis e testáveis
As três seções anteriores se baseiam apenas em informações públicas. O que realmente decide qual modelo escolher são a taxa de aprovação, a latência e o custo da sua própria tarefa sob as mesmas condições. No momento, não temos dados de taxa de sucesso, latência e cobrança dos dois modelos na plataforma APIYI para a mesma tarefa e o mesmo grupo. A seguir, apresentamos uma metodologia de comparação que você pode executar por conta própria.
4.1 Controle de variáveis e campos de registro
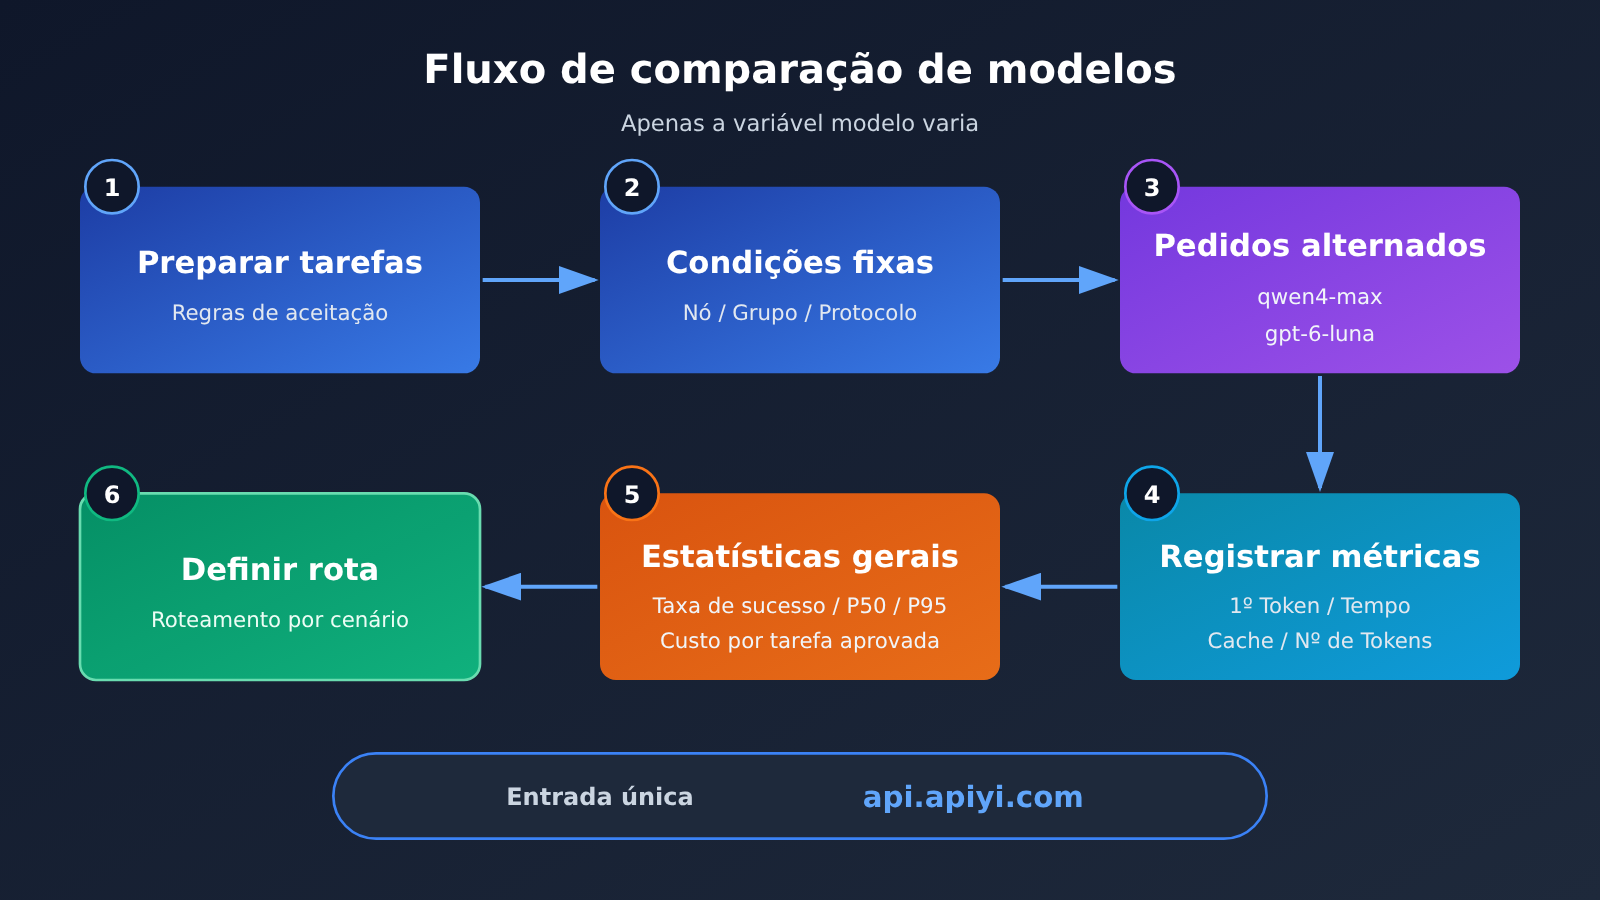
A comparação deve, na medida do possível, variar apenas a variável “modelo”. Na prática, use o mesmo nó na China continental e a mesma operadora, o mesmo grupo e protocolo da APIYI, o mesmo conjunto de entradas e o mesmo limite de saída e, sob a mesma concorrência, alterne as requisições entre os dois modelos. Isso evita o viés temporal de executar um modelo até o fim e só depois o outro.
| Campo de registro | Uso |
|---|---|
| Aprovação na aceitação | Calcular a taxa de aprovação e o custo por tarefa qualificada |
| Status HTTP, ID da requisição | Investigar falhas e conciliar com os logs de uso |
| Latência até o primeiro token visível da resposta | Medir a experiência de interação; em modelos de raciocínio, deve ser medida separadamente do primeiro evento |
| Tempo total | Medir o throughput de processamento em lote |
| Conexão fria/quente, acerto de cache | Explicar flutuações de latência e custo |
| Número de tokens de entrada e saída | Conferir o uso efetivamente cobrado |
É melhor registrar separadamente os tempos de DNS, TCP e TLS. Ao reportar os resultados, deixe explícitos o número de amostras, a taxa de aprovação, o P50 e o P95; se for fazer uma comparação pública externa, pode-se tomar como referência as definições de taxa de sucesso, latência do primeiro token e throughput do relatório da CAICT (Academia Chinesa de Tecnologia da Informação e Comunicações).
4.2 Script mínimo de comparação alternada
O script abaixo chama dois modelos alternadamente através da interface compatível com OpenAI, usando saída em streaming para medir o tempo até o primeiro Token de resposta visível e o tempo total. A função de validação precisa ser substituída de acordo com a sua tarefa; caso seja necessário configurar o nível de raciocínio, confirme o nome do parâmetro na documentação do APIYI antes de adicioná-lo e registre isso no log.
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada do APIYI, os dois modelos compartilham uma única chave
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的会议记录整理成 JSON:...", "..."]  # Substitua pelo seu conjunto de tarefas

def passed(task, answer):
    return answer.strip().startswith("{")  # Substitua pela regra real de validação

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # Requisições alternadas para reduzir o viés de horário
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # Os dois modelos usam o mesmo limite de saída
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # Primeiro Token de resposta visível
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "样本", n, "通过率", sum(r["ok"] for r in rs) / n,
          "首字P50", statistics.median(ttfts) if ttfts else None,
          "首字P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
Para o consumo de Tokens e o custo, recomenda-se agregar diretamente os logs de uso da plataforma por ID de requisição e depois aplicar a fórmula abaixo.
4.3 Custo por tarefa qualificada e roteamento por níveis
Custo por tarefa qualificada = todos os custos de chamada (incluindo falhas e novas tentativas) + custos de revisão manual e retrabalho, dividido pelo número de tarefas finalmente aprovadas na aceitação. Se um modelo com preço unitário mais baixo tiver baixa taxa de aprovação, o denominador diminui e o numerador aumenta, e o custo por tarefa qualificada pode acabar ficando acima do modelo com preço unitário mais alto; por outro lado, se as taxas de aprovação dos dois forem parecidas, a diferença de preço unitário aparecerá quase intacta no resultado.
Com base nisso, dá para rotear por nível de complexidade da tarefa: tarefas comuns usam gpt-6-luna por padrão; tarefas de alta complexidade ou tarefas de vídeo usam qwen4-max. Para decidir se uma rota deve ser ativada, primeiro veja se a taxa de aprovação dela no conjunto de tarefas correspondente atinge o mínimo exigido; depois, olhe para o custo por tarefa qualificada. Como os dois modelos estão sob o mesmo conjunto de interfaces compatíveis com OpenAI da APIYI (apiyi.com), trocar a rota exige apenas alterar o campo model.
🎯 Sugestão para o teste comparativo: novos usuários podem primeiro usar a cota de teste de cadastro listada na página de início rápido da APIYI (apiyi.com) para rodar o script de ponta a ponta, e depois recarregar créditos conforme o tamanho do conjunto de tarefas para fazer o teste comparativo formal.
4.4 Dados de sondagem de endpoint só mostram os limites da medição
A tabela pública de monitoramento da Lingjian AI coletou amostras de nós da China continental para o domínio da APIYI; os tempos de três registros HTTP 200, de 2026-11-05 a 11-06, foram 429, 569 e 565 ms, respectivamente. Esse tipo de sondagem reflete apenas a conectividade do endpoint; além disso, a página conta alguns HTTP 404 como normais e não informa o payload da requisição nem o método de autenticação, portanto não serve para inferir a latência de geração nem a taxa de sucesso do modelo. O tempo até o primeiro token do Artificial Analysis também representa apenas o ambiente de avaliação dele; os resultados nas suas condições de rede e concorrência precisam ser medidos separadamente com o método da seção 4.1.
Voltando à pergunta do título: a entrada de vídeo é um requisito obrigatório, e o único que o atende é o Qwen4-Max; em tarefas somente de texto e em tarefas de texto com imagem, a vantagem no preço de tabela do GPT-6 Luna é maior em contextos curtos e diminui quando a entrada passa de 272.000 tokens; em tarefas de alta complexidade com várias etapas, a vantagem do Qwen4-Max em itens específicos pode compensar a diferença de preço unitário. As três conclusões dependem da faixa, do comprimento da entrada e do tipo de tarefa; no fim, vale o custo por tarefa qualificada no seu próprio conjunto de tarefas. Quando precisar fazer um teste comparativo alternado com um ponto de entrada unificado, você pode chamar os dois modelos ao mesmo tempo com uma única chave pela APIYI (apiyi.com).
Materiais de referência
- Artificial Analysis – Comparação de lançamento Qwen4 Max vs. GPT-6 Luna: Intelligence Index v5.0.1 e dados por categoria
- Link:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- Link:
- Alibaba Cloud Model Studio – Model card e tabela de preços do Qwen4-Max: modalidades de entrada e preço padrão de Singapura
- Link:
alibabacloud.com/help/en/model-studio/model-pricing
- Link:
- OpenAI – GPT-6 Luna Model: modalidades de entrada e precificação de contexto longo
- Link:
developers.openai.com/api/docs/models/gpt-6-luna
- Link:
- OrcaRouter – Qwen4-Max vs GPT-6 Luna: proporção de preço unitário, explicação da mudança de faixa para 272.000 tokens
- Link:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- Link:
- Together AI – Pricing: preço promocional por tempo limitado do Qwen4 Max
- Link:
together.ai/pricing
- Link:
- APIYI – Tabela resumida de preços dos modelos, registro de modelos e FAQ de campanha de recarga: preço de tabela, agrupamento de endpoints e níveis de bônus extras
- Link:
docs.apiyi.com/models
- Link:
- CAICT e outros – Relatório de monitoramento de desempenho do serviço de tokens de Modelos de Linguagem Grande (2026): definições de taxa de sucesso, latência do primeiro token e throughput
- Link:
caict.ac.cn
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Fique à vontade para nos contatar pela página inicial do site APIYI apiyi.com. Mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com


