
Artikel ini menggunakan metrik papan peringkat yang sama, harga konteks panjang, dan modalitas input dari Qwen4-Max serta GPT-6 Luna untuk melakukan satu putaran pemilihan Model Bahasa Besar, lalu mengubah skor komprehensif menjadi kriteria penerimaan dan penilaian biaya untuk tugas konkret.
Kesimpulan lebih dulu, syarat menyusul. Jika tugas harus memasukkan video, berdasarkan kartu model kedua penyedia, hanya Qwen4-Max yang bisa dipertimbangkan lebih dulu; GPT-6 Luna tidak masuk kandidat. Jika tugasnya teks murni atau teks-gambar, dan biaya per panggilan serta volume panggilan merupakan batasan keras, harga yang tercantum untuk GPT-6 Luna jauh lebih rendah dan layak dijadikan opsi default. Jika tugasnya berlapis seperti otomasi multi-langkah dengan kompleksitas tinggi, Qwen4-Max unggul jelas pada sebagian subskor Artificial Analysis dan dapat menjadi kandidat untuk perutean kompleksitas tinggi. Tingkat mana yang akhirnya dipakai bergantung pada tingkat kelulusan uji penerimaan dan biaya per tugas yang memenuhi syarat pada kumpulan tugas Anda sendiri.
Kesimpulan ini dapat berubah karena tiga kondisi. Pertama, dengan tingkat penalaran Luna yang berbeda, selisih skor indeks dan biaya tugas dapat berubah dari sekitar 22 kali menjadi sekitar 77 kali. Kedua, ketika input melebihi 272,000 Token, Luna menaikkan seluruh permintaan ke tingkat harga berikutnya sesuai daftar harga OpenAI. Ketiga, selisih subskor pada tugas tertentu bisa sangat kecil; misalnya pada FrontierCode-AA 2.0 keduanya hanya berbeda 1.3 poin persentase.
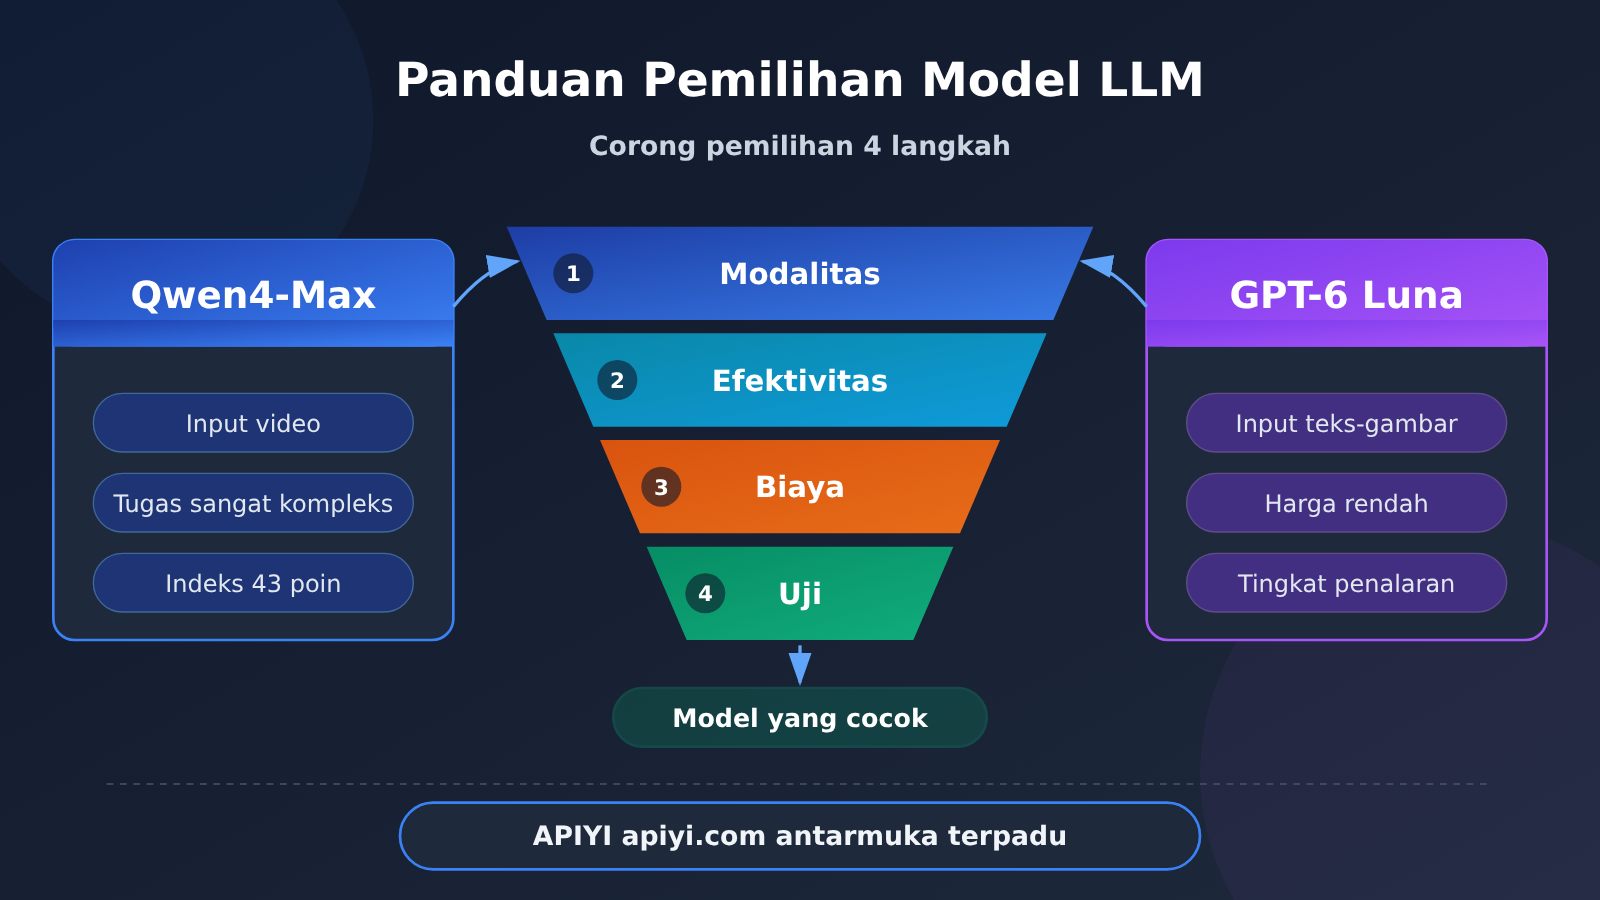
Ringkasan cepat perbandingan pemilihan Model Bahasa Besar: Qwen4-Max dan GPT-6 Luna
Tabel berikut hanya mencantumkan dimensi yang memengaruhi keputusan pemilihan. Skor dalam tabel berasal dari Intelligence Index v5.0.1 milik Artificial Analysis, sedangkan harga berasal dari daftar harga publik vendor atau katalog APIYI. Semuanya adalah informasi publik pada tanggal verifikasi artikel ini, 2026-11-20, bukan hasil pengujian berbayar kami.
| Dimensi perbandingan | Qwen4-Max | GPT-6 Luna | Apa arti perbedaannya |
|---|---|---|---|
| Modalitas input (kartu model vendor) | Teks, gambar, video | Teks, gambar | Tugas video langsung menyingkirkan Luna |
| Modalitas output | Teks | Teks | Keduanya tidak menghasilkan gambar atau suara |
| Intelligence Index v5.0.1 | 43 poin | Tingkat Medium 18 poin; tingkat Max 28 poin | Tingkatnya berbeda, jadi selisihnya juga berbeda |
| Biaya tugas indeks | $3.27 | Tingkat Medium $0.0422; tingkat Max $0.15 | Hanya berlaku untuk beban kerja indeks tersebut |
| Harga resmi vendor (per juta token, konteks pendek) | Alibaba Cloud Singapura: input $1.50, output $4.50 | OpenAI standar: input $0.10, output $0.50 | Input sekitar 15 banding 1, output 9 banding 1 |
| Penagihan input panjang | Sumber pihak ketiga menyebut tarif seragam untuk seluruh jendela konteks | Permintaan yang melebihi 272,000 token seluruhnya naik ke tingkat berikutnya | Skenario dokumen panjang perlu dihitung terpisah |
| Endpoint katalog APIYI | chat, responses, messages | Chat Completions, Responses | Pilihan protokol memengaruhi biaya migrasi |
| Platform yang tersedia | APIYI apiyi.com, Alibaba Cloud Model Studio, dll. | APIYI apiyi.com, OpenAI resmi, dll. | Key yang sama memudahkan pengujian bergantian |
Uraian isi disusun mengikuti urutan ketergantungan dalam pemilihan. Bagian 1 terlebih dahulu memastikan apakah integrasi bisa dilakukan, karena jika modalitas atau endpoint tidak terpenuhi, skor dan harga di belakang tidak ada artinya. Bagian 2 membandingkan performa pada benchmark yang sama, bagian 3 dengan penggunaan yang sama menguraikan harga vendor, harga katalog, dan pembayaran aktual akun, bagian 4 mengubah penilaian sebelumnya menjadi langkah yang bisa diuji ulang pada bisnis Anda sendiri. Pembaca yang hanya peduli biaya bisa langsung melompat ke Bagian 3, tetapi sebaiknya lihat dulu syarat eliminasi di Bagian 1.
Istilah yang perlu diketahui saat memilih Model Bahasa Besar (To Know)
| Istilah | Makna dalam artikel ini |
|---|---|
| Intelligence Index | Skor ringkasan Artificial Analysis atas performa pada sejumlah tugas di versi tertentu; artikel ini memakai v5.0.1 |
| Biaya tugas indeks | Estimasi biaya untuk menjalankan satu tugas dalam benchmark tersebut; tingkat penalaran serta jumlah input dan output akan mengubah hasil |
| Tingkat penalaran | Mengontrol intensitas berpikir yang dikerahkan model, misalnya Medium dan Max pada Luna; saat membandingkan wajib dicantumkan |
| Modalitas input | Jenis konten yang diterima model, misalnya teks, gambar, atau video |
| Harga bertingkat berdasarkan konteks | Setelah input melewati ambang tertentu, penagihan memakai tarif lain; perlu dipastikan apakah hanya bagian yang melewati ambang atau seluruh permintaan yang dihitung |
| Pembacaan cache | Item penagihan untuk memakai kembali input yang sudah ada; harus dihitung berdasarkan daftar harga dan catatan hit aktual |
| Latensi token jawaban pertama yang terlihat | Waktu dari permintaan dikirim hingga muncul bagian jawaban pertama yang bisa dipakai; untuk model penalaran, bedakan dari “event pertama” |
| P50 / P95 | Median dan persentil ke-95 dari distribusi latensi, masing-masing mencerminkan nilai tipikal dan permintaan lambat |
| Biaya tugas yang memenuhi syarat | Membagi biaya kegagalan, peninjauan ulang, dan pengerjaan ulang ke setiap hasil yang benar-benar memenuhi standar |
1. Langkah pertama memilih Model Bahasa Besar: singkirkan kombinasi yang tidak cocok berdasarkan kendala tugas
Langkah paling hemat biaya dalam memilih model adalah menyortir lebih dulu. Sebagus apa pun skor sebuah model, jika tidak bisa menerima jenis input atau protokol pemanggilan Anda, model itu harus ditinggalkan. Sebaliknya, model murah yang tidak memenuhi kendala mutlak juga tidak perlu dihitung biayanya sejak awal.
1.1 Membedakan modalitas input dengan kartu model
Kartu model Model Studio Alibaba Cloud mencantumkan bahwa Qwen4-Max menerima input teks, gambar, dan video, serta menghasilkan output teks. Kartu model OpenAI mencantumkan bahwa GPT-6 Luna menerima input teks dan gambar, serta menghasilkan output teks. Rangkuman dari OrcaRouter juga menyebut bahwa Luna tidak mendukung pembuatan gambar, pembuatan suara, transkripsi, dan terjemahan. Inilah perbedaan paling mutlak antara keduanya, yang menentukan bahwa untuk tugas video hanya ada satu kandidat: Qwen4-Max.
Perlu diperhatikan bahwa kartu model dari vendor menjelaskan kemampuan model itu sendiri. Untuk penyedia integrasi atau endpoint tertentu, apakah parameter video bisa dikirim harus diperiksa terpisah. Misalnya, halaman model Together AI secara eksplisit mencantumkan input teks dan gambar, tetapi tidak ditemukan penjelasan video untuk rute yang sama. Dalam hal ini kita hanya bisa menulis “Together telah secara eksplisit mencantumkan teks dan gambar”, dan tidak bisa menyimpulkan bahwa layanan itu mendukung video.
1.2 Memeriksa ID, grup, dan endpoint lewat direktori APIYI
APIYI mengumumkan pada 2026-11-17 bahwa qwen4-max telah tersedia. Registri model publik yang dibuat pada 2026-11-20 mencantumkan endpoint-nya sebagai chat, responses, messages, dengan grup ClaudeCode, CodexResponses, default, dan svip. Dalam daftar harga, gpt-6-luna tercantum dengan grup Default, SVIP serta entri Chat Completions dan Responses. Pernyataan di blog lama bahwa “Qwen4-Max belum tersedia” harus mengikuti pengumuman dan registri terbaru.
Direktori hanya bisa membuktikan bahwa platform mendukung model dan endpoint tersebut. Grup tempat akun Anda berada dan izin token akan memengaruhi apakah Anda benar-benar bisa memanggilnya. Setelah membuat token di konsol APIYI apiyi.com, sebaiknya lakukan satu permintaan minimal untuk memastikan ID model dan endpoint yang tepat dapat digunakan, baru kemudian masuk ke perbandingan hasil.
1.3 Kendala yang tidak bisa dikompromikan di tiga skenario
| Skenario | Kendala yang tidak bisa dikompromikan | Hasil eliminasi | Fokus berikutnya |
|---|---|---|---|
| Perapian catatan teks (notula rapat, pengarsipan tiket) | Format keluaran stabil, biaya per panggilan rendah, volume panggilan besar | Keduanya bisa masuk kandidat | Bandingkan tingkat kelulusan format dan biaya per unit |
| Pemahaman video (pemeriksaan kualitas rekaman layar, ringkasan video) | Harus menerima input video | Singkirkan GPT-6 Luna berdasarkan kartu model | Periksa apakah endpoint dan token mendukung parameter video |
| Proses kompleks (otomatisasi multi-langkah, operasi lintas sistem) | Tingkat keberhasilan eksekusi multi-langkah tinggi, biaya kegagalan besar | Keduanya bisa masuk kandidat | Utamakan tingkat keberhasilan penerimaan, bukan harga satuan |
Perapian catatan teks adalah skenario yang khas sensitif biaya. Tugasnya sendiri tidak sulit; kuncinya adalah rata-rata biaya per hasil saat memanggil dalam jumlah besar. Pemahaman video adalah soal ambang kemampuan. Kalau modalitas tidak cocok, tidak ada gunanya membandingkan. Kegagalan pada proses kompleks sering berarti kerja ulang manual. Jika model murah gagal beberapa kali, biaya aktualnya bisa jadi justru lebih tinggi. Ini akan dihitung secara konkret di bagian 3 dan 4.
2. Langkah kedua pemilihan Model Bahasa Besar: membandingkan keuntungan pada tolok ukur yang sama
Setelah penyisihan selesai, barulah kita lihat hasilnya. Di sini kita hanya memakai data dari halaman perbandingan rilis yang sama di Artificial Analysis, karena kumpulan tugas dan cara penilaian tiap leaderboard berbeda-beda, sehingga menggabungkan semuanya dalam satu peringkat tidak ada gunanya.
2.1 Skor komprehensif dan biaya tugas harus dibaca bersama tingkatnya
| Konfigurasi | Intelligence Index v5.0.1 | Biaya tugas indeks | Kelipatan biaya relatif terhadap Qwen4-Max |
|---|---|---|---|
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna (Medium, tingkat default) | 18 | $0.0422 | sekitar 1/77 |
| GPT-6 Luna (tingkat Max) | 28 | $0.15 | sekitar 1/22 |
Angka “sekitar 22 kali” yang sering dikutip berasal dari $3.27 ÷ $0.15, yaitu membandingkan Qwen4 Max dengan tingkat Max milik Luna, dengan selisih skor 15 poin. Kalau dibandingkan dengan tingkat Medium bawaan Luna, kelipatan biayanya sekitar 77 kali dengan selisih skor 25 poin. Jadi hanya mengatakan “22 kali lebih mahal” belum lengkap — harus sekaligus dijelaskan tingkat mana dan jenis beban kerja yang mana.
Detail lain adalah kelengkapan data. OrcaRouter menunjukkan bahwa leaderboard hanya mempublikasikan satu skor untuk Qwen4-Max, tanpa data per tingkat; sementara Luna mempublikasikan tangga tingkat yang lengkap. Saat membuat proyeksi biaya, tangga yang lengkap memungkinkan kita melihat titik belok “apakah skor masih naik setelah menambah tingkat”, dan informasi semacam ini kadang lebih berguna daripada satu skor tunggal yang lebih tinggi.
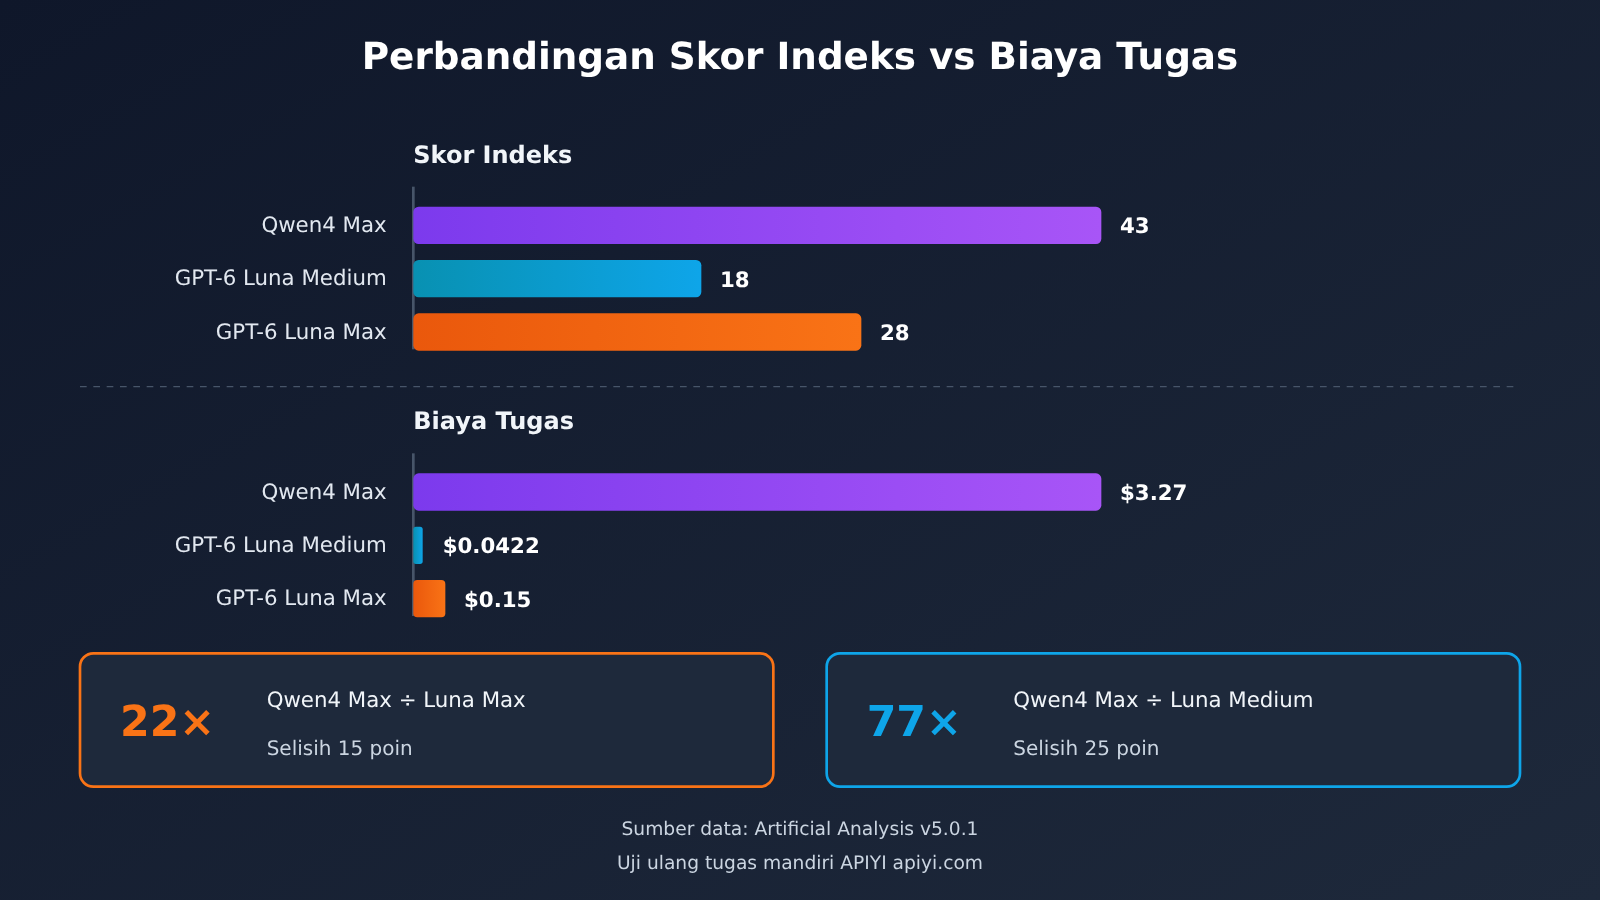
2.2 Selisih per komponen berubah sesuai tugas
Indeks komprehensif tidak bisa memprediksi keuntungan pada tugas tertentu. Pada AutomationBench-AA, Qwen4 Max mencapai 72,6% dan Luna Max 53,2%, selisih sekitar 19 poin persentase; pada FrontierCode-AA 2.0, keduanya masing-masing 26,5% dan 25,2%, hanya berbeda 1,3 poin persentase.
Kalau dikembalikan ke skenario di bagian 1, alur yang kompleks lebih mirip tugas otomasi bertahap seperti AutomationBench, sehingga keunggulan Qwen4-Max mungkin berujung pada lebih sedikit pekerjaan ulang. Kalau tugas Anda lebih mirip FrontierCode, selisih keduanya sangat kecil sementara selisih harga per unit tetap besar, jadi rasio harga-kinerja Luna lebih menonjol. Ini baru penilaian arah, dan tetap perlu diverifikasi pada kumpulan tugas Anda sendiri.
3. Langkah ketiga pemilihan Model Bahasa Besar: pisahkan perhitungan harga vendor, harga katalog, dan biaya akun
Biaya adalah hal yang paling mudah tercampur aduk saat dibicarakan. Bagian ini dibagi menjadi tiga lapis: harga resmi yang dipublikasikan vendor, harga katalog APIYI, serta pembayaran aktual akun setelah top-up dan bonus. Ketiganya punya domain berbeda dan tidak bisa saling menggantikan.
3.1 Contoh perhitungan harga vendor untuk satu permintaan input panjang
Misalkan satu permintaan dengan input 400 ribu Token, output yang ditagih 8,000 Token, tanpa cache hit, dan tanpa biaya tool tambahan.
| Item | Qwen4-Max (harga standar Alibaba Cloud International Singapura) | GPT-6 Luna (harga standar OpenAI, input panjang) |
|---|---|---|
| Tarif input | $1.50 / juta | $0.20 / juta (di atas 272,000 seluruh permintaan naik tingkat) |
| Tarif output | $4.50 / juta | $0.75 / juta |
| Rumus | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| Biaya sekali permintaan | $0.636 | $0.086 |
Keduanya sekitar 7.40 kali, separuh lebih kecil dibandingkan selisih harga input 15 banding 1 pada konteks pendek. Penyebabnya ada pada aturan naik tingkat milik Luna. Menurut harga OpenAI, kenaikan tingkat input panjang berlaku untuk seluruh permintaan, bukan hanya bagian yang melewati batas: petunjuk 300 ribu Token, semuanya 300 ribu dihitung dengan tarif tinggi, bukan hanya 28,000 terakhir. Rangkuman OrcaRouter menyebut Qwen4-Max ditagih dengan tarif yang sama di seluruh jendela satu juta, tanpa tingkatan 32K atau 128K.
Harga vendor juga berubah tergantung wilayah dan saluran. OrcaRouter mencantumkan Qwen4-Max di wilayah Global dengan input $1.413 dan output $4.24, berbeda dari Singapura. Halaman Pricing resmi Together AI menandai Qwen4 Max sebagai promo, dengan harga waktu terbatas input $1.05, output $3.15, baca cache $0.0525, tepat 70% dari harga Singapura; halaman itu mencantumkan berlaku hingga 2026-11-23 tetapi tidak menulis zona waktunya. Sementara halaman detail modelnya justru menampilkan tingkat lain: $1.43, $4.28, $0.0713. Saat mengutip harga semacam ini, tuliskan halaman sumber dan tanggalnya; penyelesaian aktual mengikuti penggunaan akun.
3.2 Harga katalog APIYI dihitung berdasarkan tarif katalog dan log penggunaan
Dalam katalog APIYI, qwen4-max dikenakan biaya $1.50 per satu juta Token untuk input, $4.50 untuk output, dan $0.075 untuk pembacaan cache; gpt-6-luna untuk konteks pendek dikenakan biaya input $0.10, output $0.50, dan pembacaan cache $0.01. Tabel harga mencatat bahwa jika input melebihi 272.000 Token, harga input naik menjadi $0.20.
Dengan menerapkan permintaan yang sama seperti di 3.1, qwen4-max dengan harga katalog juga $0.636. Bagian input gpt-6-luna adalah 0.4 × 0.20 = $0.08; tabel harga yang diverifikasi dalam pemeriksaan ini hanya mencantumkan kenaikan tarif input. Mengenai tarif output mana yang berlaku pada konteks panjang, silakan berpedoman pada tabel harga periode berjalan dan log penggunaan. Angka biaya sebenarnya harus berasal dari log penggunaan di akun Anda, bukan dari rumus di atas.
💰 Saran penghitungan biaya: Di akun yang sama di APIYI apiyi.com, panggil kedua model secara terpisah. Log penggunaan akan mencatat input, output, dan Token cache untuk setiap permintaan, sehingga lebih mendekati tagihan sebenarnya dibandingkan estimasi dari harga publik.
3.3 Bonus top-up memengaruhi konversi pokok, bukan harga satuan model
FAQ APIYI saat ini mencantumkan tingkatan top-up per transaksi: top-up $100 hingga kurang dari $500 mendapat bonus 10%, $500 hingga kurang dari $1.000 mendapat bonus 12%, $1.000 hingga kurang dari $3.000 mendapat bonus 15%, dan mulai $3.000 mendapat bonus 20%. Top-up online dan korporat dapat ikut serta, dan bonus diberikan secara otomatis; apakah penyesuaian harga khusus bisnis dapat digabungkan perlu dikonfirmasi terpisah. Pengguna biasa yang melakukan top-up pertama kali mendapat tambahan $1, sedangkan pengguna pendidikan dengan verifikasi email sekolah mendapat $2; bonus perlu dikirim dengan menghubungi layanan pelanggan; saldo top-up digunakan sesuai aturan 365 hari yang tercantum dalam dokumen.
| Tingkat top-up | Saldo diterima | Setara pokok top-up per $1 log | Penurunan biaya pokok |
|---|---|---|---|
| Top-up $100 per transaksi | $110 | sekitar $0.909 | sekitar 9,09% |
| Mulai top-up $3.000 per transaksi | jumlah top-up × 1,2 | sekitar $0.833 | sekitar 16,67% |
Prasyaratnya adalah seluruh saldo bonus terpakai habis. Dengan konversi tingkat 10%, biaya log satu kali sebesar $0.636 pada 3.1 setara dengan sekitar $0.578 pokok top-up. Perlu diperhatikan bahwa bonus berlaku seragam untuk saldo seluruh situs; yang diturunkan adalah pokok yang setara dengan setiap $1 kuota log, bukan berarti model tertentu mendapat diskon tambahan. Saat membandingkan pilihan model, kedua sisi harus menggunakan koefisien konversi yang sama, jika tidak perbandingannya menjadi tidak akurat.
4. Langkah keempat pemilihan Model Bahasa Besar: merumuskan kondisi menjadi langkah yang bisa diuji banding
Tiga bagian sebelumnya semuanya bersumber dari materi publik. Yang benar-benar menentukan model mana yang dipilih adalah tingkat kelulusan, latensi, dan biaya tugas Anda sendiri di bawah kondisi yang sama. Saat ini kami belum memiliki data tingkat keberhasilan, latensi, dan tagihan untuk kedua model pada tugas dan grup yang sama di platform APIYI, jadi berikut ini disajikan tolok ukur pengujian banding yang bisa Anda jalankan sendiri.
4.1 Variabel kontrol dan bidang pencatatan
Pengujian banding harus sedapat mungkin hanya mengubah satu variabel, yaitu “model”. Caranya: gunakan node dan operator daratan yang sama, grup dan protokol APIYI yang sama, set input dan batas output yang sama, lalu kirimkan permintaan ke kedua model secara bergantian pada tingkat konkurensi yang sama. Ini menghindari bias periode waktu yang muncul kalau satu model diselesaikan dulu baru menjalankan model lainnya.
| Bidang pencatatan | Kegunaan |
|---|---|
| Lolos penerimaan atau tidak | Menghitung tingkat kelulusan dan biaya tugas yang memenuhi syarat |
| Status HTTP, ID permintaan | Menelusuri kegagalan, merekonsiliasi dengan log penggunaan |
| Latensi token jawaban pertama yang terlihat | Mengukur pengalaman interaktif; pada model reasoning perlu dipisahkan dari event pertama |
| Total waktu | Mengukur throughput pemrosesan batch |
| Koneksi dingin/panas, cache hit | Menjelaskan fluktuasi latensi dan biaya |
| Jumlah token input dan output | Memeriksa penggunaan yang sebenarnya ditagih |
Waktu DNS, TCP, dan TLS sebaiknya dicatat terpisah. Saat melaporkan, tuliskan dengan jelas jumlah sampel, tingkat kelulusan, P50, dan P95; untuk perbandingan publik ke luar, Anda bisa merujuk definisi tingkat keberhasilan, latensi kata pertama, dan throughput dalam laporan CAICT (Akademi Informasi dan Komunikasi Tiongkok).
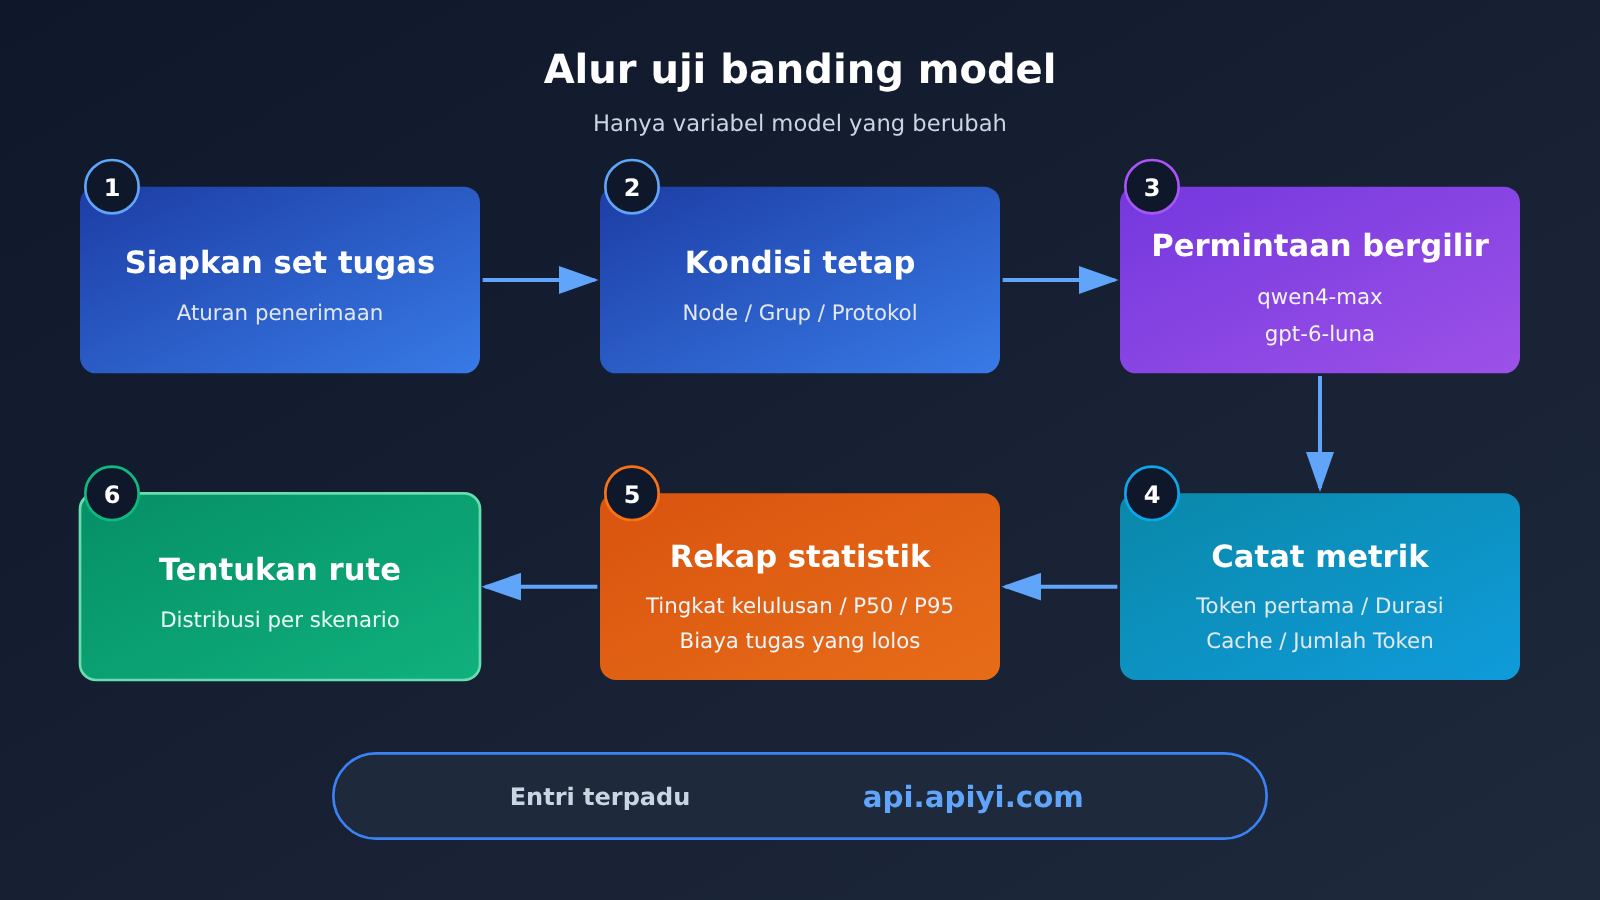
4.2 Skrip minimal untuk pengujian perbandingan bergantian
Skrip di bawah ini memanggil dua model secara bergantian melalui antarmuka yang kompatibel dengan OpenAI, dengan output streaming untuk mengukur token jawaban pertama yang terlihat dan total waktu yang dibutuhkan. Fungsi penerimaan perlu Anda ganti sesuai tugas Anda; jika perlu mengatur tingkat penalaran, pastikan dulu nama parameter di dokumentasi APIYI sebelum menambahkannya, dan catat hal tersebut dalam catatan.
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI antarmuka terpadu, kedua model berbagi satu kunci
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的会议记录整理成 JSON:...", "..."]  # ganti dengan kumpulan tugas Anda

def passed(task, answer):
    return answer.strip().startswith("{")  # ganti dengan aturan penerimaan yang sebenarnya

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # permintaan bergantian, mengurangi bias waktu
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # kedua model menggunakan batas output yang sama
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # token jawaban pertama yang terlihat
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "样本", n, "通过率", sum(r["ok"] for r in rs) / n,
          "首字P50", statistics.median(ttfts) if ttfts else None,
          "首字P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
Untuk penggunaan token dan biaya, sebaiknya dirangkum langsung dari log penggunaan platform berdasarkan ID permintaan, lalu dimasukkan ke rumus di bawah ini.
4.3 Biaya tugas yang lolos dan perutean berjenjang
Biaya tugas yang lolos = seluruh biaya pemanggilan (termasuk kegagalan dan percobaan ulang) + biaya tinjauan manual dan pengerjaan ulang, lalu dibagi dengan jumlah tugas yang akhirnya lulus uji terima. Jika model dengan harga satuan rendah memiliki tingkat kelulusan yang rendah, penyebutnya mengecil dan pembilangnya membesar, sehingga biaya tugas yang lolos bisa melampaui model dengan harga satuan tinggi; sebaliknya, jika tingkat kelulusan keduanya berdekatan, selisih harga satuan akan hampir tercermin apa adanya dalam hasil.
Berdasarkan hal ini, perutean dapat dilakukan secara berjenjang menurut kompleksitas tugas: tugas biasa secara default menggunakan gpt-6-luna, tugas berkemampuan sangat tinggi atau tugas video menggunakan qwen4-max. Untuk memutuskan apakah suatu rute diaktifkan, pertama lihat apakah tingkat kelulusan uji terimanya pada kumpulan tugas terkait sudah memenuhi standar, lalu lihat biaya tugas yang lolos. Karena kedua model berada di bawah antarmuka kompatibel OpenAI yang sama di APIYI apiyi.com, mengganti rute cukup dengan mengubah bidang model.
🎯 Saran uji banding: Pengguna baru dapat terlebih dahulu memakai kuota percobaan pendaftaran yang tercantum di halaman Mulai Cepat APIYI apiyi.com untuk menjalankan skrip hingga berhasil, lalu mengisi saldo sesuai skala kumpulan tugas untuk melakukan uji banding resmi.
4.4 Data probing titik masuk hanya menjelaskan batas pengukuran
Tabel pemantauan publik Lingjian AI mengambil sampel dari node daratan utama terhadap domain APIYI, dengan tiga catatan HTTP 200 pada 2026-11-05 hingga 11-06 memakan waktu masing-masing 429, 569, dan 565 ms. Probing semacam ini hanya mencerminkan konektivitas titik masuk; halaman tersebut bahkan menghitung sebagian HTTP 404 sebagai normal, dan tidak menjelaskan beban permintaan maupun metode autentikasi, sehingga tidak dapat dipakai untuk menyimpulkan latensi pembuatan atau tingkat keberhasilan model. Waktu token pertama dari Artificial Analysis juga hanya mewakili lingkungan pengukurannya sendiri; hasil di bawah kondisi jaringan dan konkrensi Anda perlu diukur terpisah dengan metode pada 4.1.
Kembali ke pertanyaan di judul: input video adalah ambang batas mutlak, dan hanya Qwen4-Max yang memenuhinya; pada tugas teks murni dan teks-gambar, keunggulan harga yang tertera pada GPT-6 Luna paling besar pada konteks pendek, lalu menyusut setelah input melebihi 272.000 Token; pada tugas multi-langkah yang sangat kompleks, keunggulan per komponen Qwen4-Max mungkin mengimbangi selisih harga satuan. Ketiga kesimpulan bergantung pada tingkat, panjang input, dan jenis tugas; pada akhirnya patokannya adalah biaya tugas yang lolos pada kumpulan tugas Anda sendiri. Bila membutuhkan titik masuk terpadu untuk uji banding bergantian, Anda dapat memanggil kedua model sekaligus dengan satu Key melalui APIYI apiyi.com.
Referensi
- Artificial Analysis – Perbandingan Peluncuran Qwen4 Max vs. GPT-6 Luna: Intelligence Index v5.0.1 dan data per komponen
- Tautan:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- Tautan:
- Alibaba Cloud Model Studio – Kartu Model dan Daftar Harga Qwen4-Max: modalitas input dan harga standar Singapura
- Tautan:
alibabacloud.com/help/en/model-studio/model-pricing
- Tautan:
- OpenAI – Model GPT-6 Luna: modalitas input dan penetapan harga konteks panjang
- Tautan:
developers.openai.com/api/docs/models/gpt-6-luna
- Tautan:
- OrcaRouter – Qwen4-Max vs GPT-6 Luna: rasio harga satuan, penjelasan peningkatan tier 272,000 Token
- Tautan:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- Tautan:
- Together AI – Harga: harga promosi terbatas Qwen4 Max
- Tautan:
together.ai/pricing
- Tautan:
- APIYI – Tabel Harga Model Lengkap, Registri Model, dan FAQ Aktivitas Top-Up: harga katalog, pengelompokan endpoint, dan tingkatan bonus
- Tautan:
docs.apiyi.com/models
- Tautan:
- CAICT dkk. – Laporan Pemantauan Kinerja Layanan Token Model Bahasa Besar (2026): tingkat keberhasilan, latensi token pertama, definisi throughput
- Tautan:
caict.ac.cn
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda situs APIYI apiyi.com. Materi integrasi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com


