
本記事では、Qwen4-Max と GPT-6 Luna を、同じリーダーボード上の指標、長コンテキストの料金、入力モダリティという3つの観点から比較し、大規模言語モデルの選定を一巡します。そのうえで、総合スコアを具体的なタスクの受け入れ基準とコスト判断に置き換えます。
まず結論を述べ、次に条件を示します。タスクで動画入力が必須なら、両社のモデルカード上では、まず Qwen4-Max しか検討できず、GPT-6 Luna は候補に入りません。純テキストまたは画像・テキスト系のタスクで、1回あたりのコストと呼び出し量が厳格な制約になるなら、GPT-6 Luna のリスト価格は大幅に低く、デフォルトの選択肢として有力です。多段階自動化のような高複雑度タスクなら、Qwen4-Max は Artificial Analysis の一部項目別スコアで明確にリードしており、高複雑度ルーティングの候補になります。最終的にどのティアを使うかは、実際のタスクセットでの受け入れ合格率と、合格タスク1件あたりのコストを見て決めます。
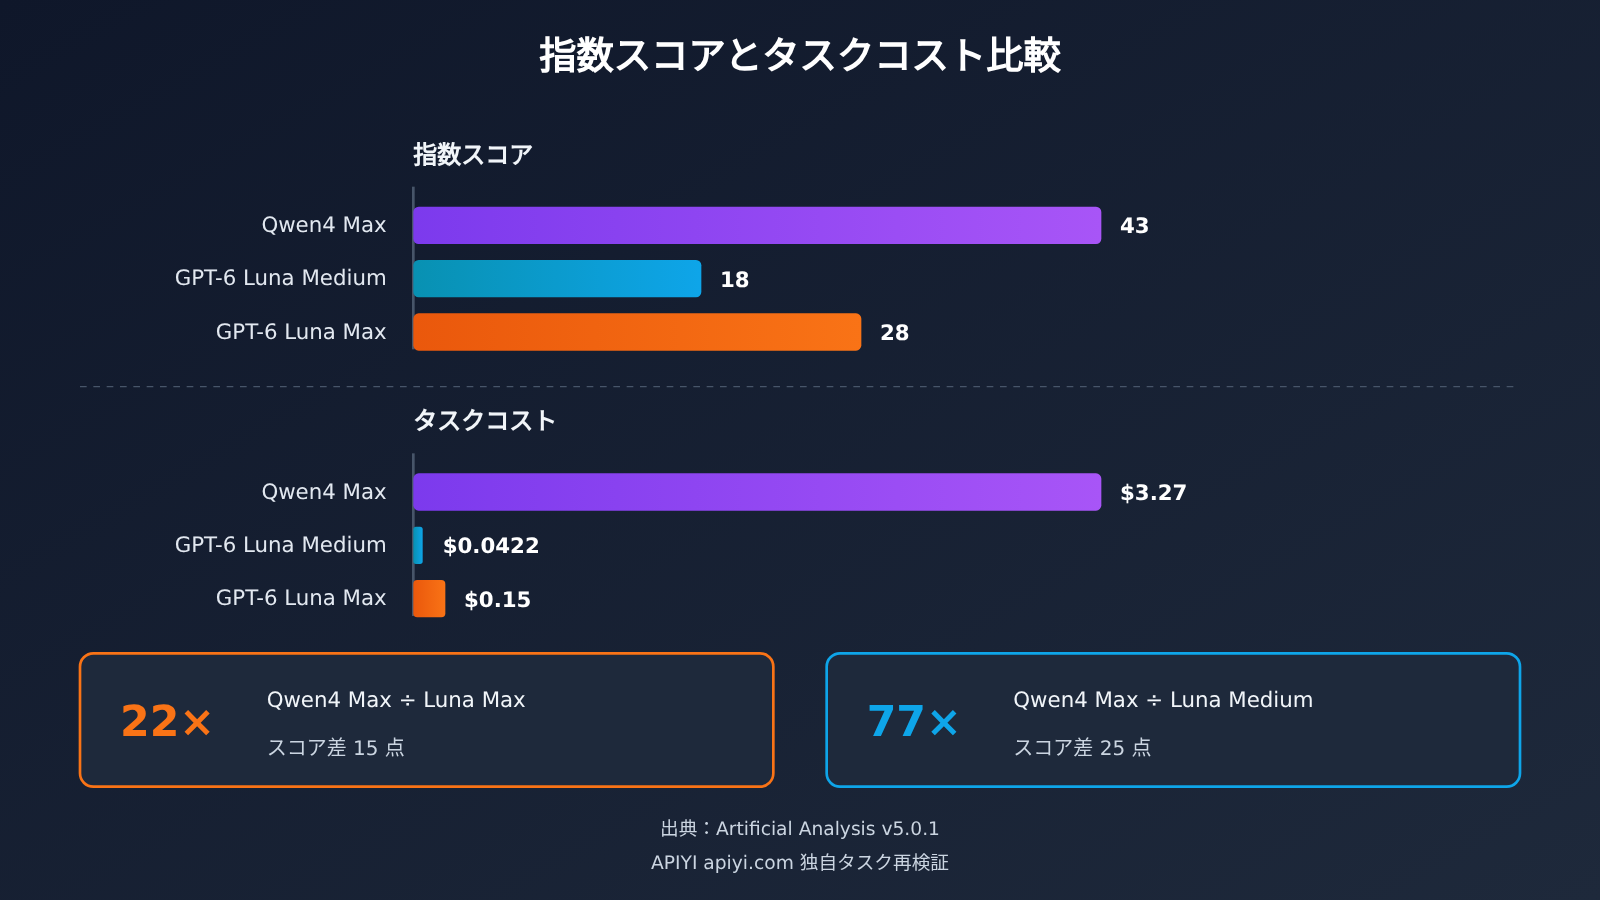
結論は3つの条件によって変わります。第一に、Luna の推論ティアが異なると、指数スコアとタスクコストの差は約22倍から約77倍まで変わり得ます。第二に、入力が272,000トークンを超えると、Luna は OpenAI のリスト価格に従ってリクエスト全体が上位ティアに移行します。第三に、特定タスクの項目別スコア差は非常に小さい場合があります。たとえば FrontierCode-AA 2.0 では、両者の差はわずか1.3パーセントポイントです。
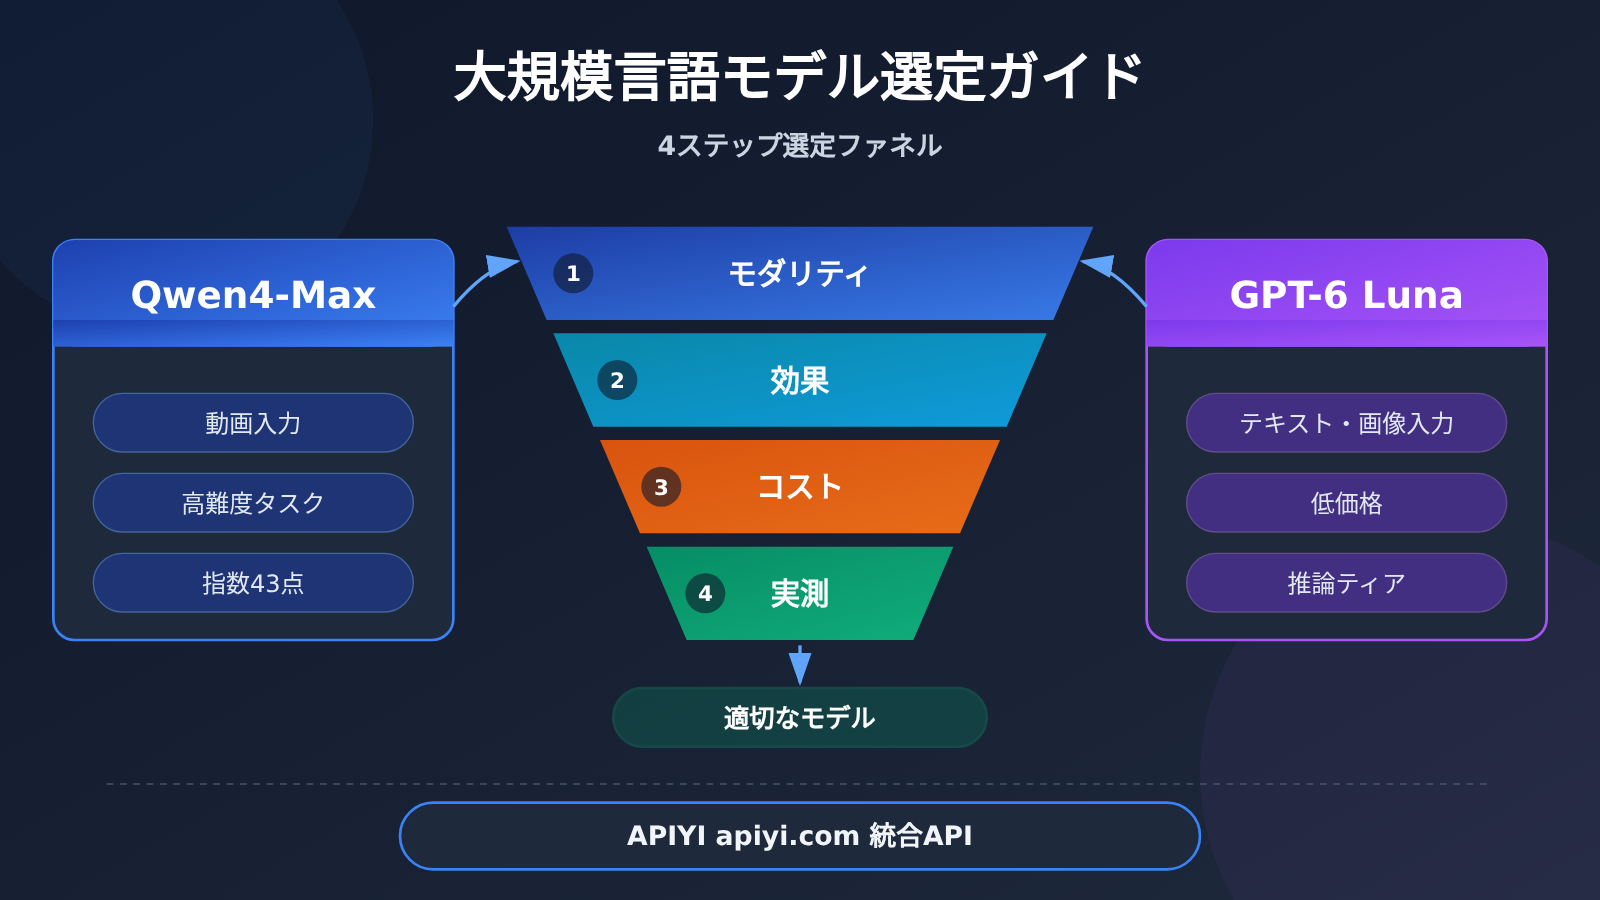
大規模言語モデル選定の比較早見表:Qwen4-Max と GPT-6 Luna
下表には、選定に影響する軸だけを記載します。表内のスコアは Artificial Analysis の Intelligence Index v5.0.1 に基づき、価格はベンダーの公開定価または APIYI カタログに基づくものです。いずれも本記事の検証日である 2026-11-20 時点の公開情報であり、当社による有料実測ではありません。
| 比較軸 | Qwen4-Max | GPT-6 Luna | 差異が意味すること |
|---|---|---|---|
| 入力モダリティ(ベンダーのモデルカード) | テキスト、画像、動画 | テキスト、画像 | 動画タスクでは Luna が直接除外される |
| 出力モダリティ | テキスト | テキスト | どちらも画像や音声は生成しない |
| Intelligence Index v5.0.1 | 43 点 | Medium 段階 18 点;Max 段階 28 点 | 段階が異なれば、差も異なる |
| 指数タスクコスト | $3.27 | Medium 段階 $0.0422;Max 段階 $0.15 | 当該指数のワークロードにのみ適用される |
| ベンダー定価(100万 Token あたり、短いコンテキスト) | Alibaba Cloud シンガポール:入力 $1.50、出力 $4.50 | OpenAI 標準:入力 $0.10、出力 $0.50 | 入力は約15対1、出力は9対1 |
| 長入力の課金 | 第三者資料では全ウィンドウ統一料率とされる | 272,000 Token を超えるとリクエスト全体が上位段階に移行 | 長文ドキュメントのシナリオでは別途計算が必要 |
| APIYI カタログのエンドポイント | chat、responses、messages | Chat Completions、Responses | プロトコルの選択が移行コストに影響する |
| 利用可能なプラットフォーム | APIYI apiyi.com、Alibaba Cloud Model Studio など | APIYI apiyi.com、OpenAI 公式など | 同一の Key で交互に比較テストしやすい |
本文は選定の依存関係の順に並べています。第1節ではまず接続可否を確認します。モダリティやエンドポイントが要件を満たさない場合、後続のスコアや価格は意味を持たないからです。第2節では同一ベンチマークでの性能を比較し、第3節では同一使用量に基づいてベンダー価格、カタログ価格、アカウント実払額を分解します。第4節では、ここまでの判断を自社業務で再検証できる手順に落とし込みます。コストのみに関心がある読者は第3節へ直接進んでも構いませんが、まず第1節の除外条件を確認することをおすすめします。
大規模言語モデルの選定前に知っておきたい用語(To Know)
| 用語 | 本文での意味 |
|---|---|
| Intelligence Index | Artificial Analysis が指定バージョンで複数タスクの性能を集約したスコア。本記事では v5.0.1 を使用 |
| 指数タスクコスト | 当該ベンチマークで1タスクを完走した際の消費コスト見積もり。推論段階と入出力の使用量によって結果が変わる |
| 推論段階 | モデルが投じる思考強度を制御するもの。たとえば Luna の Medium と Max があり、比較時には必ず明記する必要がある |
| 入力モダリティ | モデルが受け取るコンテンツの種類。たとえばテキスト、画像、動画 |
| コンテキスト段階制価格 | 入力が一定のしきい値を超えると別の料率で精算される方式。超過分のみか、リクエスト全体かを確認する必要がある |
| キャッシュ読み取り | 既存入力を再利用する際の課金項目。価格表と実際のヒット記録に基づいて集計すべき |
| 最初の可視回答 Token レイテンシ | リクエスト送信から最初の利用可能な回答が現れるまでの時間。推論モデルでは「最初のイベント」と区別する必要がある |
| P50 / P95 | レイテンシ分布の中央値と95パーセンタイル。それぞれ典型値と遅いリクエストを反映する |
| 合格タスクコスト | 失敗、再確認、やり直しの費用を、実際に基準を満たした各結果に按分したもの |
1. 大規模言語モデル選定の第一歩:タスク制約で不適切な組み合わせを除外する
モデル選定で最もコストを抑えられる行動は、まず候補を絞り落とすことです。モデルのスコアがどれほど高くても、入力タイプや呼び出しプロトコルに接続できなければ諦めるしかありません。逆に、安価なモデルがハード制約を満たさない場合、その後のコスト計算も不要です。
1.1 モデルカードで入力モダリティを判別する
Alibaba Cloud Model Studio のモデルカードには、Qwen4-Max がテキスト・画像・動画の入力を受け付け、テキストを出力すると記載されています。OpenAI のモデルカードには、GPT-6 Luna がテキスト・画像の入力を受け付け、テキストを出力すると記載されています。OrcaRouter の整理記事はさらに、Luna が画像生成・音声生成・文字起こし・翻訳をサポートしていないと述べています。これが両者で最も決定的な違いであり、動画系のタスクでは Qwen4-Max だけが候補になることが決まります。
注意すべき点は、ベンダーのモデルカードが示すのはモデル自体の能力であり、特定の接続事業者や特定のエンドポイントで動画パラメータを渡せるかどうかは別途確認が必要だということです。たとえば Together AI のモデルページにはテキストと画像の入力が明確に記載されていますが、同じルートでの動画に関する説明は見つかっていません。この場合、「Together はテキストと画像を明記している」と書くことしかできず、動画をサポートしていると推論することはできません。
1.2 APIYI のカタログで ID・グループ・エンドポイントを照合する
APIYI は 2026-11-17 に qwen4-max の提供開始を告知し、2026-11-20 に生成された公開モデルレジストリには、そのエンドポイントが chat、responses、messages、グループが ClaudeCode、CodexResponses、default、svip と記載されています。gpt-6-luna は価格表に Default、SVIP グループおよび Chat Completions、Responses の項目が記載されています。以前のブログにあった「Qwen4-Max はまだ未上架」という記述については、最新の公告とレジストリを優先してください。
カタログはプラットフォームがそのモデルとエンドポイントをサポートしていることしか証明できず、アカウントが属するグループやトークンの権限が、実際に呼び出せるかどうかに影響します。APIYI apiyi.com のコンソールでトークンを作成した後、まず最小限のリクエストで正確なモデル ID とエンドポイントが利用可能かを確認してから、効果の比較に進むことをおすすめします。
1.3 3つのシナリオそれぞれで譲れない制約
| シナリオ | 譲れない制約 | 絞り込み結果 | 次の重点 |
|---|---|---|---|
| テキスト記録の整理(議事録、チケットのアーカイブ) | 出力フォーマットが安定、1回あたりのコストが低い、呼び出し量が多い | 両方とも候補に残る | フォーマット通過率と単位コストを比較 |
| 動画理解(画面録画の品質チェック、動画要約) | 動画入力を受け付けることが必須 | モデルカードに基づき GPT-6 Luna を除外 | エンドポイントとトークンが動画パラメータをサポートするか確認 |
| 複雑なフロー(多段階自動化、システム横断操作) | 多段階実行の成功率が高い、失敗コストが大きい | 両方とも候補に残る | 単価ではなく受け入れ通過率を重視 |
テキスト記録の整理は典型的なコスト重視のシナリオで、タスク自体は難しくありません。鍵となるのは、大量呼び出し時の1件あたりの平均コストです。動画理解は能力のハードルを問う問題で、モダリティが合わなければ比較する必要はありません。複雑なフローの失敗はしばしば人手によるやり直しを意味し、安価なモデルが何度も失敗すれば実際のコストはかえって高くなる可能性があります。この点は第3節と第4節で具体的に計算します。
2. 大規模言語モデルの選定ステップ2:同じベンチマークでコスト対効果を比較
足切りが完了したら、次に効果を見ます。ここでは Artificial Analysis の同じ公開比較ページのデータだけを使います。リーダーボードごとにタスクセットや採点方法が異なり、混ぜてランキングしても意味がないからです。
2.1 総合スコアとタスクコストはティアとセットで読む
| 構成 | Intelligence Index v5.0.1 | 指数タスクコスト | Qwen4-Max に対するコスト倍率 |
|---|---|---|---|
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna(Medium、デフォルトティア) | 18 | $0.0422 | 約 1/77 |
| GPT-6 Luna(Max ティア) | 28 | $0.15 | 約 1/22 |
よく引用される「約22倍」は $3.27 ÷ $0.15 に由来し、Qwen4 Max と Luna の Max ティアを比較したものです。このときのスコア差は15点です。Luna のデフォルトである Medium ティアと比較すると、コスト倍率は約77倍、スコア差は25点になります。したがって「22倍高い」とだけ言うのは不十分で、どのティア、どのワークロードかを同時に示す必要があります。
もう一つのポイントはデータの完全性です。OrcaRouter は、リーダーボードが Qwen4-Max のスコアを1つしか公表しておらず、ティア別のデータがないと指摘しています。一方、Luna はティアの全段階を公開しています。コスト予測を行う際、ティアの全段階が公開されていれば「ティアを上げてもスコアがさらに伸びるかどうか」という変曲点が見えます。こうした情報は、単により高いスコアよりも有用なことがあります。
2.2 項目別の差はタスクによって変わる
総合指数では、特定のタスクにおける効果を予測できません。AutomationBench-AA では Qwen4 Max が72.6%、Luna Max が53.2%で、約19ポイントの差があります。FrontierCode-AA 2.0 ではそれぞれ26.5%と25.2%で、差はわずか1.3ポイントです。
第1節のシナリオに戻って考えると、複雑なフローは AutomationBench のような多段階の自動化タスクに近く、Qwen4-Max の優位性が手戻りの少なさにつながる可能性があります。あなたのタスクが FrontierCode に近い種類であれば、両者の差は小さく、一方で単価差は依然として大きいため、Luna のコストパフォーマンスがより際立ちます。これはあくまで方向性の判断であり、実際にはあなたのタスクセットで検証する必要があります。
3. 大規模言語モデルの選定ステップ3:ベンダー価格、カタログ価格、アカウント費用を分けて計算する
コストは最も混同されやすい部分です。本節では3つの層に分けます。ベンダーの公開表示価格、APIYI のカタログ価格、そしてチャージ特典を加味したアカウントの実払額です。この3つは帰属が異なり、互いに代替することはできません。
3.1 同一の長い入力リクエストにおけるベンダー表示価格の計算例
1回のリクエストで入力 40万トークン、課金対象の出力 8,000トークン、キャッシュヒットなし、追加のツール費用もなしとします。
| 項目 | Qwen4-Max(Alibaba Cloud 国際(シンガポール)標準価格) | GPT-6 Luna(OpenAI 標準価格、長い入力) |
|---|---|---|
| 入力料率 | $1.50 / 100万 | $0.20 / 100万(272,000 を超えるとリクエスト全体が上位料金に移行) |
| 出力料率 | $4.50 / 100万 | $0.75 / 100万 |
| 計算式 | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| 1回あたりの費用 | $0.636 | $0.086 |
両者は約 7.40 倍で、短いコンテキストでの入力単価差 15 対 1 より、その差は半分ほど小さくなっています。理由は Luna の料金ティア移行ルールにあります。OpenAI の表示価格では、長い入力のティア移行はリクエスト全体に適用され、超過分だけに割増されるわけではありません。30万トークンのプロンプトでは、30万トークンすべてが高い料率で計算され、最後の 28,000 トークンだけが対象ではありません。OrcaRouter のまとめによると、Qwen4-Max は100万トークンのウィンドウ全体で同じ料率が適用され、32K や 128K の料金ティアはないとしています。
ベンダー価格は地域やチャネルによっても変わります。OrcaRouter は Qwen4-Max の Global リージョンでの入力 $1.413、出力 $4.24 を掲載しており、シンガポールとは異なります。Together AI 公式 Pricing ページでは Qwen4 Max がプロモーションとして表示され、期間限定価格は入力 $1.05、出力 $3.15、キャッシュ読み取り $0.0525 で、ちょうどシンガポール価格の7割です。ページには有効期限が 2026-11-23 と記載されていますが、タイムゾーンは書かれていません。一方、そのモデル詳細ページには別の料金ティアとして $1.43、$4.28、$0.0713 が表示されています。こうした価格を引用する際は、出典ページと日付を明記してください。実際の請求額はアカウントの使用量に基づきます。
3.2 APIYI のカタログ価格は、カタログ料率と使用量ログから計算する
APIYI のカタログでは、qwen4-max は 100万 Token あたり入力 $1.50、出力 $4.50、キャッシュ読み取り $0.075 です。gpt-6-luna は短いコンテキストで入力 $0.10、出力 $0.50、キャッシュ読み取り $0.01 で、価格表には「入力が 272,000 Token を超える場合は入力が $0.20 に上がる」と注記されています。
3.1 と同じリクエストを当てはめると、qwen4-max はカタログ価格でも同様に $0.636 です。gpt-6-luna の入力部分は 0.4 × 0.20 = $0.08 になります。今回の検証で参照した価格表は入力の段階引き上げのみを明記しており、長いコンテキストにおける出力部分がどの料率で計算されるかは、その時点の価格表と使用量ログで確認してください。実際のコスト数値は、上記の計算式ではなく、お使いのアカウントの使用量ログから取得すべきものです。
💰 コスト計算のアドバイス:APIYI apiyi.com の同じアカウントで 2 つのモデルをそれぞれ呼び出すと、使用量ログに各リクエストの入力・出力・キャッシュ Token が記録されます。公開価格から推測するよりも、実際の請求額に近い数字が得られます。
3.3 チャージ時のボーナスは元本の換算に影響し、モデル単価には影響しない
APIYI の現行 FAQ には、1 回のチャージ金額ごとの段階が記載されています。$100 以上 $500 未満で 10%、$500 以上 $1,000 未満で 12%、$1,000 以上 $3,000 未満で 15%、$3,000 以上で 20% のボーナスが付きます。オンライン・法人向けチャージのどちらも対象で、ボーナスは自動的に付与されます。ビジネス向けの個別価格調整と併用できるかは別途確認が必要です。初回チャージの一般ユーザーにはさらに $1、学校メールアドレスで認証した教育ユーザーには $2 が付与され、カスタマーサポートへの連絡が必要です。チャージ残高はドキュメントに記載の 365 日ルールに従って使用します。
| チャージ段階 | 着金額 | ログ $1 あたりのチャージ元本 | 元本コストの低減 |
|---|---|---|---|
| 1 回 $100 | $110 | 約 $0.909 | 約 9.09% |
| 1 回 $3,000 以上 | チャージ額 × 1.2 | 約 $0.833 | 約 16.67% |
ここでの前提は、ボーナス残高をすべて使い切ることです。10% の段階で換算すると、3.1 の 1 回 $0.636 のログ費用は、約 $0.578 のチャージ元本に相当します。注意すべきは、ボーナスがサイト全体の残高に一律で適用される点です。これにより下がるのはログ上の $1 あたりの元本であり、特定のモデルが追加で値下げされるわけではありません。モデル選定の比較では、両方に同じ換算係数を使わないと比較がゆがみます。
4. 大規模言語モデル選定の第4ステップ:条件を比較可能な測定手順として書き出す
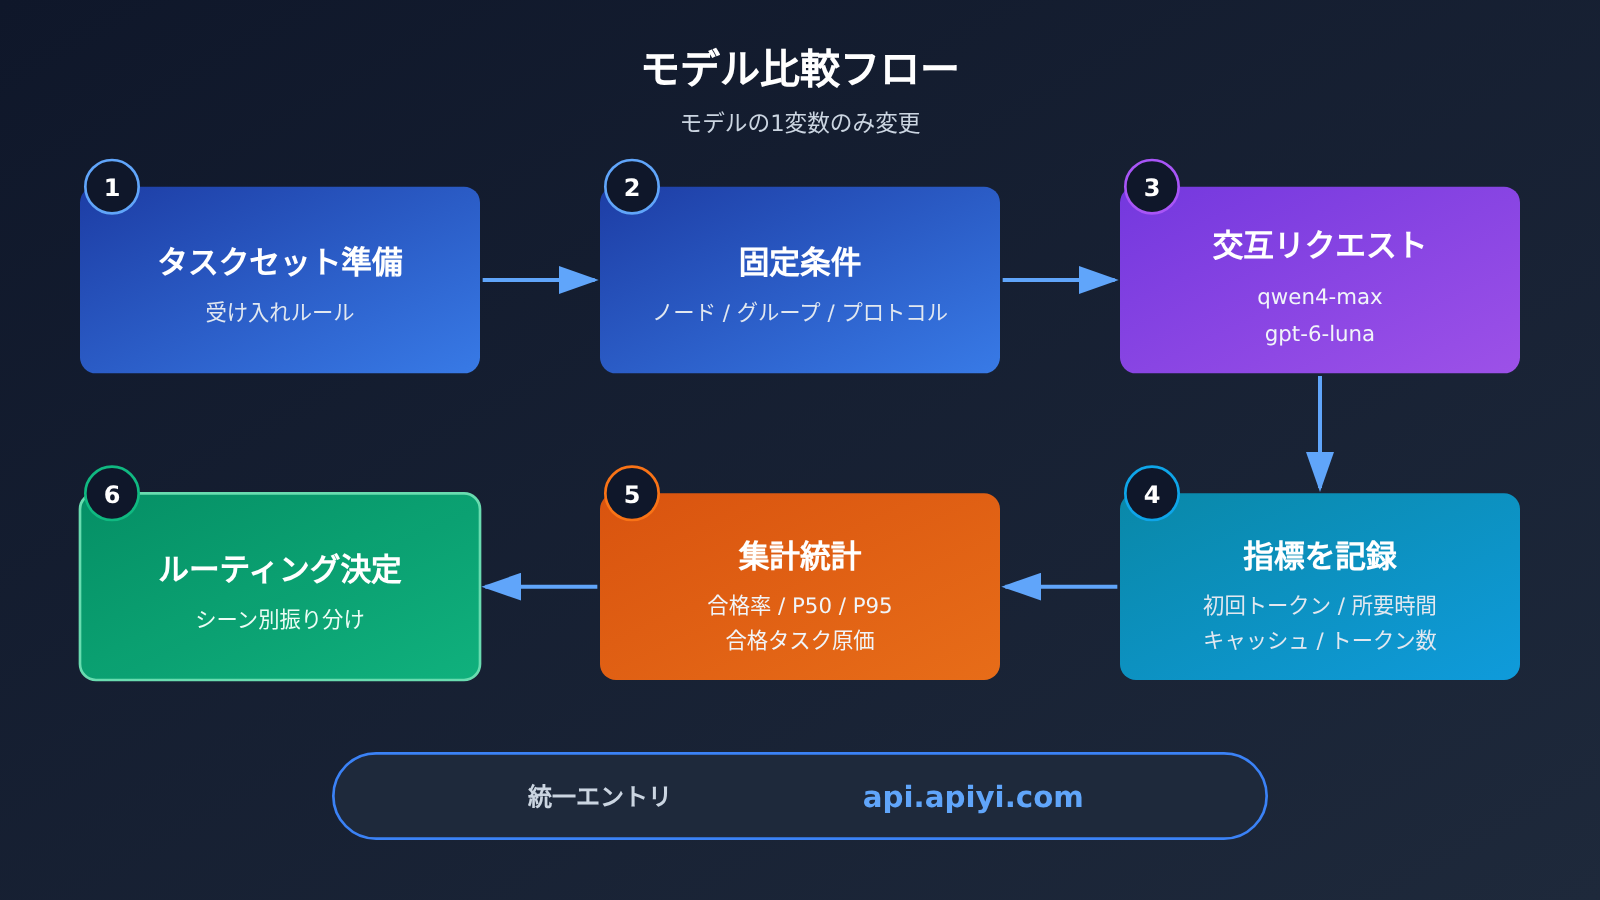
最初の3節はすべて公開情報です。どのモデルを選ぶかを実際に決めるのは、あなた自身のタスクを同一条件で実行したときの通過率・レイテンシ・コストです。現時点で、APIYI プラットフォーム上で2つのモデルを同一タスク・同一グループで実行した成功率、レイテンシ、課金データは手元にありません。以下では、ご自身で実行できる比較測定の基準を示します。
4.1 変数の統制と記録項目
比較測定では、変化させる変数を「モデル」だけに限定するのが理想です。具体的には、同じ中国大陸のノードと通信事業者、同じ APIYI グループとプロトコル、同じ入力セットと出力上限を使い、同じ並列度で2つのモデルへのリクエストを交互に発行します。片方を最後まで実行してからもう片方を実行すると時間帯による偏りが生じるため、これを避けます。
| 記録フィールド | 用途 |
|---|---|
| 検収に合格したか | 通過率と合格タスクあたりのコストを算出 |
| HTTP ステータス、リクエスト ID | 失敗の調査、使用量ログとの照合 |
| 最初に表示される回答トークンのレイテンシ | インタラクション体験を測定。推論モデルでは最初のイベントと分けて計測する必要がある |
| 総所要時間 | バッチ処理のスループットを測定 |
| コールド/ホット接続、キャッシュヒット | レイテンシとコストの変動を説明 |
| 入力・出力トークン数 | 実際の課金使用量を照合 |
DNS、TCP、TLS の所要時間はできれば個別に記録しておきましょう。報告時にはサンプル数、通過率、P50、P95 を明記します。外部に公開して比較する場合は、中国信息通信研究院(CAICT)のレポートにおける成功率、最初のトークンまでのレイテンシ、スループットの定義を参照するとよいでしょう。
4.2 交互比較テストの最小スクリプト
以下のスクリプトは、OpenAI互換インターフェースを通じて2つのモデルを交互に呼び出し、ストリーミング出力で最初の可視回答Tokenと総所要時間を計測します。受け入れ判定関数は、あなたのタスクに合わせて置き換えてください。推論レベルを設定する必要がある場合は、APIYIのドキュメントでパラメータ名を確認したうえで追加し、その旨を記録に明記してください。
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統一インターフェース、2つのモデルが1つのキーを共有
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的会议记录整理成 JSON:...", "..."]  # あなたのタスクセットに置き換える

def passed(task, answer):
    return answer.strip().startswith("{")  # 実際の受け入れルールに置き換える

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # 交互リクエストで時間帯の偏りを減らす
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # 2つのモデルが同じ出力上限を使用
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # 最初の可視回答Token
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "样本", n, "通过率", sum(r["ok"] for r in rs) / n,
          "首字P50", statistics.median(ttfts) if ttfts else None,
          "首字P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
Token使用量と費用は、プラットフォームの使用量ログからリクエストIDごとに集計し、以下の式に代入することをお勧めします。
4.3 合格タスクコストと段階的ルーティング
合格タスクコスト =(すべての呼び出し費用(失敗とリトライを含む)+ 人手によるレビューと手戻りのコスト)÷ 最終的に検収に合格したタスク数です。単価の低いモデルでも合格率が低ければ、分母が小さくなり分子が大きくなるため、合格タスクコストは単価の高いモデルを逆転する可能性があります。逆に両者の合格率が近ければ、単価差はほぼそのまま結果に反映されます。
これに基づき、タスクの複雑さに応じて段階的にルーティングできます。通常タスクはデフォルトで gpt-6-luna、高複雑度タスクまたは動画タスクは qwen4-max を使います。あるルートを有効にするかどうかは、まず対応するタスクセットでの検収合格率が基準を満たすかを見て、次に合格タスクコストを確認します。両モデルは APIYI apiyi.com の同一の OpenAI 互換インターフェース上にあるため、ルーティングの切り替えは model フィールドを変更するだけです。
🎯 比較テストの提案:新規ユーザーは、まず APIYI apiyi.com のクイックスタートページに記載されている登録トライアル枠でスクリプトを一通り動作させ、その後、タスクセットの規模に合わせてチャージし、本格的な比較テストを行ってください。
4.4 入口プローブデータが示すのは測定境界だけ
灵简AI が公開している監視表は、APIYI のドメインについて中国大陸ノードでサンプリングを実施しており、2026-11-05 から 11-06 までの HTTP 200 の3件の記録では、所要時間がそれぞれ 429、569、565 ms でした。この種のプローブは入口の疎通だけを反映します。また、このページでは一部の HTTP 404 を正常として数えており、リクエスト負荷や認証方式についても説明がありません。そのため、モデルの生成レイテンシや成功率を推測するのには使えません。Artificial Analysis の最初のトークンまでの時間も、同社独自の評価環境を表すにすぎません。ご自身のネットワークと同時実行条件下での結果は、4.1 の方法で別途測定する必要があります。
タイトルの問いに戻りましょう。動画入力は必須要件であり、これを満たすのは Qwen4-Max だけです。純テキストおよび画像付きテキストのタスクでは、GPT-6 Luna の表示価格上の優位性は短いコンテキストで最大となり、入力が 272,000 Token を超えると縮小します。高複雑度の多段タスクでは、Qwen4-Max の項目別の優位性が単価差を相殺する可能性があります。3つの結論はいずれもモデルのグレード、入力長、タスク種別に依存するため、最終的にはご自身のタスクセットにおける合格タスクコストを基準にしてください。共通の入口で交互比較テストを行う場合は、APIYI apiyi.com を通じて1つのAPIキーで両モデルを同時に呼び出せます。
参考資料
- Artificial Analysis – Qwen4 Max vs. GPT-6 Luna 公開比較:Intelligence Index v5.0.1 およびサブ項目データ
- リンク:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- リンク:
- Alibaba Cloud Model Studio – Qwen4-Max モデルカードと価格表:入力モダリティとシンガポール標準価格
- リンク:
alibabacloud.com/help/en/model-studio/model-pricing
- リンク:
- OpenAI – GPT-6 Luna Model:入力モダリティと長コンテキストの料金体系
- リンク:
developers.openai.com/api/docs/models/gpt-6-luna
- リンク:
- OrcaRouter – Qwen4-Max vs GPT-6 Luna:単価比率、272,000トークンの料金段階引き上げに関する説明
- リンク:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- リンク:
- Together AI – Pricing:Qwen4 Max 期間限定プロモーション価格
- リンク:
together.ai/pricing
- リンク:
- APIYI – モデル価格一覧表、モデルレジストリ、チャージキャンペーンFAQ:カタログ価格、エンドポイントのグループ分け、追加ボーナスの段階
- リンク:
docs.apiyi.com/models
- リンク:
- 中国情報通信研究院ほか – 大規模言語モデル・トークンサービス性能モニタリングレポート(2026年):成功率、最初のトークンまでの遅延、スループットの定義
- リンク:
caict.ac.cn
- リンク:
作者:APIYI 技術チーム
技術交流:APIYI(apiyi.com)のサイトトップページからお気軽にお問い合わせください。接続に関する資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。


