
이 글에서는 Qwen4-Max와 GPT-6 Luna를 같은 벤치마크의 지표, 긴 컨텍스트 가격, 입력 모달리티 기준으로 비교하며 대규모 언어 모델 선정을 진행하고, 종합 점수를 구체적인 과업의 수용 기준과 비용 판단으로 바꿔볼게요.
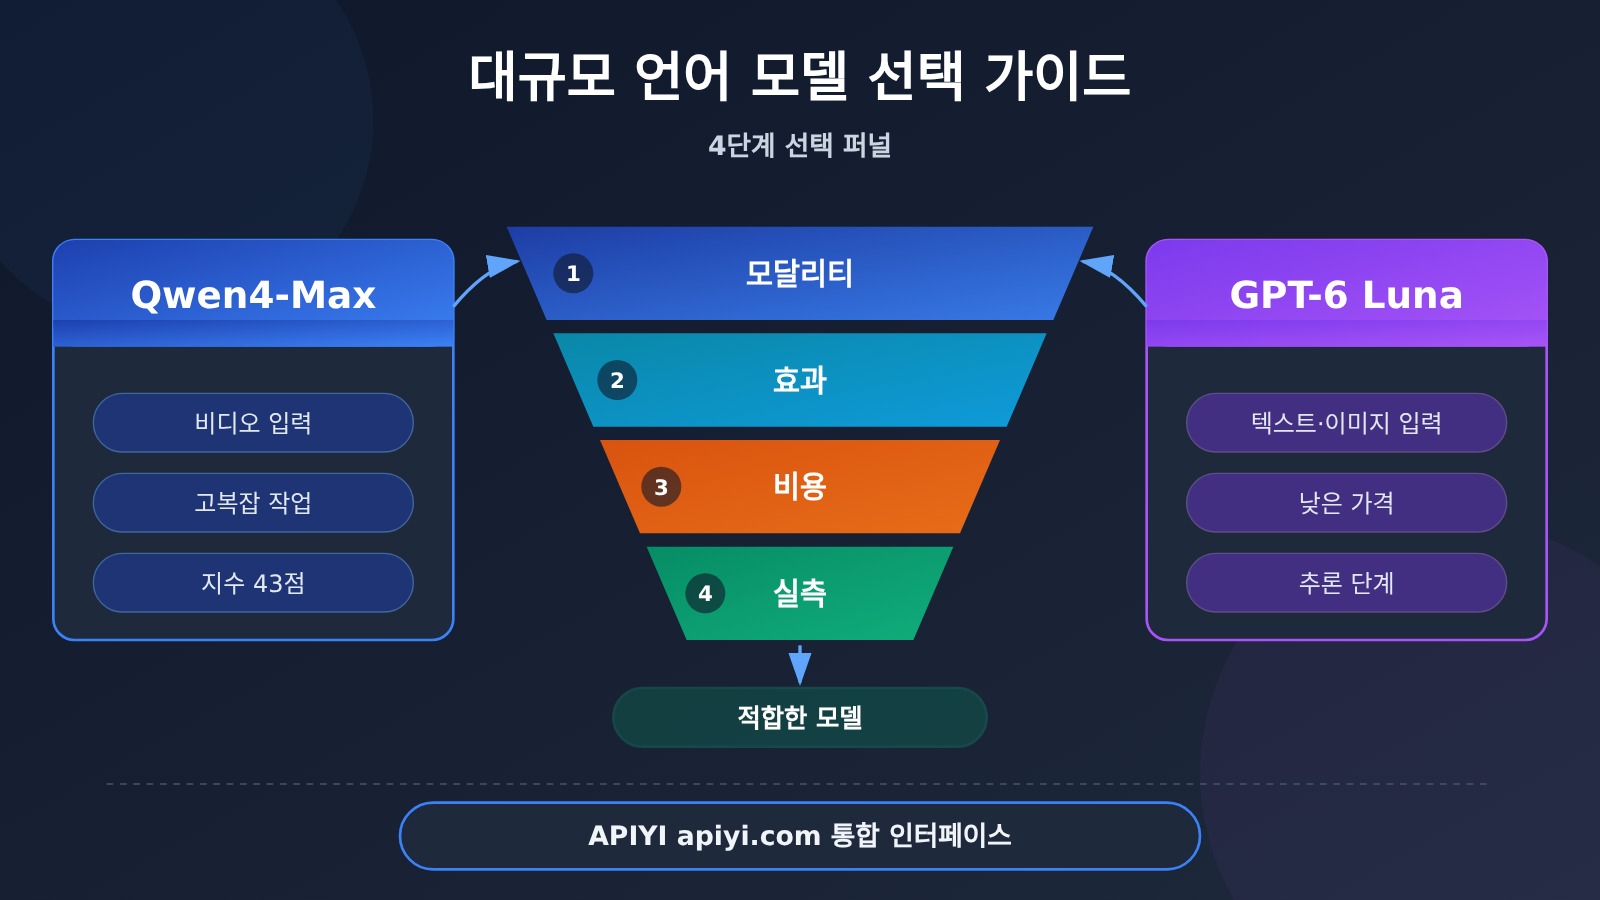
먼저 결론을 말하고, 그다음 조건을 제시할게요. 과업에 영상 입력이 반드시 필요하다면 두 모델 카드 기준으로 우선 Qwen4-Max만 고려할 수 있고, GPT-6 Luna는 후보에 올릴 수 없어요. 순수 텍스트 또는 텍스트·이미지 과업이면서 1회 비용과 호출량이 확고한 제약이라면 GPT-6 Luna의 정가가 훨씬 낮으니 기본 티어로 삼을 만해요. 다단계 자동화처럼 복잡도가 높은 과업이라면 Qwen4-Max가 Artificial Analysis의 일부 세부 항목에서 확실히 앞서므로 고복잡도 라우팅 후보로 쓸 수 있어요. 최종적으로 어느 티어를 쓸지는 여러분의 과업 세트에서의 수용 통과율과 합격 과업 비용을 보고 결정해야 해요.
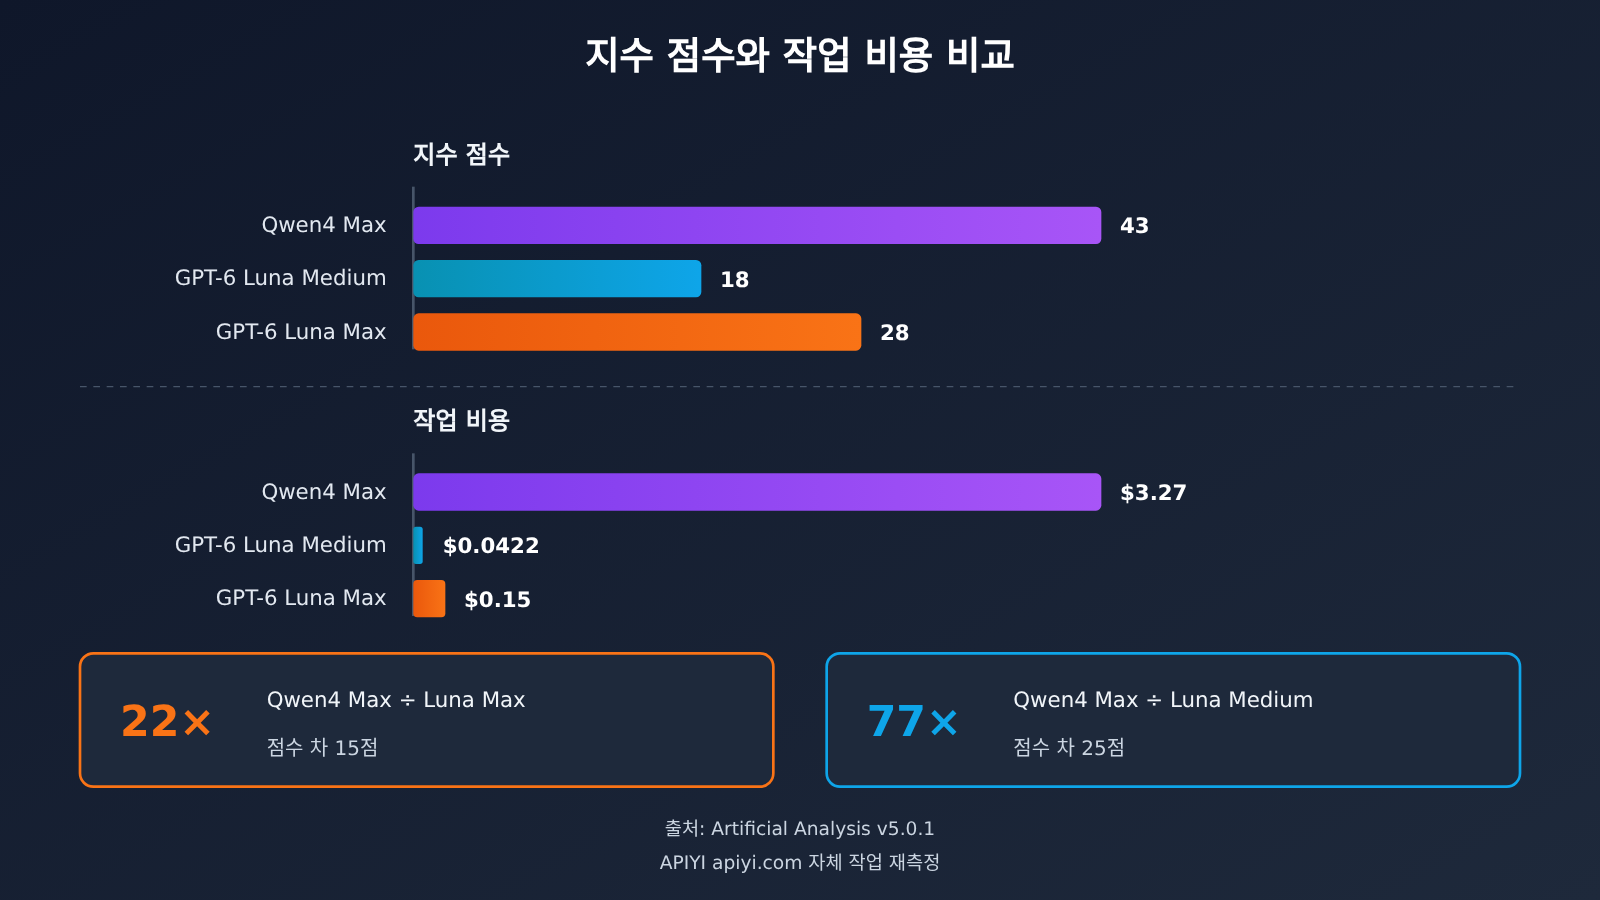
결론은 세 가지 조건에 따라 달라져요. 첫째, Luna의 추론 티어가 달라지면 지수 점수와 과업 비용 격차가 약 22배에서 약 77배까지 벌어질 수 있어요. 둘째, 입력이 272,000 토큰을 넘으면 Luna는 OpenAI 정가 기준으로 요청 전체가 상위 티어로 올라가요. 셋째, 특정 과업의 세부 항목 격차는 아주 작을 수 있어요. 예를 들어 FrontierCode-AA 2.0에서는 두 모델 차이가 1.3퍼센트포인트에 불과해요.
대규모 언어 모델 선정 비교 한눈에 보기: Qwen4-Max와 GPT-6 Luna
아래 표는 선정에 영향을 주는 차원만 정리했어요. 표의 점수는 Artificial Analysis의 Intelligence Index v5.0.1에서, 가격은 제조사 공개 정가 또는 APIYI 카탈로그에서 가져온 것으로, 모두 이 글의 검증 날짜인 2026-11-20 기준 공개 정보예요. 우리가 유료로 직접 테스트한 결과는 아니에요.
| 비교 차원 | Qwen4-Max | GPT-6 Luna | 차이가 의미하는 것 |
|---|---|---|---|
| 입력 모달리티(제조사 모델 카드) | 텍스트, 이미지, 비디오 | 텍스트, 이미지 | 비디오 작업에서는 Luna가 바로 제외돼요 |
| 출력 모달리티 | 텍스트 | 텍스트 | 둘 다 이미지나 음성을 생성하지 않아요 |
| Intelligence Index v5.0.1 | 43점 | Medium 티어 18점, Max 티어 28점 | 티어가 다르면 차이도 달라져요 |
| 지수 작업 비용 | $3.27 | Medium 티어 $0.0422, Max 티어 $0.15 | 이 지수 워크로드에만 해당해요 |
| 제조사 정가(백만 토큰당, 짧은 컨텍스트) | 알리바바 클라우드 싱가포르: 입력 $1.50, 출력 $4.50 | OpenAI 표준: 입력 $0.10, 출력 $0.50 | 입력 약 15:1, 출력 9:1 |
| 긴 입력 가격 책정 | 외부 자료에 따르면 전체 윈도 통일 요율 | 272,000 토큰을 넘으면 요청 전체가 상위 티어로 올라가요 | 긴 문서 시나리오는 따로 계산해야 해요 |
| APIYI 카탈로그 엔드포인트 | chat, responses, messages | Chat Completions, Responses | 프로토콜 선택이 마이그레이션 비용에 영향을 줘요 |
| 사용 가능 플랫폼 | APIYI apiyi.com, 알리바바 클라우드 Model Studio 등 | APIYI apiyi.com, OpenAI 공식 등 | 같은 Key로 번갈아 비교 테스트하기 편해요 |
본문은 선정의 의존 순서대로 배치했어요. 1절은 먼저 접속 가능 여부를 확인하는데, 모달리티나 엔드포인트가 맞지 않으면 뒤의 점수와 가격은 의미가 없기 때문이에요. 2절은 같은 벤치마크에서의 효과를 비교하고, 3절은 같은 사용량을 기준으로 제조사 가격, 카탈로그 가격, 계정 실결제 금액을 나눠서 보여드려요. 4절은 앞선 판단을 자기 업무에서 다시 검증할 수 있는 단계로 바꿔볼 거예요. 비용만 궁금한 독자라면 3절로 바로 건너뛰어도 되지만, 먼저 1절의 제외 조건을 보시는 걸 권해요.
대규모 언어 모델 선정에서 먼저 알아야 할 용어(To Know)
| 용어 | 이 글에서의 의미 |
|---|---|
| Intelligence Index | Artificial Analysis가 지정된 버전에서 여러 작업 성과를 종합한 점수로, 이 글에서는 v5.0.1을 사용해요 |
| 지수 작업 비용 | 해당 벤치마크에서 작업 하나를 수행하는 데 드는 소모 추정치로, 추론 티어와 입출력 사용량이 모두 결과를 바꿔요 |
| 추론 티어 | 모델이 투입하는 사고 강도를 조절하는 것으로, 예를 들어 Luna의 Medium과 Max가 있어요. 비교할 때는 반드시 명시해야 해요 |
| 입력 모달리티 | 모델이 받아들이는 콘텐츠 유형으로, 예를 들어 텍스트, 이미지, 비디오가 있어요 |
| 컨텍스트 구간별 가격 책정 | 입력이 특정 임계값을 넘으면 또 다른 요율로 정산하는 것으로, 초과분만 계산하는지 요청 전체를 계산하는지 확인해야 해요 |
| 캐시 읽기 | 기존 입력을 재사용하는 과금 항목으로, 가격표와 실제 적중 기록을 기준으로 집계해야 해요 |
| 첫 번째 가시 응답 토큰 지연 | 요청을 보낸 뒤 첫 번째 사용 가능한 응답이 나타나기까지의 시간으로, 추론 모델은 ‘첫 이벤트’와 구분해야 해요 |
| P50 / P95 | 지연 분포의 중앙값과 95 분위수로, 각각 일반적인 값과 느린 요청을 반영해요 |
| 유효 작업 비용 | 실패, 재검토, 재작업 비용을 실제로 기준을 충족한 결과 하나하나에 분담한 비용이에요 |
1. 대규모 언어 모델 선정 첫 단계: 작업 제약 조건으로 부적합한 조합 먼저 걸러내기
선정에서 가장 비용을 아끼는 행동은 먼저 걸러내는 거예요. 모델 점수가 아무리 높아도 내 입력 유형이나 호출 프로토콜에 연결할 수 없다면 포기할 수밖에 없고, 반대로 저렴한 모델이라도 하드 제약을 충족하지 못하면 뒤에서 비용을 계산할 필요도 없죠.
1.1 모델 카드로 입력 모달리티 구분하기
알리바바 클라우드 Model Studio의 모델 카드에는 Qwen4-Max가 텍스트, 이미지, 비디오 입력을 받고 텍스트를 출력한다고 나와 있어요. OpenAI의 모델 카드에는 GPT-6 Luna가 텍스트, 이미지 입력을 받고 텍스트를 출력한다고 되어 있고, OrcaRouter의 정리 자료에서는 Luna가 이미지 생성, 음성 생성, 전사, 번역을 지원하지 않는다고도 언급해요. 이게 두 모델의 가장 확실한 차이점이고, 비디오 관련 작업에서는 Qwen4-Max만 후보가 된다는 걸 결정해요.
주의할 점은 벤더의 모델 카드가 모델 자체의 능력을 설명할 뿐이라는 거예요. 특정 접속 지점, 특정 엔드포인트에서 비디오 파라미터를 실제로 넘길 수 있는지는 따로 확인해야 하죠. 예를 들어 Together AI의 모델 페이지에는 텍스트와 이미지 입력이 명확히 나와 있지만, 같은 라우팅에서 비디오 관련 설명은 찾을 수 없었어요. 이럴 때는 “Together는 텍스트와 이미지를 명확히 나열했다”까지만 쓸 수 있고, 비디오를 지원한다고 추론할 수는 없어요.
1.2 APIYI 카탈로그로 ID, 그룹, 엔드포인트 확인하기
APIYI는 2026-11-17에 qwen4-max 출시를 공지했고, 2026-11-20에 생성된 공개 모델 레지스트리에는 엔드포인트가 chat, responses, messages, 그룹이 ClaudeCode, CodexResponses, default, svip로 나와 있어요. gpt-6-luna는 가격표에 Default, SVIP 그룹과 Chat Completions, Responses 항목이 등록되어 있죠. 이전 블로그에 있던 “Qwen4-Max는 아직 출시되지 않았다”는 내용은 최신 공지와 레지스트리를 기준으로 보면 돼요.
카탈로그는 플랫폼이 해당 모델과 엔드포인트를 지원한다는 것만 증명할 뿐, 계정이 속한 그룹과 토큰 권한에 따라 실제 호출 가능 여부가 달라져요. APIYI apiyi.com 콘솔에서 토큰을 만든 뒤, 최소 요청 하나로 정확한 모델 ID와 엔드포인트가 사용 가능한지 먼저 확인하고 나서 성능 비교에 들어가는 걸 권해요.
1.3 세 시나리오별로 양보할 수 없는 제약
| 시나리오 | 양보할 수 없는 제약 | 탈락 결과 | 다음 단계 중점 |
|---|---|---|---|
| 텍스트 기록 정리(회의록, 티켓 아카이빙) | 출력 형식 안정성, 낮은 1회 비용, 많은 호출량 | 둘 다 진입 가능 | 형식 통과율과 단위 비용 비교 |
| 비디오 이해(화면 녹화 품질 검사, 비디오 요약) | 반드시 비디오 입력을 받아야 함 | 모델 카드 기준 GPT-6 Luna 탈락 | 엔드포인트와 토큰이 비디오 파라미터를 지원하는지 확인 |
| 복잡한 프로세스(다단계 자동화, 시스템 간 작업) | 다단계 실행 성공률이 높아야 하고 실패 비용이 큼 | 둘 다 진입 가능 | 단가보다 검수 통과율 중심으로 |
텍스트 기록 정리는 대표적인 비용 민감 시나리오예요. 작업 자체는 어렵지 않고, 핵심은 대량 호출 시 결과 한 건당 평균 비용이죠. 비디오 이해는 능력 문턱 문제라서, 모달리티가 맞지 않으면 비교할 필요조차 없어요. 복잡한 프로세스에서의 실패는 곧 수작업 재작업을 뜻하는 경우가 많아서, 저렴한 모델이 몇 번 더 실패하면 실제 비용은 오히려 더 높아질 수 있어요. 이 부분은 3, 4절에서 구체적으로 계산해볼게요.
2. 대규모 언어 모델 선택 2단계: 같은 기준에서 이점 비교
후보를 걸러낸 뒤에는 효과를 확인해요. 여기서는 Artificial Analysis의 같은 공개 비교 페이지 데이터만 사용하는데, 리더보드마다 작업 세트와 점수 산정 방식이 달라서 서로 섞어 순위를 매기는 건 의미가 없어요.
2.1 종합 점수와 작업 비용은 티어와 함께 읽어야 해요
| 구성 | Intelligence Index v5.0.1 | 지수 작업 비용 | Qwen4-Max 대비 비용 배수 |
|---|---|---|---|
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna(Medium, 기본 티어) | 18 | $0.0422 | 약 1/77 |
| GPT-6 Luna(Max 티어) | 28 | $0.15 | 약 1/22 |
자주 인용되는 “약 22배”는 $3.27 ÷ $0.15에서 나온 값으로, Qwen4 Max와 Luna의 Max 티어를 비교한 것이며 이때 점수 차이는 15점이에요. Luna 기본 Medium 티어와 비교하면 비용 배수는 약 77배, 점수 차이는 25점이죠. 따라서 “22배 더 비싸다”고만 말하는 건 불완전하고, 어떤 티어와 어떤 워크로드인지 함께 밝혀야 해요.
또 하나의 디테일은 데이터 완전성이에요. OrcaRouter는 리더보드가 Qwen4-Max의 점수 하나만 공개했고 티어별 데이터는 없다고 지적했어요. 반면 Luna는 전체 티어 단계를 공개했죠. 비용 예측을 할 때 전체 티어 단계를 보면 “티어를 올린 뒤에도 점수가 더 오르는지”를 보여주는 변곡점을 확인할 수 있는데, 이런 정보가 때로는 단일 고득점보다 더 유용해요.
2.2 세부 항목 격차는 작업에 따라 달라져요
종합 지수만으로는 특정 작업에서의 이점을 예측할 수 없어요. AutomationBench-AA에서는 Qwen4 Max가 72.6%, Luna Max가 53.2%로 약 19%포인트 차이가 났어요. FrontierCode-AA 2.0에서는 두 모델이 각각 26.5%와 25.2%로 겨우 1.3%포인트 차이였죠.
1절의 시나리오로 돌아가 보면, 복잡한 프로세스는 AutomationBench 같은 다단계 자동화 작업에 더 가깝기 때문에 Qwen4-Max의 우위가 재작업 감소로 이어질 수 있어요. 작업이 FrontierCode 쪽에 더 가깝다면 두 모델의 격차는 작고 단가 차이는 여전히 크기 때문에 Luna의 가성비가 더 돋보여요. 이건 방향성 판단일 뿐이고, 구체적으로는 여러분의 작업 세트에서 검증해야 해요.
3. 대규모 언어 모델 선정 3단계: 벤더 가격, 카탈로그 가격, 계정 비용을 분리해 계산하기
비용은 가장 쉽게 뒤섞여 이야기돼요. 이번 절에서는 세 가지 층위로 나눠서 볼게요. 벤더가 공개한 정가, APIYI 카탈로그 가격, 그리고 충전 보너스가 반영된 계정 실결제 금액이에요. 세 가지는 귀속 주체가 다르기 때문에 서로 대체할 수 없어요.
3.1 동일한 장문 입력 요청의 벤더 가격 계산 예시
한 번의 요청에 입력 40만 Token, 과금 출력 8,000 Token이라고 가정해 볼게요. 캐시 적중도 없고 추가 도구 비용도 없어요.
| 항목 | Qwen4-Max(알리바바 클라우드 인터내셔널 싱가포르 표준가) | GPT-6 Luna(OpenAI 표준가, 장문 입력) |
|---|---|---|
| 입력 단가 | $1.50 / 100만 | $0.20 / 100만(272,000 초과 시 요청 전체에 상위 단가 적용) |
| 출력 단가 | $4.50 / 100만 | $0.75 / 100만 |
| 계산식 | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| 1회 비용 | $0.636 | $0.086 |
두 값의 차이는 약 7.40배로, 짧은 컨텍스트에서의 15 대 1 입력 단가 차이보다 절반가량 줄었어요. 그 이유는 바로 Luna의 단가 상향 규칙에 있어요. OpenAI 표준가 기준으로, 장문 입력 단가 상향은 요청 전체에 적용돼요. 초과분에만 가격을 더하는 게 아니에요. 즉 30만 Token 프롬프트라면 30만 Token 전부가 높은 단가로 계산되고, 마지막 28,000 Token만이 아니에요. OrcaRouter의 정리에 따르면 Qwen4-Max는 100만 컨텍스트 윈도우 전체에서 동일한 단가가 적용되고, 32K나 128K 같은 구간이 따로 없어요.
벤더 가격은 지역과 채널에 따라 달라지기도 해요. OrcaRouter는 Qwen4-Max의 Global 지역 입력 단가를 $1.413, 출력 단가를 $4.24로 표기하는데, 싱가포르와 달라요. Together AI 공식 Pricing 페이지는 Qwen4 Max를 프로모션으로 표시하며, 한시적 가격은 입력 $1.05, 출력 $3.15, 캐시 읽기 $0.0525로 정확히 싱가포르 가격의 7할이에요. 페이지에는 2026-11-23까지 유효하다고 적혀 있지만 시간대는 명시되지 않았어요. 그런데 모델 상세 페이지에는 또 다른 구간인 $1.43, $4.28, $0.0713이 표시돼요. 이런 가격을 인용할 때는 출처 페이지와 날짜를 반드시 밝히고, 실제 결제는 계정 사용량을 기준으로 한다는 점을 기억해야 해요.
3.2 APIYI 카탈로그 가격은 카탈로그 요율과 사용량 로그로 계산해요
APIYI 카탈로그에서 qwen4-max는 백만 토큰당 입력 $1.50, 출력 $4.50, 캐시 읽기 $0.075이고, gpt-6-luna는 짧은 컨텍스트 기준 입력 $0.10, 출력 $0.50, 캐시 읽기 $0.01이며, 가격표에는 입력이 272,000 토큰을 초과하면 입력 요율이 $0.20로 올라간다고 명시되어 있어요.
3.1의 동일한 요청을 적용하면 qwen4-max는 카탈로그 가격 기준으로도 $0.636이에요. gpt-6-luna의 입력 부분은 0.4 × 0.20 = $0.08이고, 이번 검증에 사용한 가격표에는 입력 요율 상향만 명시되어 있어요. 긴 컨텍스트에서 출력 부분이 어느 요율로 계산되는지는 해당 시점의 가격표와 사용량 로그를 기준으로 확인해 주세요. 실제 비용 수치는 위 공식이 아니라 여러분 계정의 사용량 로그에서 나와야 해요.
💰 비용 산정 팁: APIYI apiyi.com의 동일한 계정에서 두 모델을 각각 호출하면 사용량 로그에 요청마다 입력, 출력, 캐시 토큰이 기록돼요. 공개 정가로 추산하는 것보다 실제 청구서에 더 가까워요.
3.3 충전 보너스는 모델 단가가 아니라 원금 환산에 영향을 줘요
APIYI 현행 FAQ에는 1회 충전 구간이 나와 있어요. $100 이상 $500 미만은 10% 추가 증정, $500 이상 $1,000 미만은 12%, $1,000 이상 $3,000 미만은 15%, $3,000부터는 20% 추가 증정이에요. 온라인 충전과 법인 계좌 충전 모두 참여할 수 있고, 추가 증정은 자동으로 지급돼요. 비즈니스 별도 가격 조정과 중복 적용할 수 있는지는 별도로 확인해야 해요. 첫 충전 일반 사용자에게는 $1, 학교 이메일 인증을 마친 교육 사용자에게는 $2를 추가로 지급하며, 고객센터에 문의해 받아야 해요. 충전 잔액은 문서에 기재된 365일 규칙에 따라 사용해요.
| 충전 구간 | 충전 후 잔액 | 로그 $1당 환산 충전 원금 | 원금 비용 절감 |
|---|---|---|---|
| 1회 $100 | $110 | 약 $0.909 | 약 9.09% |
| 1회 $3,000부터 | 충전액 × 1.2 | 약 $0.833 | 약 16.67% |
여기서 전제는 추가 증정 잔액을 전부 사용한다는 것이에요. 10% 구간 기준으로 환산하면 3.1의 $0.636 단일 로그 비용은 약 $0.578의 충전 원금에 해당해요. 주의할 점은 추가 증정이 사이트 전체 잔액에 일괄 적용된다는 거예요. 즉, 로그 $1 한도에 대응하는 원금을 낮추는 것이지, 특정 모델이 별도로 할인된다고 이해하면 안 돼요. 모델 선택 비교를 할 때는 양쪽에 동일한 환산 계수를 적용해야 해요. 그렇지 않으면 비교가 왜곡될 수 있어요.
4. 대규모 언어 모델 선택 4단계: 조건을 비교 테스트 가능한 절차로 작성하기
앞선 세 절은 모두 공개 자료를 다뤘어요. 결국 어떤 모델을 선택할지는 같은 조건에서 여러분의 작업이 얼마나 통과하는지, 지연 시간은 얼마인지, 비용은 얼마인지에 달려 있어요. 현재 APIYI 플랫폼에서 두 모델이 같은 작업, 같은 그룹에서 보이는 성공률과 지연 시간, 과금 데이터는 아직 없어요. 그래서 아래에서는 직접 실행해 볼 수 있는 비교 측정 기준을 제시할게요.
4.1 변수 통제와 기록 필드
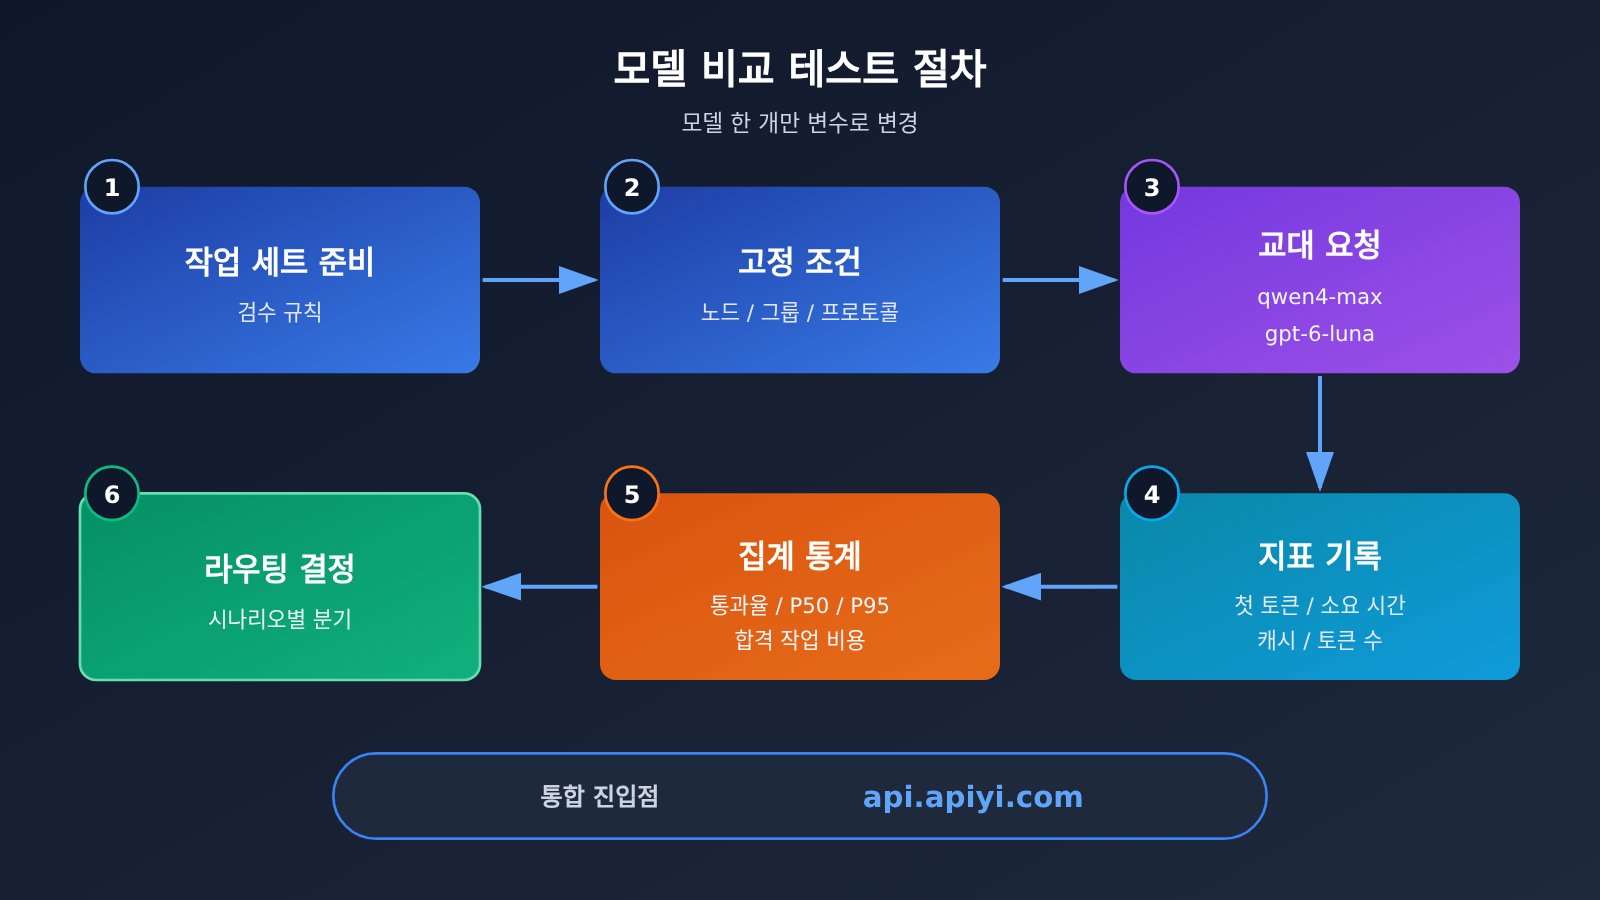
비교 테스트에서는 가능한 한 ‘모델’이라는 변수 하나만 바뀌게 해야 해요. 구체적으로는 같은 중국 본토 노드와 통신사, 같은 APIYI 그룹과 프로토콜, 같은 입력 세트와 출력 상한을 사용하고, 동일한 동시성 조건에서 두 모델의 요청을 번갈아 보내면 돼요. 하나를 먼저 끝까지 돌린 뒤 다른 하나를 돌려서 생기는 시간대 편향을 피하는 거죠.
| 기록 필드 | 용도 |
|---|---|
| 승인 기준 통과 여부 | 통과율과 통과 작업당 비용 계산 |
| HTTP 상태, 요청 ID | 실패 원인 추적, 사용량 로그와 대조 |
| 첫 번째로 표시되는 답변 Token 지연 시간 | 대화형 경험 측정, 추론 모델은 첫 이벤트와 분리해 측정해야 함 |
| 총 소요 시간 | 배치 처리량 측정 |
| 콜드/핫 연결, 캐시 적중 | 지연 시간과 비용 변동의 원인 설명 |
| 입력/출력 Token 수 | 실제 과금 사용량 확인 |
DNS, TCP, TLS의 소요 시간은 따로 기록하는 게 좋아요. 보고할 때는 샘플 수, 통과율, P50, P95를 분명히 적어요. 외부에 공개 비교할 때는 중국정보통신연구원(CAICT) 보고서의 성공률, 첫 토큰 지연 시간, 처리량 정의를 참고할 수 있어요.
4.2 교차 비교 측정을 위한 최소 스크립트
아래 스크립트는 OpenAI 호환 인터페이스를 통해 두 모델을 번갈아 호출하고, 스트리밍 출력으로 첫 번째로 보이는 답변 토큰까지의 시간과 전체 소요 시간을 측정해요. 검수 함수는 여러분의 작업에 맞게 교체해야 하고, 추론 등급(reasoning effort)을 설정해야 한다면 APIYI 문서에서 파라미터 이름을 먼저 확인한 뒤 추가하고 기록에 명시하세요.
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 두 모델이 Key 하나를 공유
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的会议记录整理成 JSON:...", "..."]  # 여러분의 작업 세트로 교체하세요

def passed(task, answer):
    return answer.strip().startswith("{")  # 실제 검수 규칙으로 교체하세요

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # 교대로 요청해 시간대 편향을 줄입니다
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # 두 모델에 동일한 출력 상한을 적용
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # 첫 번째로 보이는 답변 토큰
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "샘플", n, "통과율", sum(r["ok"] for r in rs) / n,
          "첫 토큰 P50", statistics.median(ttfts) if ttfts else None,
          "첫 토큰 P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
토큰 사용량과 비용은 플랫폼 사용 로그에서 요청 ID 기준으로 집계한 다음, 아래 공식에 대입하는 걸 권장해요.
4.3 합격 작업 비용과 등급별 라우팅
합격 작업 비용 = 전체 호출 비용(실패 및 재시도 포함) + 수동 검수와 재작업 비용을, 최종 검수를 통과한 작업 수로 나눈 값입니다. 단가가 낮은 모델이라도 통과율이 낮으면 분모는 작아지고 분자는 커져서 합격 작업 비용이 단가 높은 모델을 역전할 수 있어요. 반대로 두 모델의 통과율이 비슷하다면 단가 차이는 거의 그대로 결과에 나타납니다.
이를 바탕으로 작업 복잡도에 따라 등급별 라우팅을 할 수 있어요. 일반 작업은 기본적으로 gpt-6-luna로, 고복잡도 작업이나 비디오 작업은 qwen4-max로 보내는 식이죠. 특정 라우팅을 활성화할지는 먼저 해당 작업 세트에서 검수 통과율이 기준을 충족하는지 보고, 그다음 합격 작업 비용을 확인하면 됩니다. 두 모델 모두 APIYI apiyi.com의 동일한 OpenAI 호환 인터페이스 아래에 있으므로, 라우팅을 바꿀 때는 model 필드만 수정하면 됩니다.
🎯 비교 테스트 제안: 신규 사용자는 먼저 APIYI apiyi.com 빠른 시작 페이지에 안내된 가입 체험 크레딧으로 스크립트를 끝까지 실행해 보고, 그다음 작업 세트 규모에 맞춰 충전해 정식 비교 테스트를 진행하세요.
4.4 진입점 탐지 데이터는 측정 경계만 보여줄 뿐
灵简AI가 공개한 모니터링 표는 APIYI 도메인에 대해 중국 본토 노드로 샘플링했는데, 2026-11-05부터 11-06까지의 HTTP 200 기록 세 건의 소요 시간은 각각 429, 569, 565 ms였습니다. 이런 탐지는 진입점 연결성만 반영할 뿐이고, 페이지는 일부 HTTP 404도 정상으로 집계하며, 요청 페이로드와 인증 방식도 밝히지 않아요. 따라서 모델의 생성 지연 시간이나 성공률을 추론하는 데 쓸 수 없습니다. Artificial Analysis의 첫 토큰 시간 역시 자체 평가 환경만 대표할 뿐이므로, 내 네트워크와 동시성 조건에서의 결과는 4.1의 방법으로 따로 측정해야 합니다.
다시 처음 질문으로 돌아가 볼까요. 비디오 입력은 넘기 어려운 관문이고, 이를 충족하는 모델은 Qwen4-Max 하나뿐입니다. 순수 텍스트와 이미지-텍스트 작업에서는 GPT-6 Luna의 가격 우위가 짧은 컨텍스트에서 가장 크고, 입력이 272,000 토큰을 넘으면 그 우위가 줄어들어요. 고복잡도 다단계 작업에서는 Qwen4-Max의 항목별 우위가 단가 차이를 상쇄할 수 있습니다. 세 가지 결론 모두 등급, 입력 길이, 작업 유형에 따라 달라지며, 최종 기준은 내 작업 세트에서의 합격 작업 비용이에요. 통일된 진입점에서 교차 비교 테스트를 하고 싶다면, APIYI apiyi.com을 통해 하나의 키로 두 모델을 동시에 호출할 수 있습니다.
참고 자료
- Artificial Analysis – Qwen4 Max vs. GPT-6 Luna 출시 비교: Intelligence Index v5.0.1 및 항목별 데이터
- 링크:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- 링크:
- 알리바바 클라우드 Model Studio – Qwen4-Max 모델 카드 및 가격표: 입력 모달리티 및 싱가포르 표준 가격
- 링크:
alibabacloud.com/help/en/model-studio/model-pricing
- 링크:
- OpenAI – GPT-6 Luna Model: 입력 모달리티 및 장문맥 가격 책정
- 링크:
developers.openai.com/api/docs/models/gpt-6-luna
- 링크:
- OrcaRouter – Qwen4-Max vs GPT-6 Luna: 단가 비율, 272,000 Token 상향 안내
- 링크:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- 링크:
- Together AI – Pricing: Qwen4 Max 기간 한정 프로모션 가격
- 링크:
together.ai/pricing
- 링크:
- APIYI – 모델 가격 총표, 모델 레지스트리 및 충전 이벤트 FAQ: 카탈로그 가격, 엔드포인트 그룹 및 추가 증정 단계
- 링크:
docs.apiyi.com/models
- 링크:
- 중국정보통신연구원(CAICT) 등 – 대규모 언어 모델 토큰 서비스 성능 모니터링 보고서(2026년): 성공률, 첫 토큰 지연시간, 처리량 정의
- 링크:
caict.ac.cn
- 링크:
작성자: APIYI 기술팀
기술 교류: APIYI apiyi.com 웹사이트 첫 페이지에서 저희에게 연락 주세요. 더 많은 연동 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요


