
Este artículo hace una ronda de selección de Modelo de Lenguaje Grande entre Qwen4-Max y GPT-6 Luna usando sus métricas en la misma tabla comparativa, los precios para contexto largo y las modalidades de entrada, para convertir la puntuación global en criterios de aceptación y juicios de costo sobre tareas concretas.
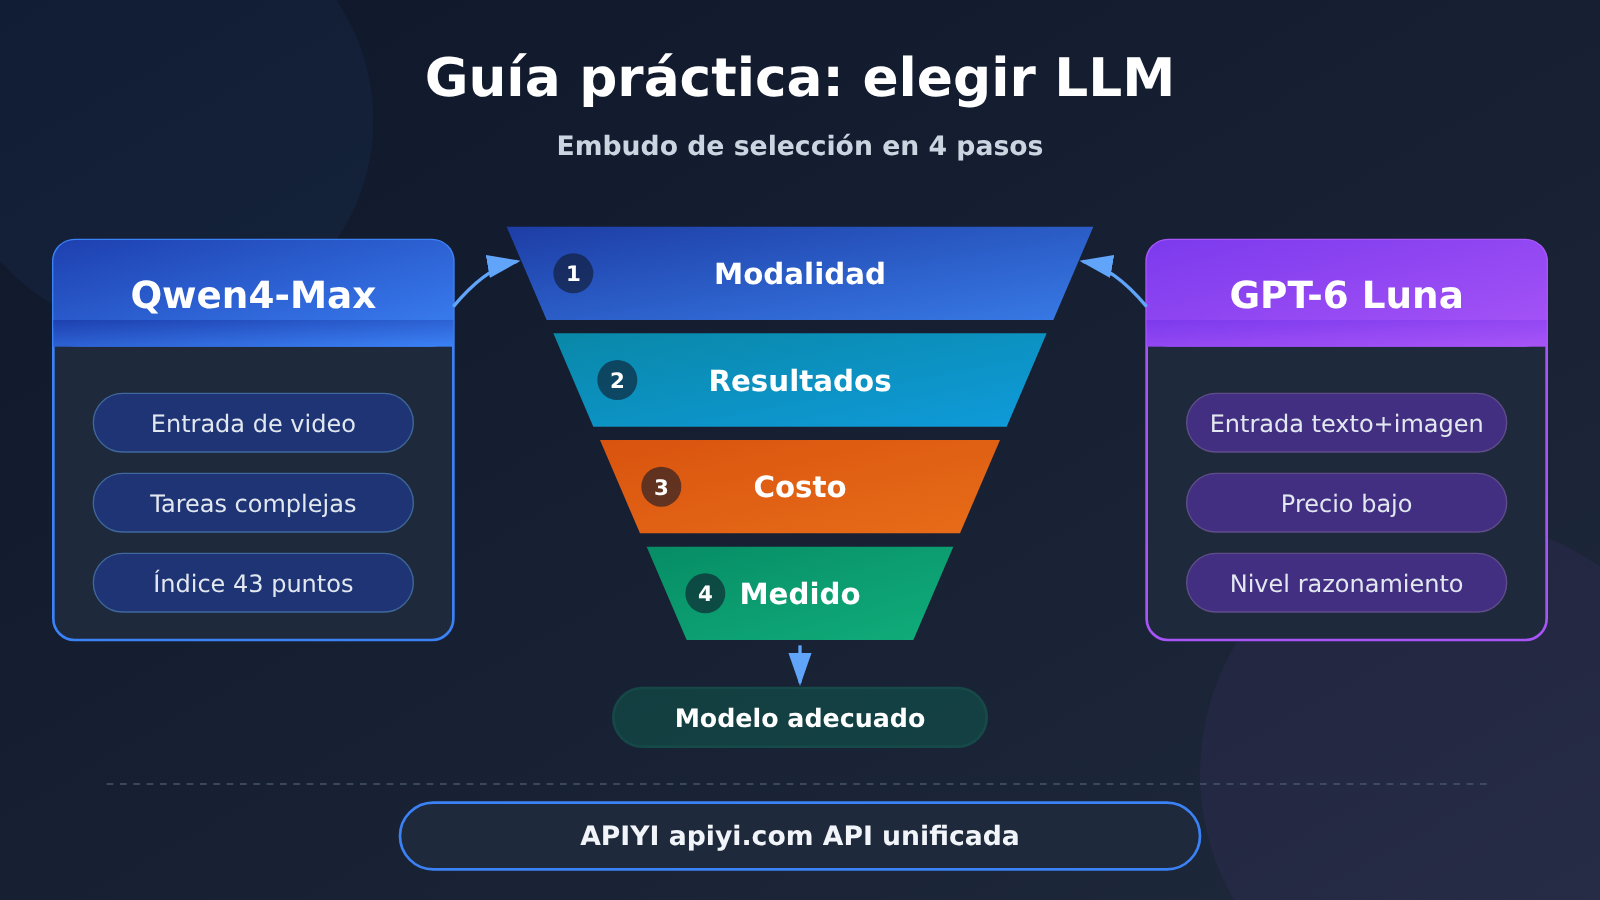
Primero las conclusiones, luego las condiciones. Si la tarea exige entrada de video, según las fichas de ambos modelos solo se puede considerar primero a Qwen4-Max; GPT-6 Luna no entra en la lista de candidatos. Si se trata de tareas solo de texto o de texto e imagen, y el costo por llamada y el volumen de invocaciones son restricciones duras, el precio de lista de GPT-6 Luna es mucho menor, así que vale la pena tomarlo como opción predeterminada. Si hablamos de tareas de alta complejidad como la automatización de múltiples pasos, Qwen4-Max lidera claramente en algunas subpuntuaciones de Artificial Analysis, por lo que puede ser candidato para enrutamiento de alta complejidad. La opción final dependerá de la tasa de aprobación en aceptación y del costo por tarea aprobada en tu propio conjunto de tareas.
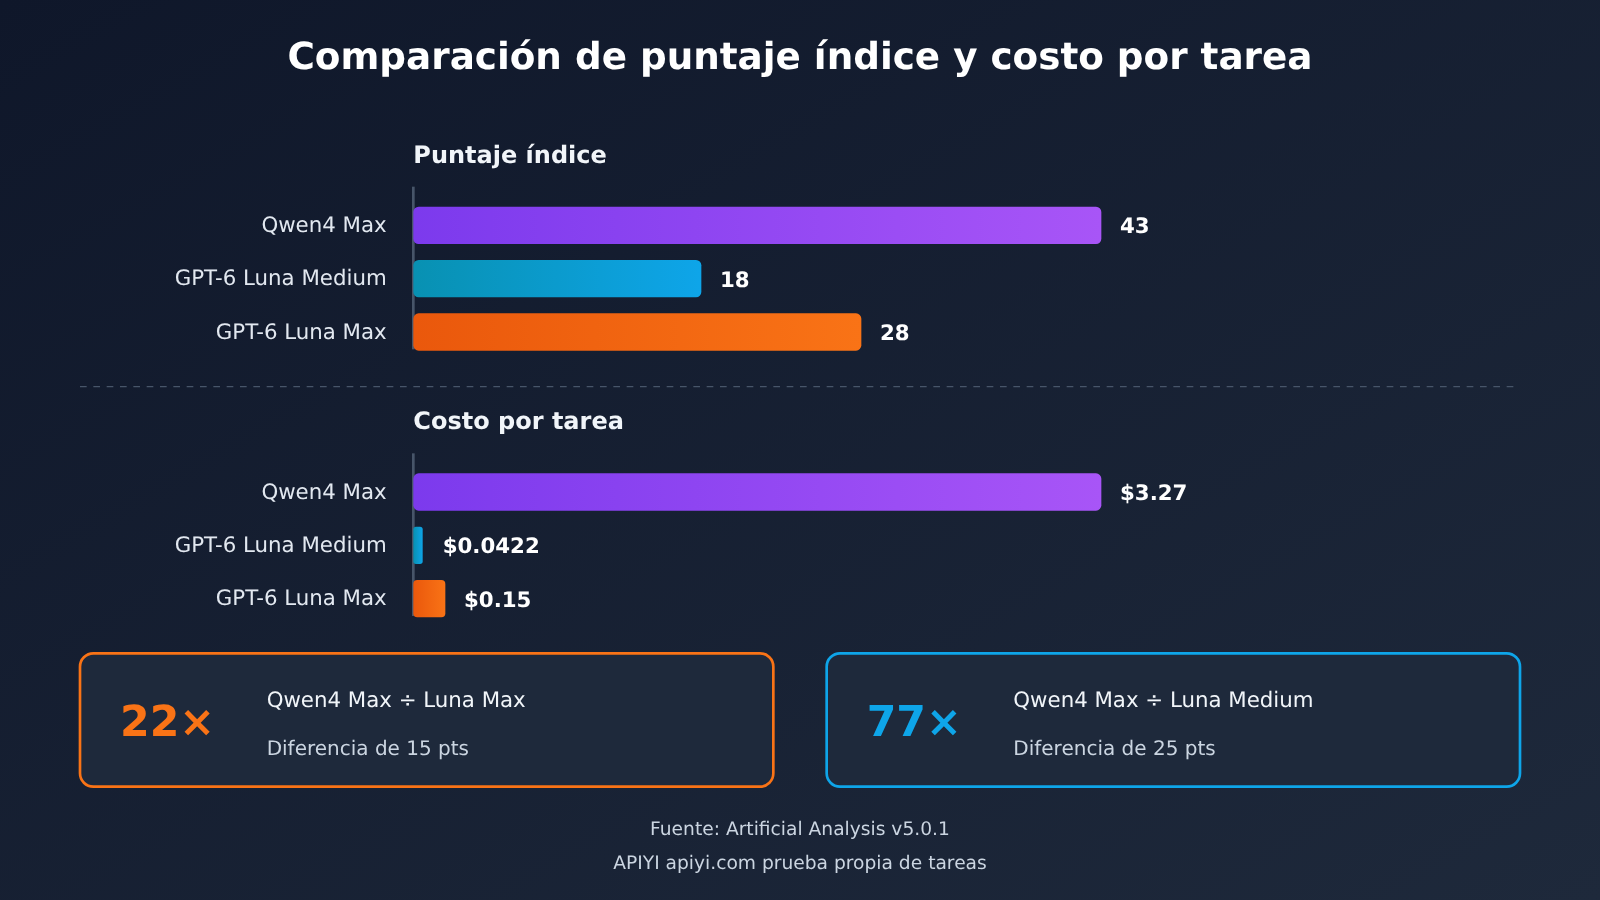
Las conclusiones cambian por tres condiciones. Primera, según el nivel de razonamiento de Luna, la brecha en la puntuación del índice y en el costo por tarea puede pasar de aproximadamente 22 veces a aproximadamente 77 veces. Segunda, cuando la entrada supera los 272,000 tokens, Luna sube de tarifa toda la solicitud según el precio de lista de OpenAI. Tercera, la diferencia en una subpuntuación para una tarea concreta puede ser muy pequeña; por ejemplo, en FrontierCode-AA 2.0 ambos solo difieren en 1.3 puntos porcentuales.
Comparativa rápida de selección de Modelos de Lenguaje Grande: Qwen4-Max y GPT-6 Luna
La siguiente tabla solo incluye las dimensiones que influyen en la selección. Las puntuaciones provienen del Intelligence Index v5.0.1 de Artificial Analysis; los precios proceden de la lista pública de los proveedores o del catálogo de APIYI. Toda la información estaba disponible públicamente en la fecha de verificación de este artículo, 2026-11-20, y no se trata de pruebas pagadas realizadas por nosotros.
| Dimensión de comparación | Qwen4-Max | GPT-6 Luna | Qué implica la diferencia |
|---|---|---|---|
| Modalidad de entrada (ficha del modelo del proveedor) | Texto, imagen, video | Texto, imagen | Para tareas con video, Luna queda descartado de inmediato |
| Modalidad de salida | Texto | Texto | Ninguno de los dos genera imágenes ni voz |
| Intelligence Index v5.0.1 | 43 puntos | Nivel Medium: 18 puntos; nivel Max: 28 puntos | Según el nivel de razonamiento, la diferencia cambia |
| Costo por tarea del índice | $3.27 | Nivel Medium: $0.0422; nivel Max: $0.15 | Solo aplica a esa carga de trabajo del índice |
| Precio de lista del proveedor (por millón de tokens, contexto corto) | Alibaba Cloud Singapur: entrada $1.50, salida $4.50 | Estándar de OpenAI: entrada $0.10, salida $0.50 | Entrada aprox. 15:1; salida 9:1 |
| Facturación de entradas largas | Fuentes de terceros indican una tarifa única para toda la ventana | Si se superan 272,000 tokens, toda la solicitud pasa a una tarifa superior | En documentos largos, hay que calcularlo por separado |
| Endpoints del catálogo de APIYI | chat, responses, messages | Chat Completions, Responses | La elección de protocolo afecta el costo de migración |
| Plataformas disponibles | APIYI apiyi.com, Alibaba Cloud Model Studio, etc. | APIYI apiyi.com, OpenAI oficial, etc. | Con la misma clave API es más fácil alternar y comparar |
El análisis sigue el orden de dependencias de la selección. La sección 1 confirma primero si es posible integrar el modelo, porque si la modalidad o los endpoints no cumplen los requisitos, las puntuaciones y los precios posteriores carecen de sentido. La sección 2 compara el rendimiento con el mismo benchmark; la sección 3 desglosa, para un mismo volumen de uso, el precio del proveedor, el precio del catálogo y lo que realmente paga la cuenta; la sección 4 convierte las conclusiones anteriores en pasos que puedes volver a probar en tu propio negocio. Quien solo se preocupe por el costo puede saltar directamente a la sección 3, pero le recomendamos revisar antes los criterios de descarte de la sección 1.
Términos que conviene conocer antes de seleccionar un Modelo de Lenguaje Grande
| Término | Significado en este artículo |
|---|---|
| Intelligence Index | Puntuación agregada del rendimiento en múltiples tareas de Artificial Analysis para una versión concreta; en este artículo usamos v5.0.1 |
| Costo por tarea del índice | Estimación del costo de completar una tarea dentro de ese benchmark; tanto el nivel de razonamiento como el volumen de entrada y salida modifican el resultado |
| Nivel de razonamiento | Controla la intensidad de pensamiento que invierte el modelo; por ejemplo, Medium y Max en Luna. Al comparar, siempre hay que indicar el nivel |
| Modalidad de entrada | Tipos de contenido que recibe el modelo, por ejemplo texto, imagen o video |
| Precio escalonado por contexto | Cuando la entrada supera cierto umbral, se aplica otra tarifa; hay que confirmar si se calcula solo sobre el excedente o sobre toda la solicitud |
| Lectura de caché | Partida de facturación por reutilizar entradas existentes; debe contarse según la tabla de precios y los aciertos reales de caché |
| Latencia del primer token visible | Tiempo desde que se envía la solicitud hasta que aparece el primer fragmento de respuesta utilizable; en modelos de razonamiento, no confundirlo con el «primer evento» |
| P50 / P95 | Mediana y percentil 95 de la distribución de latencia; reflejan respectivamente el caso típico y las solicitudes lentas |
| Costo por tarea válida | Distribuye los costos de fallos, revisión y repetición entre cada resultado que realmente cumple el criterio |
1. Primer paso para elegir un Modelo de Lenguaje Grande: descartar combinaciones inadecuadas según las restricciones de la tarea
Lo más económico al elegir un modelo es empezar descartando. Por muy alta que sea la puntuación de un modelo, si no admite tu tipo de entrada o tu protocolo de invocación, no queda más remedio que dejarlo fuera; a la inversa, si un modelo barato no cumple las restricciones duras, tampoco tiene sentido calcular costos más adelante.
1.1 Usar la ficha del modelo para distinguir las modalidades de entrada
La ficha del modelo de Alibaba Cloud Model Studio indica que Qwen4-Max acepta entradas de texto, imagen y video, y produce texto como salida. La ficha de OpenAI indica que GPT-6 Luna acepta entradas de texto e imagen y produce texto; la recopilación de OrcaRouter también menciona que Luna no admite generación de imágenes, generación de voz, transcripción ni traducción. Esta es la diferencia más contundente entre ambos y determina que, para tareas de video, Qwen4-Max sea el único candidato.
Cabe señalar que la ficha del fabricante describe las capacidades del modelo en sí; en el caso concreto de un integrador o un endpoint, hay que verificar por separado si los parámetros de video se pueden enviar. Por ejemplo, la página del modelo de Together AI enumera explícitamente entradas de texto e imagen, pero no se encontró una descripción de video para la misma ruta. En ese caso, solo se puede afirmar que «Together enumera explícitamente texto e imagen», y no se puede inferir que admita video.
1.2 Usar el directorio de APIYI para verificar ID, grupos y endpoints
APIYI anunció el 2026-11-17 el lanzamiento de qwen4-max; el registro público de modelos generado el 2026-11-20 enumera sus endpoints como chat, responses, messages, y sus grupos como ClaudeCode, CodexResponses, default, svip. gpt-6-luna aparece en la lista de precios con los grupos Default, SVIP y las entradas Chat Completions, Responses. Si un blog anterior decía que «Qwen4-Max aún no está disponible», lo que vale ahora es el anuncio y el registro más recientes.
El directorio solo demuestra que la plataforma admite ese modelo y endpoint; el grupo en el que está la cuenta y los permisos del token influyen en si realmente puedes invocarlo. Se recomienda crear un token en la consola de APIYI apiyi.com y, antes de comparar resultados, enviar una solicitud mínima para confirmar que el ID exacto del modelo y el endpoint están disponibles.
1.3 Tres escenarios, cada uno con restricciones no negociables
| Escenario | Restricciones no negociables | Resultado del descarte | Siguiente paso |
|---|---|---|---|
| Organización de registros textuales (actas de reunión, archivado de tickets) | Formato de salida estable, bajo costo por llamada, alto volumen de llamadas | Ambos son viables | Comparar tasa de aprobación de formato y costo por unidad |
| Comprensión de video (control de calidad de grabaciones de pantalla, resúmenes de video) | Debe aceptar entrada de video | Descartar GPT-6 Luna según la ficha del modelo | Verificar si el endpoint y el token admiten parámetros de video |
| Flujos complejos (automatización de varios pasos, operaciones entre sistemas) | Alta tasa de éxito en la ejecución de varios pasos, alto costo de fallo | Ambos son viables | Centrarse en la tasa de aprobación de validación, no en el precio unitario |
La organización de registros textuales es un escenario típico sensible al costo: la tarea no es difícil en sí, y la clave está en el costo promedio por resultado cuando se hacen llamadas masivas. La comprensión de video, en cambio, es una cuestión de umbral de capacidad: si las modalidades no coinciden, no tiene sentido comparar. En los flujos complejos, un fallo suele implicar retrabajo manual; si un modelo barato falla unas cuantas veces más, el costo real puede terminar siendo mayor. Esto se calcula en detalle en las secciones 3 y 4.
2. Segundo paso para elegir el Modelo de Lenguaje Grande: comparar beneficios bajo el mismo benchmark
Después de hacer la eliminación, toca mirar los resultados. Aquí usamos únicamente los datos de la misma página de comparación de una publicación de Artificial Analysis, porque distintos rankings tienen conjuntos de tareas y formas de puntuar diferentes, y mezclarlos para ordenarlos no tiene sentido.
2.1 La puntuación integral y el coste de las tareas deben leerse junto con el nivel
| Configuración | Intelligence Index v5.0.1 | Coste de las tareas del índice | Multiplicador de coste respecto a Qwen4-Max |
|---|---|---|---|
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna (Medium, nivel predeterminado) | 18 | $0.0422 | Aprox. 1/77 |
| GPT-6 Luna (nivel Max) | 28 | $0.15 | Aprox. 1/22 |
El famoso «aproximadamente 22 veces» viene de $3.27 ÷ $0.15, y compara Qwen4 Max con el nivel Max de Luna, donde la diferencia de puntos es de 15. Si comparamos con el nivel Medium predeterminado de Luna, el multiplicador de coste es de unas 77 veces, con una diferencia de 25 puntos. Por eso, decir solo que «cuesta 22 veces más» no está completo: hay que indicar al mismo tiempo de qué nivel se trata y qué tipo de carga de trabajo.
Otro detalle es la integridad de los datos. OrcaRouter señala que el ranking solo publicó una puntuación de Qwen4-Max, sin datos por nivel; Luna, en cambio, hizo pública la escalera completa de niveles. A la hora de hacer predicciones de coste, una escalera completa permite ver el punto de inflexión en el que «subir de nivel ya no aumenta la puntuación», y este tipo de información a veces resulta más útil que una puntuación individual más alta.
2.2 La diferencia por apartados varía según la tarea
El índice compuesto no puede predecir el beneficio de una tarea concreta. En AutomationBench-AA, Qwen4 Max obtiene 72.6% y Luna Max 53.2%, unos 19 puntos porcentuales de diferencia; en FrontierCode-AA 2.0, las cifras son 26.5% y 25.2% respectivamente, solo 1.3 puntos porcentuales de diferencia.
Volviendo a los escenarios de la sección 1, los flujos complejos se parecen más a tareas de automatización de varios pasos como las de AutomationBench, y la ventaja de Qwen4-Max podría traducirse en menos retrabajo. Si tus tareas se acercan más a las de FrontierCode, la diferencia entre ambos es pequeña mientras que la diferencia de precio unitario sigue siendo grande, así que la relación calidad-precio de Luna destaca mucho más. Esto es solo una orientación; en concreto, aún hay que verificarlo con tu propio conjunto de tareas.
3. Tercer paso para elegir un Modelo de Lenguaje Grande: calcular por separado el precio del proveedor, el precio de catálogo y los costos de la cuenta
El costo es lo que más fácilmente se mezcla. Esta sección lo divide en tres capas: el precio público del proveedor, el precio de catálogo de APIYI y lo que realmente paga la cuenta después de la recarga con bonificación. Cada capa pertenece a algo distinto y no se puede sustituir por otra.
3.1 Ejemplo de cálculo con el precio del proveedor para una misma solicitud de entrada larga
Supongamos que una solicitud tiene 400.000 tokens de entrada y 8.000 tokens de salida facturable, sin aciertos de caché y sin costos adicionales por herramientas.
| Elemento | Qwen4-Max (precio estándar internacional de Alibaba Cloud en Singapur) | GPT-6 Luna (precio estándar de OpenAI, entrada larga) |
|---|---|---|
| Tarifa de entrada | $1.50 / millón | $0.20 / millón (por encima de 272.000 se escala toda la solicitud) |
| Tarifa de salida | $4.50 / millón | $0.75 / millón |
| Cálculo | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| Costo por solicitud | $0.636 | $0.086 |
La relación entre ambos es de aproximadamente 7,40 veces, casi la mitad de la diferencia de 15 a 1 que hay en el precio de entrada con contexto corto. La razón está en la regla de escalado de Luna. Según el precio de OpenAI, el escalado por entrada larga se aplica a toda la solicitud, no solo a la parte que excede el umbral: con una indicación de 300.000 tokens, los 300.000 se cobran todos a la tarifa alta, no solo los últimos 28.000. El análisis de OrcaRouter señala que Qwen4-Max se cobra a la misma tarifa en toda la ventana de un millón, sin niveles de 32K ni 128K.
El precio del proveedor también cambia según la región y el canal. OrcaRouter indica que Qwen4-Max, en la región Global, tiene entrada a $1.413 y salida a $4.24, distinto de Singapur. La página oficial Pricing de Together AI marca Qwen4 Max como promoción, con precio por tiempo limitado de entrada $1.05, salida $3.15 y lectura de caché $0.0525, exactamente el 70 % del precio de Singapur; la página indica que es válido hasta 2026-11-23, pero no especifica la zona horaria. Su página de detalles del modelo, en cambio, muestra otra escala: $1.43, $4.28 y $0.0713. Al citar este tipo de precios, hay que indicar la página de origen y la fecha; la facturación real se basa en el consumo de la cuenta.
3.2 Precio de catálogo de APIYI calculado según la tarifa de catálogo y el registro de uso
En el catálogo de APIYI, qwen4-max cuesta $1.50 por millón de Tokens de entrada, $4.50 de salida y $0.075 de lectura de caché; gpt-6-luna cuesta $0.10 de entrada en contexto corto, $0.50 de salida y $0.01 de lectura de caché, y la tabla de precios indica que cuando la entrada supera los 272,000 Tokens, la tarifa de entrada sube a $0.20.
Aplicando la misma solicitud de 3.1, qwen4-max según el precio de catálogo da igualmente $0.636. La parte de entrada de gpt-6-luna es 0.4 × 0.20 = $0.08; la tabla de precios verificada en esta ronda solo especifica el escalón superior de entrada, así que sobre qué tarifa se calcula la parte de salida en contexto largo debe consultarse en la tabla de precios vigente y en el registro de uso. La cifra real de costo debe provenir del registro de uso de tu cuenta, no de la fórmula anterior.
💰 Sugerencia para el cálculo de costos: invoca ambos modelos por separado bajo la misma cuenta en APIYI apiyi.com; el registro de uso anotará los Tokens de entrada, salida y caché de cada solicitud, lo que se acerca más a la factura real que estimar a partir de los precios públicos.
3.3 La bonificación por recarga afecta la conversión del capital, no el precio unitario del modelo
El FAQ vigente de APIYI enumera los tramos de recarga por transacción: de $100 a menos de $500, bonificación del 10%; de $500 a menos de $1,000, bonificación del 12%; de $1,000 a menos de $3,000, bonificación del 15%; a partir de $3,000, bonificación del 20%. Tanto las recargas en línea como las corporativas pueden participar, y la bonificación se emite automáticamente; si el ajuste de precios individual para empresas puede acumularse debe confirmarse por separado. Los usuarios normales reciben además $1 en su primera recarga, y los usuarios educativos verificados con correo escolar reciben $2, que deben solicitarse contactando al servicio al cliente; el saldo de recarga se usa según la regla de 365 días indicada en la documentación.
| Tramo de recarga | Saldo acreditado | Capital de recarga equivalente a $1 en el registro | Reducción del costo de capital |
|---|---|---|---|
| $100 por transacción | $110 | Aprox. $0.909 | Aprox. 9.09% |
| A partir de $3,000 por transacción | Monto de recarga × 1.2 | Aprox. $0.833 | Aprox. 16.67% |
La premisa aquí es que el saldo bonificado se agote por completo. Convertido según el tramo del 10%, el costo de registro de $0.636 por solicitud en 3.1 corresponde aproximadamente a $0.578 de capital de recarga. Cabe señalar que la bonificación se aplica de forma uniforme al saldo de todo el sitio; lo que reduce es el capital correspondiente a cada $1 de cuota de registro, y no debe interpretarse como una rebaja adicional de precio de un modelo concreto; al hacer comparaciones de selección, ambos lados deben usar el mismo coeficiente de conversión, de lo contrario la comparación resultará distorsionada.
4. Cuarto paso de selección del Modelo de Lenguaje Grande: convertir las condiciones en pasos comparables y medibles
Las tres primeras secciones se basan en información pública. Lo que realmente decide qué modelo elegir es la tasa de aprobación, la latencia y el costo de tu propia tarea en las mismas condiciones. Actualmente no tenemos, en la plataforma APIYI, datos de tasa de éxito, latencia y facturación de los dos modelos para la misma tarea y el mismo grupo; a continuación presentamos una metodología de comparación que puedes ejecutar por tu cuenta.
4.1. Control de variables y campos de registro
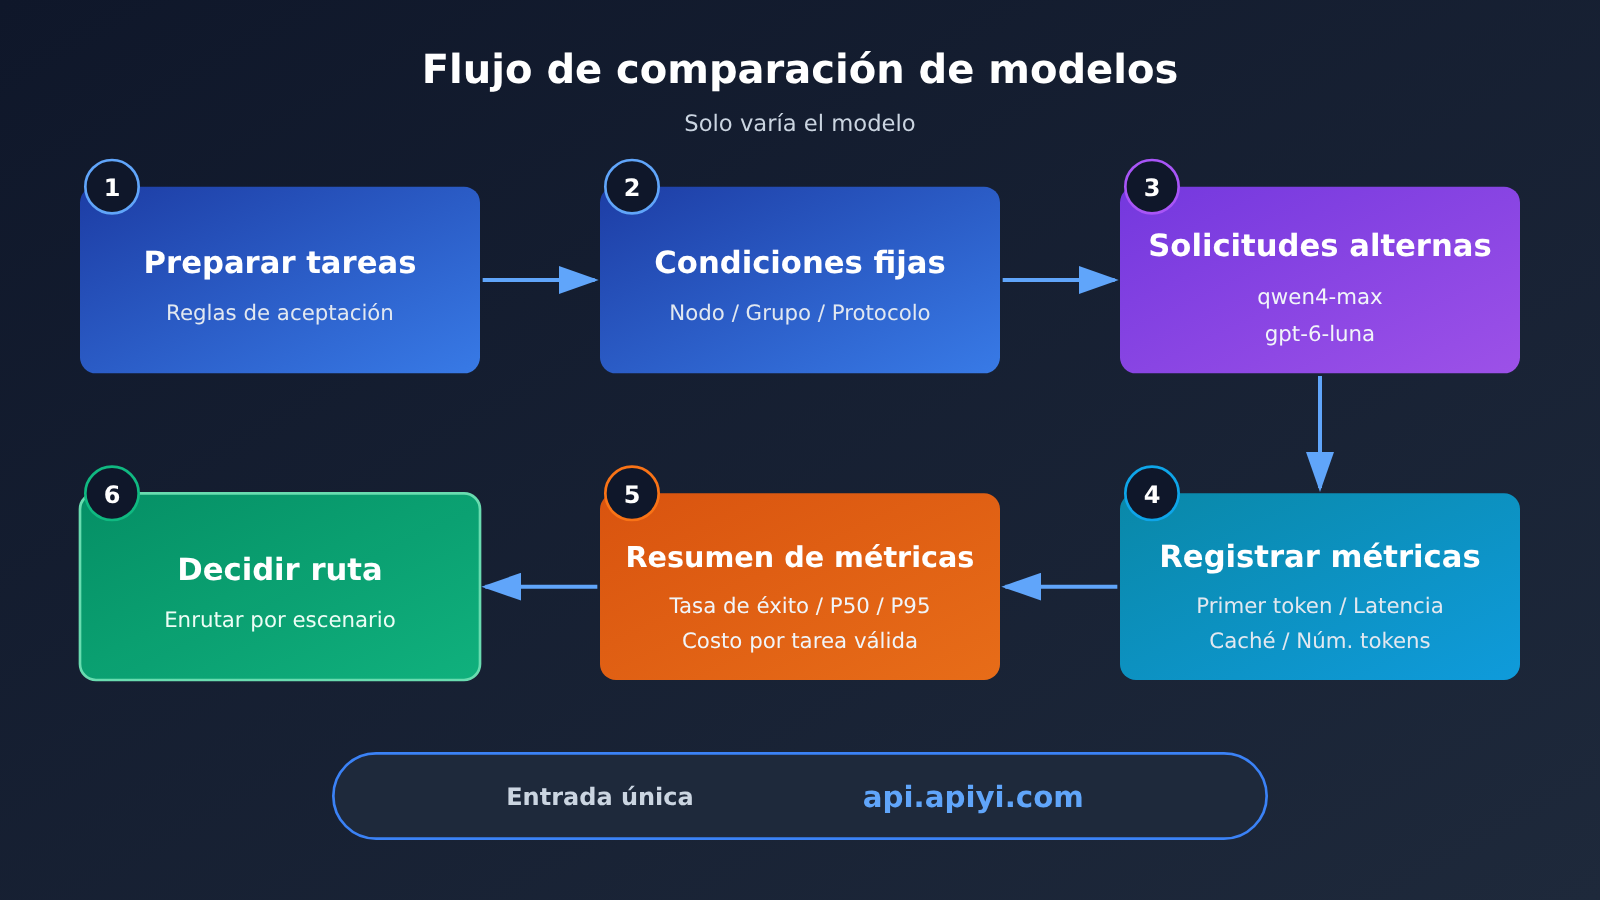
La comparación debe intentar que la única variable que cambie sea el “modelo”. En concreto, usa el mismo nodo de China continental y operador, el mismo grupo y protocolo de APIYI, el mismo conjunto de entrada y límite de salida, y alterna las solicitudes a los dos modelos con la misma concurrencia, para evitar el sesgo temporal que se produce al ejecutar primero un modelo por completo y luego el otro.
| Campo de registro | Uso |
|---|---|
| Si pasa la validación | Calcular la tasa de aprobación y el costo por tarea aceptada |
| Estado HTTP, ID de solicitud | Diagnosticar fallos y conciliar con los registros de uso |
| Latencia del primer token de respuesta visible | Medir la experiencia interactiva; en modelos de razonamiento, debe separarse del primer evento |
| Tiempo total | Medir el rendimiento del procesamiento por lotes |
| Conexión en frío/caliente, aciertos de caché | Explicar las fluctuaciones de latencia y costo |
| Número de tokens de entrada y salida | Verificar el uso real facturado |
Conviene registrar por separado los tiempos de DNS, TCP y TLS. Al presentar los resultados, indica claramente el tamaño de la muestra, la tasa de aprobación y P50/P95; si haces comparaciones públicas externas, puedes tomar como referencia las definiciones de tasa de éxito, latencia del primer token y rendimiento del informe de la CAICT (Academia China de Tecnología de la Información y las Comunicaciones).
4.2 Script mínimo para la prueba comparativa alternada
El siguiente script llama alternadamente a dos modelos mediante la interfaz compatible con OpenAI y usa salida en streaming para medir el primer token visible de la respuesta y el tiempo total. Debes sustituir la función de validación según tu tarea; si necesitas configurar el nivel de razonamiento, confirma antes el nombre del parámetro en la documentación de APIYI, añádelo y déjalo indicado en el registro.
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI; ambos modelos comparten la misma clave
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的会议记录整理成 JSON:...", "..."]  # Sustituye por tu conjunto de tareas

def passed(task, answer):
    return answer.strip().startswith("{")  # Sustituye por la regla de validación real

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # Peticiones alternadas para reducir el sesgo temporal
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # Ambos modelos usan el mismo límite de salida
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # Primer token visible de la respuesta
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "样本", n, "通过率", sum(r["ok"] for r in rs) / n,
          "首字P50", statistics.median(ttfts) if ttfts else None,
          "首字P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
Se recomienda totalizar el uso de tokens y el costo directamente desde los registros de uso de la plataforma por ID de solicitud, y luego sustituirlos en la fórmula siguiente.
4.3 Costo por tarea válida y enrutamiento por niveles
El costo por tarea válida es igual al total de costos de invocación (incluidos fallos y reintentos) más los costos de revisión manual y corrección, dividido por el número de tareas que finalmente pasan la validación. Si un modelo con precio unitario bajo tiene una tasa de aprobación baja, el denominador se reduce y el numerador aumenta, por lo que su costo por tarea válida podría superar al de un modelo con precio unitario más alto; a la inversa, si ambas tasas de aprobación son similares, la diferencia de precio unitario se reflejará casi tal cual en el resultado.
Con base en esto, se puede enrutar por niveles según la complejidad de la tarea: las tareas comunes van por defecto a gpt-6-luna, y las tareas de alta complejidad o de video van a qwen4-max. Para decidir si se habilita una ruta, primero verifica si su tasa de aprobación en el conjunto de tareas correspondiente alcanza el umbral, y luego revisa el costo por tarea válida. Como ambos modelos están disponibles a través de la misma API compatible con OpenAI de APIYI apiyi.com, para cambiar de ruta solo hay que modificar el campo model.
🎯 Consejo para la comparación: los nuevos usuarios pueden usar primero el crédito de prueba por registro que aparece en la página de inicio rápido de APIYI apiyi.com para ejecutar el script de principio a fin, y luego recargar según el tamaño del conjunto de tareas para hacer la comparación formal.
4.4 Los datos de sondeo del punto de entrada solo delimitan la medición
La tabla de monitoreo pública de 灵简AI tomó muestras desde nodos de China continental para el dominio de APIYI; del 2026-11-05 al 11-06, tres registros HTTP 200 tuvieron tiempos de 429, 569 y 565 ms, respectivamente. Este tipo de sondeo solo refleja la conectividad del punto de entrada; además, la página cuenta algunos HTTP 404 como normales y no especifica la carga útil de la solicitud ni el método de autenticación, por lo que no sirve para inferir la latencia de generación o la tasa de éxito del modelo. El tiempo hasta el primer token de Artificial Analysis también representa únicamente su propio entorno de evaluación; los resultados bajo tus condiciones de red y concurrencia deben medirse por separado con el método de 4.1.
Volviendo a la pregunta del título: la entrada de video es un requisito obligatorio, y el único modelo que lo cumple es Qwen4-Max; en tareas de solo texto y de texto con imágenes, la ventaja de precio de lista de GPT-6 Luna es mayor con contextos cortos y se reduce cuando la entrada supera los 272,000 tokens; en tareas de alta complejidad con múltiples pasos, las ventajas de Qwen4-Max en apartados específicos podrían compensar la diferencia de precio unitario. Las tres conclusiones dependen del nivel, la longitud de entrada y el tipo de tarea, así que al final manda el costo por tarea válida en tu propio conjunto de tareas. Si necesitas un punto de entrada unificado para hacer pruebas comparativas alternando los modelos, puedes llamar a ambos al mismo tiempo con una sola clave API a través de APIYI apiyi.com.
Referencias
- Artificial Analysis – Comparativa de lanzamiento Qwen4 Max vs. GPT-6 Luna: Intelligence Index v5.0.1 y datos por categoría
- Enlace:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- Enlace:
- Alibaba Cloud Model Studio – Ficha del modelo Qwen4-Max y lista de precios: modalidades de entrada y precio estándar de Singapur
- Enlace:
alibabacloud.com/help/en/model-studio/model-pricing
- Enlace:
- OpenAI – Modelo GPT-6 Luna: modalidades de entrada y tarificación de contexto largo
- Enlace:
developers.openai.com/api/docs/models/gpt-6-luna
- Enlace:
- OrcaRouter – Qwen4-Max vs GPT-6 Luna: proporción de precios unitarios y aclaración sobre el tramo de 272,000 tokens
- Enlace:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- Enlace:
- Together AI – Precios: precio promocional por tiempo limitado de Qwen4 Max
- Enlace:
together.ai/pricing
- Enlace:
- APIYI – Tabla general de precios de modelos, registro de modelos y FAQ de la campaña de recarga: precios de catálogo, agrupación de endpoints y niveles de bonificación adicional
- Enlace:
docs.apiyi.com/models
- Enlace:
- CAICT (Academia China de Tecnologías de la Información y las Comunicaciones) y otros – Informe de monitorización del rendimiento del servicio de tokens de Modelos de Lenguaje Grande (2026): tasa de éxito, latencia del primer token y definiciones de throughput
- Enlace:
caict.ac.cn
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes escribirnos desde la página principal de APIYI apiyi.com; encontrarás más material de integración en el centro de documentación docs.apiyi.com


