
Résumé : cet article répond à une question : GPT-6.2 Sol peut-il prendre en charge les questions de données posées par les utilisateurs en front office, et quelles questions demandent encore une vérification supplémentaire.
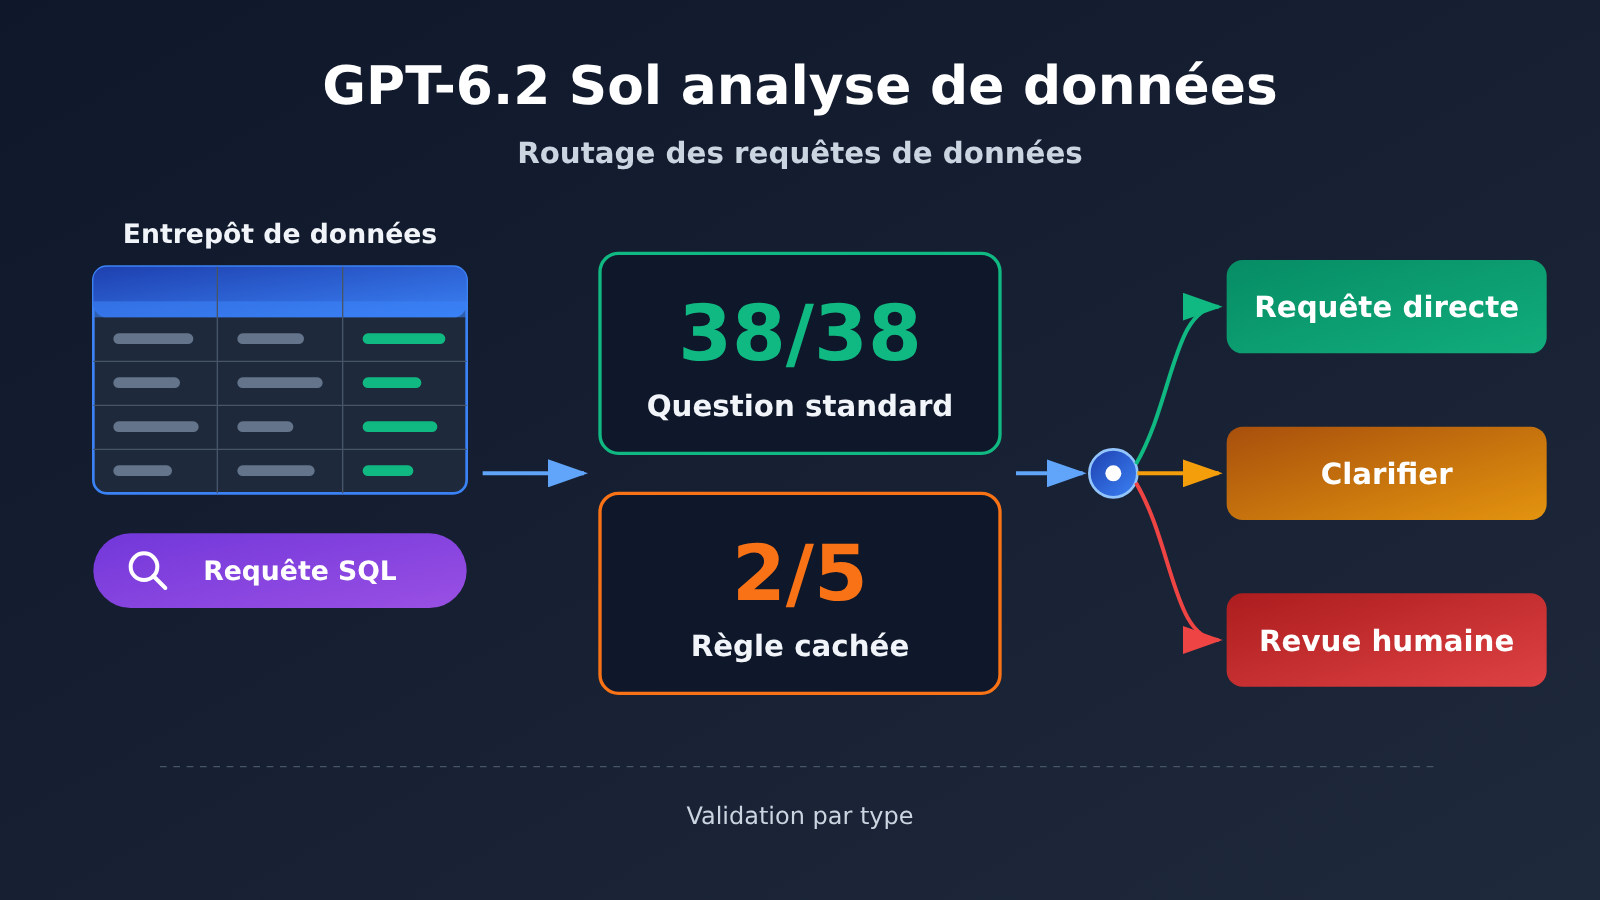
Les performances de GPT-6.2 Sol en analyse de données se lisent en deux parties. Dans le test spécialisé à un seul tour publié par Plotly le 17 novembre 2026, il a répondu correctement aux 38 questions sur 38 réparties en cinq catégories : analyse courante, détection d’ambiguïté, données non répondables, qualité des données et pièges statistiques, avec un temps médian d’environ 10,5 secondes par question. Dans la même session, il n’a validé que 2 des 5 questions à motif caché.
On peut donc en tirer la conclusion suivante : les questions de synthèse dont le périmètre est clair et l’impact limité peuvent être confiées à Sol en pilote, en lecture seule ; quand le périmètre manque, il faut d’abord lui demander de clarifier ; l’attribution ouverte et les décisions vers l’extérieur doivent passer par une revue d’analyste. Cette conclusion repose sur trois préalables : le test n’a été exécuté qu’une seule fois, la banque de questions est constituée de questions en anglais simulant une entreprise éolienne, et les coûts proviennent du canal OpenRouter. Une fois transposé à vos propres données et à votre propre canal, il faudra refaire la validation par type de question.
GPT-6.2 Sol analyse de données : carte des connaissances et index de lecture
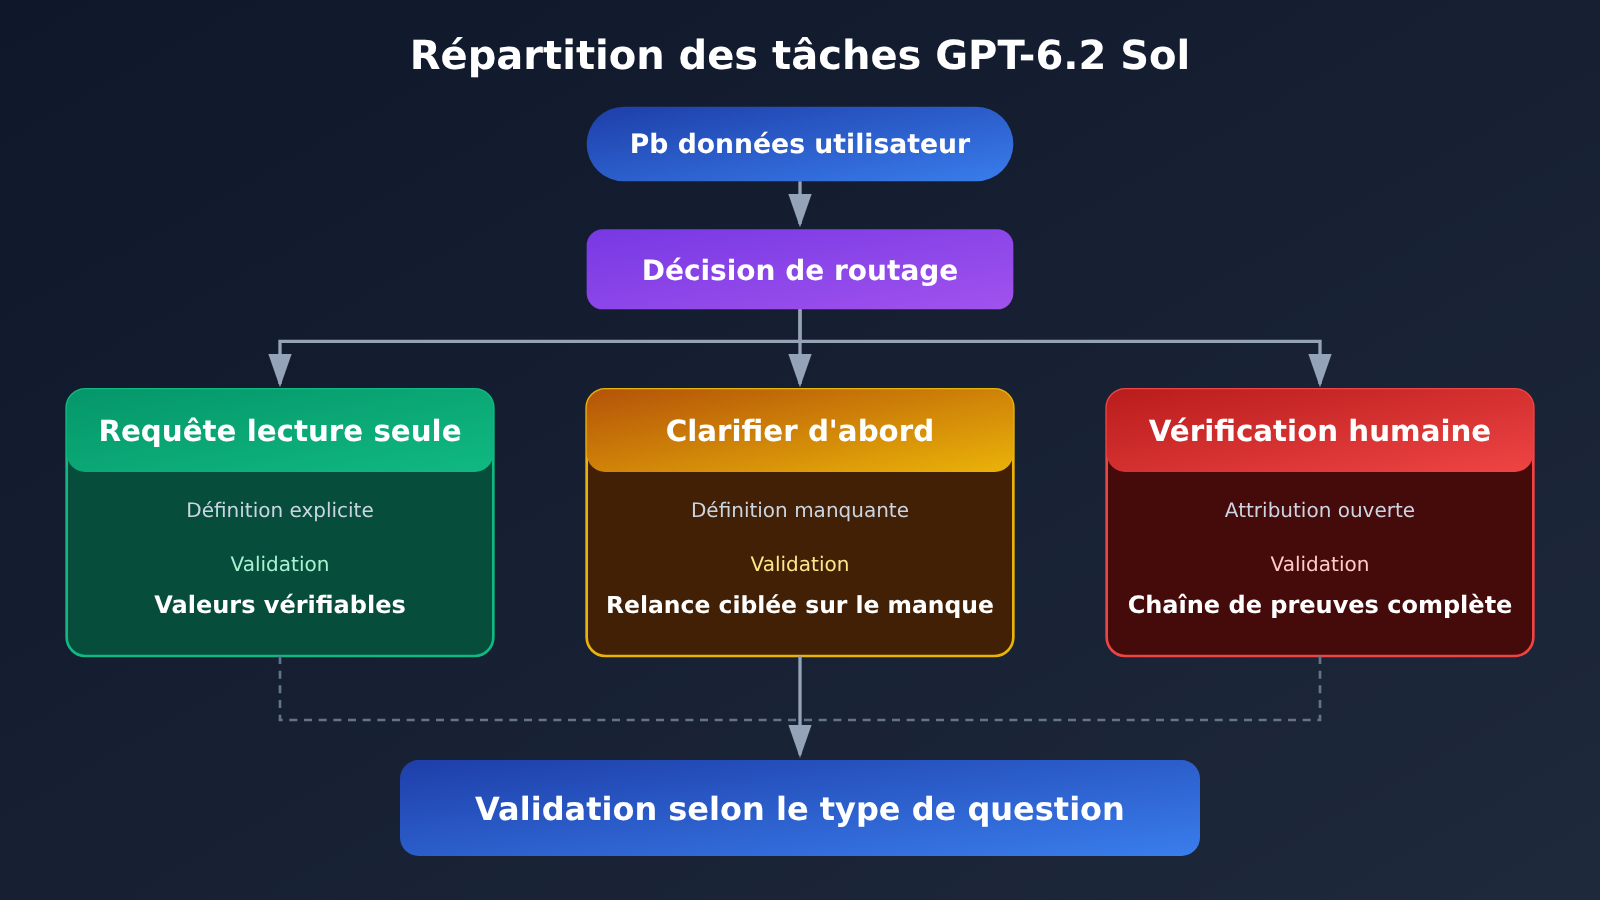
L’image ci-dessous illustre la logique de routage des tâches pour l’ensemble de l’article. Chaque branche précise la condition d’entrée, la sortie attendue du modèle, ainsi que le numéro de section correspondant dans le corps du texte.
L'utilisateur pose une question sur des données
 │
 ├─ Définition claire + synthèse à faible impact ──→ [1] Sol en lecture seule
 │                                                  Sortie : valeur + numérateur/dénombre + plage temporelle et fuseau horaire + requête SQL
 │
 ├─ Définition manquante / données insuffisantes ──→ [3.2] Clarifier d'abord
 │                                                  Sortie : une question de suivi précise + liste des définitions possibles
 │
 └─ Analyse causale ouverte / décision externe ────→ [3.3] Remettre à un analyste pour vérification
                                                    Sortie : journal de diagnostic initial + preuves à l'appui + vérification des explications alternatives
            ↓
   [2] Décider si l'on place Sol au premier plan selon la latence et le coût par question
            ↓
   [4] Valider sur vos propres données par type de question, livrer un résultat accompagné de la date des données et des preuves de requête
L’ordre des sections est le suivant. La section 3, qui est parallèle, peut être consultée selon vos besoins ; les autres sections gagnent à être lues dans l’ordre.
| N° de section | Question à laquelle elle répond | Ce qu’elle apporte à la section suivante | Ce que vous pouvez faire après lecture |
|---|---|---|---|
| 1 | Sur quels types de questions Sol est stable | Frontières des types de questions : 38/38 et 2/5 | Délimiter le périmètre où l’on peut interroger directement |
| 2 | Est-ce rentable de le placer au premier plan | Latence, coût par question et hypothèses d’extrapolation | Évaluer le budget et le temps d’attente pour un scénario interactif |
| 3 | Quels signaux exigent clarification ou passage à un humain | Trois formes d’échec et trois exemples de sortie | Concevoir les règles de routage |
| 4 | Comment valider sur vos propres données | Indicateurs et frontières par type de question | Produire un livrable vérifiable |
To Know : Termes liés à l’analyse de données GPT-6.2 Sol
| Terme | Explication concise |
|---|---|
| Entrepôt de données | Ensemble de données regroupant des données historiques dispersées dans les systèmes métier, destiné aux requêtes et à l’analyse |
| Définition d’un indicateur | Définition de l’indicateur, conditions de filtre, numérateur/dénombre et bornes temporelles |
| SQL en lecture seule | Mode de requête qui ne fait que de la recherche et de l’agrégation, la source de données conservant des droits en lecture seule |
| Question à motifs cachés | Des anomalies structurelles sont préalablement injectées dans les données, la question ne donne que des indices et le modèle doit aller chercher activement la règle précise |
| Preuve de requête | Requête SQL, définition, résultat et date des données permettant à un tiers de vérifier la conclusion |
| Latence p50 / p95 | Durée dans laquelle la moitié des requêtes sont terminées / durée dans laquelle 95 % des requêtes sont terminées |
| Entrée en cache | Tokens d’entrée identifiés comme réutilisables lors de la facturation en amont, dont le prix unitaire est bien inférieur à celui d’une entrée normale |
| Validation par type de question | Noter séparément l’interrogation de données, la clarification, le refus de répondre et l’exploration, pour éviter qu’un score global ne masque un type d’erreur |
1. GPT-6.2 Sol pour l’analyse de données : commencer par les résultats de requêtes validables de façon stable
1.1 Ce que le test Plotly a réellement mesuré
Dans son cadre de test Plotly Studio Embedded, Plotly appelle le modèle via OpenRouter en n’exposant que quatre outils en lecture seule : lister les jeux de données, exécuter une requête SQL, tracer un graphique et afficher un tableau. Le dépôt de test simule une entreprise du secteur éolien, avec environ 19,9 millions de lignes, 44 tables et 554 colonnes. 43 questions en anglais sont évaluées une par une comme réussies ou échouées, sur la base d’une clé de réponses et de règles de notation. Le modèle qui note est Claude Sonnet 5, avec temperature=0, et les questions échouées sont réexaminées à la main par l’équipe.
Ce dispositif est proche de la réalité des requêtes BI en entreprise : le modèle ne voit pas toutes les données, il doit trouver lui-même les tables, écrire du SQL, lire les résultats puis répondre. La banque de questions et la clé de réponses sont conservées par Plotly et ne peuvent pas être reproduites question par question depuis l’extérieur. Les chiffres ci-dessous doivent donc être lus comme une observation ponctuelle, assortie d’une description de méthode, et non comme un classement stable.
| Type de question | Nb de questions | Résultat GPT-6.2 Sol | Implication métier |
|---|---|---|---|
| Analyse courante | 20 | 20/20 | Les synthèses à périmètre figé peuvent être tentées en réponse directe |
| Détection d’ambiguïté | 5 | 5/5 | Capable de repérer qu’une question admet plusieurs interprétations |
| Données insuffisantes pour répondre | 5 | 5/5 | Capable de refuser de répondre quand les données ne le permettent pas, sans inventer de chiffres |
| Qualité des données | 3 | 3/3 | Capable de remarquer les valeurs manquantes, les doublons, etc. |
| Pièges statistiques | 5 | 5/5 | Capable d’éviter les erreurs d’interprétation statistique courantes |
| Régularités cachées | 5 | 2/5 | La recherche ouverte de tendances demande encore une validation humaine |
| Total | 43 | 40/43 | Les 38 premières questions passent toutes ; les points perdus se concentrent sur les questions exploratoires |
Plotly indique également que d’autres modèles ont connu jusqu’à trois questions d’écart lors de réexécutions. Un score de 40/43 n’est donc qu’à trois questions du maximum, ce qui tombe précisément dans cette marge de variation. Ce qui mérite davantage l’attention, c’est la répartition des points perdus : ils se situent tous sur les questions de régularités cachées, les cinq premières catégories n’ayant enregistré aucune erreur.
1.2 Pourquoi les requêtes à périmètre figé sont vérifiables
Prenons l’exemple d’un rapport après-vente : la question « taux de retour par entrepôt sur les 7 derniers jours » peut être validée de façon stable à condition que trois éléments aient été fixés à l’avance : le dénominateur est-il constitué des commandes livrées ou de l’ensemble des commandes, sur quel fuseau horaire la plage temporelle est-elle tronquée, et les filtres excluent-ils les commandes de test et les commandes internes. Une fois ces trois points consignés dans la documentation du périmètre, le SQL généré par le modèle et les résultats peuvent être comparés point par point à une requête faite à la main.
Le périmètre figé transforme la question « le modèle est-il intelligent ? » en « les chiffres sont-ils identiques ? », et cette seconde question peut être comparée automatiquement. C’est aussi ce qui explique que les 38 questions puissent toutes passer, et que ce résultat ait du sens : la plupart ont une réponse de référence unique.
2. Latence et coûts de l’analyse de données avec GPT-6.2 Sol : faut-il le déployer en production ?
2.1 Comparaison des deux générations de Sol sur un run complet
Quand un utilisateur pose une question sur ses données en production, le temps d’attente détermine directement son expérience. Le rapport Plotly fournit une comparaison entre GPT-6.2 Sol et GPT-6.1 Sol sur le même run de 43 questions :
| Indicateur | GPT-6.1 Sol | GPT-6.2 Sol | Variation |
|---|---|---|---|
| Coût du run complet | $2.61 | $1.22 | environ 53.3 % de moins |
| Durée médiane par question | 17.6 secondes | 10.5 secondes | environ 40.3 % de moins |
| Nombre d’appels d’outils | 258 | 158 | nette diminution |
| Nombre d’invocations du modèle | 227 | 173 | en baisse |
| Volume d’entrée | env. 7,8 millions de tokens | env. 4,6 millions de tokens | en baisse |
| Volume de sortie | env. 70 000 tokens | env. 45 000 tokens | en baisse |
| Proportion d’entrée mise en cache | 94 % | 97 % | en hausse |
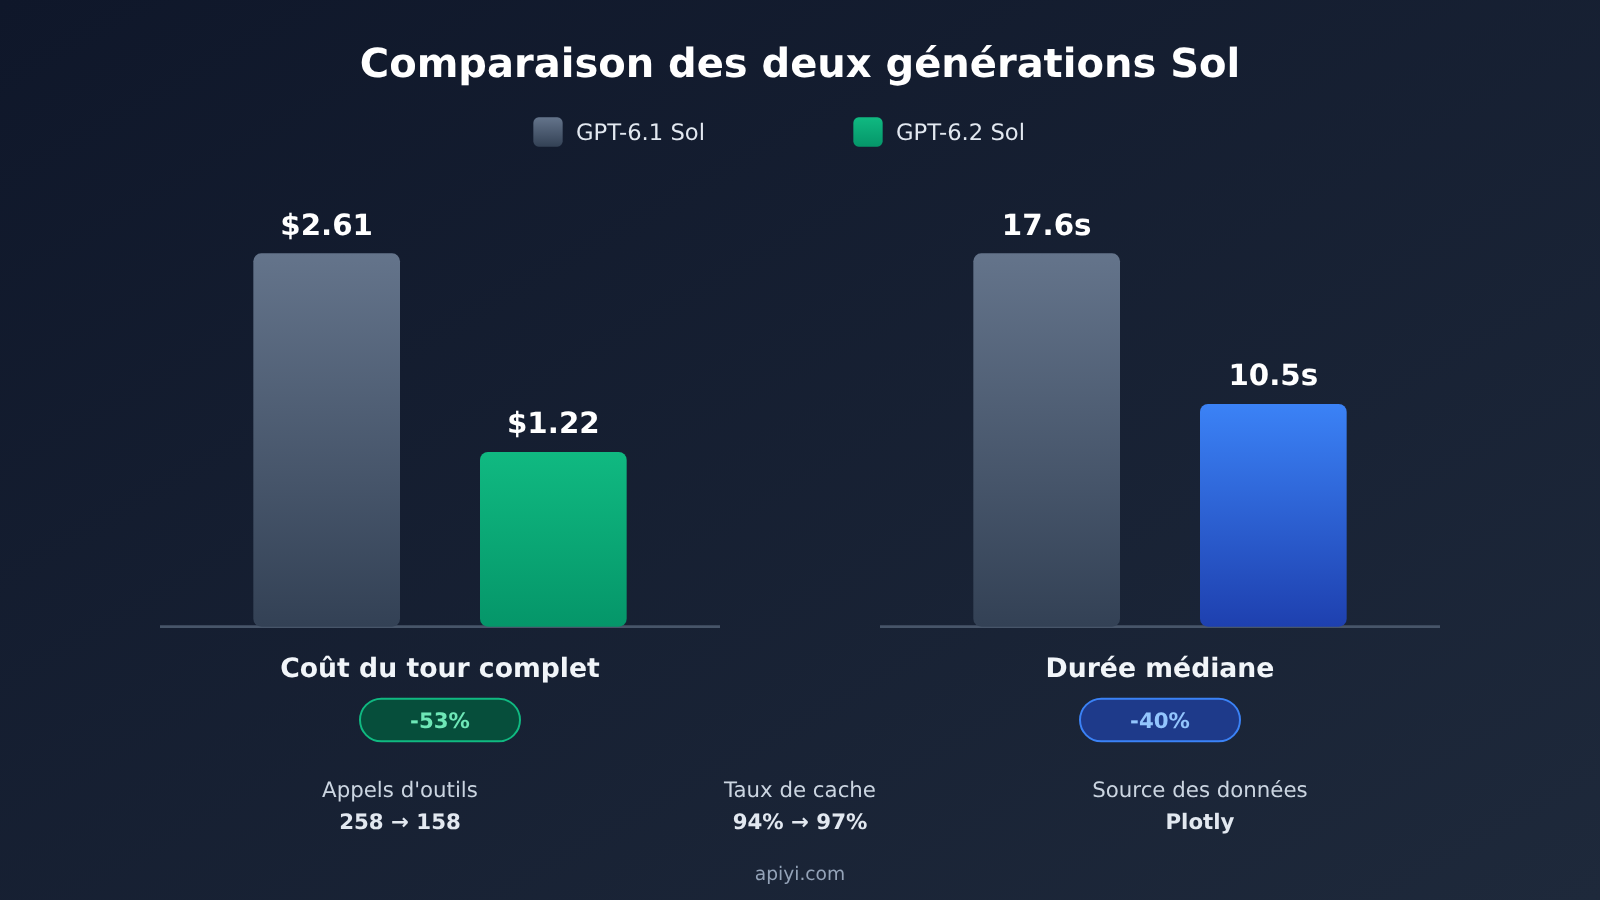
Les deux générations de Sol affichent le même tarif de base Standard en contexte court, mais le coût d’un run complet est presque divisé par deux. L’écart vient du déroulement de la tâche : moins de tours d’appel, moins de tokens lus et écrits, un taux de succès du cache plus élevé. Pour évaluer le coût d’un scénario d’analyse de données, il faut donc raisonner en « combien coûte la résolution d’une question » ; le tarif au million de tokens n’est qu’un facteur parmi d’autres.
2.2 Extrapolation à environ $28.4 pour mille questions et hypothèses sous-jacentes
Si l’on divise les $1.22 du run complet par 43 questions, on obtient environ $0.0284 par question, soit environ $28.4 pour mille questions. Ce chiffre n’est valable que si les hypothèses suivantes sont réunies simultanément :
- la répartition des types de questions est identique à celle des 43 questions de Plotly, dont les questions exploratoires représentent environ 12 % ;
- on utilise le même canal OpenRouter et la même tarification ;
- le taux de cache reste autour de 97 %, les questions partageant la même invite système et la même description du schéma de tables ;
- chaque question n’est exécutée qu’une seule fois, sans nouvelle tentative.
Un autre chiffre figure dans le classement Plotly : le coût médian par question, $0.017, qui relève d’une statistique différente de la valeur moyenne. Les questions exploratoires mobilisent plus d’outils et prennent plus de temps, ce qui tire la moyenne vers le haut, tandis que la médiane reste plus proche du coût d’une question de données ordinaire. Pour établir un budget, on peut estimer les questions quotidiennes à partir de la médiane, puis ajouter séparément une part correspondant à la proportion de questions exploratoires.
Le tarif officiel Standard d’OpenAI en contexte court est le suivant : entrée normale $2.00, lecture du cache $0.10, sortie $10.00 (USD / million de tokens, la sortie incluant déjà les tokens de raisonnement). Lorsque le volume total d’entrée d’une requête dépasse 272K, l’ensemble de la requête bascule sur la grille tarifaire du contexte long. Le palier court de l’interface de tarification publique d’APIYI apiyi.com est identique à l’officiel ; le palier long est de $3 pour l’entrée, $0.15 pour la lecture du cache, $3.75 pour l’écriture du cache et $11.25 pour la sortie. Dans un scénario de questions sur données, une requête individuelle reste généralement bien au-dessous de 272K ; il faut seulement surveiller le changement de palier lorsqu’on injecte d’un coup de nombreuses structures de tables ou des résultats historiques.
3. GPT-6.2 Sol : trois pistes pour l’analyse de données — quand clarifier, quand transférer à un humain
3.1 Pourquoi les questions à règle cachée font perdre des points
Parmi les 38 questions sans règle cachée, 6.2 Sol effectue en moyenne environ 2,9 appels d’outils par question, contre environ 4,3 pour 6.1 Sol, et les deux les réussissent toutes. Pour les 5 questions à règle cachée, le rapport spécialisé sur Sol indique qu’en moyenne 6.2 Sol effectue environ 9 requêtes à la base de données, contre environ 16 pour 6.1 Sol. (Dans l’article du classement général de Plotly, l’exemple donné pour la génération précédente utilise un ordre de grandeur d’environ 18 requêtes ; ici, nous nous en tenons au rapport spécialisé.)
Après un examen manuel, les trois questions ratées sont les suivantes :
- La règle implantée n’a pas été isolée séparément ;
- Les objets précis concernés n’ont pas été identifiés ;
- La partie des données où l’effet existe réellement n’a pas été retrouvée.
Ces trois échecs ont un point commun : les requêtes sont restées à la surface. On peut retenir cette observation : la nouvelle version effectue des recherches moins approfondies sur les questions d’exploration. Quant à la relation de cause à effet « un nombre réduit de requêtes entraîne une perte de points », elle nécessiterait une expérience avec variables contrôlées pour être confirmée. Pour le métier, la conclusion est la même : pour toute question d’attribution qui exige de rechercher activement des preuves, il ne faut pas prendre la première réponse du modèle comme conclusion directe.
3.2 Définition manquante : demander avant de répondre
Voici trois types de sorties illustrés avec un jeu de données fictif de tickets après-vente. Le jeu de données contient quatre tables : commandes, tickets, lots de produits et entrepôts. Les sorties ci-dessous sont des exemples de conception, pas des résultats mesurés.
Réponse normale (définition explicite). L’utilisateur demande « le taux de retour par entrepôt sur les 7 derniers jours ». Une sortie recevable doit, en plus de la valeur pour chaque entrepôt, conserver : le numérateur (nombre de tickets de retour physique), le dénominateur (nombre de commandes réceptionnées sur la même période), la plage de dates et le fuseau horaire (par exemple du 11 au 13 jusqu’au 11 au 19 en heure de Pékin), la dimension d’agrégation (entrepôt), ainsi que la requête SQL exécutée.
Demander d’abord la définition (définition manquante). L’utilisateur demande simplement « quel est le taux de retour la semaine dernière ». Le modèle doit d’abord poser une question : « Le taux de retour est-il calculé sur les demandes de remboursement ou sur les retours physiques ? La différence est importante dans les cas de remboursement sans retour. » Puis il présente les deux définitions au choix de l’utilisateur, et n’affiche aucun chiffre tant que ce dernier n’a pas choisi.
3.3 Attribution ouverte : transmettre à l’analyste
L’utilisateur demande « le taux de retour d’un canal a doublé, sur quels lots se concentre l’anomalie ? » On entre ici dans le domaine des questions à régularité cachée. Le modèle peut d’abord mener une investigation préliminaire : vérifier s’il manque des données, si la taille globale de l’échantillon est suffisante, puis découper successivement par canal, catégorie, entrepôt et lot. La sortie doit conserver au moins une preuve corroborante et une vérification destinée à écarter une explication alternative (par exemple, confirmer que le volume de commandes de ce canal n’a pas anormalement chuté cette semaine-là, pour exclure un doublement dû à un dénominateur plus petit).
Une fois cela fait, la sortie doit être étiquetée « en attente de révision par l’analyste » et non « conclusion ». Les règles de routage peuvent se résumer dans un tableau :
| Indice | Formulation typique | Routage | Sortie du modèle | Point de validation |
|---|---|---|---|---|
| Définition claire, faible impact | Taux de retour sur 7 jours par entrepôt | Interrogation en lecture seule par Sol | Valeur + définition + SQL | Valeur identique à la requête manuelle |
| Définition ou données insuffisantes | Quel est le taux de retour la semaine dernière | Clarifier d’abord | Une question de suivi + définitions candidates | La question de suivi cible bien le manque |
| Attribution ouverte, décision externe | Sur quels lots se concentre l’anomalie | Transmettre à l’analyste pour révision | Journal d’investigation + preuve corroborante + vérification d’explication alternative | Couverture des preuves, faux positifs et faux négatifs |
4. Valider les capacités d’analyse de données de GPT-6.2 Sol avec vos propres données
4.1 Code d’intégration et de routage
gpt-6.2-sol peut être appelé via les endpoints Responses et Chat Completions ; les appels de fonction et les outils intégrés passent par la voie Responses. Aucun des deux endpoints n’accepte le niveau de raisonnement none ; lors de la migration de code existant, pensez à vérifier ce paramètre. Voici un exemple minimal de classification de routage avec Chat Completions :
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

question = "上周退货率多少"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "把用户的数据问题分类为 direct / clarify / escalate,"
                                      "只返回 JSON:{\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
Voir l’exemple complet d’appel de l’outil SQL en lecture seule (API Responses)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Ouverture de la base en lecture seule au niveau de la base : la vérification par expression régulière ne sert que de seconde protection
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "在售后数据仓库执行只读 SQL,返回最多 200 行",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "你是数据分析助手。回答必须包含:分子、分母、时间范围与时区、聚合维度、所执行的 SQL。"
    "口径不明确时先提问;涉及归因的结论标注为待分析师复核。"
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="按仓库列过去 7 天的退货率",
    tools=tools,
)

# Traiter les appels d'outils en boucle jusqu'à ce que le modèle fournisse la réponse finale
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 Démarrage rapide : pour valider avec vos propres échantillons métier, vous pouvez demander un quota d’essai gratuit pour les nouveaux utilisateurs via APIYI apiyi.com. Une même clé API permet de basculer entre
gpt-6.2-solet d’autres modèles phares, afin de comparer horizontalement sur un même jeu de questions, à condition que la source de données reste en lecture seule.
4.2 Indicateurs de validation par type de question
La banque de questions de validation devrait couvrir les trois routes de la section 3, avec un score calculé séparément pour chaque type de question.
| Type de question | Indicateur principal | Mode de jugement | À consigner |
|---|---|---|---|
| Question chiffrée sur un périmètre figé | Taux d’exactitude des valeurs | Comparaison ligne à ligne avec le résultat du SQL rédigé à la main | Coût par question, latence p50/p95 |
| Périmètre manquant | Taux de pertinence de la clarification | La question de relance cible-t-elle bien le périmètre réellement manquant | Apparition de cas « on pose la question alors qu’on n’aurait pas dû » |
| Données non répondables | Taux de refus correct | Aucun chiffre inventé | Nombre de réponses erronées |
| Attribution ouverte | Couverture des preuves, faux positifs et faux négatifs | Les preuves à l’appui et les explications alternatives sont-elles toutes vérifiées | Cohérence entre plusieurs réexécutions |
Le rapport Plotly ne donne que la durée médiane ; votre propre validation doit y ajouter le p95. L’expérience côté client est souvent plombée par une poignée de requêtes à longue traîne, et les questions exploratoires y sont particulièrement exposées. Côté coût, lisez le volume de sortie dans usage.output_tokens — les tokens de raisonnement figurent en général dans le sous-champ output_tokens_details.reasoning_tokens — puis combinez-le avec le volume de tokens lus depuis le cache pour calculer la dépense réelle par question.
4.3 Les limites du petit échantillon et des ré-exécutions
La règle cachée de Plotly ne repose que sur 5 questions. Avec un score de 2/5, l’intervalle de confiance est très large : sur un autre lot de questions, on pourrait tout aussi bien tomber sur 1/5 que sur 4/5. Lors des ré-exécutions d’autres modèles, on a observé des variations allant jusqu’à trois questions. Un écart de score total sur une seule passe ne suffit donc pas à choisir un modèle. Pour votre propre validation, faites tourner les questions exploratoires sur plusieurs passes, et alignez cinq variables : l’instantané de données, le jeu d’outils, le niveau de raisonnement du modèle, le canal d’appel et la grille de notation. Si l’une de ces variables change, les résultats d’avant et d’après ne sont plus comparables.
💡 Conseil de validation : le canal est la variable que l’on oublie le plus facilement. Les coûts de Plotly proviennent d’OpenRouter, alors que votre canal de production peut appliquer une facturation et une politique de cache différentes. Le plus simple est de ré-exécuter sur APIYI apiyi.com avec le même instantané de données, de recalculer le coût pour mille questions à partir de la facture réelle, puis de fixer le quota côté front.
4.4 Un livrable vérifiable
Le critère d’acceptation est le suivant : chaque résultat d’interrogation de données doit pouvoir être contrôlé de façon indépendante par une troisième personne. Voici à quoi ressemble un livrable conforme (données fictives) :
question: 按仓库列过去 7 天的退货率
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: 实物退回工单数(status = returned)
  denominator: 同期已签收订单数(排除测试单、内部单)
  time_range: 2026-11-13 ~ 2026-11-19,北京时间
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: 华东一仓, rate: 3.1%}, {warehouse: 华南二仓, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: 无需复核(固定口径问数)
Un livrable comporte la date des données, la définition de la métrique, la requête et le résultat. Côté front, l’étape d’interrogation de données avec GPT-6.2 Sol peut être validée à ce niveau. Une sortie dépourvue de ces éléments ne devrait pas entrer dans un rapport, même si le chiffre tombe juste par hasard. Pour dérouler ce processus dans votre propre entrepôt, vous pouvez partir de l’interface compatible OpenAI d’APIYI apiyi.com : commencez par mettre en ligne l’interrogation de données à définition figée, puis étendez progressivement à la clarification et à l’analyse des causes.
Références
- Plotly – Rapport spécial d’analyse de données sur GPT-6.2 Sol : résultats détaillés des 43 questions, comparaison des coûts et des temps d’exécution
- Lien :
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Lien :
- Plotly – Méthodologie de test DataAnalyticsBench : conception des types de questions, règles de notation et critères statistiques du classement
- Lien :
plotly.com/blog/introducing-dataanalyticsbench
- Lien :
- OpenAI – Fiche modèle GPT-6.2 Sol : fenêtre de contexte, prise en charge des endpoints et règles de facturation pour le contexte long
- Lien :
developers.openai.com/api/docs/models/gpt-6.2-sol
- Lien :
- OpenAI – Tarification de l’API : tarifs unitaires Standard pour l’entrée, le cache et la sortie
- Lien :
developers.openai.com/api/docs/pricing
- Lien :
- Endpoint public de tarification APIYI : expressions de calcul des prix de
gpt-6.2-solpour les paliers court et long- Lien :
api.apiyi.com/api/pricing
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com


