
本文用 Qwen4-Max 與 GPT-6 Luna 的同榜指標、長上下文報價和輸入模態做一輪大模型選型,把綜合分換成具體任務的驗收標準與成本判斷。
先說結論,再給條件。如果任務必須輸入視頻,按兩家模型卡只能先考慮 Qwen4-Max,GPT-6 Luna 不進入候選。如果是純文本或圖文任務,而且單次成本和調用量是硬約束,GPT-6 Luna 的標價低得多,值得作爲默認檔。如果是多步驟自動化這類高複雜任務,Qwen4-Max 在 Artificial Analysis 的部分分項上領先明顯,可以作爲高複雜度路由的候選。最終用哪一檔,要看你自己任務集上的驗收通過率和合格任務成本。
結論會被三個條件改變。第一,Luna 的推理檔位不同,指數分和任務成本差距可以從約 22 倍變成約 77 倍。第二,輸入超過 272,000 Token 時,Luna 按 OpenAI 標價整條請求升檔。第三,某個具體任務上的分項差距可能很小,例如 FrontierCode-AA 2.0 兩者只差 1.3 個百分點。
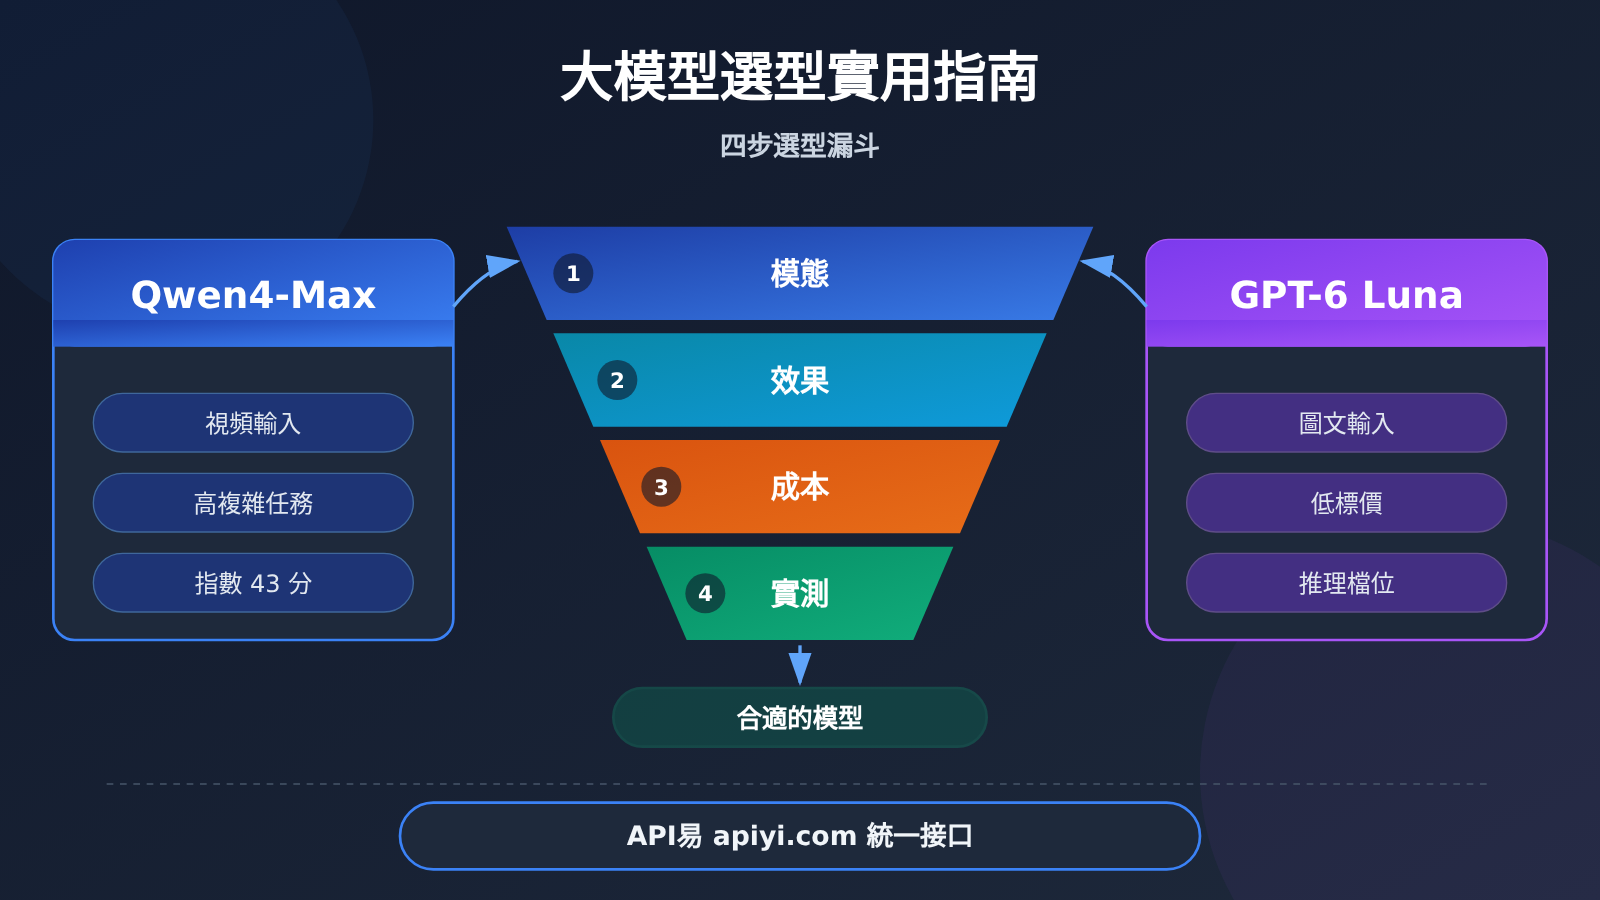
大模型選型對比速覽:Qwen4-Max 與 GPT-6 Luna
下表只列對選型有影響的維度。表中分數來自 Artificial Analysis 的 Intelligence Index v5.0.1,價格來自廠商公開標價或 API易 目錄,均爲本文覈驗日期 2026-11-20 時的公開信息,不是我們的付費實測。
| 對比維度 | Qwen4-Max | GPT-6 Luna | 差異意味着什麼 |
|---|---|---|---|
| 輸入模態(廠商模型卡) | 文本、圖像、視頻 | 文本、圖像 | 視頻任務直接淘汰 Luna |
| 輸出模態 | 文本 | 文本 | 兩者都不生成圖像或語音 |
| Intelligence Index v5.0.1 | 43 分 | Medium 檔 18 分;Max 檔 28 分 | 檔位不同,差距不同 |
| 指數任務成本 | $3.27 | Medium 檔 $0.0422;Max 檔 $0.15 | 只適用於該指數工作負載 |
| 廠商標價(每百萬 Token,短上下文) | 阿里雲新加坡:輸入 $1.50、輸出 $4.50 | OpenAI 標準:輸入 $0.10、輸出 $0.50 | 輸入約 15 比 1,輸出 9 比 1 |
| 長輸入計價 | 第三方資料稱全窗口統一費率 | 超過 272,000 Token 整條請求升檔 | 長文檔場景要單獨算 |
| API易 目錄端點 | chat、responses、messages | Chat Completions、Responses | 協議選擇會影響遷移成本 |
| 可用平臺 | API易 apiyi.com、阿里雲 Model Studio 等 | API易 apiyi.com、OpenAI 官方等 | 同一 Key 便於交替比測 |
正文按選型的依賴順序排列。第 1 節先確認能否接入,因爲模態或端點不滿足時,後面的分數和價格都沒有意義。第 2 節比較同一基準下的效果,第 3 節按同一用量拆開廠商價、目錄價和賬戶實付,第 4 節把前面的判斷變成可以在自己業務上覆測的步驟。只關心成本的讀者可以直接跳到第 3 節,但建議先看第 1 節的淘汰條件。
大模型選型需要先知道的術語(To Know)
| 術語 | 本文中的含義 |
|---|---|
| Intelligence Index | Artificial Analysis 在指定版本下對多項任務表現的彙總分,本文用 v5.0.1 |
| 指數任務成本 | 該基準中跑完一個任務的耗用估值,推理檔位和輸入輸出用量都會改變結果 |
| 推理檔位 | 控制模型投入的思考強度,例如 Luna 的 Medium 與 Max,比較時必須註明 |
| 輸入模態 | 模型接收的內容類型,例如文本、圖像或視頻 |
| 上下文階梯定價 | 輸入超過某個閾值後按另一套費率結算,需確認是只算超出部分還是整條請求 |
| 緩存讀取 | 複用已有輸入的計費項,應按價表及實際命中記錄統計 |
| 首個可見答案 Token 時延 | 從發出請求到出現第一段可用答案的時間,推理模型要和“首個事件”區分 |
| P50 / P95 | 時延分佈的中位數和 95 分位數,分別反映典型值和慢請求 |
| 合格任務成本 | 把失敗、複覈和重做的費用都攤到每一個實際達標結果上 |
1. 大模型選型第一步:按任務約束淘汰不合適的組合
選型最省錢的動作是先淘汰。模型分數再高,接不進你的輸入類型或調用協議,也只能放棄;反過來,便宜的模型如果在硬約束上不達標,後面也不必算成本。
1.1 用模型卡區分輸入模態
阿里雲 Model Studio 的模型卡列出 Qwen4-Max 接受文本、圖像、視頻輸入,輸出文本。OpenAI 的模型卡列出 GPT-6 Luna 接受文本、圖像輸入,輸出文本;OrcaRouter 的整理還提到,Luna 不支持圖像生成、語音生成、轉寫和翻譯。這是兩者最硬的一條差異,決定了視頻類任務只有 Qwen4-Max 一個候選。
需要注意的是,廠商模型卡說明的是模型本身的能力,具體到某個接入方、某個端點,視頻參數能否傳進去要另外核對。例如 Together AI 的型號頁明確列出了文本與圖像輸入,但沒有找到同一路由的視頻說明,此時只能寫“Together 已明確列出文本與圖像”,不能推出它支持視頻。
1.2 用 API易 目錄覈對 ID、分組和端點
API易 於 2026-11-17 公告上線 qwen4-max,2026-11-20 生成的公開模型註冊表列出其端點爲 chat、responses、messages,分組爲 ClaudeCode、CodexResponses、default、svip。gpt-6-luna 在價表中列有 Default、SVIP 分組及 Chat Completions、Responses 條目。早先博客裏“Qwen4-Max 暫未上架”的說法,以最新公告和註冊表爲準。
目錄只能證明平臺支持該模型和端點,賬號所在分組、令牌權限會影響你實際能否調用。建議在 API易 apiyi.com 控制檯創建令牌後,先用一條最小請求確認精確的模型 ID 和端點可用,再進入效果比較。
1.3 三個場景各自不可退讓的約束
| 場景 | 不可退讓的約束 | 淘汰結果 | 下一步重點 |
|---|---|---|---|
| 文本記錄整理(會議紀要、工單歸檔) | 輸出格式穩定、單次成本低、調用量大 | 兩者都可進入 | 比較格式通過率和單位成本 |
| 視頻理解(錄屏質檢、視頻摘要) | 必須接收視頻輸入 | 按模型卡淘汰 GPT-6 Luna | 覈對端點和令牌是否支持視頻參數 |
| 複雜流程(多步驟自動化、跨系統操作) | 多步執行成功率高,失敗代價大 | 兩者都可進入 | 以驗收通過率而非單價爲主 |
文本記錄整理是典型的成本敏感場景,任務本身不難,關鍵在於大批量調用時每條結果的平均花費。視頻理解則是能力門檻題,模態不匹配就沒有比較的必要。複雜流程的失敗往往意味着人工返工,便宜模型多失敗幾次,實際成本可能反而更高,這一點在第 3、4 節會具體算。
2. 大模型選型第二步:在同一基準下比較收益
完成淘汰後再看效果。這裏只用 Artificial Analysis 同一個發佈對比頁的數據,因爲不同榜單的任務集和打分方式不同,混在一起排名沒有意義。
2.1 綜合分與任務成本要連同檔位一起讀
| 配置 | Intelligence Index v5.0.1 | 指數任務成本 | 相對 Qwen4-Max 的成本倍數 |
|---|---|---|---|
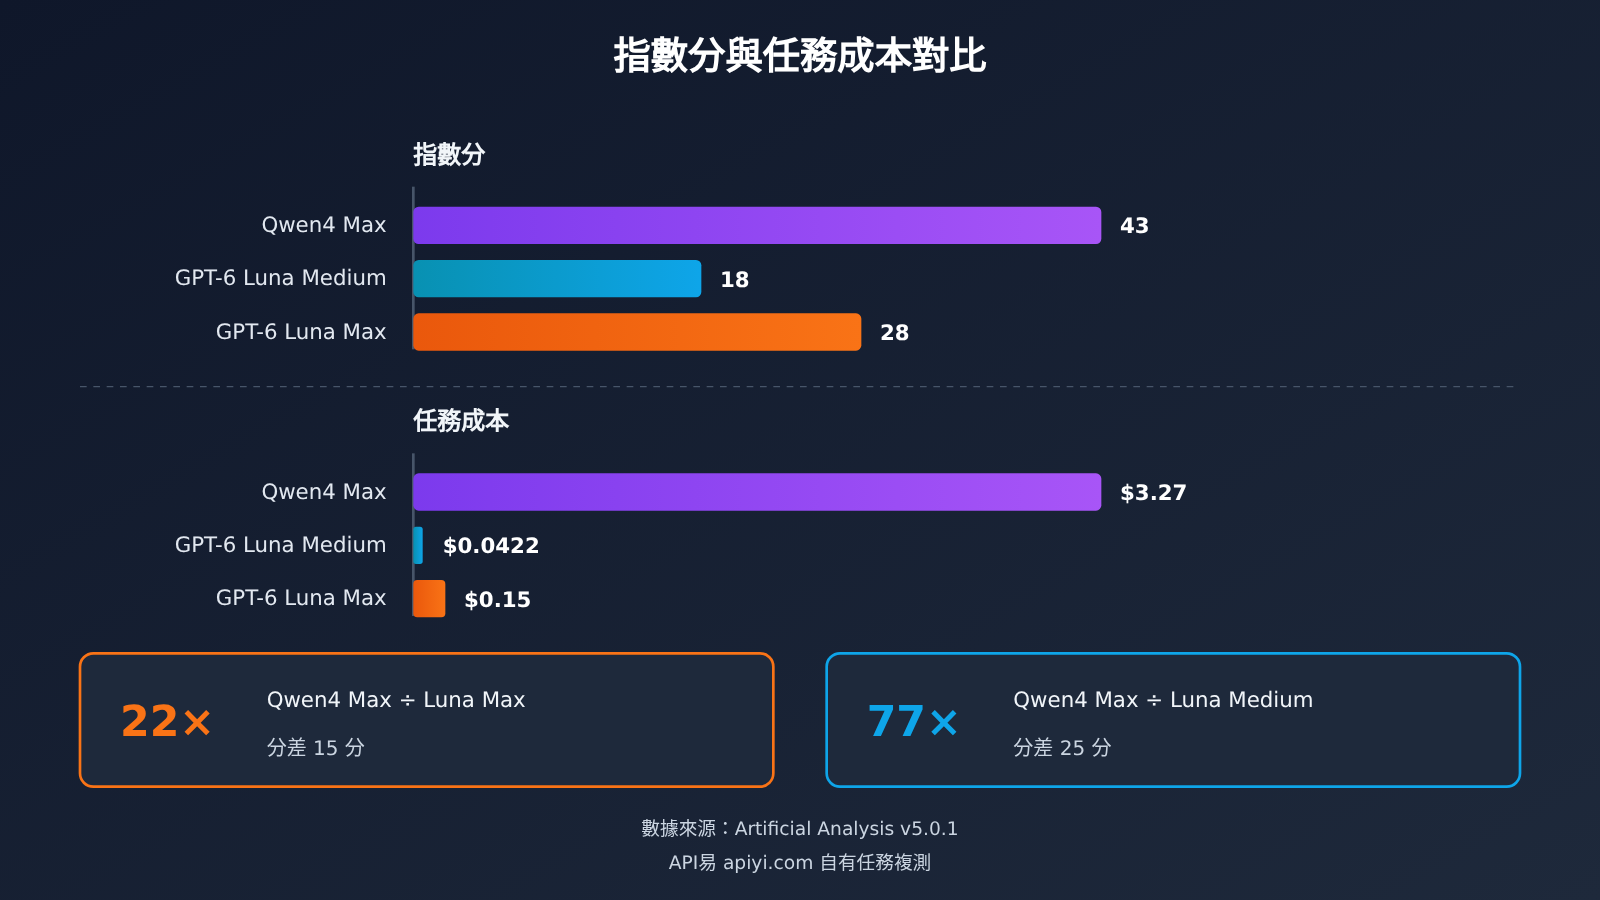
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna(Medium,默認檔) | 18 | $0.0422 | 約 1/77 |
| GPT-6 Luna(Max 檔) | 28 | $0.15 | 約 1/22 |
常被引用的“約 22 倍”來自 $3.27 ÷ $0.15,比較的是 Qwen4 Max 和 Luna 的 Max 檔,此時分差爲 15 分。如果拿 Luna 默認的 Medium 檔比較,成本倍數約 77 倍,分差爲 25 分。所以單說“貴 22 倍”並不完整,必須同時說明是哪個檔位、哪種工作負載。
另一個細節是數據完整度。OrcaRouter 指出,榜單隻公佈了 Qwen4-Max 的一個分數,沒有分檔位數據;Luna 則公開了完整的檔位階梯。做成本預測時,完整的階梯能看到“加檔位後分數還漲不漲”的拐點,這類信息有時比單個更高的分數更有用。
2.2 分項差距隨任務變化
綜合指數無法預測某個具體任務的收益。在 AutomationBench-AA 上,Qwen4 Max 爲 72.6%,Luna Max 爲 53.2%,相差約 19 個百分點;在 FrontierCode-AA 2.0 上,兩者分別爲 26.5% 和 25.2%,只差 1.3 個百分點。
放回第 1 節的場景裏看,複雜流程更接近 AutomationBench 這類多步自動化任務,Qwen4-Max 的領先可能轉化爲更少的返工。如果你的任務更接近 FrontierCode 這一類,兩者差距很小,而單價差距依然很大,Luna 的性價比就更突出。這只是方向性判斷,具體還要在你的任務集上驗證。
3. 大模型選型第三步:分開覈算廠商價、目錄價和賬戶費用
成本最容易被混在一起說。本節分三層:廠商公開標價、API易 目錄價,以及充值加贈後的賬戶實付。三者歸屬不同,不能互相替代。
3.1 同一長輸入請求的廠商標價算例
假設一次請求輸入 40 萬 Token,計費輸出 8,000 Token,沒有緩存命中,也沒有額外工具費用。
| 項目 | Qwen4-Max(阿里雲國際新加坡標準價) | GPT-6 Luna(OpenAI 標準價,長輸入) |
|---|---|---|
| 輸入費率 | $1.50 / 百萬 | $0.20 / 百萬(超過 272,000 整條升檔) |
| 輸出費率 | $4.50 / 百萬 | $0.75 / 百萬 |
| 算式 | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| 單次費用 | $0.636 | $0.086 |
兩者約爲 7.40 倍,比短上下文下 15 比 1 的輸入單價差小了一半,原因就在 Luna 的升檔規則。按 OpenAI 標價,長輸入升檔作用於整條請求,而不是隻對超出部分加價:30 萬 Token 的提示詞,30 萬全部按高費率計,不只是最後的 28,000。OrcaRouter 的整理稱 Qwen4-Max 在整個百萬窗口內按同一費率計費,沒有 32K 或 128K 檔位。
廠商價還會因地區和渠道變化。OrcaRouter 列出 Qwen4-Max 在 Global 區域的輸入爲 $1.413、輸出 $4.24,與新加坡不同。Together AI 官方 Pricing 頁把 Qwen4 Max 標爲促銷,限時價爲輸入 $1.05、輸出 $3.15、緩存讀取 $0.0525,恰好是新加坡價的七折,頁面註明有效至 2026-11-23 但沒有寫時區;它的型號詳情頁卻顯示另一檔 $1.43、$4.28、$0.0713。引用這類價格時要寫明來源頁面和日期,實際結算以賬號用量爲準。
3.2 API易 目錄價按目錄費率和用量日誌計算
API易 目錄中,qwen4-max 每百萬 Token 輸入 $1.50、輸出 $4.50、緩存讀取 $0.075;gpt-6-luna 短上下文輸入 $0.10、輸出 $0.50、緩存讀取 $0.01,價表註明輸入超過 272,000 Token 時輸入升爲 $0.20。
套用 3.1 的同一請求,qwen4-max 按目錄價同樣是 $0.636。gpt-6-luna 的輸入部分爲 0.4 × 0.20 = $0.08;本輪覈驗的價表只註明了輸入升檔,輸出部分在長上下文下按哪個費率計,請以當期價表和用量日誌爲準。真正的成本數字應來自你賬號裏的用量日誌,而不是上面的公式。
💰 成本覈算建議:在 API易 apiyi.com 的同一賬號下分別調用兩個模型,用量日誌會記錄每次請求的輸入、輸出和緩存 Token,比按公開標價推算更接近真實賬單。
3.3 充值加贈影響的是本金折算,不是模型單價
API易 現行 FAQ 列出單筆充值階梯:$100 到不足 $500 加贈 10%,$500 到不足 $1,000 加贈 12%,$1,000 到不足 $3,000 加贈 15%,$3,000 起加贈 20%。線上和對公充值都可參與,加贈自動發放;商務單獨調價能否疊加需另行確認。首次充值的普通用戶另贈 $1,學校郵箱認證的教育用戶爲 $2,需聯繫客服發放;充值餘額按文檔所列 365 天規則使用。
| 充值檔位 | 到賬餘額 | 日誌 $1 摺合充值本金 | 本金成本降低 |
|---|---|---|---|
| 單筆 $100 | $110 | 約 $0.909 | 約 9.09% |
| 單筆 $3,000 起 | 充值額 × 1.2 | 約 $0.833 | 約 16.67% |
這裏的前提是加贈餘額全部用完。按 10% 檔折算,3.1 中 $0.636 的單次日誌費用約對應 $0.578 的充值本金。要注意的是,加贈是對全站餘額統一生效的,它降低的是每 $1 日誌額度對應的本金,不能理解爲某個模型額外降價;做選型對比時,兩邊應使用同一折算係數,否則比較會失真。
4. 大模型選型第四步:把條件寫成可比測的步驟
前三節都是公開資料。真正決定選哪個模型的,是你自己的任務在同一條件下的通過率、時延和費用。目前我們沒有 API易 平臺上兩模型同任務、同分組的成功率、時延和賬單數據,下面給出可以自行執行的比測口徑。
4.1 控制變量與記錄字段
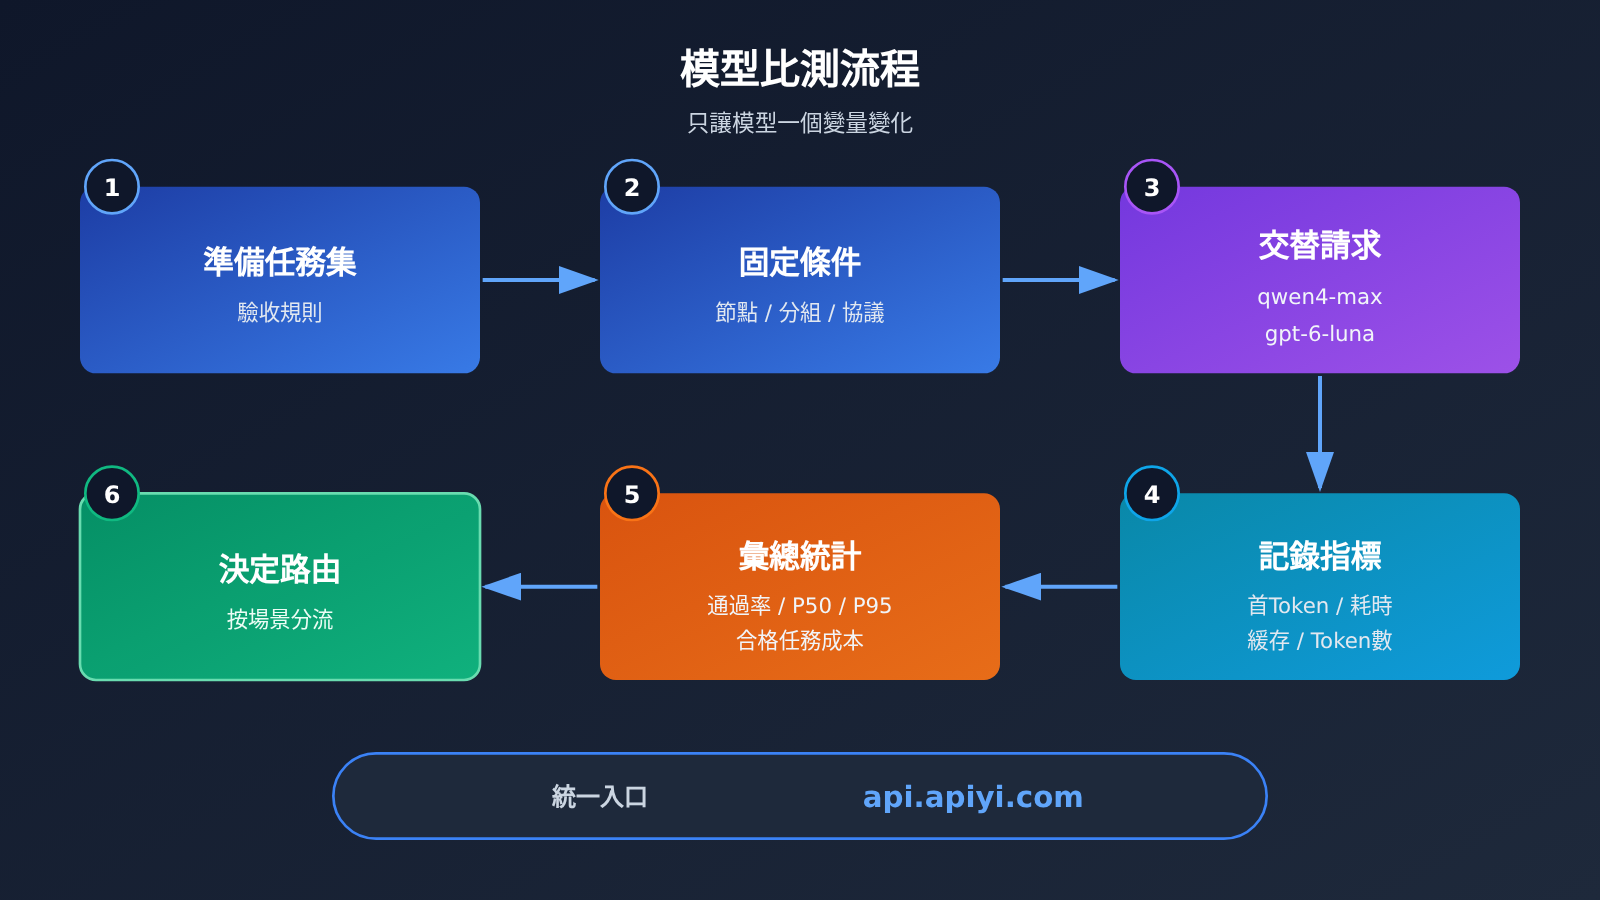
比測要儘量只讓“模型”這一個變量變化。具體做法是用同一個大陸節點和運營商、同一個 API易 分組和協議、同一輸入集和輸出上限,在相同併發下交替發起兩個模型的請求,避免先跑完一個再跑另一個導致的時段偏差。
| 記錄字段 | 用途 |
|---|---|
| 是否通過驗收 | 計算通過率和合格任務成本 |
| HTTP 狀態、請求 ID | 排查失敗,與用量日誌對賬 |
| 首個可見答案 Token 時延 | 衡量交互體驗,推理模型需與首事件分開 |
| 總耗時 | 衡量批處理吞吐 |
| 冷/熱連接、緩存命中 | 解釋時延和費用的波動 |
| 輸入、輸出 Token 數 | 覈對實際計費用量 |
DNS、TCP、TLS 的耗時最好單獨記錄。彙報時寫清樣本數、通過率、P50 和 P95;公開對外比較時,可以參照中國信通院報告中成功率、首詞時延和吞吐的定義。
4.2 交替比測的最小腳本
下面的腳本通過 OpenAI 兼容接口交替調用兩個模型,用流式輸出測量首個可見答案 Token 和總耗時。驗收函數需要按你的任務替換;推理檔位如需設置,請按 API易 文檔確認參數名後再加入,並在記錄中註明。
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,兩個模型共用一個 Key
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的會議記錄整理成 JSON:...", "..."]  # 替換爲你的任務集

def passed(task, answer):
    return answer.strip().startswith("{")  # 替換爲真實驗收規則

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # 交替請求,減少時段偏差
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # 兩個模型使用相同輸出上限
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # 首個可見答案 Token
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "樣本", n, "通過率", sum(r["ok"] for r in rs) / n,
          "首字P50", statistics.median(ttfts) if ttfts else None,
          "首字P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
Token 用量和費用建議直接從平臺用量日誌按請求 ID 彙總,再代入下面的公式。
4.3 合格任務成本與分級路由
合格任務成本 = 全部調用費用(含失敗與重試) + 人工複覈與返工成本,再除以最終通過驗收的任務數。單價低的模型如果通過率低,分母變小、分子變大,合格任務成本可能反超單價高的模型;反之,若兩者通過率接近,單價差會幾乎原樣體現在結果裏。
據此可以按任務複雜度分級路由:普通任務默認走 gpt-6-luna,高複雜任務或視頻任務走 qwen4-max。是否啓用某條路由,先看它在對應任務集上的驗收通過率是否達標,再看合格任務成本。由於兩個模型都在 API易 apiyi.com 的同一套 OpenAI 兼容接口下,切換路由只需要改 model 字段。
🎯 比測建議:新用戶可以先用 API易 apiyi.com 快速開始頁列出的註冊試用額度跑通腳本,再按任務集規模充值做正式比測。
4.4 入口探測數據只能說明測量邊界
靈簡AI 公開的監測表對 API易 域名做了大陸節點採樣,2026-11-05 至 11-06 的三條 HTTP 200 記錄耗時分別爲 429、569、565 ms。這類探測只反映入口連通,頁面還把部分 HTTP 404 計爲正常,且沒有說明請求負載和鑑權方式,因此不能用來推斷模型的生成時延或成功率。Artificial Analysis 的首 Token 時間也只代表它自己的測評環境,你的網絡和併發條件下的結果,需要用 4.1 的方法另測。
回到標題的問題:視頻輸入是硬門檻,滿足它只剩 Qwen4-Max;純文本和圖文任務裏,GPT-6 Luna 的標價優勢在短上下文下最大,輸入超過 272,000 Token 後會縮小;高複雜多步任務上 Qwen4-Max 的分項領先可能抵消單價差。三條結論都依賴檔位、輸入長度和任務類型,最終以你自己任務集上的合格任務成本爲準。需要統一入口做交替比測時,可以通過 API易 apiyi.com 用一個 Key 同時調用兩個模型。
參考資料
- Artificial Analysis – Qwen4 Max vs. GPT-6 Luna 發佈比較:Intelligence Index v5.0.1 及分項數據
- 鏈接:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- 鏈接:
- 阿里雲 Model Studio – Qwen4-Max 模型卡與價目表:輸入模態與新加坡標準價
- 鏈接:
alibabacloud.com/help/en/model-studio/model-pricing
- 鏈接:
- OpenAI – GPT-6 Luna Model:輸入模態與長上下文計價
- 鏈接:
developers.openai.com/api/docs/models/gpt-6-luna
- 鏈接:
- OrcaRouter – Qwen4-Max vs GPT-6 Luna:單價比例、272,000 Token 升檔說明
- 鏈接:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- 鏈接:
- Together AI – Pricing:Qwen4 Max 限時促銷價
- 鏈接:
together.ai/pricing
- 鏈接:
- API易 – 模型價格總表、模型註冊表與充值活動 FAQ:目錄價、端點分組與加贈階梯
- 鏈接:
docs.apiyi.com/models
- 鏈接:
- 中國信通院等 – 大模型詞元服務性能監測報告(2026年):成功率、首詞時延、吞吐定義
- 鏈接:
caict.ac.cn
- 鏈接:
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心


