
В этой статье мы сравниваем Qwen4-Max и GPT-6 Luna по показателям в одних и тех же рейтингах, ценам на длинный контекст и входным модальностям — то есть делаем очередной разбор выбора большой языковой модели и переводим общий балл в критерии приёмки и оценку стоимости для конкретных задач.
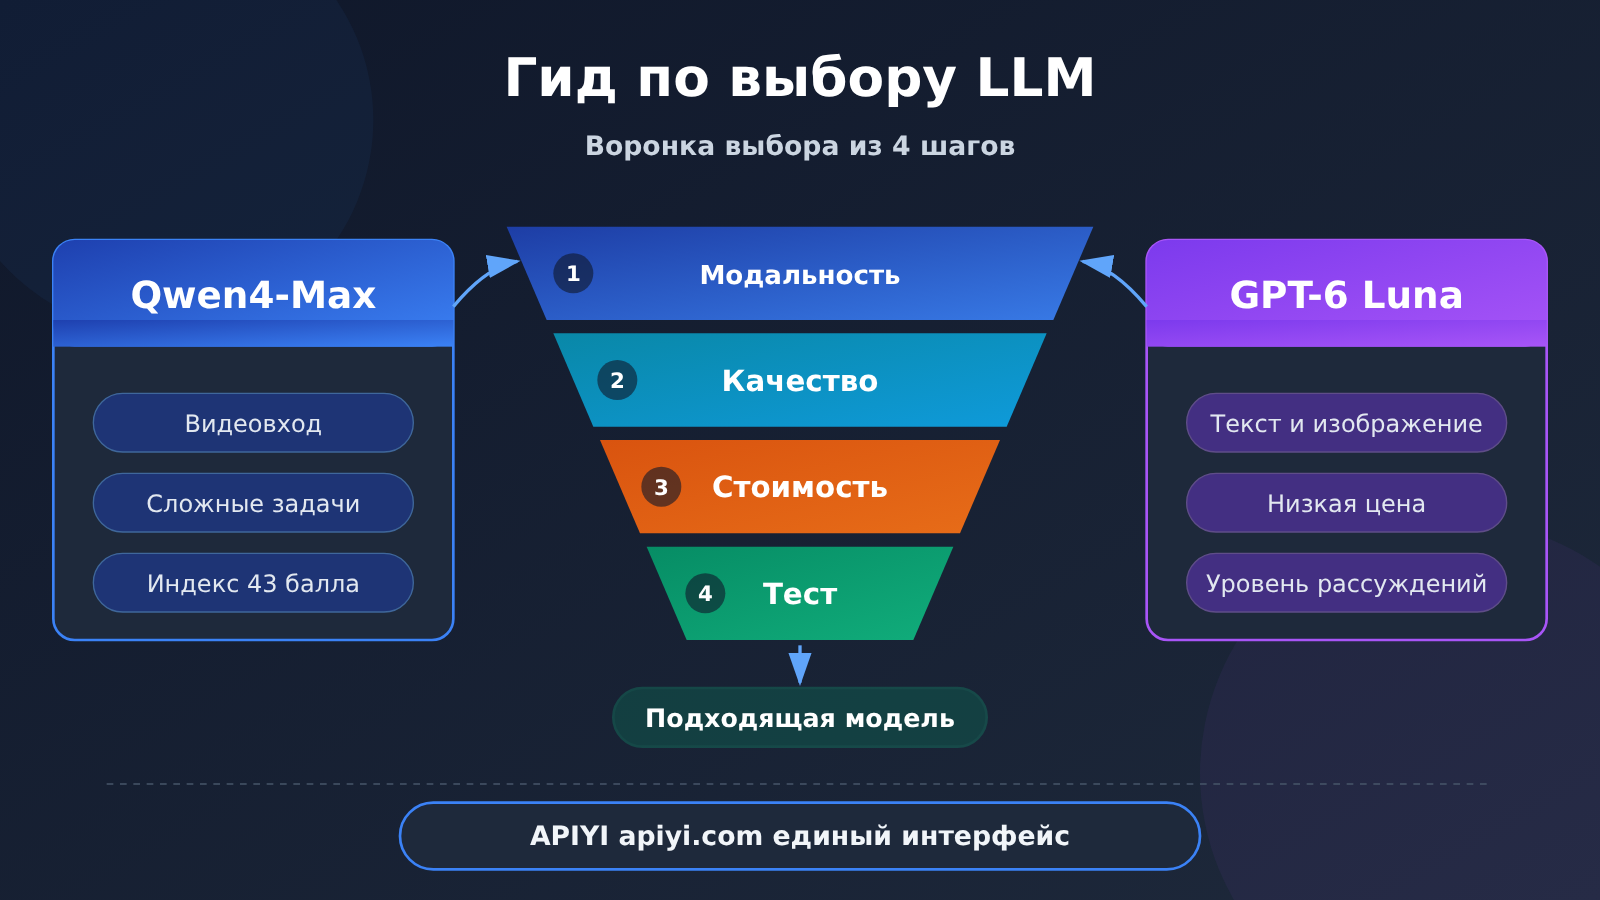
Сначала вывод, затем условия. Если задача требует подачи видео на вход, то по карточкам обеих моделей сначала можно рассматривать только Qwen4-Max — GPT-6 Luna в список кандидатов не попадает. Если задача чисто текстовая или включает текст и изображения, а стоимость одного вызова и объём вызовов — жёсткие ограничения, у GPT-6 Luna прайс заметно ниже, и её стоит взять как вариант по умолчанию. Если речь о высокосложной задаче вроде многошаговой автоматизации, Qwen4-Max заметно лидирует по некоторым отдельным метрикам в Artificial Analysis и может быть кандидатом для маршрутизации высокосложных запросов. Какой вариант в итоге выбрать, зависит от доли задач, прошедших приёмку, и стоимости выполнения одной принятой задачи на вашем собственном наборе задач.
Вывод могут изменить три условия. Во-первых, у Luna бывают разные уровни рассуждений, и разница по баллу индекса и стоимости задачи может вырасти с примерно 22-кратной до примерно 77-кратной. Во-вторых, если вход превышает 272,000 токенов, Luna по прайсу OpenAI переводит весь запрос на более высокий тариф. В-третьих, разрыв по отдельным метрикам на конкретной задаче может быть совсем небольшим — например, в FrontierCode-AA 2.0 между ними всего 1.3 процентного пункта.
Быстрый обзор выбора модели: Qwen4-Max против GPT-6 Luna
В таблице перечислены только те параметры, которые влияют на выбор. Оценки в таблице взяты из Intelligence Index v5.0.1 от Artificial Analysis, цены — из публичных прайс-листов производителей или из каталога APIYI. Все данные публичны по состоянию на дату проверки в этой статье, 2026-11-20, и не являются нашими платными тестами.
| Критерий сравнения | Qwen4-Max | GPT-6 Luna | Что означает разница |
|---|---|---|---|
| Входные модальности (карточка модели от производителя) | текст, изображения, видео | текст, изображения | задачи с видео сразу отсекают Luna |
| Выходные модальности | текст | текст | обе не генерируют изображения или речь |
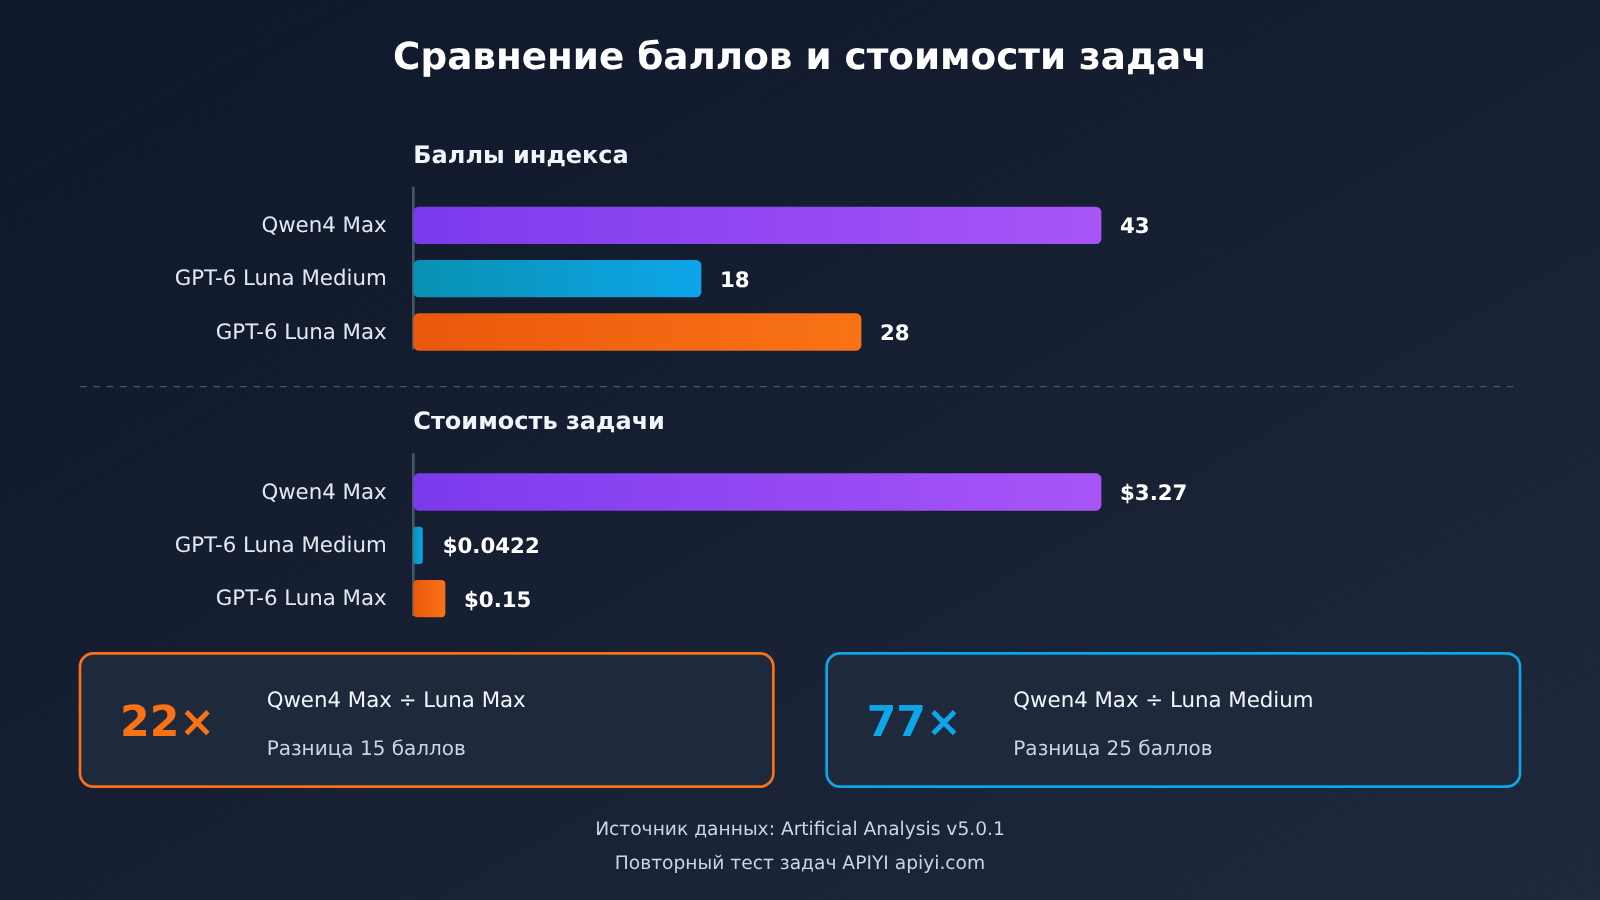
| Intelligence Index v5.0.1 | 43 балла | уровень Medium — 18 баллов; уровень Max — 28 баллов | уровни разные — и разрыв разный |
| Стоимость задачи в индексе | $3.27 | уровень Medium — $0.0422; уровень Max — $0.15 | применимо только к нагрузке этого индекса |
| Цены производителя (за миллион токенов, короткий контекст) | Alibaba Cloud Singapore: вход $1.50, выход $4.50 | OpenAI стандарт: вход $0.10, выход $0.50 | по входу примерно 15 к 1, по выходу 9 к 1 |
| Тарификация длинного входа | по данным третьих сторон — единый тариф на всё окно | при превышении 272 000 токенов весь запрос переходит на другой уровень | для сценариев с длинными документами считать отдельно |
| Эндпоинты в каталоге APIYI | chat, responses, messages | Chat Completions, Responses | выбор протокола влияет на стоимость миграции |
| Доступные платформы | APIYI apiyi.com, Alibaba Cloud Model Studio и др. | APIYI apiyi.com, официальный OpenAI и др. | один и тот же ключ удобен для попеременного сравнения |
Основной текст построен в порядке зависимостей при выборе. В разделе 1 сначала проверяем, можно ли вообще подключиться: если модальности или эндпоинты не подходят, дальнейшие оценки и цены теряют смысл. Раздел 2 сравнивает результаты на одном и том же бенчмарке, раздел 3 на одинаковом объёме использования раскладывает цену производителя, цену в каталоге и реальный платёж по счёту, а раздел 4 превращает предыдущие выводы в шаги, которые можно повторить на собственном бизнесе. Те, кого интересует только стоимость, могут сразу перейти к разделу 3, но советуем сначала посмотреть на условия отсева в разделе 1.
Термины, которые нужно знать перед выбором большой языковой модели
| Термин | Значение в этой статье |
|---|---|
| Intelligence Index | Сводный балл Artificial Analysis по набору задач в указанной версии; в этой статье используется v5.0.1 |
| Стоимость задачи в индексе | Оценка затрат на выполнение одной задачи в этом бенчмарке; на результат влияют уровень рассуждений и объём входных и выходных данных |
| Уровень рассуждений | Управляет интенсивностью размышлений модели, например Medium и Max у Luna; при сравнении его нужно обязательно указывать |
| Входные модальности | Типы контента, которые принимает модель: например, текст, изображения или видео |
| Ступенчатая тарификация по контексту | После превышения входными данными определённого порога применяется другой тариф; нужно уточнить, считается по нему только превышение или весь запрос |
| Чтение из кэша | Статья расходов за повторное использование уже имеющихся входных данных; считается по прайс-листу и фактическим попаданиям в кэш |
| Задержка до первого видимого токена ответа | Время от отправки запроса до появления первого пригодного фрагмента ответа; у моделей рассуждений это нужно отличать от «первого события» |
| P50 / P95 | Медиана и 95-й процентиль распределения задержки; показывают типичное значение и медленные запросы соответственно |
| Стоимость успешной задачи | Затраты на сбои, проверку и переделки распределяются на каждый фактически достигнутый результат |
1. Первый шаг при выборе большой языковой модели: отсеиваем неподходящие комбинации по ограничениям задачи
Самый экономный шаг при выборе — сначала отсеять. Даже если у модели высокая оценка, но она не подключается к вашему типу входных данных или протоколу вызова, её остаётся только отбросить; и наоборот, если дешёвая модель не проходит по жёстким ограничениям, дальше считать её стоимость смысла нет.
1.1. Различаем входные модальности по карточке модели
В карточке модели Alibaba Cloud Model Studio для Qwen4-Max указано, что на входе она принимает текст, изображения и видео, а на выходе выдаёт текст. В карточке модели OpenAI для GPT-6 Luna указано, что она принимает текст и изображения, а выдаёт текст; в обзоре OrcaRouter также упоминается, что Luna не поддерживает генерацию изображений, генерацию речи, транскрипцию и перевод. Это самое принципиальное различие между ними: для задач с видео кандидат только один — Qwen4-Max.
Важно: карточка модели от производителя описывает возможности самой модели. Но для конкретного провайдера и конкретного эндпоинта возможность передать параметры видео нужно проверять отдельно. Например, на странице модели Together AI явно указаны текстовый и графический ввод, но описания видео для того же маршрута найти не удалось. В таком случае можно написать только «Together явно указывает текст и изображения», но нельзя делать вывод, что он поддерживает видео.
1.2. Проверяем ID, группы и эндпоинты по каталогу APIYI
В объявлении APIYI от 2026-11-17 сообщается о запуске qwen4-max; в публичном реестре моделей, сформированном 2026-11-20, для неё указаны эндпоинты chat, responses, messages и группы ClaudeCode, CodexResponses, default, svip. Для gpt-6-luna в прайс-листе указаны группы Default, SVIP и строки Chat Completions, Responses. Что касается более раннего утверждения в блоге — «Qwen4-Max пока не добавлена в каталог», — ориентируйтесь на последнее объявление и реестр.
Каталог подтверждает только то, что платформа поддерживает эту модель и эндпоинты; группа аккаунта и права токена влияют на то, сможете ли вы фактически вызвать модель. Рекомендую в консоли APIYI (apiyi.com) создать токен, затем одним минимальным запросом проверить, что точный ID модели и эндпоинт доступны, и только после этого переходить к сравнению результатов.
1.3. Жёсткие ограничения в каждом из трёх сценариев
| Сценарий | Жёсткое ограничение | Результат отсева | На что смотреть дальше |
|---|---|---|---|
| Работа с текстовыми записями (протоколы встреч, архивирование тикетов) | Стабильный формат вывода, низкая стоимость одного вызова, большой объём вызовов | Оба варианта проходят | Сравнить долю успешных проверок формата и удельную стоимость |
| Понимание видео (проверка качества записи экрана, сводка по видео) | Обязательный приём видео на входе | GPT-6 Luna отсеивается по карточке модели | Проверить, поддерживают ли эндпоинт и токен параметры видео |
| Сложные процессы (многошаговая автоматизация, межсистемные операции) | Высокая доля успешных многошаговых выполнений, высокая цена ошибки | Оба варианта проходят | Ориентироваться на долю успешных приёмочных проверок, а не на цену за вызов |
Работа с текстовыми записями — типичный сценарий, чувствительный к стоимости: сама задача несложная, главное — средние затраты на один результат при массовых вызовах. Понимание видео — это вопрос порога возможностей: если модальность не совпадает, сравнивать нечего. Неудача в сложном процессе обычно означает ручную переделку; если дешёвая модель ошибается на несколько раз больше, реальная стоимость может оказаться выше. Это мы конкретно посчитаем в разделах 3 и 4.
2. Второй шаг выбора большой языковой модели: сравнение выгоды на одном и том же бенчмарке
После отсева смотрим на результат. Здесь используются только данные с одной и той же страницы сравнения Artificial Analysis — потому что у разных рейтингов различаются наборы задач и способы оценки, и смешивать их в одном рейтинге бессмысленно.
2.1 Сводный балл и стоимость задачи нужно читать вместе с уровнем
| Конфигурация | Intelligence Index v5.0.1 | Стоимость задачи в индексе | Кратность стоимости относительно Qwen4-Max |
|---|---|---|---|
| Qwen4 Max | 43 | $3.27 | 1 |
| GPT-6 Luna (Medium, уровень по умолчанию) | 18 | $0.0422 | ≈ 1/77 |
| GPT-6 Luna (уровень Max) | 28 | $0.15 | ≈ 1/22 |
Часто цитируемые «примерно 22 раза» получаются из $3.27 ÷ $0.15 — то есть сравниваются Qwen4 Max и уровень Max у Luna, и разница в баллах при этом составляет 15 баллов. Если же сравнивать с уровнем Medium по умолчанию у Luna, кратность стоимости будет около 77 раз, а разница в баллах — 25. Поэтому фраза «дороже в 22 раза» сама по себе неполна: обязательно указывать, о каком уровне и о какой нагрузке идёт речь.
Ещё одна деталь — полнота данных. OrcaRouter отмечает: в рейтинге опубликован только один результат Qwen4-Max, без данных по уровням; у Luna, наоборот, раскрыта полная лестница уровней. При прогнозировании затрат полная лестница позволяет увидеть точку перегиба — «растёт ли балл дальше при повышении уровня». Иногда такая информация полезнее, чем один более высокий балл.
2.2 Разрывы по отдельным метрикам зависят от задачи
Сводный индекс не позволяет предсказать выгоду в конкретной задаче. В AutomationBench-AA у Qwen4 Max — 72.6%, у Luna Max — 53.2%, разница около 19 процентных пунктов; в FrontierCode-AA 2.0 у них 26.5% и 25.2% соответственно, разница всего 1.3 процентного пункта.
Если вернуться к сценариям из раздела 1, то сложные процессы ближе к многошаговым задачам автоматизации вроде AutomationBench, и преимущество Qwen4-Max может обернуться меньшим числом переделок. Если ваши задачи ближе к категории FrontierCode, разрыв между моделями невелик, а разница в цене за токен по-прежнему огромна — тогда соотношение цены и качества у Luna выглядит заметно выгоднее. Это лишь ориентировочная оценка, конкретику нужно проверять на вашем собственном наборе задач.
3. Выбор большой языковой модели, шаг третий: раздельный учёт цен производителя, каталожных цен и расходов по счёту
Стоимость чаще всего сваливают в одну кучу. В этом разделе три уровня: публичный прайс производителя, каталожная цена APIYI и фактическая сумма по счёту после пополнения с бонусом. Это разные вещи, и подменять одно другим нельзя.
3.1 Пример расчёта по прайсу производителя для одного запроса с длинным вводом
Допустим, один запрос: 400 000 токенов на входе, 8 000 токенов на выходе, без попаданий в кэш и без платы за дополнительные инструменты.
| Параметр | Qwen4-Max (стандартная цена Alibaba Cloud International, Сингапур) | GPT-6 Luna (стандартная цена OpenAI, длинный ввод) |
|---|---|---|
| Тариф за ввод | $1.50 / млн | $0.20 / млн (свыше 272,000 — тариф повышается на весь запрос) |
| Тариф за вывод | $4.50 / млн | $0.75 / млн |
| Формула | 0.4 × 1.50 + 0.008 × 4.50 | 0.4 × 0.20 + 0.008 × 0.75 |
| Стоимость одного запроса | $0.636 | $0.086 |
Разница — примерно 7.40 раза, то есть почти вдвое меньше, чем 15-кратный разрыв в цене за ввод при коротком контексте. Причина именно в правиле повышения тарифа у Luna. По прайсу OpenAI повышение тарифа при длинном вводе применяется ко всему запросу, а не только к превышающей части: для промпта в 300 000 токенов все 300 000 считаются по высокому тарифу, а не только последние 28,000. В подборке OrcaRouter указано, что Qwen4-Max тарифицируется по единой ставке на всём миллионном окне, без уровней 32K или 128K.
Цены производителя также зависят от региона и канала. OrcaRouter указывает для Qwen4-Max в регионе Global ввод $1.413 и вывод $4.24 — не так, как в Сингапуре. На официальной странице Pricing у Together AI модель Qwen4 Max помечена как акционная: ограниченное по времени предложение — ввод $1.05, вывод $3.15, чтение из кэша $0.0525, что ровно 70% от сингапурской цены. На странице отмечено, что предложение действует до 2026-11-23, но часовой пояс не указан; при этом на странице с описанием модели фигурируют другие цифры: $1.43, $4.28, $0.0713. Когда ссылаетесь на такие цены, указывайте страницу-источник и дату: фактический расчёт идёт по фактическому потреблению вашего аккаунта.
3.2 Каталожные цены APIYI: считаем по тарифам каталога и журналу использования
В каталоге APIYI qwen4-max стоит $1.50 за миллион входных токенов, $4.50 за выходные и $0.075 за чтение из кэша; gpt-6-luna — $0.10 за вход, $0.50 за выход и $0.01 за чтение из кэша при коротком контексте, причём в прайс-листе указано: если вход превышает 272,000 токенов, цена входа поднимается до $0.20.
Берём тот же запрос, что и в 3.1: у qwen4-max по каталожной цене получается те же $0.636. У gpt-6-luna входная часть — 0.4 × 0.20 = $0.08; прайс-лист, который проверяли в этом раунде, оговаривает только повышение тарифа на вход, а по какому тарифу считается выходная часть при длинном контексте — смотрите в актуальном прайс-листе и журнале использования. Настоящие цифры затрат должны браться из журнала использования в вашем аккаунте, а не из формул выше.
💰 Совет по расчёту затрат: вызовите обе модели из одного и того же аккаунта на APIYI apiyi.com — журнал использования фиксирует входные, выходные и кэшированные токены каждого запроса, и это ближе к реальному счёту, чем расчёт по опубликованным ценам.
3.3 Бонус за пополнение влияет на пересчёт вложенной суммы, а не на цену модели
В актуальном FAQ APIYI перечислены ступени бонуса за одно пополнение: от $100 до менее $500 — +10%, от $500 до менее $1,000 — +12%, от $1,000 до менее $3,000 — +15%, от $3,000 — +20%. Участвуют и онлайн-пополнения, и пополнения по безналичному расчёту, бонус начисляется автоматически; можно ли суммировать его с индивидуальной корректировкой цены от отдела продаж — нужно уточнять отдельно. Обычным пользователям за первое пополнение дополнительно дают $1, образовательным пользователям с подтверждённой почтой учебного заведения — $2, начисляет служба поддержки по обращению; бонусный баланс используется по правилам 365 дней, указанным в документации.
| Ступень пополнения | Баланс к зачислению | $1 в журнале в пересчёте на вложенную сумму | Снижение стоимости вложений |
|---|---|---|---|
| Одно пополнение $100 | $110 | около $0.909 | около 9.09% |
| Одно пополнение от $3,000 | сумма пополнения × 1.2 | около $0.833 | около 16.67% |
Здесь предполагается, что бонусный баланс израсходован полностью. При пересчёте по ступени 10% разовая стоимость $0.636 из журнала в 3.1 соответствует примерно $0.578 вложенных средств. Важно: бонус действует единообразно на весь баланс, он снижает вложенную сумму, соответствующую каждому $1 в журнале, и это не стоит понимать как дополнительную скидку на конкретную модель. При сравнении вариантов применяйте к обеим сторонам один и тот же коэффициент пересчёта, иначе сравнение будет искажено.
4. Четвёртый шаг выбора большой языковой модели: превращаем условия в сопоставимые для тестирования шаги
Первые три раздела опираются на открытые данные. Что действительно определяет выбор модели — это процент прохождения, задержка и стоимость именно вашей задачи в одинаковых условиях. Сейчас у нас нет данных о проценте успеха, задержке и счетах для двух моделей на одной задаче и в одной группе на платформе APIYI, поэтому ниже приведён подход к сравнительному тестированию, который вы можете выполнить самостоятельно.
4.1 Контроль переменных и поля записи
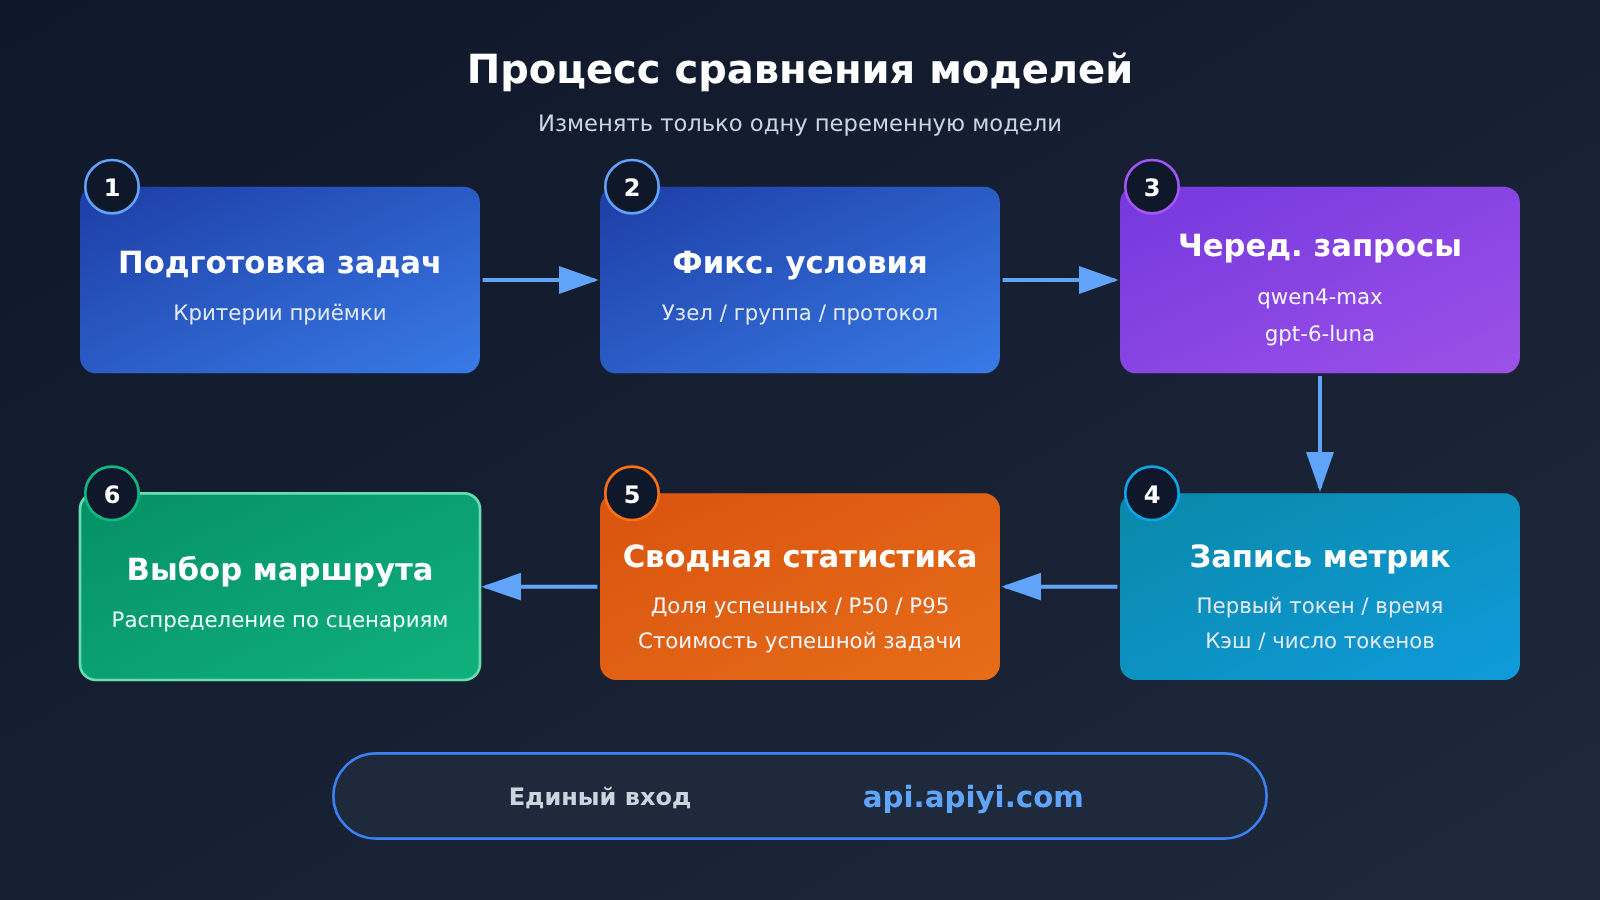
При сравнительном тестировании нужно стараться менять только одну переменную — «модель». Конкретно: использовать один и тот же материковый узел и оператора связи, одну и ту же группу и протокол APIYI, один и тот же набор входных данных и лимит вывода, и при одинаковой конкурентности поочерёдно отправлять запросы к обеим моделям. Так вы избежите смещения по времени суток, которое возникает, если сначала полностью прогнать один модель, а потом другой.
| Поле записи | Назначение |
|---|---|
| Пройдено ли приёмочное тестирование | Расчёт процента успеха и стоимости качественно выполненной задачи |
| HTTP-статус, ID запроса | Диагностика сбоев, сверка с журналом использования |
| Задержка до первого видимого токена ответа | Оценка интерактивного опыта; для reasoning-моделей нужно отделять от первого события |
| Общее время выполнения | Оценка пропускной способности пакетной обработки |
| Холодное/тёплое соединение, попадание в кэш | Объяснение колебаний задержки и стоимости |
| Число входных и выходных токенов | Сверка фактического объёма тарификации |
Затраты по DNS, TCP и TLS лучше записывать отдельно. В отчёте указывайте размер выборки, процент успеха, P50 и P95. При публичном внешнем сравнении можно опираться на определения процента успеха, задержки до первого слова и пропускной способности из отчёта Академии информационных и коммуникационных технологий Китая (CAICT).
4.2 Минимальный скрипт для поочерёдного сравнительного тестирования
Скрипт ниже поочерёдно вызывает две модели через OpenAI-совместимый интерфейс и с помощью потокового вывода измеряет время до первого видимого токена ответа и общее время. Функцию проверки нужно заменить под вашу задачу; если нужно задать уровень рассуждений, сначала уточните имя параметра в документации APIYI, затем добавьте его и укажите в записях.
import time, statistics, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI, обе модели используют один API-ключ
)

MODELS = ["qwen4-max", "gpt-6-luna"]
TASKS = ["把下面的会议记录整理成 JSON:...", "..."]  # замените на свой набор задач

def passed(task, answer):
    return answer.strip().startswith("{")  # замените на реальное правило проверки

records = {m: [] for m in MODELS}
for task in TASKS:
    for model in MODELS:  # поочерёдные запросы, чтобы уменьшить смещение по времени
        start, first = time.perf_counter(), None
        text = ""
        stream = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": task}],
            max_tokens=2000,  # одинаковая верхняя граница вывода для обеих моделей
            stream=True,
        )
        for chunk in stream:
            if chunk.choices and chunk.choices[0].delta.content:
                if first is None:
                    first = time.perf_counter() - start  # первый видимый токен ответа
                text += chunk.choices[0].delta.content
        total = time.perf_counter() - start
        records[model].append({"ok": passed(task, text), "ttft": first, "total": total})

for m, rs in records.items():
    ttfts = sorted(r["ttft"] for r in rs if r["ttft"] is not None)
    n = len(rs)
    print(m, "样本", n, "通过率", sum(r["ok"] for r in rs) / n,
          "首字P50", statistics.median(ttfts) if ttfts else None,
          "首字P95", ttfts[int(0.95 * (len(ttfts) - 1))] if ttfts else None)
Расход токенов и стоимость рекомендуется汇总 напрямую из журнала использования платформы по ID запроса, а затем подставить в формулу ниже.
4.3 Стоимость принятой задачи и маршрутизация по уровням сложности
Стоимость принятой задачи = все расходы на вызовы (включая неудачные и повторные) + затраты на ручную проверку и доработку, затем делим на число задач, которые в итоге прошли приёмку. Если у модели с низкой ценой за вызов низкая доля прохождения приёмки, знаменатель уменьшается, а числитель растёт — и стоимость принятой задачи может оказаться выше, чем у модели с более высокой ценой. Наоборот, если доли прохождения близки, разница в цене за вызов почти без изменений отразится в результате.
На этом основании можно маршрутизировать задачи по сложности: обычные задачи по умолчанию идут через gpt-6-luna, а особо сложные задачи или видеозадачи — через qwen4-max. Прежде чем включать маршрут, проверьте, достигает ли он нужной доли прохождения приёмки на соответствующем наборе задач, а затем смотрите на стоимость принятой задачи. Поскольку обе модели доступны через один и тот же OpenAI-совместимый интерфейс APIYI apiyi.com, для переключения маршрута достаточно изменить поле model.
🎯 Совет по сравнительному тестированию: новым пользователям стоит сначала прогнать скрипт на пробном кредите, который указан на странице быстрого старта APIYI apiyi.com, а затем пополнить баланс под размер набора задач и провести полноценное сравнительное тестирование.
4.4 Данные зондирования точки входа говорят только о границах измерения
В опубликованной Lingjian AI таблице мониторинга есть выборка с узлов в материковом Китае для домена APIYI: три записи HTTP 200 за 2026-11-05 — 11-06 показали время отклика 429, 569 и 565 мс соответственно. Такое зондирование отражает только доступность точки входа; кроме того, на странице часть ответов HTTP 404 считается нормальной, а нагрузка запроса и способ аутентификации не указаны. Поэтому по этим данным нельзя судить о задержке генерации или доле успешных вызовов модели. Время до первого токена (TTFT) у Artificial Analysis тоже отражает только его собственную среду тестирования; результаты в вашей сети и при вашей параллельной нагрузке нужно измерять отдельно методами из раздела 4.1.
Возвращаясь к вопросу из заголовка: видеовход — жёсткое требование, и ему соответствует только Qwen4-Max; в чисто текстовых задачах и задачах с текстом и изображениями преимущество GPT-6 Luna в прейскурантной цене максимально на коротком контексте, а после превышения 272 000 токенов на входе оно сокращается; на особо сложных многошаговых задачах преимущество Qwen4-Max по отдельным показателям может компенсировать разницу в цене за вызов. Все три вывода зависят от тарифного уровня, длины входа и типа задачи, поэтому в итоге ориентируйтесь на стоимость принятой задачи в вашем собственном наборе задач. Если нужно поочерёдно сравнивать модели через единую точку входа, можно через APIYI apiyi.com вызывать обе модели одним ключом.
Источники
- Artificial Analysis — сравнение релизов Qwen4 Max и GPT-6 Luna: Intelligence Index v5.0.1 и данные по отдельным категориям
- Ссылка:
artificialanalysis.ai/zh/models/comparisons/qwen4-max-vs-gpt-6-luna
- Ссылка:
- Alibaba Cloud Model Studio — карточка модели Qwen4-Max и прайс-лист: входные модальности и стандартные цены в Сингапуре
- Ссылка:
alibabacloud.com/help/en/model-studio/model-pricing
- Ссылка:
- OpenAI — модель GPT-6 Luna: входные модальности и тарификация длинного контекста
- Ссылка:
developers.openai.com/api/docs/models/gpt-6-luna
- Ссылка:
- OrcaRouter — Qwen4-Max vs GPT-6 Luna: соотношение цен за единицу, пояснение про переход на тариф с 272 000 токенов
- Ссылка:
orcarouter.ai/blog/qwen-4-max-vs-gpt-6-luna
- Ссылка:
- Together AI — Pricing: промо-цена на Qwen4 Max с ограниченным сроком действия
- Ссылка:
together.ai/pricing
- Ссылка:
- APIYI — сводная таблица цен на модели, реестр моделей и FAQ по акциям пополнения: каталожные цены, группировка эндпоинтов и уровни бонусных начислений
- Ссылка:
docs.apiyi.com/models
- Ссылка:
- CAICT и др. — отчёт о мониторинге производительности токенных сервисов больших языковых моделей (2026): определения успешного запроса, задержки первого токена и пропускной способности
- Ссылка:
caict.ac.cn
- Ссылка:
Автор: техническая команда APIYI
Обсуждение технологий: свяжитесь с нами на главной странице сайта APIYI apiyi.com; больше материалов по подключению — в центре документации docs.apiyi.com


