
Les agents d’entreprise n’ont pas besoin de réinvoquer le grand modèle de langage à chaque fois qu’ils exécutent une tâche répétitive. Le CUA Agent Kit open source de CVS Health propose une voie d’ingénierie plus économique : laisser d’abord un Computer-use Agent explorer un processus métier inconnu et enregistrer son déroulement réussi sous forme de captures d’écran, d’événements et de Trace ; puis demander à Codex de transformer ces preuves en code déterministe, vérifiable, maintenable et réexécutable.
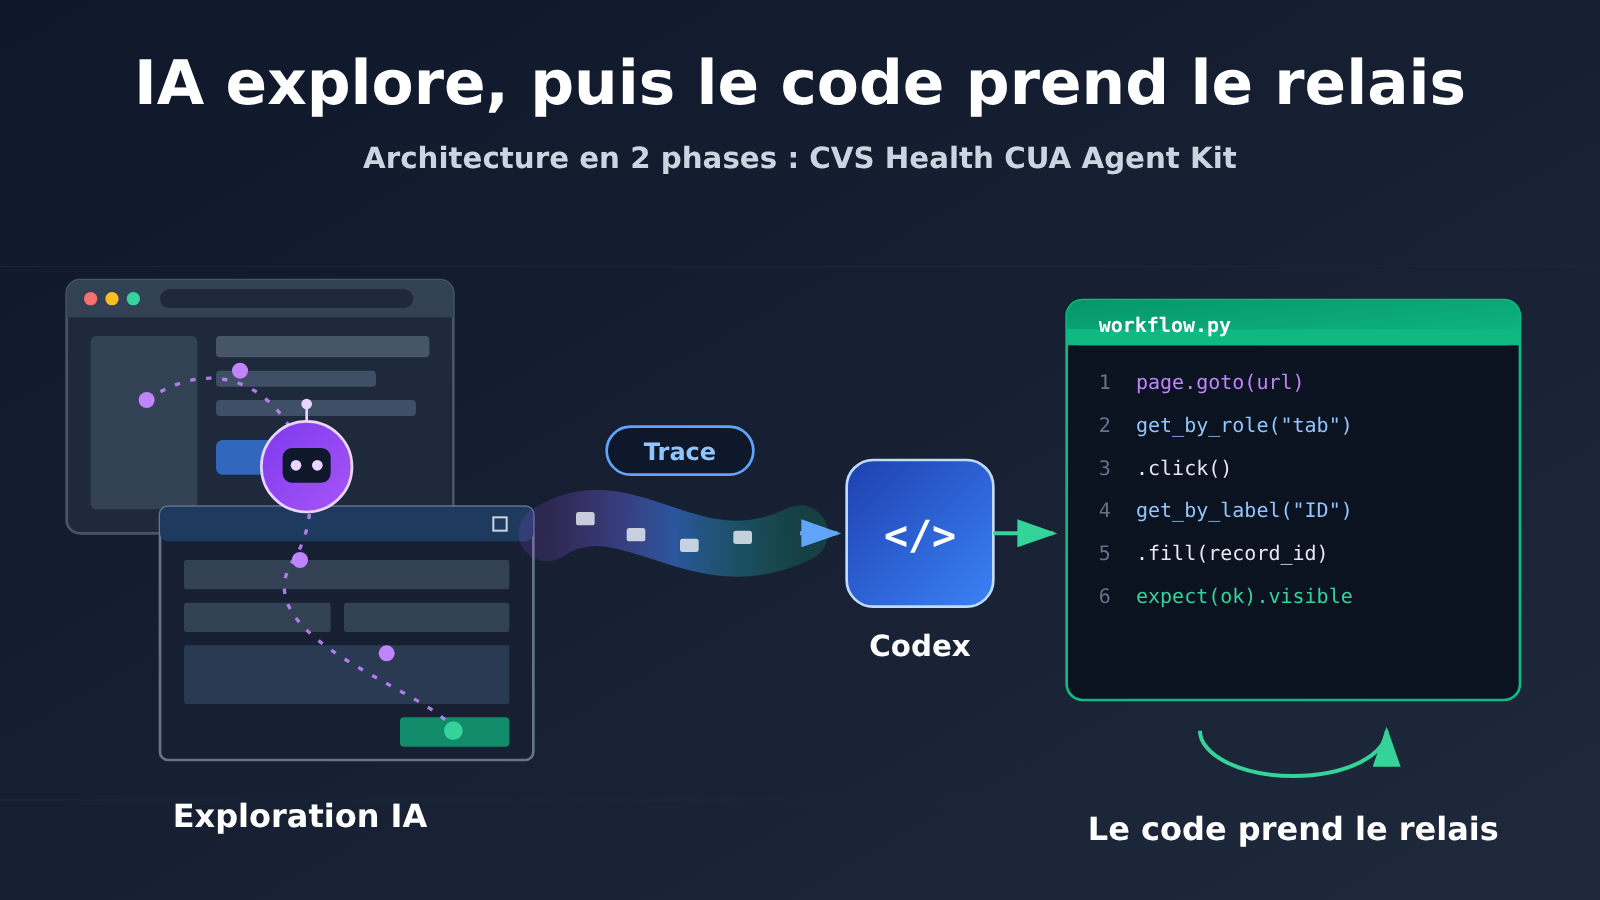
Cette approche combine la capacité d’exploration flexible de l’IA et la stabilité d’exécution de l’automatisation traditionnelle pour former une architecture hybride : « l’IA explore, le code consolide, la maintenance se poursuit ». Elle ne cherche pas à faire remplacer les scripts par un agent, mais à confier à l’agent l’écriture et la réparation des scripts.
Ce que vous allez découvrir dans cet article
- Comment le CUA Agent Kit de CVS Health mène le processus en deux phases, de l’exploration par l’IA à la consolidation dans le code
- Le rôle respectif des captures d’écran, de
events.jsonl, de la Trace et des localisateurs sémantiques dans la phase de consolidation - Comment un processus figé peut s’exécuter sans invoquer le grand modèle de langage, et comment le maintenir après une anomalie
La partie factuelle qui suit présente dans l’ordre : le mécanisme de fonctionnement du CUA Agent Kit, ce qui se joue entre l’opération par l’IA et le code Playwright, les tâches de maintenance dont l’agent reste chargé après la consolidation, les différences entre cette architecture et le RPA traditionnel — avec les éléments de recherche à l’appui —, ainsi que la manière dont les développeurs peuvent réutiliser le kit en pratique. La partie analyse revient ensuite sur deux questions : pourquoi le fait, pour un agent, de repenser depuis zéro à chaque fois constitue un gaspillage, et quels types de tâches sont adaptés à cette architecture hybride, tandis que d’autres doivent impérativement conserver une validation humaine.
À savoir : comprendre la feuille de route d’automatisation de CVS Agent en 7 concepts
| Concept | Explication en bref |
|---|---|
| Computer Use | Capacité à accomplir une tâche en observant l’interface d’un logiciel puis en effectuant des clics et des saisies |
| EHR | Système de dossier de santé électronique : le logiciel central grâce auquel les établissements de santé stockent et traitent les dossiers médicaux des patients |
| MCP | Protocole standard permettant de découvrir et d’appeler des outils externes |
| RPA | Approche d’automatisation qui exécute des processus répétitifs via des règles ou des programmes préconfigurés |
| Rubric points | Points de notation découpés selon les règles d’évaluation, qui mesurent le degré d’atteinte de chaque exigence partielle |
| Taux de réussite de bout en bout | Proportion de tâches complètes qui remplissent l’ensemble des conditions de succès |
| Trace | Preuve de parcours qui enregistre le déroulement de l’exécution, les opérations effectuées et l’état des pages |
Aperçu des impacts : qui est concerné par la feuille de route d’automatisation de CVS Agent
- Développeurs et responsables techniques : la question n’est pas de savoir « faut-il utiliser un Agent ou non », mais de découper les mécanismes d’exécution en fonction de la tâche. Il faut vérifier séparément le taux de complétion de la phase d’exploration, la stabilité du code figé, ainsi que le coût complet, maintenance incluse — et non se contenter du prix d’un seul appel de modèle.
- Établissements de santé et responsables des flux de travail : il convient de distinguer les démonstrations synthétiques, les évaluations de fournisseurs, les cas rendus publics par des entreprises et les pilotes menés chez soi : ces types de preuves n’ont pas le même poids. Pour les étapes qui touchent aux données des patients et à la modification d’états, il faut mettre en place à l’avance la validation humaine, le principe du moindre privilège et la traçabilité des opérations.
Faits objectifs : la feuille de route en deux phases du CUA Agent Kit de CVS Health
Commençons par planter le décor. Le 16 novembre 2026, OpenAI a publié des avancées sur les agents Computer-use destinés aux équipes médicales, en rendant publics les résultats d’évaluation sur des tâches cliniques et administratives de santé, ainsi que des retours d’expérience menés avec CVS Health, Cigna Healthcare, Abridge, Ambience et d’autres organisations. CVS Health y a dévoilé un cas d’usage en environnement de production et a open-sourcé le CUA Agent Kit, sous licence Apache-2.0.
Parmi les résultats de production rendus publics par CVS Health : dans un flux de travail donné, un agent a résorbé en un week-end un arriéré de tâches d’envoi de documents qui traînait depuis plusieurs mois ; un autre agent traite chaque jour des dizaines de milliers d’étapes d’opérations système liées aux consultations de spécialistes. Le système intègre des contrôles de validation et une supervision humaine, et vérifie l’état réel des opérations et des applications au moyen de captures d’écran et de journaux d’actions. À noter : ce sont là des données divulguées par l’entreprise elle-même. Le chiffre de « dizaines de milliers » désigne les étapes d’opérations système liées aux consultations, et non des dizaines de milliers de décisions cliniques prises de façon autonome par l’IA. Les documents publics ne précisent pas non plus si ces agents de production reposent intégralement sur la version open source de l’Agent Kit : il ne faut donc pas mettre directement un signe d’égalité entre les deux.
Source : openai.com/index/advancing-computer-use-for-healthcare-teams/
Comment fonctionne le CUA Agent Kit de CVS Health ?
Le README du projet est on ne peut plus clair sur sa vocation : c’est une boîte à outils de démarrage pour automatiser les navigateurs et les workflows Windows, où l’IA sert à découvrir les étapes et le code à les rejouer. Le projet insiste particulièrement sur un point : « comprendre comment faire une tâche » et « la répéter de façon stable sur la durée » sont deux problèmes différents, qu’il faut résoudre avec des moyens différents.
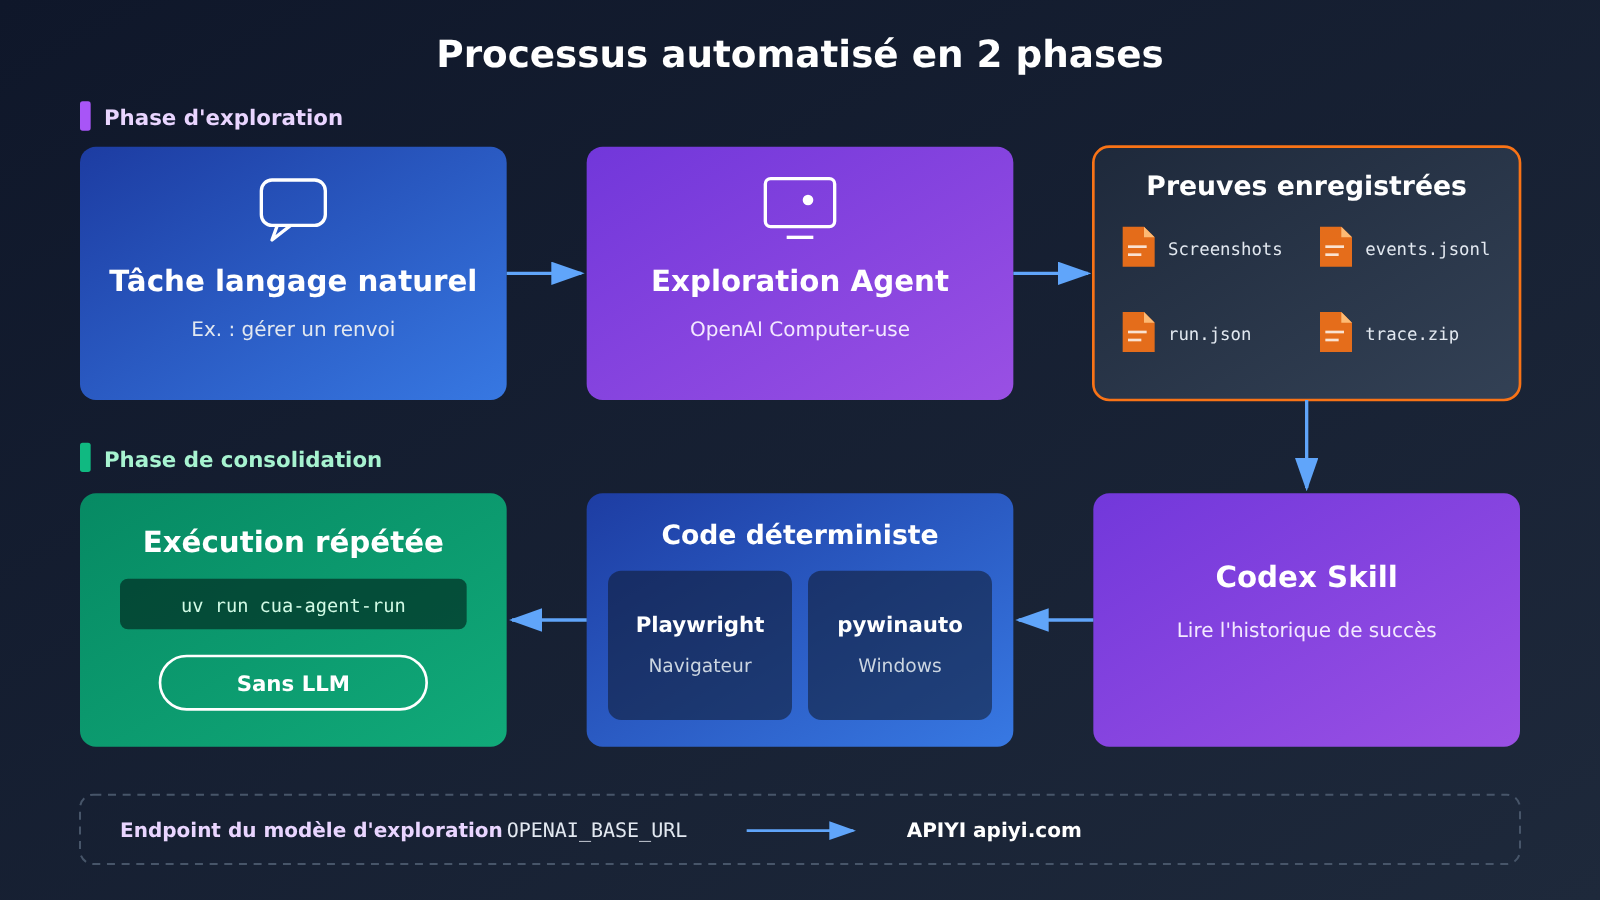
L’ensemble du processus se déroule en deux phases :
- Phase d’exploration : l’agent OpenAI Computer-use reçoit une tâche décrite en langage naturel, par exemple « trouver tel enregistrement et traiter le transfert », puis explore, exécute et vérifie dans l’interface réelle. Au passage, il enregistre captures d’écran, actions effectuées, cibles des actions et traces d’exécution.
- Phase de consolidation : le Codex Skill lit les enregistrements d’exploration réussis et génère ou met à jour un code de workflow déterministe. Ensuite, la répétition du même processus est confiée à du code ordinaire : plus besoin de demander au grand modèle de langage de refaire une inférence à chaque fois.
Les preuves laissées par la phase d’exploration sont des fichiers écrits sur disque, et non un raisonnement resté à l’intérieur du modèle. Voici les types d’enregistrements publiés dans le README :
| Enregistrement | Utilisation principale | Valeur dans la phase de consolidation |
|---|---|---|
| Screenshots | Consignent l’état de l’interface à chaque étape | Permettent aux ingénieurs et à Codex de vérifier à quoi ressemble réellement la page |
| events.jsonl | Journalisent les événements d’opération ligne par ligne | Reconstituent « ce qui a été fait, et dans quel ordre » |
| run.json | Consignent les informations de l’exécution en cours | Distinguent les différentes exécutions et indiquent si elles ont réussi |
| trace.zip | Traces d’exécution Playwright | Fournissent les détails sur les éléments, le réseau et la chronologie, pour générer et diagnostiquer le code |
Source : github.com/cvs-health/cua-agent-kit
De l’action IA au code Playwright : que fait CVS Agent Kit ?
Le détail le plus important de la phase de consolidation : ce qui est généré n’est pas un « replay de coordonnées souris ». Lorsque le projet CVS produit un workflow navigateur, il s’appuie sur des localisateurs sémantiques (Semantic Locators) pour générer du code Playwright, en ciblant les éléments via leur rôle, leur nom et autres caractéristiques sémantiques, plutôt qu’en mémorisant une coordonnée écran figée.
La différence entre les deux approches est particulièrement flagrante lors de la maintenance. Le replay de coordonnées dépend de la résolution, de la taille de la fenêtre et des ajustements de mise en page : un bouton déplacé de quelques pixels et le clic tombe dans le vide ; et en cas d’erreur, il est bien difficile de deviner, à partir d’une suite de coordonnées, ce qu’on voulait cliquer au départ. Le code produit par les localisateurs sémantiques ressemble à « cliquer sur le bouton nommé « Envoyer » » : l’intention est inscrite dans le code, l’ingénieur peut la relire directement, et un ajustement local de la page a moins de risques de la casser. Bien sûr, si un bouton change de nom ou si le flux est refondu, les localisateurs sémantiques échouent aussi — mais l’échec est plus facile à localiser.
La répartition des outils du projet est la suivante :
- Playwright : assure l’exécution déterministe des workflows navigateur et produit des traces rejouables comme trace.zip.
- pywinauto : prend en charge l’automatisation des applications de bureau Windows, y compris les anciens systèmes sans interface web.
- Codex Skill : lit les traces d’exploration réussies et génère ou met à jour les deux types de code ci-dessus.
Cette approche rejoint la direction de la documentation officielle d’OpenAI. Le guide Computer Use d’OpenAI présente deux voies : l’une où le modèle renvoie des actions souris/clavier structurées, exécutées par l’application ; l’autre où le modèle génère du code et pilote l’interface via des outils comme Playwright. La documentation recommande l’exécution de code pour GPT-6 Astra, Computer Tool restant une option. ComputerToolset, BrowserToolset et l’entrée de navigateur hébergé sont présentés séparément dans le guide officiel.
Source : developers.openai.com/api/docs/guides/tools-computer-use
Une fois le processus figé, que reste-t-il à faire à l’Agent du CVS Agent Kit ?
Une fois le workflow figé, l’exécution déterministe passe par la commande indiquée dans le README :
uv run cua-agent-run
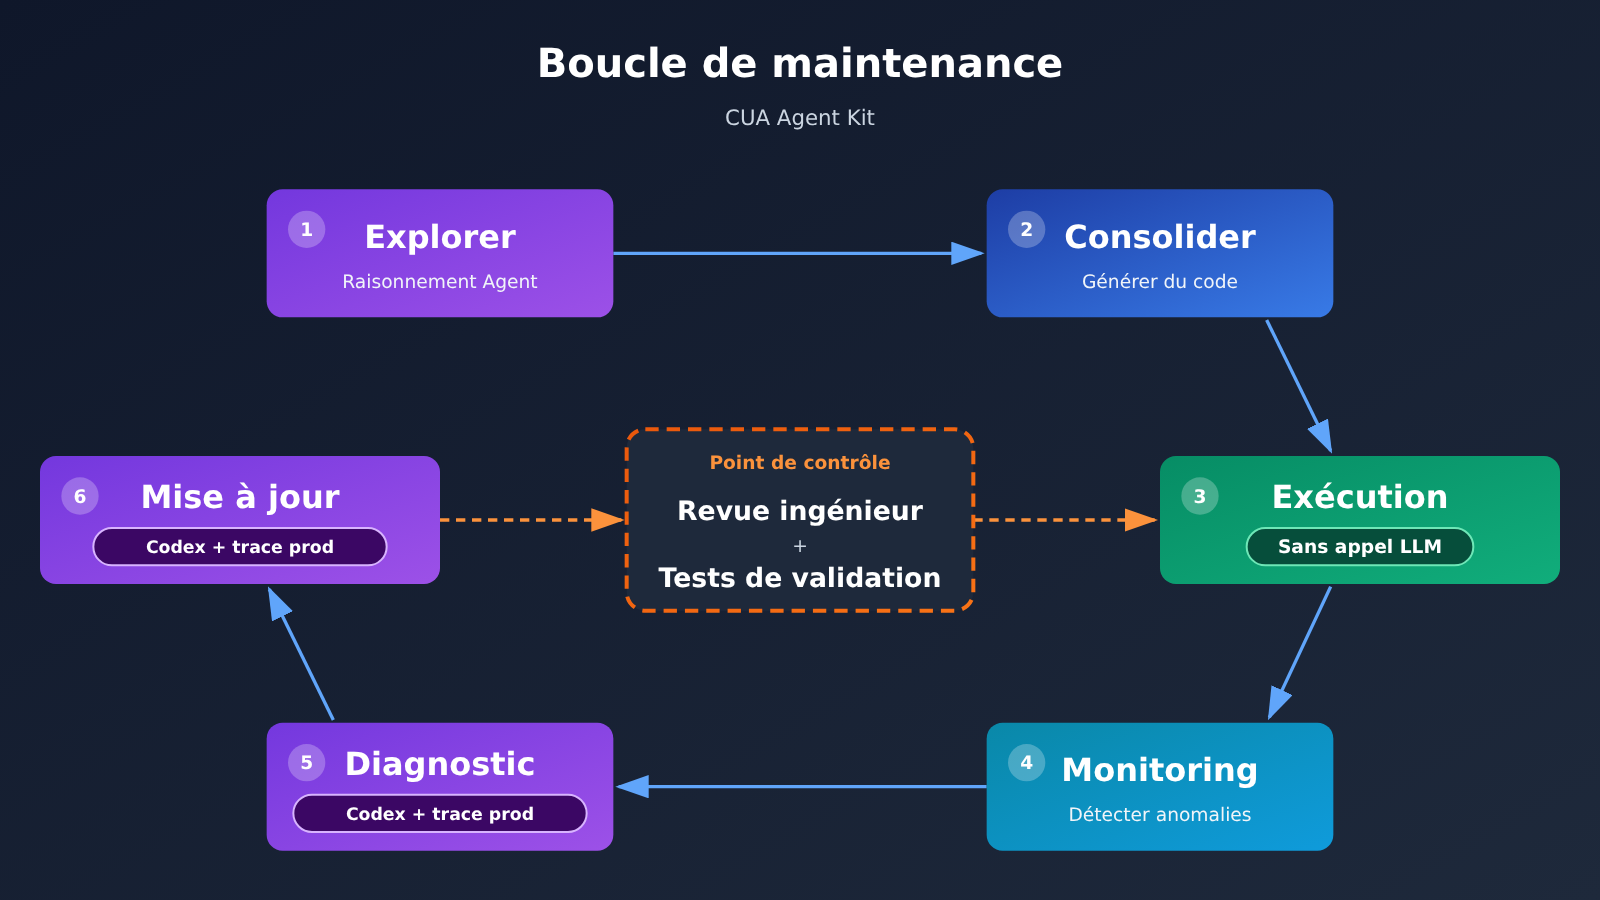
À ce stade, plus besoin d’appeler le grand modèle de langage à chaque exécution, ni de clé API. Mais le projet ne considère pas ce figement comme acquis une fois pour toutes. Le mécanisme de maintenance décrit dans le README forme une boucle fermée :
- Le workflow figé s’exécute comme prévu ;
- Des anomalies apparaissent dans les traces de production ;
- Codex s’appuie sur ces traces pour diagnostiquer le problème ;
- Le code déterministe est mis à jour ;
- Un ingénieur relit les modifications ;
- Une fois les tests et la validation passés, le code repart en exécution répétée.
Autrement dit, le rôle de l’Agent passe de « je fais le travail moi-même à chaque fois » à « je suis absent la plupart du temps, et j’interviens pour réparer le code quand ça casse ». Le code peut planter, les interfaces peuvent être refaites : le projet part de ce principe, et c’est précisément pour cela qu’il a prévu les étapes de diagnostic et de relecture.
Quelle est la différence entre l’automatisation hybride par Agent de CVS et le RPA traditionnel ?
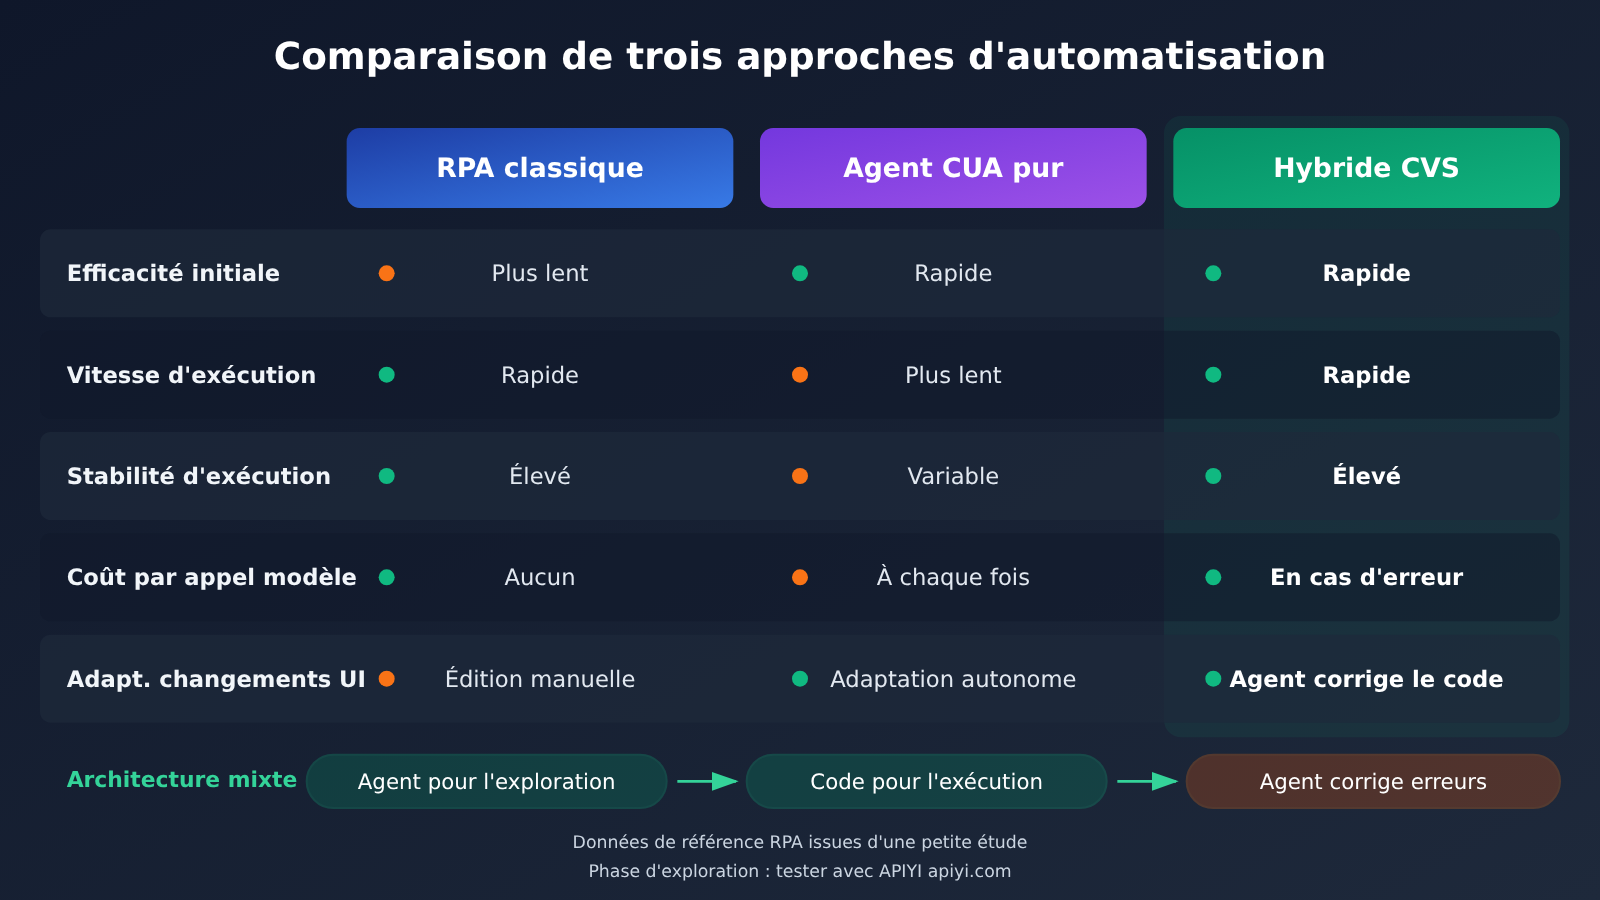
Le RPA traditionnel repose sur des étapes préconfigurées et le repérage des éléments d’interface. Son exécution est rapide et ses résultats stables, mais le développement et la maintenance lors des changements de version demandent un travail humain. Un Agent pur sait comprendre le langage naturel et s’adapter aux changements d’interface, mais chaque nouvelle inférence entraîne des coûts et une variabilité des résultats. Le CUA Agent Kit se positionne entre les deux : l’Agent remplace l’étape où l’on enregistre et rédige manuellement le processus, puis la phase d’exécution revient à du code déterministe.
Pour une comparaison directe, on peut se référer à une étude publiée en 2026 : Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks (DOI : 10.1080/23311975.2026.2724760). L’étude a été menée entre mai et juin 2025 et compare UiPath Studio 2023.4.0 à Anthropic Computer Use Agent, sur trois types de tâches standardisées : saisie de données, surveillance et extraction de documents.
| Tâche | Taux de réussite RPA | Taux de réussite Agent | Temps de développement initial (observation d’un seul développeur) |
|---|---|---|---|
| P1 | Non inclus dans les statistiques comparatives | L’Agent a échoué dès sa première exécution et n’a pas été intégré aux statistiques suivantes | Non divulgué |
| P2 | 100 % (10 exécutions) | 90 % (10 exécutions) | Agent env. 10 minutes, RPA env. 38 minutes |
| P3 | 100 % (10 exécutions) | 60 % (10 exécutions) | Agent env. 15 minutes, RPA env. 240 minutes |
L’étude constate aussi que le RPA est nettement plus rapide à l’exécution sur P2 et P3 ; les problèmes de l’Agent concernent principalement des échecs d’opérations d’interface, des pertes de contexte et des erreurs de jugement ; l’Agent présente un avantage potentiel pour s’adapter aux interfaces dynamiques.
Les limites de cette étude doivent être clairement précisées :
- Échantillon réduit : pour P2 et P3, 10 exécutions par technologie, tandis que P1 ne correspond pas à « 10 exécutions par technologie » ; impossible de généraliser.
- Temps de développement : seulement des observations préliminaires : ils proviennent d’un seul développeur et n’ont pas de représentativité statistique ; ce ne sont pas des moyennes sectorielles.
- Versions d’outils plutôt anciennes : l’étude utilise une configuration d’Agent de 2025 et ne représente pas les résultats des nouveaux modèles de 2026.
Malgré cela, la direction des conclusions fait écho à la conception de CVS : l’Agent est doué pour l’exploration rapide et le traitement flexible, tandis que l’exécution déterministe à la RPA garde un avantage pour les répétitions stables.
Source : tandfonline.com/doi/full/10.1080/23311975.2026.2724760
Comment les développeurs peuvent-ils réutiliser l’approche de CVS CUA Agent Kit ?
Le README ne liste pas beaucoup de prérequis :
- Python 3.12 ou supérieur ;
- uv (outil de gestion de paquets et de projets Python) ;
- un site web ou une application de bureau cible accessible ;
- l’étape d’exploration nécessite
OPENAI_API_KEY; - la possibilité de configurer un endpoint API personnalisé via
OPENAI_BASE_URL.
L’utilisation s’organise en trois étapes : la découverte (l’agent explore et conserve les preuves), la consolidation (Codex génère le code) et l’exécution (exécution déterministe). Pour les commandes et paramètres précis des phases de découverte et de consolidation, référez-vous au README du dépôt ; la phase d’exécution correspond à la commande uv run cua-agent-run présentée plus haut.
Le choix de OPENAI_BASE_URL mérite qu’on s’y arrête. Il signifie que le point d’entrée du modèle pour la phase d’exploration peut pointer vers l’API officielle, mais aussi vers une passerelle interne à l’entreprise ou tout autre service compatible avec l’interface OpenAI, ce qui facilite l’authentification, la facturation et l’audit centralisés. Voici comment configurer les variables d’environnement de la phase d’exploration :
# Phase d'exploration : nécessite l'API du modèle
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # Utiliser l'interface unifiée APIYI, ou remplacer par votre passerelle

# Phase d'exécution : exécution déterministe, pas de clé API nécessaire
uv run cua-agent-run
Un point à souligner : Computer Use dépend de capacités et de types d’outils spécifiques à l’API Responses. Avant de basculer vers un endpoint personnalisé, vérifiez d’abord que celui-ci prend en charge les modèles et les outils requis par la phase d’exploration, et validez-le sur un flux simple avant de généraliser.
Une fois la consolidation effectuée, la tâche la plus fréquente en maintenance quotidienne consiste à lire les traces et les journaux d’événements. Voici un exemple de script auxiliaire : on soumet le events.jsonl d’une exécution à un grand modèle de langage généraliste pour qu’il en tire une liste d’étapes et repère les points de défaillance suspects, à titre de référence pour la revue d’un ingénieur. Les champs exacts de events.jsonl dépendent de ce que le projet produit réellement ; ici, on se contente de lire ligne par ligne. Dès qu’il s’agit de données sensibles, comme des informations de patients, anonymisez-les impérativement au préalable, ou travaillez uniquement dans un environnement conforme.
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """Lit un events.jsonl déjà anonymisé et génère une liste d'étapes ainsi que les points de défaillance suspectés"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # Limiter la longueur du contexte
    prompt = (
        "以下是一次界面自动化运行的事件日志。"
        "请按顺序列出操作步骤,并指出最可能导致失败的步骤及原因,"
        "只基于日志内容,不要臆测。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # Remplacez par le modèle réellement disponible sur votre plateforme
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
Ce script ne sert qu’à faciliter la lecture : il ne remplace ni le diagnostic de Codex à partir de la trace complète, ni la revue et les tests réalisés par un ingénieur.
🚀 Conseil pour démarrer rapidement : quand vous réutilisez cette approche, commencez par un flux à faible risque sur un site de test interne, et faites tourner toute la chaîne « exploration → consolidation → exécution ». La phase d’exploration demande des invocations répétées du modèle pour comparer les résultats : vous pouvez obtenir des crédits de test gratuits via APIYI apiyi.com, utiliser la même clé API pour basculer entre différents modèles sur des tâches auxiliaires comme l’analyse de journaux, puis choisir le modèle pour l’environnement de production.
Analyse et arbitrage : les compromis de la voie d’automatisation des agents CVS
Ce qui suit est une interprétation basée sur les faits exposés précédemment, et non les conclusions du projet ni celles d’OpenAI.
Pourquoi est-il wasteful qu’un agent reparte de zéro à chaque fois ?
L’automatisation de processus métier multi-étapes présente une particularité : une fois le flux validé, la grande majorité des exécutions ultérieures suivent le même chemin. Si l’on demande à chaque fois à l’agent Computer-use de reprendre une capture d’écran, de comprendre l’interface et de planifier l’étape suivante, le modèle paie en réalité à répétition pour des questions dont il connaît déjà la réponse. Cette inférence répétée entraîne simultanément trois types de coûts.
Le premier, c’est le coût. Computer Use fonctionne par appels multi-tours : les captures d’écran après chaque opération constituent des entrées d’image et accumulent continuellement des Tokens. Prenons l’exemple des tarifs Standard à contexte court publiés par OpenAI le 17 novembre 2026 : pour GPT-6 Astra, l’entrée, la sortie et l’entrée mise en cache sont respectivement de 10, 50 et 1 dollar par million de Tokens ; pour GPT-6 Luna, de 0,10, 0,50 et 0,01 dollar. Dans l’évaluation HealthAdminBench, le coût par tâche de Luna est de 0,085 dollar, soit 98 % de moins qu’Astra ; en inversant ce ratio, Astra revient à environ 4,25 dollars par tâche, mais il ne s’agit là que d’une estimation, et d’un coût dans les conditions du benchmark, qui ne saurait servir de devis de production.
Le deuxième, c’est la latence. Chaque étape exige d’attendre le retour du modèle ; plus le flux est long, plus l’attente est longue. Dans l’étude citée plus haut, la RPA s’exécute nettement plus vite que l’agent aux étapes P2 et P3, et c’est aussi pour cette raison.
Le troisième, c’est la variabilité. Sur plusieurs exécutions d’une même tâche, l’agent peut emprunter des chemins différents ; dans l’étude, le taux de réussite de l’agent à P3 n’atteint que 60 %. Pour des activités qui exigent prévisibilité et auditabilité, cette incertitude est plus difficile à accepter que le coût.
Il convient donc de comptabiliser séparément les structures de coûts des deux phases :
| Poste de coût | Phase d’exploration (agent) | Phase d’exécution (code déterministe) |
|---|---|---|
| Tokens du modèle | Entrées visuelles et textuelles de chaque tour, sorties facturées comptées séparément ; les Tokens de nouvelle tentative déjà inclus dans le total ne sont pas ajoutés deux fois | Nuls en fonctionnement normal |
| Outils et environnement d’exécution | Services réellement utilisés : navigateur, environnement de bureau, conteneurs, etc. | Machine et environnement de navigateur exécutant le code |
| Investissement d’ingénierie | Rédaction de la description de tâche, vérification des preuves, revue du code généré | Supervision, diagnostic des anomalies, mise à jour et tests du code |
| Fréquence | Lors de la mise en service d’un nouveau flux ou d’une refonte importante | À chaque exécution métier |
| Pratique recommandée | Choisir le modèle par paliers de complexité : modèle puissant pour les flux difficiles, modèle économique pour les flux structurés | Éviter au maximum les appels au modèle, ne revenir à l’agent qu’en cas d’anomalie pour corriger |
L’économie de l’architecture hybride découle précisément de ce tableau : les appels coûteux au modèle se concentrent sur les phases d’exploration et de correction, peu fréquentes, tandis que les phases d’exécution à haute fréquence reviennent à du code dont le coût marginal en modèle est proche de zéro. Le vrai bilan doit aussi intégrer la maintenance : plus les refontes d’interface sont fréquentes, plus on retourne souvent en phase d’exploration, et plus l’économie se réduit.
💰 Conseil coût : pour le choix de modèles par paliers en phase d’exploration, mieux vaut tester avec vos propres flux réels plutôt que de recopier les chiffres du benchmark. Avec APIYI apiyi.com, vous pouvez changer de modèle sous une même interface compatible OpenAI, avec facturation à l’usage, ce qui facilite la comparaison de la consommation réelle de Tokens des différents modèles en phase d’exploration et de diagnostic des logs.
Il y a aussi une question de convention d’évaluation facile à négliger. Les scores publiés par OpenAI sur HealthAdminBench sont de 94,3 % pour Astra et de 91,8 % pour Luna : il s’agit de la part des points de la grille d’évaluation (rubric points) obtenue à l’intensité de raisonnement maximale, et non d’un taux de réussite de bout en bout. La version 2604.09937v1 de l’article de l’équipe de Stanford contient 135 tâches et 1 698 sous-tâches (dont 1 177 évaluations déterministes et 521 jugées par un modèle) ; elle rapporte un meilleur taux de réussite sur la tâche complète de 36,3 % (Claude Opus 4.6 CUA) et un meilleur taux de réussite sur les sous-tâches de 82,8 % (GPT-5.4 CUA). Les 70 tâches et 947 points d’évaluation divulgués plus tôt sur le site web relèvent d’une autre version publique et ne peuvent servir que de repère historique. Ces chiffres proviennent de modèles, de dates, de conditions d’exécution et d’indicateurs différents : ils ne peuvent pas être alignés dans un même classement.
Pour l’approche « explorer, puis consolider », le taux de réussite de bout en bout compte davantage que les scores partiels. Codex a besoin d’une trajectoire pleinement réussie : si la phase d’exploration réussit 90 % des sous-étapes mais échoue à l’étape finale de soumission, la Trace produite ne peut pas être consolidée directement. Au moment de choisir un modèle, il faut donc mesurer le taux de réussite sur la tâche complète avec son propre processus.
Quelles tâches sont adaptées à une architecture d’agent hybride de type CVS ?
En rassemblant les faits précédents, on obtient un tableau approximatif de répartition des tâches :
| Caractéristique de la tâche | Mode d’exécution recommandé | Exemple typique | Intervention humaine |
|---|---|---|---|
| Processus inconnu, documentation absente, interface complexe | L’agent explore et conserve des preuves | Première cartographie du parcours opérationnel d’un ancien système | Examiner les résultats de l’exploration et le code généré |
| Processus stable, répétition à haute fréquence, vérifiable par l’état | Figer sous forme de code déterministe | Envoi de fichiers entre systèmes, transfert de champs fixes | Contrôle par échantillonnage des résultats, surveillance des anomalies |
| Couverture API existante | Appeler l’API en priorité | Écriture de données structurées | Gestion selon les autorisations habituelles |
| Interface fréquemment remaniée | Après figement, renforcer la surveillance et prévoir un budget pour revenir à l’exploration | Portails tiers | Révision à chaque mise à jour du code |
| Modifier un état métier à haut risque | Le code ou l’agent se limite à un brouillon / à une attente d’approbation | Soumettre une demande, envoyer un message, modifier un enregistrement | Approbation humaine obligatoire |
Dans le domaine médical, les pratiques d’autres partenaires offrent aussi un point de comparaison. La solution présentée par Ambience fait s’arrêter l’agent pour interroger le médecin lorsqu’un dossier médical est ambigu, et attend l’approbation avant la soumission ; dans le cas d’Assort, l’API prend en charge ce qu’elle peut couvrir, et Computer Use ne complète que les étapes d’interface non couvertes par l’API. La combinaison « API + Computer Use + code déterministe + approbation humaine » est plus réaliste que le pari sur une seule technologie.
Il faut être clair : le code déterministe rend seulement l’exécution prévisible, il ne garantit pas l’exactitude du résultat. Si, pendant la phase d’exploration, on a figé un parcours défectueux, le code répétera stablement ce défaut ; dans les opérations inter-systèmes, une erreur peut aussi être copiée vers plusieurs systèmes en aval. Par conséquent, la vérification de l’état avant l’opération, la validation du résultat après l’opération, le moindre privilège et la traçabilité de bout en bout restent indispensables même après le figement. Cet article porte sur l’architecture d’ingénierie et ne contient aucune recommandation de diagnostic ou de traitement pour des patients.
Pour les équipes qui veulent passer à l’action, la voie la plus sûre est la suivante : choisir d’abord, dans un environnement non production, un processus à faible risque et fortement répétitif, dérouler entièrement un cycle d’exploration, de figement, d’exécution, puis une modification d’interface provoquée artificiellement, et consigner le coût d’invocation du modèle, les heures de maintenance du code et le temps de récupération après échec. Ces trois chiffres disent mieux que n’importe quel score de référence si cette architecture est rentable dans votre contexte. Pour les tests comparatifs multi-modèles de la phase d’exploration, vous pouvez d’abord démarrer avec le quota gratuit d’APIYI apiyi.com, puis décider du modèle et du mode d’intégration à déployer en production en fonction des résultats mesurés.
La solution de CVS mérite l’attention non pas parce qu’elle prétend que l’agent est très intelligent, mais parce qu’elle reconnaît les limites de l’agent et utilise l’intelligence là où elle est la plus utile : explorer une fois, figer dans du code, réparer en cas de problème. La capacité de cette approche à s’imposer dans davantage d’entreprises dépendra en fin de compte des données mesurées des processus de chacun dans des environnements réels.
The proof of the pudding is in the eating. (C’est en mangeant le pudding qu’on sait s’il est bon : l’effet réel doit être vérifié par la pratique.)
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI apiyi.com ; davantage de documentation d’intégration est disponible au centre de documentation docs.apiyi.com


