
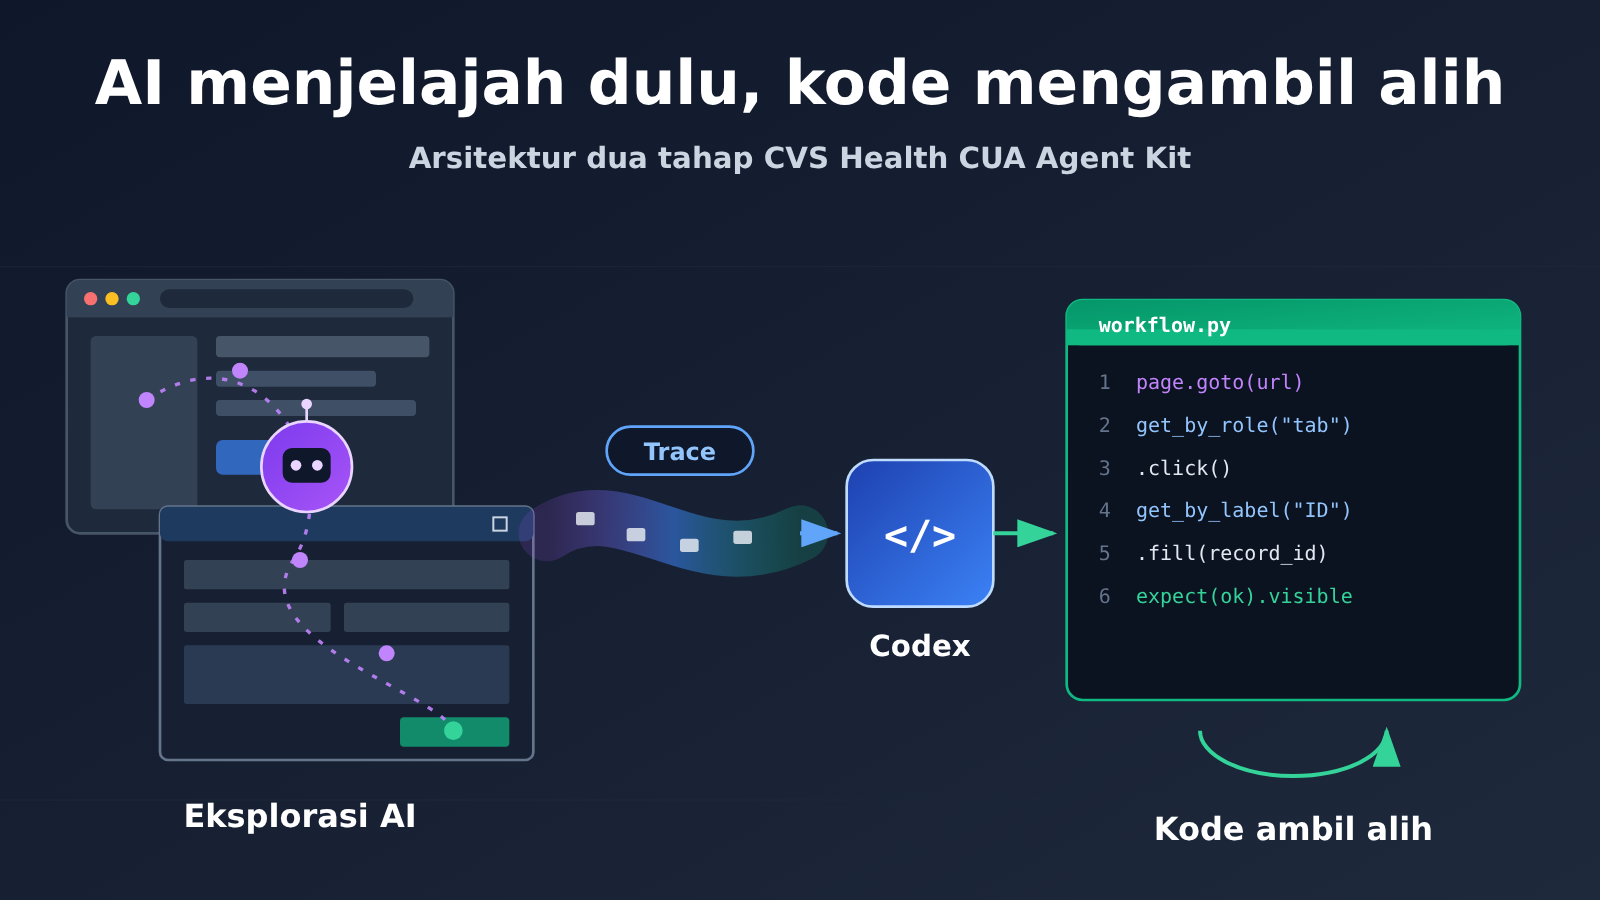
Agent perusahaan tidak perlu lagi memanggil Model Bahasa Besar pada setiap tugas berulang. CUA Agent Kit open source dari CVS Health menawarkan pendekatan rekayasa yang lebih hemat biaya: pertama, biarkan Computer-use Agent mengeksplorasi alur bisnis yang belum diketahui, lalu merekam proses yang berhasil sebagai tangkapan layar, event, dan Trace; setelah itu, Codex mengubah bukti-bukti tersebut menjadi kode deterministik yang dapat diperiksa, dipelihara, dan dieksekusi berulang kali.
Solusi ini menggabungkan kemampuan eksplorasi AI yang fleksibel dengan kemampuan eksekusi otomatisasi tradisional yang stabil, membentuk arsitektur hybrid “AI mengeksplorasi, kode memantapkan, pemeliharaan berkelanjutan”. Ini bukan membuat Agent menggantikan skrip, melainkan membuat Agent menulis dan memperbaiki skrip.
Apa yang bisa Anda pahami setelah membaca artikel ini?
- Bagaimana CUA Agent Kit dari CVS Health menjalankan alur dua tahap dari eksplorasi AI hingga pemantapan kode
- Apa peran tangkapan layar, events.jsonl, Trace, dan locator semantik pada tahap pemantapan kode
- Bagaimana alur tetap berjalan tanpa memanggil Model Bahasa Besar, dan bagaimana pemeliharaannya saat muncul anomali
Bagian fakta objektif berikut ini akan menjelaskan secara berurutan: mekanisme kerja CUA Agent Kit, apa yang terjadi antara operasi AI dan kode Playwright, pekerjaan pemeliharaan apa yang masih ditanggung Agent setelah pemantapan kode, dasar riset atas perbedaan arsitektur ini dengan RPA tradisional, dan bagaimana developer dapat mulai memanfaatkannya ulang. Bagian analisis dan penilaian kemudian membahas dua pertanyaan: mengapa Agent yang berpikir dari nol setiap kali merupakan pemborosan, serta tugas mana yang cocok untuk arsitektur hybrid ini dan tugas mana yang tetap harus melewati peninjauan manusia.
To Know: Memahami 7 konsep dalam jalur otomatisasi CVS Agent
| Konsep | Penjelasan singkat |
|---|---|
| Computer Use | Kemampuan menyelesaikan tugas dengan mengamati antarmuka perangkat lunak, melakukan klik, input, dan operasi sejenisnya |
| EHR | Sistem rekam kesehatan elektronik, perangkat lunak inti tempat institusi medis menyimpan dan memproses rekam medis pasien |
| MCP | Protokol standar untuk menemukan dan memanggil alat eksternal |
| RPA | Cara otomatisasi yang menjalankan proses berulang melalui aturan atau program yang telah dikonfigurasi sebelumnya |
| Rubric points | Poin penilaian yang dipecah menurut aturan evaluasi, untuk mengukur tercapainya sebagian persyaratan |
| Tingkat keberhasilan ujung ke ujung | Proporsi tugas lengkap yang memenuhi seluruh kondisi keberhasilan |
| Trace | Bukti jejak yang mencatat proses eksekusi, operasi, dan status halaman |
Ringkasan dampak: Siapa yang terpengaruh oleh jalur otomatisasi CVS Agent
- Pengembang dan penanggung jawab teknis: Fokusnya bukan “pakai atau tidak pakai Agent”, melainkan memecah mekanisme eksekusi berdasarkan tugas. Perlu memverifikasi secara terpisah tingkat penyelesaian tahap eksplorasi, stabilitas kode yang sudah dikunci, serta biaya total termasuk pemeliharaan, bukan hanya melihat harga satu kali pemanggilan model.
- Institusi medis dan penanggung jawab alur kerja: Perlu membedakan demo sintetis, evaluasi vendor, studi kasus publik perusahaan, dan uji coba sendiri — bobot bukti dari masing-masing kategori ini berbeda. Untuk langkah yang melibatkan data pasien dan perubahan status, persetujuan manual, hak akses minimal, dan jejak audit operasi harus diterapkan sejak awal.
Fakta Objektif: Rute Dua Tahap CVS Health CUA Agent Kit
Mari kita mulai dari latar belakangnya. Pada 16 November 2026, OpenAI merilis kemajuan Computer-use Agent untuk tim layanan kesehatan, mengumumkan hasil evaluasi untuk tugas klinis dan administrasi medis, serta praktik kerja sama dengan CVS Health, Cigna Healthcare, Abridge, Ambience, dan institusi lainnya. CVS Health di antaranya mengungkapkan studi kasus lingkungan produksi dan mengopen-source-kan CUA Agent Kit dengan lisensi Apache-2.0.
Hasil produksi yang diungkapkan CVS Health mencakup: sebuah Agent dalam salah satu alur kerja produksi membersihkan tumpukan tugas pengiriman dokumen yang menumpuk selama beberapa bulan hanya dalam satu akhir pekan; Agent lain setiap hari menangani puluhan ribu langkah operasi sistem dalam konsultasi spesialis. Sistem ini dilengkapi pemeriksaan validasi dan pengawasan manusia, serta mencocokkan operasi aktual dengan status aplikasi melalui tangkapan layar dan catatan operasi. Perlu dicatat, semua ini adalah data yang diungkapkan sendiri oleh perusahaan. “Puluhan ribu kali” merujuk pada langkah operasi sistem terkait konsultasi, bukan berarti puluhan ribu keputusan klinis diselesaikan secara mandiri oleh AI. Materi publik juga tidak menjelaskan apakah Agent produksi tersebut sepenuhnya dibangun berdasarkan versi open source Agent Kit, sehingga keduanya tidak bisa langsung disamakan.
Sumber: openai.com/index/advancing-computer-use-for-healthcare-teams/
Bagaimana CUA Agent Kit dari CVS Health Bekerja?
README proyek mendeskripsikan posisinya dengan sangat gamblang: ini adalah toolkit pemula untuk mengotomatiskan alur kerja browser dan Windows, menggunakan AI untuk menemukan langkah-langkah, lalu menggunakan kode untuk mengeksekusi secara berulang. Proyek ini secara khusus menekankan bahwa “mencari tahu bagaimana sebuah tugas dikerjakan” dan “mengulanginya secara stabil dalam jangka panjang” adalah dua masalah yang berbeda, dan keduanya harus diselesaikan dengan cara yang berbeda.
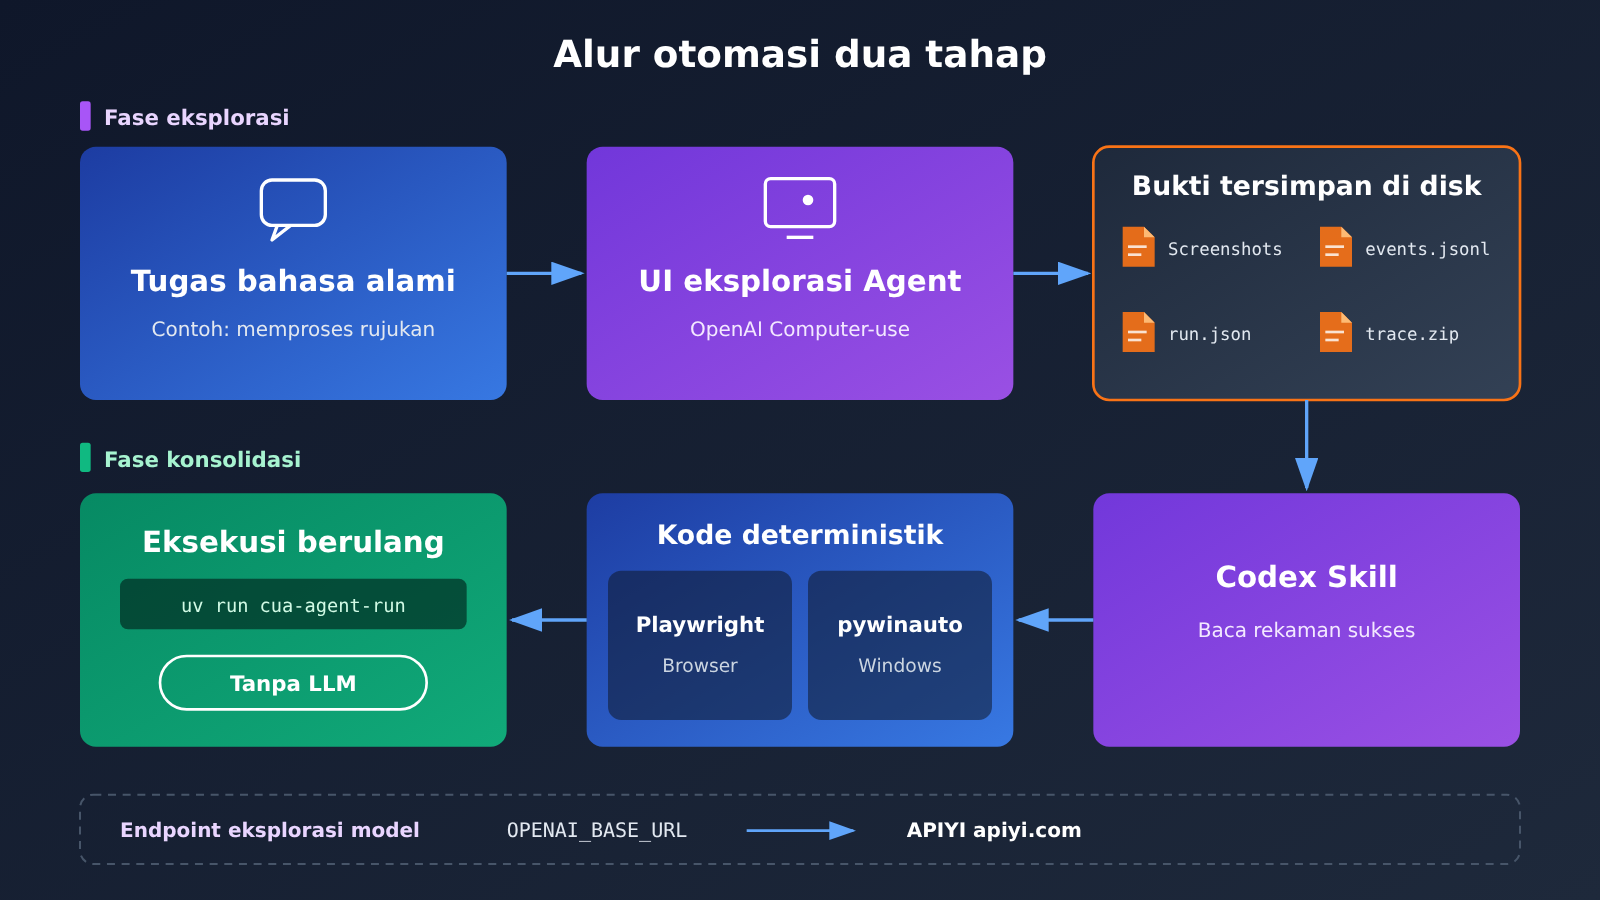
Seluruh alur terbagi menjadi dua tahap:
- Tahap eksplorasi: OpenAI Computer-use Agent menerima tugas yang dijelaskan dalam bahasa alami, misalnya “temukan catatan tertentu dan proses rujukannya”, lalu mengeksplorasi, mengeksekusi, dan memverifikasi di antarmuka nyata. Selama proses berlangsung, tangkapan layar, aksi operasi, target operasi, dan jejak eksekusi disimpan.
- Tahap pemantapan: Codex Skill membaca catatan eksplorasi yang telah berhasil, lalu menghasilkan atau memperbarui kode alur kerja yang deterministik. Setelah itu, eksekusi berulang dari alur yang sama diserahkan kepada kode biasa, tidak lagi menuntut Model Bahasa Besar untuk bernalar ulang setiap kali.
Bukti yang ditinggalkan oleh tahap eksplorasi semuanya berupa file yang tersimpan di disk, bukan proses penalaran yang tertahan di dalam model. Jenis catatan yang diungkapkan README adalah sebagai berikut:
| Catatan | Kegunaan utama | Nilai dalam tahap pemantapan |
|---|---|---|
| Screenshots | Merekam status antarmuka di setiap langkah | Untuk engineer dan Codex memeriksa seperti apa tampilan halaman sebenarnya |
| events.jsonl | Merekam peristiwa operasi baris per baris | Merekonstruksi “apa yang dilakukan, dalam urutan apa” |
| run.json | Merekam informasi eksekusi kali ini | Membedakan antar-eksekusi, menilai apakah berhasil |
| trace.zip | Jejak eksekusi Playwright | Menyediakan detail elemen, jaringan, dan urutan waktu, untuk menghasilkan dan mendiagnosis kode |
Sumber: github.com/cvs-health/cua-agent-kit
Dari operasi AI hingga kode Playwright, apa yang dilakukan CVS Agent Kit?
Satu detail paling penting pada tahap finalisasi adalah: yang dihasilkan bukanlah “replay koordinat mouse”. Saat membuat alur kerja browser, proyek CVS menggunakan pengidentifikasi semantik (Semantic Locators) untuk menghasilkan kode Playwright. Target ditemukan melalui fitur semantik elemen seperti peran dan nama, bukan dengan menghafal koordinat layar tertentu.
Perbedaannya paling terlihat saat维护. Replay koordinat dipengaruhi resolusi, ukuran jendela, dan penyesuaian tata letak; tombol bergeser beberapa piksel saja bisa membuat klik meleset, dan saat terjadi error, sulit memahami dari deretan koordinat apa yang sebenarnya ingin diklik. Kode yang dihasilkan pengidentifikasi semantik mirip dengan “klik tombol bernama ‘Kirim’”. Niatnya tertulis di dalam kode, engineer bisa langsung meninjaunya, dan kode lebih tahan terhadap penyesuaian kecil pada halaman. Tentu saja, jika tombol diganti nama atau alurnya dirombak, pengidentifikasi semantik juga akan gagal, hanya saja kegagalannya lebih mudah dilacak.
Pembagian tugas alat dalam proyek adalah sebagai berikut:
- Playwright: bertanggung jawab atas eksekusi deterministik alur kerja browser dan menghasilkan jejak yang dapat diputar ulang seperti trace.zip.
- pywinauto: menangani otomasi aplikasi desktop Windows, termasuk sistem lama yang tidak memiliki antarmuka web.
- Codex Skill: membaca jejak eksplorasi yang berhasil, lalu membuat atau memperbarui dua jenis kode di atas.
Pendekatan ini sejalan dengan arahan dokumentasi resmi OpenAI. Panduan Computer Use dari OpenAI memperkenalkan dua jalur: pertama, model mengembalikan aksi mouse dan keyboard terstruktur yang dieksekusi oleh aplikasi; kedua, model menghasilkan kode dan mengoperasikan antarmuka dengan bantuan alat seperti Playwright. Dokumentasi merekomendasikan pendekatan eksekusi kode untuk GPT-6 Astra, sementara Computer Tool tetap menjadi opsi alternatif. ComputerToolset, BrowserToolset, dan entri browser terkelola dijelaskan secara terpisah dalam panduan resmi.
Sumber: developers.openai.com/api/docs/guides/tools-computer-use
Setelah pemantapan, apa lagi yang perlu dilakukan Agent dalam CVS Agent Kit?
Setelah alur kerja dipantapkan, eksekusi deterministik dijalankan melalui perintah yang diberikan di README:
uv run cua-agent-run
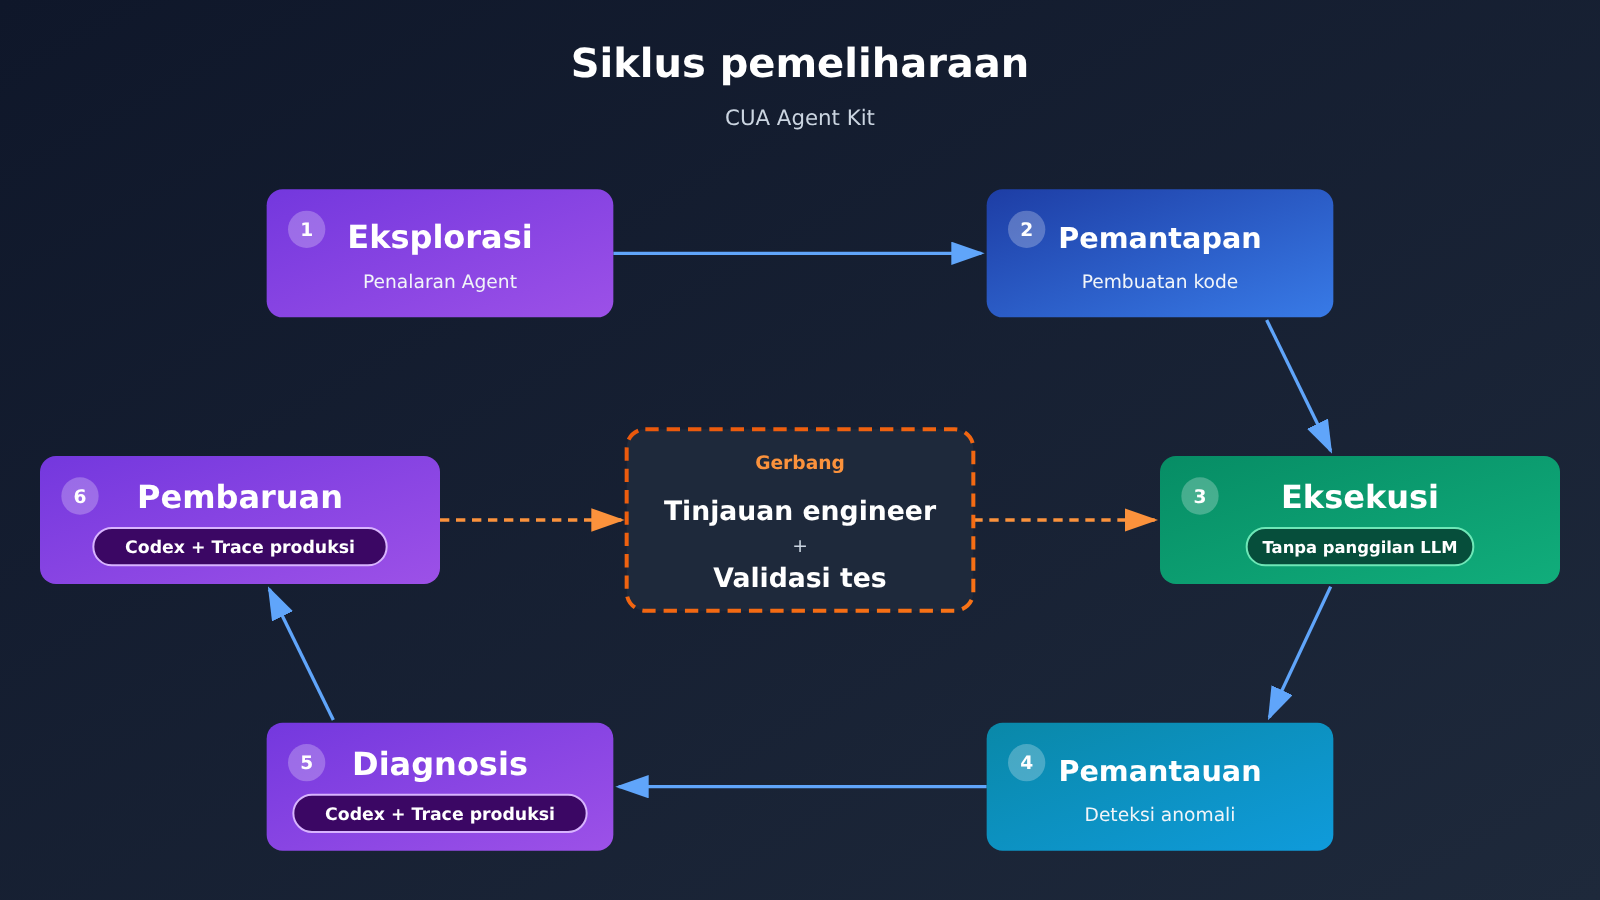
Pada tahap ini tidak perlu memanggil Model Bahasa Besar setiap kali, dan juga tidak perlu kunci API. Namun proyek ini tidak menganggap “pemantapan” sebagai solusi sekali jadi untuk selamanya. Mekanisme pemeliharaan yang dijelaskan di README adalah sebuah siklus tertutup:
- Alur kerja tetap dijalankan sesuai jadwal;
- Anomali ditemukan pada Trace di lingkungan produksi;
- Codex menggunakan Trace untuk mendiagnosis masalah;
- Kode deterministik diperbarui;
- Perubahan ditinjau oleh engineer;
- Setelah lolos pengujian dan verifikasi, alur kerja dijalankan kembali secara berulang.
Dengan kata lain, peran Agent berubah dari “mengerjakan semuanya sendiri setiap kali” menjadi “tidak hadir saat operasi normal, dan datang untuk memperbaiki kode ketika muncul masalah”. Kode bisa gagal, antarmuka bisa berubah versi — proyek ini sendiri sudah mengasumsikan hal itu, itulah sebabnya dirancang tahap diagnosis dan peninjauan.
Apa perbedaan otomasi Agent hybrid CVS dengan RPA tradisional?
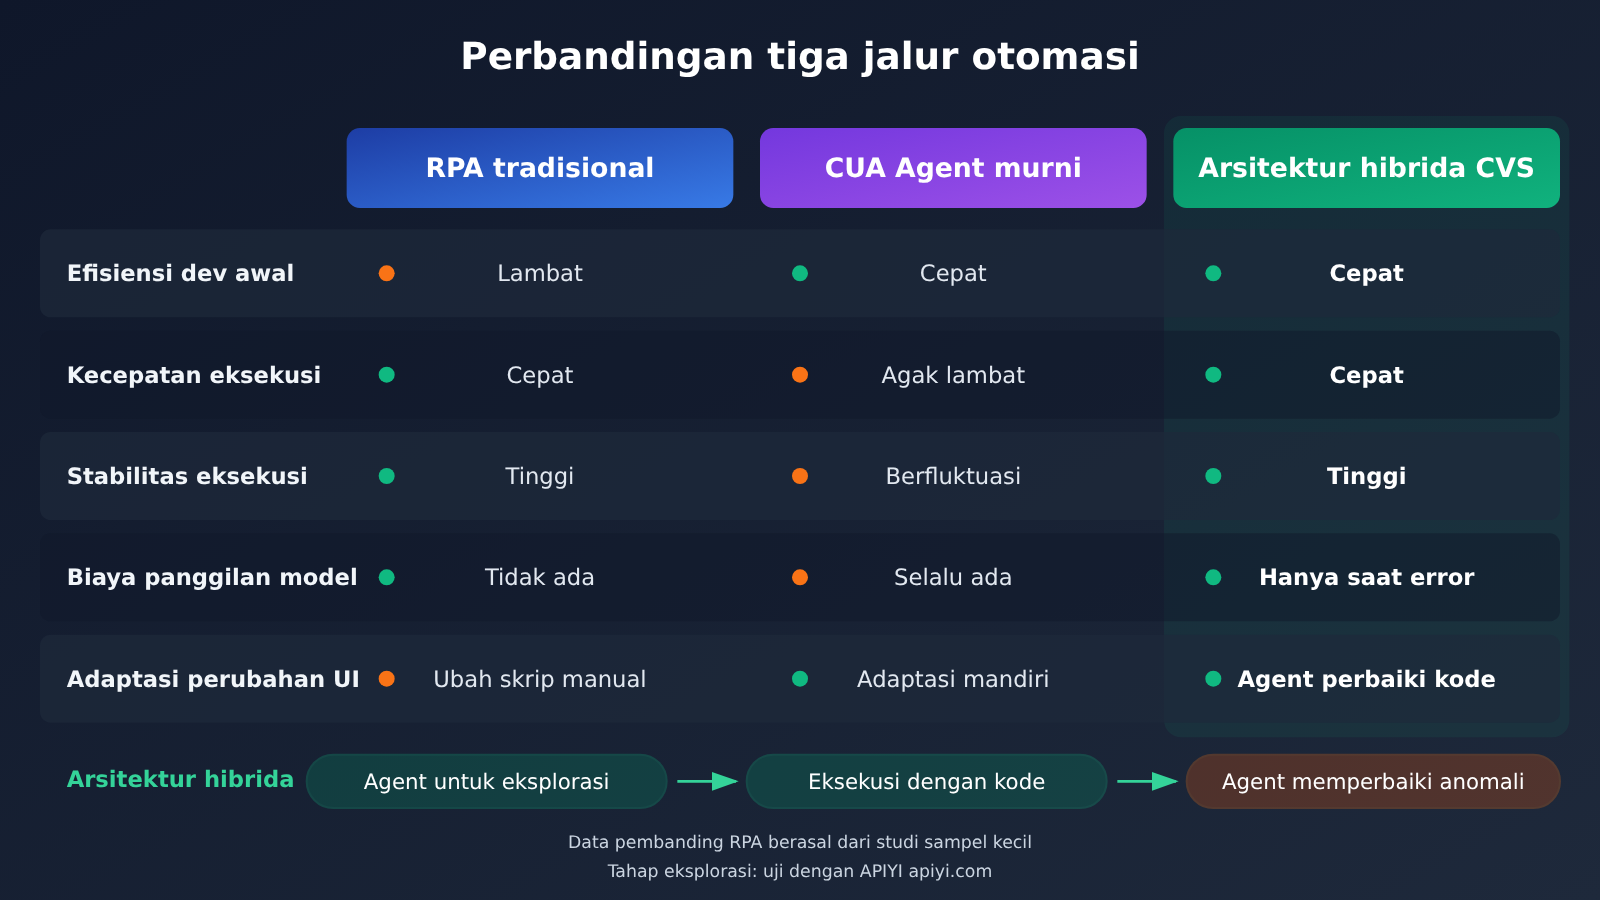
RPA tradisional bergantung pada langkah yang dikonfigurasi sebelumnya dan penentuan lokasi antarmuka. Eksekusinya cepat dan hasilnya stabil, tetapi pengembangan serta pemeliharaan saat ada perubahan versi membutuhkan campur tangan manusia. Agent murni dapat memahami bahasa alami dan beradaptasi dengan perubahan antarmuka, tetapi penalaran ulang setiap kali menimbulkan biaya dan variasi hasil. Posisi CUA Agent Kit berada di antara keduanya: Agent menggantikan langkah “merekam dan menulis alur secara manual”, sedangkan tahap eksekusi kembali ke kode deterministik.
Untuk perbandingan langsung keduanya, dapat merujuk pada studi yang diterbitkan pada 2026: Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks (DOI: 10.1080/23311975.2026.2724760). Studi dilakukan pada Mei—Juni 2025, membandingkan UiPath Studio 2023.4.0 dengan Anthropic Computer Use Agent, mencakup tiga jenis tugas standar: entri data, pemantauan, dan ekstraksi dokumen.
| Tugas | Tingkat keberhasilan RPA | Tingkat keberhasilan Agent | Waktu pengembangan awal (observasi satu pengembang) |
|---|---|---|---|
| P1 | Tidak dimasukkan dalam statistik pembanding | Agent gagal saat baru dijalankan 1 kali, sehingga tidak masuk statistik selanjutnya | Tidak diungkapkan |
| P2 | 100% (10 kali) | 90% (10 kali) | Agent sekitar 10 menit, RPA sekitar 38 menit |
| P3 | 100% (10 kali) | 60% (10 kali) | Agent sekitar 15 menit, RPA sekitar 240 menit |
Studi juga menemukan bahwa RPA jauh lebih cepat dalam eksekusi pada P2 dan P3; masalah Agent terutama meliputi kegagalan operasi antarmuka, kehilangan konteks, dan kesalahan penilaian; Agent berpotensi unggul dalam kemampuan beradaptasi terhadap antarmuka dinamis.
Batasan studi ini perlu dijelaskan dengan gamblang:
- Sampel sangat kecil: P2 dan P3 masing-masing 10 kali per teknologi, P1 bukan “10 kali per teknologi”, sehingga tidak bisa digeneralisasi secara sembarangan.
- Waktu pengembangan hanya observasi awal: berasal dari satu pengembang, tidak memiliki representativitas statistik, dan tidak dapat dianggap sebagai rata-rata industri.
- Versi alat cenderung lama: studi menggunakan konfigurasi Agent tahun 2025, sehingga tidak dapat mewakili performa model baru tahun 2026.
Meski demikian, arah kesimpulannya saling menguatkan dengan desain CVS: Agent unggul dalam eksplorasi cepat dan penanganan fleksibel, sedangkan eksekusi deterministik ala RPA masih unggul dalam pengulangan yang stabil.
Sumber: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
Bagaimana Pengembang Dapat Menggunakan Kembali Pendekatan CVS CUA Agent Kit?
README hanya mencantumkan sedikit persyaratan lingkungan:
- Python 3.12 atau versi lebih tinggi;
- uv (alat manajemen paket dan proyek Python);
- situs web target atau aplikasi desktop yang dapat diakses;
- tahap eksplorasi memerlukan
OPENAI_API_KEY; - Endpoint API kustom dapat dikonfigurasi melalui
OPENAI_BASE_URL.
Penggunaannya mencakup tiga tahap: penemuan (Agent mengeksplorasi dan meninggalkan bukti), pemantapan (Codex menghasilkan kode), dan eksekusi (pengeksekusian deterministik). Untuk perintah dan parameter spesifik pada tahap penemuan dan pemantapan, silakan merujuk ke README repositori; tahap eksekusi adalah uv run cua-agent-run seperti yang dijelaskan sebelumnya.
Desain OPENAI_BASE_URL ini patut diperhatikan. Artinya, pintu masuk model pada tahap eksplorasi dapat diarahkan ke API resmi, maupun ke gateway internal perusahaan atau layanan lain yang kompatibel dengan antarmuka OpenAI, sehingga memudahkan autentikasi, penagihan, dan audit terpadu. Variabel lingkungan pada tahap eksplorasi dapat dikonfigurasi seperti ini:
# Tahap eksplorasi: memerlukan API model
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # Menggunakan antarmuka terpadu APIYI, atau ganti dengan gateway Anda

# Tahap eksekusi: eksekusi deterministik, tidak memerlukan API Key
uv run cua-agent-run
Satu hal perlu ditekankan: Computer Use bergantung pada kemampuan Responses API dan jenis alat tertentu. Sebelum beralih ke endpoint kustom apa pun, pastikan dulu bahwa endpoint tersebut mendukung model dan alat yang diperlukan pada tahap eksplorasi, jalankan alur sederhana sampai berhasil, baru kemudian diperluas.
Setelah pemantapan, hal yang paling sering dilakukan dalam pemeliharaan sehari-hari adalah membaca Trace dan log peristiwa. Berikut adalah contoh skrip bantu: serahkan events.jsonl dari satu kali eksekusi ke Model Bahasa Besar umum, biarkan ia menyusun daftar langkah dan titik kegagalan yang mencurigakan, sebagai referensi bagi insinyur saat meninjau. Bidang spesifik events.jsonl mengikuti keluaran aktual proyek; di sini hanya dibaca per baris. Jika menyangkut informasi sensitif seperti pasien, pastikan untuk melakukan desensitisasi terlebih dahulu, atau hanya memprosesnya di lingkungan yang patuh.
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """Membaca events.jsonl yang telah didesensitisasi, menghasilkan daftar langkah dan titik kegagalan yang diduga"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # Mengendalikan panjang konteks
    prompt = (
        "以下是一次界面自动化运行的事件日志。"
        "请按顺序列出操作步骤,并指出最可能导致失败的步骤及原因,"
        "只基于日志内容,不要臆测。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # Ganti dengan model yang benar-benar tersedia di platform Anda
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
Skrip ini hanya membantu pembacaan, tidak menggantikan Codex dalam mendiagnosis masalah berdasarkan Trace lengkap, juga tidak menggantikan peninjauan dan pengujian oleh insinyur.
🚀 Saran memulai cepat: Saat menggunakan kembali pendekatan ini, Anda bisa terlebih dahulu memilih alur berisiko rendah di situs pengujian internal untuk menjalankan seluruh rantai “eksplorasi → pemantapan → eksekusi” sampai berhasil. Tahap eksplorasi memerlukan pemanggilan model berulang kali untuk membandingkan hasil; Anda dapat memperoleh kuota pengujian gratis melalui APIYI apiyi.com, menggunakan kunci API yang sama untuk beralih antar model guna mengerjakan tugas bantu seperti analisis log, lalu menentukan pilihan model untuk lingkungan produksi.
Analisis dan Penilaian: Pilihan Strategi Otomasi CVS Agent
Konten berikut adalah interpretasi berdasarkan fakta-fakta yang telah diuraikan sebelumnya, bukan kesimpulan dari pihak proyek maupun OpenAI.
Mengapa membuat Agent berpikir dari nol setiap kali itu sebuah pemborosan?
Otomasi bisnis multi-langkah memiliki satu karakteristik: begitu alur berjalan lancar, mayoritas eksekusi berikutnya akan menempuh jalur yang sama. Jika setiap kali Computer-use Agent diminta mengambil tangkapan layar ulang, memahami antarmuka, dan merencanakan langkah berikutnya, model sebenarnya membayar berulang kali untuk pertanyaan yang sudah diketahui jawabannya. Penalaran berulang ini memunculkan tiga jenis biaya sekaligus.
Pertama adalah biaya. Computer Use adalah pemanggilan multi-putaran; tangkapan layar setelah setiap langkah operasi tergolong input gambar yang terus mengakumulasi Token. Mengacu pada harga Standard konteks pendek yang diumumkan OpenAI pada 17 November 2026, GPT-6 Astra menetapkan biaya input, output, dan input cache masing-masing 10, 50, dan 1 dolar per juta Token, sedangkan GPT-6 Luna sebesar 0,10, 0,50, dan 0,01 dolar. Dalam evaluasi HealthAdminBench, biaya per tugas Luna adalah 0,085 dolar, 98% lebih rendah daripada Astra; dengan rasio ini sebagai pembanding terbalik, Astra sekitar 4,25 dolar per tugas, namun angka ini hanya estimasi dan merupakan biaya dalam kondisi pengujian benchmark, bukan harga produksi.
Kedua adalah latensi. Setiap langkah harus menunggu model mengembalikan hasil; semakin panjang alurnya, semakin lama waktu tunggunya. Inilah juga alasan mengapa pada penelitian sebelumnya RPA jauh lebih cepat daripada Agent dalam eksekusi P2 dan P3.
Ketiga adalah fluktuasi. Ketika tugas yang sama dijalankan beberapa kali, Agent bisa menempuh jalur yang berbeda; dalam penelitian, tingkat keberhasilan Agent pada P3 hanya 60%. Bagi bisnis yang membutuhkan prediktabilitas dan auditabilitas, ketidakpastian ini lebih sulit diterima daripada biaya.
Oleh karena itu, struktur biaya kedua tahap harus dihitung secara terpisah:
| Pos biaya | Tahap eksplorasi (Agent) | Tahap eksekusi (kode deterministik) |
|---|---|---|
| Token model | Input visual dan teks serta output berbayar tiap putaran dihitung terpisah; Token percobaan ulang yang sudah masuk ke total tidak dihitung dua kali | Nol pada operasi normal |
| Alat dan lingkungan runtime | Layanan yang benar-benar dipakai seperti browser, lingkungan desktop, kontainer | Mesin dan lingkungan browser yang menjalankan kode |
| Investasi rekayasa | Menulis deskripsi tugas, memverifikasi bukti, meninjau kode hasil generasi | Pemantauan, diagnosis anomali, pembaruan kode, dan pengujian |
| Frekuensi kemunculan | Saat alur baru diluncurkan atau alur berubah besar | Setiap eksekusi bisnis |
| Praktik yang disarankan | Pilih model berlapis sesuai kompleksitas: alur rumit memakai model kuat, alur terstruktur memakai model berbiaya rendah | Sebisa mungkin tidak memanggil model, kembali ke Agent hanya saat ada anomali untuk perbaikan |
Ekonomi arsitektur hybrid justru berasal dari tabel ini: pemanggilan model yang mahal terkonsentrasi pada tahap eksplorasi dan perbaikan yang frekuensinya rendah, sementara tahap eksekusi yang frekuensinya tinggi kembali ke kode yang biaya marginal modelnya mendekati nol. Pembukuan nyata tetap harus memperhitungkan investasi pemeliharaan; semakin sering antarmuka diubah, semakin sering kembali ke tahap eksplorasi, dan semakin kecil penghematan yang diperoleh.
💰 Saran biaya: Untuk pemilihan model berlapis pada tahap eksplorasi, sebaiknya uji langsung dengan alur nyata Anda sendiri, bukan menyalin angka benchmark. Melalui APIYI apiyi.com Anda dapat beralih model di bawah satu set antarmuka yang kompatibel dengan OpenAI, dengan penagihan sesuai pemakaian, sehingga memudahkan perbandingan konsumsi Token aktual berbagai model pada tahap eksplorasi dan diagnosis log.
Ada satu persoalan definisi evaluasi yang mudah terlewat. OpenAI mengumumkan skor HealthAdminBench untuk Astra sebesar 94.3% dan Luna 91.8%; keduanya adalah proporsi poin rubrik pada intensitas penalaran tertinggi, bukan tingkat keberhasilan end-to-end. Versi makalah tim Stanford 2604.09937v1 mencakup 135 tugas dan 1698 subtugas (1177 di antaranya dinilai secara deterministik dan 521 oleh penilai model), serta melaporkan tingkat keberhasilan tugas lengkap terbaik sebesar 36.3% (Claude Opus 4.6 CUA) dan tingkat keberhasilan subtugas terbaik sebesar 82.8% (GPT-5.4 CUA); 70 tugas dan 947 titik penilaian yang diungkapkan di situs web versi awal berasal dari versi publik lain dan hanya bisa dijadikan pembanding historis. Angka-angka ini berasal dari model, tanggal, kondisi eksekusi, dan metrik yang berbeda, sehingga tidak dapat disusun dalam satu daftar peringkat yang sama.
Bagi pola “jelajahi dulu, lalu kunci”, tingkat keberhasilan end-to-end lebih penting daripada skor parsial. Codex memerlukan satu lintasan sukses yang utuh; fase eksplorasi bisa benar pada 90% subtugas tetapi tersangkut di langkah pengiriman terakhir, dan Trace yang ditinggalkannya tetap tidak dapat langsung dikunci. Saat memilih model, ukurlah tingkat keberhasilan tugas lengkap dengan alur kerja Anda sendiri.
Tugas Apa yang Cocok untuk Arsitektur Agent Hibrida Gaya CVS?
Menyatukan fakta-fakta di atas akan menghasilkan tabel pembagian tugas kasar berikut:
| Karakteristik Tugas | Cara Eksekusi yang Direkomendasikan | Contoh Umum | Intervensi Manusia |
|---|---|---|---|
| Proses tidak diketahui, dokumentasi minim, antarmuka rumit | Agent mengeksplorasi dan meninggalkan bukti | Pertama kali memetakan jalur operasi sistem lama | Meninjau hasil eksplorasi dan kode yang dihasilkan |
| Proses stabil, pengulangan frekuensi tinggi, status dapat diverifikasi | Dikukuhkan menjadi kode deterministik | Pengiriman file lintas sistem, pemindahan kolom tetap | Uji petik hasil, pantau anomali |
| Sudah tercakup API | Prioritaskan pemanggilan API | Penulisan data terstruktur | Mengikuti manajemen izin normal |
| Antarmuka sering berubah versi | Perkuat pemantauan setelah dikukuhkan, sisihkan anggaran untuk kembali ke eksplorasi | Portal pihak ketiga | Perlu tinjauan setiap kali kode diperbarui |
| Mengubah status bisnis berisiko tinggi | Kode atau Agent hanya sampai draf / menunggu persetujuan | Mengajukan permohonan, mengirim pesan, mengubah catatan | Wajib persetujuan manusia |
Dalam skenario medis, praktik pihak lain juga memberikan referensi. Solusi yang ditunjukkan Ambience membuat Agent berhenti dan bertanya kepada dokter ketika rekam medis ambigu, lalu menunggu persetujuan sebelum mengirim; kasus Assort menempatkan API untuk menangani bagian yang bisa dicakup, sementara Computer Use hanya melengkapi langkah antarmuka yang tidak tercakup API. Kombinasi “API + Computer Use + kode deterministik + persetujuan manusia” lebih realistis daripada bertumpu pada satu teknologi saja.
Perlu ditegaskan bahwa kode deterministik hanya membuat eksekusi dapat diprediksi, tidak menjamin hasilnya benar. Jika pada fase eksplorasi yang dikukuhkan ternyata jalur yang cacat, kode akan secara stabil mengulangi cacat tersebut; dalam operasi lintas sistem, satu kesalahan bahkan bisa tercopy ke beberapa sistem hilir. Karena itu, pemeriksaan status sebelum operasi, verifikasi hasil setelah operasi, hak akses minimal, dan jejak audit menyeluruh tetap tidak boleh dilewatkan setelah pengukuhan. Artikel ini membahas arsitektur engineering, tidak melibatkan saran diagnosis atau pengobatan pasien apa pun.
Bagi tim yang ingin mulai praktik, jalur yang cukup aman adalah: pertama pilih satu proses berisiko rendah dan berulang tinggi di lingkungan non-produksi, jalankan satu putaran penuh eksplorasi, pengukuhan, operasi, dan sekali perubahan antarmuka yang sengaja dibuat, lalu catat biaya pemanggilan model, jam kerja pemeliharaan kode, dan waktu pemulihan kegagalan. Ketiga data ini lebih menjelaskan apakah arsitektur ini layak secara ekonomis di skenario Anda daripada skor benchmark mana pun. Untuk uji perbandingan multi-model di fase eksplorasi, Anda bisa mulai dengan kuota gratis APIYI apiyi.com, lalu berdasarkan hasil pengukuran nyata tentukan model dan cara integrasi untuk deployment resmi.
Alasan solusi CVS layak diperhatikan bukan karena ia mengklaim Agent-nya sangat pintar, melainkan karena ia mengakui keterbatasan Agent dan memakai kepintarannya di tempat yang paling tepat: eksplorasi sekali, kukuhkan jadi kode, rusak lalu perbaiki. Apakah jalur ini bisa diterapkan di lebih banyak perusahaan, pada akhirnya bergantung pada data pengukuran nyata dari proses masing-masing di lingkungan sebenarnya.
The proof of the pudding is in the eating. (Puding enak atau tidak baru diketahui setelah dimakan: hasil nyata harus diuji melalui praktik.)
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami di halaman beranda situs APIYI apiyi.com, materi integrasi lebih lanjut dapat diakses di pusat dokumentasi docs.apiyi.com


