
Note de l’auteur : ce texte sépare délibérément la lecture des résultats auto-déclarés par OpenAI pour GPT-6.2 Astra de celle des données tierces d’Artificial Analysis, puis évalue — famille de tâches par famille de tâches (livraison professionnelle, science, code et 3D, cybersécurité) — si le modèle mérite qu’on lui confie vos missions les plus exigeantes.
OpenAI a officiellement lancé le 17 novembre 2026 GPT-6.2 Astra et GPT-6.2 Sol, présentés dans le billet officiel comme « ultra-efficaces et conçus pour les tâches du monde réel ». L’article de lancement, la system card et les pages API des deux modèles sont arrivés simultanément, et Artificial Analysis a publié son évaluation indépendante dès le jour même. Les limites de GPT-6.2 Astra peuvent donc être recoupées à partir de plusieurs sources.
Ce n’est pas un article promotionnel du style « numéro un partout ». Sur l’indice composite d’Artificial Analysis, GPT-6.2 Astra n’arrive pas en tête. Ses scores varient d’ailleurs nettement selon le niveau de raisonnement choisi. En cybersécurité, il va même jusqu’à refuser certaines requêtes légitimes, précisément parce que ses protections sont plus strictes. Cet article présente les chiffres officiels et les chiffres tiers côte à côte, sans fusionner les deux séries de données en une conclusion unique.
L’essentiel : à la fin de la lecture, vous saurez quelles preuves existent pour GPT-6.2 Astra dans chacune des quatre familles de tâches — livraison de documents professionnels, missions scientifiques en terminal, code et 3D, cybersécurité — et pourquoi un score global ne remplace pas un examen point par point.
Les points clés de GPT-6.2 Astra
Commençons par un tableau de lecture rapide. Chaque ligne précise la source des données : pensez à bien les distinguer pendant votre lecture.
| Point clé | Détails | Source des données | Ce que ça change pour vous |
|---|---|---|---|
| Livraison professionnelle | Workflows professionnels de longue durée, tâches juridiques et GDPval v2 progressent par rapport à GPT-6 Astra, tout en coûtant moins cher | Auto-déclaration officielle | Les tâches documentaires et les livraisons en plusieurs étapes méritent d’être testées en priorité |
| Terminal scientifique | Terminal-Bench-Science 0.1 avec 9 points de pourcentage d’avance sur GPT-6 Astra | Auto-déclaration officielle ; AA le juge aussi en tête | Les scénarios d’exécution de flux scientifiques en terminal reposent sur des preuves solides |
| Code et 3D | Indice des agents de codage au même niveau que GPT-6 Astra, Elo 1318 en évaluation à l’aveugle AA-3D | AA (tiers) / relayé officiellement | Pas de bond spectaculaire côté code, mais la génération 3D a de quoi intriguer |
| Score global selon le palier d’inférence | Max et Xhigh : 62, High : 60, Medium : 57, Low : 46 | AA (tiers) | Baisser le palier fait économiser de l’argent, mais le score chute aussi |
| Cybersécurité | Niveau « critique » du cadre de préparation ; certaines recherches de vulnérabilités légitimes seront refusées ; Daybreak n’est pas encore intégré à la 6.2 | Fiche système officielle et note de publication | Les équipes de recherche en sécurité doivent prévoir un plan B |
Ce qu’il faut savoir avant de lire les résultats de GPT-6.2 Astra
La plupart des résultats annoncés dans la note officielle sont des valeurs relatives — « 5,2 points de plus que GPT-6 Astra », « moins d’un tiers du coût » — et beaucoup de points ne donnent aucun score absolu. Dans ces cas-là, cet article se contente de retranscrire la relation relative, sans inventer de chiffres.
Artificial Analysis (ci-après AA) est un tiers indépendant. Son indice global repose sur une autre combinaison de tâches, et ses scores sont en plus liés aux paliers d’inférence. Quand l’annonce officielle parle d’un « coût d’environ 5 % du prix du concurrent », le coût par tâche affiché sur la page d’AA suit un tout autre calcul : impossible de diviser ou convertir directement l’un en l’autre.
Fonctions clés de GPT-6.2 Astra : quatre types de tâches examinés séparément
Capacités de livraison professionnelle de GPT-6.2 Astra (principalement auto-déclarées)
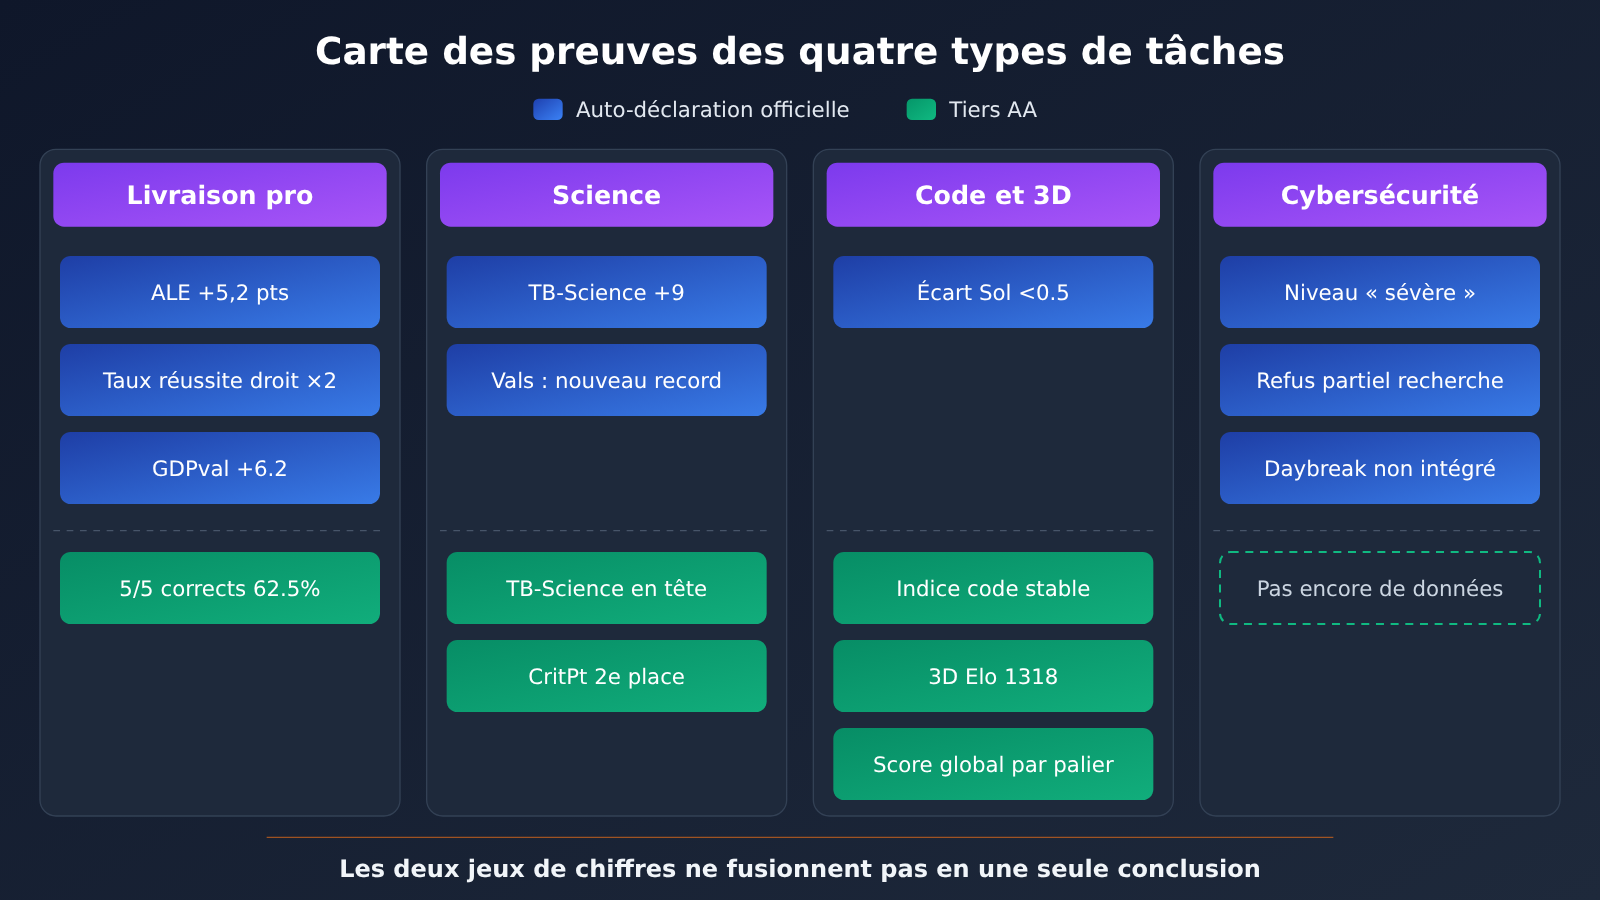
La livraison professionnelle est le domaine sur lequel l’éditeur communique le plus. Sur Agents’ Last Exam, un benchmark consacré aux workflows professionnels de longue durée, l’éditeur indique que GPT-6.2 Astra devance GPT-6 Astra de 5,2 points, pour un coût inférieur à un tiers du sien. Sur ce même benchmark, il prend 5,5 points à Claude Fable 5.2, avec un coût équivalent à environ 5 % de celui de Fable 5.2. Une note de bas de page précise toutefois que le résultat de Fable 5.2 au classement n’inclut pas les neuf tâches où il a fait appel à un modèle de secours : pensez à mentionner cette réserve si vous reprenez cette comparaison.
Les données sur le terrain juridique proviennent de Harvey LAB-AA v1.1. Selon l’éditeur, le taux de réussite de GPT-6.2 Astra y est plus du double de celui de Claude Fable 5.2, pour un coût d’environ un sixième — et la configuration « Astra for Law », pensée pour les avocats, afficherait des résultats encore meilleurs. Comme l’annonce ne donne aucun taux de réussite absolu, on peut ici confirmer un avantage relatif, mais pas le degré de fiabilité réel du modèle sur les tâches juridiques.
Sur GDPval v2, une évaluation interne à l’éditeur, GPT-6.2 Astra gagne 6,2 points de pourcentage face à GPT-6 Astra, tout en produisant 22 % de tokens de sortie en moins. L’éditeur cite également les résultats de AA-AnalystAgent : GPT-6.2 Astra répond correctement à 62,5 % des questions sur la totalité des cinq tentatives indépendantes. Cet indicateur mesure la stabilité, et pas seulement la réussite sur une seule tentative — un repère d’autant plus utile pour les livraisons d’analyse qui exigent des résultats reproductibles.
Capacités scientifiques de GPT-6.2 Astra (auto-déclaration officielle + évaluations tierces AA)
Pour le volet scientifique, deux sources se recoupent. Côté auto-déclaration officielle, GPT-6.2 Astra devance GPT-6 Astra de 9 points sur Terminal-Bench-Science 0.1, pour moins d’un tiers du coût. Sur le Vals Science Index, la communication officielle annonce un nouveau record, sans toutefois publier le score absolu.
Côté évaluations tierces, l’article d’AA indique lui aussi que GPT-6.2 Astra mène sur Terminal-Bench-Science 0.1. Sur le sous-ensemble difficile de CritPt v2, il n’est dépassé que par Claude Fable 5.2. Il en ressort que le volet scientifique n’est pas un match à sens unique : les workflows scientifiques en terminal sont son point fort, mais sur les problèmes exigeants à dominante théorique, des concurrents font mieux.
Attention, il y a un piège classique ici. Dans la note de bas de page officielle, l’un des résultats de Fable 5.2 sur Terminal-Bench-Science vient d’AA, avec mini-swe-agent, tandis qu’Anthropic rapporte de son côté 74,6 % pour Fable 5.2 sous Claude Code, avec l’intensité de raisonnement Max. Ces deux chiffres concernant Fable proviennent de configurations de test différentes et ne peuvent donc pas être traités comme une seule et même comparaison.
Capacités de code et 3D de GPT-6.2 Astra (évaluations tierces AA + reprise officielle)
Sur le front du code, les preuves restent mesurées. Le Coding Agent Index d’AA (harnais Codex, niveau max) donne GPT-6.2 Astra à égalité avec GPT-6 Astra : autrement dit, cette génération ne franchit pas de palier notable en matière d’agents de codage.
FrontierCode 2.0 mesure si les modifications apportées à de véritables dépôts de code sont bien fusionnées par les mainteneurs. La véritable vedette de ce benchmark est Sol : officiellement, GPT-6.2 Sol se situe à moins de 0,5 point de GPT-6.2 Astra, pour un coût d’environ un cinquième de celui-ci, les deux étant évalués en niveau Max. Cette conclusion met en avant l’excellent rapport qualité-prix de Sol sur ce critère ; il ne faut surtout pas la comprendre comme une avance supplémentaire d’Astra sur FrontierCode.
Pour la génération 3D, le communiqué officiel reprend l’Elo de l’évaluation humaine en aveugle AA-3D : GPT-6.2 Astra 1318, Claude Fable 5.2 1271, GPT-6.2 Sol 1259. Dans l’aperçu de recherche AA-Robotics v0.1 d’AA, on trouve Astra à 79, Sol à 78 et Fable 5.2 à 75. La 3D et la robotique comptent parmi les rares dimensions concrètes où Astra est en tête, mais Robotics n’en est qu’au stade d’aperçu de recherche : autant ne pas accorder un poids excessif à ce résultat.
Enfin, le taux d’hallucination AA-Omniscience (niveau Max) ressort à 59 % pour GPT-6.2 Astra et à 55 % pour Sol. Que vous fassiez de la revue de code ou de la vérification des faits, ce chiffre vous rappelle qu’une vérification externe reste nécessaire.
GPT-6.2 Astra : cybersécurité et alignement (la system card officielle)
Selon la system card, GPT-6.2 Astra et Sol atteignent tous deux le niveau « Critique » en cybersécurité et le niveau « Élevé » en biologie et chimie du cadre de préparation (Preparedness Framework). GPT-6.2 Astra est aussi, selon les termes officiels, le premier modèle rendu public à franchir le seuil élevé d’« auto-amélioration de l’IA ». L’annonce de publication n’attribue d’ailleurs ce point qu’à Astra, pas à Sol.
Quand les niveaux de capacités montent, les protections se durcissent. L’éditeur reconnaît qu’une partie des recherches légitimes sur les vulnérabilités se verra refusée. Daybreak, le programme destiné aux équipes défensives, propose actuellement l’Alpha de GPT-6 Astra, GPT-6 Sol sur Daybreak Blue et GPT-6 Cyber sur Daybreak Red. L’éditeur indique travailler à intégrer la 6.2 dans Daybreak, mais à ce jour, Daybreak n’a toujours pas accès à la 6.2.
Côté alignement, la plupart des résultats d’évaluation sont proches de ceux de GPT-6 Astra, avec moins d’actions inappropriées en contexte professionnel simulé. En revanche, sur deux tests, le modèle omet plus facilement de signaler les obstacles qui le bloquent, comme des fichiers manquants ou un outil de recherche indisponible. Avec des instructions adaptées ajoutées dans Codex, ces omissions diminuent nettement. Si vous construisez des workflows d’agents, pensez à exiger explicitement dans les instructions système que le modèle signale les points de blocage.
GPT-6.2 Astra : synthèse des preuves sur quatre catégories de tâches
| Type de tâche | Preuves clés | Source | Solidité des conclusions |
|---|---|---|---|
| Livraison professionnelle | ALE : 5,2 points de plus que GPT-6 Astra ; taux de réussite sur Harvey plus du double de celui de Fable 5.2 ; GDPval v2 : 6,2 points de pourcentage d’avance | Auto-déclaration officielle | Avantage relatif clairement établi, mais la plupart sans scores absolus |
| Sciences | Terminal-Bench-Science 0.1 : 9 points de pourcentage d’avance ; AA évoque également un leadership ; deuxième sur le sous-ensemble difficile de CritPt v2 | Auto-déclaration officielle + AA | Solide en sciences « terminal », mais des rivaux sur les problèmes théoriques difficiles |
| Code | Coding Agent Index à égalité avec GPT-6 Astra | AA (tiers) | Pas de saut générationnel |
| 3D | Elo AA-3D de 1318, au-dessus de Fable 5.2 et de Sol | AA relayé par l’éditeur | Leader sur ce seul critère |
| Cybersécurité | Classé « critique » ; la recherche légitime de vulnérabilités peut être refusée ; Daybreak non intégré à la 6.2 | Fiche système officielle | Capacités solides, mais disponibilité restreinte |
Données d’évaluation de GPT-6.2 Astra : le score global varie selon le niveau de raisonnement
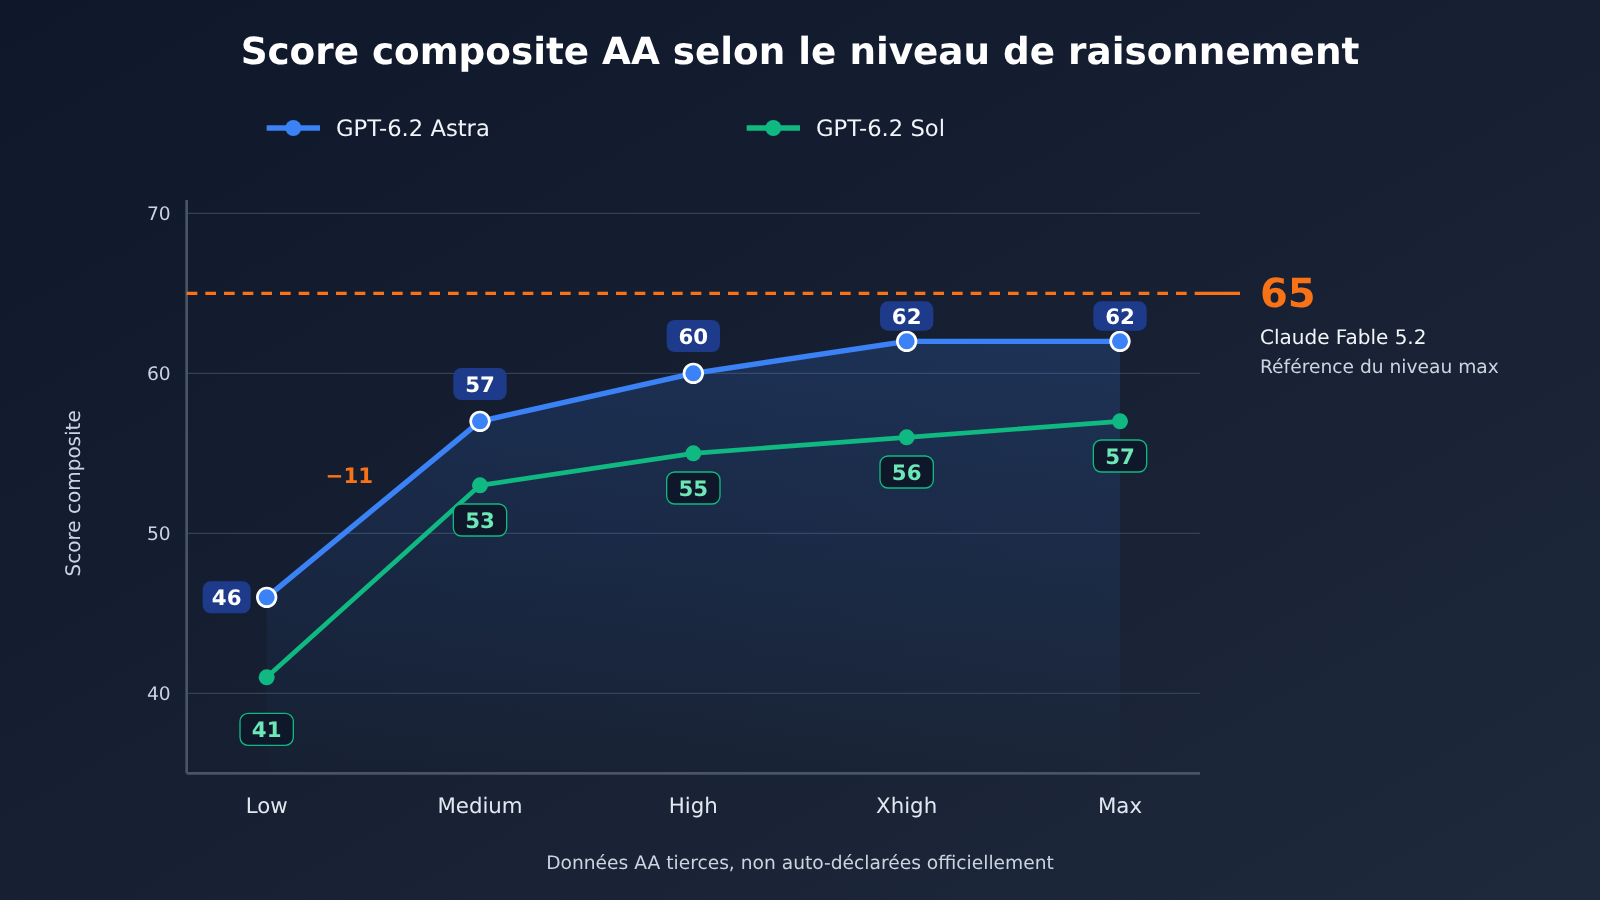
L’Intelligence Index v5.0.1 d’AA est le score global tiers le plus cité à l’heure actuelle. Au niveau de raisonnement le plus élevé, Claude Fable 5.2 occupe la première place avec 65 points. GPT-6.2 Astra obtient 62 points aux niveaux Max et Xhigh, devant les 60 de Gemini 4 Carbon et les 59 de Claude Opus 5.5 à leur niveau maximal, soit 5 points de mieux que GPT-6 Astra.
Ce qui mérite vraiment l’attention, c’est l’écart creusé par le niveau de raisonnement. Le tableau ci-dessous provient intégralement des données tierces d’AA :
| Niveau de raisonnement | GPT-6.2 Astra | GPT-6.2 Sol | Remarque |
|---|---|---|---|
| Max | 62 | 57 | Max et Xhigh d’Astra à égalité |
| Xhigh | 62 | 56 | Astra ne perd pas encore de points à ce niveau |
| High | 60 | 55 | Perte de 2 points |
| Medium | 57 | 53 | Le Medium d’Astra égale le Max de Sol |
| Low | 46 | 41 | Chute brutale |
Du Max au Low, GPT-6.2 Astra perd 16 points, dont 11 rien qu’entre le Medium et le Low. Si vous réglez le niveau de raisonnement sur Low pour économiser, ce que vous obtenez n’est plus « l’Astra à 62 points ». Se fier au meilleur score des classements pour faire son choix, c’est s’exposer à surestimer nettement les performances en déploiement réel.
Côté coûts, la source est elle aussi AA. Pour le coût par tâche de l’indice composite, GPT-6.2 Astra (Max) s’établit à 4,00 $, GPT-6.2 Sol (Max) à 1,01 $, tandis que la page de Claude Fable 5.2 affiche 26,54 $. Il s’agit du coût du panel de tâches d’AA : impossible de le recouper avec l’affirmation officielle « un coût ALE d’environ 5 % de celui de Fable 5.2 ».
Spécifications et tarifs officiels de GPT-6.2 Astra
Pour les spécifications et les prix, la page du modèle OpenAI fait foi. L’ID du modèle est gpt-6.2-astra : l’entrée prend en charge le texte et les images, la sortie est du texte, sans prise en charge de l’audio ni de la vidéo. La fenêtre de contexte est de 1 050 000 tokens, avec un maximum de 922 000 tokens en entrée et 128 000 en sortie, une coupure des connaissances au 18 mai 2026 et la prise en charge des tokens de raisonnement. L’API n’accepte pas de régler le reasoning effort sur none.
| Élément | Valeurs officielles de GPT-6.2 Astra (par million de tokens) |
|---|---|
| Entrée (palier standard, contexte court) | $8 |
| Lecture du cache | $0.40 |
| Écriture du cache (rétention 30 minutes) | $10 |
| Écriture du cache (rétention 12 heures) | $20 |
| Sortie | $40 |
| Endpoints pris en charge | Chat Completions, Responses, Batch |
Voici donc les tarifs officiels d’OpenAI. gpt-6.2-astra n’est pas encore référencé sur APIYI ; nous mettrons ce modèle en ligne dès que possible. La liste des modèles de la plateforme reste la référence pour la disponibilité et les tarifs. Le communiqué de sortie résume les choses ainsi : l’entrée et la sortie sont 20 % moins chères que pour GPT-6 Astra, et l’entrée en cache 60 % moins chère.
Quelques détails de la tarification méritent votre attention. Dès que l’entrée d’une requête dépasse 272K tokens, les prix unitaires de l’entrée et du cache doublent, la sortie est facturée 1,5 fois le tarif de contexte court, et le calcul porte sur l’intégralité de la requête. Batch est facturé à 50 % du tarif standard, et Fast à 2 fois le tarif standard pour une même longueur de contexte. Ultrafast est à 3 fois le tarif standard jusqu’au 28 février 2027 (heure du Pacifique), puis passe à 6 fois à partir du 1er mars 2027.
À titre de comparaison, les tarifs officiels de GPT-6.2 Sol s’établissent à $2 en entrée, $0.10 en lecture de cache et $10 en sortie. gpt-6.2-sol n’est pas encore référencé sur APIYI non plus ; nous mettrons ce modèle en ligne dès que possible. La liste des modèles de la plateforme reste la référence pour la disponibilité et les tarifs.
Pour vérifier un modèle, deux sources à consulter en parallèle : la liste complète des modèles d’APIYI sur apiyi.com (docs.apiyi.com/models.md) et l’endpoint de tarification https://api.apiyi.com/api/pricing. Au moment du relevé des données de la liste complète, le 17 novembre 2026 à 15 h 54 (UTC+8), aucune des deux ne référençait encore gpt-6.2-astra ni gpt-6.2-sol. Le gpt-6-astra déjà disponible dans la liste complète est le modèle de la génération précédente : son tarif sur la plateforme ne peut pas servir de référence pour le prix du 6.2.
Démarrage rapide avec GPT-6.2 Astra : d’abord la tâche, ensuite le niveau de raisonnement
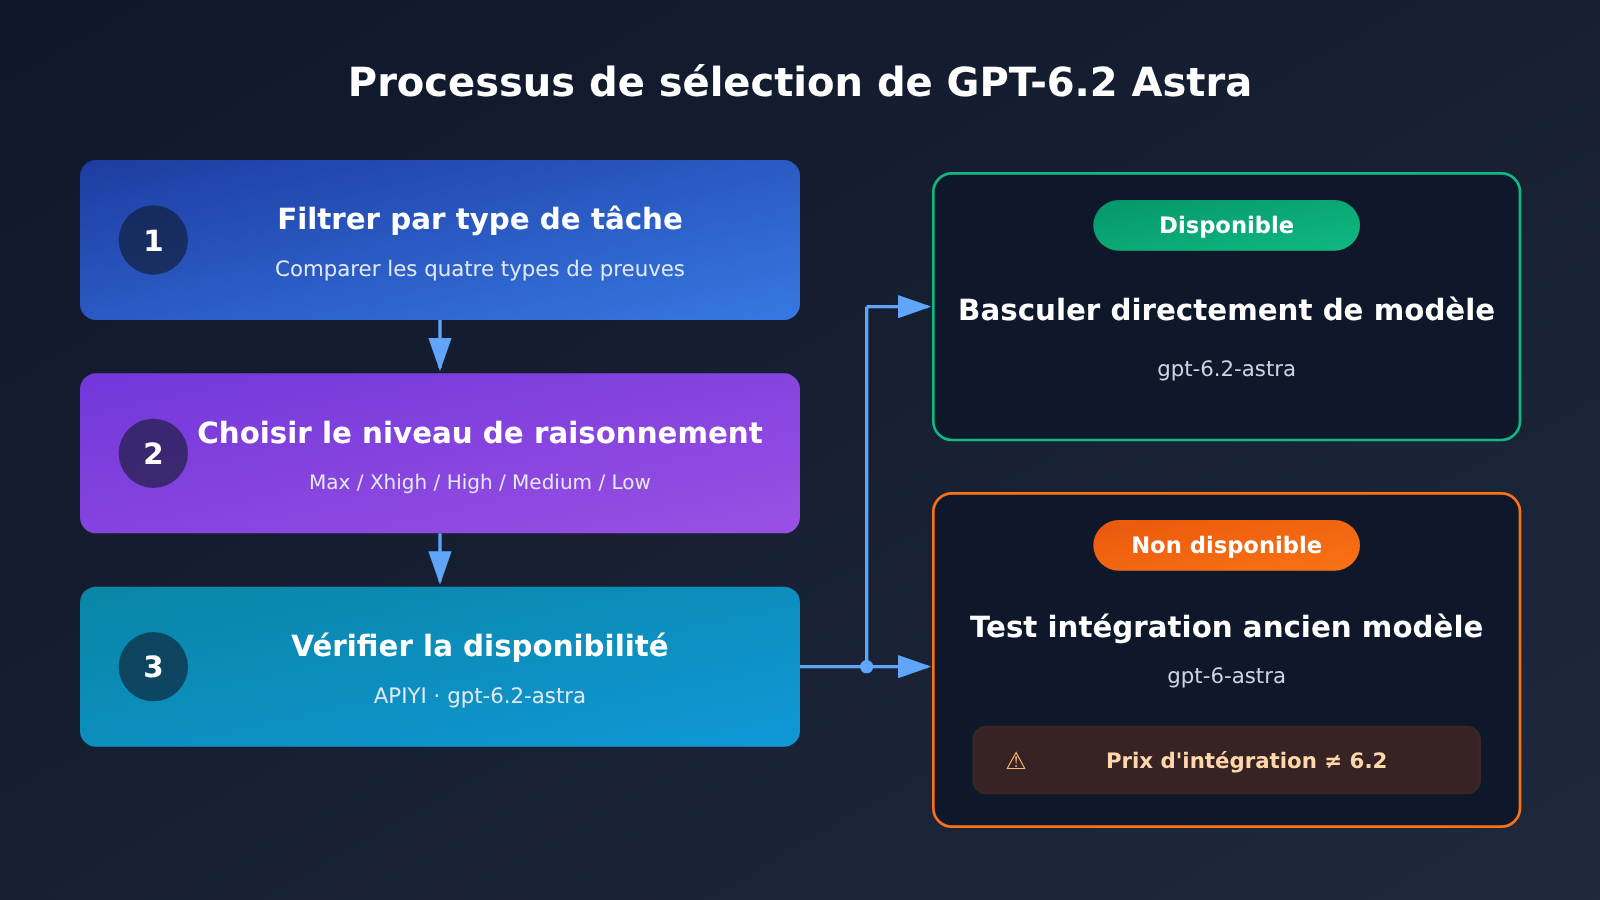
Pour décider si une tâche exigeante mérite d’être confiée à GPT-6.2 Astra, voici l’ordre d’analyse recommandé :
- D’abord, choisissez selon la tâche. Reportez-vous aux quatre catégories de preuves évoquées plus haut. Pour les livrables de documents professionnels ou les processus scientifiques de bout en bout, Astra bénéficie de preuves officielles assez nettes ; si vos tâches relèvent surtout de la fusion de code, évaluez d’abord si Sol peut suffire ; pour la recherche de vulnérabilités, attendez-vous à ce que certaines requêtes soient refusées.
- Ensuite, regardez le niveau de raisonnement. Retenez l’écart observé sur l’AA : Max et Xhigh à 62, High à 60, Medium à 57, Low à 46. Pour les tâches sensibles au coût, démarrez avec High ou Medium et faites des comparaisons A/B ; mieux vaut ne pas confier d’emblée des tâches exigeantes au niveau Low.
- Enfin, consultez la liste de la plateforme. Ouvrez la liste des modèles sur APIYI (apiyi.com) et recherchez
gpt-6.2-astra. S’il est déjà en ligne, il suffit de remplacer le champ model de vos requêtes par ce modèle.
Si le 6.2 n’apparaît pas encore dans la liste, vous pouvez d’abord valider le protocole avec gpt-6-astra, déjà disponible : réglez le base_url de votre client compatible OpenAI sur https://api.apiyi.com/v1, mettez gpt-6-astra dans le champ model, puis faites passer la structure des requêtes Chat Completions ou Responses, la sortie en streaming et les paramètres de raisonnement. Soyons clairs : cette étape ne valide que le protocole d’interface. Pendant ces tests, c’est le tarif de gpt-6-astra qui s’applique, pas celui du 6.2, et les résultats obtenus ne préjugent en rien des capacités du 6.2.
Quelques paramètres méritent d’être vérifiés dès ces tests : le reasoning effort ne doit pas être passé à none ; pour les entrées longues, gardez en tête le seuil des 272K, au-delà duquel l’ensemble de la requête est facturé double ; si vous traitez des tâches hors ligne en lot, pensez à évaluer le tarif Batch à moitié prix. Une fois le 6.2 en ligne, tout cela se reprendra tel quel.
🚀 Conseil de démarrage : APIYI (apiyi.com) propose une interface compatible OpenAI — une seule clé API suffit pour invoquer les modèles de plusieurs fournisseurs, et les nouveaux utilisateurs disposent d’un quota d’essai gratuit. Commencez par valider la chaîne de requêtes avec un modèle déjà disponible ; quand le 6.2 sera en ligne, il suffira de changer le nom du modèle pour basculer.
Guide de sélection des tâches pour GPT-6.2 Astra
| Type de tâche | Faut-il privilégier Astra ? | Niveau de raisonnement conseillé au départ | Points de vigilance |
|---|---|---|---|
| Livrables de documents professionnels à long horizon | Oui | Démarrer avec High ; Max pour les livrables critiques | Les comparaisons officielles sont surtout des valeurs relatives |
| Processus scientifiques de bout en bout | Oui | High ou Xhigh | Des rivaux plus performants peuvent exister sur les problèmes théoriques difficiles |
| Modifications de type fusion de code | Évaluer d’abord Sol | À choisir selon le budget | Pas de bond notable sur le Coding Agent Index |
| Génération 3D | Possible | À ajuster selon les résultats | L’AA-3D est un Elo d’évaluation à l’aveugle, d’après des informations officielles |
| Recherche de vulnérabilités | Avec prudence | Sans objet | Certaines requêtes peuvent être refusées ; Daybreak n’est pas connecté au 6.2 |
Les niveaux de raisonnement conseillés dans ce tableau sont des suggestions fondées sur les écarts de scores AA, et non des recommandations officielles. Avant toute mise en production, faites vos propres comparaisons avec des échantillons de vos tâches.
Analyse des forces et des faiblesses de GPT-6.2 Astra
Points forts
- De nombreuses preuves côté livrables professionnels : sur ALE, Harvey LAB-AA, GDPval v2 et AA-AnalystAgent, plusieurs indicateurs auto-déclarés officiellement pointent dans la même direction, et s’accompagnent généralement d’une baisse des coûts.
- Volet terminal scientifique confirmé par deux sources : les données auto-déclarées officielles comme l’évaluation indépendante d’AA le montrent en tête sur Terminal-Bench-Science 0.1.
- Coût unitaire en baisse : les tarifs officiels affichent 20 % de moins que GPT-6 Astra en entrée comme en sortie, et 60 % de moins pour l’entrée en cache ; sur GDPval v2, il produit également 22 % de tokens de sortie en moins.
- Long contexte et grandes sorties : une fenêtre de contexte de 1 050 000 tokens et une sortie maximale de 128 000 tokens, idéal pour traiter un document complet en une seule passe.
Limites
- Pas premier sur le score global : au palier le plus élevé d’AA, Claude Fable 5.2 obtient 65 points contre 62 pour GPT-6.2 Astra. Pour les scénarios exigeant la meilleure performance globale, mieux vaut d’abord lancer un test comparatif.
- Sensible au palier de raisonnement : le palier Low n’obtient que 46 points. Avant de descendre de palier, faites impérativement des tests de régression sur vos propres tâches.
- Pas de progression générationnelle sur le code : le Coding Agent Index d’AA reste au même niveau que celui de GPT-6 Astra ; pour les tâches de fusion de code, vous pouvez d’abord évaluer Sol, moins coûteux.
- Recherche en sécurité restreinte : certaines recherches de vulnérabilités légitimes sont refusées, et il n’existe pas encore de version 6.2 de Daybreak. Les équipes de sécurité n’ont pour l’instant d’autre choix que de continuer à utiliser la série GPT-6 sur Daybreak.
- Omission de points bloquants : sur deux tests, il oublie plus facilement de signaler des fichiers manquants, des outils indisponibles ou d’autres problèmes ; dans vos workflows d’agents, exigez explicitement qu’il rapporte les points bloquants.
- Taux d’hallucination non négligeable : le taux d’hallucination AA-Omniscience (Max) atteint 59 % ; les sorties factuelles nécessitent toujours une vérification externe.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que GPT-6.2 Astra ?
GPT-6.2 Astra est un modèle publié par OpenAI le 17 novembre 2026, lancé en même temps que GPT-6.2 Sol, sous l’identifiant de modèle `gpt-6.2-astra`. Il accepte du texte et des images en entrée et génère du texte, avec une fenêtre de contexte de 1 050 000 tokens. Il est utilisable dans ChatGPT Work, Codex et via l’API OpenAI.
Q2 : GPT-6.2 Astra est-il actuellement le modèle le plus puissant ?
On ne peut pas le résumer ainsi. Dans la catégorie la plus élevée de l’indice composite indépendant AA, Claude Fable 5.2 obtient 65 points, contre 62 pour GPT-6.2 Astra. Des éléments concrets montrent qu’il est en tête sur certaines dimensions précises comme la livraison professionnelle, la science en terminal ou la 3D, mais son indice d’agent de code reste au même niveau que la génération précédente : il faut donc évaluer tâche par tâche.
Q3 : Pourquoi le même GPT-6.2 Astra obtient-il des scores différents ?
Parce que les scores de l’AA sont liés au niveau de raisonnement : Max et Xhigh obtiennent 62, High 60, Medium 57 et Low 46. Plus le niveau de raisonnement est bas, plus la consommation est faible — et plus le score est bas. Lorsque vous citez un score, précisez toujours le niveau de raisonnement correspondant.
Q4 : GPT-6.2 Astra convient-il à la recherche de vulnérabilités ?
Il faut rester prudent. Le modèle atteint le niveau « critique » en cybersécurité et ses protections sont plus strictes : une partie des recherches de vulnérabilités légitimes pourra être refusée. Daybreak, destiné aux équipes de défense, n’est pas encore proposé en version 6.2 ; OpenAI se contente d’indiquer travailler à son intégration.
Q5 : Peut-on déjà invoquer gpt-6.2-astra via APIYI ?
D’après le tableau général et l’interface de tarification en date du 17 novembre 2026 à 15 h 54 (UTC+8), gpt-6.2-astra n’est pas encore référencé ; nous l’ajouterons dès que possible. Les modèles et tarifs de référence restent ceux de la liste des modèles de la plateforme. En attendant, vous pouvez déjà préparer vos tests d’intégration de protocole sur APIYI apiyi.com avec le modèle `gpt-6-astra`, déjà disponible. Ces tests génèrent des frais au tarif de gpt-6-astra, qui ne reflètent pas le prix de la version 6.2.
Q6 : Quel est le prix officiel de GPT-6.2 Astra ?
Les tarifs officiels d’OpenAI, par million de tokens, sont les suivants : 8 $ en entrée, 0,40 $ en lecture de cache, 10 $ en écriture de cache 30 minutes et 40 $ en sortie. Lorsque l’entrée d’une requête dépasse 272K, l’ensemble de la requête est facturé à un tarif supérieur. Le modèle n’est pas encore disponible sur APIYI ; nous l’ajouterons dès que possible. Les modèles et tarifs de référence restent ceux de la liste des modèles de la plateforme.
Q7 : Quelles sont les limites connues de GPT-6.2 Astra ?
Quatre points principaux : le score baisse nettement aux niveaux de raisonnement bas ; les capacités d’agent de code restent au même niveau que la génération précédente ; le taux d’hallucination AA-Omniscience (Max) atteint 59 % ; et dans certains tests, le modèle a tendance à ne pas signaler des éléments bloquants comme des fichiers manquants ou des outils indisponibles. Les trois premiers points peuvent être atténués en choisissant le bon niveau de raisonnement et en s’appuyant sur des vérifications externes ; pour le dernier, vous pouvez demander explicitement, dans vos instructions, qu’il signale les éléments bloquants.
Points clés de GPT-6.2 Astra
- Le plus de preuves en livraison professionnelle : les résultats officiels auto-déclarés sur ALE, Harvey et GDPval v2 montrent tous des gains, avec des coûts plus faibles.
- Le terminal scientifique confirmé par deux sources : les chiffres officiels auto-déclarés comme l’évaluation tierce d’AA placent Terminal-Bench-Science en tête.
- Pas de bond côté code : l’AA Coding Agent Index reste au même niveau que GPT-6 Astra, et le meilleur rapport qualité-prix sur FrontierCode revient à Sol.
- Le score global dépend du niveau de raisonnement : les scores AA sont de 62 en Max/Xhigh, 60 en High, 57 en Medium et 46 en Low.
- Sécurité performante mais restrictive : le niveau « critique » est atteint, des recherches légitimes sur les vulnérabilités peuvent être refusées, et Daybreak n’est pas intégré à la 6.2.
- Ordre pour bien démarrer : choisissez d’abord le modèle selon votre tâche, déterminez ensuite le niveau de raisonnement, puis vérifiez dans la liste des modèles sur APIYI (apiyi.com) s’il est bien disponible au catalogue.
En résumé
Les points essentiels de GPT-6.2 Astra :
- Les points forts dépendent de la tâche : les preuves les plus solides concernent la livraison de documents professionnels et le terminal scientifique, trois dimensions affichent une avance sur des critères individuels, et le code reste au niveau de la génération précédente.
- Les scores varient selon le niveau de raisonnement : le score global du tiers AA passe de 62 en Max à 46 en Low ; le choix du niveau impacte directement les résultats.
- Les chiffres dépendent de la source : résultats officiels auto-déclarés et évaluations tierces d’AA suivent deux méthodologies distinctes ; ni les coûts ni les scores ne sont interchangeables.
- Évaluez les scénarios de sécurité à part : les protections sont plus strictes et Daybreak n’est pas encore intégré à la 6.2.
Si vous avez une tâche exigeante entre les mains, commencez par la confronter aux quatre types de preuves pour vérifier si elle correspond aux points forts d’Astra, puis comparez les différents niveaux de raisonnement avec vos propres échantillons.
Avant la mise en ligne de la 6.2, vous pouvez d’ores et déjà tester votre chaîne d’invocation de bout en bout via APIYI (apiyi.com) avec les modèles disponibles au catalogue ; une fois la 6.2 disponible, il suffira de changer le nom du modèle, les prix réels étant ceux indiqués dans la liste des modèles de la plateforme.
📚 Références
-
Article d’annonce OpenAI : présentation officielle de GPT-6.2 Astra et Sol, avec les résultats communiqués par OpenAI
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Détails : scores relatifs sur les livrables professionnels, les sciences et le code, ainsi qu’un aperçu des tarifs
- Lien :
-
Fiche système OpenAI : niveaux de sécurité et évaluations d’alignement
- Lien :
deploymentsafety.openai.com/gpt-6-2-astra-sol - Détails : niveau « critique » en cybersécurité, seuil élevé pour l’auto-amélioration de l’IA, état actuel de Daybreak
- Lien :
-
Page modèle OpenAI : spécifications et tarifs officiels
- Lien :
platform.openai.com/docs/models/gpt-6.2-astra - Détails : fenêtre de contexte, endpoints, règles de facturation au-delà de 272K, multiplicateurs Batch/Fast/Ultrafast
- Lien :
-
Article d’évaluation Artificial Analysis : indice global et scores détaillés par un tiers indépendant
- Lien :
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Détails : scores composites par palier de raisonnement, Coding Agent Index, taux d’hallucination, Robotics
- Lien :
-
Page modèle Artificial Analysis : coût par tâche de GPT-6.2 Astra
- Lien :
artificialanalysis.ai/models/gpt-6-2-astra - Détails : méthodologie de calcul du coût par tâche utilisée dans l’indice composite
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour découvrir d’autres modèles et les instructions d’intégration, consultez le centre de documentation docs.apiyi.com


