
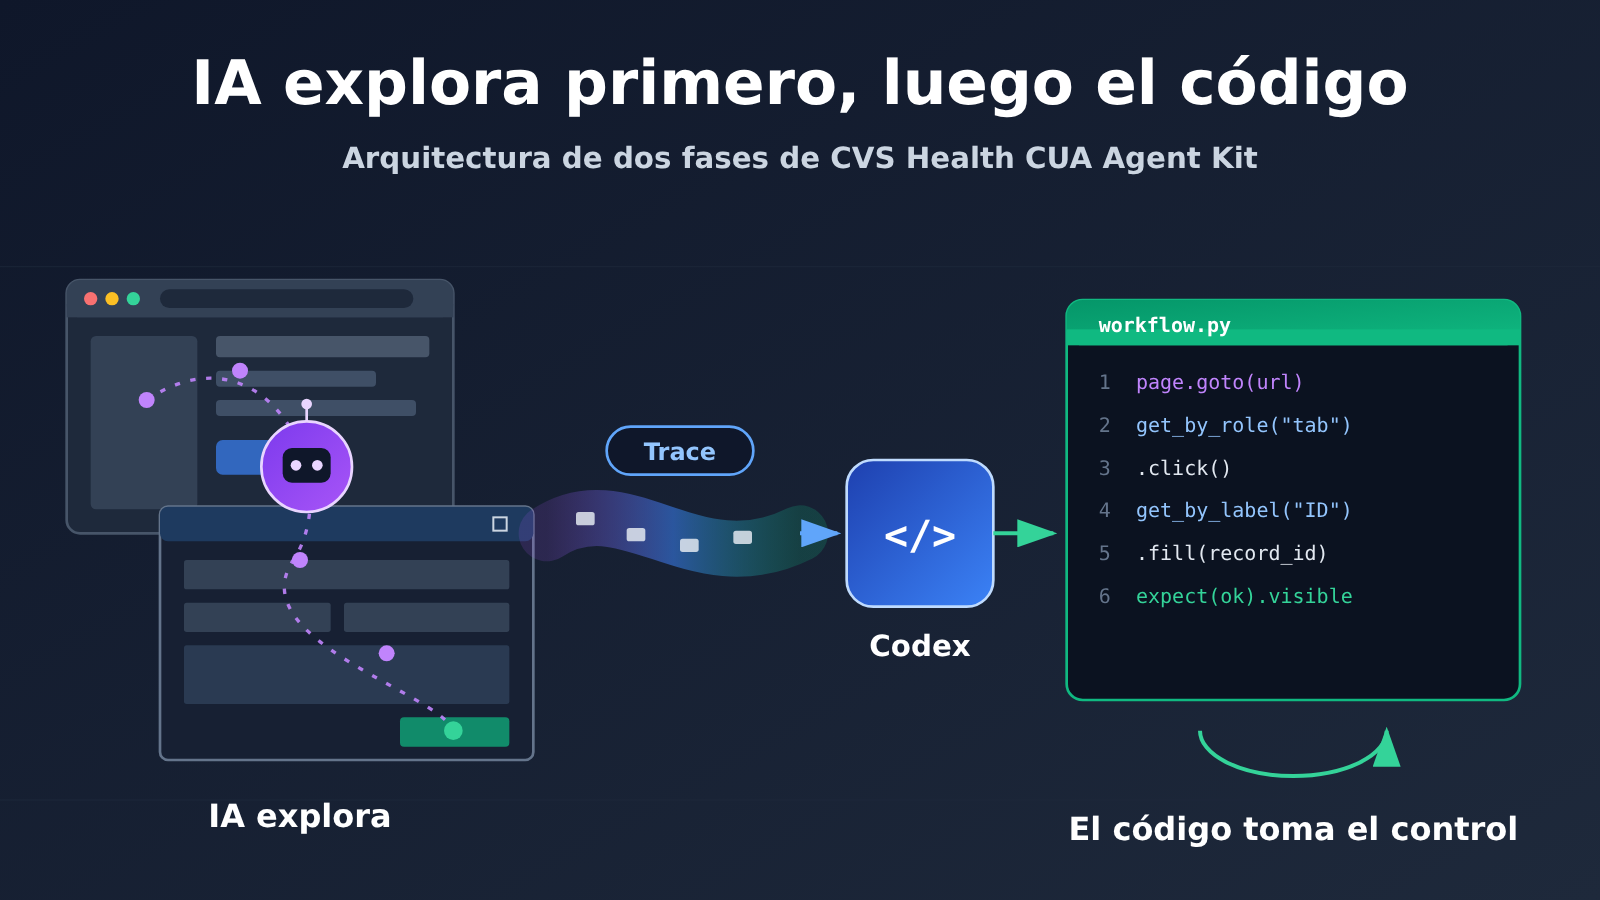
Los agentes empresariales no necesitan invocar al Modelo de Lenguaje Grande en cada tarea repetitiva. El CUA Agent Kit de código abierto de CVS Health propone una ruta de ingeniería más económica: primero, un agente de uso de computadora (Computer-use Agent) explora un proceso de negocio desconocido y registra el proceso exitoso en capturas de pantalla, eventos y Trace; después, Codex convierte esa evidencia en código determinista, revisable, mantenible y ejecutable de forma repetible.
Este enfoque combina la capacidad de exploración flexible de la IA con la estabilidad de ejecución de la automatización tradicional, dando forma a una arquitectura híbrida en la que “la IA explora, el código se consolida y el mantenimiento continúa”. No se trata de que el agente sustituya a los scripts, sino de que escriba y repare scripts.
¿Qué aprenderá leyendo este artículo?
- Cómo el CUA Agent Kit de CVS Health completa el flujo de dos fases, desde la exploración con IA hasta la consolidación en código
- Qué papel desempeñan las capturas de pantalla, events.jsonl, el Trace y los localizadores semánticos en la fase de consolidación
- Cómo se ejecuta un flujo fijo sin invocar al Modelo de Lenguaje Grande y cómo se mantiene cuando aparece una anomalía
La sección de hechos objetivos que sigue presenta, en orden: el mecanismo de funcionamiento de CUA Agent Kit, qué ocurre entre la operación con IA y el código de Playwright, qué tareas de mantenimiento sigue asumiendo el agente después de la consolidación, qué base de investigación respalda las diferencias entre esta arquitectura y la RPA tradicional, y cómo los desarrolladores pueden reutilizarla en la práctica. La sección de análisis y juicio aborda dos preguntas: por qué es un desperdicio que el agente vuelva a pensar desde cero cada vez, y qué tareas encajan en esta arquitectura híbrida y cuáles deben mantener una revisión humana.
Para conocer: 7 conceptos para entender la ruta de automatización de CVS Agent
| Concepto | Explicación breve |
|---|---|
| Computer Use | Capacidad de completar tareas observando la interfaz del software y ejecutando acciones como clics e introducción de texto |
| EHR | Sistema de historia clínica electrónica; software central que utilizan las instituciones sanitarias para almacenar y procesar historiales de pacientes |
| MCP | Protocolo estándar para descubrir e invocar herramientas externas |
| RPA | Forma de automatización que ejecuta procesos repetitivos mediante reglas o programas preconfigurados |
| Rubric points | Puntos de puntuación divididos según las reglas de evaluación, que miden el cumplimiento de requisitos parciales |
| Tasa de éxito de extremo a extremo | Proporción de tareas completas que cumplen todas las condiciones de éxito |
| Trace | Evidencia de seguimiento que registra el proceso de ejecución, las operaciones y los estados de página |
Resumen de impactos: quién se ve afectado por la ruta de automatización de CVS Agent
- Desarrolladores y responsables técnicos: lo importante no es “usar o no un Agent”, sino dividir el mecanismo de ejecución según la tarea. Hay que verificar por separado la tasa de finalización en la fase de exploración, la estabilidad del código consolidado y el coste total, incluido el mantenimiento, en lugar de fijarse solo en el precio de una única invocación del modelo.
- Instituciones sanitarias y responsables de flujos de trabajo: es necesario distinguir entre demos sintéticas, evaluaciones de proveedores, casos públicos de empresas y pilotos propios, porque el peso de cada tipo de evidencia es distinto. En los pasos que implican datos de pacientes y cambios de estado, deben establecerse de antemano la aprobación humana, los privilegios mínimos y la trazabilidad de las operaciones.
Hechos objetivos: la ruta de dos fases del CUA Agent Kit de CVS Health
Primero, pongamos el contexto. El 16 de noviembre de 2026, OpenAI presentó avances de Computer-use Agent orientados a equipos médicos, publicó resultados de evaluación en tareas clínicas y administrativas del ámbito sanitario, así como prácticas de colaboración con organizaciones como CVS Health, Cigna Healthcare, Abridge y Ambience. CVS Health reveló allí casos en entorno de producción y liberó como código abierto el CUA Agent Kit, con licencia Apache-2.0.
Los resultados de producción que CVS Health hizo públicos incluyen: un Agent en cierto flujo de trabajo de producción liquidó durante un fin de semana una acumulación de meses de tareas de envío de documentos; otro Agent procesa cada día decenas de miles de pasos de operación de sistemas en consultas de especialistas. El sistema incorpora verificaciones y supervisión humana, y contrasta la operación real con el estado de la aplicación mediante capturas de pantalla y registros de operaciones. Conviene tener presente que todos estos son datos divulgados por la propia empresa. La cifra de «decenas de miles» se refiere a pasos de operación de sistemas relacionados con las consultas, y no implica que decenas de miles de decisiones clínicas las haya completado la IA de forma autónoma. El material público tampoco aclara si estos Agent en producción se construyeron íntegramente sobre la versión de código abierto del Agent Kit, por lo que no conviene equiparar sin más ambos casos.
Fuente: openai.com/index/advancing-computer-use-for-healthcare-teams/
¿Cómo funciona el CUA Agent Kit de CVS Health?
El README del proyecto define su alcance con franqueza: es un kit inicial para automatizar flujos de trabajo de navegador y Windows, que usa IA para descubrir los pasos y luego código para repetirlos. El proyecto subraya especialmente que «entender cómo se hace una tarea» y «repetirla de forma estable a largo plazo» son dos problemas distintos, y que conviene resolverlos con medios distintos.
Todo el flujo se divide en dos fases:
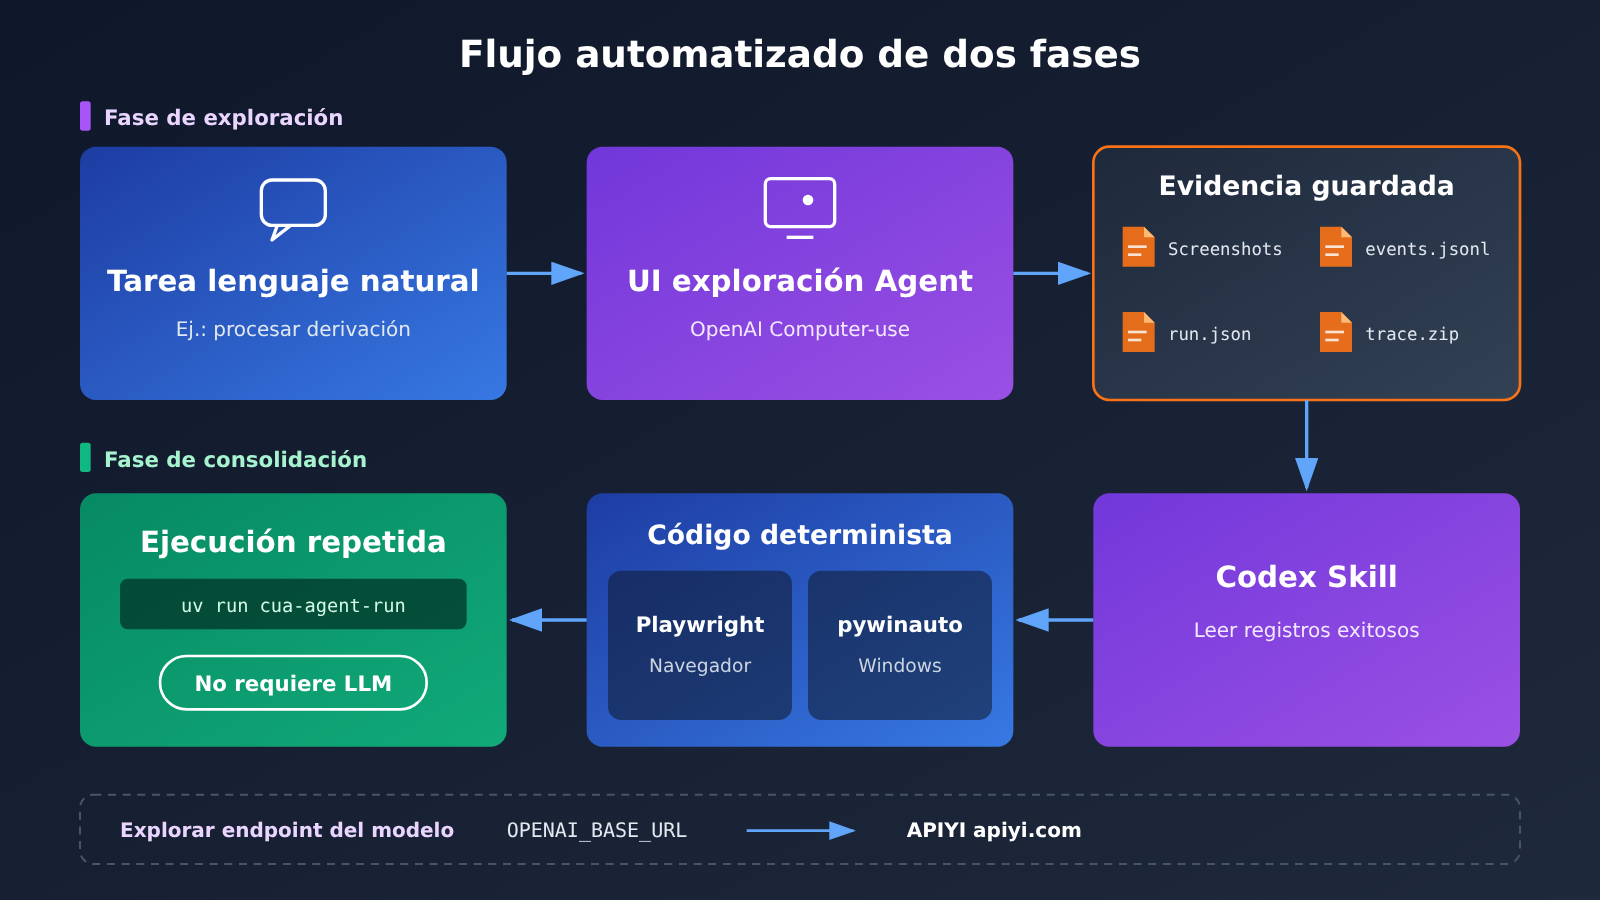
- Fase de exploración: el Computer-use Agent de OpenAI recibe una tarea descrita en lenguaje natural, por ejemplo «localizar cierto registro y gestionar una derivación», y explora, ejecuta y verifica en la interfaz real. Durante el proceso guarda capturas de pantalla, acciones de operación, objetivos de operación y trazas de ejecución.
- Fase de consolidación: Codex Skill lee los registros de exploración ya exitosos y genera o actualiza el código determinista del flujo de trabajo. A partir de ahí, la ejecución repetida del mismo flujo queda en manos de código convencional, y el Modelo de Lenguaje Grande ya no tiene que razonar de nuevo en cada ocasión.
Las evidencias que deja la fase de exploración son archivos volcados a disco, no razonamientos que se quedan dentro del modelo. Los tipos de registro que el README hace públicos son estos:
| Registro | Uso principal | Valor en la fase de consolidación |
|---|---|---|
| Screenshots | Registra el estado de la interfaz en cada paso | Permite a ingenieros y a Codex verificar cómo es realmente la página |
| events.jsonl | Registra los eventos de operación línea a línea | Reconstruye «qué se hizo y en qué orden» |
| run.json | Registra la información de esta ejecución | Distingue entre ejecuciones y determina si tuvieron éxito |
| trace.zip | Traza de ejecución de Playwright | Aporta detalles de elementos, red y temporización para generar y diagnosticar código |
Fuente: github.com/cvs-health/cua-agent-kit
De la operación de IA al código Playwright: ¿qué hace CVS Agent Kit?
Uno de los detalles más importantes de la fase de consolidación es este: lo que se genera no es una «repetición de coordenadas del mouse». Cuando CVS generó flujos de trabajo de navegador, utiliza localizadores semánticos (Semantic Locators) para producir código Playwright, localizando el objetivo a través de características semánticas como el rol y el nombre del elemento, en lugar de memorizar unas coordenadas de pantalla concretas.
La diferencia entre ambas opciones se nota soprattutto al hacer mantenimiento. La reproducción por coordenadas depende de la resolución, el tamaño de la ventana y los ajustes de layout; basta que el botón se desplace unos pocos píxeles para que el clic falle, y cuando algo sale mal resulta difícil deducir, de una simple lista de coordenadas, qué se pretendía clicar. El código escrito con localizadores semánticos viene a decir algo como «haz clic en el botón llamado ‘Enviar'»: la intención queda escrita en el código, el ingeniero puede revisarla directamente y, ante ajustes parciales de la página, es menos probable que deje de funcionar. Dicho esto, si el botón cambia de nombre o el flujo se rediseña, los localizadores semánticos también fallan; simplemente, el fallo es más fácil de localizar.
El reparto de herramientas del proyecto es el siguiente:
- Playwright: se encarga de la ejecución determinista de los flujos de trabajo del navegador y genera trayectorias reproducibles como trace.zip.
- pywinauto: se encarga de la automatización de aplicaciones de escritorio Windows, cubriendo sistemas antiguos sin interfaz web.
- Codex Skill: lee las trayectorias de exploración que han tenido éxito y genera o actualiza los dos tipos de código anteriores.
Esta idea está alineada con la dirección de la documentación oficial de OpenAI. La guía Computer Use de OpenAI presenta dos caminos: uno en el que el modelo devuelve acciones estructuradas de ratón y teclado, que ejecuta la aplicación; y otro en el que el modelo genera código y opera la interfaz con ayuda de herramientas como Playwright. La documentación recomienda la ejecución de código para GPT-6 Astra, mientras que Computer Tool sigue como opción. ComputerToolset, BrowserToolset y la entrada de navegador alojado se explican por separado en la guía oficial.
Fuente: developers.openai.com/api/docs/guides/tools-computer-use
Una vez consolidado el flujo, ¿qué más tiene que hacer el Agent de CVS Agent Kit?
Con el flujo ya consolidado, la ejecución determinista se lanza con el comando que indica el README:
uv run cua-agent-run
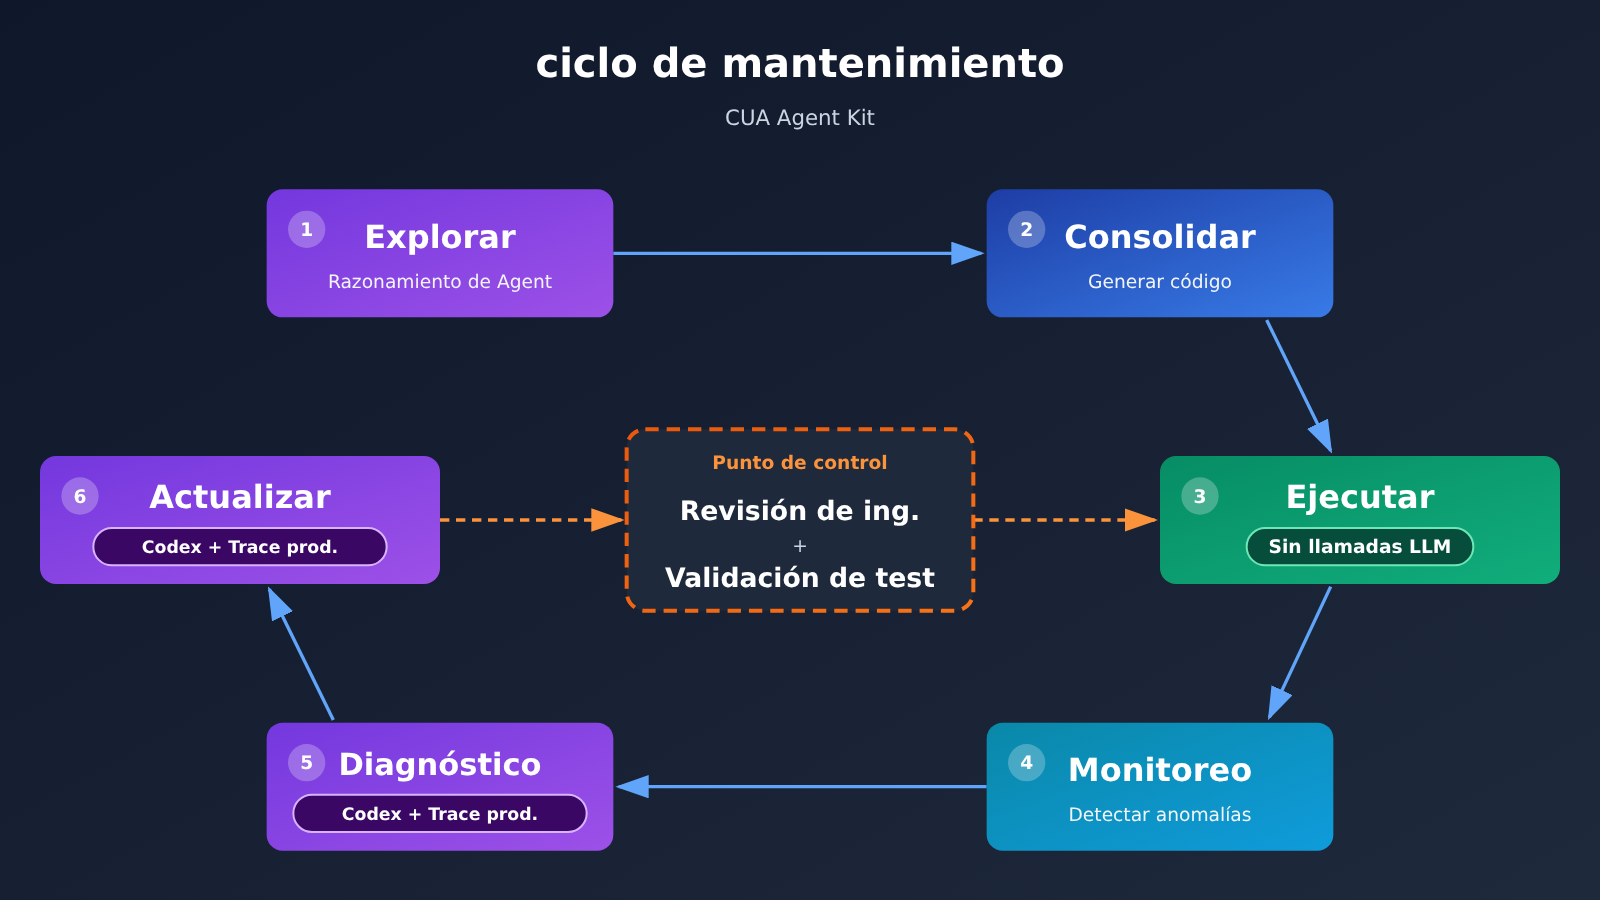
En esta etapa no hace falta invocar el Modelo de Lenguaje Grande en cada pasada, ni tampoco una clave API. Pero el proyecto no entiende la «consolidación» como algo definitivo y para siempre. El mecanismo de mantenimiento que describe el README es un ciclo cerrado:
- El flujo de trabajo fijo se ejecuta según lo planificado;
- Se detectan anomalías en las trazas (Trace) de producción;
- Codex usa las trazas para diagnosticar el problema;
- Se actualiza el código determinista;
- Un ingeniero revisa los cambios;
- Tras superar las pruebas y la validación, vuelve a entrar en el ciclo de ejecución repetida.
Dicho de otro modo, el rol del Agent pasa de «hacerlo todo en persona cada vez» a «no estar presente normalmente y aparecer cuando surge un problema para arreglar el código». El código falla, las interfaces cambian de versión; el proyecto lo da por sentado desde el principio, y precisamente por eso diseñó las fases de diagnóstico y revisión.
¿En qué se diferencia la automatización híbrida con Agent de CVS del RPA tradicional?
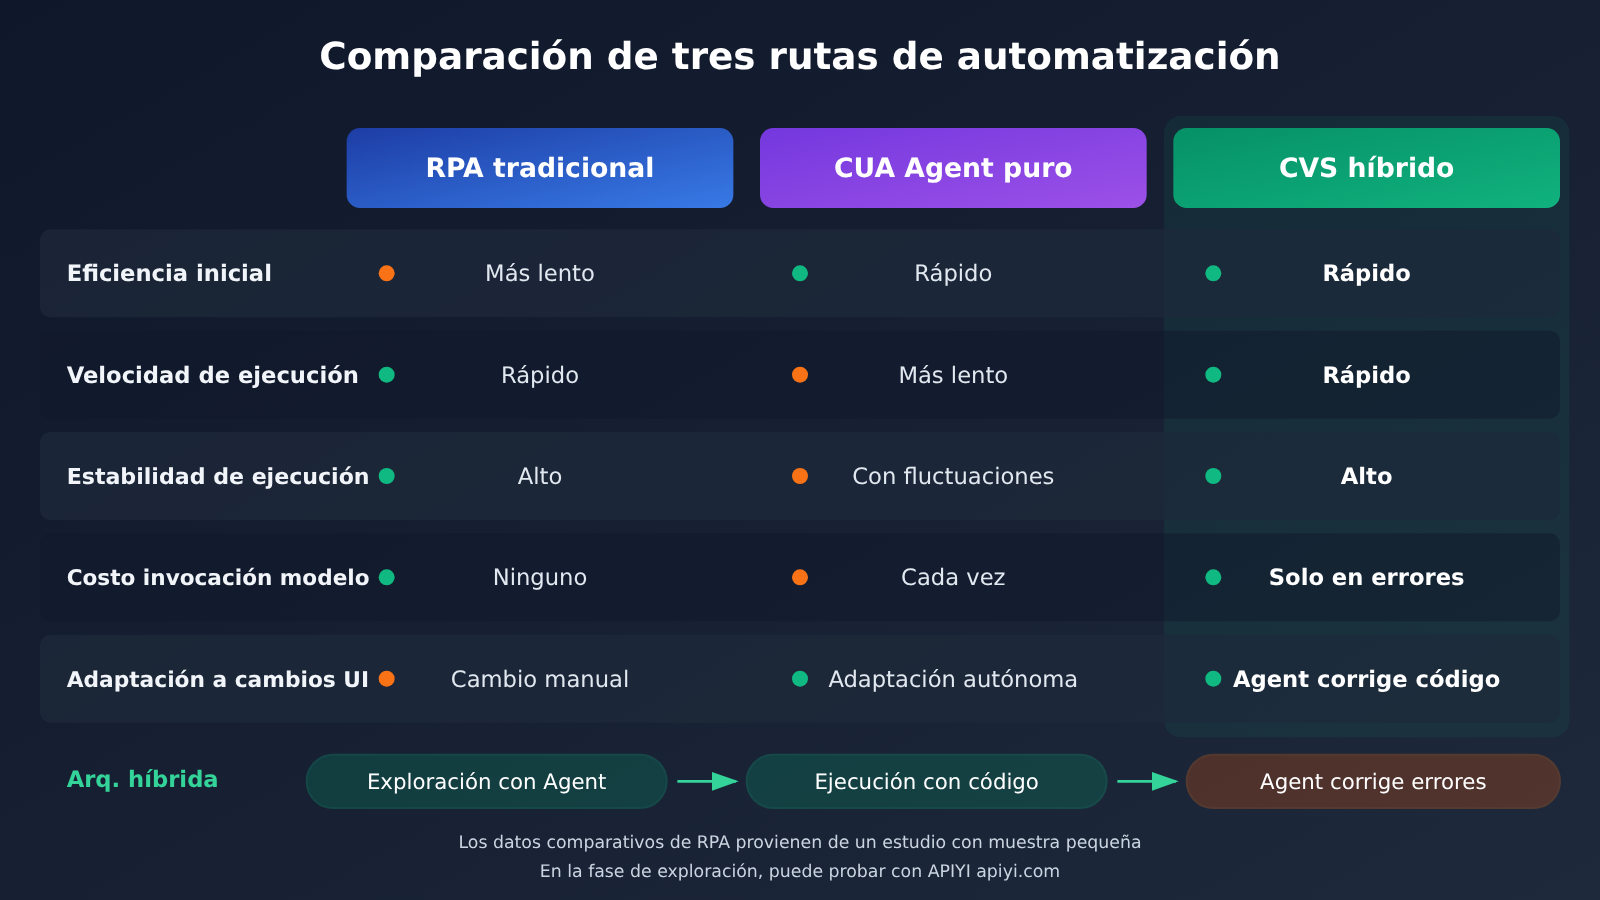
El RPA tradicional depende de pasos preconfigurados y de la localización de elementos de la interfaz; se ejecuta rápido y ofrece resultados estables, pero el desarrollo y el mantenimiento frente a cambios de versión requieren trabajo manual. Un Agent puro puede entender lenguaje natural y adaptarse a los cambios de interfaz, pero razonar de nuevo en cada ejecución implica costos y variabilidad en los resultados. El CUA Agent Kit se sitúa entre ambos: usa un Agent para sustituir el paso de “grabar y escribir el flujo manualmente”, mientras que la fase de ejecución vuelve a código determinista.
Para una comparación directa entre ambos, puede consultarse un estudio publicado en 2026: Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks (DOI: 10.1080/23311975.2026.2724760). El estudio se realizó entre mayo y junio de 2025, comparó UiPath Studio 2023.4.0 con Anthropic Computer Use Agent y abarcó tres tipos de tareas estándar: entrada de datos, monitoreo y extracción de documentos.
| Tarea | Tasa de éxito de RPA | Tasa de éxito del Agent | Tiempo inicial de desarrollo (observación de un solo desarrollador) |
|---|---|---|---|
| P1 | No incluida en el recuento comparativo | El Agent falló en su única ejecución y no entró en el recuento posterior | No divulgado |
| P2 | 100% (10 ejecuciones) | 90% (10 ejecuciones) | Agent: aprox. 10 minutos; RPA: aprox. 38 minutos |
| P3 | 100% (10 ejecuciones) | 60% (10 ejecuciones) | Agent: aprox. 15 minutos; RPA: aprox. 240 minutos |
El estudio también encontró que el RPA fue significativamente más rápido en P2 y P3; los problemas del Agent incluyeron fallos en las operaciones de interfaz, pérdida de contexto y errores de juicio; el Agent tiene una ventaja potencial para adaptarse a interfaces dinámicas.
Conviene aclarar los límites de este estudio:
- Muestra muy pequeña: P2 y P3 incluyen 10 ejecuciones por técnica; P1 no equivale a “10 ejecuciones por técnica”, por lo que no se puede generalizar.
- El tiempo de desarrollo es solo una observación preliminar: proviene de un único desarrollador, no tiene representatividad estadística y no debe tomarse como promedio del sector.
- Las versiones de las herramientas están algo desactualizadas: el estudio utilizó una configuración de Agent de 2025, que no puede representar el desempeño de los nuevos modelos de 2026.
Aun así, la dirección de las conclusiones coincide con el diseño de CVS: el Agent destaca en la exploración rápida y en el manejo flexible, mientras que la ejecución determinista al estilo RPA sigue teniendo ventajas en tareas repetitivas y estables.
Fuente: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
¿Cómo pueden los desarrolladores reutilizar el enfoque de CVS CUA Agent Kit?
El README enumera pocos requisitos de entorno:
- Python 3.12 o superior;
- uv (herramienta de gestión de paquetes y proyectos de Python);
- un sitio web objetivo o una aplicación de escritorio accesible;
- la fase de exploración requiere
OPENAI_API_KEY; - se puede configurar un endpoint de API personalizado mediante
OPENAI_BASE_URL.
El uso corresponde a tres fases: descubrimiento (el agente explora y deja evidencia), consolidación (Codex genera código) y ejecución (ejecución determinista). Para los comandos y parámetros concretos de las fases de descubrimiento y consolidación, consulta el README del repositorio; la fase de ejecución es la ya mencionada uv run cua-agent-run.
Vale la pena prestar atención al diseño de OPENAI_BASE_URL. Significa que el endpoint del modelo en la fase de exploración puede apuntar a la API oficial, al gateway interno de la empresa o a otros servicios compatibles con la interfaz de OpenAI, lo que facilita una autenticación, facturación y auditoría unificadas. Las variables de entorno de la fase de exploración se pueden configurar así:
# Fase de exploración: requiere la API del modelo
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # Usa la interfaz unificada de APIYI, o cámbiala por tu gateway

# Fase de ejecución: ejecución determinista, no requiere clave API
uv run cua-agent-run
Hay que destacar un punto: Computer Use depende de capacidades específicas de la Responses API y de tipos de herramientas concretos. Antes de cambiar a cualquier endpoint personalizado, confirma que ese endpoint admite los modelos y herramientas que necesita la fase de exploración; valida con un flujo sencillo antes de generalizarlo.
Después de la consolidación, la tarea más habitual en el mantenimiento diario es leer el Trace y los registros de eventos. A continuación, un ejemplo de script auxiliar: pasa el events.jsonl de una ejecución a un Modelo de Lenguaje Grande general para que organice una lista de pasos y posibles puntos de fallo, que sirva de referencia en la revisión de ingeniería. Los campos concretos de events.jsonl dependen de la salida real del proyecto; aquí solo se lee línea por línea. Si hay datos sensibles, como información de pacientes, asegúrate de anonimizarlos primero o procésalos únicamente en un entorno conforme a la normativa.
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """Lee un events.jsonl ya anonimizado y genera una lista de pasos y posibles puntos de fallo"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # Controla la longitud del contexto
    prompt = (
        "以下是一次界面自动化运行的事件日志。"
        "请按顺序列出操作步骤,并指出最可能导致失败的步骤及原因,"
        "只基于日志内容,不要臆测。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # Reemplaza con el modelo realmente disponible en tu plataforma
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
Este script solo ayuda a la lectura; no sustituye el diagnóstico de problemas que hace Codex a partir del Trace completo, ni la revisión y las pruebas de ingeniería.
🚀 Consejo para empezar rápido: al reutilizar este enfoque, puedes empezar con un flujo de bajo riesgo en un sitio de pruebas interno para validar de extremo a extremo la ruta «descubrimiento → consolidación → ejecución». En la fase de descubrimiento tendrás que invocar el modelo repetidamente para comparar resultados; puedes obtener una cuota gratuita de pruebas en APIYI apiyi.com, usar la misma clave API para cambiar entre distintos modelos y hacer tareas auxiliares, como el análisis de logs, y luego decidir la selección del modelo para el entorno de producción.
Análisis y valoración: las disyuntivas de la ruta de automatización de CVS Agent
El siguiente contenido es una interpretación basada en los hechos expuestos anteriormente; no son conclusiones del equipo del proyecto ni de OpenAI.
¿Por qué es un desperdicio que el Agent piense desde cero cada vez?
La automatización de procesos de negocio de varios pasos tiene una particularidad: una vez que el flujo funciona, la gran mayoría de las ejecuciones posteriores recorren el mismo camino. Si cada vez dejamos que el Computer-use Agent vuelva a tomar capturas de pantalla, a entender la interfaz y a planificar el siguiente paso, el modelo en realidad está pagando una y otra vez por preguntas cuya respuesta ya conoce. Este razonamiento repetitivo conlleva al mismo tiempo tres tipos de costes.
El primero es el coste. Computer Use es una invocación de múltiples rondas: la captura de pantalla posterior a cada paso constituye una entrada de imagen y acumula Token de forma continua. Tomando como ejemplo los precios Standard de contexto corto que OpenAI publicó el 17 de noviembre de 2026, GPT-6 Astra tiene costes de entrada, salida y entrada en caché de 10, 50 y 1 dólar por millón de Token, mientras que GPT-6 Luna es de 0.10, 0.50 y 0.01 dólar. En la evaluación HealthAdminBench, el coste por tarea de Luna fue de 0.085 dólares, un 98% menos que Astra; extrapolando a partir de esta proporción, Astra vendría a costar unos 4.25 dólares por tarea, pero se trata solo de una estimación y de un coste en condiciones de benchmark, que no debe tomarse como una cotización de producción.
El segundo es la latencia. Cada paso requiere esperar la respuesta del modelo; cuanto más largo es el flujo, más larga es la espera. En la investigación anterior, la velocidad de ejecución de RPA en P2 y P3 era notablemente superior a la del Agent, y la razón es precisamente esta.
El tercero es la volatilidad. Cuando una misma tarea se ejecuta varias veces, el Agent puede seguir caminos distintos; en el estudio, la tasa de éxito del Agent en P3 fue de solo el 60%. Para negocios que requieren previsibilidad y auditabilidad, esta incertidumbre es más difícil de aceptar que el propio coste.
Por ello, la estructura de costes de las dos fases debe calcularse por separado:
| Coste | Fase de exploración (Agent) | Fase de ejecución (código determinista) |
|---|---|---|
| Token del modelo | Se contabilizan por separado la entrada visual y de texto y la salida facturable de cada ronda; los Token de reintento ya incluidos en el total no se suman dos veces | Cero en operación normal |
| Herramientas y entorno de ejecución | Servicios realmente utilizados, como navegadores, entornos de escritorio y contenedores | La máquina y el entorno de navegador donde se ejecuta el código |
| Esfuerzo de ingeniería | Redactar la descripción de la tarea, verificar las evidencias y revisar el código generado | Monitorización, diagnóstico de anomalías, actualización y pruebas del código |
| Frecuencia | Al poner en marcha un flujo nuevo o al modificarlo sustancialmente | En cada ejecución de negocio |
| Práctica recomendada | Elegir el modelo por capas según la complejidad: modelos potentes para flujos difíciles, modelos económicos para flujos estructurados | Evitar en lo posible la invocación del modelo y volver al Agent para corregir solo ante anomalías |
La economía de la arquitectura híbrida nace precisamente de esta tabla: las caras invocaciones del modelo se concentran en las fases poco frecuentes de exploración y corrección, mientras que las fases muy frecuentes de ejecución vuelven a un código con un coste marginal de modelo cercano a cero. La cuenta real debe incluir también el esfuerzo de mantenimiento: cuanto más frecuentes son los cambios de interfaz, más veces hay que volver a la fase de exploración y menor es el ahorro.
💰 Consejo de costes: para la selección de modelos por capas en la fase de exploración, lo mejor es probar con tus propios flujos reales en lugar de copiar las cifras del benchmark. A través de APIYI apiyi.com puedes cambiar de modelo bajo la misma interfaz compatible con OpenAI, con facturación por uso, lo que facilita comparar el consumo real de Token de distintos modelos en la fase de exploración y en el diagnóstico de logs.
Hay otro matiz de evaluación que se suele pasar por alto. Los resultados que OpenAI publicó en HealthAdminBench —94,3 % para Astra y 91,8 % para Luna— corresponden a la proporción de puntos de rúbrica (rubric points) con la intensidad de razonamiento máxima, no a la tasa de éxito de extremo a extremo. El artículo del equipo de Stanford, versión 2604.09937v1, incluye 135 tareas y 1698 subtareas (1177 con puntuación determinista y 521 evaluadas por un modelo juez), y reporta la mejor tasa de éxito en tareas completas del 36,3 % (Claude Opus 4.6 CUA) y la mejor tasa de éxito en subtareas del 82,8 % (GPT-5.4 CUA); las 70 tareas y 947 puntos de evaluación que se divulgaron antes en la web pertenecen a otra versión pública y solo sirven como referencia histórica. Estas cifras provienen de modelos, fechas, condiciones de ejecución y métricas distintas, así que no se pueden alinear en una misma tabla de clasificación.
Para el enfoque de «explorar primero y luego consolidar», la tasa de éxito de extremo a extremo pesa más que las puntuaciones parciales. Codex necesita una trayectoria que se complete con éxito de principio a fin: si la fase de exploración acierta en el 90 % de los subpasos pero se atasca en el paso final de envío, la traza (Trace) que queda tampoco se puede consolidar directamente. A la hora de elegir un modelo, conviene medir la tasa de éxito en tareas completas usando tu propio flujo de trabajo.
¿Qué tareas son adecuadas para una arquitectura híbrida de Agentes al estilo CVS?
Si juntamos los hechos anteriores, podemos obtener una tabla aproximada de reparto de tareas:
| Característica de la tarea | Forma de ejecución recomendada | Ejemplo típico | Intervención humana |
|---|---|---|---|
| Proceso desconocido, falta de documentación, interfaz compleja | El Agente explora y deja evidencia | Primera revisión del recorrido operativo de un sistema antiguo | Revisar los resultados de la exploración y el código generado |
| Proceso estable, repetición de alta frecuencia, verificable mediante estados | Solidificar como código determinista | Envío de archivos entre sistemas, traslado de campos fijos | Muestreo de resultados, monitoreo de anomalías |
| Ya cubierto por una API | Priorizar la llamada a la API | Escritura de datos estructurados | Gestión según los permisos habituales |
| Interfaz que cambia con frecuencia | Tras solidificar, reforzar el monitoreo y reservar presupuesto para volver a la exploración | Portales de terceros | Revisión necesaria en cada actualización de código |
| Cambiar estados de negocio de alto riesgo | Que el código o el Agente lleguen solo a borrador / pendiente de aprobación | Enviar solicitudes, enviar mensajes, modificar registros | Aprobación humana obligatoria |
En el ámbito médico, las prácticas de otros colaboradores también sirven de referencia. La solución presentada por Ambience hace que el Agente se detenga y pregunte al médico cuando hay ambigüedad en la historia clínica, y espera la aprobación antes de enviar; en el caso de Assort, la API se encarga de la parte que puede cubrir, y Computer Use solo completa los pasos de interfaz que la API no cubre. La combinación de «API + Computer Use + código determinista + aprobación humana» es más realista que apostar por una sola tecnología.
Conviene aclarar que el código determinista solo hace que la ejecución sea predecible, no garantiza que el resultado sea correcto. Si durante la fase de exploración se solidificó una ruta defectuosa, el código repetirá ese defecto de forma estable; en operaciones entre sistemas, además, un error puede replicarse en múltiples sistemas downstream. Por eso, la verificación de estado antes de la operación, la validación de resultados después, los privilegios mínimos y la trazabilidad completa siguen siendo indispensables incluso después de la solidificación. Este artículo trata de arquitectura de ingeniería y no implica ninguna recomendación de diagnóstico o tratamiento para pacientes.
Para los equipos que quieren ponerse manos a la obra, el camino más seguro es: primero elegir en un entorno que no sea de producción un proceso de bajo riesgo y alta repetición, recorrer completo la exploración, la solidificación y la ejecución, y además provocar artificialmente un cambio de interfaz; registrar el coste de invocación del modelo, las horas de mantenimiento del código y el tiempo de recuperación ante fallos. Estos tres datos explican mejor que cualquier puntuación de benchmark si esta arquitectura resulta rentable en tu escenario. Para las pruebas comparativas de varios modelos durante la fase de exploración, se puede empezar con la cuota gratuita de APIYI apiyi.com y, después, decidir el modelo y la forma de integración para el despliegue formal según los resultados reales.
La propuesta de CVS merece atención no porque proclame lo inteligente que es el Agente, sino porque reconoce sus limitaciones y aplica la inteligencia donde más falta hace: explorar una vez, solidificar en código y corregir cuando se rompe. Que esta ruta pueda consolidarse en más empresas dependerá, en última instancia, de los datos de prueba reales de cada proceso en entornos reales.
The proof of the pudding is in the eating. (El pudding se conoce al comerlo: el efecto real debe comprobarse con la práctica.)
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI apiyi.com; para más materiales de integración, visita el centro de documentación docs.apiyi.com


