
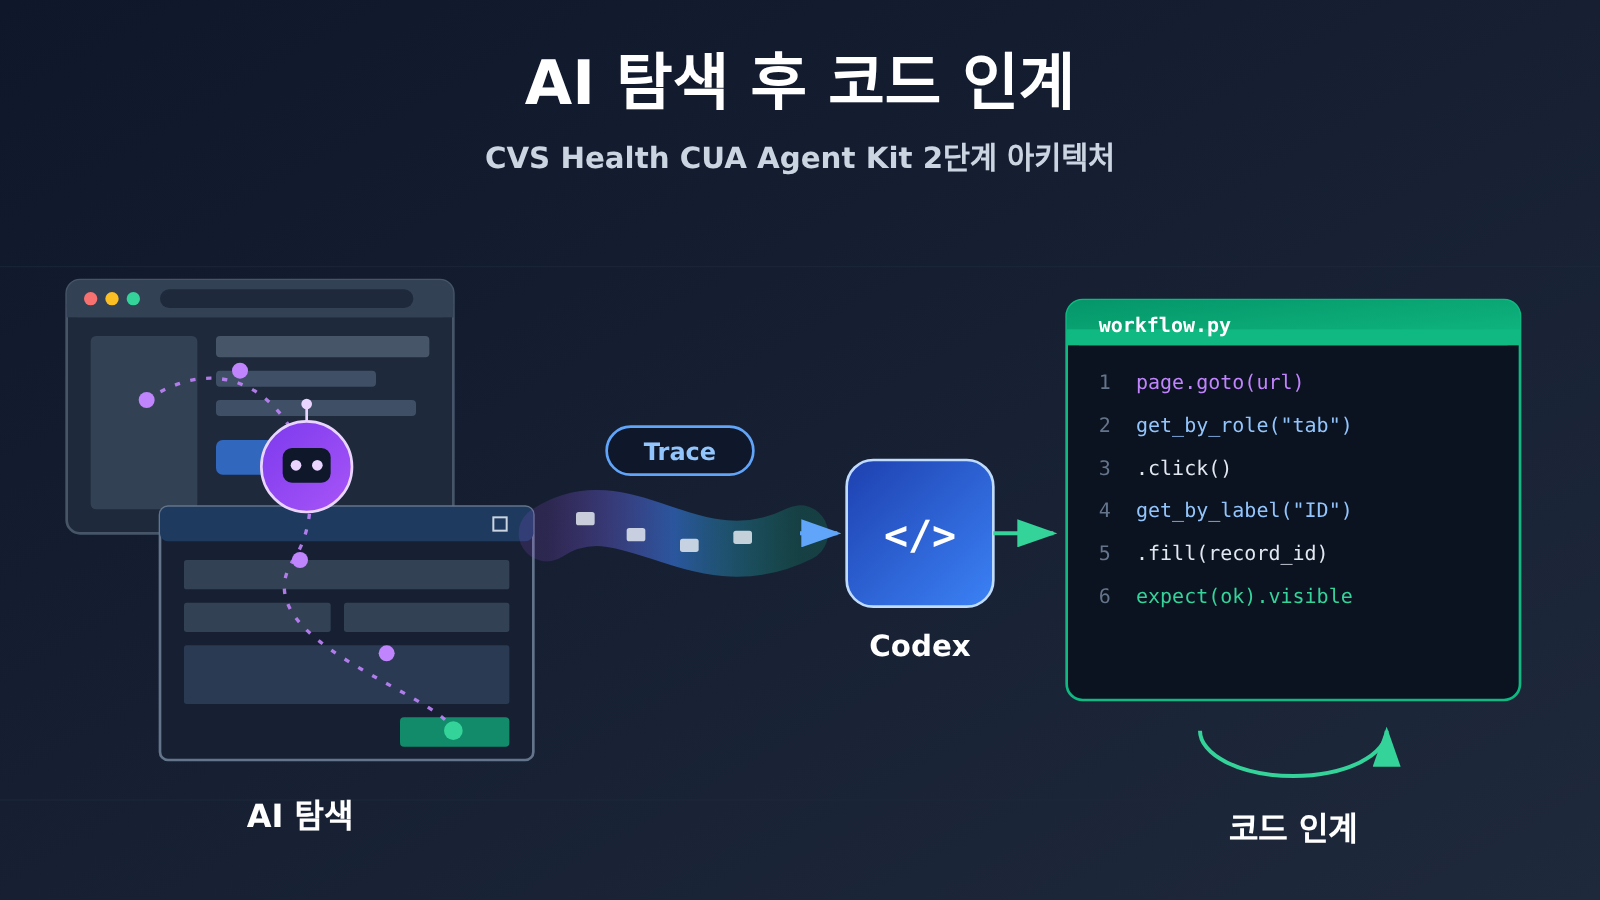
기업 에이전트는 반복 작업마다 대규모 언어 모델을 다시 호출할 필요가 없어요. CVS Health가 오픈소스로 공개한 CUA Agent Kit은 더 경제적인 엔지니어링 경로를 제시해요. 먼저 Computer-use 에이전트가 알려지지 않은 업무 프로세스를 탐색하고, 성공 과정을 스크린샷, 이벤트, Trace로 기록하게 해요. 그다음 Codex가 이 증거들을 검토 가능하고 유지보수 가능하며 반복 실행 가능한 결정론적 코드로 바꿔 주죠.
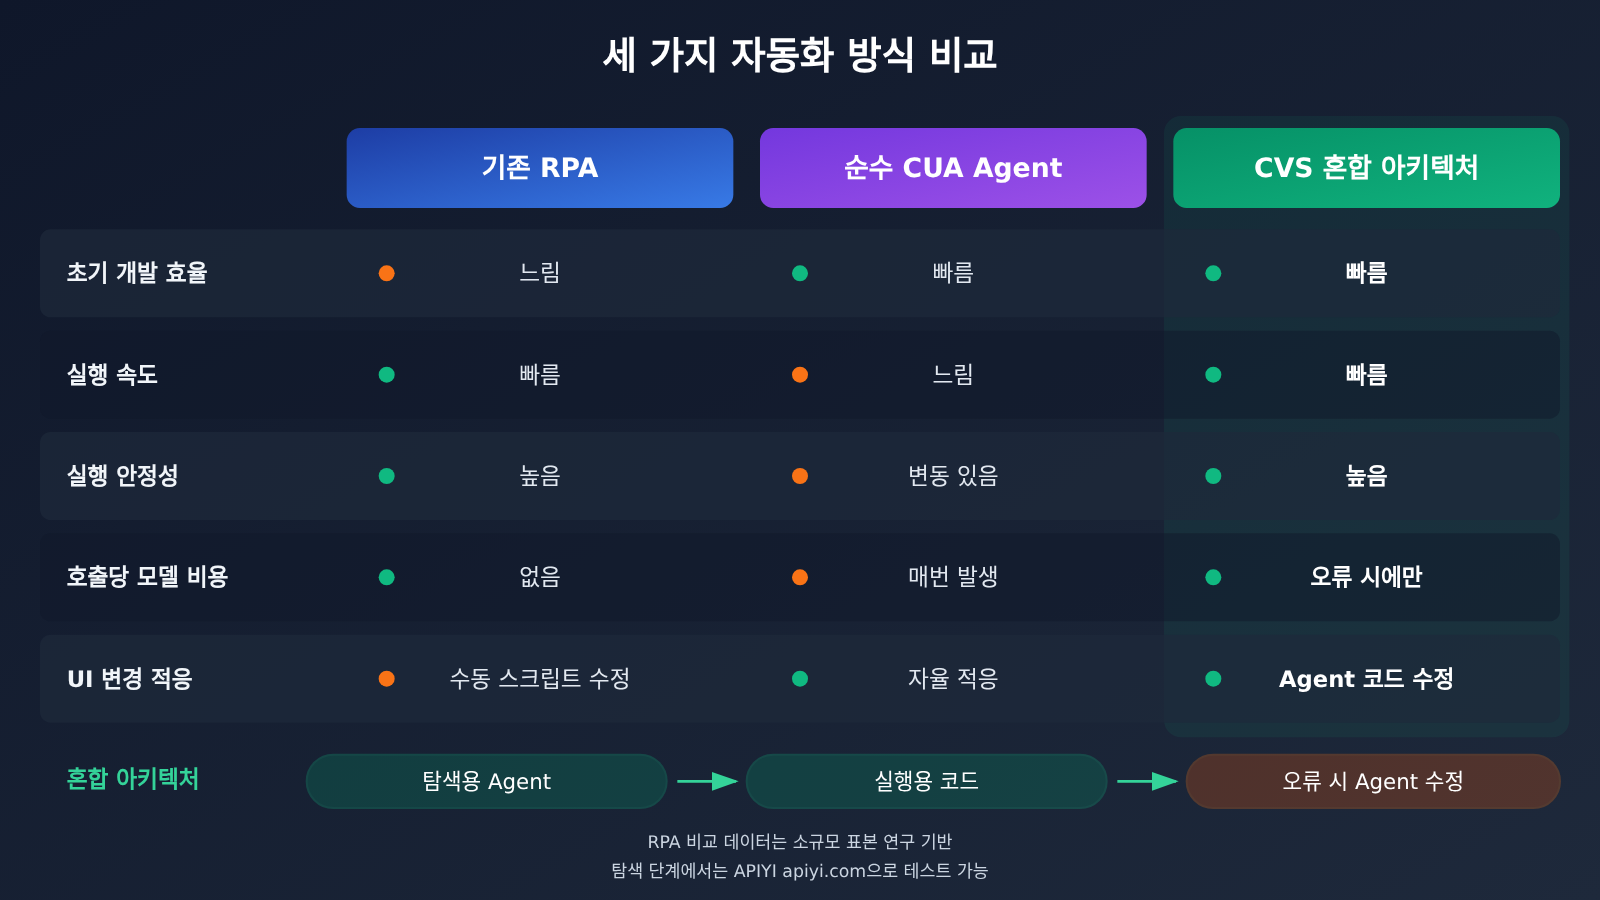
이 방식은 AI의 유연한 탐색 능력과 전통 자동화의 안정적인 실행 능력을 결합해 “AI 탐색, 코드 고정화, 지속적 유지보수”라는 하이브리드 아키텍처를 만들어요. 에이전트가 스크립트를 대체하는 게 아니라, 에이전트가 스크립트를 쓰고 고치게 하는 거죠.
이 글을 읽고 무엇을 알 수 있을까요?
- CVS Health CUA Agent Kit가 AI 탐색에서 코드 고정화로 이어지는 2단계 프로세스를 어떻게 완성하는지
- 스크린샷, events.jsonl, Trace, 시맨틱 로케이터가 고정화 단계에서 각각 어떤 역할을 하는지
- 고정된 프로세스가 대규모 언어 모델을 호출하지 않고 어떻게 실행되며, 예외가 발생하면 어떻게 유지보수하는지
뒤의 객관적 사실 부분에서는 CUA Agent Kit의 작동 방식, AI 조작에서 Playwright 코드로 넘어가는 사이에 무슨 일이 일어나는지, 고정화 이후에도 에이전트가 맡는 유지보수 작업은 무엇인지, 이 아키텍처와 전통 RPA의 차이에 어떤 연구 근거가 있는지, 개발자가 어떻게 직접 재사용할 수 있는지를 차례로 설명해요. 분석과 판단 부분에서는 두 가지 질문을 다뤄요. 에이전트가 매번 처음부터 생각하는 것이 왜 낭비인지, 그리고 어떤 작업이 이 하이브리드 아키텍처에 적합하고 어떤 작업은 반드시 사람의 검토를 남겨야 하는지요.
알아두기: CVS Agent 자동화 로드맵을 이해하는 7가지 개념
| 개념 | 간단한 설명 |
|---|---|
| Computer Use | 소프트웨어 화면을 관찰하고 클릭·입력 등의 조작을 수행해 작업을 완료하는 능력 |
| EHR | 전자 건강 기록 시스템으로, 의료 기관이 환자 진료 기록을 보관·처리하는 핵심 소프트웨어 |
| MCP | 외부 도구를 발견하고 호출하기 위한 표준 프로토콜 |
| RPA | 미리 구성된 규칙이나 프로그램으로 반복 프로세스를 실행하는 자동화 방식 |
| Rubric points | 평가 규칙에 따라 나눈 채점 포인트로, 요구사항이 부분적으로 얼마나 충족됐는지를 측정 |
| 엔드투엔드 성공률 | 전체 작업이 모든 성공 조건을 만족한 비율 |
| Trace | 실행 과정, 조작, 페이지 상태를 기록한 추적 증거 |
영향 한눈에 보기: CVS Agent 자동화 로드맵은 누구에게 영향을 주나
- 개발자와 기술 리더: 핵심은 “Agent를 쓰느냐 마느냐”가 아니라 작업별로 실행 메커니즘을 나누는 것입니다. 탐색 단계의 완료율, 코드로 고정한 뒤의 안정성, 유지보수까지 포함한 전체 비용을 각각 검증해야 하며, 단일 모델 호출 가격만 보고 판단해서는 안 됩니다.
- 의료 기관과 워크플로 담당자: 합성 데모, 벤더 평가, 기업 공개 사례, 자체 파일럿을 구분해야 하며 각 증거의 무게는 다릅니다. 환자 데이터와 상태 변경이 얽힌 단계라면 사전에 인간 승인, 최소 권한, 작업 이력 기록을 마련해 두어야 합니다.
객관적 사실: CVS Health CUA Agent Kit의 2단계 접근 방식
먼저 배경을 짚어볼게요. 2026년 11월 16일, OpenAI는 의료 팀을 위한 Computer-use Agent 발전 내용을 발표했어요. 임상 및 의료 행정 작업의 평가 결과와 CVS Health, Cigna Healthcare, Abridge, Ambience 등과의 협업 사례도 함께 공개했죠. CVS Health는 이 가운데 프로덕션 환경 사례를 공개하고 CUA Agent Kit를 Apache-2.0 라이선스로 오픈소스화했어요.
CVS Health가 공개한 프로덕션 결과에는 이런 내용이 있어요. 특정 프로덕션 워크플로의 에이전트가 주말 동안 수개월 치로 쌓인 파일 전송 작업을 정리했고, 또 다른 에이전트는 매일 수만 건의 전문의 협진에서 발생하는 시스템 조작 단계를 처리했어요. 시스템에는 검증 확인 절차와 사람의 감독이 마련되어 있고, 스크린샷과 작업 기록을 통해 실제 조작과 애플리케이션 상태를 대조해요. 여기서 염두에 둘 점은 이 수치가 모두 기업이 자체 공개한 데이터라는 거예요. ‘수만 건’은 협진과 관련된 시스템 조작 단계를 가리키며, AI가 수만 건의 임상 의사결정을 독립적으로 완료했다는 뜻은 아니에요. 공개 자료에는 이 프로덕션 에이전트가 오픈소스 버전 Agent Kit만을 기반으로 구축됐는지도 나와 있지 않아요. 따라서 둘을 곧바로 동일시해서는 안 돼요.
출처: openai.com/index/advancing-computer-use-for-healthcare-teams/
CVS Health의 CUA Agent Kit는 어떻게 동작하나요?
프로젝트 README는 자신의 위치를 아주 명확히 설명해요. 브라우저와 Windows 워크플로를 자동화하기 위한 시작용 툴킷이며, AI로 단계를 발견한 뒤 코드로 반복 실행한다는 거죠. 프로젝트는 특히 ‘작업이 어떻게 이루어지는지 파악하는 일’과 ‘장기간 안정적으로 반복하는 일’이 서로 다른 문제이며, 각각 다른 방법으로 풀어야 한다고 강조해요.
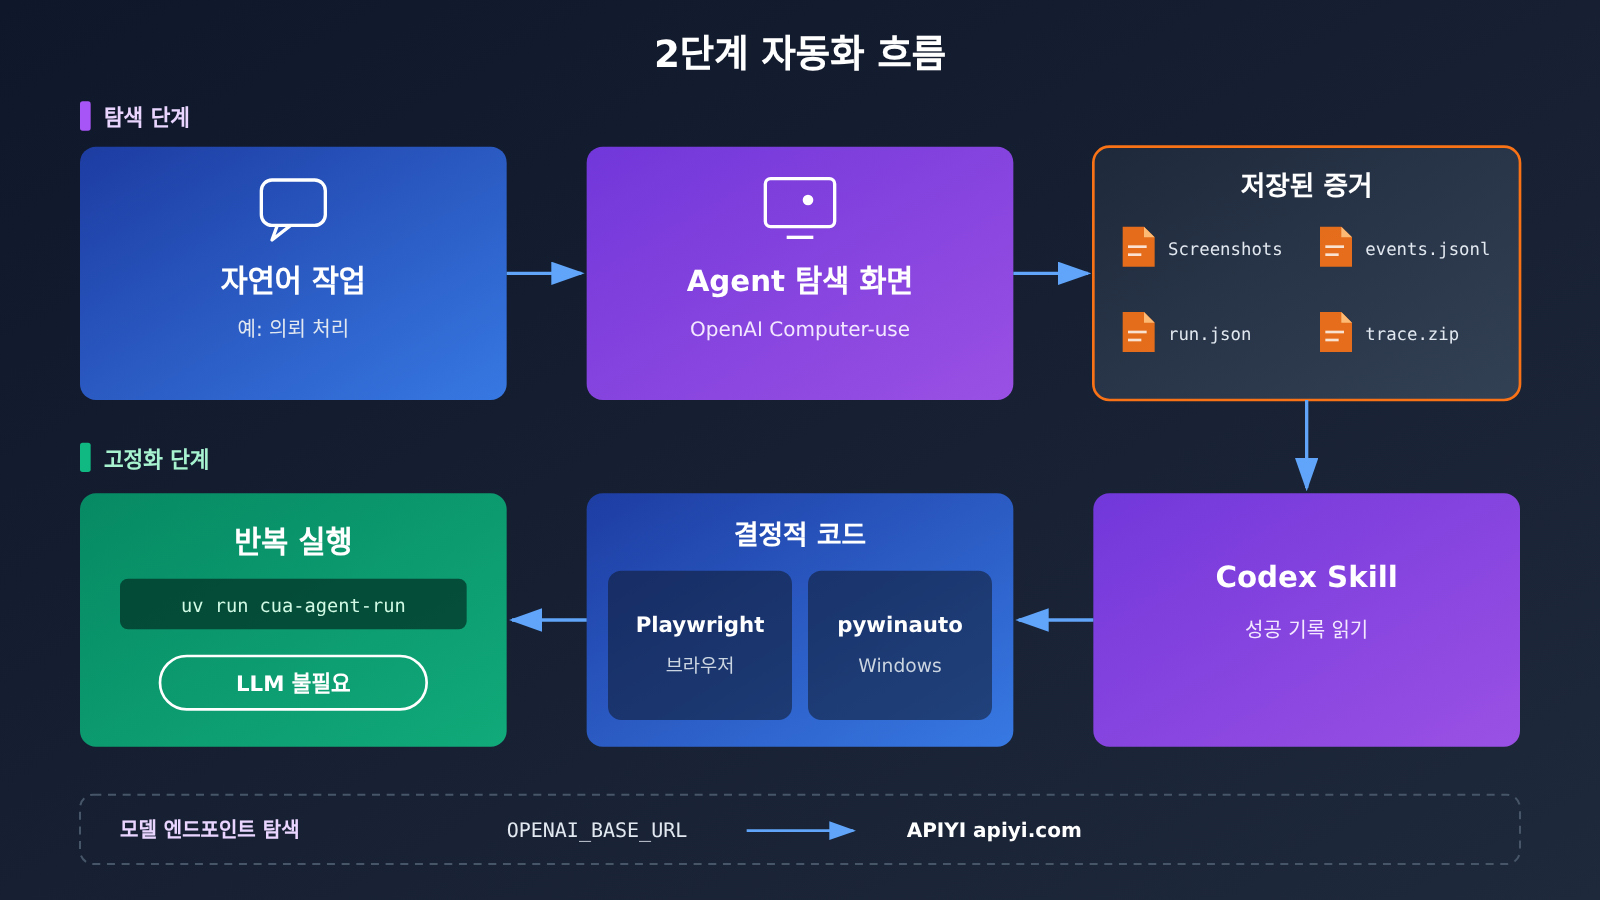
전체 흐름은 두 단계로 나뉘어요:
- 탐색 단계: OpenAI Computer-use Agent가 자연어로 설명된 작업, 예를 들어 “특정 기록을 찾아 진료 의뢰를 처리하라”와 같은 작업을 받아 실제 인터페이스에서 탐색하고 실행하고 검증해요. 이 과정에서 스크린샷, 조작 동작, 조작 대상, 실행 트레이스를 저장합니다.
- 코드화 단계: Codex Skill이 성공한 탐색 기록을 읽고 결정적 워크플로 코드를 생성하거나 업데이트해요. 이후 같은 흐름의 반복 실행은 일반 코드에 맡기며, 매번 대규모 언어 모델이 다시 추론할 필요가 없습니다.
탐색 단계에서 남는 근거는 모델 내부의 추론 과정에 머무르지 않고 모두 디스크에 기록된 파일로 남아요. README에 공개된 기록 유형은 다음과 같아요.
| 기록 | 주요 용도 | 코드화 단계에서의 가치 |
|---|---|---|
| Screenshots | 각 단계의 인터페이스 상태를 기록 | 엔지니어와 Codex가 페이지의 실제 모습을 대조 |
| events.jsonl | 조작 이벤트를 한 줄씩 기록 | ‘무엇을, 어떤 순서로 했는지’를 재현 |
| run.json | 이번 실행 정보를 기록 | 서로 다른 실행을 구분하고 성공 여부를 판단 |
| trace.zip | Playwright 실행 트레이스 | 요소, 네트워크, 타이밍 등의 세부 정보를 제공해 코드 생성과 진단에 사용 |
출처: github.com/cvs-health/cua-agent-kit
AI 조작부터 Playwright 코드까지, CVS Agent Kit이 하는 일은?
고정화 단계에서 가장 중요한 디테일 하나는 바로 ‘마우스 좌표 재생’을 생성하지 않는다는 점이에요. CVS 프로젝트는 브라우저 워크플로를 생성할 때 의미론적 로케이터(Semantic Locators)를 활용해 Playwright 코드를 만들어요. 화면의 특정 좌표를 외우는 대신, 요소의 역할과 이름 같은 의미적 특징으로 대상을 찾아내는 거죠.
두 방식의 차이는 유지보수에서 가장 뚜렷하게 드러나요. 좌표 재생은 해상도, 창 크기, 레이아웃의 미세한 조정에 영향을 받아서 버튼이 몇 픽셀만 움직여도 클릭이 빗나갈 수 있고, 오류가 나도 좌표 목록만 보고는 원래 무엇을 클릭하려 했는지 알기 어려워요. 반면 의미론적 로케이터로 작성된 코드는 ‘제출’이라는 이름의 버튼 클릭’처럼 의도가 코드에 그대로 담겨 있어서 엔지니어가 바로 검토할 수 있고, 페이지가 일부 조정될 때도 쉽게 깨지지 않아요. 물론 버튼 이름이 바뀌거나 흐름이 개편되면 의미론적 로케이터도 마찬가지로 실패하지만, 실패 지점을 찾기는 훨씬 쉬워요.
프로젝트의 도구 분담은 다음과 같아요:
- Playwright: 브라우저 워크플로의 결정론적 실행을 담당하고, trace.zip 같은 재생 가능한 추적(trace)을 생성해요.
- pywinauto: Windows 데스크톱 애플리케이션 자동화를 담당하며, 웹 인터페이스가 없는 레거시 시스템까지 커버해요.
- Codex Skill: 성공한 탐색 추적을 읽어 위 두 종류의 코드를 생성하거나 업데이트해요.
이런 접근은 OpenAI 공식 문서의 방향과도 일치해요. OpenAI의 Computer Use 가이드는 두 가지 경로를 소개하는데, 하나는 모델이 구조화된 마우스·키보드 동작을 반환하고 애플리케이션이 이를 실행하는 방식이고, 다른 하나는 모델이 코드를 생성해 Playwright 같은 도구로 인터페이스를 조작하는 방식이에요. 문서는 GPT-6 Astra에 대해 코드 실행 방식을 권장하며, Computer Tool은 여전히 선택지로 남아 있어요. ComputerToolset, BrowserToolset, 그리고 호스팅 브라우저 진입점은 공식 가이드에서 각각 설명하고 있어요.
출처: developers.openai.com/api/docs/guides/tools-computer-use
고정화 이후, CVS Agent Kit의 Agent는 무엇을 더 해야 할까요?
워크플로우가 고정된 후, 결정적 실행은 README에서 제시한 명령으로 구동됩니다:
uv run cua-agent-run
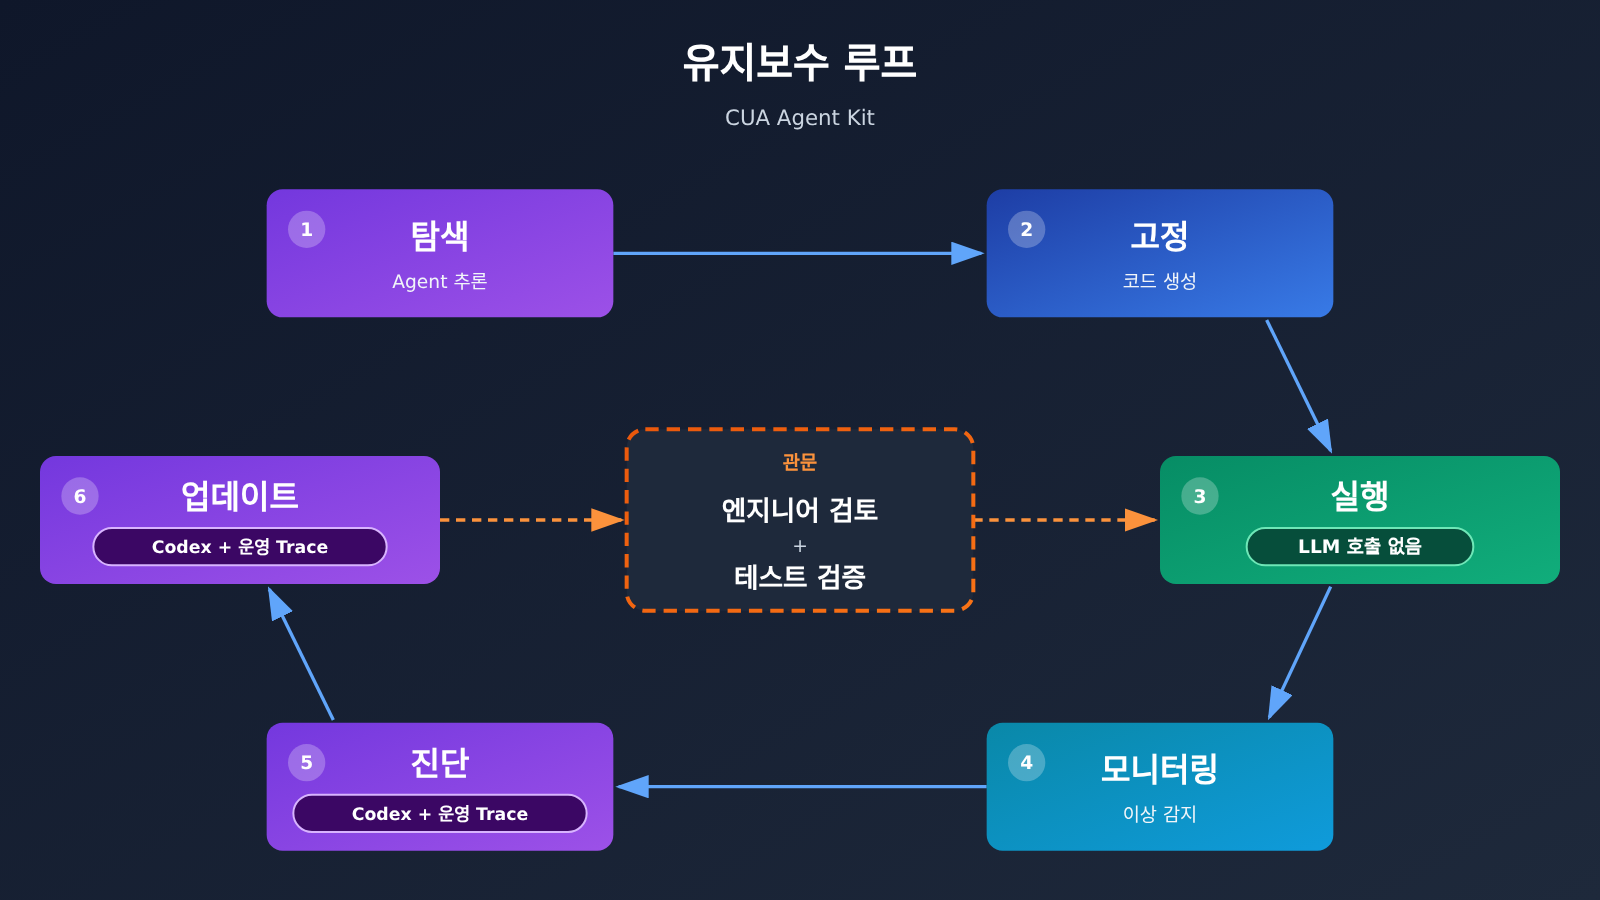
이 단계에서는 매번 대규모 언어 모델을 호출할 필요도 없고 API 키도 필요 없습니다. 하지만 프로젝트는 ‘고정화’를 한 번으로 끝나는 일로 보지 않았습니다. README에서 설명하는 유지보수 메커니즘은 하나의 순환 구조입니다:
- 고정된 워드플로우가 계획대로 실행됩니다;
- 프로덕션 Trace에서 이상을 발견합니다;
- Codex가 Trace를 활용해 문제를 진단합니다;
- 결정적 코드를 업데이트합니다;
- 엔지니어가 변경 사항을 검토합니다;
- 테스트와 검증을 통과한 후 다시 반복 실행에 투입합니다.
다시 말해, Agent의 역할은 ‘매번 직접 작업하는 것’에서 ‘평소에는 현장에 없다가 문제가 생기면 코드를 고치는 것’으로 바뀌었습니다. 코드는 실패하고, 화면은 개편됩니다. 이 점을 프로젝트 자체가 이미 기본 전제로 삼았기 때문에 진단과 검토 단계를 설계한 것입니다.
CVS의 하이브리드 에이전트 자동화는 기존 RPA와 무엇이 다른가요?
기존 RPA는 미리 구성한 단계와 UI 위치 정보에 의존해 실행이 빠르고 결과가 안정적이지만, 개발과 개편 유지보수에는 사람의 투입이 필요해요. 순수 에이전트는 자연어를 이해하고 UI 변화에 적응할 수 있지만, 매번 다시 추론하면서 비용과 결과 변동성이 생기죠. CUA Agent Kit은 그 사이에 자리해요. ‘사람이 직접 녹화하고 흐름을 작성하는’ 단계를 에이전트로 대체하고, 실행 단계에서는 다시 결정론적 코드로 돌아가요.
두 방식의 직접 비교는 2026년에 발표된 연구를 참고하면 좋아요: Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks (DOI: 10.1080/23311975.2026.2724760). 이 연구는 2025년 5~6월에 진행됐고, UiPath Studio 2023.4.0과 Anthropic Computer Use Agent를 비교했으며, 데이터 입력, 모니터링, 문서 추출의 세 가지 표준 작업을 다뤘어요.
| 작업 | RPA 성공률 | 에이전트 성공률 | 초기 개발 시간(단일 개발자 관찰) |
|---|---|---|---|
| P1 | 대조 통계에 포함되지 않음 | 에이전트가 1회만 실행되고 실패해 이후 통계에 포함되지 않음 | 공개되지 않음 |
| P2 | 100%(10회) | 90%(10회) | 에이전트 약 10분, RPA 약 38분 |
| P3 | 100%(10회) | 60%(10회) | 에이전트 약 15분, RPA 약 240분 |
연구에서는 RPA가 P2, P3에서 실행 속도가 눈에 띄게 더 빨랐고, 에이전트의 문제는 주로 UI 조작 실패, 컨텍스트 손실, 판단 오류로 나타났어요. 반면 에이전트는 동적 UI에 적응하는 능력에서 잠재적 우위를 보였습니다.
이 연구의 한계는 분명히 짚고 넘어가야 해요:
- 표본이 작아요: P2, P3는 기술별로 각각 10회씩이고, P1은 ‘기술별 10회’가 아니어서 한마디로 일반화할 수 없어요.
- 개발 시간은 초기 관찰일 뿐이에요: 단일 개발자의 관찰 결과라 통계적 대표성이 없고, 업계 평균으로 볼 수 없어요.
- 도구 버전이 다소 오래됐어요: 2025년의 에이전트 구성을 사용했기 때문에 2026년 신모델의 성과를 대표하지는 못해요.
그래도 결론의 방향은 CVS의 설계와 서로 맞아떨어져요. 에이전트는 빠른 탐색과 유연한 처리에 강하고, RPA식 결정론적 실행은 안정적인 반복 작업에서 여전히 우위가 있어요.
출처: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
개발자는 CVS CUA Agent Kit의 접근 방식을 어떻게 재사용할 수 있을까요?
README에 나열된 환경 요구 사항은 많지 않아요.
- Python 3.12 이상 버전
- uv(Python 패키지 및 프로젝트 관리 도구)
- 접근 가능한 대상 웹사이트 또는 데스크톱 애플리케이션
- 탐색 단계에서는
OPENAI_API_KEY필요 OPENAI_BASE_URL을 통해 사용자 정의 API Endpoint 구성 가능
사용 방식은 세 단계에 대응해요. 발견(Agent가 탐색하며 증거를 남김), 고정화(Codex가 코드 생성), 실행(결정론적 실행)이에요. 발견과 고정화 단계의 구체적인 명령과 파라미터는 저장소 README를 기준으로 확인하고, 실행 단계는 앞서 설명한 uv run cua-agent-run이에요.
OPENAI_BASE_URL이라는 설계는 눈여겨볼 만해요. 탐색 단계의 모델 진입점을 공식 API로 지정할 수도 있고, 기업 내부 게이트웨이나 OpenAI 인터페이스와 호환되는 다른 서비스로 지정할 수도 있다는 뜻이죠. 통합 인증, 과금, 감사에 유리해요. 탐색 단계의 환경 변수는 이렇게 구성할 수 있어요.
# 탐색 단계: 모델 API가 필요
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # APIYI 통합 인터페이스 사용, 또는 게이트웨이로 교체

# 실행 단계: 결정론적 실행, API Key 불필요
uv run cua-agent-run
한 가지 강조하고 싶은 점은 Computer Use가 특정 Responses API 기능과 도구 유형에 의존한다는 거예요. 어떤 사용자 정의 엔드포인트로 바꾸기 전에, 해당 엔드포인트가 탐색 단계에 필요한 모델과 도구를 지원하는지 먼저 확인하고, 간단한 플로우로 먼저 검증한 뒤 확대 적용해야 해요.
고정화 이후 일상 유지보수에서 가장 자주 하는 일은 Trace와 이벤트 로그를 읽는 거예요. 다음은 보조 스크립트 예시예요. 한 번의 실행에서 나온 events.jsonl을 범용 대규모 언어 모델에 넘겨 단계 목록과 의심스러운 실패 지점을 정리하게 하고, 엔지니어가 검토할 때 참고 자료로 쓰는 방식이죠. events.jsonl의 구체적인 필드는 프로젝트의 실제 출력을 기준으로 하며, 여기서는 줄 단위로 읽기만 해요. 환자 등 민감 정보가 포함된 경우에는 반드시 먼저 비식별화하거나, 규정을 준수하는 환경에서만 처리해야 해요.
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """비식별화된 events.jsonl을 읽어 단계 목록과 의심 실패 지점을 생성"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # 컨텍스트 길이 제어
    prompt = (
        "다음은 한 번의 인터페이스 자동화 실행 이벤트 로그입니다."
        "작업 단계를 순서대로 나열하고, 실패 가능성이 가장 높은 단계와 그 이유를 지적해 주세요."
        "로그 내용만 근거로 삼고, 추측하지 마세요.\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # 플랫폼에서 실제로 사용 가능한 모델로 교체하세요
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
이 스크립트는 읽기를 돕는 용도일 뿐, Codex가 전체 Trace를 바탕으로 문제를 진단하는 일을 대신하지도, 엔지니어의 검토와 테스트를 대신하지도 않아요.
🚀 빠른 시작 팁: 이 접근 방식을 재사용할 때는 먼저 사내 테스트 사이트의 저위험 플로우 하나를 골라 “탐색 → 고정화 → 실행” 전체 경로를 끝까지 돌려 보세요. 탐색 단계에서는 효과를 비교하려고 모델을 반복 호출해야 하는데, APIYI apiyi.com에서 무료 테스트 크레딧을 받아 같은 API 키로 여러 모델을 바꿔 가며 로그 분석 같은 보조 작업을 해 보고, 그다음 운영 환경의 모델 선택을 결정하면 돼요.
분석 판단: CVS Agent 자동화 경로의 선택
아래 내용은 앞선 사실들을 바탕으로 한 해석이며, 프로젝트 측이나 OpenAI의 결론은 아닙니다.
왜 Agent가 매번 처음부터 생각하는 것이 낭비일까요?
다단계 업무 자동화에는 한 가지 특징이 있어요. 프로세스가 한 번 정상적으로 돌아가기 시작하면, 이후 실행의 대부분은 같은 경로를 따릅니다. 매번 Computer-use Agent에게 스크린샷을 다시 찍고, 인터페이스를 이해하고, 다음 단계를 계획하게 한다면, 모델은 사실 이미 답을 알고 있는 질문에 반복해서 비용을 치르는 셈이에요. 이런 반복 추론은 동시에 세 가지 비용을 발생시킵니다.
첫째는 비용이에요. Computer Use는 멀티턴 호출이고, 매 단계 작업 후의 스크린샷은 이미지 입력에 해당하므로 Token이 계속 누적돼요. OpenAI가 2026년 11월 17일 공개한 Standard 단문맥 가격을 예로 들면, GPT-6 Astra의 입력·출력·캐시 입력 가격은 각각 백만 Token당 10달러, 50달러, 1달러이고, GPT-6 Luna는 0.10달러, 0.50달러, 0.01달러예요. HealthAdminBench 평가에서 Luna의 과제당 비용은 0.085달러로 Astra보다 98% 낮았어요. 이 비율로 역산하면 Astra는 과제당 약 4.25달러가 되지만, 이는 추정치일 뿐이고 벤치마크 조건에서의 비용이므로 실제 운영 견적으로 받아들일 수는 없어요.
둘째는 지연이에요. 매 단계마다 모델의 응답을 기다려야 하니, 프로세스가 길수록 대기 시간도 길어져요. 앞선 연구에서 RPA가 P2, P3에서 실행 속도가 Agent보다 확연히 빨랐던 이유도 바로 여기에 있어요.
셋째는 변동성이에요. 같은 과제를 여러 번 실행해도 Agent가 서로 다른 경로를 걸을 수 있고, 연구에서 P3의 Agent 성공률은 60%에 불과했어요. 예측 가능성과 감사 가능성이 필요한 업무에서는 이런 불확실성이 비용보다 더 받아들이기 어려워요.
따라서 두 단계의 비용 구조는 따로 계산해야 해요:
| 비용 항목 | 탐색 단계(Agent) | 실행 단계(결정적 코드) |
|---|---|---|
| 모델 Token | 매 라운드의 시각·텍스트 입력과 과금 출력을 각각 집계하고, 재시도 Token이 이미 총량에 포함된 경우 중복 가산하지 않음 | 정상 실행 시 0 |
| 도구와 실행 환경 | 브라우저, 데스크톱 환경, 컨테이너 등 실제로 사용한 서비스 | 코드를 실행하는 머신과 브라우저 환경 |
| 엔지니어링 투입 | 과제 설명 작성, 증거 확인, 생성 코드 검토 | 모니터링, 이상 진단, 코드 업데이트와 테스트 |
| 발생 빈도 | 새 프로세스 출시 또는 프로세스 대폭 변경 시 | 매 업무 실행 시 |
| 권장 방식 | 복잡도에 따라 모델을 계층화해 선택하고, 고난도 프로세스에는 강한 모델, 구조화된 프로세스에는 저가 모델 사용 | 가능한 한 모델을 호출하지 않고, 이상 발생 시에만 Agent로 복귀해 수리 |
혼합 아키텍처의 경제성은 바로 이 표에서 나와요. 비싼 모델 호출은 저빈도의 탐색·수리 단계에 집중되고, 고빈도 실행 단계는 모델 한계 비용이 거의 0에 가까운 코드로 돌아가는 거예요. 실제 장부에는 유지보수 투입도 반드시 포함해야 하고, 인터페이스 개편이 잦을수록 탐색 단계로 돌아가는 횟수가 늘어나 절감 폭은 줄어들어요.
💰 비용 제안: 탐색 단계의 모델 계층화 선택은 벤치마크 숫자를 그대로 가져오기보다 자체 실제 프로세스로 직접 측정해 보는 게 좋아요. APIYI apiyi.com을 통해 동일한 OpenAI 호환 인터페이스 아래에서 모델을 전환하고 사용량 기반 과금으로 비교할 수 있어서, 탐색과 로그 진단 단계에서 서로 다른 모델의 실제 Token 소모를 대조하기 편리해요.
여기에는 놓치기 쉬운 평가 기준 문제가 하나 더 있어요. OpenAI가 공개한 HealthAdminBench 성적은 Astra 94.3%, Luna 91.8%인데, 이는 모두 최고 추론 강도에서의 rubric points 비율이지 엔드투엔드 성공률이 아니에요. 스탠퍼드 팀 논문 2604.09937v1 버전에는 135개 과제, 1698개 하위 과제(그중 1177개는 결정론적 채점, 521개는 모델 판정)가 포함되어 있고, 보고된 최고 전체 과제 성공률은 36.3%(Claude Opus 4.6 CUA), 최고 하위 과제 성공률은 82.8%(GPT-5.4 CUA)예요. 초기 웹페이지에 공개된 70개 과제, 947개 채점 항목은 또 다른 공개 버전으로, 역사적 대조 자료로만 쓸 수 있어요. 이 숫자들은 서로 다른 모델, 날짜, 실행 조건, 지표에서 나온 것이라 같은 순위표에 나란히 놓을 수 없어요.
‘먼저 탐색한 뒤 고정’이라는 관점에서 보면 엔드투엔드 성공률이 부분 점수보다 훨씬 중요해요. Codex에 필요한 것은 완전히 성공한 하나의 궤적이에요. 탐색 단계에서 하위 단계의 90%를 맞혔는데 마지막 제출 단계에서 막혔다면, 그때 남은 Trace로는 여전히 바로 고정할 수 없죠. 모델을 고를 때는 자신의 프로세스로 전체 과제의 성공률을 측정해야 해요.
어떤 작업이 CVS 방식의 하이브리드 Agent 아키텍처에 적합할까요?
앞서 살펴본 사실들을 종합하면 대략적인 작업 분담표를 얻을 수 있습니다.
| 작업 특징 | 권장 실행 방식 | 대표적인 예시 | 사람 개입 |
|---|---|---|---|
| 프로세스가 불명확하고 문서가 부족하며 인터페이스가 복잡함 | Agent가 탐색하고 증거를 남김 | 레거시 시스템의 운영 경로를 처음 정리 | 탐색 결과와 생성 코드 검토 |
| 프로세스가 안정적이고 반복 빈도가 높으며 상태 검증이 가능함 | 결정론적 코드로 고정 | 시스템 간 파일 전송, 고정 필드 이관 | 결과 표본 검사, 이상 징후 모니터링 |
| 기존 API로 커버 가능 | API 호출 우선 | 구조화 데이터 쓰기 | 일반적인 권한 관리 절차에 따름 |
| 인터페이스가 자주 개편됨 | 고정한 뒤 모니터링을 강화하고, 탐색으로 되돌아갈 예산을 확보 | 서드파티 포털 | 코드를 업데이트할 때마다 검토 필요 |
| 고위험 업무 상태를 변경함 | 코드나 Agent는 초안 작성 또는 승인 대기까지만 수행 | 신청 제출, 메시지 발송, 기록 수정 | 반드시 사람이 승인 |
의료 현장에서 다른 협력사들의 접근 방식도 참고가 됩니다. Ambience가 제시한 방안은 진료 기록에 모호한 부분이 있을 때 Agent가 멈춰서 의사에게 묻고, 제출 전에는 승인을 기다리도록 했습니다. Assort의 사례에서는 API가 커버할 수 있는 부분을 담당하고, Computer Use는 API가 커버하지 못하는 인터페이스 단계만 보완했습니다. “API + Computer Use + 결정론적 코드 + 사람 승인”의 조합이 특정 기술 하나에 올인하는 것보다 현실적입니다.
분명히 해둘 점이 있습니다. 결정론적 코드는 실행을 예측 가능하게 만들 뿐, 결과가 옳다는 것을 보장하지는 않습니다. 탐색 단계에서 고정해 둔 경로에 결함이 있다면, 코드는 그 결함을 안정적으로 반복할 뿐이에요. 시스템 간 작업에서는 하나의 오류가 여러 다운스트림 시스템으로 복제될 수도 있습니다. 그래서 작업 전 상태 점검, 작업 후 결과 검증, 최소 권한, 전 과정 추적 기록은 코드로 고정한 뒤에도 여전히 생략할 수 없습니다. 이 글은 엔지니어링 아키텍처를 다루며, 환자 진료와 관련된 어떤 권고도 포함하지 않습니다.
직접 시작해보려는 팀에게 비교적 안전한 경로는 이렇습니다. 먼저 비운영 환경에서 위험도가 낮고 반복이 많은 프로세스 하나를 골라 탐색, 고정, 실행, 그리고 의도적으로 한 번 만들어낸 인터페이스 변경까지 전체 사이클을 돌려보는 거예요. 이때 모델 호출 비용, 코드 유지보수 공수, 실패 복구 시간을 기록합니다. 이 세 가지 데이터가 어떤 벤치마크 점수보다도 이 아키텍처가 여러분의 환경에서 비용 대비 효과가 있는지를 잘 보여줍니다. 탐색 단계의 다중 모델 비교 테스트는 APIYI apiyi.com의 무료 사용량으로 먼저 시작하고, 실측 결과에 따라 정식 배포할 모델과 접속 방식을 결정하면 됩니다.
CVS의 방안이 주목할 만한 이유는 Agent가 얼마나 똑똑한지를 내세우는 데 있지 않습니다. 오히려 Agent의 한계를 인정하고, 똑똑함을 가장 필요한 곳에 쓰는 데 있습니다. 한 번 탐색하고, 코드로 고정하고, 고장 나면 다시 고친다. 이 경로가 더 많은 기업에서 성립할 수 있을지는 결국 각자의 프로세스가 실제 환경에서 보여주는 실측 데이터에 달려 있습니다.
The proof of the pudding is in the eating.(푸딩이 좋은지는 먹어 봐야 안다: 실제 효과는 실전으로 검증해야 한다.)
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 웹사이트 첫 페이지에서 저희에게 연락해 주세요. 더 많은 접속 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있습니다.


