
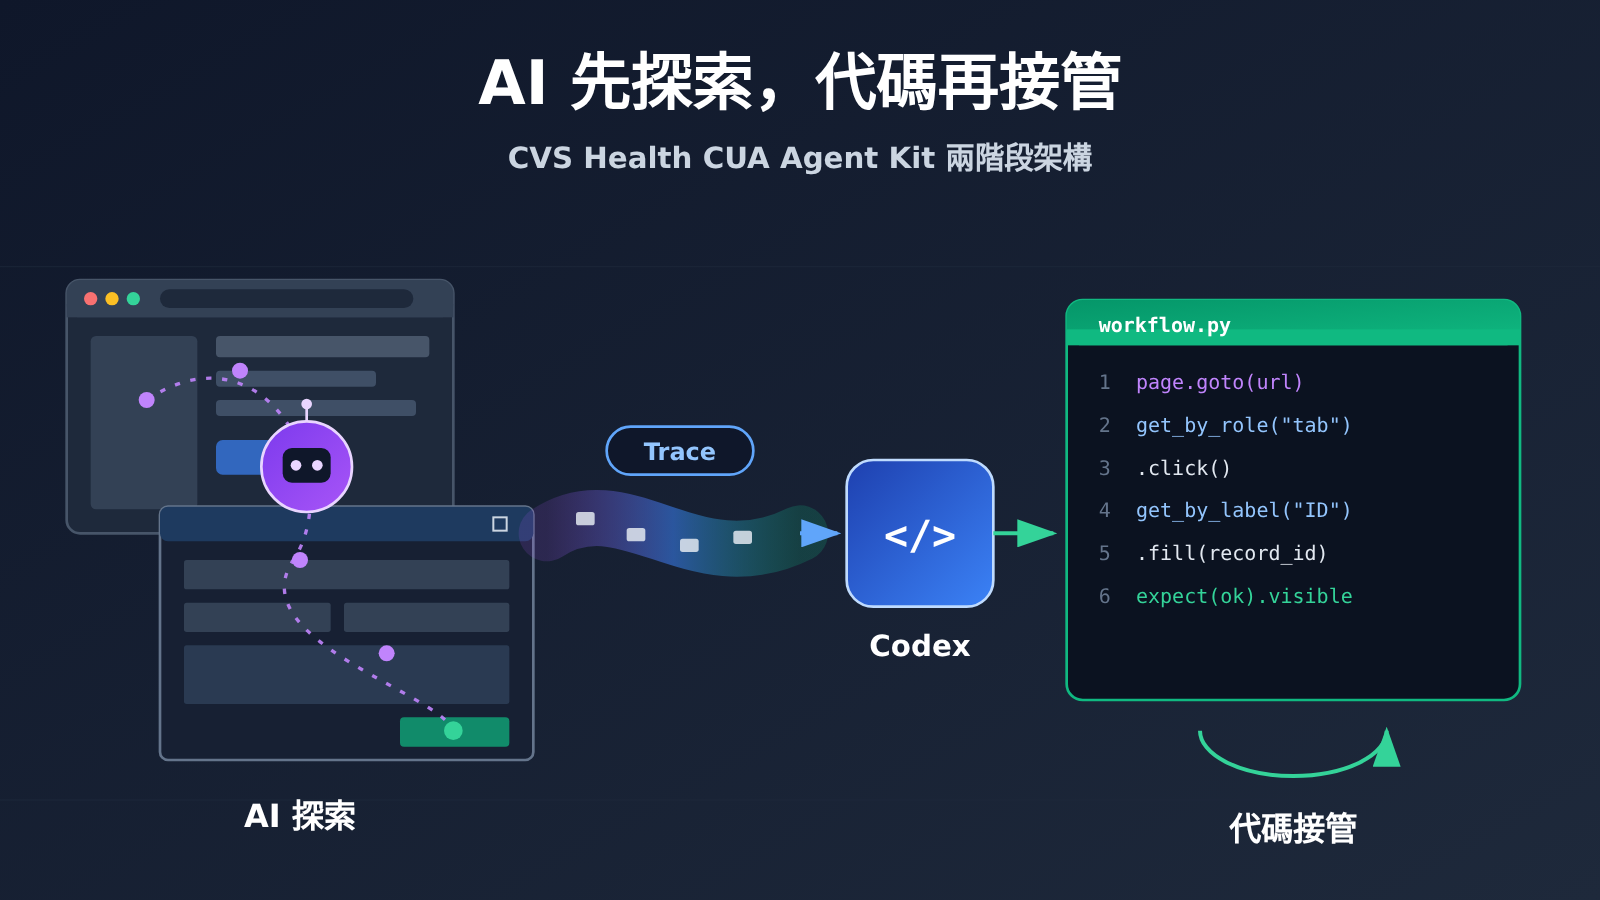
企業 Agent 不必在每一次重複任務中都重新調用大模型。CVS Health 開源的 CUA Agent Kit 給出了一條更經濟的工程路線:先讓 Computer-use Agent 探索未知業務流程,並把成功過程記錄成截圖、事件和 Trace;再由 Codex 把這些證據轉換爲可檢查、可維護、可重複執行的確定性代碼。
這套方案把 AI 的靈活探索能力和傳統自動化的穩定執行能力拼在一起,形成“AI 探索、代碼固化、持續維護”的混合架構。它不是讓 Agent 取代腳本,而是讓 Agent 去寫腳本、修腳本。
您讀完此文能瞭解到什麼?
- CVS Health CUA Agent Kit 如何完成從 AI 探索到代碼固化的兩階段流程
- 截圖、events.jsonl、Trace 和語義定位器在固化環節分別起什麼作用
- 固定流程如何在不調用大模型的情況下運行,出現異常後又如何維護
後文的客觀事實部分依次交代:CUA Agent Kit 的工作機制、從 AI 操作到 Playwright 代碼之間發生了什麼、固化之後 Agent 還承擔哪些維護工作、這套架構與傳統 RPA 的區別有什麼研究依據,以及開發者如何動手複用。分析判斷部分再討論兩個問題:爲什麼 Agent 每次從頭思考是一種浪費,以及哪些任務適合這種混合架構、哪些必須保留人工審覈。
To Know:理解 CVS Agent 自動化路線的 7 個概念
| 概念 | 簡要解釋 |
|---|---|
| Computer Use | 通過觀察軟件界面、執行點擊和輸入等操作來完成任務的能力 |
| EHR | 電子健康記錄系統,醫療機構存放和處理患者病歷的核心軟件 |
| MCP | 用於發現和調用外部工具的標準協議 |
| RPA | 通過預先配置的規則或程序執行重複流程的自動化方式 |
| Rubric points | 按評測規則拆分的評分點,衡量部分要求的達成情況 |
| 端到端成功率 | 完整任務滿足全部成功條件的比例 |
| Trace | 記錄執行過程、操作和頁面狀態的軌跡證據 |
影響速覽:CVS Agent 自動化路線對誰有影響
- 開發者與技術負責人:重點不是“用不用 Agent”,而是按任務拆分執行機制。需要分別驗證探索階段的完成率、固化代碼的穩定性,以及包含維護在內的完整成本,而不是隻看單次模型調用價格。
- 醫療機構與工作流負責人:需要區分合成演示、廠商評測、企業公開案例和自家試點,這幾類證據的分量不同。涉及患者數據和狀態變更的步驟,應提前落實人工審批、最小權限和操作留痕。
客觀事實:CVS Health CUA Agent Kit 的兩階段路線
背景先交代清楚。2026 年 11 月 16 日,OpenAI 發佈面向醫療團隊的 Computer-use Agent 進展,公佈了臨牀和醫療行政任務的評測結果,以及與 CVS Health、Cigna Healthcare、Abridge、Ambience 等機構的合作實踐。CVS Health 在其中披露了生產環境案例,並開源了 CUA Agent Kit,許可證爲 Apache-2.0。
CVS Health 方面公開的生產結果包括:某個生產工作流中的 Agent 在一個週末清理了積壓數月的文件發送任務;另一個 Agent 每天處理數萬次專科會診中的系統操作步驟。系統配有驗證檢查和人工監督,並通過截圖和操作記錄覈對實際操作與應用狀態。需要注意,這些都是企業自行披露的數據。“數萬次”指的是會診相關的系統操作步驟,不代表數萬個臨牀決策由 AI 獨立完成。公開材料也沒有說明這些生產 Agent 是否完全基於開源版 Agent Kit 構建,兩者不應直接畫等號。
來源: openai.com/index/advancing-computer-use-for-healthcare-teams/
CVS Health 的 CUA Agent Kit 是如何工作的?
項目 README 對自己的定位很直白:這是一個用於自動化瀏覽器和 Windows 工作流的起步工具包,用 AI 發現步驟,再用代碼重複執行。項目特別強調,“搞清楚任務怎麼做”和“長期穩定地重複做”是兩個不同的問題,應該用不同的手段解決。
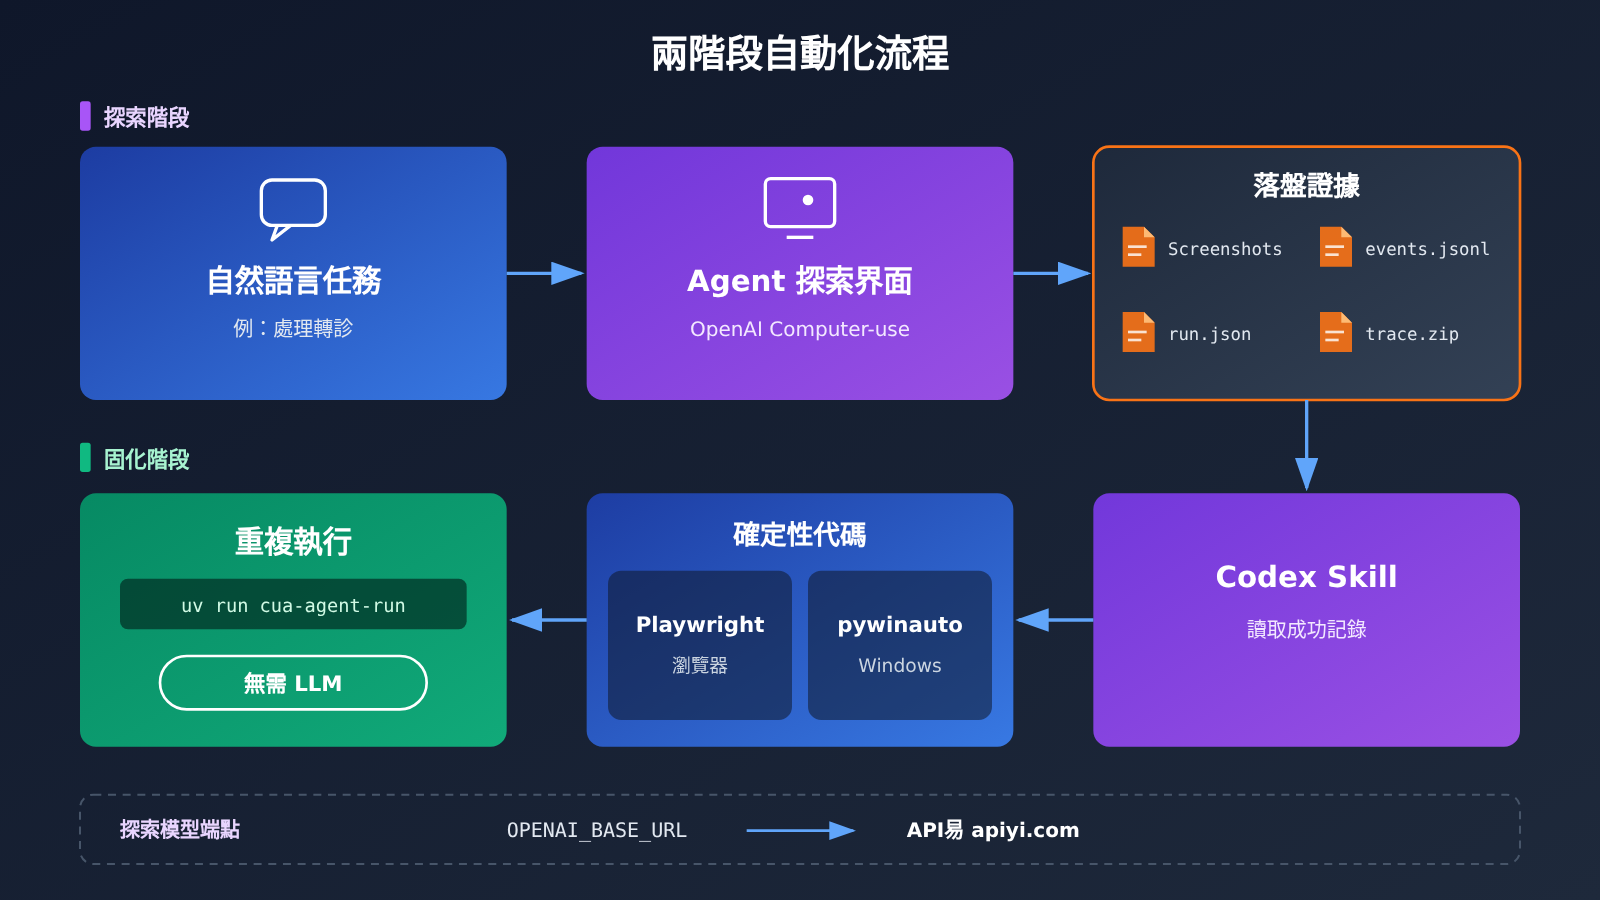
整個流程分爲兩個階段:
- 探索階段:OpenAI Computer-use Agent 接收自然語言描述的任務,例如“找到某條記錄並處理轉診”,在真實界面中探索、執行和驗證。過程中保存截圖、操作動作、操作目標和執行軌跡。
- 固化階段:Codex Skill 讀取已經成功的探索記錄,生成或更新確定性工作流代碼。之後同一流程的重複執行交給普通代碼,不再要求大模型每次重新推理。
探索階段留下的證據都是落盤文件,而不是停留在模型內部的推理過程。README 公開的記錄類型如下:
| 記錄 | 主要用途 | 在固化環節的價值 |
|---|---|---|
| Screenshots | 記錄每一步的界面狀態 | 供工程師和 Codex 覈對頁面到底長什麼樣 |
| events.jsonl | 逐行記錄操作事件 | 還原“做了什麼、按什麼順序做” |
| run.json | 記錄本次運行信息 | 區分不同運行、判斷是否成功 |
| trace.zip | Playwright 執行軌跡 | 提供元素、網絡和時序等細節,用於生成和診斷代碼 |
來源: github.com/cvs-health/cua-agent-kit
從 AI 操作到 Playwright 代碼,CVS Agent Kit 做了什麼?
固化階段最關鍵的一個細節是:生成的不是“鼠標座標回放”。CVS 項目在生成瀏覽器工作流時,會利用語義定位器(Semantic Locators)產出 Playwright 代碼,通過元素的角色、名稱等語義特徵定位目標,而不是死記某個屏幕座標。
兩者的差別在維護時最明顯。座標回放受分辨率、窗口大小、佈局微調影響,按鈕挪動幾個像素就可能點空,而且出錯後很難從一串座標裏看出原本想點什麼。語義定位器寫出來的代碼類似“點擊名爲‘提交’的按鈕”,意圖寫在代碼裏,工程師能直接審查,頁面局部調整時也更不容易失效。當然,如果按鈕改名或流程改版,語義定位器同樣會失敗,只是失敗更容易定位。
項目的工具分工如下:
- Playwright:負責瀏覽器工作流的確定性執行,併產出 trace.zip 這類可回放軌跡。
- pywinauto:負責 Windows 桌面應用的自動化,覆蓋沒有網頁界面的老系統。
- Codex Skill:讀取成功的探索軌跡,生成或更新上述兩類代碼。
這一思路與 OpenAI 官方文檔的方向一致。OpenAI 的 Computer Use 指南介紹了兩種路徑:一種是模型返回結構化的鼠標鍵盤動作,由應用執行;另一種是模型生成代碼,藉助 Playwright 等工具操作界面。文檔對 GPT-6 Astra 推薦代碼執行方式,Computer Tool 仍作爲可選方案。ComputerToolset、BrowserToolset 和託管瀏覽器入口在官方指南中分別說明。
來源: developers.openai.com/api/docs/guides/tools-computer-use
固化之後,CVS Agent Kit 中的 Agent 還需要做什麼?
流程固化後,確定性執行通過 README 給出的命令運行:
uv run cua-agent-run
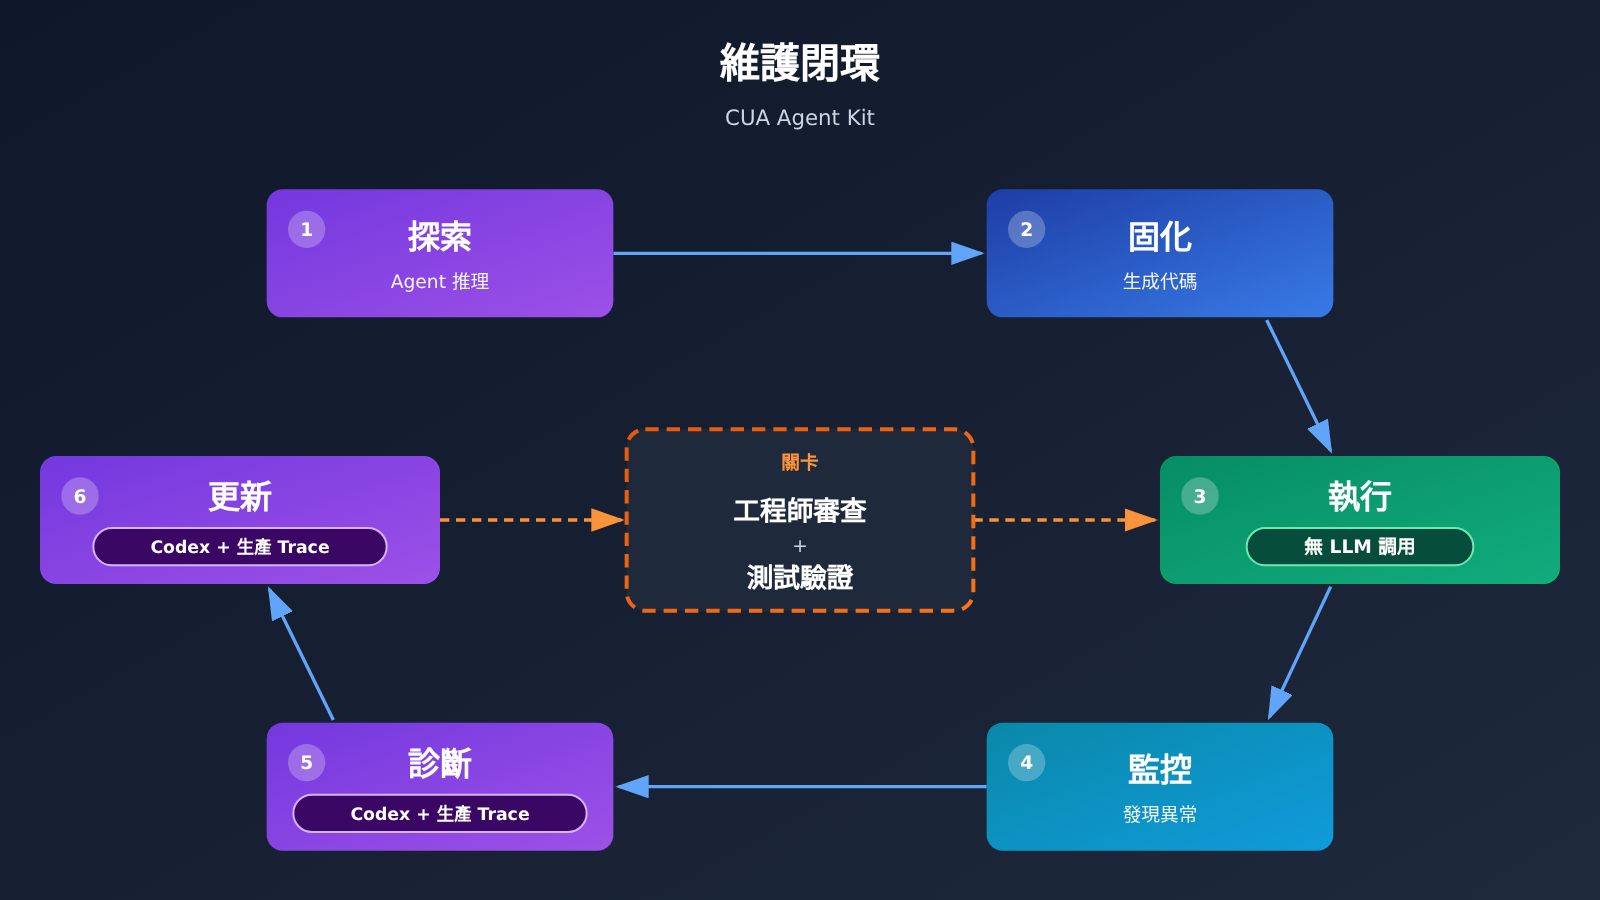
這一階段不需要每次調用大模型,也不需要 API Key。但項目並沒有把“固化”當成一勞永逸。README 描述的維護機制是一個閉環:
- 固定工作流按計劃執行;
- 在生產 Trace 中發現異常;
- Codex 利用 Trace 診斷問題;
- 更新確定性代碼;
- 由工程師審查改動;
- 通過測試和驗證後,重新投入重複執行。
換句話說,Agent 的角色從“每次都親自幹活”變成了“平時不在場,出問題時來修代碼”。代碼會失敗,界面會改版,這一點項目本身就默認了,所以才設計了診斷和審查環節。
CVS 的混合 Agent 自動化與傳統 RPA 有什麼區別?
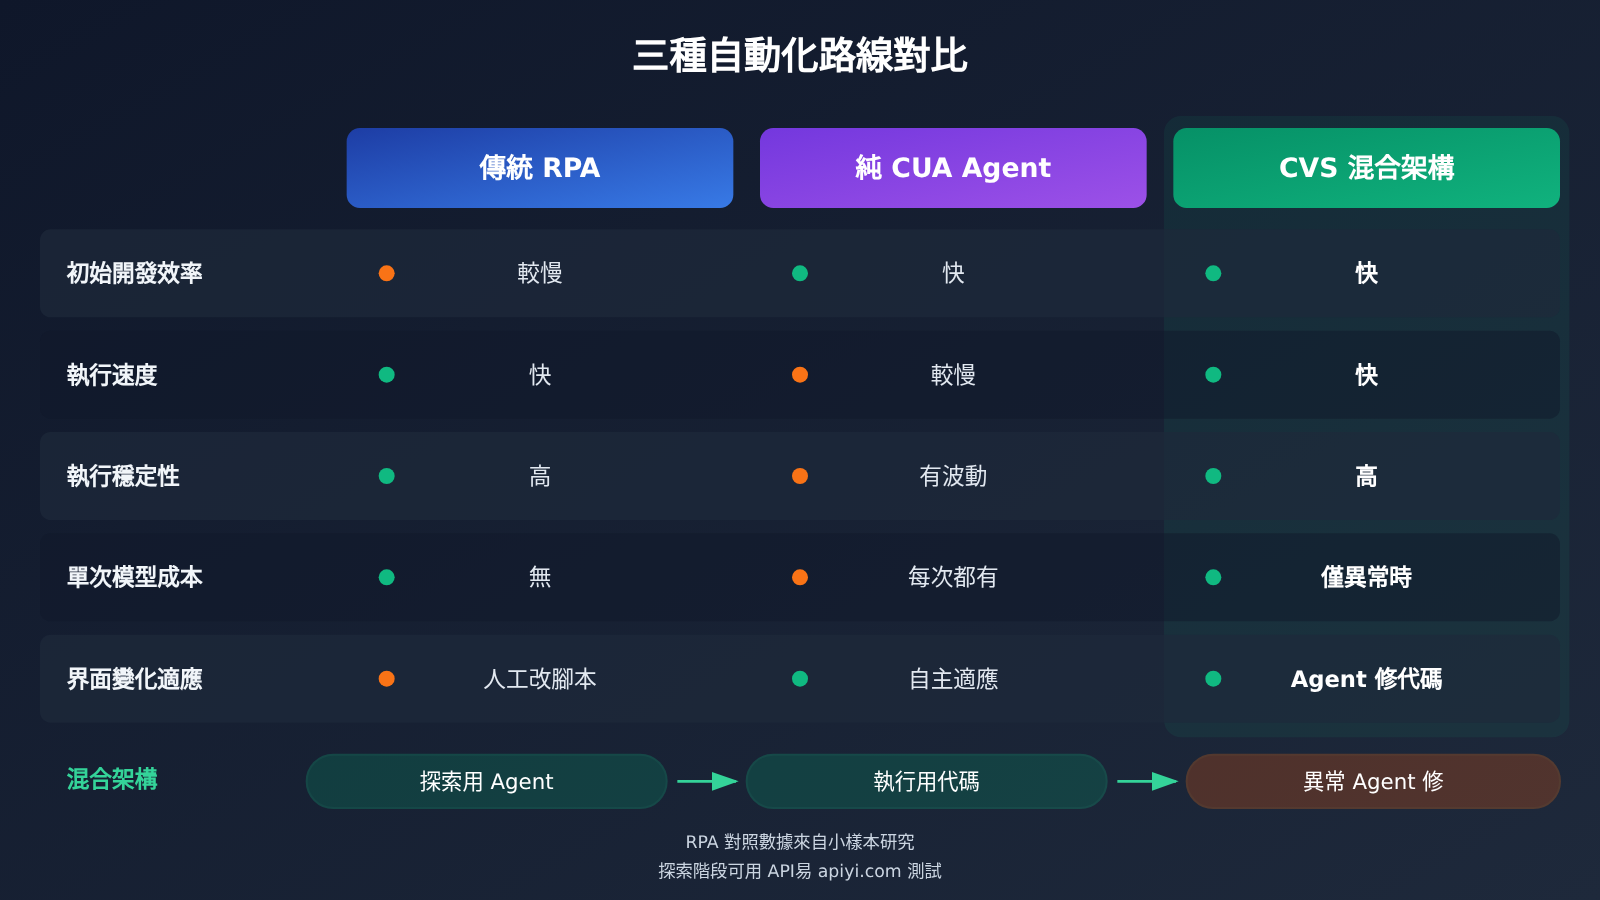
傳統 RPA 依賴預先配置的步驟和界面定位,執行快、結果穩定,但開發和改版維護需要人工投入。純 Agent 能理解自然語言、適應界面變化,但每次重新推理會帶來成本和結果波動。CUA Agent Kit 的定位介於兩者之間:用 Agent 替代“人工錄製和編寫流程”這一步,執行階段則回到確定性代碼。
關於兩者的直接對比,可參考 2026 年發表的一項研究:Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks(DOI: 10.1080/23311975.2026.2724760)。研究在 2025 年 5—6 月進行,對比 UiPath Studio 2023.4.0 與 Anthropic Computer Use Agent,覆蓋數據錄入、監控、文檔提取三類標準任務。
| 任務 | RPA 成功率 | Agent 成功率 | 初步開發時間(單開發者觀察) |
|---|---|---|---|
| P1 | 未納入對照統計 | Agent 僅運行 1 次即失敗,未進入後續統計 | 未披露 |
| P2 | 100%(10 次) | 90%(10 次) | Agent 約 10 分鐘,RPA 約 38 分鐘 |
| P3 | 100%(10 次) | 60%(10 次) | Agent 約 15 分鐘,RPA 約 240 分鐘 |
研究還發現,RPA 在 P2、P3 中執行速度顯著更快;Agent 的問題主要包括界面操作失敗、上下文丟失和判斷錯誤;Agent 對動態界面的適應能力有潛在優勢。
這項研究的邊界必須說清楚:
- 樣本很小:P2、P3 每種技術各 10 次,P1 並非“每技術 10 次”,不能籠統概括。
- 開發時間只是初步觀察:來自單個開發者,沒有統計代表性,不能當作行業平均值。
- 工具版本偏舊:研究使用的是 2025 年的 Agent 配置,不能代表 2026 年新模型的成績。
即便如此,結論方向與 CVS 的設計相互印證:Agent 擅長快速探索和靈活處理,RPA 式的確定性執行在穩定重複方面仍有優勢。
來源: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
開發者如何複用 CVS CUA Agent Kit 的思路?
README 列出的環境要求不多:
- Python 3.12 或更高版本;
- uv(Python 包與項目管理工具);
- 可訪問的目標網站或桌面應用;
- 探索階段需要
OPENAI_API_KEY; - 可通過
OPENAI_BASE_URL配置自定義 API Endpoint。
使用上對應三個階段:發現(Agent 探索並留證據)、固化(Codex 生成代碼)、運行(確定性執行)。發現和固化階段的具體命令與參數請以倉庫 README 爲準,運行階段即前文的 uv run cua-agent-run。
OPENAI_BASE_URL 這個設計值得留意。它意味着探索階段的模型入口可以指向官方 API,也可以指向企業內部網關或其他兼容 OpenAI 接口的服務,便於統一鑑權、計費和審計。探索階段的環境變量可以這樣配置:
# 探索階段:需要模型 API
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # 使用 API易 統一接口,或換成你的網關

# 運行階段:確定性執行,不需要 API Key
uv run cua-agent-run
需要強調一點:Computer Use 依賴特定的 Responses API 能力和工具類型。換用任何自定義端點前,都要先確認該端點支持探索階段所需的模型與工具,用一個簡單流程跑通再推廣。
固化之後,日常維護中最常做的事是讀 Trace 和事件日誌。下面是一個輔助腳本示例:把一次運行的 events.jsonl 交給通用大模型,讓它整理出步驟清單和可疑失敗點,供工程師審查時參考。events.jsonl 的具體字段以項目實際輸出爲準,這裏只按行讀取;涉及患者等敏感信息時,務必先脫敏,或只在合規環境內處理。
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """讀取已脫敏的 events.jsonl,生成步驟清單與疑似失敗點"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # 控制上下文長度
    prompt = (
        "以下是一次界面自動化運行的事件日誌。"
        "請按順序列出操作步驟,並指出最可能導致失敗的步驟及原因,"
        "只基於日誌內容,不要臆測。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # 替換爲你在平臺上實際可用的模型
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
這個腳本只是輔助閱讀,不替代 Codex 根據完整 Trace 診斷問題,也不替代工程師審查和測試。
🚀 快速上手建議:複用這套思路時,可以先挑一個內部測試站點上的低風險流程跑通“探索 → 固化 → 運行”全鏈路。探索階段需要反覆調用模型對比效果,可以通過 API易 apiyi.com 獲取免費測試額度,用同一個 API Key 切換不同模型做日誌分析等輔助任務,再決定正式環境的模型選型。
分析判斷:CVS Agent 自動化路線的取捨
以下內容是基於前述事實的解讀,不是項目方或 OpenAI 的結論。
爲什麼 Agent 每次都從頭思考是一種浪費?
多步驟業務自動化有一個特點:流程一旦跑通,後面絕大多數執行都是同一條路徑。如果每次都讓 Computer-use Agent 重新截圖、理解界面、規劃下一步,模型其實是在爲已經知道答案的問題反覆付費。這種重複推理會同時帶來三類代價。
第一是成本。Computer Use 是多輪調用,每一步操作後的截圖屬於圖像輸入,會持續累積 Token。以 OpenAI 2026 年 11 月 17 日公佈的 Standard 短上下文價格爲例,GPT-6 Astra 輸入、輸出、緩存輸入分別爲每百萬 Token 10、50、1 美元,GPT-6 Luna 爲 0.10、0.50、0.01 美元。在 HealthAdminBench 評測中,Luna 每任務成本爲 0.085 美元,比 Astra 低 98%;按此比例反推,Astra 約爲每任務 4.25 美元,但這只是估算值,而且是基準測試條件下的成本,不能當作生產報價。
第二是延遲。每一步都要等模型返回,流程越長,等待越久。前文研究中 RPA 在 P2、P3 的執行速度顯著快於 Agent,原因也在於此。
第三是波動。同一任務多次運行,Agent 可能走出不同路徑,研究中 P3 的 Agent 成功率只有 60%。對於需要可預測、可審計的業務,這種不確定性比成本更難接受。
因此,兩個階段的成本結構應當分開覈算:
| 成本項 | 探索階段(Agent) | 執行階段(確定性代碼) |
|---|---|---|
| 模型 Token | 每輪視覺與文本輸入、計費輸出分別統計;重試 Token 已計入總量的不重複加 | 正常運行爲零 |
| 工具與運行環境 | 瀏覽器、桌面環境、容器等實際使用的服務 | 運行代碼的機器與瀏覽器環境 |
| 工程投入 | 編寫任務描述、覈對證據、審查生成代碼 | 監控、異常診斷、代碼更新與測試 |
| 發生頻率 | 新流程上線或流程大改時 | 每次業務執行 |
| 推薦做法 | 按複雜度分層選模型,高難流程用強模型,結構化流程用低價模型 | 儘量不調用模型,異常時纔回到 Agent 修復 |
混合架構的經濟性正來自這張表:昂貴的模型調用集中在低頻的探索和修復環節,高頻的執行環節回到接近零邊際模型成本的代碼。真實賬本還要算上維護投入,界面改版越頻繁,回到探索階段的次數越多,節省幅度就越小。
💰 成本建議:探索階段的模型分層選型,最好用自己的真實流程實測,而不是照搬基準數字。通過 API易 apiyi.com 可以在同一套 OpenAI 兼容接口下切換模型,按量計費,便於對比不同模型在探索和日誌診斷環節的實際 Token 消耗。
這裏還有一個容易被忽略的評測口徑問題。OpenAI 公佈的 HealthAdminBench 成績爲 Astra 94.3%、Luna 91.8%,均爲最高推理強度下的 rubric points 佔比,不是端到端成功率。斯坦福團隊論文 2604.09937v1 版本包含 135 項任務、1698 個子任務(其中 1177 個確定性評分、521 個由模型裁判),報告的最佳完整任務成功率爲 36.3%(Claude Opus 4.6 CUA),最佳子任務成功率爲 82.8%(GPT-5.4 CUA);早期網頁披露的 70 項任務、947 個評分點屬於另一個公開版本,只能作爲歷史對照。這些數字來自不同模型、日期、執行條件和指標,不能排成同一張榜單。
對“先探索後固化”而言,端到端成功率比局部得分更關鍵。Codex 需要的是一條完整成功的軌跡,探索階段在 90% 的子步驟上做對、卻卡在最後一步提交,留下的 Trace 依然無法直接固化。選模型時,應當用自己的流程測完整任務的成功率。
什麼任務適合 CVS 式的混合 Agent 架構?
把前述事實合在一起,可以得到一張大致的任務分工表:
| 任務特徵 | 推薦執行方式 | 典型例子 | 人工介入 |
|---|---|---|---|
| 流程未知、缺少文檔、界面複雜 | Agent 探索並留證據 | 首次梳理某個老系統的操作路徑 | 審查探索結果和生成代碼 |
| 流程穩定、高頻重複、可用狀態驗證 | 固化爲確定性代碼 | 跨系統文件發送、固定字段搬運 | 抽檢結果、監控異常 |
| 已有 API 覆蓋 | 優先調用 API | 結構化數據寫入 | 按常規權限管理 |
| 界面頻繁改版 | 固化後加強監控,預留回到探索的預算 | 第三方門戶 | 每次代碼更新都需審查 |
| 改變高風險業務狀態 | 代碼或 Agent 只做到草稿 / 待審批 | 提交申請、發送消息、修改記錄 | 必須人工審批 |
醫療場景中,其他合作方的做法也提供了參照。Ambience 展示的方案在病歷存在歧義時讓 Agent 停下來詢問醫生,提交前等待批准;Assort 的案例則是 API 負責能覆蓋的部分,Computer Use 只補齊 API 未覆蓋的界面步驟。“API + Computer Use + 確定性代碼 + 人工審批”的組合,比單押某一種技術更現實。
需要明確的是,確定性代碼只是讓執行可預測,並不保證結果正確。如果探索階段固化下來的是一條有缺陷的路徑,代碼會穩定地重複這個缺陷;跨系統操作中,一個錯誤還可能被複制到多個下游系統。因此,操作前狀態檢查、操作後結果驗證、最小權限和全程留痕,在固化之後依然不能省。本文討論的是工程架構,不涉及任何患者診療建議。
對於想動手的團隊,比較穩妥的路徑是:先在非生產環境挑一個低風險、高重複的流程,完整走一遍探索、固化、運行和一次人爲製造的界面變更,記錄模型調用成本、代碼維護工時和失敗恢復時間。這三項數據比任何基準分數都更能說明這套架構在你的場景裏是否划算。探索階段的多模型對比測試,可以先用 API易 apiyi.com 的免費額度起步,再根據實測結果決定正式部署的模型和接入方式。
CVS 的方案之所以值得關注,不在於它宣稱 Agent 有多聰明,而在於它承認了 Agent 的侷限,並把聰明用在最該用的地方:探索一次,固化成代碼,壞了再修。這條路線能否在更多企業成立,最終要看各家流程在真實環境中的實測數據。
The proof of the pudding is in the eating.(布丁好不好,喫了才知道:實際效果要靠實踐檢驗。)
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 apiyi.com 網站首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心


