
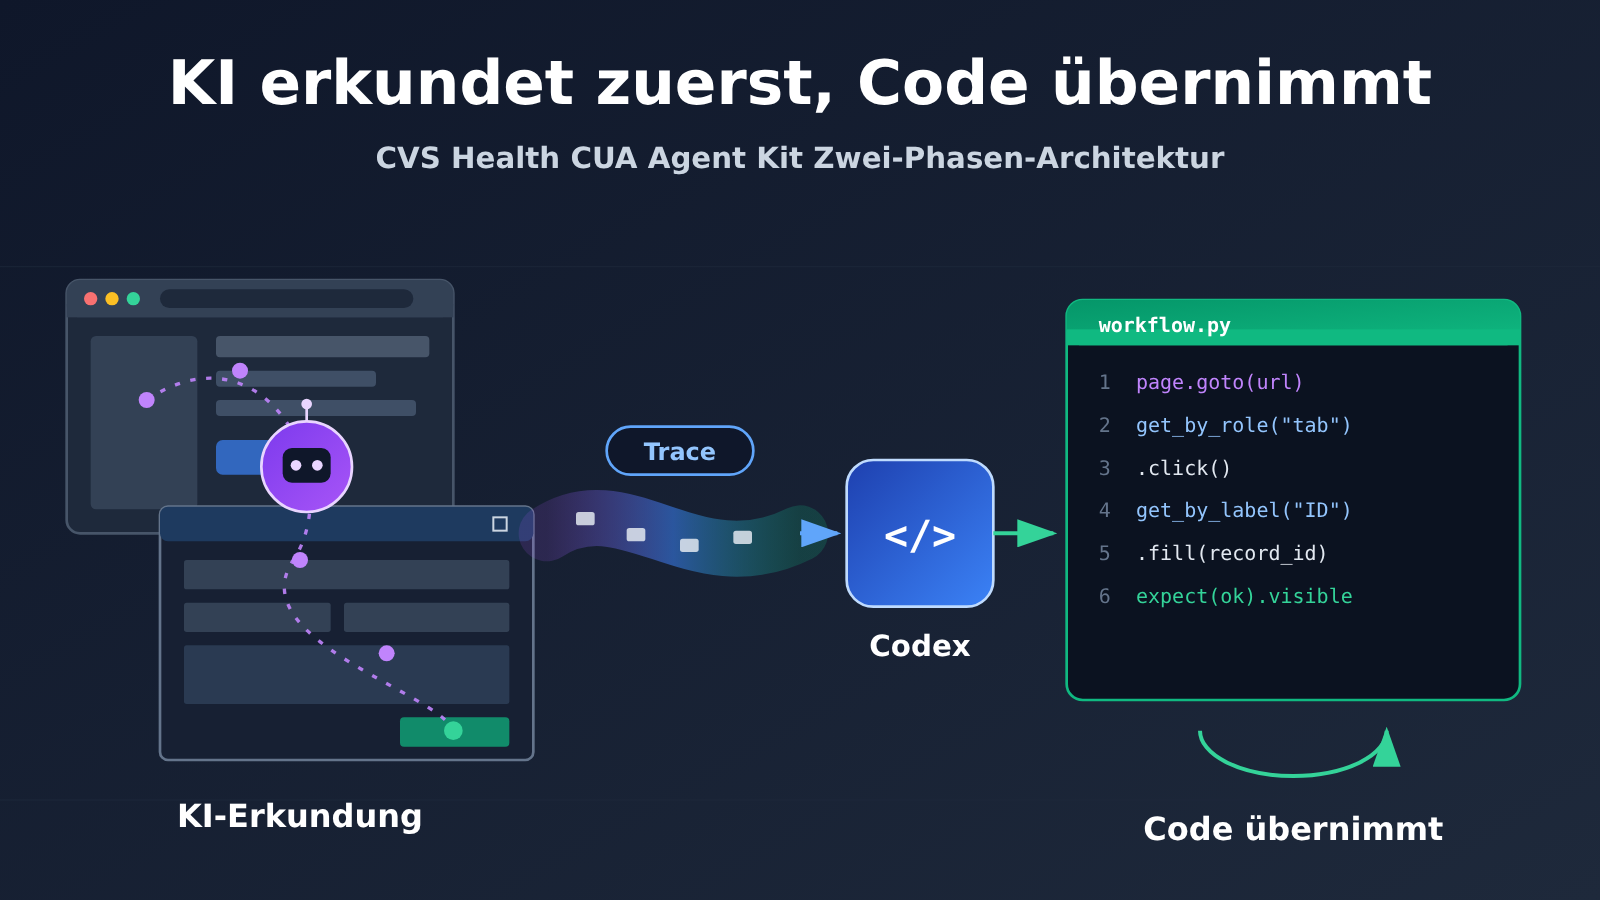
Unternehmen-Agenten müssen bei jeder wiederkehrenden Aufgabe nicht erneut ein großes Sprachmodell aufrufen. Das von CVS Health quelloffene CUA Agent Kit zeigt einen wirtschaftlicheren Engineering-Weg: Zuerst erkundet ein Computer-Use-Agent unbekannte Geschäftsprozesse und zeichnet den erfolgreichen Ablauf als Screenshots, Events und Trace auf; anschließend wandelt Codex diese Belege in überprüfbaren, wartbaren und reproduzierbar ausführbaren deterministischen Code um.
Dieser Ansatz kombiniert die flexible Erkundungsfähigkeit von KI mit der stabilen Ausführung traditioneller Automatisierung und bildet eine Hybridarchitektur aus „KI erkundet, Code verfestigt, kontinuierliche Wartung“. Dabei ersetzt der Agent nicht die Skripte, sondern schreibt und repariert sie.
Was Sie nach dem Lesen dieses Artikels wissen:
- Wie das CVS Health CUA Agent Kit den zweistufigen Prozess von der KI-Erkundung bis zur Code-Verfestigung umsetzt
- Welche Rolle Screenshots, events.jsonl, Trace und semantische Locator im Verfestigungsschritt jeweils spielen
- Wie festgelegte Abläufe ohne Aufruf eines großen Sprachmodells laufen und wie sie bei Anomalien gewartet werden
Der sachliche Teil im Folgenden beschreibt der Reihe nach: den Arbeitsmechanismus des CUA Agent Kit, was zwischen der KI-Bedienung und dem Playwright-Code passiert, welche Wartungsaufgaben der Agent nach der Verfestigung übernimmt, welche Forschungsbelege es für den Unterschied zwischen dieser Architektur und klassischer RPA gibt und wie Entwickler sie praktisch wiederverwenden können. Im analytischen Teil werden anschließend zwei Fragen erörtert: Warum es Verschwendung ist, wenn der Agent jedes Mal von vorn denkt, und welche Aufgaben für diese Hybridarchitektur geeignet sind, während bei welchen eine menschliche Prüfung zwingend erhalten bleiben muss.
To Know: Die 7 Konzepte zum Verständnis der Automatisierungsstrategie des CVS-Agent
| Konzept | Kurze Erklärung |
|---|---|
| Computer Use | Die Fähigkeit, Aufgaben zu erledigen, indem man die Softwareoberfläche beobachtet und Klicks, Eingaben und ähnliche Aktionen ausführt |
| EHR | Elektronisches Gesundheitsakten-System – die Kernsoftware, in der medizinische Einrichtungen Patientenakten speichern und verarbeiten |
| MCP | Ein Standardprotokoll zum Auffinden und Aufrufen externer Tools |
| RPA | Ein Automatisierungsansatz, bei dem wiederkehrende Abläufe über vorkonfigurierte Regeln oder Programme ausgeführt werden |
| Rubric points | Bewertungspunkte, die nach Bewertungsregeln aufgeteilt sind und messen, inwieweit Teilanforderungen erfüllt sind |
| End-to-End-Erfolgsrate | Der Anteil vollständiger Aufgaben, die alle Erfolgsbedingungen erfüllen |
| Trace | Belege in Form einer Spur, die den Ausführungsverlauf, die Aktionen und die Seitenzustände aufzeichnen |
Auswirkungen im Überblick: Wen die Automatisierungsstrategie des CVS-Agent betrifft
- Entwickler und technische Leiter: Im Mittelpunkt steht nicht die Frage „Agent ja oder nein“, sondern die Aufteilung des Ausführungsmechanismus nach Aufgabe. Es gilt, getrennt voneinander die Abschlussrate in der Explorationsphase, die Stabilität des festgeschriebenen Codes und die vollständigen Kosten inklusive Wartung zu prüfen – und nicht nur den Preis eines einzelnen Modellaufrufs zu betrachten.
- Medizinische Einrichtungen und Workflow-Verantwortliche: Es ist wichtig, zwischen synthetischen Demos, Anbieter-Bewertungen, öffentlich zugänglichen Unternehmensfallstudien und eigenen Pilotprojekten zu unterscheiden – diese Arten von Belegen haben unterschiedliches Gewicht. Bei Schritten, die Patientendaten und Statusänderungen betreffen, sollten manuelle Freigaben, minimale Berechtigungen und die Nachverfolgbarkeit von Aktionen im Voraus umgesetzt werden.
Faktenlage: Der zweistufige Ansatz des CVS Health CUA Agent Kit
Zuerst der Hintergrund. Am 16. November 2026 veröffentlichte OpenAI Neuigkeiten zu Computer-Use-Agenten für medizinische Teams – inklusive Evaluierungsergebnissen für klinische und medizinisch-administrative Aufgaben sowie Einblicken in die Zusammenarbeit mit CVS Health, Cigna Healthcare, Abridge, Ambience und weiteren Organisationen. CVS Health stellte dabei einen Fall aus dem Produktivbetrieb vor und veröffentlichte das CUA Agent Kit als Open Source unter der Apache-2.0-Lizenz.
Die von CVS Health öffentlich genannten Produktionsergebnisse umfassen: Ein Agent in einem produktiven Workflow hat an einem Wochenende einen mehrere Monate alten Rückstand bei der Dateiversendung abgearbeitet. Ein anderer Agent bearbeitet täglich Zehntausende Systembedienschritte im Rahmen von Facharztkonsultationen. Das System verfügt über Verifikationsprüfungen und menschliche Aufsicht und gleicht die tatsächlich ausgeführten Aktionen über Screenshots und Aktionsprotokolle mit dem Anwendungszustand ab. Wichtig: Es handelt sich dabei durchweg um Daten, die das Unternehmen selbst veröffentlicht hat. „Zehntausende“ bezieht sich auf Systembedienschritte im Kontext von Konsultationen und bedeutet nicht, dass Zehntausende klinischer Entscheidungen eigenständig von der KI getroffen wurden. Aus den öffentlich zugänglichen Materialien geht außerdem nicht hervor, ob diese Produktions-Agenten vollständig auf der Open-Source-Version des Agent Kit aufbauen – beides sollte man nicht gleichsetzen.
Quelle: openai.com/index/advancing-computer-use-for-healthcare-teams/
Wie funktioniert das CUA Agent Kit von CVS Health?
Die README des Projekts beschreibt sich selbst ganz direkt: Es ist ein Starter-Toolkit zur Automatisierung von Browser- und Windows-Workflows – mit KI werden die Schritte entdeckt, mit Code werden sie anschließend wiederholt ausgeführt. Das Projekt betont ausdrücklich, dass „herausfinden, wie eine Aufgabe erledigt wird“ und „sie langfristig stabil wiederholen“ zwei unterschiedliche Probleme sind, die mit unterschiedlichen Mitteln gelöst werden sollten.
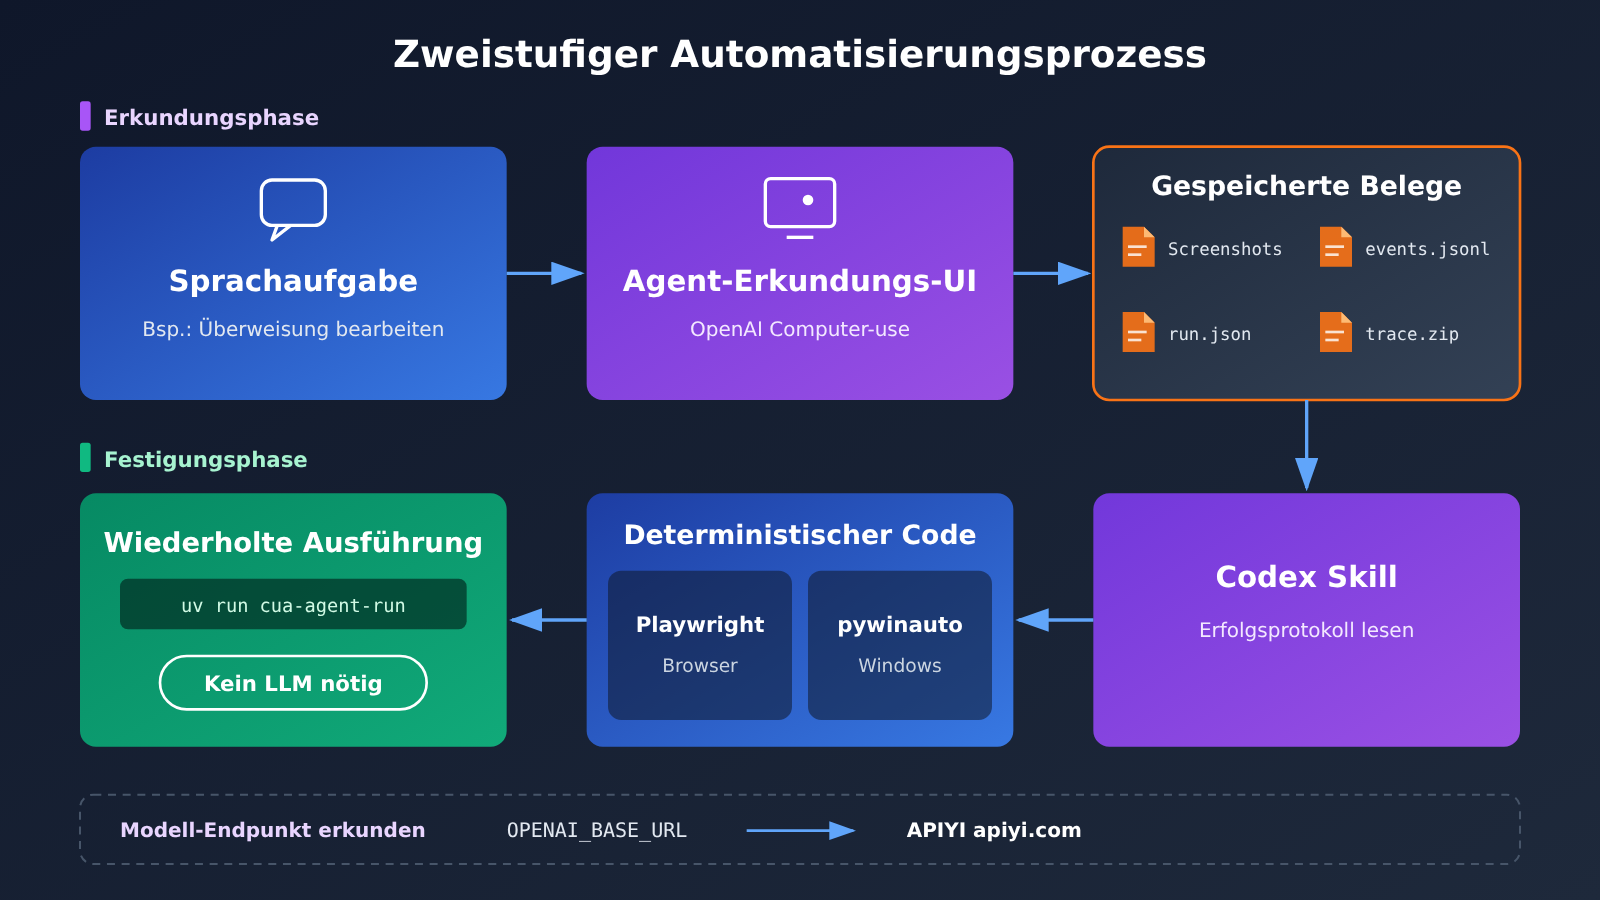
Der gesamte Ablauf besteht aus zwei Phasen:
- Erkundungsphase: Der OpenAI Computer-use Agent erhält eine in natürlicher Sprache beschriebene Aufgabe, zum Beispiel „einen bestimmten Datensatz finden und eine Überweisung bearbeiten“, und erkundet, führt aus und verifiziert in der realen Oberfläche. Dabei werden Screenshots, ausgeführte Aktionen, Aktionsziele und Ausführungsverläufe gespeichert.
- Festigungsphase: Der Codex Skill liest die erfolgreichen Erkundungsaufzeichnungen und erzeugt oder aktualisiert deterministischen Workflow-Code. Die wiederholte Ausführung desselben Ablaufs wird danach von gewöhnlichem Code übernommen – das große Sprachmodell muss nicht jedes Mal neu reasoning betreiben.
Die Belege aus der Erkundungsphase liegen alle als Dateien auf der Festplatte vor und verbleiben nicht im internen Reasoning-Prozess des Modells. Die in der README öffentlich dokumentierten Aufzeichnungstypen sind:
| Aufzeichnung | Hauptzweck | Wert in der Festigungsphase |
|---|---|---|
| Screenshots | Halten den Oberflächenzustand jedes Schritts fest | Damit Ingenieure und Codex abgleichen können, wie die Seite tatsächlich aussieht |
| events.jsonl | Protokollieren Bedienereignisse Zeile für Zeile | Rekonstruieren „was getan wurde, in welcher Reihenfolge“ |
| run.json | Speichern der Informationen zu diesem Lauf | Unterscheiden verschiedener Läufe, Beurteilen des Erfolgs |
| trace.zip | Playwright-Ausführungsverlauf | Liefert Details zu Elementen, Netzwerk und Timing für die Codegenerierung und Diagnose |
Quelle: github.com/cvs-health/cua-agent-kit
Von KI-Aktionen zu Playwright-Code: Was leistet das CVS Agent Kit?
Das entscheidendste Detail in der Konsolidierungsphase ist: Was hier erzeugt wird, ist keine „Mauskoordinaten-Wiedergabe“. Wenn das CVS-Projekt Browser-Workflows generiert, nutzt es semantische Locators (Semantic Locators), um Playwright-Code zu erzeugen. Die Ziele werden dabei über semantische Merkmale wie die Rolle und den Namen des Elements angesteuert, statt sich eine bestimmte Bildschirmkoordinate zu merken.
Der Unterschied zwischen beiden Ansätzen zeigt sich bei der Wartung am deutlichsten. Die Koordinaten-Wiedergabe hängt von Auflösung, Fenstergröße und kleinen Layout-Anpassungen ab. Verschiebt sich ein Button um ein paar Pixel, kann der Klick ins Leere gehen – und wenn ein Fehler auftritt, lässt sich aus einer Reihe von Koordinaten kaum noch erkennen, was ursprünglich angeklickt werden sollte. Code aus semantischen Locators liest sich eher wie „Klicke auf den Button mit dem Namen ‚Absenden'“. Die Absicht steht im Code, Ingenieure können sie direkt prüfen, und bei lokalen Anpassungen der Seite fällt sie weniger leicht aus. Natürlich scheitern semantische Locators ebenso, wenn ein Button umbenannt oder der Ablauf überarbeitet wird – nur lässt sich das Scheitern leichter lokalisieren.
Die Aufgabenverteilung der Tools im Projekt sieht so aus:
- Playwright: Zuständig für die deterministische Ausführung von Browser-Workflows und erzeugt abspielbare Traces wie trace.zip.
- pywinauto: Zuständig für die Automatisierung von Windows-Desktop-Anwendungen und deckt alte Systeme ohne Weboberfläche ab.
- Codex Skill: Liest erfolgreiche Explorations-Traces und generiert oder aktualisiert die beiden oben genannten Code-Arten.
Dieser Ansatz deckt sich mit der Richtung der offiziellen OpenAI-Dokumentation. Der Computer-Use-Leitfaden von OpenAI beschreibt zwei Wege: Einmal gibt das Modell strukturierte Maus- und Tastaturaktionen zurück, die die Anwendung ausführt; zum anderen generiert das Modell Code und bedient die Oberfläche mit Tools wie Playwright. Die Dokumentation empfiehlt für GPT-6 Astra die Code-Ausführung; das Computer Tool bleibt eine optionale Alternative. ComputerToolset, BrowserToolset und der Einstiegspunkt für den gehosteten Browser werden im offiziellen Leitfaden jeweils separat erläutert.
Quelle: developers.openai.com/api/docs/guides/tools-computer-use
Was muss der Agent im CVS Agent Kit nach der Fixierung noch tun?
Nach der Fixierung des Workflows läuft die deterministische Ausführung über den Befehl aus der README:
uv run cua-agent-run
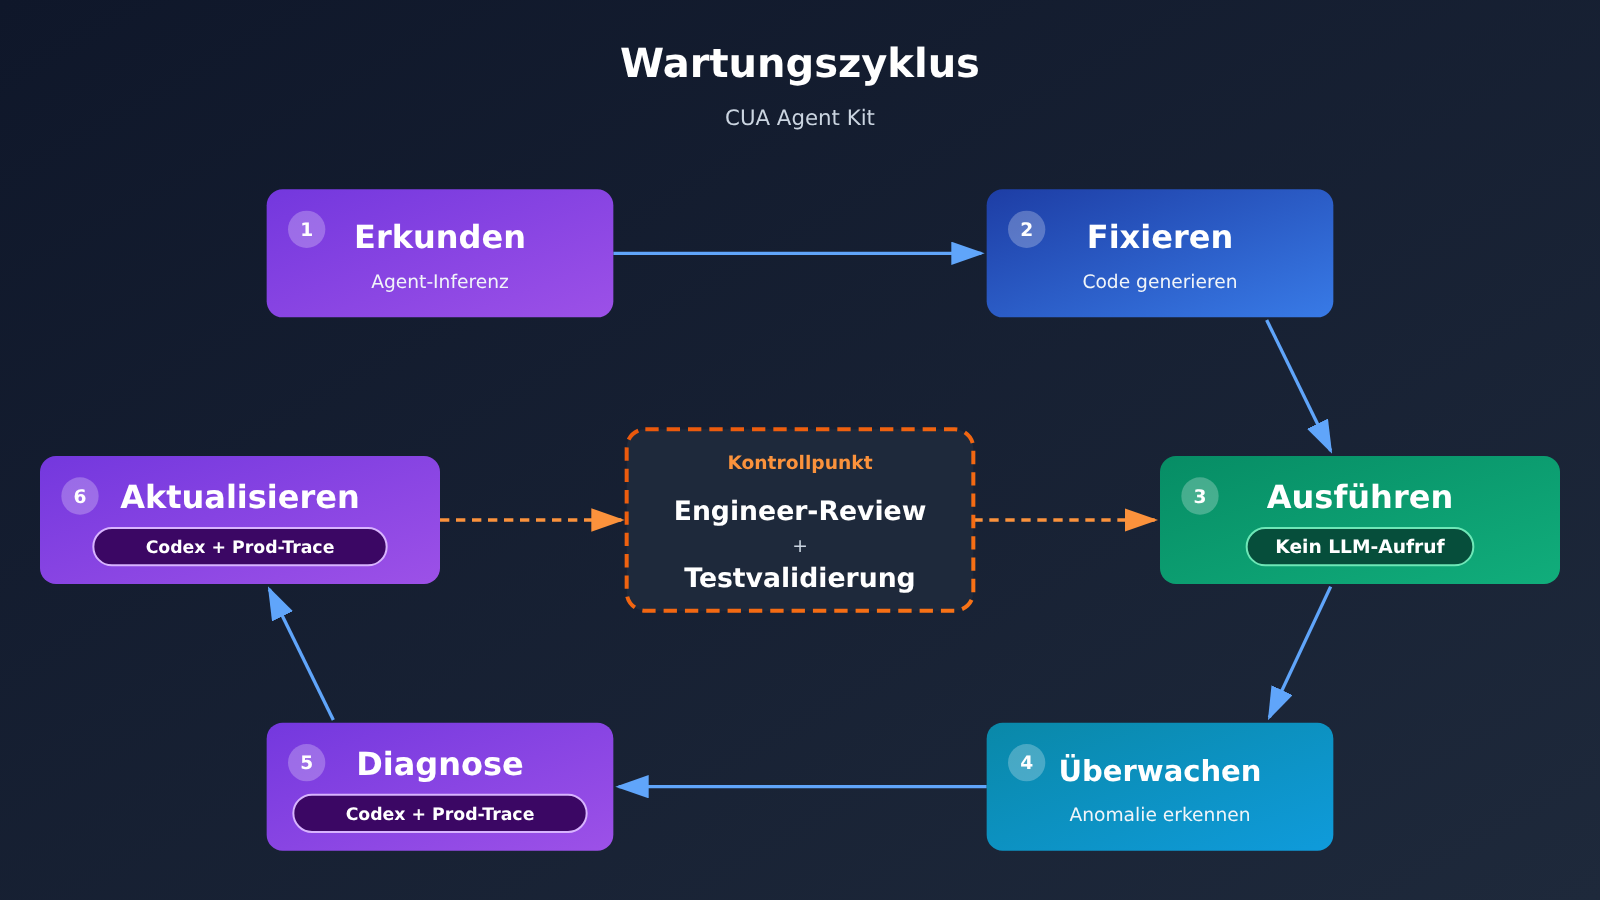
In dieser Phase ist kein Modellaufruf eines großen Sprachmodells bei jedem Durchlauf nötig – und auch kein API-Schlüssel. Das Projekt versteht die Fixierung aber nicht als einmalig erledigte Sache. Der in der README beschriebene Wartungsmechanismus ist ein geschlossener Kreislauf:
- Der feste Workflow läuft nach Plan.
- In den Produktions-Traces werden Anomalien erkannt.
- Codex nutzt die Traces, um das Problem zu diagnostizieren.
- Der deterministische Code wird aktualisiert.
- Engineers prüfen die Änderungen.
- Nach Tests und Validierung geht es zurück in die wiederholte Ausführung.
Anders gesagt: Die Rolle des Agent wandelt sich von „bei jedem Lauf selbst mit anpacken“ zu „im Alltag nicht dabei sein und bei Problemen den Code reparieren“. Code kann fehlschlagen, Oberflächen werden umgebaut – das räumt das Projekt von vornherein ein, und genau deshalb gibt es die Diagnose- und Review-Stufen.
Worin unterscheidet sich die hybride Agent-Automatisierung von CVS von klassischer RPA?
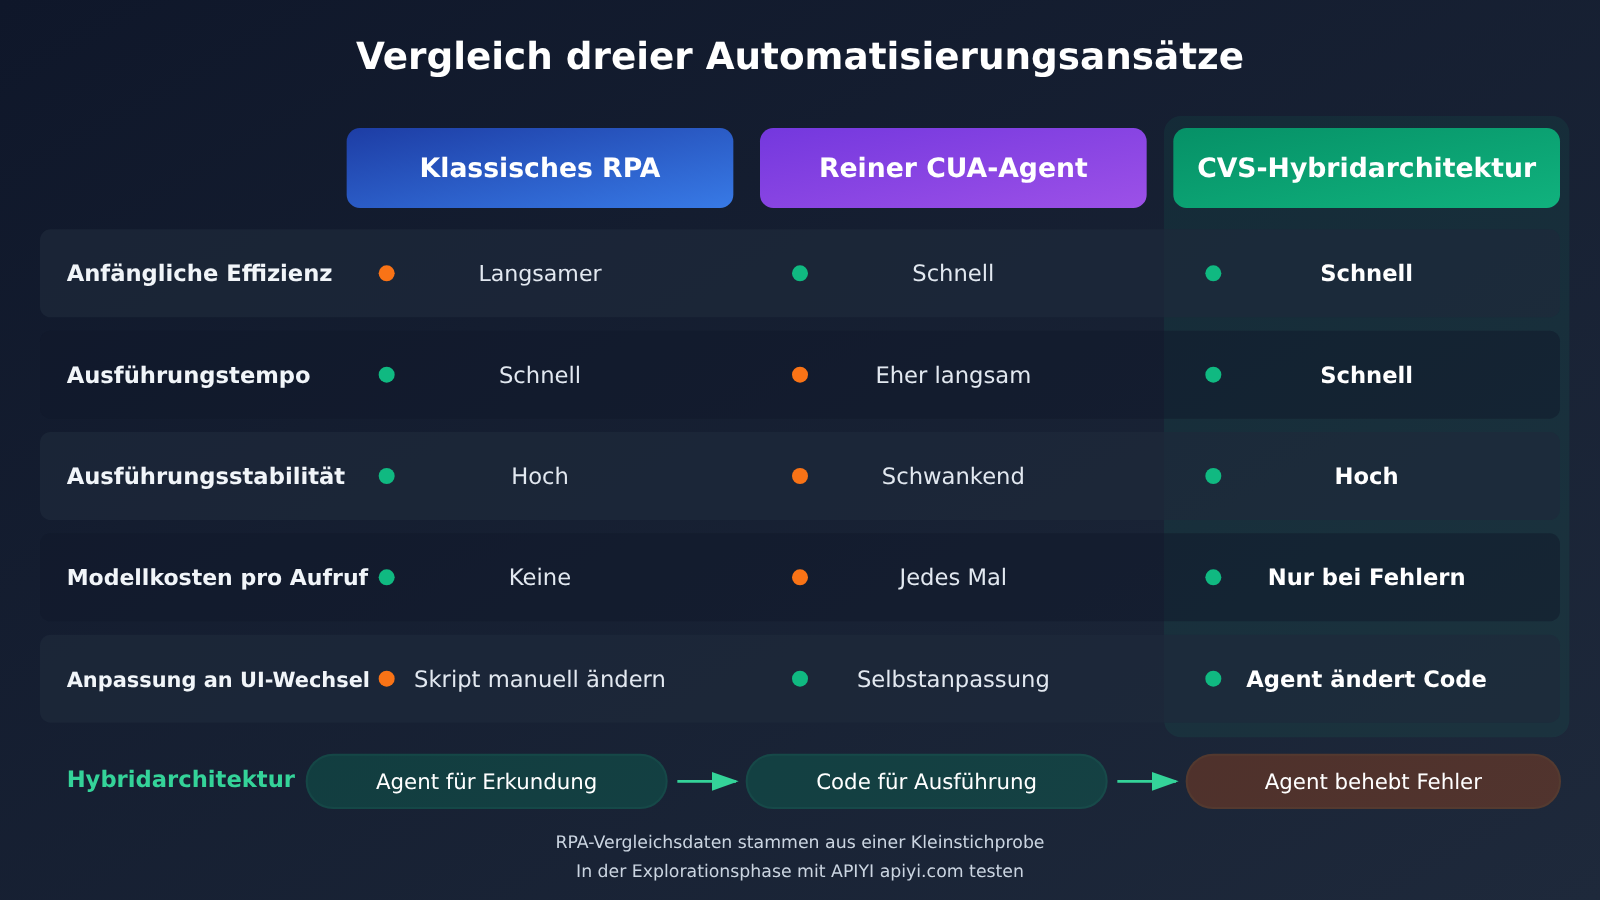
Klassische RPA setzt auf vorab konfigurierte Schritte und UI-Positionierung: schnell in der Ausführung, stabil im Ergebnis – aber Entwicklung und Pflege nach UI-Änderungen kosten menschlichen Aufwand. Ein reiner Agent versteht natürliche Sprache und passt sich an UI-Veränderungen an, doch jede erneute Inferenz bringt Kosten und schwankende Ergebnisse mit sich. Das CUA Agent Kit ist dazwischen angesiedelt: Der Agent ersetzt den Schritt „Flow manuell aufzeichnen und niederschreiben“, in der Ausführungsphase geht es zurück zu deterministischem Code.
Für den direkten Vergleich lohnt ein Blick auf eine 2026 veröffentlichte Studie: Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks (DOI: 10.1080/23311975.2026.2724760). Die Untersuchung lief von Mai bis Juni 2025 und verglich UiPath Studio 2023.4.0 mit dem Anthropic Computer Use Agent – über drei Kategorien von Standardaufgaben: Dateneingabe, Überwachung und Dokumentenextraktion.
| Aufgabe | RPA-Erfolgsrate | Agent-Erfolgsrate | Erste Entwicklungszeit (Beobachtung eines einzelnen Entwicklers) |
|---|---|---|---|
| P1 | Nicht in die Vergleichsstatistik aufgenommen | Agent scheiterte bereits im ersten Lauf und floss nicht in die weitere Statistik ein | Nicht angegeben |
| P2 | 100 % (10 Läufe) | 90 % (10 Läufe) | Agent ca. 10 Minuten, RPA ca. 38 Minuten |
| P3 | 100 % (10 Läufe) | 60 % (10 Läufe) | Agent ca. 15 Minuten, RPA ca. 240 Minuten |
Die Studie zeigt außerdem: RPA war bei P2 und P3 deutlich schneller in der Ausführung; die Probleme des Agenten lagen vor allem in fehlgeschlagenen UI-Operationen, verlorenem Kontext und Fehlentscheidungen; bei der Anpassung an dynamische Oberflächen hat der Agent potenzielle Vorteile.
Die Grenzen dieser Studie muss man klar benennen:
- Sehr kleine Stichprobe: Bei P2 und P3 jeweils 10 Läufe pro Technik, bei P1 eben nicht „10 pro Technik“ – das lässt sich nicht pauschal verallgemeinern.
- Entwicklungszeiten sind nur erste Beobachtungen: Sie stammen von einem einzelnen Entwickler, haben keine statistische Repräsentativität und taugen nicht als Branchendurchschnitt.
- Werkzeugversionen sind relativ alt: Die Studie nutzt eine Agent-Konfiguration aus 2025 und bildet nicht die Leistung neuer Modelle aus 2026 ab.
Trotzdem deckt sich die Stoßrichtung der Ergebnisse mit dem Design von CVS: Agenten sind gut im schnellen Explorieren und im flexiblen Umgang mit Unwägbarkeiten, die deterministische Ausführung im RPA-Stil bleibt bei stabiler Wiederholung im Vorteil.
Quelle: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
Wie können Entwickler den Ansatz des CVS CUA Agent Kit wiederverwenden?
Das README listet nur wenige Umgebungsanforderungen auf:
- Python 3.12 oder höher;
- uv (Werkzeug für Python-Pakete und Projektmanagement);
- eine erreichbare Zielwebsite oder Desktop-Anwendung;
OPENAI_API_KEYfür die Erkundungsphase;- ein eigener API-Endpunkt, der sich über
OPENAI_BASE_URLkonfigurieren lässt.
Die Nutzung entspricht drei Phasen: Erkundung (der Agent erkundet und hinterlässt Belege), Fixierung (Codex erzeugt den Code) und Ausführung (deterministische Ausführung). Die konkreten Befehle und Parameter für Erkundungs- und Fixierungsphase entnehmen Sie bitte dem README des Repositorys; die Ausführungsphase ist das bereits erwähnte uv run cua-agent-run.
Das Design von OPENAI_BASE_URL ist einen zweiten Blick wert. Es bedeutet nämlich, dass der Modelleinstieg in der Erkundungsphase sowohl auf die offizielle API als auch auf ein internes Firmen-Gateway oder andere Dienste mit OpenAI-kompatibler Schnittstelle zeigen kann – praktisch für einheitliche Authentifizierung, Abrechnung und Auditierung. Die Umgebungsvariablen der Erkundungsphase lassen sich so setzen:
# Erkundungsphase: Modell-API erforderlich
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # APIYI-Universalschnittstelle verwenden oder durch Ihr eigenes Gateway ersetzen

# Ausführungsphase: deterministische Ausführung, kein API Key erforderlich
uv run cua-agent-run
Ein Punkt sei ausdrücklich betont: Computer Use hängt von bestimmten Fähigkeiten der Responses API und von bestimmten Tool-Typen ab. Bevor Sie irgendeinen eigenen Endpunkt einsetzen, prüfen Sie, ob dieser die für die Erkundungsphase benötigten Modelle und Tools unterstützt – und lassen Sie zuerst einen einfachen Ablauf durchlaufen, bevor Sie das Ganze breit ausrollen.
Nach der Fixierung ist die häufigste Routineaufgabe das Lesen der Trace- und Ereignisprotokolle. Hier ein Beispiel für ein Hilfsskript: Es übergibt die events.jsonl eines Laufs an ein allgemeines großes Sprachmodell, das daraus eine Schrittliste und verdächtige Fehlerstellen erstellt – als Referenz für die Prüfung durch die Ingenieure. Die konkreten Felder von events.jsonl richten sich nach der tatsächlichen Ausgabe des Projekts; hier wird nur zeilenweise gelesen. Bei sensiblen Informationen wie Patientendaten unbedingt vorher anonymisieren oder ausschließlich in einer konformen Umgebung verarbeiten.
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible APIYI-Schnittstelle
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """Liest die bereits anonymisierte events.jsonl ein und erzeugt eine Schrittliste sowie vermutete Fehlerstellen"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # Kontextlänge begrenzen
    prompt = (
        "以下是一次界面自动化运行的事件日志。"
        "请按顺序列出操作步骤,并指出最可能导致失败的步骤及原因,"
        "只基于日志内容,不要臆测。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # durch das auf Ihrer Plattform tatsächlich verfügbare Modell ersetzen
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
Dieses Skript hilft nur beim Lesen – es ersetzt weder die Diagnose durch Codex anhand des vollständigen Trace noch die Prüfung und die Tests durch die Ingenieure.
🚀 Tipp für den schnellen Einstieg: Wenn Sie diesen Ansatz wiederverwenden, wählen Sie zunächst einen risikoarmen Ablauf auf einer internen Testumgebung und lassen Sie die komplette Kette „Erkunden → Festigen → Betreiben“ einmal durchlaufen. In der Erkundungsphase müssen Sie Modelle wiederholt aufrufen und die Ergebnisse vergleichen – über APIYI apiyi.com erhalten Sie ein kostenloses Testkontingent. Mit demselben API-Schlüssel können Sie verschiedene Modelle umschalten und damit Hilfsaufgaben wie die Log-Analyse erledigen, bevor Sie sich für ein Modell für die Produktivumgebung entscheiden.
Analyse und Einschätzung: Abwägungen beim Automatisierungsansatz von CVS Agent
Die folgenden Ausführungen sind eine Interpretation auf Basis der zuvor genannten Fakten und keine Schlussfolgerung des Projektteams oder von OpenAI.
Warum ist es Verschwendung, wenn ein Agent jedes Mal von vorn denkt?
Die mehrstufige Geschäftsprozessautomatisierung hat eine Besonderheit: Sobald ein Ablauf einmal funktioniert, folgen die allermeisten späteren Ausführungen demselben Pfad. Wenn man den Computer-Use-Agenten bei jedem Lauf erneut Screenshots machen, die Oberfläche verstehen und den nächsten Schritt planen lässt, zahlt das Modell in Wahrheit immer wieder für Fragen, deren Antwort es bereits kennt. Diese wiederholte Inferenz bringt gleich drei Arten von Kosten mit sich.
Erstens die Kosten. Computer Use ist ein mehrstufiger Aufruf: Die Screenshots nach jedem Schritt sind Bildeingaben und sammeln sich fortlaufend als Token an. Nehmen wir als Beispiel die am 17. November 2026 veröffentlichten Standard-Preise für kurze Kontexte von OpenAI: GPT-6 Astra liegt bei Eingabe, Ausgabe und gecachter Eingabe bei 10, 50 und 1 US-Dollar pro Million Token, GPT-6 Luna bei 0,10, 0,50 und 0,01 US-Dollar. Im HealthAdminBench-Benchmark kostet Luna 0,085 US-Dollar pro Aufgabe, 98 % weniger als Astra; rechnet man dieses Verhältnis zurück, ergeben sich für Astra etwa 4,25 US-Dollar pro Aufgabe. Das ist allerdings nur eine Schätzung – ein Preis unter Benchmark-Bedingungen, kein Produktionsangebot.
Zweitens die Latenz. Bei jedem Schritt muss man auf die Antwort des Modells warten; je länger der Ablauf, desto länger die Wartezeit. Auch das ist der Grund, warum RPA in der früheren Untersuchung bei P2 und P3 deutlich schneller war als der Agent.
Drittens die Schwankung. Läuft dieselbe Aufgabe mehrfach, kann der Agent unterschiedliche Pfade einschlagen; in der Studie lag die Erfolgsrate des Agenten bei P3 nur bei 60 %. Für Geschäftsprozesse, die vorhersehbar und prüfbar sein müssen, ist diese Unsicherheit schwerer zu akzeptieren als die Kosten.
Deshalb sollten die Kostenstrukturen der beiden Phasen getrennt bilanziert werden:
| Kostenposition | Explorationsphase (Agent) | Ausführungsphase (deterministischer Code) |
|---|---|---|
| Modell-Token | Visuelle und textuelle Eingaben sowie kostenpflichtige Ausgaben pro Runde getrennt erfassen; Retry-Token, die bereits in der Gesamtsumme stecken, nicht doppelt zählen | Im Normalbetrieb null |
| Tools und Laufzeitumgebung | Tatsächlich genutzte Dienste wie Browser, Desktop-Umgebung, Container | Die Maschine und Browserumgebung, auf der der Code läuft |
| Engineering-Aufwand | Aufgabenspezifikation schreiben, Belege prüfen, generierten Code reviewen | Monitoring, Fehlerdiagnose, Code-Updates und Tests |
| Häufigkeit | Beim Onboarding neuer Abläufe oder bei größeren Prozessänderungen | Bei jeder Geschäftsausführung |
| Empfohlenes Vorgehen | Modelle nach Komplexität gestaffelt auswählen: starke Modelle für anspruchsvolle Abläufe, günstige Modelle für strukturierte Abläufe | Modell möglichst gar nicht aufrufen, nur bei Anomalien zurück zum Agent zur Reparatur |
Die Wirtschaftlichkeit der Hybridarchitektur kommt genau aus dieser Tabelle: Teure Modellaufrufe konzentrieren sich auf die seltene Exploration und Reparatur, während der hochfrequente Ausführungsteil auf Code mit nahezu null Grenzkosten pro Modellaufruf zurückgreift. Die echte Bilanz muss allerdings auch den Wartungsaufwand berücksichtigen: Je häufiger die Oberfläche überarbeitet wird, desto öfter geht es zurück in die Explorationsphase – und desto kleiner fällt die Ersparnis aus.
💰 Kostentipp: Die gestaffelte Modellauswahl in der Explorationsphase sollte man am besten mit den eigenen echten Abläufen testen, statt Benchmark-Zahlen einfach zu übernehmen. Über APIYI apiyi.com lassen sich Modelle unter derselben OpenAI-kompatiblen Schnittstelle wechseln, nutzungsbasiert abgerechnet – praktisch, um den tatsächlichen Token-Verbrauch verschiedener Modelle in der Exploration und bei der Log-Diagnose zu vergleichen.
Ein weiterer leicht übersehener Punkt betrifft den Bewertungsmaßstab. Die von OpenAI veröffentlichten HealthAdminBench-Ergebnisse lauten Astra 94.3% und Luna 91.8%. Beide Werte sind der Anteil der Rubric-Punkte bei maximalem Reasoning-Aufwand und nicht die End-to-End-Erfolgsrate. Die Version 2604.09937v1 des Stanford-Team-Papers umfasst 135 Aufgaben und 1698 Unteraufgaben (davon 1177 deterministisch bewertet und 521 von einem Modell-Judge bewertet). Die beste berichtete Erfolgsrate für vollständige Aufgaben liegt bei 36.3% (Claude Opus 4.6 CUA), die beste Erfolgsrate bei Unteraufgaben bei 82.8% (GPT-5.4 CUA). Die 70 Aufgaben und 947 Bewertungspunkte aus einer früheren Online-Veröffentlichung gehören zu einer anderen öffentlichen Version und dienen nur als historischer Vergleich. Diese Zahlen stammen von unterschiedlichen Modellen, Stichtagen, Ausführungsbedingungen und Metriken; sie lassen sich nicht in derselben Rangliste zusammenfassen.
Für das Vorgehen „erst explorieren, dann fixieren“ ist die End-to-End-Erfolgsrate wichtiger als lokale Punktzahlen. Codex braucht eine vollständig erfolgreiche Trajektorie. Wenn in der Explorationsphase 90% der Teilschritte stimmen, der Ablauf aber beim abschließenden Submit hängen bleibt, lässt sich der dabei entstehende Trace trotzdem nicht direkt fixieren. Bei der Modellauswahl sollte man deshalb die Erfolgsrate für vollständige Aufgaben mit dem eigenen Workflow messen.
Welche Aufgaben eignen sich für eine hybride Agent-Architektur nach CVS-Art?
Fasst man die bisherigen Fakten zusammen, ergibt sich eine grobe Aufgabenteilung:
| Aufgabenmerkmal | Empfohlene Ausführungsform | Typisches Beispiel | Menschliches Eingreifen |
|---|---|---|---|
| Prozess unbekannt, kaum dokumentiert, komplexe Oberfläche | Agent exploriert und hinterlegt Belege | Erstmalige Erkundung des Bedienpfads in einem Altsystem | Prüfung der Explorationsergebnisse und des generierten Codes |
| Prozess stabil, sehr häufig wiederkehrend, per Status verifizierbar | Als deterministischen Code fixieren | Systemübergreifender Dateiversand, Übertragen fester Felder | Stichprobenprüfung der Ergebnisse, Überwachung von Anomalien |
| Vorhandene API-Abdeckung | Bevorzugt die API aufrufen | Schreiben strukturierter Daten | Nach den üblichen Rechtevorgaben |
| Häufige UI-Überarbeitungen | Nach dem Fixieren das Monitoring verstärken und Budget für eine Rückkehr zur Exploration einplanen | Drittanbieter-Portale | Jede Code-Aktualisierung muss geprüft werden |
| Änderung risikoreicher Geschäftszustände | Code oder Agent nur bis Entwurf / Freigabe | Antrag einreichen, Nachricht versenden, Datensatz ändern | Menschliche Freigabe zwingend erforderlich |
Auch die Praxis anderer Partner im medizinischen Umfeld liefert eine Orientierung. Die von Ambience vorgestellte Lösung lässt den Agenten bei mehrdeutigen Krankenakten innehalten und den Arzt befragen sowie vor dem Absenden auf die Freigabe warten. Im Fall Assort übernimmt die API die abgedeckten Teile, während Computer Use nur diejenigen Oberflächenschritte ergänzt, die die API nicht abdeckt. Die Kombination „API + Computer Use + deterministischer Code + menschliche Freigabe“ ist realistischer als der blinde Einsatz einer einzigen Technologie.
Klar sein muss: Deterministischer Code macht die Ausführung lediglich vorhersagbar, er garantiert keine korrekten Ergebnisse. Wurde in der Explorationsphase ein fehlerhafter Pfad fixiert, wiederholt der Code diesen Fehler zuverlässig; bei systemübergreifenden Operationen kann sich ein Fehler zudem in mehrere nachgelagerte Systeme fortpflanzen. Deshalb bleiben eine Statusprüfung vor der Aktion, eine Ergebnisverifikation nach der Aktion, minimale Berechtigungen und eine lückenlose Nachvollziehbarkeit auch nach dem Fixieren unverzichtbar. Dieser Artikel behandelt die technische Architektur und enthält keinerlei Empfehlungen zur Behandlung von Patienten.
Für Teams, die selbst anfangen wollen, ist der sicherste Weg: In einer Nicht-Produktivumgebung einen risikoarmen, stark repetitiven Prozess auswählen und einmal vollständig durchspielen – Exploration, Fixierung, Betrieb und eine künstlich herbeigeführte Oberflächenänderung – und dabei die Modellaufrufkosten, den Wartungsaufwand in Arbeitsstunden und die Wiederherstellungszeit nach Fehlern erfassen. Diese drei Datenpunkte sagen mehr als jeder Benchmark-Score darüber aus, ob sich diese Architektur in Ihrem Szenario rechnet. Für Vergleichstests mehrerer Modelle in der Explorationsphase können Sie zunächst das kostenlose Kontingent von APIYI apiyi.com nutzen und dann anhand der Messergebnisse entscheiden, welches Modell und welcher Anbindungsweg für den produktiven Einsatz infrage kommen.
Bemerkenswert am CVS-Konzept ist nicht die Behauptung, der Agent sei besonders schlau, sondern dass es die Grenzen des Agenten eingesteht und die Intelligenz genau dort einsetzt, wo sie hingehört: einmal explorieren, in Code fixieren, bei Problemen reparieren. Ob sich dieser Weg in weiteren Unternehmen durchsetzt, hängt letztlich von den Messdaten ab, die die jeweiligen Prozesse im realen Umfeld liefern.
The proof of the pudding is in the eating. (Ob der Pudding gut ist, zeigt sich erst beim Essen: Die tatsächliche Wirkung muss sich in der Praxis erweisen.)
Autor: APIYI Technik-Team
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI unter apiyi.com; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com


