
Корпоративному агенту не обязательно при каждом повторяющемся задании заново обращаться к большой языковой модели. Открытый CUA Agent Kit от CVS Health предлагает более экономный инженерный путь: сначала Computer-use Agent исследует незнакомый бизнес-процесс и записывает успешный сценарий в виде скриншотов, событий и Trace; затем Codex превращает эти свидетельства в проверяемый, поддерживаемый и воспроизводимый детерминированный код.
Эта схема объединяет гибкость AI в исследовании и стабильность традиционной автоматизации в исполнении, образуя гибридную архитектуру «AI исследует, код фиксирует, поддержка продолжается». Она не про замену скриптов агентом, а про то, чтобы агент писал и исправлял скрипты.
Что вы узнаете из этой статьи?
- Как CVS Health CUA Agent Kit проходит двухэтапный процесс — от исследования с помощью AI до фиксации в коде
- Какую роль на этапе фиксации играют скриншоты, events.jsonl, Trace и семантические локаторы
- Как зафиксированный процесс работает без вызова большой языковой модели и как поддерживать его при сбоях
Дальше по порядку — факты. Разберём, как работает CUA Agent Kit, что происходит на пути от действий AI к коду Playwright, какие задачи по поддержке остаются за агентом после фиксации, на какие исследования опирается отличие этой архитектуры от традиционной RPA и как разработчику повторить этот подход у себя. В аналитической части обсудим два вопроса: почему заставлять агента каждый раз думать с нуля — расточительно, и какие задачи подходят для такой гибридной архитектуры, а какие обязательно должны оставаться под контролем человека.
Что нужно знать: 7 понятий для понимания стратегии автоматизации CVS Agent
| Понятие | Краткое объяснение |
|---|---|
| Computer Use | Способность выполнять задачи, наблюдая за интерфейсом ПО и совершая действия вроде кликов и ввода текста |
| EHR | Электронная медицинская карта — ключевая система, в которой медицинские организации хранят и обрабатывают истории болезней пациентов |
| MCP | Стандартный протокол для обнаружения и вызова внешних инструментов |
| RPA | Автоматизация повторяющихся процессов по заранее заданным правилам или программам |
| Rubric points | Баллы, на которые разбита оценка по критериям; показывают, насколько выполнены отдельные требования |
| Сквозной процент успеха | Доля задач, где весь сценарий выполнен и все условия успеха соблюдены |
| Trace | Трассировка — запись хода выполнения, действий и состояний страниц как доказательство |
Кратко о влиянии: кого затрагивает стратегия автоматизации CVS Agent
- Разработчики и технические руководители:Главное здесь не «использовать Agent или нет», а разбить механизм выполнения по задачам. Нужно отдельно проверять долю успешных выполнений на этапе исследования, стабильность зафиксированного кода и полную стоимость с учётом поддержки, а не смотреть только на цену одного вызова модели.
- Медицинские организации и руководители рабочих процессов:Нужно различать синтетические демо, оценки от вендоров, публичные кейсы компаний и собственные пилотные проекты — вес этих типов доказательств различается. Для шагов, связанных с данными пациентов и изменением статусов, стоит заранее внедрить ручное подтверждение, минимальные привилегии и журналирование действий.
Объективные факты: двухэтапный путь CVS Health CUA Agent Kit
Для начала — предыстория. 16 ноября 2026 года OpenAI опубликовала материалы о прогрессе Computer-use Agent для медицинских команд: результаты оценок на клинических и административных задачах в здравоохранении, а также практику сотрудничества с CVS Health, Cigna Healthcare, Abridge, Ambience и другими организациями. CVS Health в этом материале раскрыла кейс из продуктивной среды и выложила в открытый доступ CUA Agent Kit под лицензией Apache-2.0.
Среди опубликованных CVS Health результатов из продуктивной среды: агент в одном из боевых рабочих процессов за одни выходные разгрёб накопившуюся за несколько месяцев очередь задач по отправке документов; другой агент ежедневно выполняет десятки тысяч системных операций в рамках приёмов у узких специалистов. Система оснащена проверками валидации и человеческим надзором, а фактические действия и состояние приложения сверяются по скриншотам и журналам операций. Важно: всё это данные, раскрытые самой компанией. «Десятки тысяч» — это системные операции, связанные с консультациями, а вовсе не десятки тысяч клинических решений, которые ИИ принял самостоятельно. В открытых материалах также не сказано, полностью ли эти боевые агенты построены на открытой версии Agent Kit, — ставить между ними знак равенства не стоит.
Источник: openai.com/index/advancing-computer-use-for-healthcare-teams/
Как работает CUA Agent Kit от CVS Health?
README проекта описывает его без лишней скромности: это стартовый набор для автоматизации браузерных и Windows-процессов, где шаги сначала находит ИИ, а потом они повторяются кодом. Авторы особо подчёркивают: «понять, как выполняется задача» и «стабильно повторять её долгое время» — это две разные проблемы, и решать их нужно разными средствами.
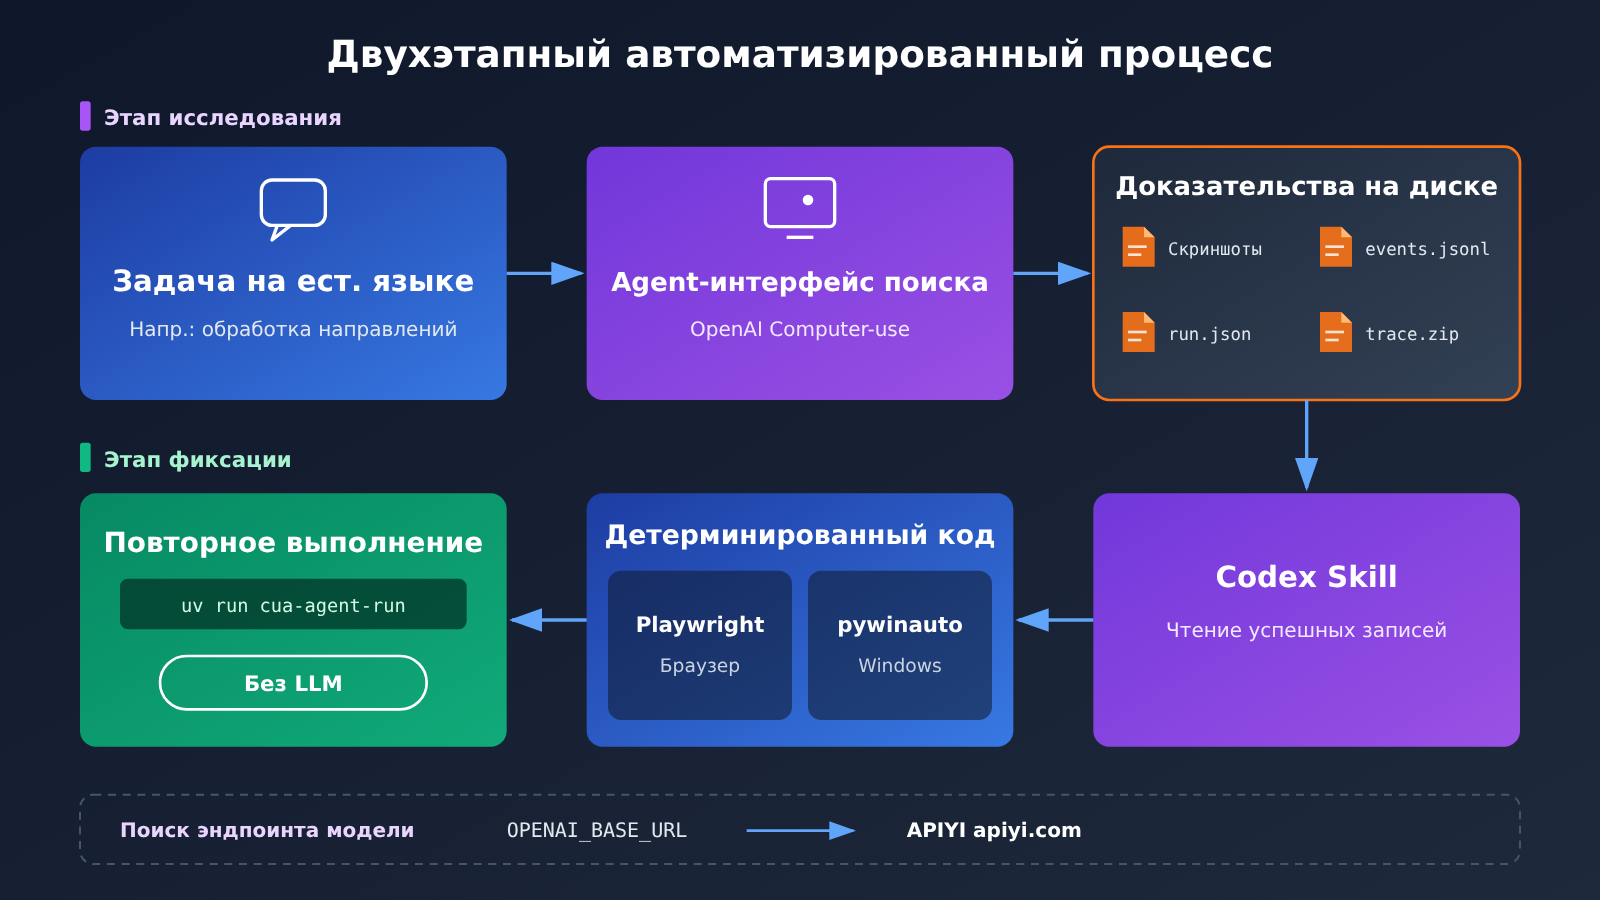
Весь процесс делится на два этапа:
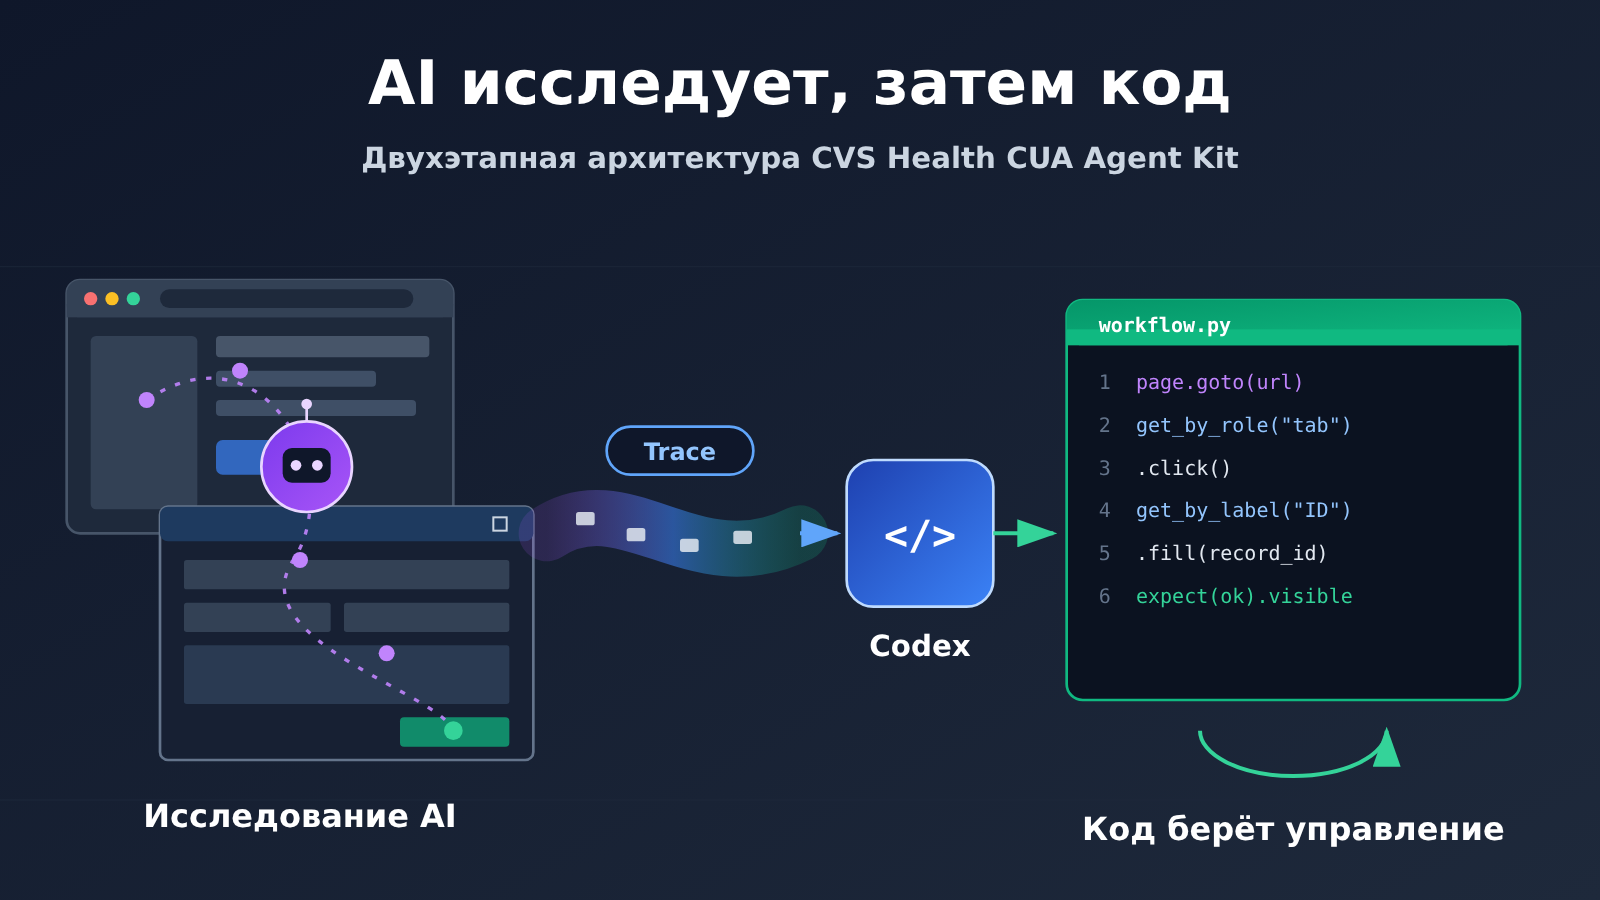
- Этап исследования: OpenAI Computer-use Agent получает задачу, описанную обычным языком, — например, «найти нужную запись и обработать направление», — и исследует, выполняет и проверяет её в реальном интерфейсе. По ходу сохраняются скриншоты, действия, цели действий и траектория выполнения.
- Этап фиксации: Codex Skill читает записи уже успешно выполненного исследования и генерирует или обновляет код детерминированного рабочего процесса. После этого повторное выполнение того же процесса достаётся обычному коду — большой языковой модели больше не нужно каждый раз заново рассуждать.
Все свидетельства этапа исследования — это файлы на диске, а не рассуждения, застрявшие внутри модели. README перечисляет такие типы записей:
| Запись | Основное назначение | Ценность на этапе фиксации |
|---|---|---|
| Screenshots | Фиксируют состояние интерфейса на каждом шаге | Позволяют инженеру и Codex проверить, как страница выглядит на самом деле |
| events.jsonl | Построчно записывает события операций | Восстанавливает, «что было сделано и в каком порядке» |
| run.json | Хранит информацию о конкретном запуске | Различает запуски и помогает понять, был ли он успешным |
| trace.zip | Трасса выполнения Playwright | Даёт детали по элементам, сети и таймингам — для генерации и диагностики кода |
Источник: github.com/cvs-health/cua-agent-kit
От действий ИИ к коду Playwright: что делает CVS Agent Kit?
Самый важный нюанс на этапе закрепления: генерируется не «воспроизведение координат мыши». Когда проект CVS создаёт браузерный воркфлоу, он использует семантические локаторы (Semantic Locators) для генерации кода Playwright. Цель находится по семантическим признакам элемента — роли, имени и т. п. — а не по запомненной координате на экране.
Разница между двумя подходами особенно заметна при сопровождении. Воспроизведение координат зависит от разрешения, размера окна и мелких изменений вёрстки: кнопка сдвинулась на пару пикселей — и клик может промахнуться. А если что-то сломается, по набору координат трудно понять, куда вообще собирались кликнуть. Код с семантическими локаторами выглядит примерно так: «нажать кнопку с именем „Отправить“». Намерение записано прямо в коде, инженер может сразу его проверить, и при локальных изменениях страницы такой код реже ломается. Конечно, если кнопку переименуют или переделают сам процесс, семантические локаторы тоже сломаются — просто такую поломку проще локализовать.
Инструменты в проекте распределены так:
- Playwright: отвечает за детерминированное выполнение браузерных воркфлоу и создаёт воспроизводимые траектории вроде trace.zip.
- pywinauto: отвечает за автоматизацию настольных приложений Windows и охватывает старые системы без веб-интерфейса.
- Codex Skill: читает успешные траектории исследования и генерирует или обновляет код обоих типов, описанных выше.
Этот подход совпадает с направлением, заданным официальной документацией OpenAI. В руководстве OpenAI по Computer Use описаны два пути: первый — модель возвращает структурированные действия мыши и клавиатуры, а приложение их выполняет; второй — модель генерирует код и управляет интерфейсом с помощью таких инструментов, как Playwright. Для GPT-6 Astra документация рекомендует подход с исполнением кода, а Computer Tool по-прежнему остаётся опциональным вариантом. ComputerToolset, BrowserToolset и точка входа в управляемый браузер описаны в официальном руководстве отдельно.
Источник: developers.openai.com/api/docs/guides/tools-computer-use
Что ещё нужно делать агенту в CVS Agent Kit после фиксации?
После фиксации процесса детерминированное выполнение запускается командой, указанной в README:
uv run cua-agent-run
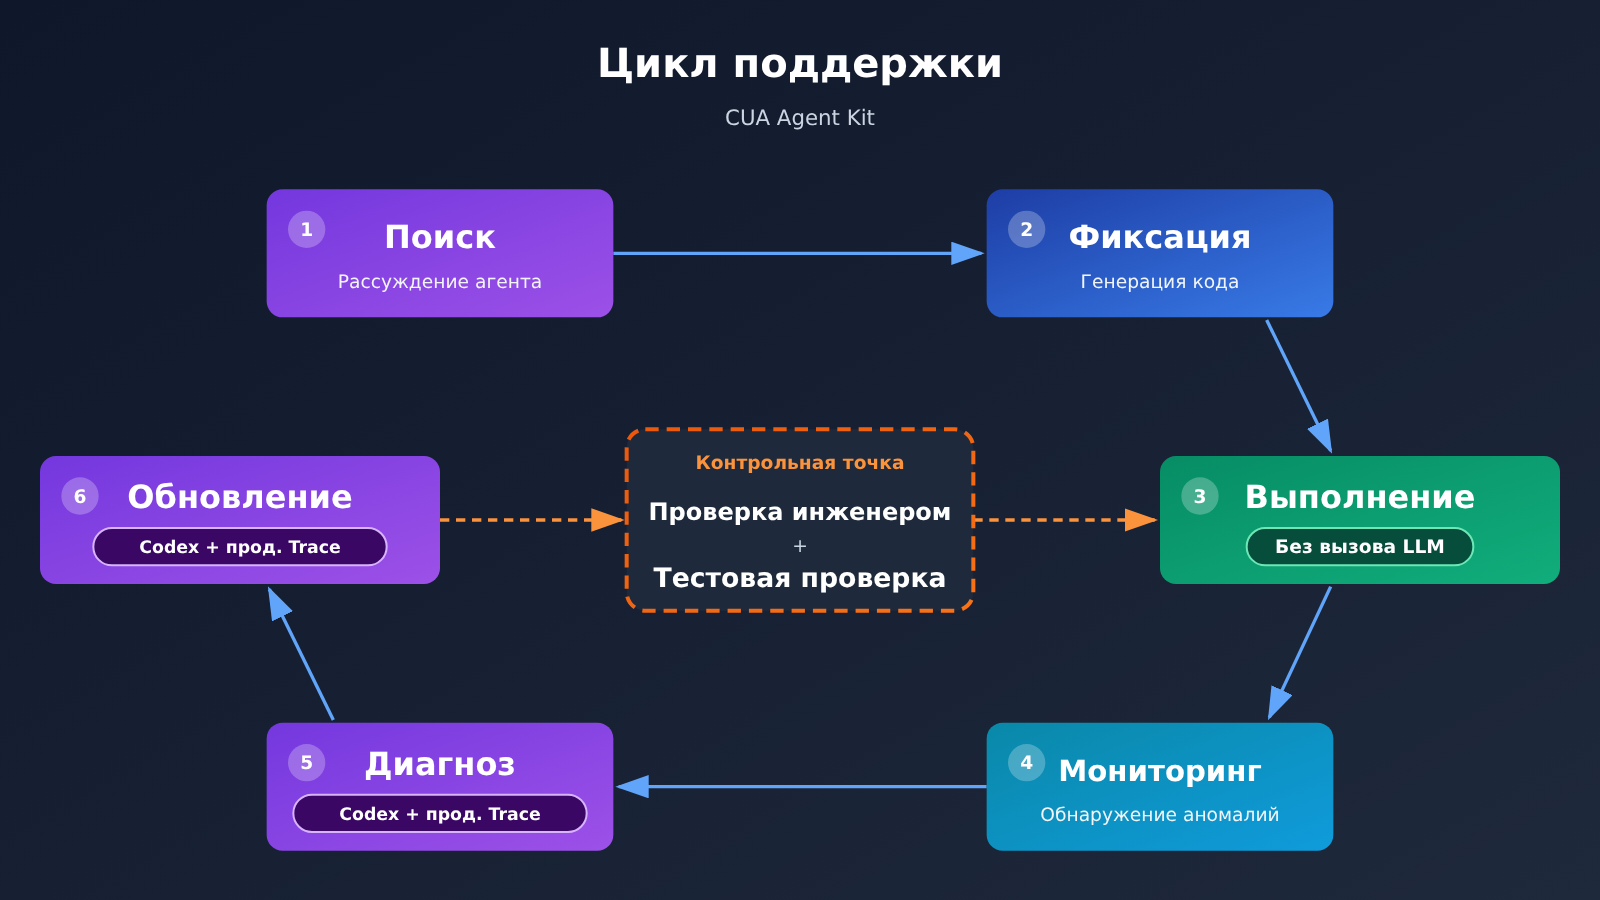
На этом этапе не нужно каждый раз вызывать большую языковую модель, и API-ключ тоже не требуется. Но проект вовсе не считает «фиксацию» решением на все времена. Механизм поддержки, описанный в README, — это замкнутый цикл:
- Фиксированный рабочий процесс выполняется по расписанию;
- В производственных трейсах обнаруживаются аномалии;
- Codex использует трейсы для диагностики проблем;
- Детерминированный код обновляется;
- Инженер проверяет изменения;
- После прохождения тестов и проверки код снова уходит в повторяющееся выполнение.
Иными словами, роль агента меняется: вместо «каждый раз делать всё самому» он теперь «обычно отсутствует, а когда что-то ломается — приходит починить код». Код может падать, интерфейс может меняться — проект это изначально допускает, поэтому и предусмотрены этапы диагностики и проверки.
Чем гибридная автоматизация с Agent в CVS отличается от традиционного RPA?
Традиционный RPA опирается на заранее настроенные шаги и привязку к элементам интерфейса: он быстро выполняется и даёт стабильный результат, но разработка и поддержка при изменениях требуют ручного труда. Чистый Agent понимает естественный язык и адаптируется к изменениям интерфейса, однако каждое повторное рассуждение создаёт затраты и разброс в результатах. CUA Agent Kit занимает промежуточное положение: Agent заменяет шаг «ручной записи и составления процесса», а на этапе выполнения происходит возврат к детерминированному коду.
Что касается прямого сравнения этих двух подходов, можно обратиться к исследованию, опубликованному в 2026 году: Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks (DOI: 10.1080/23311975.2026.2724760). Исследование проводилось в мае–июне 2025 года и сравнивало UiPath Studio 2023.4.0 и Anthropic Computer Use Agent; оно охватывало три типа стандартных задач: ввод данных, мониторинг и извлечение данных из документов.
| Задача | Успешность RPA | Успешность Agent | Предварительное время разработки (наблюдение одного разработчика) |
|---|---|---|---|
| P1 | Не включена в контрольную статистику | Agent выполнил лишь 1 запуск, сразу сбойнул и не попал в дальнейшую статистику | Не раскрыто |
| P2 | 100% (10 запусков) | 90% (10 запусков) | Agent — около 10 минут, RPA — около 38 минут |
| P3 | 100% (10 запусков) | 60% (10 запусков) | Agent — около 15 минут, RPA — около 240 минут |
Исследование также показало, что в P2 и P3 RPA заметно быстрее выполняет задачи. Основные проблемы Agent — сбои при работе с интерфейсом, потеря контекста и ошибки в решениях. При этом у Agent есть потенциальное преимущество в адаптации к динамическим интерфейсам.
Границы этого исследования нужно обозначить явно:
- Очень маленькая выборка: P2 и P3 — по 10 запусков для каждой технологии, а P1 — это не «по 10 раз на каждую технологию», так что делать обобщающие выводы нельзя.
- Время разработки — только предварительное наблюждение: данные получены от одного разработчика, у них нет статистической репрезентативности, и их нельзя считать средним показателем по отрасли.
- Версии инструментов устарели: в исследовании использовалась конфигурация Agent 2025 года, поэтому она не отражает результаты новых моделей 2026 года.
Тем не менее общий вывод перекликается с архитектурой CVS: Agent хорош в быстром исследовании и гибкой работе, а детерминированное выполнение в стиле RPA по-прежнему сохраняет преимущество в стабильных повторяющихся операциях.
Источник: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
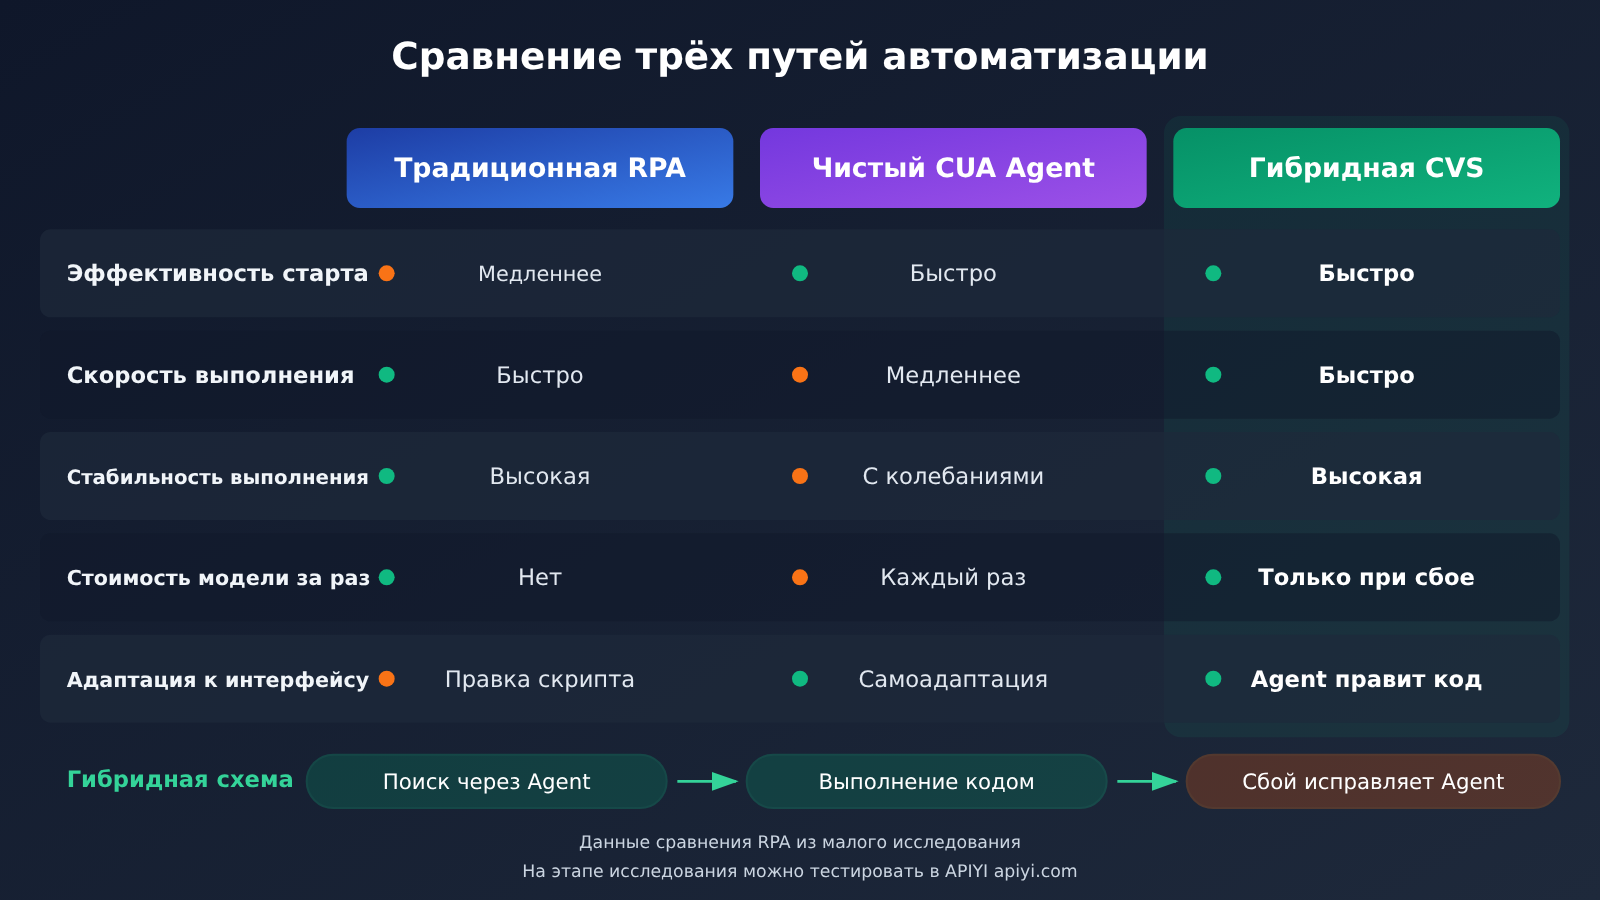
Как разработчику повторить подход CVS CUA Agent Kit?
В README перечислено не так много требований к окружению:
- Python 3.12 или выше;
- uv (менеджер пакетов и проектов Python);
- доступный целевой сайт или десктопное приложение;
- на этапе исследования нужен
OPENAI_API_KEY; - можно настроить собственный API Endpoint через
OPENAI_BASE_URL.
В использовании это соответствует трём этапам: обнаружение (Agent исследует и оставляет доказательства), закрепление (Codex генерирует код), выполнение (детерминированное исполнение). Конкретные команды и параметры этапов обнаружения и закрепления смотрите в README репозитория; этап выполнения — это уже упомянутая команда uv run cua-agent-run.
На дизайн OPENAI_BASE_URL стоит обратить внимание. Он означает, что точка входа к модели на этапе исследования может указывать как на официальный API, так и на внутренний шлюз предприятия или другой сервис, совместимый с интерфейсом OpenAI, — так удобнее централизовать аутентификацию, биллинг и аудит. Переменные окружения для этапа исследования можно настроить так:
# Этап исследования: нужен API модели
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # единый интерфейс APIYI, или замените на ваш шлюз

# Этап выполнения: детерминированное исполнение, API Key не нужен
uv run cua-agent-run
Стоит подчеркнуть один момент: Computer Use зависит от определённых возможностей Responses API и типов инструментов. Прежде чем переключаться на любой собственный endpoint, убедитесь, что он поддерживает нужные для этапа исследования модели и инструменты, и сначала прогоните простой сценарий, а уже потом масштабируйте.
После закрепления в повседневном сопровождении чаще всего приходится читать Trace и журналы событий. Ниже пример вспомогательного скрипта: он передаёт events.jsonl одного запуска универсальной большой языковой модели, чтобы та составила список шагов и подозрительные точки отказа — для справки инженеру при проверке. Конкретные поля events.jsonl зависят от фактического вывода проекта; здесь скрипт просто читает файл построчно. Если в данных есть чувствительная информация, например данные пациентов, обязательно сначала обезличьте её или работайте только в среде, соответствующей требованиям.
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """Читает обезличенный events.jsonl и формирует список шагов и подозрительные точки отказа"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # ограничиваем длину контекста
    prompt = (
        "以下是一次界面自动化运行的事件日志。"
        "请按顺序列出操作步骤,并指出最可能导致失败的步骤及原因,"
        "只基于日志内容,不要臆测。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # замените на модель, реально доступную вам на платформе
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
Этот скрипт лишь помогает читать логи: он не заменяет диагностику проблем, которую Codex проводит по полному Trace, и не заменяет проверку и тестирование инженером.
🚀 Совет по быстрому старту: когда будете повторно использовать этот подход, можно сначала прогнать на внутреннем тестовом сайте низкорисковый процесс через всю цепочку «исследование → закрепление → эксплуатация». На этапе исследования нужно многократно вызывать модели и сравнивать результаты; можно получить бесплатную тестовую квоту через APIYI apiyi.com, использовать один и тот же API-ключ для переключения между разными моделями и выполнения вспомогательных задач вроде анализа логов, а затем уже определяться с выбором моделей для рабочей среды.
Анализ и выводы: компромиссы на пути автоматизации CVS Agent
Следующий текст — интерпретация на основе вышеизложенных фактов, а не выводы команды проекта или OpenAI.
Почему каждый раз заставлять Agent думать с нуля — это расточительство?
У многошаговой бизнес-автоматизации есть одна особенность: как только процесс отлажен, подавляющее большинство последующих запусков идёт по одному и тому же пути. Если каждый раз заставлять Computer-use Agent заново делать скриншоты, разбираться в интерфейсе и планировать следующий шаг, модель по сути снова и снова платит за вопросы, ответы на которые уже известны. Такое повторное рассуждение даёт сразу три вида издержек.
Первое — стоимость. Computer Use — это многораундовые вызовы, и скриншот после каждого шага попадает в модель как изображение, а значит, токены постоянно накапливаются. Возьмём для примера цены Standard с коротким контекстом, которые OpenAI опубликовала 17 ноября 2026 года: у GPT-6 Astra ввод, вывод и кэшированный ввод стоят 10, 50 и 1 доллар за миллион токенов, а у GPT-6 Luna — 0,10, 0,50 и 0,01 доллара. В бенчмарке HealthAdminBench стоимость одного задания у Luna составила 0,085 доллара — на 98% меньше, чем у Astra. Если пересчитать обратно по этой пропорции, у Astra выходит около 4,25 доллара за задание, но это лишь оценка, причём в условиях бенчмарка, и её нельзя воспринимать как производственный ценник.
Второе — задержка. На каждом шаге нужно ждать ответа модели, и чем длиннее процесс, тем дольше ожидание. Именно поэтому в упомянутом ранее исследовании RPA на этапах P2 и P3 работал заметно быстрее Agent.
Третье — нестабильность. При нескольких прогонах одной и той же задачи Agent может выбрать разные пути: в исследовании доля успешных прогонов Agent на этапе P3 составила всего 60%. Для бизнеса, где важны предсказуемость и аудируемость, такая неопределённость тяжелее, чем стоимость.
Поэтому затраты двух этапов стоит считать раздельно:
| Статья затрат | Этап исследования (Agent) | Этап исполнения (детерминированный код) |
|---|---|---|
| Токены модели | Отдельно учитываются визуальный и текстовый ввод каждого раунда и оплачиваемый вывод; токены повторных попыток, уже входящие в общий объём, повторно не добавляются | При нормальной работе — ноль |
| Инструменты и среда запуска | Фактически используемые сервисы: браузер, рабочий стол, контейнеры и т.п. | Машина и браузерная среда, где выполняется код |
| Инженерные усилия | Написание описания задачи, проверка доказательств, ревью сгенерированного кода | Мониторинг, диагностика сбоев, обновление и тестирование кода |
| Частота | При запуске нового процесса или его серьёзном изменении | При каждом бизнес-исполнении |
| Рекомендуемый подход | Выбирать модель по уровню сложности: для трудных процессов — мощную, для структурированных — дешёвую | По возможности не вызывать модель, а возвращаться к Agent только при сбоях |
Экономика гибридной архитектуры как раз и вытекает из этой таблицы: дорогие вызовы модели сосредоточены в редких этапах исследования и починки, а частый этап исполнения возвращается к коду с почти нулевой маржинальной стоимостью модели. В реальной бухгалтерии нужно ещё учитывать расходы на поддержку: чем чаще меняется интерфейс, тем больше раз приходится возвращаться на этап исследования, и тем меньше оказывается экономия.
💰 Совет по стоимости: тировку моделей на этапе исследования лучше проверять на собственных реальных процессах, а не копировать цифры из бенчмарков. Через APIYI apiyi.com можно переключать модели в рамках одного OpenAI-совместимого интерфейса с оплатой по факту потребления — удобно для сравнения фактического расхода токенов разными моделями на этапах исследования и диагностики по логам.
Есть ещё один нюанс с критериями оценки, который легко упустить. В опубликованных OpenAI результатах HealthAdminBench Astra показывает 94,3%, Luna — 91,8%; оба значения отражают долю баллов по критериям (rubric points) при максимальной интенсивности рассуждений, а не успешность выполнения задачи от начала до конца. Версия 2604.09937v1 статьи команды Стэнфорда включает 135 задач и 1698 подзадач (из них 1177 — детерминированные оценки, 521 — оценки моделью-судьёй). В ней сообщается лучшая доля успешно выполненных задач целиком — 36,3% (Claude Opus 4.6 CUA) и лучшая доля успешно выполненных подзадач — 82,8% (GPT-5.4 CUA). Более ранние 70 задач и 947 пунктов оценки, опубликованные на веб-странице, относятся к другой публичной версии и могут служить только историческим ориентиром. Эти цифры получены на разных моделях, в разные даты, при разных условиях выполнения и по разным метрикам, поэтому их нельзя сводить в один рейтинг.
Для подхода «сначала исследовать, потом закреплять» успешность выполнения от начала до конца важнее локального балла. Codex нужна полная успешная траектория: если на этапе исследования он правильно проходит 90% подшагов, но застревает на последнем шаге — отправке, — оставшийся Trace всё равно не получится напрямую закрепить. При выборе модели стоит измерять на своём процессе долю успешно выполненных задач целиком.
Какие задачи подходят для гибридной агентной архитектуры в стиле CVS?
Если собрать все вышеперечисленные факты вместе, получится примерная таблица распределения задач:
| Характеристика задачи | Рекомендуемый способ выполнения | Типичный пример | Вмешательство человека |
|---|---|---|---|
| Процесс неизвестен, документации мало, интерфейс сложный | Агент исследует и оставляет доказательства | Первичное изучение пути выполнения операций в старой системе | Проверка результатов исследования и сгенерированного кода |
| Процесс стабилен, часто повторяется, состояние можно проверить | Закрепить в детерминированном коде | Межсистемная отправка файлов, перенос фиксированных полей | Выборочная проверка результатов, мониторинг аномалий |
| Уже есть покрытие API | В первую очередь вызывать API | Запись структурированных данных | Управление по обычным правам доступа |
| Интерфейс часто меняется | После закрепления усилить мониторинг и резервировать бюджет на возврат к исследованию | Сторонние порталы | Каждое обновление кода требует проверки |
| Изменение состояния высокорискового бизнес-процесса | Код или агент доводят только до черновика / ожидания утверждения | Подача заявки, отправка сообщения, изменение записи | Обязательное утверждение человеком |
В медицинских сценариях подходы других партнёров также дают ориентир. Решение, которое показала Ambience, заставляет агента остановиться и спросить врача при неоднозначности в медицинской карте, а перед отправкой ждать одобрения; в кейсе Assort API отвечает за те части, которые может покрыть, а Computer Use только дополняет шаги интерфейса, не покрытые API. Комбинация «API + Computer Use + детерминированный код + утверждение человеком» реалистичнее, чем ставка на одну технологию.
Важно понимать, что детерминированный код лишь делает выполнение предсказуемым, но не гарантирует правильность результата. Если на этапе исследования в код закрепляется дефектный путь, код будет стабильно повторять этот дефект; при межсистемных операциях одна ошибка может копироваться в несколько нижестоящих систем. Поэтому проверка состояния перед операцией, проверка результата после операции, минимальные права доступа и полная трассировка по-прежнему обязательны после закрепления. В этой статье обсуждается инженерная архитектура, а не какие-либо рекомендации по лечению пациентов.
Для команд, которые хотят попробовать, более надёжный путь такой: сначала в непроизводственной среде выбрать низкорисковый, часто повторяющийся процесс, полностью пройти цикл «исследование — закрепление — запуск — одно искусственно созданное изменение интерфейса» и записать стоимость вызовов модели, трудозатраты на поддержку кода и время восстановления после сбоя. Эти три показателя лучше любых бенчмарков объяснят, окупается ли эта архитектура в вашем сценарии. На этапе исследования для сравнительного тестирования нескольких моделей можно начать с бесплатного лимита APIYI apiyi.com, а затем по результатам реальных замеров решить, какую модель и способ подключения использовать для промышленного развёртывания.
Решение CVS заслуживает внимания не потому, что оно рекламирует, насколько умён агент, а потому, что оно признаёт ограничения агента и использует его ум там, где это нужнее всего: исследовать один раз, закрепить в коде, а если сломается — починить. Сможет ли этот путь утвердиться в большем числе компаний, в конечном счёте покажут реальные данные испытаний процессов в каждой организации.
The proof of the pudding is in the eating. (Что толку от пудинга, если его не съесть: настоящий результат проверяется на практике.)
Автор: Техническая команда APIYI
Связь по техническим вопросам: Добро пожаловать — свяжитесь с нами через главную страницу сайта APIYI apiyi.com. Больше материалов по интеграции вы найдёте в центре документации docs.apiyi.com


