
Nota del autor: un repaso de Gemini 4 Carbon, Claude Fable 5.2 y FastFrames de Apple en noviembre de 2026, para ayudarte a distinguir qué se puede invocar hoy mediante API y qué es solo paper y pesos de investigación.
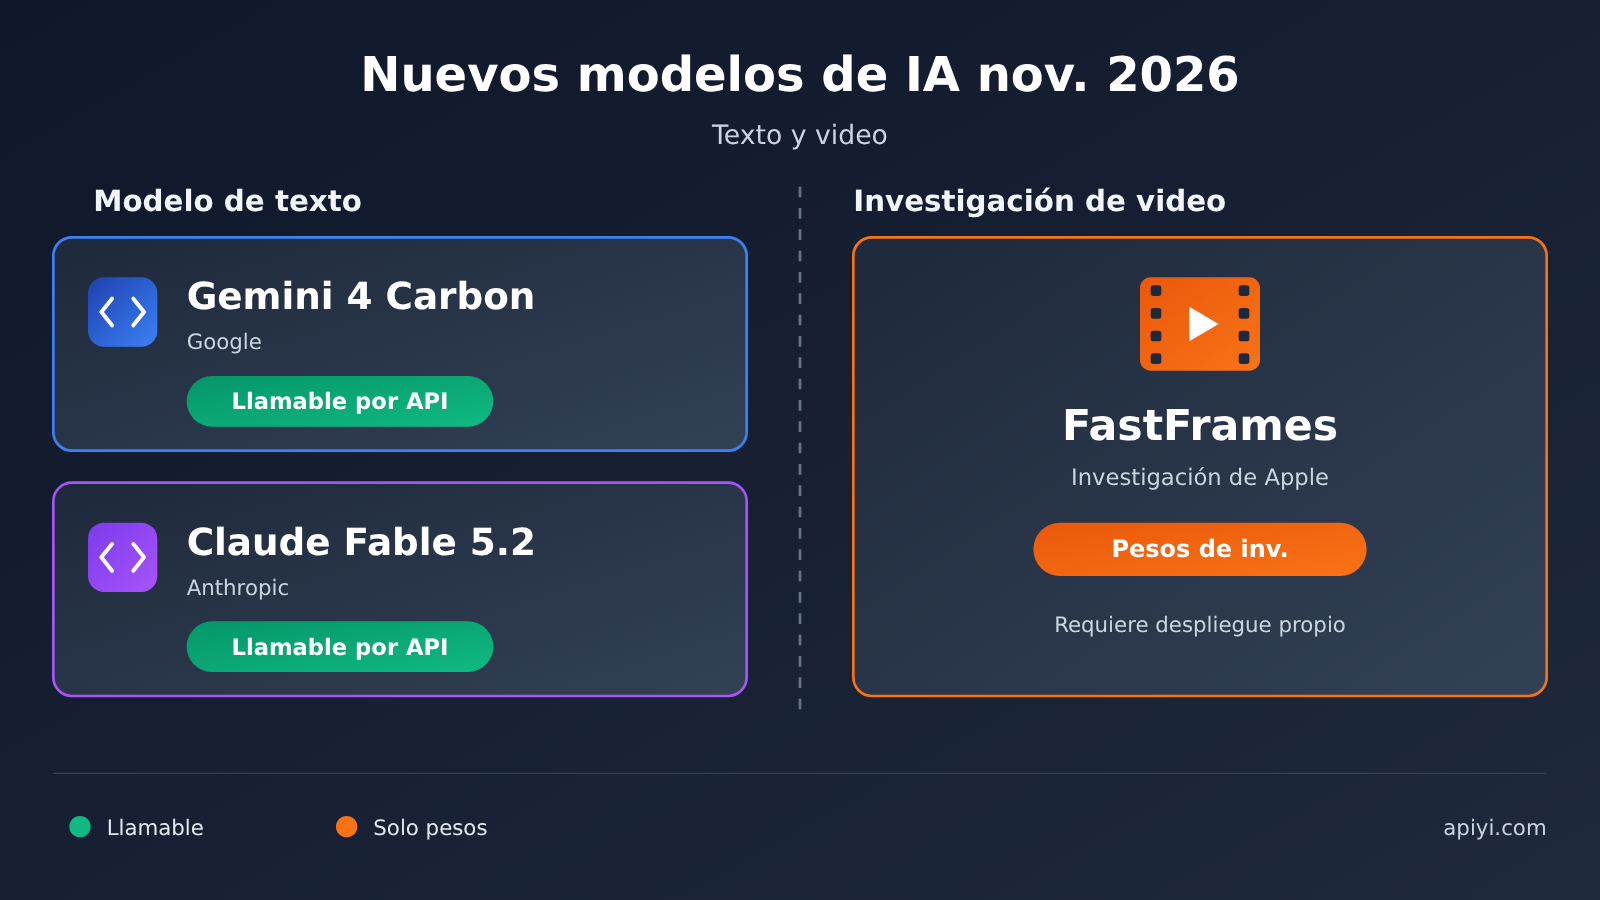
Los nuevos modelos de IA de noviembre de 2026 aparecieron todos en apenas dos semanas: Google abrió Gemini 4 Carbon a los desarrolladores de pago el 10 de noviembre, Anthropic lanzó Claude Fable 5.2 el 9 de noviembre y Apple publicó el 17 de noviembre el paper y los pesos de FastFrames, su investigación sobre video. Hay muchos nombres, pero para quien quiere ponerse manos a la obra ya mismo, la pregunta real es: cuáles se pueden invocar por API hoy y cuáles son solo papers y pesos.
Esto no es un ranking integral de «quién es el número uno». Este artículo solo reúne la información que se puede contrastar entre las fuentes oficiales, lo que declaran los propios papers y las páginas de modelos de las plataformas; no saca conclusiones de pruebas reales ni toma la capacidad «máxima» que indica el fabricante como una cifra ya medida.
Valor clave: al terminar de leer, tendrás una tabla comparativa. Para tareas de texto puedes alternar entre Gemini 4 Carbon y Claude Fable 5.2 según lo que necesites; en la parte de video, primero hay que tener claro que FastFrames son pesos de investigación, no una API que puedas invocar.
Vistazo rápido a la información clave de los nuevos modelos de IA de noviembre de 2026
La siguiente tabla responde primero a las preguntas más importantes: qué tipo de modelo es cada uno, quién lo publicó y si hoy se puede invocar mediante API. Las fechas se basan en el anuncio oficial o en la fecha de la versión del paper.
| Modelo | Publicado por | Tipo | Fecha clave | ¿Se puede invocar hoy vía API? |
|---|---|---|---|---|
| Gemini 4 Carbon | Modelo de lenguaje grande de texto | Primero para equipos de defensa de ciberseguridad (Fairwind) el 28 de octubre; abierto a desarrolladores de pago y empresas el 10 de noviembre | Sí, ID del modelo gemini-4-carbon |
|
| Claude Fable 5.2 | Anthropic | Modelo de lenguaje grande de texto | Publicado el 9 de noviembre | Sí, ID del modelo claude-fable-5-2 |
| FastFrames | Apple Research | Investigación de generación de video | Fecha de la versión v1 del paper: 17 de noviembre | No es una API, sino un paper y pesos abiertos |
Ambos modelos de texto ya aparecen en la lista de modelos de la plataforma APIYI y se pueden invocar directamente con el formato compatible con OpenAI. Los modelos y precios se rigen por la lista de modelos de APIYI apiyi.com; la fecha de verificación de los datos de precios de este artículo es 2026-11-19.
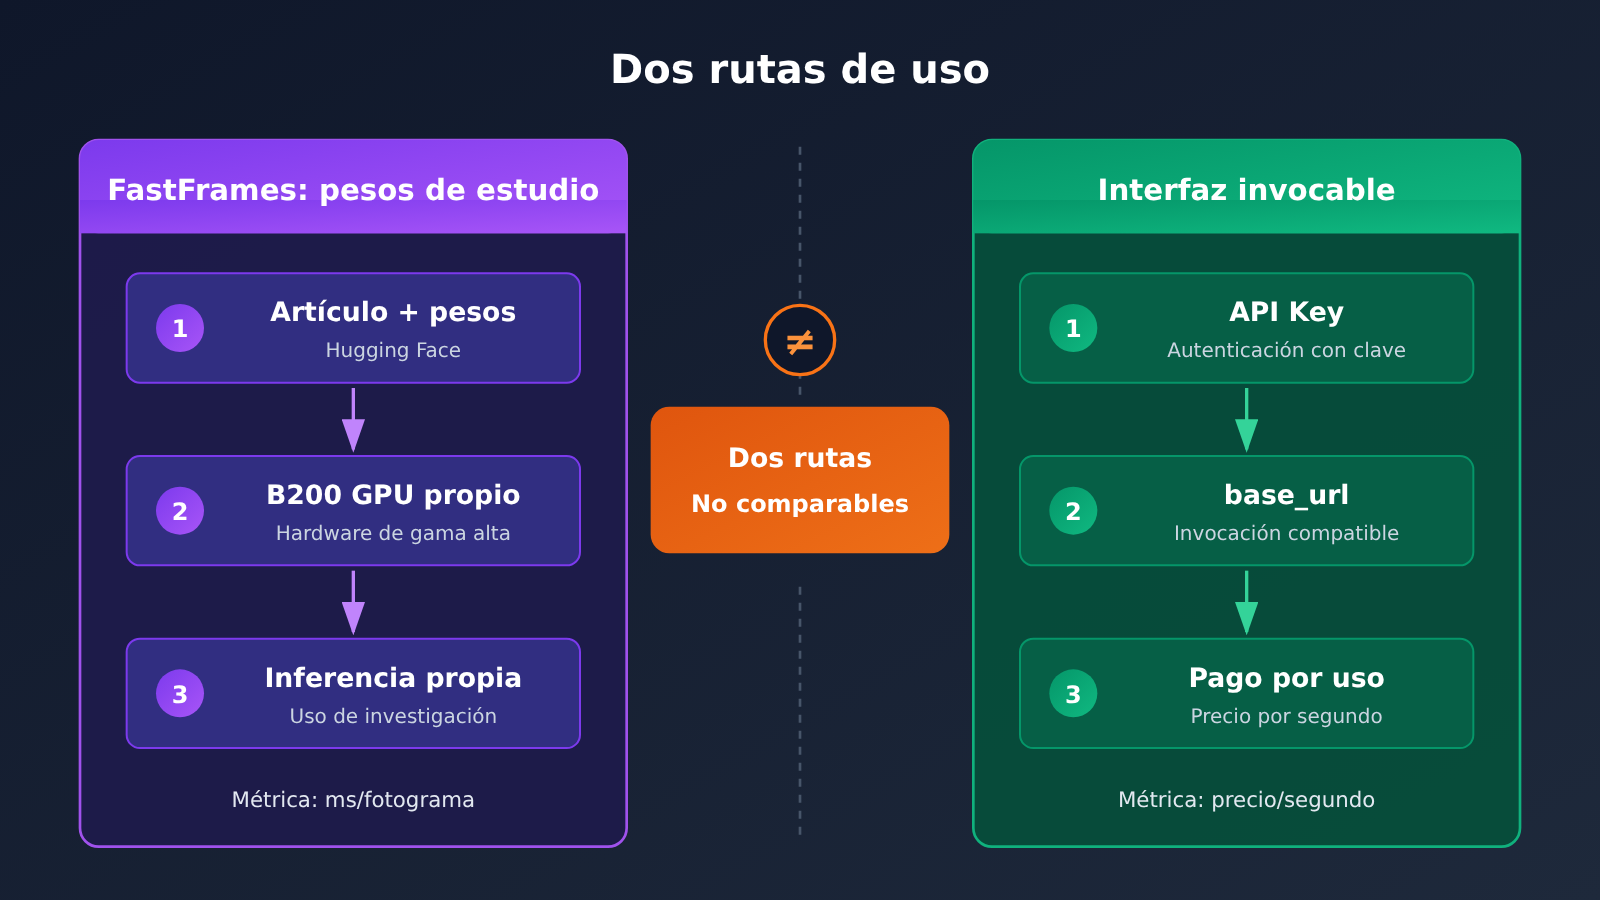
El caso de FastFrames es completamente diferente. Es un paper más un conjunto de archivos de pesos en Hugging Face; para usarlo hay que preparar una GPU propia y desplegar la inferencia. No existe un precio de llamada por uso, y lo explicaremos por separado más abajo.
Nuevos modelos de texto de noviembre de 2026: análisis de Gemini 4 Carbon
El calendario de lanzamiento de Gemini 4 Carbon es bastante peculiar. Google primero lo abrió el 28 de octubre a los equipos de defensa en ciberseguridad y, después, el 10 de noviembre, lo puso a disposición de desarrolladores de pago y empresas. El precio introductorio oficial es el mismo que el de Gemini 4 Argon: 2 USD de entrada y 10 USD de salida por millón de tokens.
Texto oficial de Gemini 4 Carbon frente a la página del modelo en la plataforma
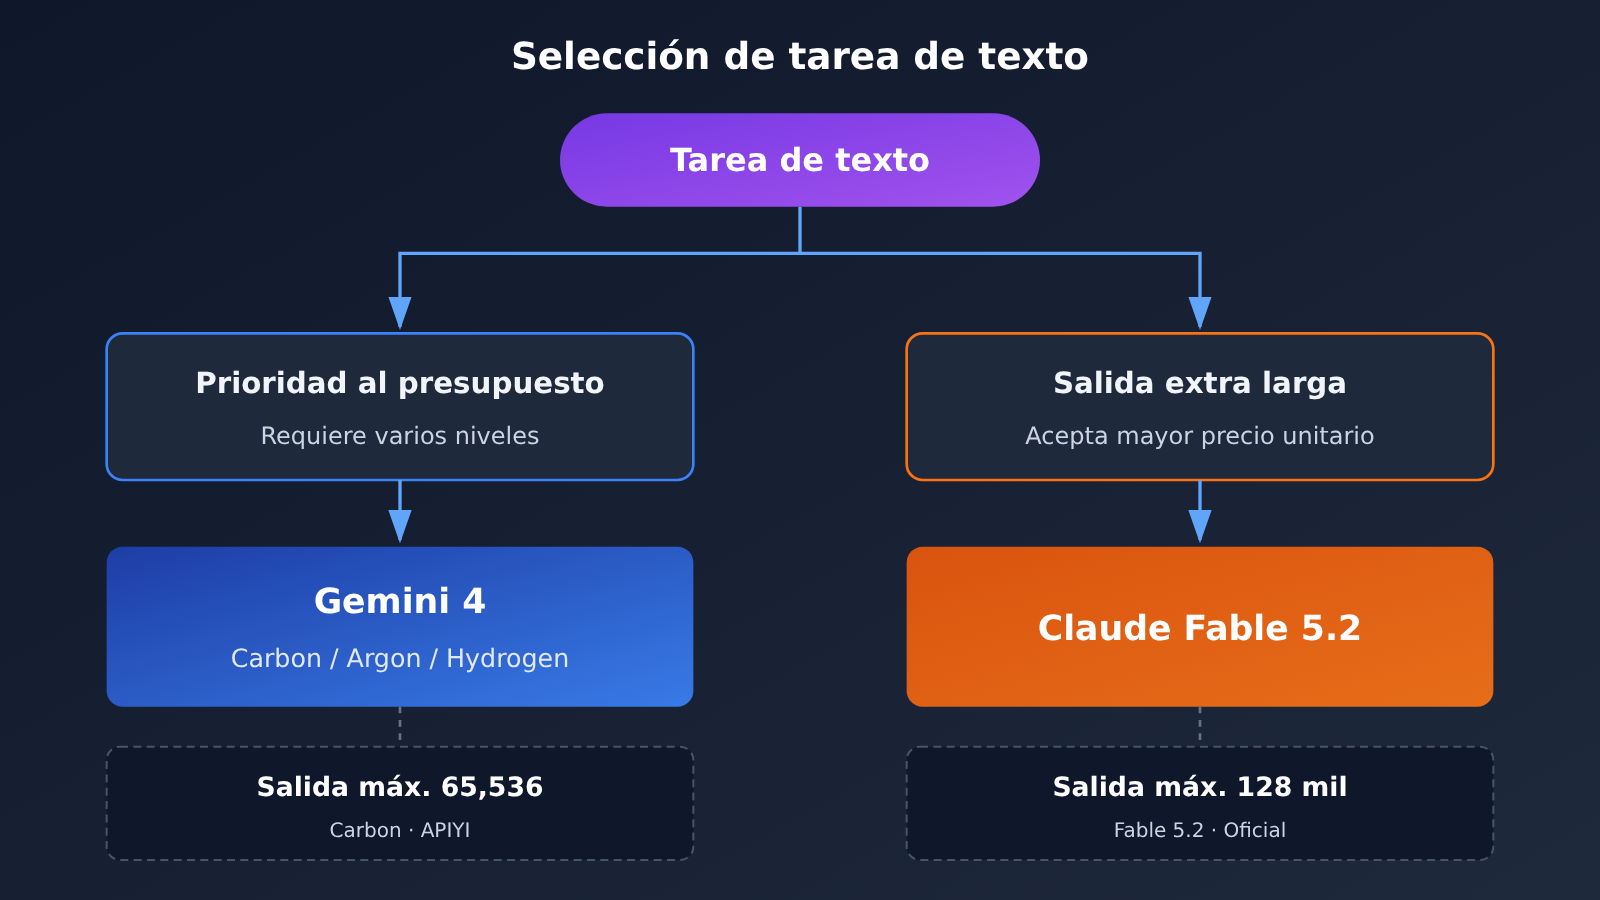
La salida máxima de Carbon tiene dos criterios que conviene distinguir. La página de descripción de Google AI Studio indica que una respuesta individual puede superar los 64K y llegar hasta 1 millón menos la longitud de la entrada. En cambio, la página del modelo en APIYI marca la salida máxima en 65,536 tokens.
| Parámetro | Texto oficial (Google) | Página del modelo en APIYI |
|---|---|---|
| ID del modelo | Gemini 4 Carbon | gemini-4-carbon |
| Fecha de lanzamiento | 10 de noviembre: apertura a desarrolladores de pago | 2026-11-11 |
| Longitud de contexto | Del orden de 1 millón | 1,048,576 tokens |
| Salida máxima | Puede superar 64K, hasta 1 millón menos la entrada | 65,536 tokens |
| Precio de entrada | 2 USD / millón de tokens | 2 USD / millón de tokens |
| Lectura de caché | — | 0.1 USD / millón de tokens |
| Precio de salida | 10 USD / millón de tokens | 10 USD / millón de tokens |
| Endpoints admitidos | — | chat y gemini |
La conclusión práctica es muy sencilla: al invocar gemini-4-carbon a través de APIYI, el límite de salida por respuesta debe planificarse según los 65,536 tokens de la página del modelo. La salida ultralarga oficial responde a otro criterio y forma parte de las indicaciones para el entorno nativo de Google; no mezcles ambos números. En la página del modelo también aparece esta frase textual de la documentación: «textos largos de 199 000 tokens: aprobado». Eso es un registro de la documentación, no una conclusión de las pruebas de este artículo.
El mismo precio unitario de Gemini 4 Carbon no equivale al mismo coste por tarea
Muchas personas, al ver que Carbon y Argon tienen el mismo precio unitario, dan por hecho que usarlos cuesta lo mismo; aquí hay un detalle fácil de pasar por alto. El texto oficial de Google indica claramente que Carbon usará más tokens que Argon para realizar verificaciones. Es decir, si le planteas la misma pregunta a Carbon, los tokens consumidos en la salida o en el razonamiento pueden ser mayores.
Así que un precio unitario idéntico solo indica que la facturación por millón de tokens es la misma; no implica que la factura de una tarea individual vaya a ser igual. La documentación oficial no especifica cuánto más consume y este artículo tampoco estima un factor multiplicador. Si el coste es una preocupación para ti, lo más prudente es ejecutar tus tareas reales varias veces con cada modelo y comparar el consumo de tokens que figura en la facturación.
Dentro de la misma familia hay una opción más barata, gemini-4-hydrogen; en la tabla general de APIYI figura con un precio de 1.5 USD de entrada, 0.075 USD de lectura de caché y 7.5 USD de salida por millón de tokens. Resulta adecuada para escenarios con un volumen alto de invocaciones y requisitos de profundidad de verificación no muy exigentes.
Nuevo modelo de texto de noviembre de 2026: análisis de Claude Fable 5.2
Claude Fable 5.2 fue lanzado por Anthropic el 9 de noviembre. El ID del modelo que figura en la documentación oficial es claude-fable-5-2. Los parámetros oficiales son una ventana de contexto de 1 millón de tokens y una salida máxima de 128 000 tokens; el precio es de 8 dólares por millón de tokens de entrada y 40 dólares por millón de tokens de salida.
Comparación de precios entre Claude Fable 5.2 y la generación anterior
La tabla general de APIYI incluye tanto claude-fable-5-2 como claude-fable-5-2-thinking, ambos con el mismo precio. La documentación oficial indica que la lectura de caché de Fable 5.2 es el 2.5 % del precio de entrada; el 2.5 % de 8 dólares es exactamente 0.2 dólares, lo que coincide con la tabla general de la plataforma.
| ID del modelo | Entrada (USD/millón) | Lectura de caché (USD/millón) | Salida (USD/millón) |
|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 |
claude-fable-5-2-thinking |
8 | 0.2 | 40 |
claude-fable-5-1 (generación anterior) |
10 | 0.25 | 50 |
Como se puede ver en la tabla, los tres precios unitarios de Fable 5.2 son inferiores a los de Fable 5.1. Si tu proyecto funciona actualmente con 5.1, migrar a 5.2 supone, al menos a nivel de precio unitario, una reducción directa; aun así, conviene verificar las diferencias concretas de rendimiento con tus propias tareas.
Cabe señalar que la tabla general de APIYI no ofrece una página de detalles independiente para Fable 5.2, por lo que los datos de contexto y salida máxima que aparecen aquí provienen de la documentación oficial de Anthropic. Si al invocar el modelo necesitas una salida muy larga, toma como referencia las indicaciones oficiales y establece explícitamente max_tokens en la solicitud.
Comparativa de precios y formas de invocación de los nuevos modelos de IA en noviembre de 2026
Si ponemos los dos nuevos modelos de texto junto a sus modelos hermanos, las diferencias de precio se ven mucho más claras. Todos los precios unitarios a continuación están en dólares por millón de tokens y provienen de la tabla general de modelos de APIYI del mismo día.
| ID del modelo | Entrada | Lectura de caché | Salida | Plataformas disponibles |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | APIYI apiyi.com, Google oficial |
gemini-4-argon |
2 | 0.1 | 10 | APIYI, Google oficial |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | APIYI, Google oficial |
claude-fable-5-2 |
8 | 0.2 | 40 | APIYI, Anthropic oficial |
claude-fable-5-1 |
10 | 0.25 | 50 | APIYI, Anthropic oficial |
Hagamos la cuenta con un escenario hipotético: una tarea con 100.000 tokens de entrada y 10.000 de salida. Según el precio unitario, Carbon costaría unos 0.2 + 0.1 = 0.3 dólares, y Fable 5.2 alrededor de 0.8 + 0.4 = 1.2 dólares. Esto es solo una ilustración aritmética basada en el precio unitario; en la práctica es posible que Carbon salga más caro porque consume más tokens para verificar, así que el gasto real conviene comprobarlo con la factura.
En cuanto a la forma de invocación, se puede acceder a ambos modelos a través de la interfaz compatible con OpenAI de APIYI; el base_url se rellena siempre como https://api.apiyi.com/v1, y para cambiar de modelo basta modificar el campo model. Con una sola clave API puedes invocar gemini-4-carbon y claude-fable-5-2 al mismo tiempo, lo que facilita hacer una comparación A/B dentro del mismo código.
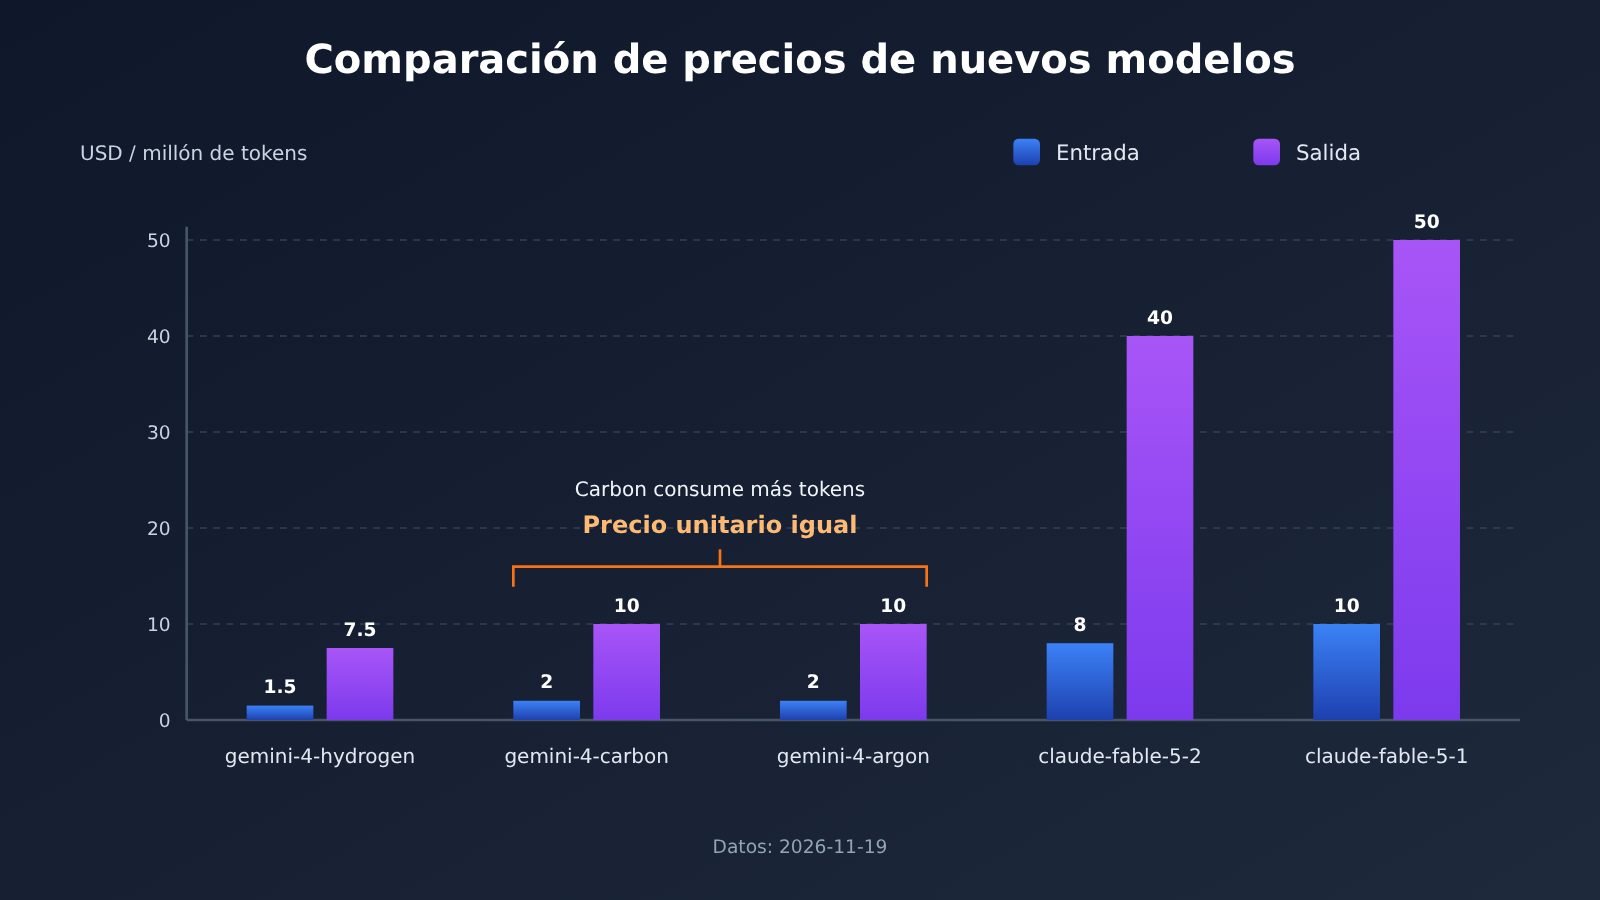
Nota sobre el gráfico: los precios unitarios del gráfico provienen de la tabla general de modelos de APIYI apiyi.com del 19-11-2026; que las barras de Carbon y Argon tengan la misma altura solo significa que el precio unitario coincide, y el costo de una tarea concreta depende del consumo real de tokens.
Llamada rápida a Gemini 4 Carbon y Claude Fable 5.2 mediante la API
Esta es la forma más sencilla de invocarlos: basta cambiar un campo model para alternar entre los dos modelos nuevos:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # cambia a "claude-fable-5-2" para alternar
    messages=[{"role": "user", "content": "用三句话解释零信任架构"}]
)
print(response.choices[0].message.content)
Ver el código completo de la llamada comparativa
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Con APIYI, la salida máxima de Carbon se planifica según la página del modelo: 65,536
MAX_OUTPUT = {
    "gemini-4-carbon": 65536,
    "claude-fable-5-2": 8192,  # ajusta según necesidad; la salida máxima oficial es de 128 mil
}

def ask(model: str, prompt: str, system: Optional[str] = None) -> dict:
    messages = []
    if system:
        messages.append({"role": "system", "content": system})
    messages.append({"role": "user", "content": prompt})

    resp = client.chat.completions.create(
        model=model,
        messages=messages,
        max_tokens=min(MAX_OUTPUT.get(model, 4096), 8192),
    )
    return {
        "model": model,
        "text": resp.choices[0].message.content,
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
    }

if __name__ == "__main__":
    task = "审查下面这段代码的安全隐患,并给出修复建议:..."
    for m in ["gemini-4-carbon", "claude-fable-5-2"]:
        r = ask(m, task, system="你是资深安全工程师")
        print(m, r["prompt_tokens"], r["completion_tokens"])
        print(r["text"][:300], "\n---")
El código completo imprime los tokens de entrada y de salida de cada llamada, justo lo que necesitas para comprobar lo que comentábamos antes: «mismo precio unitario, distinto gasto por llamada». Ejecutar la misma tarea varias veces en cada modelo y comparar completion_tokens resulta más fiable que mirar solo la tabla de precios.
🚀 Consejo para empezar rápido: si quieres comparar estos dos modelos nuevos en tus propias tareas, primero regístrate en APIYI apiyi.com para obtener crédito de prueba gratuito, ejecuta una ronda con el código de arriba en cada modelo y después decide cuál será tu modelo principal según el consumo de tokens y la calidad de la salida.
Nuevo modelo de video de noviembre de 2026: FastFrames, pesos de investigación
FastFrames proviene del equipo de investigación de Apple; el número del artículo es arXiv:2611.23226 y la versión v1 tiene fecha 2026-11-17. El proyecto también ofrece una página en GitHub Pages y ha publicado en Hugging Face dos conjuntos de pesos: FastFrames-S y FastFrames-L.
Datos autodeclarados en el artículo de FastFrames
Todas las cifras siguientes están autodeclaradas en el artículo; no son la clasificación final de una evaluación de terceros, y mucho menos el precio por llamada de ninguna API.
| Versión | Parámetros | Hardware autodeclarado en el artículo | Velocidad autodeclarada en el artículo | Resolución |
|---|---|---|---|---|
| FastFrames-S | 1,3 mil millones | una B200 | unos 36 ms por fotograma | 480p |
| FastFrames-L | 14 mil millones | 8 B200 | unos 45 ms por fotograma | 480p |
Esta tabla deja clara la posición de FastFrames: muestra un método de investigación para generar video fotograma a fotograma con rapidez en GPU de gama alta. Para reproducir estas velocidades, tendrás que preparar por tu cuenta hardware del nivel de una B200 y desplegarlo; eso no es lo mismo que «rellenar una clave API y empezar a llamar».
FastFrames también es solo investigación en el terreno del video, no un modelo general que procesa texto y video a la vez. Si tu objetivo es generar video en tu producto hoy mismo, conviene consultar la tabla general de modelos de APIYI para ver los modelos de video que ya tienen precio por segundo; no compares la velocidad por fotograma de unos pesos de investigación con el precio de una interfaz que cobra por segundo.
Análisis del impacto de los nuevos modelos de IA de noviembre de 2026
Impacto para los desarrolladores
- Más opciones de modelos de texto y menor costo de cambio: tanto Carbon como Fable 5.2 ya admiten invocaciones compatibles con OpenAI, así que con el mismo código basta cambiar el ID del modelo para compararlos. Esto encaja con repartir las tareas entre varios modelos en lugar de apostar todo a uno solo.
- El costo se evalúa por consumo de tokens, no solo por precio unitario: Carbon y Argon tienen el mismo precio unitario, pero la documentación oficial indica que Carbon consume más tokens en la verificación, así que el presupuesto debe basarse en la factura real.
- El límite de salida hay que confirmarlo según el canal de invocación: la salida larga oficial de Carbon y los 65,536 de la página de modelos de la plataforma son dos cifras distintas; al escribir código, ajusta
max_tokenssegún el canal que realmente uses. - En video, primero hay que separar investigación de API: FastFrames es adecuado para equipos con recursos de GPU que quieran investigar la generación de video en tiempo real; no sirve para montar directamente la API de video de un producto en línea.
Impacto para la industria
- Abrir primero en escenarios de seguridad se está volviendo una forma de lanzamiento: Carbon se ofrece primero a los defensores de ciberseguridad y luego a los desarrolladores de pago, lo que muestra que los fabricantes empiezan a liberar los nuevos modelos por fases según el escenario de uso.
- El precio unitario de los modelos de gama alta sigue bajando: los tres precios unitarios de Fable 5.2 son inferiores a los de Fable 5.1, y la tendencia a la baja de precios al iterar modelos de la misma gama continúa.
- La generación de video va detrás del tiempo real: el artículo de FastFrames se plantea como objetivo una velocidad de generación de un solo fotograma del orden de milisegundos; el foco de la investigación está pasando de «poder generar» a «generar rápido».
Preguntas frecuentes FAQ
Q1: ¿Qué nuevos modelos de IA se pueden invocar directamente mediante API en noviembre de 2026?
En el ámbito de texto, Gemini 4 Carbon (`gemini-4-carbon`) y Claude Fable 5.2 (`claude-fable-5-2`, `claude-fable-5-2-thinking`) se pueden invocar directamente. FastFrames, en el ámbito de video, es un paper y pesos de investigación, no una interfaz invocable.
Q2: Gemini 4 Carbon y Gemini 4 Argon tienen el mismo precio, ¿cuál elegir?
Ambos tienen un precio unitario de 2 USD de entrada, 0.1 USD de lectura de caché y 10 USD de salida por millón de tokens. Pero el texto original de Google indica que Carbon usará más tokens que Argon para hacer verificaciones, así que el costo por tarea individual podría ser mayor. Se recomienda ejecutar varias veces cada modelo con tareas reales y comparar el consumo de tokens y la calidad de los resultados antes de decidir.
Q3: ¿Cuál es exactamente la salida máxima de Gemini 4 Carbon?
Depende del canal. Al invocar mediante APIYI, planifica según los 65,536 tokens indicados en la página del modelo. La documentación oficial de Google AI Studio indica que una respuesta individual puede superar 64K y llegar hasta 1 millón menos la entrada; esa es otra referencia del entorno nativo oficial.
Q4: ¿FastFrames se puede usar para generar video en un producto?
FastFrames es un trabajo de investigación de Apple; ofrece el paper y pesos en Hugging Face, y la velocidad reportada en el paper depende de GPU de nivel B200. Si quieres generar video directamente con una API, deberías elegir en la tabla general de modelos de APIYI un modelo de video con precio por segundo, en lugar de comparar precios usando pesos de investigación.
Q5: ¿Cómo invocar rápidamente Gemini 4 Carbon y Claude Fable 5.2?
Recomendamos probar de forma unificada mediante una plataforma de agregación de API:
1. Visita APIYI apiyi.com y crea una cuenta
2. Obtén una clave API y el crédito gratuito de prueba para nuevos usuarios
3. Usa el código de este artículo, configura `base_url` con `https://api.apiyi.com/v1` y en `model` indica `gemini-4-carbon` y `claude-fable-5-2` respectivamente
Con una sola clave puedes invocar ambos modelos al mismo tiempo, lo que facilita compararlos y cambiar entre ellos.
Q6: ¿Qué limitaciones deberían tenerse en cuenta en estos nuevos modelos?
El precio unitario de Carbon es igual al de Argon, pero el consumo real de tokens puede ser mayor; hay que confirmar el costo con pruebas reales. El precio unitario de Fable 5.2 es cuatro veces el de Carbon, y en escenarios de salida larga el gasto aumenta de forma notable. Las cifras de velocidad de FastFrames son todas reportadas en el paper y además requieren contar con una GPU de gama alta propia; no equivalen al rendimiento de una API.
Puntos clave de los nuevos modelos de IA de noviembre de 2026
- Dos opciones de texto disponibles vía API:
gemini-4-carbonyclaude-fable-5-2ya se pueden invocar mediante la interfaz compatible con OpenAI. - Carbon tiene el mismo precio unitario que Argon: ambos cuestan 2 USD de entrada y 10 USD de salida por millón de tokens, pero la documentación oficial indica que Carbon consumirá más tokens.
- Carbon maneja dos referencias de salida: en la plataforma se planifica con 65,536, mientras que la salida larga oficial responde a otra cifra.
- Fable 5.2 es más económico que 5.1: entrada 8, lectura de caché 0.2, salida 40; los tres precios unitarios son inferiores a la generación anterior.
- FastFrames son pesos de investigación: artículo de Apple más pesos de Hugging Face; la velocidad es la declarada en el artículo, no un precio de API.
- Cómo empezar: en APIYI, con la misma clave API solo cambias el ID del modelo y podrás comparar los dos nuevos modelos de texto.
Resumen
Puntos clave de los nuevos modelos de IA de noviembre de 2026:
- Dos nuevas opciones para texto: Gemini 4 Carbon tiene un precio unitario bajo y más niveles dentro de la misma familia; Claude Fable 5.2 tiene un límite de salida oficial más alto y un precio unitario inferior al de la generación anterior.
- El costo depende del consumo real: el mismo precio unitario no implica el mismo precio por uso; la verificación adicional de Carbon se reflejará en el consumo de tokens.
- En video, primero aclara la naturaleza: FastFrames son pesos de investigación, adecuados para equipos de investigación con recursos de GPU; para integración en productos, elige modelos de video con facturación por segundo.
Para los desarrolladores que quieren ponerse manos a la obra de inmediato, lo más práctico es dividir por tareas: asigna el mismo lote de tareas reales a Carbon y a Fable 5.2, y decide con base en la factura y la calidad de salida, en lugar de depender de cualquier ranking general. Recomendamos usar APIYI apiyi.com con una sola clave API para completar rápidamente esta ronda de comparación; los modelos y precios están sujetos a la lista de modelos de la plataforma.
📚 Materiales de referencia
-
Blog oficial de Google – Anuncio de lanzamiento de Gemini 4 Carbon: fecha de apertura y precio oficial introductorio
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ - Descripción: incluye la aclaración oficial sobre el precio idéntico al de Argon y la verificación de tokens de uso intensivo
- Enlace:
-
Google AI Studio – Notas de actualización de Gemini 4 Carbon: criterio oficial sobre las salidas largas
- Enlace:
aistudio.google.com/docs/whats-new-gemini-4-carbon - Descripción: fuente del texto oficial donde se indica que una sola respuesta puede superar 64K
- Enlace:
-
Documentación oficial de Anthropic – Descripción general de Claude Fable 5.2: ID del modelo, ventana de contexto y precio
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview - Descripción: fuente del máximo de salida de 128 mil tokens y de la lectura de caché al 2.5%
- Enlace:
-
Investigación de Apple – Página del proyecto FastFrames: paper y notas de investigación
- Enlace:
apple-aiml-research.github.io/ml-fastframes/ - Descripción: paper arXiv:2611.23226, fecha de la v1: 2026-11-17
- Enlace:
-
Hugging Face – Pesos de FastFrames: las dos versiones S y L
- Enlace:
huggingface.co/apple/FastFrames-S - Descripción: punto de descarga de los pesos de investigación; es necesario desplegar la inferencia por cuenta propia
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal del sitio de APIYI; los detalles de los modelos y la documentación de invocación están disponibles en el centro de documentación docs.apiyi.com


