
Se puede ahorrar, pero con condiciones. Según los dos casos hipotéticos de cálculo que figuran en la documentación oficial de Google, en un escenario con 200 herramientas y un contexto base de 2,000 tokens, los tokens de entrada de Gemini Tool Retrieval bajan de 164,000 a 23,650, una reducción de aproximadamente 85.6%. En un escenario con 10 herramientas y un contexto base de 30,000 tokens, los tokens de entrada suben de 68,000 a 92,830, un aumento de aproximadamente 36.5%. Si resulta rentable o no depende de una pregunta: ¿puede el schema completo de herramientas que se ahorra cubrir el costo de contexto adicional que genera la búsqueda del lado del servidor?
¿Qué podrás entender después de leer este artículo?
- Qué parte de los tokens ahorra Tool Retrieval y qué parte de tokens agrega.
- Los supuestos completos y el desglose detallado tanto del caso oficial de 200 herramientas como del caso de 10 herramientas.
- La fórmula del punto de equilibrio derivada de los parámetros oficiales y el método para juzgar «a partir de cuántas herramientas vale la pena activarlo».
- Cómo usar el campo
interaction.usagey las reglas de caché para calcular el costo real de una tarea de Agent.
Índice: primero, con la tabla de conceptos y el resumen rápido de impactos te ayudamos a unificar terminología y a determinar a qué tipo de lector perteneces. La sección «Hechos objetivos» explica el mecanismo, las reglas de facturación que Google publicó y el criterio textual de los dos casos de cálculo. La sección «Análisis y juicio» presenta el punto crítico derivado de los parámetros oficiales, las diferencias entre los tres tipos de «ahorro», la fórmula de facturación de una sola tarea y la tabla de decisión para activarlo.
Análisis de costes de Gemini Tool Retrieval: conceptos que conviene conocer
| Concepto | Explicación breve |
|---|---|
| Tokens de entrada | Unidad de medida del texto, el contexto histórico y las declaraciones de herramientas, etc., que se envían al modelo para su procesamiento |
| Esquema de herramientas (Schema) | Definición completa de parámetros en la que se basa el modelo al generar llamadas a funciones; en el ejemplo, cada una ocupa unos 400 tokens |
| Lista de herramientas diferidas | Tras establecer defer_loading: true, los nombres y descripciones breves de las herramientas que el modelo ve inicialmente; en las primeras pruebas oficiales, cada elemento ocupaba unos 26 tokens |
| Contexto base B | En el ejemplo, la información histórica y de la tarea que el modelo ya tenía que procesar en cada invocación |
| Razonamiento posterior a la búsqueda | Una invocación adicional del modelo que se ejecuta después de que el servidor recupere la herramienta, con el contexto existente más el esquema añadido |
total_tool_use_tokens |
Volumen de entrada adicional de invocaciones del modelo provocado por las herramientas del servidor y las búsquedas dentro de una misma solicitud |
total_cached_tokens |
Parte del consumo de entrada procesada mediante caché y facturada a la tarifa de caché |
| Punto de equilibrio | Bajo el mismo conjunto de supuestos, el límite en el que el coste de entrada de la carga estática y el de la carga bajo demanda se igualan |
| Coste de una tarea exitosa | Suma de los costes de las invocaciones del modelo en cada ronda y de las herramientas necesarias para completar un objetivo de negocio |
Gemini Tool Retrieval: panorama de impactos
- Desarrolladores de agentes que integran grandes bibliotecas de herramientas: cuando hay muchas herramientas y solo se usan unas pocas por tarea, existe la oportunidad de reducir significativamente el coste de repetir los esquemas en la entrada. Este es el escenario del ejemplo oficial con 200 herramientas.
- Desarrolladores de aplicaciones con pocas herramientas y contextos largos: cada búsqueda del lado del servidor exige una ejecución adicional de inferencia del modelo y volver a procesar el contexto largo, así que activarla puede salir más caro. El ejemplo oficial con 10 herramientas es justamente el contraejemplo.
- Ingenieros y personal de FinOps responsables del cálculo de costes: mirar solo
total_input_tokensde la primera solicitud infravalora el coste; hay que sumar tambiéntotal_tool_use_tokens, los aciertos de caché y los tokens de salida. - Equipos de plataforma que mantienen registros de herramientas corporativas: el modo de recuperación en el cliente se puede combinar con filtrado de permisos propio y herramientas dinámicas, pero cada búsqueda añade un viaje de ida y vuelta extra a la API, y el criterio de coste debe evaluarse por separado.
Hechos objetivos: lanzamiento y mecánica de facturación de Gemini Tool Retrieval
Qué es Gemini Tool Retrieval y cuándo se lanzó
El 19 de noviembre de 2026, Google anunció en su blog oficial la disponibilidad en vista previa de Tool Retrieval en la Gemini Interactions API. La función está en fase Preview y requiere la versión v1beta de la API; el método antiguo generateContent no la admite. Para activar el modo del lado del servidor, se añade {"type": "tool_search"} dentro de tools y se establece defer_loading: true en la function o el mcp_server que se quiera cargar de forma diferida.
A fecha del 20 de noviembre de 2026, la documentación para desarrolladores enumera explícitamente cuatro ID de modelo compatibles: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash y gemini-3.6-flash. La mención en el anuncio a «Gemini 3.6 y modelos más recientes» es más amplia, pero los modelos que no aparecen en la documentación deben verificarse por cuenta propia; establecer defer_loading en un modelo no compatible devuelve HTTP 400.
Hay un punto que se presta a malentendidos y conviene recalcar: en el modo del lado del servidor, los desarrolladores siguen teniendo que enviar el array completo de tools en cada solicitud, incluidos los parámetros completos de las herramientas diferidas, incluso cuando usan previous_interaction_id. Lo que cambia Tool Retrieval es el momento en que el esquema completo entra en el contexto del modelo, no que esas definiciones dejen de enviarse en el cuerpo de la solicitud.
De dónde vienen los costos de la carga estática y de Gemini Tool Retrieval
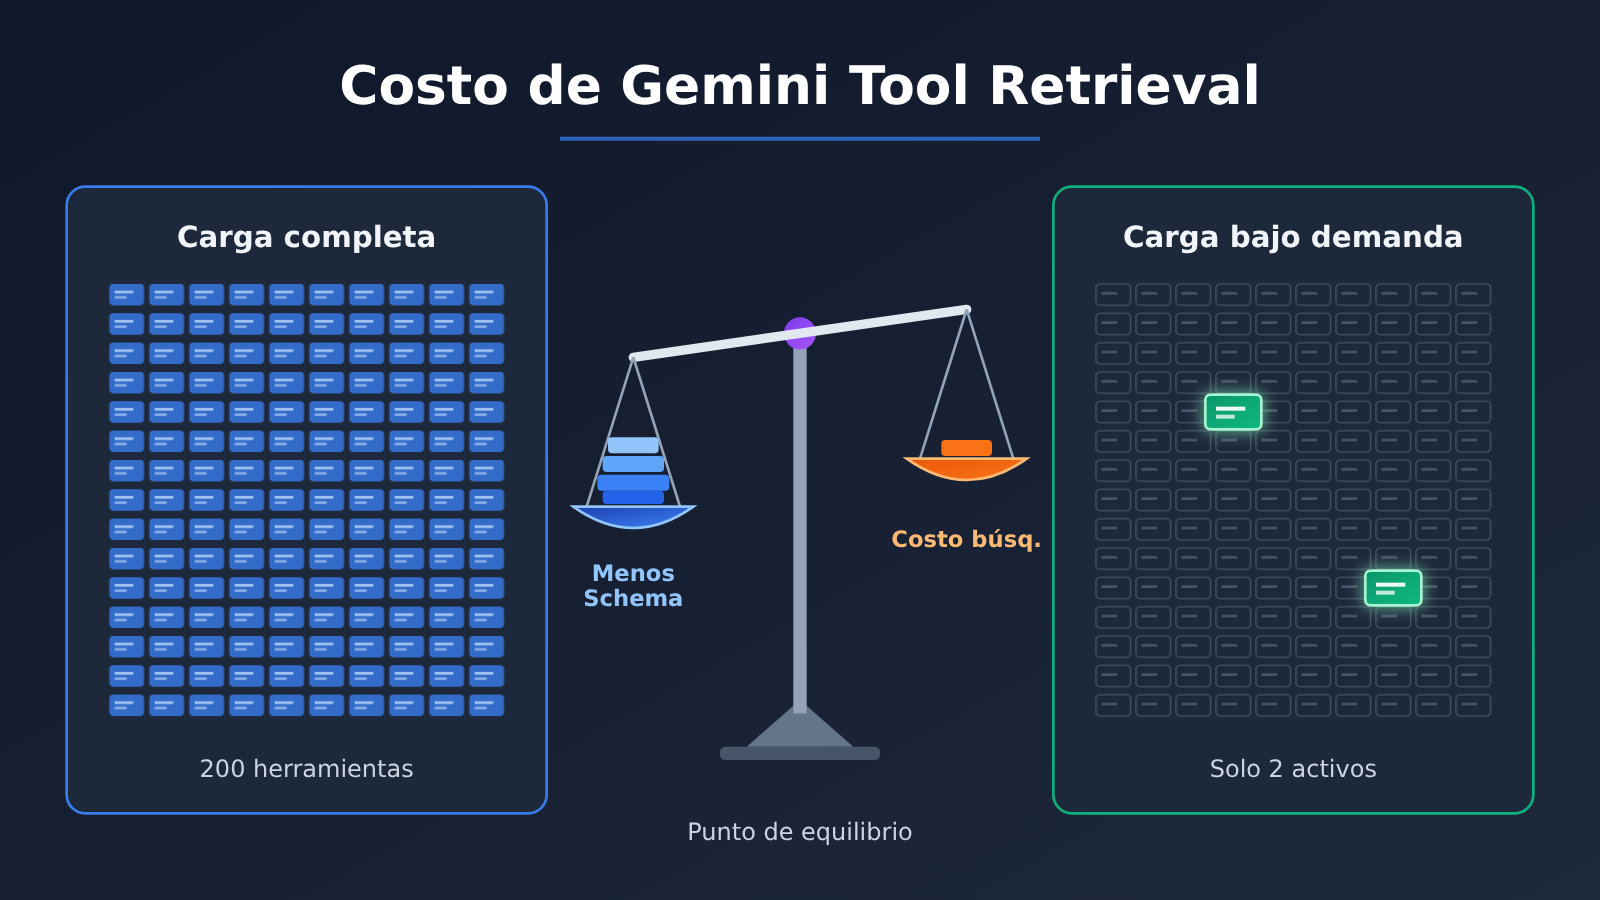
Con la carga estática, cada invocación del modelo tiene que leer el Schema completo de todas las herramientas, incluso si en esta ronda solo se usa una función de reembolso. Tool Retrieval sustituye esas definiciones completas por una lista breve de herramientas; cuando el modelo lo necesita, lanza un tool_search_call, el servidor devolve un tool_search_result que contiene el Schema completo y, a partir de ahí, el modelo genera un function_call.
Google deja claro que Tool Retrieval no tiene una tarifa funcional propia, pero los siguientes elementos se siguen facturando con la tarifa del modelo elegido:
- Los elementos de la lista breve de todas las herramientas diferidas.
- Las instrucciones de búsqueda fijas que se añaden al activar
tool_search. - La inferencia adicional del modelo que provoca cada recuperación del lado del servidor, ya que vuelve a procesar el contexto completo y el Schema recién cargado.
- El Schema completo de las herramientas cargadas y su ocupación continua en rondas posteriores (la documentación actual no ofrece ningún mecanismo de descarga).
- Los tokens normales de salida, de Thinking y de resultados de ejecución de herramientas.
Ejemplos de cálculo oficiales de Gemini Tool Retrieval: 200 herramientas frente a 10 herramientas
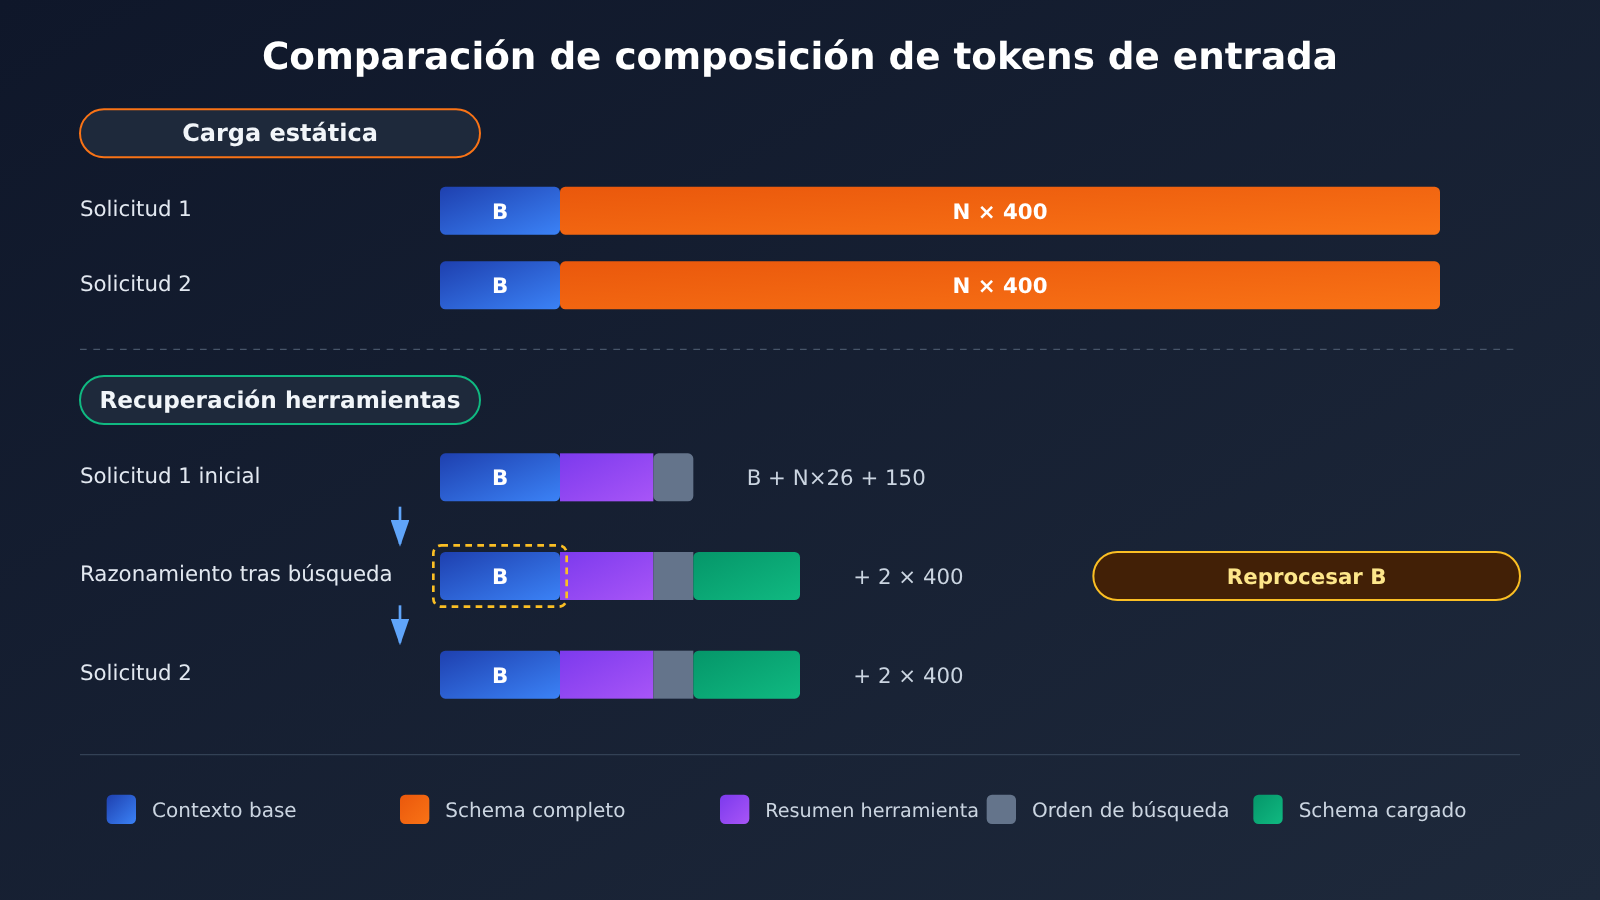
Ambos conjuntos de cálculos provienen de la documentación de Google Tool Retrieval, son cálculos hipotéticos marcados oficialmente y no benchmarks de entorno de producción, y ambos ignoran los tokens de salida y los beneficios de caché. El criterio unificado es: cada esquema completo 400 tokens, cada descripción breve de herramienta diferida unos 26 tokens, instrucción de búsqueda 150 tokens, una tarea incluye 2 solicitudes externas, en la primera solicitud se completa 1 búsqueda del lado del servidor y se cargan 2 herramientas en total.
| Concepto de cálculo | 200 herramientas, B=2,000 | 10 herramientas, B=30,000 |
|---|---|---|
| Carga estática: 2 × (B + N × 400) | 164,000 | 68,000 |
| Entrada inicial de la solicitud 1 (B + N × 26 + 150) | 7,350 | 30,410 |
| Razonamiento tras la búsqueda de la solicitud 1 (más 2 esquemas) | 8,150 | 31,210 |
| Entrada de la solicitud 2 | 8,150 | 31,210 |
| Total de Tool Retrieval | 23,650 | 92,830 |
| Variación | -140,350 | +24,830 |
| Magnitud de la variación (recálculo a partir de las cifras oficiales) | aprox. -85.6% | aprox. +36.5% |
La razón por la que el escenario de 200 herramientas ahorra de forma tan notable es que el enfoque estático tiene que cargar cada vez 80,000 tokens de definiciones de herramientas, mientras que el contexto base es de solo 2,000, de modo que el costo de ejecutar un razonamiento adicional en la búsqueda es pequeño. El escenario de 10 herramientas es justo lo contrario: las definiciones de herramientas suman solo 4,000 tokens en total, el margen de ahorro es limitado, y el razonamiento tras la búsqueda tiene que procesar de nuevo un contexto largo de 30,000 tokens, por lo que el costo añadido supera directamente el ahorro.
Campos de Usage, precios y reglas de caché de Gemini Tool Retrieval
Google ofrece en interaction.usage los campos necesarios para analizar el costo de Tool Retrieval:
| Campo | Significado | Papel en el análisis de costos |
|---|---|---|
total_input_tokens |
Entrada de la primera invocación del modelo dentro de la solicitud | Solo refleja «cuánto se acortó el contexto inicial» |
total_tool_use_tokens |
Entrada de las invocaciones adicionales del modelo provocadas por las herramientas del servidor y las búsquedas | Es la principal fuente del costo de búsqueda y la que más fácilmente se pasa por alto |
total_cached_tokens |
Parte ya incluida en la entrada que fue procesada por la caché | Se cobra a la tarifa de caché y no debe sumarse de nuevo |
total_output_tokens |
Salida generada por el modelo | Se cobra a la tarifa de salida |
total_thought_tokens |
Tokens producidos por el proceso de razonamiento | Se cobran a la tarifa de salida del modelo elegido |
En cuanto a precios, en la tarifa estándar (Standard) de la página de precios de Google, Gemini 4 Hydrogen cuesta $1.50 por millón de tokens de entrada, $7.50 por millón de tokens de salida (incluido Thinking) y $0.075 por millón de tokens de entrada en caché. Si se hiciera una conversión aritmética del ejemplo oficial usando solo ese precio unitario de entrada, el escenario de 200 herramientas daría aproximadamente $0.246 frente a $0.0355, y el de 10 herramientas aproximadamente $0.102 frente a $0.139. Esto no es más que multiplicar unos supuestos conteos de tokens por las tarifas oficiales; no corresponde a ninguna factura real.
Las reglas de caché incluyen dos umbrales que conviene entender por separado. Primero, la Interactions API solo admite caché implícita y, al 20 de noviembre de 2026, el tamaño mínimo de entrada para la caché implícita es de 4,096 tokens tanto en la serie Gemini 4 como en Gemini 3.8 Flash y Gemini 3.6 Flash. Segundo, en las conversaciones multiturno y en el Agent Loop de Gemini 4, una nueva solicitud debe aportar al menos 2,050 tokens adicionales para que el sistema cachee la solicitud anterior completa; si no alcanza ese umbral, los últimos 2,050 tokens de la solicitud anterior se vuelven a cobrar a la tarifa de entrada estándar, y la salida del modelo, el Thinking y los resultados de funciones cuentan dentro de ese incremento.
Hasta la fecha de verificación de la documentación, Google no ha publicado la proporción de ahorro de tokens de Tool Retrieval sobre conjuntos de tareas reales, ni la mejora en latencia, ni la mejora en la precisión de selección de herramientas, y tampoco se han visto pruebas de producción de desarrolladores independientes que puedan verificarse de forma suficiente.
Análisis y criterio: cuándo Gemini Tool Retrieval realmente ahorra tokens
El punto de equilibrio de Gemini Tool Retrieval: a partir de cuántas herramientas merece la pena activarlo
A continuación se muestra un ejemplo ampliado derivado de los parámetros del caso oficial de cálculo, no un umbral universal publicado por Google. Sea N el número total de herramientas y B el contexto base; mantenemos S=400, D=26, H=150, K=2 y el criterio de «dos solicitudes, una búsqueda»:
- Carga estática: T_static = 2 × (B + 400N)
- Carga bajo demanda: T_retrieval = 3 × (B + 26N + 150) + 2 × 2 × 400
Esta fórmula reproduce por completo los dos resultados oficiales. Haciendo T_retrieval < T_static, al reorganizar se obtiene 722N > B + 2050, es decir, N > (B + 2050) / 722. El 2050 aquí proviene de 3 × 150 + 1600; es solo un resultado algebraico y no guarda ninguna relación con la condición de incremento de 2.050 tokens de la caché multiturno de Gemini 4 en la documentación sobre caché. No confundas ambos conceptos.
| Contexto base B | Número de herramientas N | Carga estática | Tool Retrieval | Cambio | Variación | Tipo de dato |
|---|---|---|---|---|---|---|
| 2.000 | 200 | 164.000 | 23.650 | -140.350 | -85,6% | Caso oficial |
| 30.000 | 10 | 68.000 | 92.830 | +24.830 | +36,5% | Caso oficial |
| 30.000 | 44 | 95.200 | 95.482 | +282 | +0,3% | Derivación ampliada |
| 30.000 | 45 | 96.000 | 95.560 | -440 | -0,5% | Derivación ampliada |
| 30.000 | 50 | 100.000 | 95.950 | -4.050 | -4,1% | Derivación ampliada |
| 30.000 | 100 | 140.000 | 99.850 | -40.150 | -28,7% | Derivación ampliada |
Con B=30.000, el valor crítico es N > 44,39, es decir, a partir de la herramienta número 45 la carga bajo demanda apenas empieza a tener ventaja, y cerca del punto crítico el ahorro es prácticamente despreciable. Con la misma fórmula, si B=2.000, el valor crítico ronda 5,6; o sea, con 6 herramientas ya se invierte la balanza. Por tanto, cuanto más largo es el contexto base, más grande debe ser la biblioteca de herramientas para diluir el coste de reprocesar el contexto durante la búsqueda.
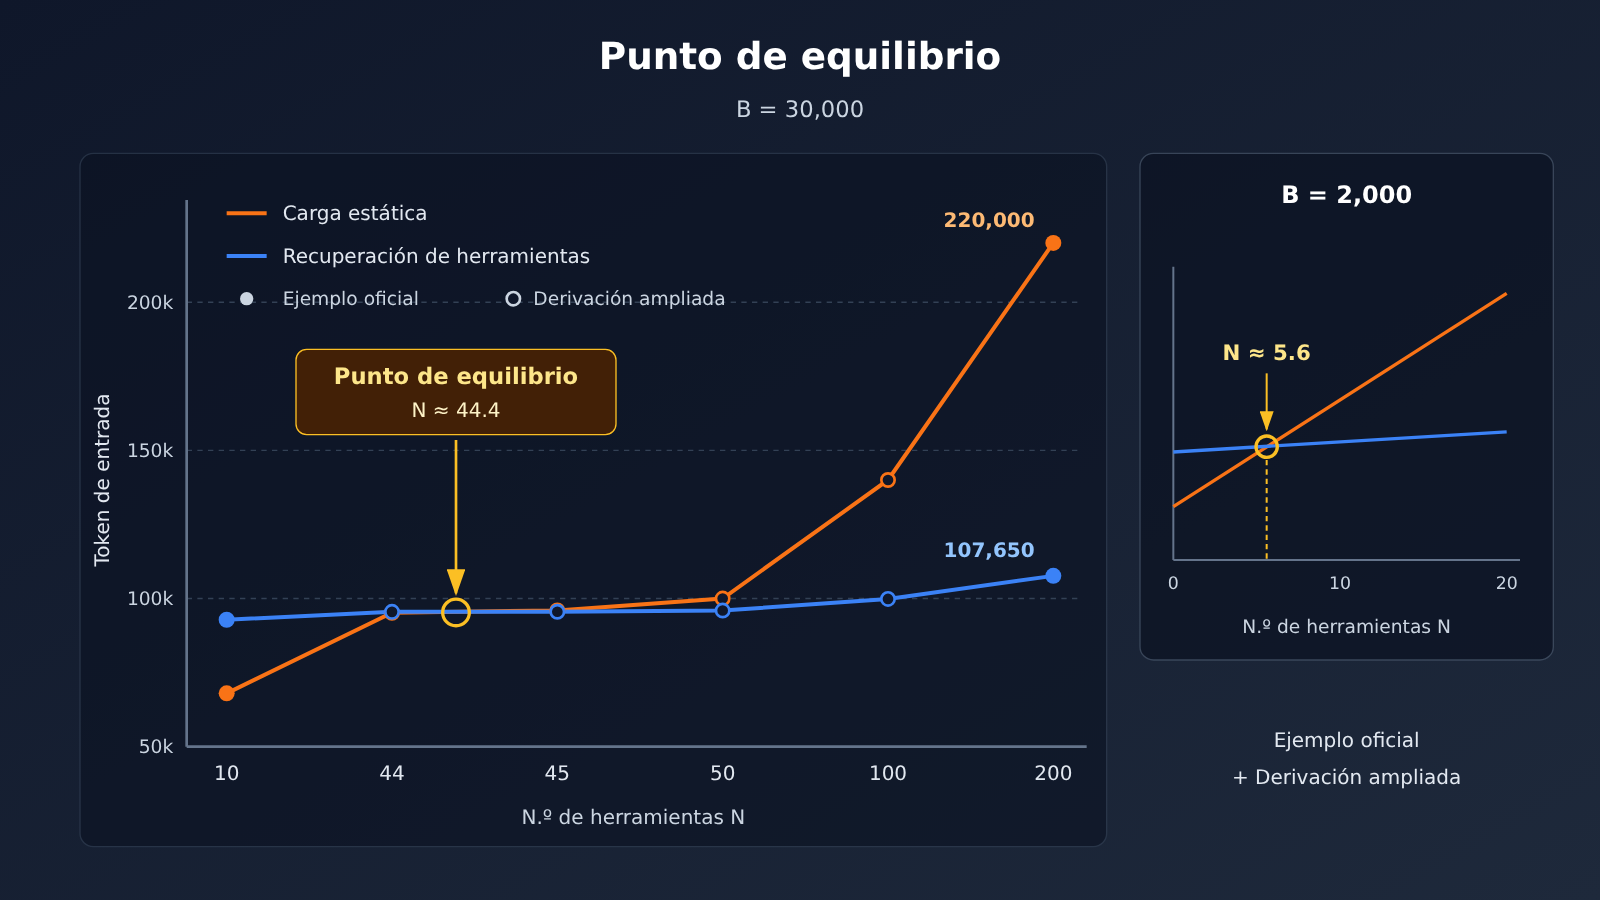
Pie de figura: las dos primeras filas de datos son casos oficiales de Google; el resto son derivaciones con el mismo criterio. En tareas reales, el número de búsquedas y la cantidad de cargas modificará la curva. Te recomendamos volver a medir con tus propias solicitudes de negocio; puedes levantar rápidamente, a través de la interfaz unificada de APIYI apiyi.com, la línea base de carga estática de varios modelos para comparar.
Las tareas reales rara vez se ajustan estrictamente a este conjunto de supuestos; las siguientes variables desplazan el punto crítico:
- Número de búsquedas: cada búsqueda adicional en el servidor representa una entrada más del modelo con el tamaño aproximado de «B + lista de herramientas + Schema ya cargado»; en escenarios de contexto largo, equivale a pagar B otra vez en cada búsqueda.
- Cantidad real cargada K: cuantas más herramientas se cargan, menor es el ahorro; los Schema ya cargados no se pueden descargar y se siguen acumulando en sesiones largas.
- Tamaño de un Schema individual S: en herramientas con parámetros complejos y descripciones extensas, la carga bajo demanda rinde más; cuando el Schema es muy corto, el beneficio se lo comen los elementos de la lista y las instrucciones de búsqueda.
- Número de turnos de la conversación: la solución estática repite todos los Schema en cada turno; cuantos más turnos haya y siempre que no se activen nuevas búsquedas, más evidente se vuelve la ventaja de la carga bajo demanda.
Menos tokens de entrada, facturación total más baja y respuestas más rápidas: las tres «economías» de Gemini Tool Retrieval
Estas tres cosas se confunden a menudo, pero no son equivalentes. Menos tokens de entrada es lo más intuitivo, pero si solo se mira total_input_tokens, se pasa por alto el razonamiento posterior a la búsqueda que se contabiliza en total_tool_use_tokens, y se sobreestima así el ahorro.
La facturación total más baja también depende de la caché y del precio unitario. La carga bajo demanda acorta el prompt inicial; si originalmente era gracias a una gran cantidad de Schema que se superaba el umbral de caché implícita de 4.096 tokens, al activarla podrías perder la caché. Si el ciclo corto de llamadas a funciones y retorno de resultados no añade contenido suficiente para 2.050 tokens, Gemini 4 tampoco obtiene la caché completa de la solicitud anterior. Es decir, aunque haya menos tokens, la estructura de precios podría empeorar.
Respuestas más rápidas no tiene hoy ningún respaldo de datos oficiales ni independientes. La búsqueda en el servidor no añade viajes de ida y vuelta desde el cliente, pero dentro de la solicitud sí se ejecuta inferencia adicional del modelo; la recuperación del lado del cliente añade un viaje de ida y vuelta de API por cada búsqueda. Si la latencia mejora o empeora, solo tu propia prueba de extremo a extremo puede responderlo.
Cómo calcular la factura real de una tarea del agente Gemini Tool Retrieval
Según la semántica oficial de Usage, y bajo la premisa de facturación estándar, tokens de caché ya incluidos en la entrada y sin otras herramientas con cobro por uso, una solicitud individual se puede estimar así:
USD ≈ [ (I + U − C) × P_in + C × P_cache + (O + T) × P_out ] / 1,000,000
Donde I, U, C, O y T corresponden, en ese orden, a los cinco campos de la tabla anterior. Una tarea de agente suele abarcar varias solicitudes, por lo que primero hay que agregar el Usage de cada solicitud y luego calcular; al final, con «coste total ÷ número de tareas completadas con éxito» se obtiene el coste de una sola tarea exitosa.
Antes de activar Tool Retrieval, lo más prudente es medir primero la línea base de carga estática. A continuación ejecutamos una llamada de Function Calling estática con la interfaz compatible con OpenAI y registramos el Usage de la línea base:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI, para ejecutar la línea base de carga estática
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",  # El nombre del modelo se rige por la lista de modelos de la plataforma
    messages=[{"role": "user", "content": "Refund 40 USD for order A-1042."}],
    tools=[{"type": "function", "function": {"name": "issue_refund",
            "parameters": {"type": "object", "properties": {
                "order_id": {"type": "string"}, "amount": {"type": "number"}},
                "required": ["order_id", "amount"]}}}]
)
print(resp.usage)  # Registrar los tokens de entrada y salida durante la carga completa estática
Cabe aclarar que Tool Retrieval en sí depende de la versión v1beta de la Google Interactions API. El ejemplo anterior solo sirve para obtener datos de comparación de carga estática; para el lado de carga bajo demanda, use el método de invocación que admite la Interactions API y luego meta el Usage de ambos lados en la misma fórmula de coste para compararlos.
Ver el código de implementación completo: cálculo del punto de equilibrio + estimación de la factura de Usage
import openai

# ---------- 1. Cálculo teórico según los criterios del ejemplo oficial (ejemplo extendido, no umbrales oficiales) ----------
def static_tokens(B: int, N: int, S: int = 400) -> int:
    return 2 * (B + N * S)

def retrieval_tokens(B: int, N: int, D: int = 26, H: int = 150,
                     K: int = 2, S: int = 400) -> int:
    return 3 * (B + N * D + H) + 2 * K * S

def breakeven_tools(B: int) -> float:
    return (B + 2050) / 722  # Solo válido cuando S=400, D=26, H=150, K=2

for B, N in [(2000, 200), (30000, 10), (30000, 45), (30000, 100)]:
    s, r = static_tokens(B, N), retrieval_tokens(B, N)
    print(f"B={B:>6} N={N:>3} static={s:>7} retrieval={r:>7} "
          f"change={(r - s) / s:+.1%}")
print("B=30000 临界工具数:", round(breakeven_tools(30000), 2))

# ---------- 2. Estimar el costo por solicitud (USD) según los campos de Usage ----------
def request_cost(I, U, C, O, T, p_in, p_cache, p_out) -> float:
    """I/U/C/O/T corresponden a total_input / tool_use / cached / output / thought tokens"""
    return ((I + U - C) * p_in + C * p_cache + (O + T) * p_out) / 1_000_000

# Ejemplo: precio estándar de Gemini 4 Hydrogen 1.50 / 0.075 / 7.50 (por millón de tokens)
print(request_cost(I=7350, U=8150, C=0, O=200, T=0,
                   p_in=1.50, p_cache=0.075, p_out=7.50))

# ---------- 3. Línea base de carga estática (interfaz compatible con OpenAI) ----------
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_static_baseline(prompt: str, tools: list, model: str = "gemini-3.8-flash"):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    return resp.usage  # Al agregar tareas de múltiples turnos, acumula solicitud por solicitud
🚀 Inicio rápido: lo mejor es primero ejecutar la línea base de carga estática en APIYI apiyi.com con una sola clave, registrar los tokens y la tasa de finalización del conjunto real de tareas de negocio, y luego decidir si conviene migrar el Agent a la carga bajo demanda. Así evitas cambiar la arquitectura basándote directamente en las cifras ilustrativas oficiales.
Decidir si activar Gemini Tool Retrieval: ¿tu biblioteca de herramientas cumple las condiciones?
Combinando las recomendaciones de ingeniería oficiales con la deducción anterior, puedes hacer una primera evaluación con la tabla siguiente; aun así, lo que manda al final son el costo por tarea exitosa y la tasa de finalización en tareas reales:
| Característica de la carga de trabajo | Estrategia recomendada | Motivo |
|---|---|---|
| Menos de unas 20 herramientas estables, la mayoría usadas en cada turno | Seguir con carga estática | Recomendación oficial; el esquema que se ahorra es poco y el costo de búsqueda pesa demasiado en proporción |
| Pocas herramientas pero un contexto base muy largo | Carga estática, o diferir solo unas pocas herramientas de esquema grande | Cada búsqueda reprocesa el contexto largo; el ejemplo de 10 herramientas ya es un contraejemplo |
| Decenas a cientos de herramientas, usando solo unas pocas por vez | Evaluar primero la recuperación del lado del servidor | Las bibliotecas grandes con cola long-tail son el escenario del ejemplo oficial de 200 herramientas |
| Mezcla de herramientas de alta frecuencia con muchas herramientas especializadas de baja frecuencia | Cargar directamente las de alta frecuencia y usar defer_loading para las de baja frecuencia |
Uso híbrido recomendado oficialmente, evita que incluso las tareas simples tengan que buscar primero |
| Multiinquilino, herramientas dinámicas, filtrado por permisos de usuario | Evaluar la recuperación del lado del cliente | Se puede conectar a un registro propio, pero cada búsqueda añade un round-trip |
| Herramientas mencionadas a menudo en las instrucciones del sistema | Mantener la carga directa | Advertencia oficial: las herramientas diferidas mencionadas por nombre pueden llamarse directamente saltándose la búsqueda y provocar errores |
💡 Recomendación de elección: ejecuta la misma tanda de tareas con los dos esquemas, el estático y el bajo demanda, manteniendo iguales el modelo, la biblioteca de herramientas, la longitud del contexto y las condiciones de caché. Con APIYI apiyi.com puedes alternar entre distintos modelos Gemini y otros modelos populares bajo una interfaz unificada para hacer comparaciones de línea base, lo que facilita atribuir la diferencia de costos a la propia estrategia de carga de herramientas.
Hay además varios detalles de ingeniería que afectan directamente la factura: cuando usas store=false y gestionas el historial por tu cuenta, debes conservar tal cual tool_search_call, tool_search_result y su signature; de lo contrario, las peticiones posteriores pueden devolver un HTTP 400. Tampoco puedes omitir los parameters de las herramientas diferidas solo para reducir el cuerpo de la petición. Y al depurar hay que revisar el function_call dentro de interaction.steps, no basta con mirar interaction.status. Si estos problemas acaban provocando un reintento, los tokens de la petición repetida también se contabilizan en el costo.
En definitiva, Tool Retrieval es una herramienta de costos que parte de la premisa de que «pocas herramientas se usan con frecuencia y la mayoría permanece inactiva durante mucho tiempo». Los dos ejemplos oficiales, que apuntan en direcciones opuestas, ya dejan claros los límites: cuanto más grande es la biblioteca de herramientas, más corto el contexto y menos búsquedas hay, más probable es ahorrar; en el caso contrario, puede que gastes más. Lo que de verdad hay que optimizar no es el número de tokens de la primera petición, sino la cuenta total por cada tarea exitosa.
Como escribió Chen Danran, autor de la dinastía Qing, en «Wuyan · Sobre el traslado de la capital y la creación de feudos»: «Quien no planifica el conjunto no puede planificar ni una sola parte.»
Referencias
- Anuncio oficial de Google: Introducing Tool Retrieval in the Gemini API (2026-11-19)
- Enlace:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Enlace:
- Documentación técnica de Google Tool Retrieval: configuración, facturación, ejemplos oficiales y limitaciones
- Enlace:
aistudio.google.com/docs/tool-retrieval
- Enlace:
- Documentación de Google Context caching: umbrales de caché implícita y reglas de caché multiturno de Gemini 4
- Enlace:
aistudio.google.com/docs/caching
- Enlace:
- Precios de Google Gemini Developer API: tarifas de entrada, salida y caché del modelo
- Enlace:
aistudio.google.com/docs/pricing
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: Si quieres comparar el costo de tokens entre Gemini y otros modelos en escenarios de Agent, te invitamos a visitar APIYI apiyi.com para obtener créditos de prueba. Para más detalles de integración, consulta el centro de documentación en docs.apiyi.com


