
Nota del autor: este artículo desglosa por separado las cifras autodeclaradas oficialmente de GPT-6.2 Astra y los datos de terceros de Artificial Analysis, y evalúa —tarea por tarea, en entrega profesional, ciencia, código y 3D, y ciberseguridad— si vale la pena confiarle tus trabajos más exigentes.
El 17 de noviembre de 2026, OpenAI lanzó oficialmente GPT-6.2 Astra y GPT-6.2 Sol. Según la publicación oficial, son «súper eficientes y están hechos para las tareas del mundo real». El anuncio de lanzamiento, la tarjeta del sistema y las páginas de modelo de la API de ambos modelos se publicaron al mismo tiempo, y ese mismo día Artificial Analysis dio a conocer su artículo de evaluación de terceros. Gracias a ello, los límites de capacidad de GPT-6.2 Astra pueden contrastarse de forma cruzada desde varias fuentes.
Este no es un artículo promocional de «número uno en todo». En el índice compuesto de Artificial Analysis, GPT-6.2 Astra no ocupa el primer puesto. Además, su puntuación varía de forma notable según el nivel de razonamiento elegido. Y en ciberseguridad ocurre lo contrario de lo que cabría esperar: sus protecciones más estrictas hacen que rechace algunas solicitudes legítimas. Aquí presentamos por separado las cifras oficiales y las de terceros, sin sumarlas en una sola conclusión.
Lo que te llevas: al terminar de leer, podrás saber qué evidencia respalda a GPT-6.2 Astra en cada uno de los cuatro frentes —entrega de documentos profesionales, tareas de terminal científico, código y 3D, y ciberseguridad—, y por qué una puntuación compuesta no puede sustituir el análisis punto por punto.
Puntos clave de GPT-6.2 Astra
Primero, una tabla de lectura rápida. Cada fila indica de dónde salen los datos, así que al leer ten presente la fuente de cada uno.
| Punto clave | Descripción | Fuente de datos | Qué significa para ti |
|---|---|---|---|
| Entrega profesional | Mejores resultados que GPT-6 Astra en flujos de trabajo profesionales de largo alcance, tareas legales y GDPval v2, además con menor costo | Autodeclarado oficialmente | Vale la pena probarlo primero en tareas de entrega documentales y multipaso |
| Terminal científico | Terminal-Bench-Science 0.1 supera a GPT-6 Astra en 9 puntos porcentuales | Autodeclarado oficialmente; AA también lo considera líder | Hay evidencia para escenarios donde hace falta ejecutar flujos científicos en la terminal |
| Código y 3D | El índice de agentes de codificación queda a la par con GPT-6 Astra, con un Elo de 1318 en la evaluación a ciegas de AA-3D | Tercero (AA) / citado en el comunicado oficial | El código no da un salto notable, pero la generación 3D tiene lo suyo |
| Puntuación global que varía según el nivel de razonamiento | Max y Xhigh: 62; High: 60; Medium: 57; Low: 46 | Tercero (AA) | Al bajar el nivel para ahorrar, la puntuación también baja |
| Ciberseguridad | Nivel «crítico» en el marco de preparación; algunas investigaciones legítimas de vulnerabilidades serán rechazadas; Daybreak aún no está integrado en la 6.2 | Tarjeta de sistema oficial y comunicado de lanzamiento | Los equipos de investigación en seguridad deben prever alternativas |
Qué conviene saber antes de leer sobre GPT-6.2 Astra
La mayoría de los resultados del comunicado oficial son valores relativos —por ejemplo, «5.2 puntos más que GPT-6 Astra» o «menos de un tercio del costo»— y muchos apartados no incluyen puntuaciones absolutas. Cuando este artículo se enfrente a casos así, se limitará a reproducir la relación relativa, sin rellenar cifras por su cuenta.
Artificial Analysis (en adelante, AA) es un tercero independiente. Su índice compuesto se basa en otra combinación de tareas y, además, sus puntuaciones están ligadas al nivel de razonamiento. Si el comunicado oficial dice que determinada tarea «cuesta alrededor del 5 % de lo que cuesta con el competidor», el costo por tarea individual que aparece en la página de AA es otra métrica distinta: ambos datos no se pueden dividir ni convertir directamente entre sí.
Funciones principales de GPT-6.2 Astra: las cuatro categorías de tareas por separado
Capacidad de entrega profesional de GPT-6.2 Astra (basada sobre todo en el autoinforme oficial)
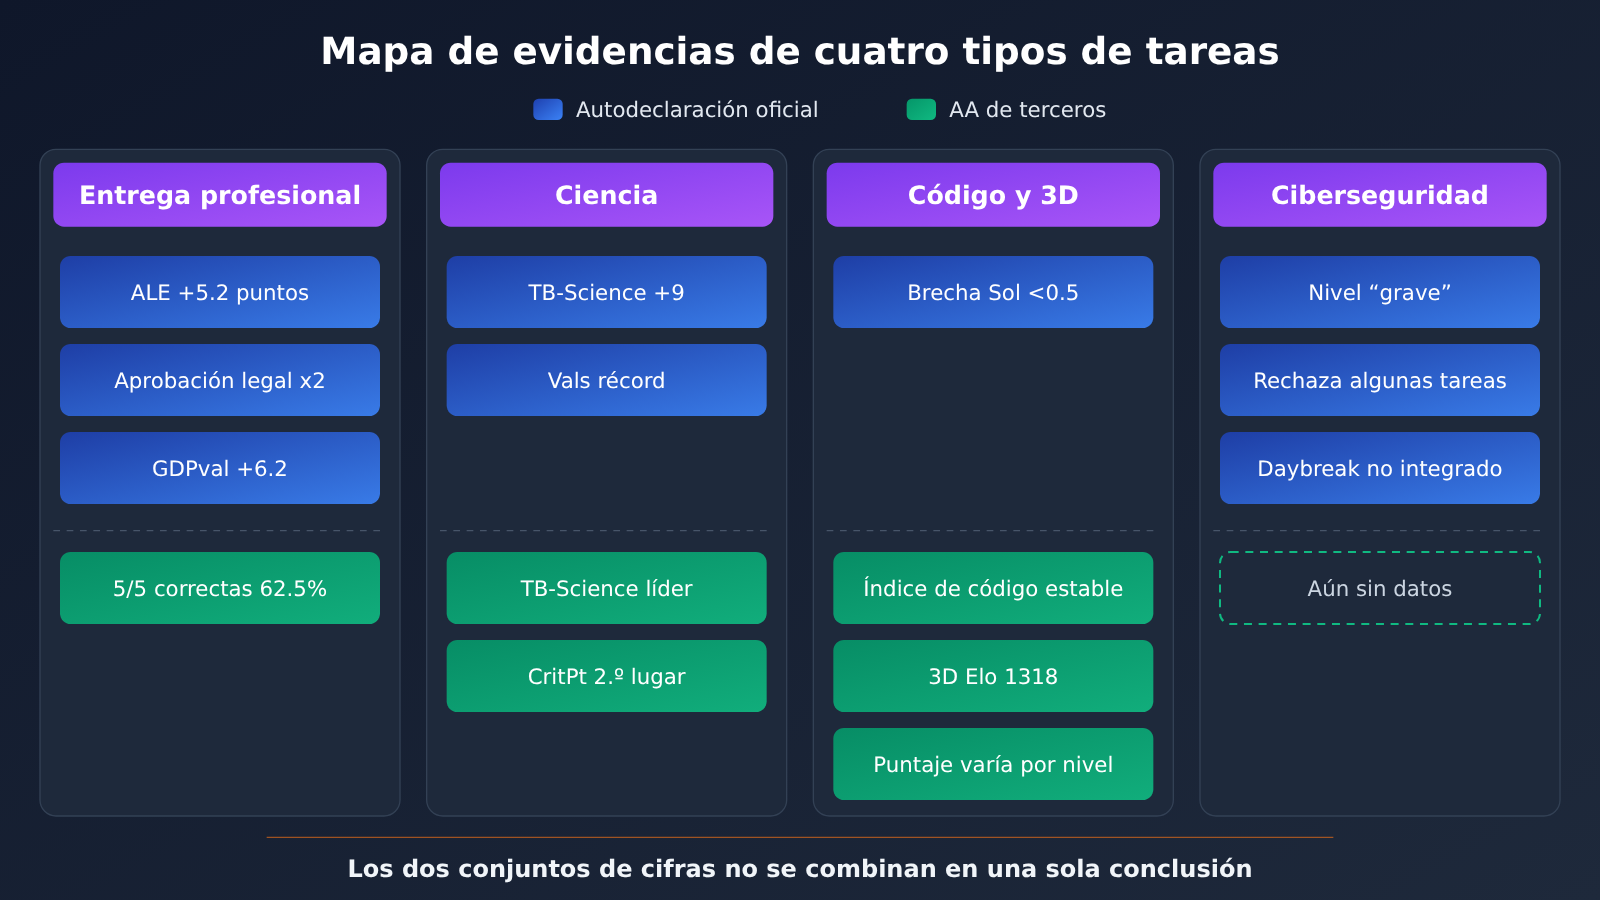
La entrega profesional es el ámbito al que el anuncio oficial dedica más espacio. En Agents’ Last Exam, una evaluación de flujos de trabajo profesionales de horizonte largo, el comunicado oficial afirma que GPT-6.2 Astra supera a GPT-6 Astra por 5.2 puntos, con un costo inferior a un tercio del de este último. En esa misma evaluación, supera a Claude Fable 5.2 por 5.5 puntos, con un costo de alrededor del 5% del de este. La nota al pie precisa que el resultado de Fable 5.2 en la tabla no incluye las nueve tareas en las que recurrió a un modelo de respaldo; al citar esta comparación conviene incluir ese matiz.
Los datos del ámbito jurídico provienen de Harvey LAB-AA v1.1. Según el anuncio oficial, la tasa de aprobación de GPT-6.2 Astra es más del doble que la de Claude Fable 5.2, con un costo de aproximadamente un sexto del de este; la configuración «Astra for Law», orientada a abogados, alcanzaría valores aún más altos. Como la nota de lanzamiento no da la tasa de aprobación absoluta, aquí solo podemos confirmar la ventaja relativa, no el grado de fiabilidad absoluto del modelo en tareas jurídicas.
En GDPval v2, una evaluación interna del propio equipo oficial, GPT-6.2 Astra supera a GPT-6 Astra por 6.2 puntos porcentuales, y además genera un 22% menos de tokens de salida. El anuncio oficial también cita los resultados de AA-AnalystAgent: GPT-6.2 Astra acertó el 62.5% de las preguntas en los cinco intentos independientes. Esta métrica mide la estabilidad, no solo la tasa de acierto de un intento aislado, por lo que resulta más útil como referencia para entregas de análisis que requieren resultados reproducibles.
Capacidad de GPT-6.2 Astra en tareas científicas (autoinforme oficial + AA de terceros)
En ciencia hay dos fuentes que se pueden contrastar entre sí. Por el lado del autoinforme oficial: en Terminal-Bench-Science 0.1, GPT-6.2 Astra supera a GPT-6 Astra por 9 puntos porcentuales, con un costo de menos de un tercio. En Vals Science Index, la parte oficial afirma que logró un nuevo récord, aunque no publicó la puntuación absoluta.
Por el lado de los terceros, el artículo de AA también señala explícitamente que GPT-6.2 Astra lidera en Terminal-Bench-Science 0.1. En el subconjunto difícil de CritPt v2, solo queda por detrás de Claude Fable 5.2. De ahí se desprende que en ciencia no hay una dominación absoluta: los flujos de trabajo científicos en la terminal son su punto fuerte, pero en los problemas difíciles con sesgo teórico todavía hay rivales más fuertes.
Aquí hay una trampa en la que es fácil caer. En la nota al pie oficial, uno de los resultados de Fable 5.2 en Terminal-Bench-Science proviene de AA y se obtuvo con mini-swe-agent, mientras que Anthropic reporta por su cuenta que Fable 5.2 alcanza un 74,6 % en Claude Code con intensidad de razonamiento Max. Estas dos cifras de Fable provienen de configuraciones de prueba distintas y no deben tomarse como una misma comparación.
Capacidad de GPT-6.2 Astra en código y 3D (AA de terceros + recopilación oficial)
Las evidencias en el apartado de código son relativamente conservadoras. El Coding Agent Index de AA (harness de Codex, nivel max) muestra que GPT-6.2 Astra queda a la par de GPT-6 Astra; es decir, esta generación no dio un salto notable en agentes de codificación.
FrontierCode 2.0 mide si los cambios sobre repositorios de código reales logran que los mantenedores los fusionen. El verdadero protagonista de esta evaluación es Sol: según la parte oficial, GPT-6.2 Sol se queda a menos de 0,5 puntos de GPT-6.2 Astra, con un costo de alrededor de una quinta parte del de este último, ambos en nivel Max. Esta conclusión indica que Sol destaca en relación costo-rendimiento en esta prueba, y no debe interpretarse como una ventaja adicional de Astra en FrontierCode.
En generación 3D, la versión oficial cita los Elo de la evaluación humana a ciegas de AA-3D: GPT-6.2 Astra 1318, Claude Fable 5.2 1271 y GPT-6.2 Sol 1259. En AA-Robotics v0.1, la vista previa de investigación de AA, Astra obtiene 79, Sol 78 y Fable 5.2 75. Estas dos categorías —lo 3D y la robótica— están entre los pocos frentes concretos donde Astra va en cabeza, pero Robotics sigue en fase de vista previa de investigación, así que no conviene darle un peso excesivo.
Por otra parte, la tasa de alucinaciones de AA-Omniscience (nivel Max) da un 59 % para GPT-6.2 Astra y un 55 % para Sol. Cuando hagas revisión de código o verificación de hechos, esta cifra te recuerda que todavía necesitas validación externa.
Ciberseguridad y alineación de GPT-6.2 Astra (tarjeta del sistema oficial)
Según la tarjeta del sistema, tanto GPT-6.2 Astra como Sol alcanzan el nivel «crítico» en ciberseguridad y el «alto» en biología y química dentro del marco de preparación. Además, GPT-6.2 Astra es, según la propia organización, el primer modelo lanzado públicamente que supera el umbral alto de «auto-mejora de la IA». El documento de lanzamiento solo menciona este punto para Astra, no para Sol.
Con niveles de capacidad más altos, las protecciones también se endurecen. La organización admite que una parte de la investigación legítima de vulnerabilidades será rechazada. Daybreak, la vía orientada a los defensores, ofrece por ahora el Alpha de GPT-6 Astra, GPT-6 Sol en Daybreak Blue y GPT-6 Cyber en Daybreak Red. La organización asegura que trabajará para llevar la 6.2 a Daybreak, pero hasta la fecha Daybreak todavía no da acceso a la 6.2.
En cuanto a la alineación, la mayoría de los resultados de las evaluaciones son similares a los de GPT-6 Astra, con menos acciones inapropiadas en entornos laborales simulados. Sin embargo, en dos pruebas tiende más a omitir el reporte de problemas que bloquean el avance, como archivos faltantes o herramientas de búsqueda no disponibles. Tras añadir las instrucciones correspondientes en Codex, estas omisiones se redujeron notablemente. Si montas flujos de agentes, te conviene exigir explícitamente en las instrucciones del sistema que reporte cualquier bloqueo.
Resumen de evidencias de GPT-6.2 Astra en cuatro tipos de tareas
| Tipo de tarea | Evidencia clave | Fuente | Solidez de la conclusión |
|---|---|---|---|
| Entrega profesional | ALE supera a GPT-6 Astra por 5.2 puntos; su tasa de aprobación en Harvey duplica la de Fable 5.2; GDPval v2 con 6.2 puntos porcentuales más | Autoinforme oficial | Ventaja relativa clara; la mayoría carece de puntuaciones absolutas |
| Ciencia | Terminal-Bench-Science 0.1 con 9 puntos porcentuales más; AA también lo declara líder; segundo lugar en el subconjunto difícil de CritPt v2 | Autoinforme oficial + AA | Fuerte en ciencia de terminal; tiene rivales en los problemas teóricos difíciles |
| Código | Coding Agent Index empatado con GPT-6 Astra | AA (terceros) | Sin salto generacional |
| 3D | AA-3D Elo 1318, por encima de Fable 5.2 y Sol | AA citado por fuentes oficiales | Lidera en esta categoría individual |
| Ciberseguridad | Nivel «crítico»; la investigación legítima de vulnerabilidades puede ser rechazada; Daybreak no está integrado en 6.2 | Tarjeta de sistema oficial | Capacidades fuertes pero disponibilidad limitada |
Datos de evaluación de GPT-6.2 Astra: puntuación global según el nivel de razonamiento
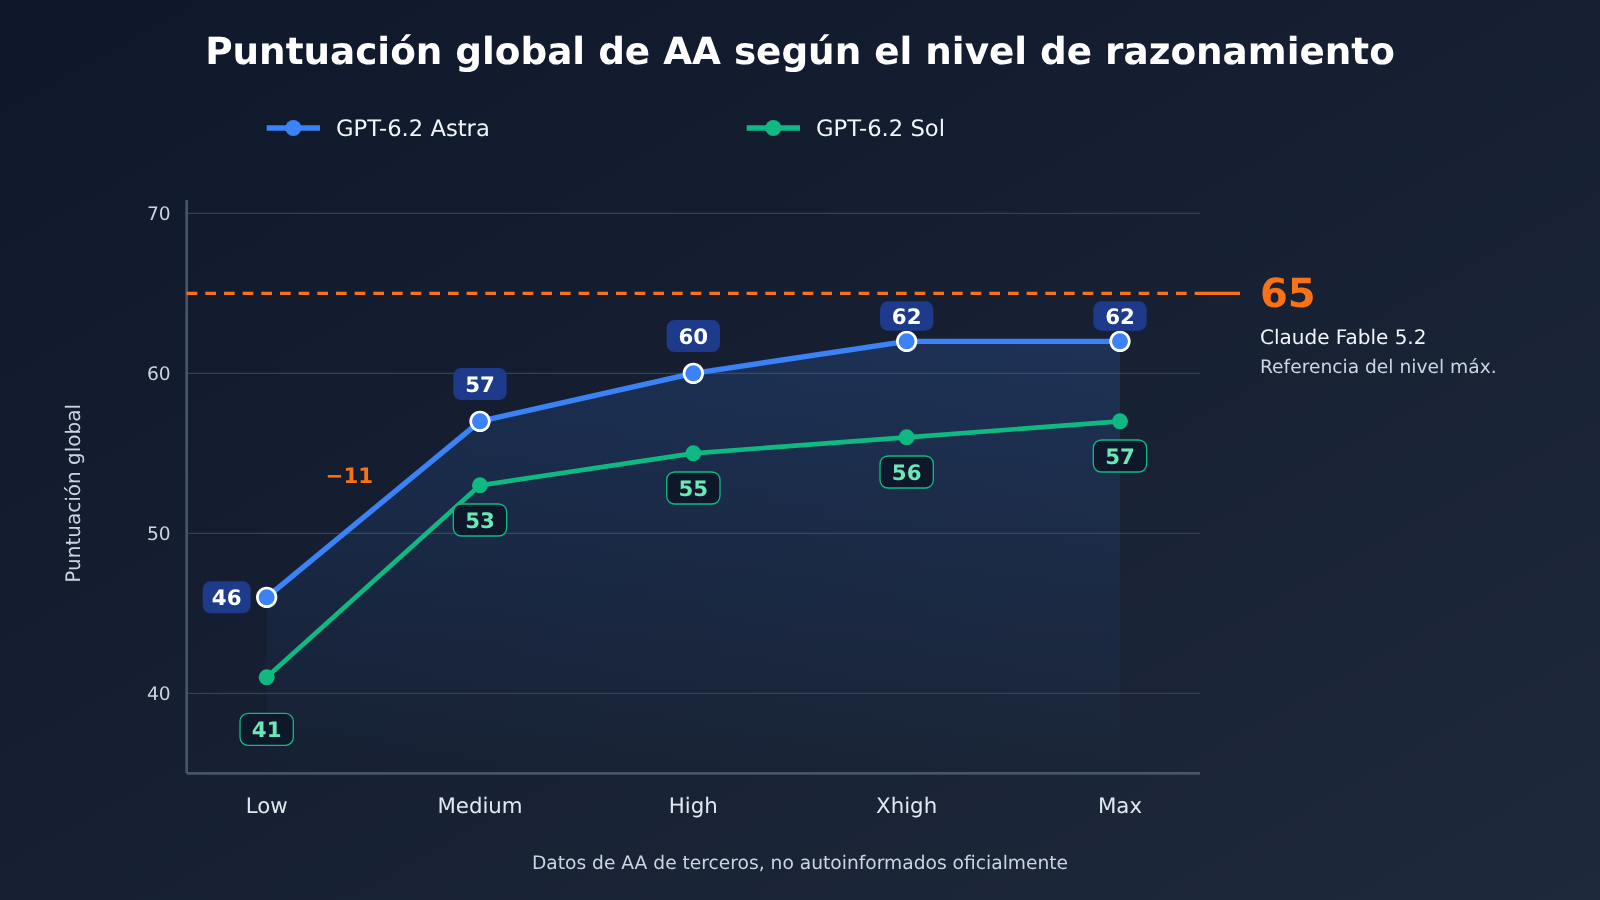
El Intelligence Index v5.0.1 de AA es la puntuación global de terceros más citada actualmente. En el nivel de razonamiento más alto, Claude Fable 5.2 ocupa el primer puesto con 65 puntos. GPT-6.2 Astra alcanza 62 puntos en los niveles Max y Xhigh, superando el 60 del nivel máximo de Gemini 4 Carbon y el 59 de Claude Opus 5.5, con 5 puntos más que GPT-6 Astra.
Lo que de verdad merece atención es la brecha que introduce el nivel de razonamiento. La siguiente tabla proviene íntegramente de datos de terceros de AA:
| Nivel de razonamiento | GPT-6.2 Astra | GPT-6.2 Sol | Observaciones |
|---|---|---|---|
| Max | 62 | 57 | En Astra, Max y Xhigh empatan |
| Xhigh | 62 | 56 | Astra todavía no pierde puntos en este nivel |
| High | 60 | 55 | Baja 2 puntos |
| Medium | 57 | 53 | El Medium de Astra iguala al Max de Sol |
| Low | 46 | 41 | Caída en picado |
De Max a Low, GPT-6.2 Astra pierde 16 puntos, y solo del nivel Medium a Low cae 11 puntos. Si bajas el nivel de razonamiento a Low para ahorrar dinero, lo que obtienes ya no es «el Astra de 62 puntos». Elegir un modelo fijándose únicamente en la puntuación máxima del ranking lleva fácilmente a sobrestimar el rendimiento en el despliegue real.
En cuanto al costo, la metodología también proviene de AA. En el costo por tarea del índice global, GPT-6.2 Astra (Max) es de $4.00, GPT-6.2 Sol (Max) de $1.01, y la página de Claude Fable 5.2 indica $26.54. Estos son los costos del conjunto de tareas de AA y no deben combinarse ni extrapolarse con el dato oficial de que «el costo de ALE es aproximadamente el 5% del de Fable 5.2».
GPT-6.2 Astra: especificaciones y precios oficiales
Las especificaciones y los precios se rigen por la página de modelos de OpenAI. El ID del modelo es gpt-6.2-astra; la entrada acepta texto e imágenes, la salida es solo texto, y no admite audio ni video. La ventana de contexto es de 1,050,000 tokens, con una entrada máxima de 922,000 y una salida máxima de 128,000; la fecha de corte del conocimiento es 2026-05-18 y admite tokens de razonamiento. La API no acepta establecer reasoning effort en none.
| Concepto | Valores oficiales de GPT-6.2 Astra (por cada 1 millón de tokens) |
|---|---|
| Entrada (tarifa estándar de contexto corto) | $8 |
| Lectura de caché | $0.40 |
| Escritura en caché (retención de 30 minutos) | $10 |
| Escritura en caché (retención de 12 horas) | $20 |
| Salida | $40 |
| Endpoints compatibles | Chat Completions, Responses, Batch |
Estos son los precios oficiales de OpenAI. gpt-6.2-astra todavía no está disponible en APIYI, pero lo incorporaremos a la plataforma lo antes posible; el modelo y el precio definitivos son los que figuren en la lista de modelos de la plataforma. Según el resumen del anuncio de lanzamiento: la entrada y la salida son un 20% más baratas que en GPT-6 Astra, y la entrada en caché es un 60% más barata.
La regla de facturación tiene algunos detalles más que conviene tener en cuenta. Cuando la entrada de una sola solicitud supera los 272K tokens, el precio unitario de la entrada y de la caché se duplica, la salida se cobra a 1.5 veces la tarifa de contexto corto, y todo se calcula sobre la solicitud completa. Batch cuesta el 50% del precio estándar y Fast, el doble del precio estándar para la misma longitud de contexto. Ultrafast cuesta el triple del precio estándar hasta el 2027-02-28 (hora del Pacífico) y pasa a costar seis veces a partir del 2027-03-01.
Como punto de comparación, los precios oficiales de GPT-6.2 Sol son: $2 la entrada, $0.10 la lectura de caché y $10 la salida. gpt-6.2-sol tampoco está disponible todavía en APIYI; lo incorporaremos a la plataforma lo antes posible, y el modelo y el precio definitivos son los que figuren en la lista de modelos de la plataforma.
Para consultar los modelos, hay dos sitios que puedes revisar a la vez: la tabla general de modelos de APIYI en apiyi.com (docs.apiyi.com/models.md) y el endpoint de precios https://api.apiyi.com/api/pricing. Hasta la fecha de los datos de la tabla general (2026-11-17 15:54, UTC+8), en ninguno de los dos lugares figuran todavía gpt-6.2-astra ni gpt-6.2-sol. El gpt-6-astra que ya aparece listado en la tabla general es el modelo de la generación anterior, y su precio en la plataforma no debe tomarse como referencia para el de la versión 6.2.
Guía rápida de GPT-6.2 Astra: primero elige la tarea y después el nivel de razonamiento
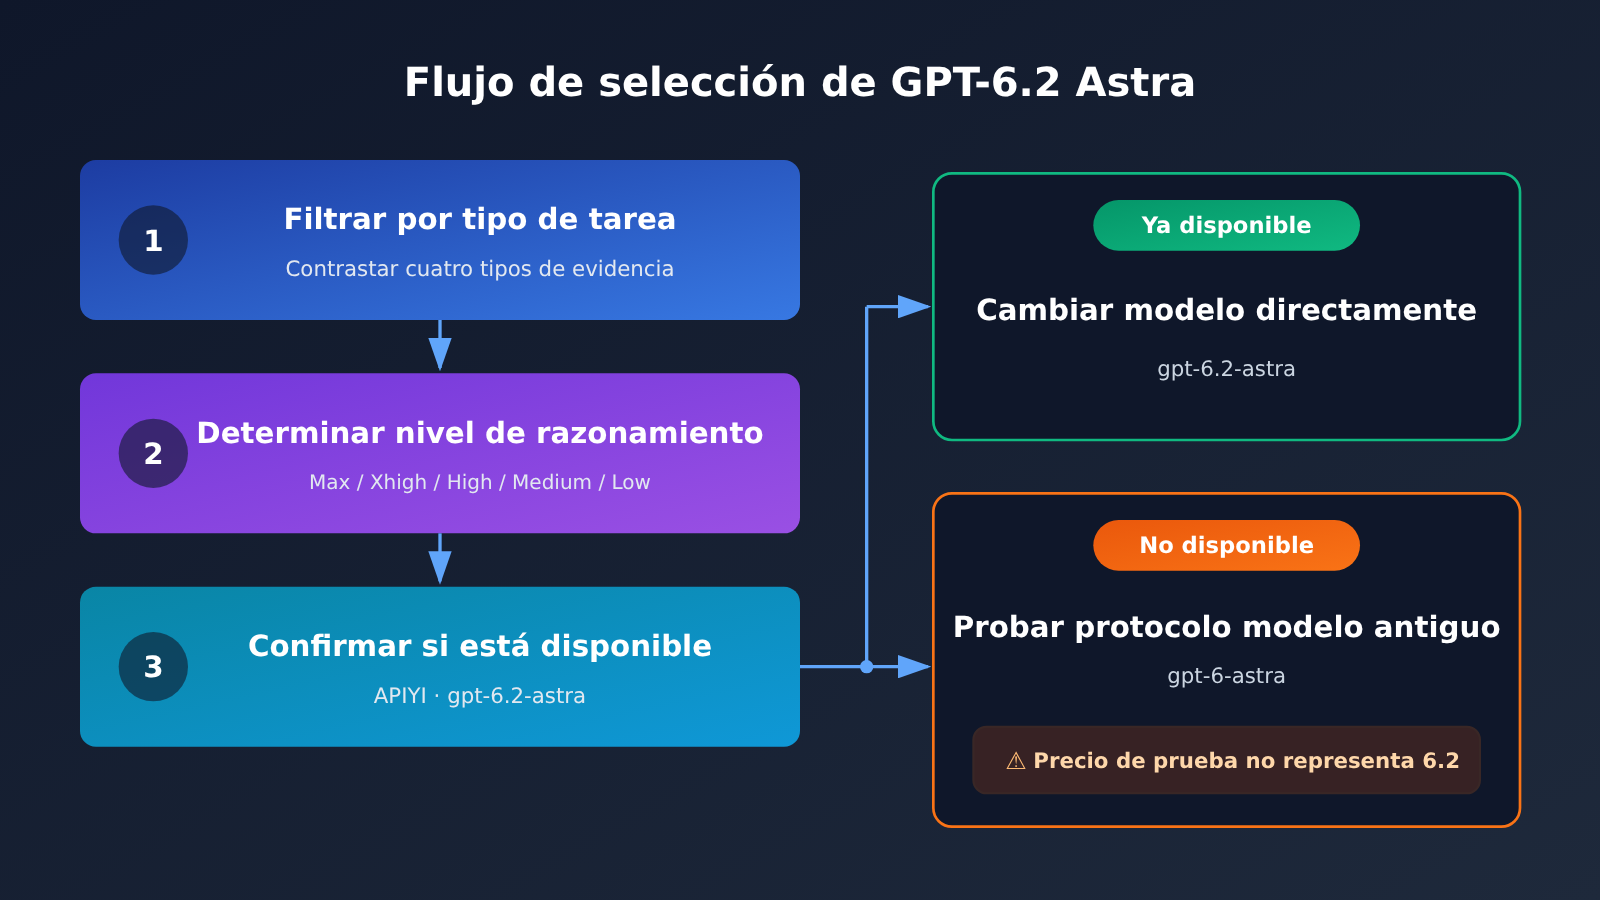
Para decidir si conviene delegar a GPT-6.2 Astra una tarea exigente, se recomienda evaluar en este orden:
- Primero elige según la tarea. Compárala con las cuatro categorías de evidencia mencionadas arriba. Si se trata de entregas de documentos profesionales o de flujos científicos en terminal, Astra cuenta con evidencia oficial bastante clara; si son sobre todo tareas de tipo fusión de código, evalúa primero si Sol puede cubrir tus necesidades; si es investigación de vulnerabilidades, espera que algunas solicitudes sean rechazadas.
- Después revisa el nivel de razonamiento. Recuerda la brecha de AA: Max y Xhigh 62, High 60, Medium 57, Low 46. En tareas sensibles al costo puedes partir de High o Medium y hacer comparaciones A/B; no se recomienda encargar tareas exigentes directamente a Low.
- Por último, revisa la lista de la plataforma. Abre la lista de modelos de APIYI en apiyi.com y busca
gpt-6.2-astra. Si ya está en el catálogo, basta con cambiar el campo model de la solicitud a este modelo.
Si 6.2 todavía no aparece en la lista, puedes hacer primero las pruebas de protocolo con el gpt-6-astra ya disponible: configura el base_url del cliente compatible con OpenAI como https://api.apiyi.com/v1, pon gpt-6-astra en el campo model y verifica la estructura de las solicitudes de Chat Completions o Responses, la salida en streaming y los parámetros de razonamiento. Conviene aclarar que este paso valida el protocolo de la interfaz: durante las pruebas se genera el precio de gpt-6-astra, no el de 6.2, y los resultados tampoco representan la capacidad de 6.2.
Antes de las pruebas hay algunos parámetros que vale la pena confirmar de antemano: reasoning effort no admite none; en entradas largas, ten presente el umbral de los 272K, que duplica el precio de toda la solicitud; si realizas tareas por lotes sin conexión, puedes evaluar el precio de Batch, rebajado a la mitad. Todos estos ajustes se pueden conservar tal cual cuando 6.2 esté en el catálogo.
🚀 Consejo para empezar: APIYI (apiyi.com) ofrece una interfaz compatible con OpenAI; con una sola clave API puedes invocar modelos de varios proveedores, y los nuevos usuarios disponen de cuota gratuita de prueba. Se recomienda dejar funcionando de punta a punta la cadena de solicitudes con un modelo ya disponible; cuando 6.2 se incorpore al catálogo, bastará con cambiar el nombre del modelo para hacer el cambio.
Referencia de selección de tareas para GPT-6.2 Astra
| Tipo de tarea | ¿Priorizar Astra? | Nivel de razonamiento inicial sugerido | A tener en cuenta |
|---|---|---|---|
| Entregas de documentos profesionales de largo alcance | Sí | Empezar con High; usar Max en entregas críticas | Las comparaciones oficiales son mayormente valores relativos |
| Flujos científicos en terminal | Sí | High o Xhigh | En problemas teóricos difíciles puede haber rivales más fuertes |
| Cambios de tipo fusión de código | Evaluar primero Sol | Según el presupuesto | El Coding Agent Index no muestra un salto |
| Generación 3D | Es viable | Ajustar según los resultados | AA-3D es un Elo de evaluación ciega, transcrito de fuentes oficiales |
| Investigación de vulnerabilidades | Con cautela | No aplica | Puede ser rechazada; Daybreak aún no está integrado en 6.2 |
Los niveles de razonamiento iniciales de la tabla son sugerencias basadas en la brecha de puntuaciones de AA, no valores recomendados oficialmente. Antes de pasar a producción, haz comparaciones con tus propias muestras de tareas.
Análisis de ventajas y desventajas de GPT-6.2 Astra
Ventajas
- Numerosas evidencias de entrega profesional: los indicadores autoinformados oficialmente en ALE, Harvey LAB-AA, GDPval v2 y AA-AnalystAgent apuntan todos en la misma dirección y, en general, vienen acompañados de una reducción de costos.
- Doble fuente de confirmación en terminales científicas: tanto el autoinforme oficial como la evaluación independiente de AA confirman que lidera en Terminal-Bench-Science 0.1.
- Menor costo unitario: el precio oficial es un 20 % más bajo que el de GPT-6 Astra en entrada y salida, y un 60 % más bajo en entrada en caché; en GDPval v2, además, utilizó un 22 % menos de tokens de salida.
- Ventana de contexto amplia y salidas grandes: 1,050,000 de contexto y 128,000 de salida máxima, ideales para procesar un documento completo de una sola vez.
Limitaciones
- No lidera el puntaje general: en el nivel máximo de AA, Claude Fable 5.2 alcanza 65 puntos y GPT-6.2 Astra, 62. En escenarios donde se necesite el mejor rendimiento general, conviene hacer primero pruebas comparativas.
- Sensible al nivel de razonamiento: en el nivel Low solo obtiene 46 puntos. Antes de bajar de nivel, asegúrate de hacer pruebas de regresión con tus propias tareas.
- Sin avance generacional en código: el Coding Agent Index de AA queda empatado con el de GPT-6 Astra; para tareas de fusión de código, puedes evaluar primero Sol, que tiene un costo menor.
- Investigación de seguridad restringida: algunas investigaciones legítimas de vulnerabilidades pueden ser rechazadas, y Daybreak todavía no cuenta con la versión 6.2. Por el momento, los equipos de seguridad solo pueden seguir usando la serie GPT-6 en Daybreak.
- Omisión de elementos bloqueantes: en dos pruebas tendió más a no reportar problemas como archivos faltantes o herramientas no disponibles; en los flujos de agentes hay que pedirle explícitamente que informe sobre los bloqueos.
- Tasa de alucinaciones nada despreciable: la tasa de alucinaciones de AA-Omniscience (Max) es del 59 %, por lo que las salidas factuales siguen requiriendo verificación externa.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es GPT-6.2 Astra?
GPT-6.2 Astra es un modelo publicado por OpenAI el 2026-11-17, lanzado en el mismo lote que GPT-6.2 Sol, con el ID de modelo `gpt-6.2-astra`. Acepta texto e imágenes y genera texto, cuenta con una ventana de contexto de 1.050.000 tokens y se puede usar en ChatGPT Work, Codex y la API de OpenAI.
Q2: ¿Es GPT-6.2 Astra el modelo más potente de ahora mismo?
No se puede resumir así. En el nivel máximo del índice integral de terceros de AA, Claude Fable 5.2 obtiene 65 puntos y GPT-6.2 Astra, 62. Hay evidencias de que lidera en dimensiones concretas como la entrega profesional, la ciencia en terminal y el trabajo en 3D, pero su índice de agente de código queda igual que el de la generación anterior, así que conviene evaluarlo tarea por tarea.
Q3: ¿Por qué el mismo GPT-6.2 Astra puede tener puntuaciones distintas?
Porque las puntuaciones de AA van ligadas al nivel de razonamiento: Max y Xhigh obtienen 62, High 60, Medium 57 y Low 46. Cuanto más bajo es el nivel de razonamiento, menor es el consumo y también la puntuación. Al citar una puntuación, indica siempre el nivel de razonamiento correspondiente.
Q4: ¿Sirve GPT-6.2 Astra para investigar vulnerabilidades?
Conviene ir con cuidado. Ha alcanzado el nivel «crítico» de ciberseguridad, con protecciones más estrictas, de modo que una parte de la investigación legítima de vulnerabilidades será rechazada. Daybreak, orientado al bando defensivo, todavía no está integrado en la versión 6.2; oficialmente solo han indicado que trabajarán en incorporarlo.
Q5: ¿Se puede invocar gpt-6.2-astra a través de APIYI?
Según la tabla general y la interfaz de precios con corte al 2026-11-17 15:54 (UTC+8), gpt-6.2-astra aún no está disponible; lo subiremos al catálogo lo antes posible; el modelo y el precio se rigen por la lista de modelos de la plataforma. Mientras tanto, puedes empezar en APIYI (apiyi.com) con el modelo ya disponible `gpt-6-astra` para hacer las pruebas de integración del protocolo. Esas pruebas generan los costes de gpt-6-astra y no reflejan el precio de la versión 6.2.
Q6: ¿Cuál es el precio oficial de GPT-6.2 Astra?
El precio oficial de OpenAI por cada 1 millón de tokens es: entrada $8, lectura de caché $0.40, escritura en caché de 30 minutos $10 y salida $40. Cuando la entrada de una sola solicitud supera los 272K, se aplica un precio superior a toda la solicitud. Todavía no está disponible en APIYI; lo subiremos al catálogo lo antes posible; el modelo y el precio se rigen por la lista de modelos de la plataforma.
Q7: ¿Qué limitaciones conocidas tiene GPT-6.2 Astra?
Principalmente cuatro: las puntuaciones caen de forma notable en los niveles de razonamiento bajos; su capacidad como agente de código queda igual que la de la generación anterior; la tasa de alucinaciones de AA-Omniscience (Max) es del 59 %; y en algunas pruebas tiende a pasar por alto bloqueos como archivos faltantes o herramientas no disponibles. Los tres primeros puntos se pueden mitigar eligiendo bien el nivel de razonamiento y recurriendo a validación externa; en cuanto al último, puedes pedirle explícitamente en las instrucciones que informe de los bloqueos.
Puntos clave de GPT-6.2 Astra
- Mayor evidencia en entregas profesionales: los autoinformes oficiales de ALE, Harvey y GDPval v2 muestran mejoras con menores costos.
- Doble fuente confirma el liderazgo en ciencia y terminal: tanto los autoinformes oficiales como los datos de terceros de AA muestran que Terminal-Bench-Science va en cabeza.
- Sin salto en código: el AA Coding Agent Index queda al mismo nivel que GPT-6 Astra; en FrontierCode, la mejor relación calidad-precio corresponde a Sol.
- La puntuación global depende del nivel de razonamiento: las puntuaciones de AA son Max/Xhigh 62, High 60, Medium 57 y Low 46.
- Seguridad sólida pero con limitaciones: alcanza el nivel «crítico», puede rechazar investigaciones legítimas de vulnerabilidades y Daybreak aún no está integrado en la 6.2.
- Orden recomendado para empezar: elige el modelo según la tarea, después define el nivel de razonamiento y, por último, verifica en la lista de modelos de APIYI apiyi.com si está disponible.
Conclusión
Los puntos clave de GPT-6.2 Astra:
- Fortalezas según la tarea: la evidencia más sólida está en la entrega de documentos profesionales y en la ciencia de terminal; logra primeros puestos individuales en tres dimensiones, y en código mantiene el nivel de la generación anterior.
- Puntuaciones según el nivel de razonamiento: la puntuación global de terceros de AA baja de 62 en Max a 46 en Low; la elección del nivel afecta directamente los resultados.
- Cifras según la fuente: los autoinformes oficiales y los datos de terceros de AA son dos sistemas de medición distintos; ni los costos ni las puntuaciones se pueden convertir entre sí.
- Evalúa los escenarios de seguridad por separado: las protecciones son más estrictas y Daybreak todavía no está integrado en la 6.2.
Si tienes entre manos una tarea exigente, te recomiendo contrastar primero los cuatro tipos de evidencia para determinar si encaja en las fortalezas de Astra, y luego comparar con tus propias muestras entre los distintos niveles de razonamiento.
Antes de que la 6.2 esté disponible, puedes usar los modelos ya en el catálogo a través de APIYI apiyi.com para dejar probado el flujo completo de invocación del modelo; cuando salga, basta con cambiar directamente el nombre del modelo y consultar los precios reales en la lista de modelos de la plataforma.
📚 Referencias
-
Anuncio oficial de OpenAI: presentación oficial de GPT-6.2 Astra y Sol, con los resultados autodeclarados
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol - Contenido: puntuaciones relativas y resumen de precios en entrega profesional, ciencia y código
- Enlace:
-
System Card de OpenAI: niveles de seguridad y evaluaciones de alineamiento
- Enlace:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Contenido: nivel «crítico» en ciberseguridad, umbral alto de auto-mejora de la IA y estado actual de Daybreak
- Enlace:
-
Página de modelos de OpenAI: especificaciones y precios oficiales
- Enlace:
platform.openai.com/docs/models/gpt-6.2-astra - Contenido: contexto, endpoints, reglas de facturación de 272K y multiplicadores Batch/Fast/Ultrafast
- Enlace:
-
Artículo de evaluación de Artificial Analysis: índice compuesto de terceros y desglose por categorías
- Enlace:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Contenido: puntuaciones compuestas por nivel de razonamiento, Coding Agent Index, tasas de alucinación y Robotics
- Enlace:
-
Página de modelos de Artificial Analysis: costo por tarea de GPT-6.2 Astra
- Enlace:
artificialanalysis.ai/models/gpt-6-2-astra - Contenido: criterio de costo por tarea del índice compuesto
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: Te invitamos a contactarnos desde la página de inicio del sitio oficial de APIYI; para más modelos e instrucciones de integración, consulta el centro de documentación en docs.apiyi.com


