
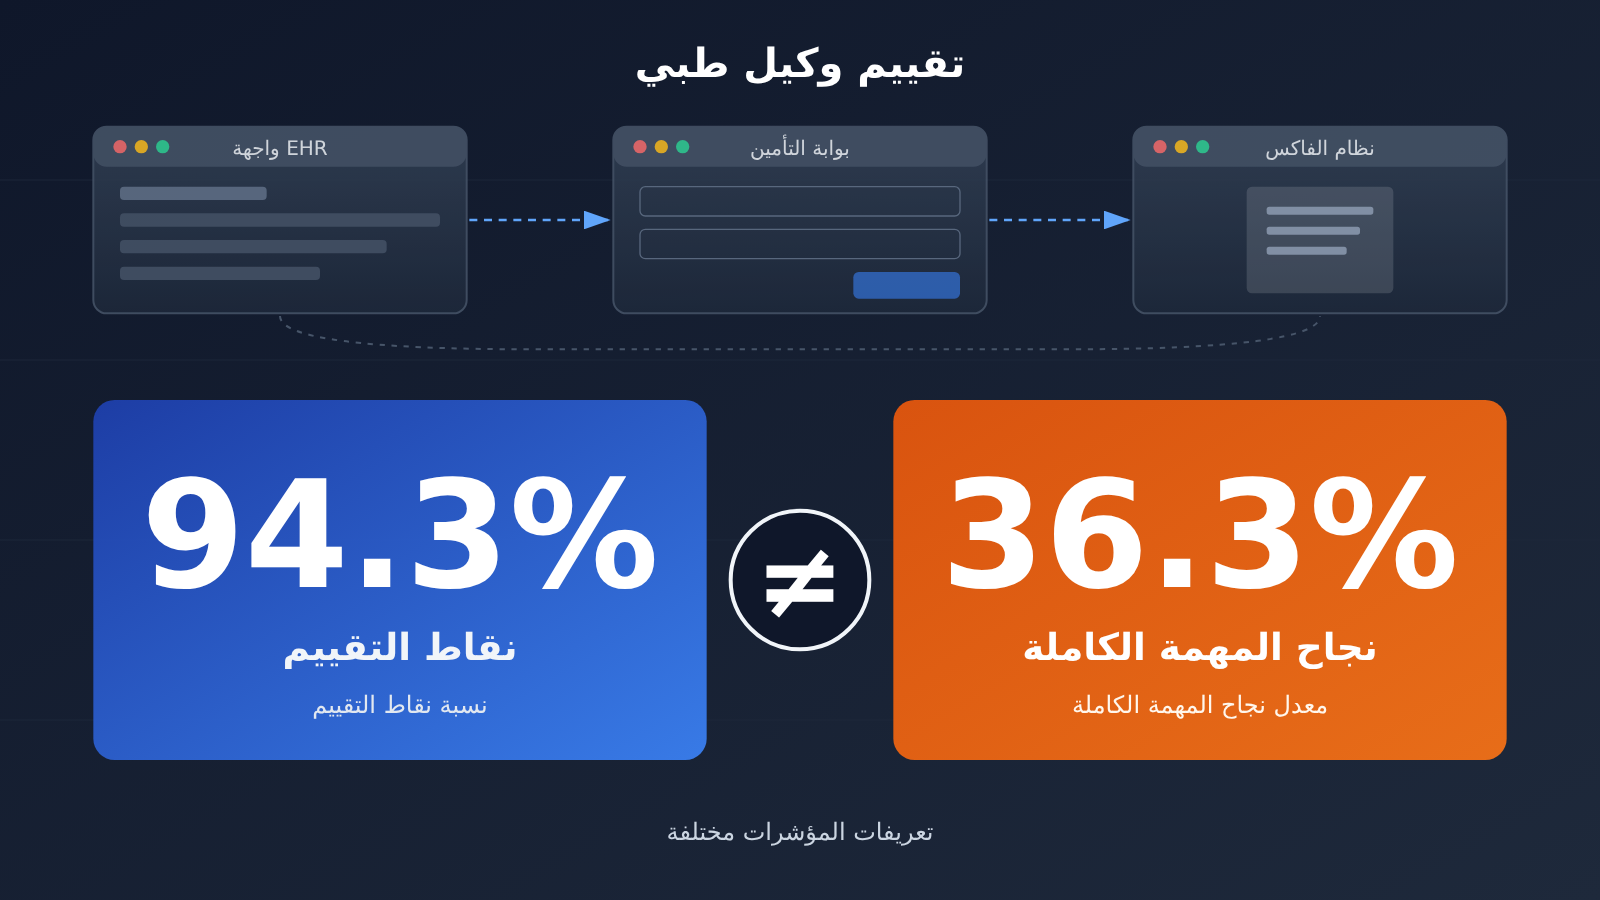
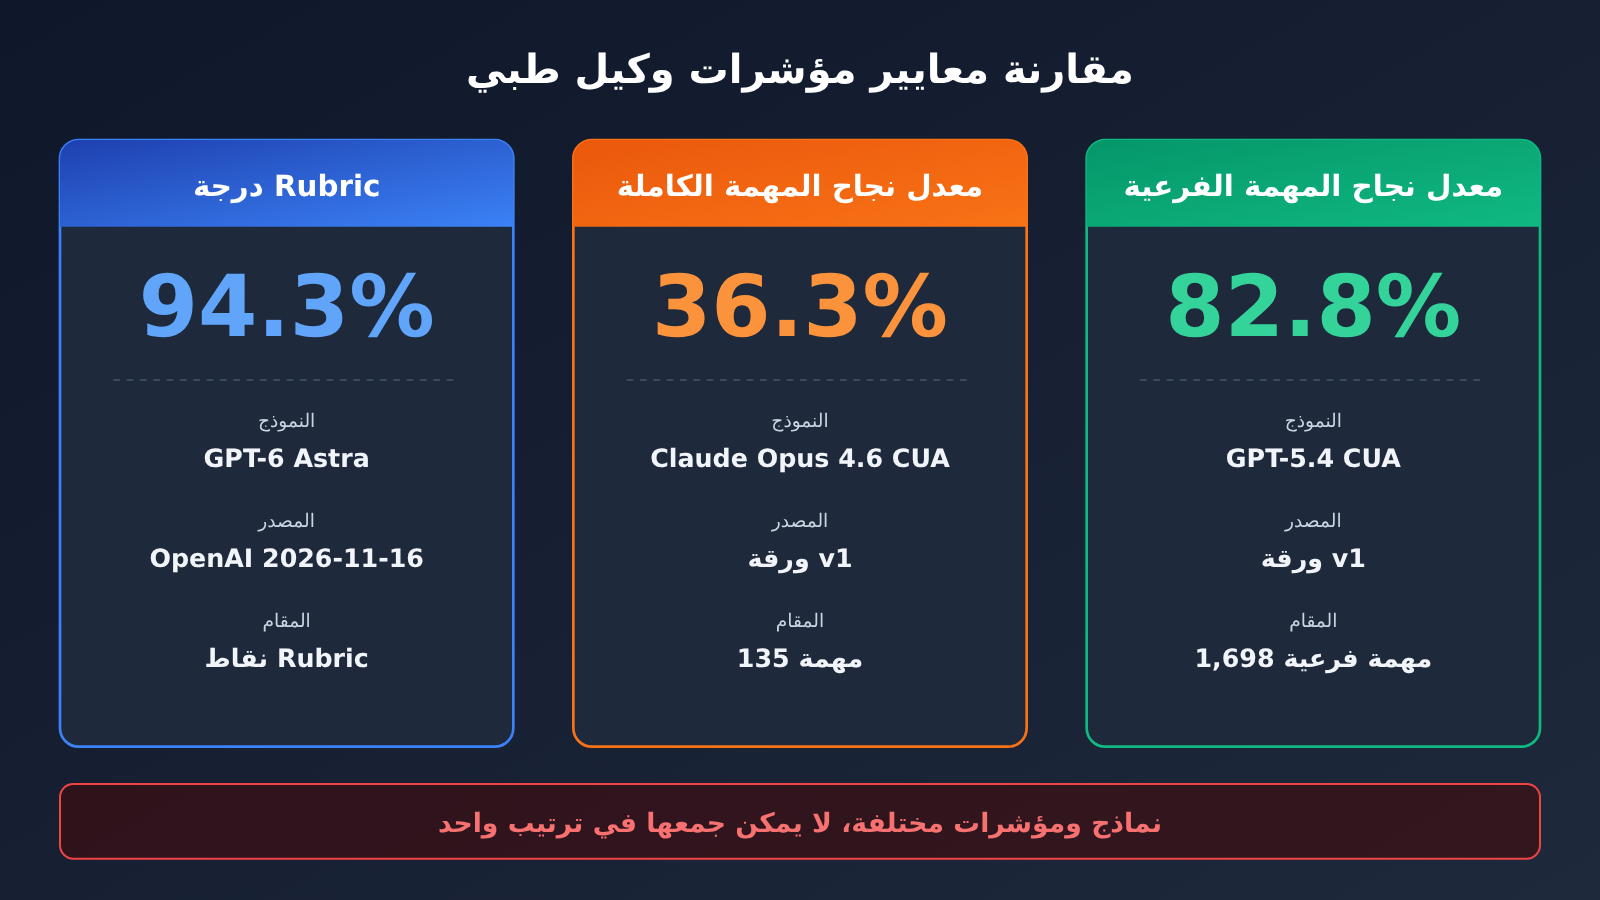
94.3% لا تعني أن 94.3% من المهام الإدارية الطبية قد أُنجزت بالكامل. نسبة 94.3% التي أعلنتها OpenAI في 16 نوفمبر 2026 للنموذج GPT-6 Astra هي نسبة نقاط التقييم (rubric points) التي حصل عليها في HealthAdminBench؛ أما نسبة 36.3% الخاصة بـ Claude Opus 4.6 CUA في ورقة Shah Lab بجامعة ستانفورد، فهي معدل نجاح المهمة الكامل (full-task success). الأولى تقيس «كم عدد نقاط التقييم التي تم تحقيقها»، والثانية تقيس «كم عدد المهام التي تحقق فيها جميع شروط النجاح»، وهما ليسا المؤشر نفسه، ولا يمكن وضعهما في لوحة الترتيب نفسها.
قد يقدم الوكيل الطبي أداءً جيدًا في عمليات منفردة مثل استرجاع المعلومات ومعالجة المستندات وتعبئة النماذج، ومع ذلك يظل غير قادر على إكمال سير عمل واحد عبر الأنظمة بشكل مستقر. ولتحديد ما إذا كان الوكيل يمتلك قيمة إنتاجية، يجب النظر في الوقت نفسه إلى أداء المهام الفرعية، ومعدل النجاح من البداية إلى النهاية، وأنواع الأخطاء، وتكلفة التنفيذ، وحجم التدخل البشري؛ فلا يكفي أي رقم منفرد.
ماذا ستتعلم بعد قراءة هذا المقال؟
- ما الذي تقيسه كل من نسبة 94.3% ونسبة 36.3% على حدة، ولماذا لا يمكن مقارنتهما مباشرة
- تكوين مهام HealthAdminBench، ومصادر نقاط التقييم، وآليتي التحقق
- مجموعة أبعاد تقييم موجهة إلى بيئة الإنتاج وقابلة للتطبيق على وكلاء المؤسسات الآخرين
المحتويات: يعرض جزء الحقائق الموضوعية، بالترتيب، لماذا أثارت نتيجة 94.3% الانتباه، وما الذي يقيسه HealthAdminBench فعليًا، والفرق بين نجاح المهمة الفرعية ونجاح المهمة الكامل، وأكثر المراحل التي يفشل فيها الوكيل الطبي، ولماذا قد يختلف أداء النموذج نفسه باختلاف إطار التنفيذ؛ أما جزء التحليل والحكم فيناقش كيفية بناء إطار تقييم شامل، وكيفية حساب التكلفة، وكيف ينبغي للشركات أن توازن بين الخيارات عند التطبيق.
ما ينبغي معرفته: 7 مفاهيم لفهم تقييم وكلاء الذكاء الاصطناعي الطبيين
| المفهوم | شرح مختصر |
|---|---|
| Computer Use | القدرة على إنجاز المهام من خلال مراقبة واجهة البرنامج ومحاكاة النقر والكتابة والتمرير وغيرها من العمليات |
| EHR | نظام السجلات الصحية الإلكترونية، وهو البرنامج الأساسي الذي تستخدمه المستشفيات لتخزين معلومات المرضى وتشخيصهم وعلاجهم |
| MCP | بروتوكول معياري لاكتشاف الأدوات الخارجية واستدعائها |
| RPA | طريقة أتمتة تنفّذ العمليات المتكررة عبر قواعد أو نصوص برمجية مُعدّة مسبقًا |
| Rubric points | نقاط التقييم الممنوحة وفق قواعد التقييم، وتُستخدم لقياس مدى استيفاء بعض المتطلبات |
| معدل النجاح من البداية إلى النهاية | نسبة المهام الكاملة التي تستوفي جميع شروط النجاح؛ وأي فشل في شرط حرج يعني اعتبار المهمة فاشلة |
| Trace | دليل تتبّع يسجّل عملية التنفيذ وإجراءات التشغيل وحالات الواجهة |
نظرة سريعة على تأثير تقييم وكلاء الذكاء الاصطناعي الطبيين
- المطورون والمسؤولون التقنيون: لا يكفي الاعتماد على درجة واحدة تنشرها الشركة المصنعة عند اختيار الحل؛ بل يجب التحقق، وفق المهام الخاصة بكل جهة، من آلية التنفيذ ومعدل الإنجاز من البداية إلى النهاية، والتكلفة الكاملة التي تشمل لقطات الشاشة وإعادة المحاولات وبيئة التشغيل.
- المؤسسات الصحية ومسؤولو سير العمل: يجب التمييز بين أربعة أنواع من الأدلة: العرض التوضيحي في بيئة اصطناعية، والتقييم المعياري، والتجربة التمهيدية داخل المؤسسة، وحالة الإنتاج. وعند النشر، ينبغي تطبيق الموافقة البشرية ومبدأ الامتياز الأدنى وتدقيق العمليات.
الحقائق الموضوعية: ما يكمن وراء 94.3% و36.3% في تقييم وكلاء الرعاية الصحية
لماذا لفتت نتيجة 94.3% الانتباه؟
في 16 نوفمبر 2026، نشرت OpenAI تحديثًا عن تقدم وكيل استخدام الحاسوب الموجّه لفرق الرعاية الصحية، وأعلنت معه عدة مجموعات من بيانات التقييم. من بينها أن GPT-6 Astra حصل على 94.3% في HealthAdminBench، بينما حصل GPT-6 Luna على 91.8%، وقد جرى تقييم كليهما عند أقصى جهد استدلالي (maximum reasoning effort). كما أعلنت OpenAI أن تكلفة المهمة الواحدة لدى Luna تبلغ 0.085 دولار، أي أقل بنسبة 98% من Astra.
تلفت هذه الأرقام الانتباه لأن نتائج HealthAdminBench التي نشرتها ستانفورد سابقًا كانت أقل بوضوح. وتجدر الإشارة إلى أن النسبتين 94.3% و91.8% التي نشرتها OpenAI هما نسب نقاط المعايير (rubric points)، وليسا معدل نجاح مستقلًا للمهام الكاملة. وهناك أيضًا مجموعتان أخريان من البيانات في الإعلان نفسه، تأتيان من مراحل تقييم مختلفة وبمقامات مختلفة:
| المقياس | القيمة | المقام/طريقة الاحتساب | ما لا يمثله |
|---|---|---|---|
| نتيجة HealthAdminBench (Astra) | 94.3% | نسبة نقاط المعايير (rubric points) | معدل نجاح المهام الكاملة |
| نتيجة HealthAdminBench (Luna) | 91.8% | نسبة نقاط المعايير (rubric points) | معدل نجاح المهام الكاملة |
| سلامة المهام السريرية (Astra) | 99% | 325 مهمة مُراجعة | دقة التشخيص الطبي |
| نسبة الموافقة العالية من الأطباء (Astra) | 93% | 646 تقييمًا من الأطباء | معدل نجاح المهام، ولا تعني 646 طبيبًا |
| تكلفة المهمة الواحدة لدى Luna | 0.085 دولار | تكلفة كل مهمة ضمن ظروف تقييم محددة | عرض سعر للنشر في بيئة الإنتاج |
هذه المجموعات الثلاث من البيانات لها مقامات مختلفة، ولا يمكن دمجها في “دقة شاملة” واحدة. إضافةً إلى ذلك، لم ينشر متن إعلان OpenAI النتائج لكل مهمة على حدة، ولا الإعداد التجريبي الكامل، ولا فترات الثقة، ولا جميع حالات الفشل؛ لذا لا يستطيع الخارجيون حاليًا مراجعة مكونات نتيجة 94.3% بشكل مستقل. وتكلفة المهمة الواحدة لدى Astra تبلغ نحو 4.25 دولار، وهي قيمة تقديرية مستنتجة من انخفاض بنسبة 98%، وليست سعرًا أعلنته الشركة رسميًا بشكل مباشر.
ما الذي يقيسه HealthAdminBench فعليًا؟
طُوّر HealthAdminBench في مختبر Shah بجامعة ستانفورد، وهو مخصص لتقييم أداء وكلاء تشغيل الحاسوب في المهام الإدارية الطبية. هناك اختلاف بين النسخة العامة المتاحة والنسخة البحثية: فصفحة البحث المبكرة تصف 70 مهمة و947 نقطة تقييم و6 وكلاء، بينما توسّعت نسخة الورقة البحثية 2604.09937v1 إلى 135 مهمة و1,698 مهمة فرعية قابلة للتحقق و7 إعدادات نماذج. يعتمد هذا المقال نسخة الورقة البحثية، وتُستخدم بيانات الصفحة المبكرة للمقارنة التاريخية فقط.
بيئات واجهة المستخدم الرسومية الأربع المحاكاة في نسخة الورقة البحثية هي: السجل الصحي الإلكتروني EHR، وبوابة الدفع التأميني A، وبوابة الدفع التأميني B، وبوابة الفاكس. وتنقسم المهام الـ135 إلى ثلاث فئات من سير العمل الإداري:
| نوع المهمة | العدد | المحتوى الرئيسي |
|---|---|---|
| Prior Authorization (التصريح المسبق) | 60 | التحقق من أهلية التأمين، وجمع السجلات الطبية، وتقديم طلب التصريح المسبق |
| Appeals and Denials Management (إدارة الطعون والرفض) | 60 | مراجعة حالات الرفض، وجمع الأدلة، وإعداد الطعن وتقديمه |
| DME Order Processing (معالجة طلبات المعدات الطبية) | 15 | جمع بيانات المعدات الطبية، وتقديم الطلب، وتسجيل النتائج |
تنتج نقاط التقييم الـ1,698 عن آليتين. فـ1,177 نقطة تعتمد على فحوص حتمية، تستخدم وسائل مُهيكلة مثل JMESPath للتحقق من حالة النظام، مثل: هل تم العثور على المريض الصحيح؟ هل تم ملء الحقول المحددة؟ هل تم إنشاء الطلب الصحيح؟ وهو نهج قريب من اختبار البرمجيات التقليدي. أما الـ521 نقطة المتبقية فتُترك لـ LLM Judge ليحكم عليها، وتقيّم أساسًا مدى كفاية محتوى المستندات، ومدى مطابقة المواد المقدمة للمتطلبات، وغيرها من الجوانب التي يصعب التحقق منها بال قواعد مباشرة.
تستخدم جميع المهام بيانات مرضى اصطناعية، وليس سجلات مرضى حقيقية. وهذا يعني أن المعيار يوفر بيئة اختبار قابلة للتكرار، وليس اختبارًا داخل أنظمة إنتاج مستشفيات حقيقية، كما أنه لا يقيس نتائج رعاية المرضى بشكل مباشر.
ما الفرق بين نجاح المهمة الفرعية ونجاح المهمة الكاملة؟
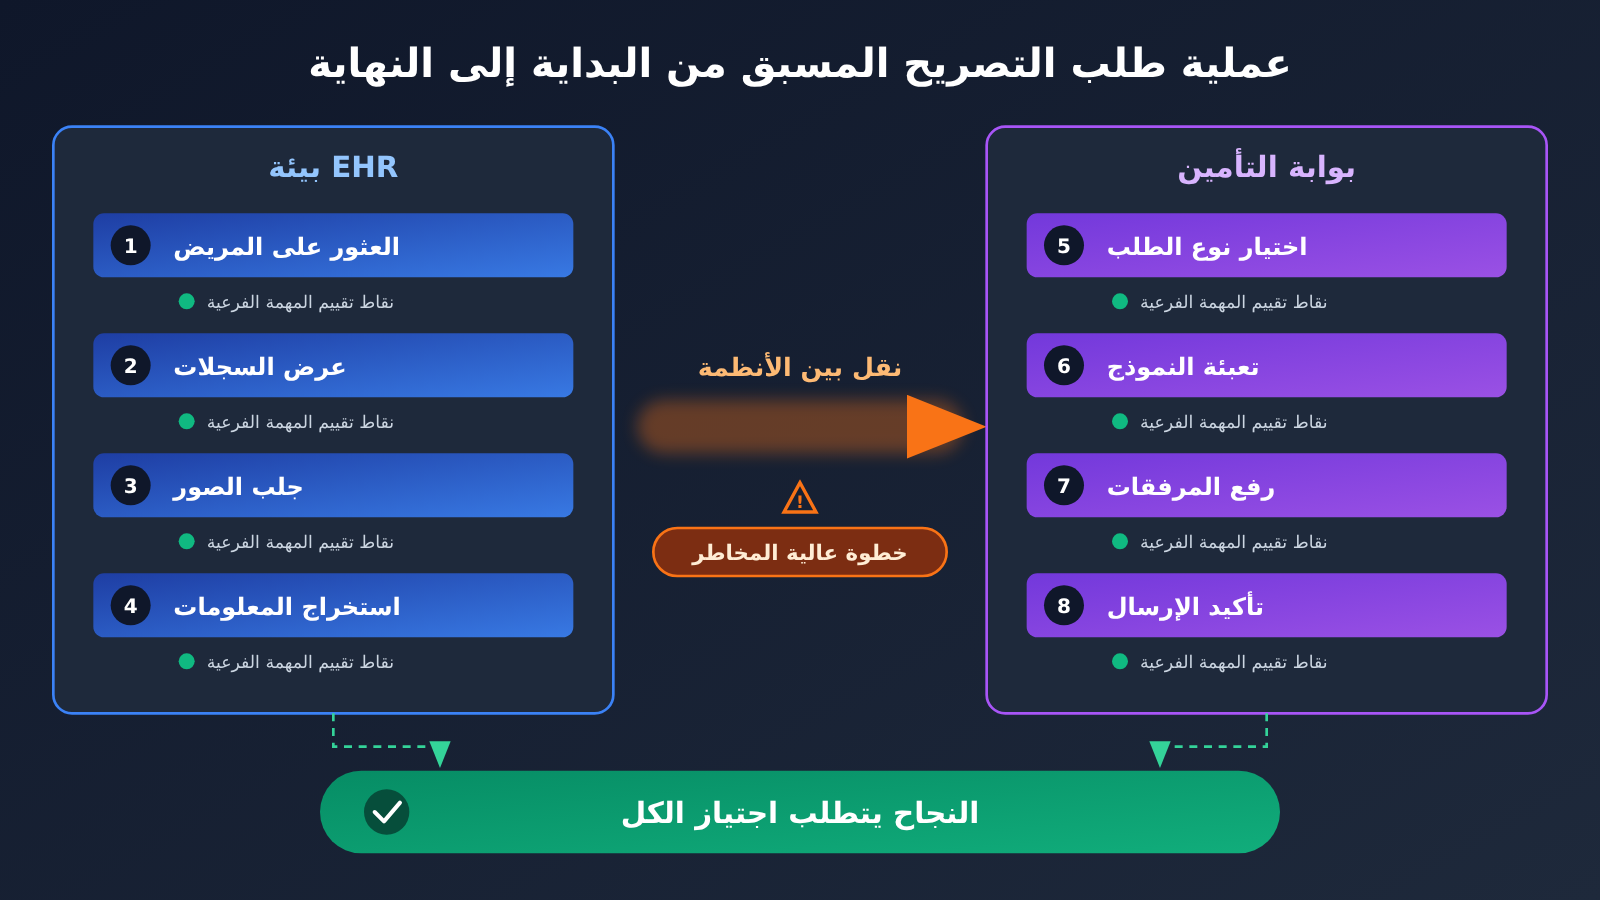
أسهل طريقة لرؤية الفرق بينهما هي عبر عملية طلب تفويض مسبق. ووفقًا لما تصفه مواد البحث، قد تتطلب مهمة التفويض المسبق من الوكيل إتمام الخطوات الآتية بالترتيب:
- العثور على المريض الصحيح في EHR
- مراجعة السجل العلاجي للمريض
- العثور على مواد التصوير والعلاجات السابقة
- تحديد الأدلة المطلوبة لطلب التأمين
- استخراج المعلومات المطلوبة من السجل الطبي
- الدخول إلى بوابة دفع التأمين
- اختيار نوع الطلب الصحيح
- ملء نموذج الطلب
- إرفاق المستندات المطلوبة
- إرسال الطلب وتأكيد الحالة
هناك علاقة اعتماد قوية بين هذه الخطوات العشر. فإذا اختار الوكيل المريض الخطأ في الخطوة 1، فستكون كل خطوة لاحقة خاطئة مهما نُفذت على نحو سليم؛ وإذا صحت الخطوات التسع الأولى كلها، لكن الخطوة 9 أغفلت إرفاق المستندات أو لم تنفذ الخطوة 10 الإرسال فعليًا، فستظل المهمة كلها مقيّمة بالفشل. يقيس معدل نجاح المهمة الفرعية «كم خطوة أُنجزت بشكل صحيح من أصل عشر»، بينما يقيس معدل نجاح المهمة الكاملة «هل أُنجزت الخطوات العشر كلها بشكل صحيح».
تُظهر البيانات الواردة في الورقة البحثية هذه الفجوة بوضوح: بلغ معدل نجاح المهمة الفرعية لدى GPT-5.4 CUA نسبة 82.8%، بينما بلغ معدل نجاح المهمة الكاملة لدى Claude Opus 4.6 CUA نسبة 36.3%. هذان الرقمان يخصان نموذجين مختلفين، وبالتالي لا يمكن مقارنتهما مباشرة، لكنهما معًا يوضحان حقيقة واحدة: إتمام إجراء محلي وإتمام سير عمل كامل قدرتان مختلفتان.
كما أبلغت صفحات بحثية مبكرة عن فجوة مشابهة: بلغ أفضل معدل نجاح مهمة كاملة لدى Claude Opus 4.5 نسبة 22.9%، بينما بلغ معدل نجاح المهمة الفرعية لدى Gemini 3 نسبة 76.4%. ونظرًا لاختلاف حجم المهام والإصدارات، فإن هذه الأرقام لا تصلح إلا لملاحظة الاتجاه، ولا يمكن وضعها في التصنيف نفسه مع نسخة الورقة أو نتائج OpenAI.
في أي المراحل ي最容易 فشل وكلاء الذكاء الاصطناعي الطبيين؟
نشرت الورقة نتائج مجموعتَي إعداد CUA مصنّفة حسب فئات المهام الفرعية:
| فئة المهمة الفرعية | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| استرجاع المعلومات | 96.5% | 96.1% |
| إعداد الوثائق | 74.3% | 84.4% |
| ملء النماذج | 88.9% | 84.9% |
| حل المهام | 70.7% | 66.2% |
| معالجة الوثائق | 92.3% | 94.3% |
| الاستدلال السريري | 61.3% | 77.0% |
وتجدر الإشارة بشكل خاص إلى أن نسبة 94.3% التي حققها GPT-5.4 CUA في معالجة الوثائق في هذا الجدول ليست سوى مصادفة رقمية مع نسبة 94.3% التي أعلنتها OpenAI لمجموع نقاط rubric الخاصة بـ GPT-6 Astra؛ فالنموذجان والمؤشران والمصدران مختلفان تمامًا.
وبالنظر إلى البنود الفرعية، يبدو أن استرجاع المعلومات قد وصل إلى حد التشبع تقريبًا، بينما يبقى الاستدلال السريري وحل المهام وإعداد الوثائق أضعف نسبيًا. وتشير الورقة في الوقت نفسه إلى أن معالجة الوثائق (Document Handling) ونقل البيانات بين الأنظمة (Cross-system Data Transfer) هما السببان الرئيسيان وراء الفشل من طرف إلى طرف. وقد أبلغت نسخة ويب مبكرة عن أن خمسة من أصل ستة نماذج سجّلت دقة أقل من 20% في المهمة الفرعية لمعالجة الوثائق، لكن ذلك يعود إلى إعداد مهمة مختلف، ولا يمكن مقارنته مباشرة بالجدول أعلاه.
فلماذا يكون النقل بين الأنظمة عرضة للخطأ بشكل خاص؟ في عملية التفويض المسبق، يجب قراءة المعلومة نفسها من السجل الصحي الإلكتروني (EHR)، ثم حفظها في سياق الوكيل، ثم كتابتها في هيكل نموذج مختلف داخل بوابة التأمين، كما أن المرفقات قد تمر عبر بوابة الفاكس. وكل عملية نقل هي فرصة إضافية لوقوع خطأ، والخطأ في المنبع يُنسخ كما هو إلى النظام في المصب. ومن المخاطر التي أوردتها مواد OpenAI أيضًا “نشر معلومات خاطئة من نظام إلى آخر” و”الإبلاغ عن إتمام المهمة بشكل خاطئ عندما تكون حالة النظام غير واضحة”.
لماذا يختلف أداء النموذج نفسه باختلاف إطار التنفيذ؟
أجرت الورقة البحثية تجارب إسقاط (Ablation) على أسلوب التوجيه ونمط المراقبة، وخلصت إلى ثلاث نتائج رئيسية:
- تقديم Portal Guidance (إرشادات تشغيل البوابة) عادةً أفضل أداءً من الاكتفاء بوصف المهمة فقط
- أسلوب المراقبة عبر Accessibility Tree (شجرة البنية الشاملة للوصول) عادةً أفضل من المراقبة باللقطات الشاشة وحدها
- الجمع بين إرشادات تشغيل البوابة ومعلومات الصفحة المُهيكلة يعطي عادةً أداءً أفضل من طرف إلى طرف
تشير الورقة أيضًا إلى أن بيئات الإنتاج الحقيقية قد لا تُتيح شجرة Accessibility Tree كاملة. بعبارة أخرى، لا تعتمد نتيجة الوكيل (Agent) على النموذج الأساسي وحده، بل تعتمد كذلك على إطار التنفيذ (Harness) وطريقة مراقبة الصفحة والموجّه وتعليمات المهمة.
وتُظهر وثائق المطوّرين الخاصة بـ OpenAI أيضًا هذا التفاوت في مسارات التنفيذ. فالدليل الرسمي يشرح كلاً من ComputerToolset وBrowserToolset ومدخل المتصفح المُدار؛ وبالنسبة إلى GPT-6 Astra، توصي الوثائق الحالية بأسلوب Code Execution، أي أن يُولّد النموذج شيفرة برمجية مثل Playwright ليتحكم في الواجهة، مع بقاء Computer Tool خيارًا متاحًا. وتؤكد الوثائق كذلك أن توليد النموذج لتعليمات التشغيل لا يعني نجاح التشغيل فعليًا، إذ يجب على التطبيق تنفيذها ثم التحقق من النتيجة عبر لقطة شاشة جديدة أو وسيلة أخرى.
أما CUA Agent Kit مفتوح المصدر من CVS Health (برخصة Apache-2.0) فيقدّم نهجًا هندسيًا مختلفًا. فالآلية المعلنة في ملف README الخاص به هي: أولاً يستكشف Computer-use Agent سير العمل ويحفظ لقطات الشاشة والأفعال وTrace كأدلة، ثم يقوم Codex Skill بتثبيت المسار الناجح في صورة شيفرة حتمية تخضع لمراجعة المهندسين؛ ولا يحتاج التشغيل الحتمي اللاحق إلى مفتاح النموذج (Key). وهكذا يفصل النهج بين سؤالين: “كيف نكتشف طريقة العمل” و”كيف نكرّرها بشكل مستقر”.
تحليل وحكم: كيف نقيّم وكيلًا طبيًا قابلًا للاستخدام فعليًا؟
كيف نقيّم وكيلًا يمكن الاعتماد عليه فعليًا؟
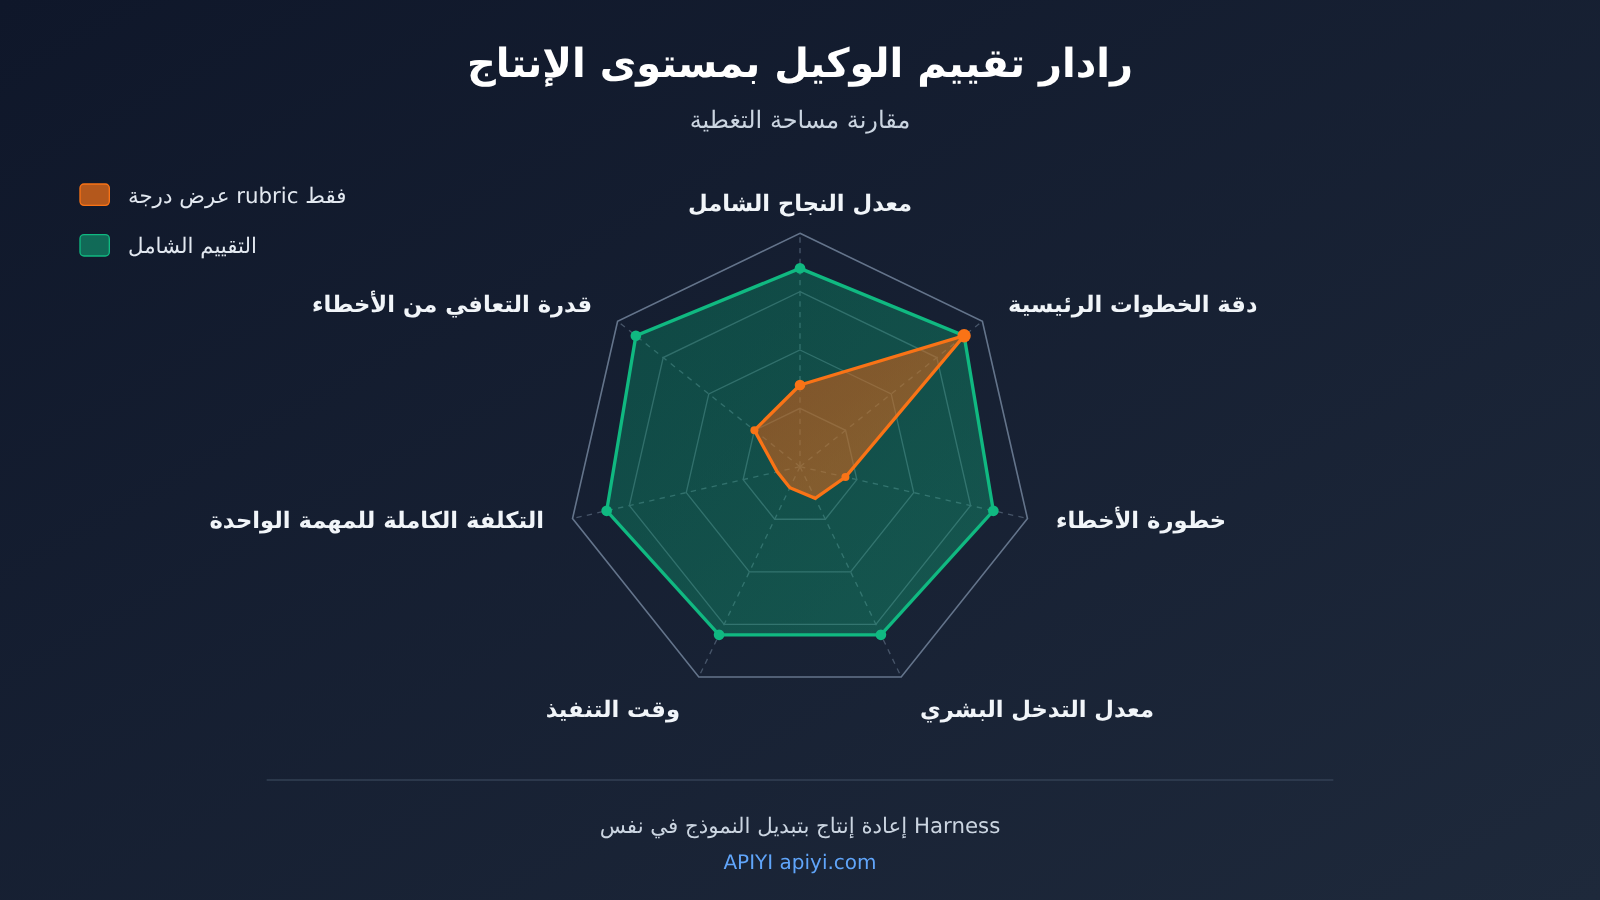
فيما يلي حكم هذا المقال، وليس معيارًا رسميًا لأي جهة. نرى أن درجات على غرار rubric points، مثل 94.3%، تصلح للإجابة عن سؤال “إلى أي مدى تقدّمت القدرات الجزئية للنموذج؟”، لكنها لا تكفي للإجابة عن سؤال “هل يمكن إدخاله في خط الإنتاج؟”. السؤال الأخير يحتاج إلى منظومة مؤشرات متشابكة:
| بُعد التقييم | ما الذي يقيسه | لماذا نحتاجه | مصدر البيانات |
|---|---|---|---|
| معدل النجاح من طرف إلى طرف | نسبة المهام الكاملة التي استوفت جميع شروط النجاح | الأعمال لا تعترف إلا بالنتيجة النهائية | التحقق من الحالة النهائية للنظام |
| دقة الخطوات الحرجة | معدل صحة النقاط الحرجة مثل اختيار المريض والإرسال ورفع المرفقات | خطأ واحد في خطوة حرجة يفشل المهمة كلها | فحوص حتمية |
| خطورة الأخطاء | هل الفشل سهو قابل للاستدراك، أم كتابة بيانات خاطئة، أم إرسال رسالة إلى الشخص الخطأ؟ | معدل فشل متساوٍ قد ينطوي على مخاطر شديدة التباين | مراجعة بشرية + تصنيفات متدرجة |
| معدل التدخل البشري | نسبة الحالات التي تحتاج إلى تولٍّ بشري أو موافقة تصحيحية | يحدد ما يوفره فعليًا من جهد بشري | سجلات الموافقات |
| زمن التنفيذ | زمن المهمة الواحدة وزمن الذيل الطويل | يؤثر في معدل الإنجاز والانتظار في الطابور | الطوابع الزمنية في Trace |
| التكلفة الإجمالية للمهمة الواحدة | مجموع تكاليف النموذج ولقطات الشاشة وإعادة المحاولات وبيئة التشغيل والصيانة | سعر الـ Token الواحد لا يمثل التكلفة الحقيقية | الفواتير + سجلات التشغيل |
| القدرة على التعافي من المواقف غير المتوقعة | هل يستطيع التوقف أو التراجع عند الغموض أو انتهاء المهلة أو تغيّر الصفحة؟ | في السياق الطبي يجب أن يكون قادرًا على “التوقف” | اختبار حقن الأعطال |
جوهر هذا الإطار هو فصل الإبلاغ عن “كم خطوة أُنجزت بشكل صحيح” عن “كم مهمة أُنجزت فعليًا”، ثم تصحيحهما باستخدام خطورة الأخطاء ومعدل التدخل البشري. الحل الذي عرضته Ambience يجسّد بُعد “التعافي من المواقف غير المتوقعة” تحديدًا: فعندما يحتوي السجل الطبي على غموض، يتوقف الوكيل ليسأل الطبيب، ولا يقدّم طلب التفويض المسبق إلا بعد موافقة الطبيب. لكن هذا مجرد حل حوكمة عرضته الشركة، ولا يعني أن جميع الوكلاء الطبيين يملكون التكوين نفسه افتراضيًا.
يجب أيضًا الإفصاح عن حجم العينة وعدد التكرارات. في دراسة تقارن بين RPA وAgent (DOI: 10.1080/23311975.2026.2724760)، نُفّذت كل تقنية 10 مرات على العمليتين P2 وP3، لكن على P1 نُفّذ Agent مرة واحدة فقط وفشل، ولم يُدرَج في الإحصاءات اللاحقة؛ وقد استخدمت الدراسة إعدادات أدوات من عام 2025، لذا لا يمكن اعتبارها نتيجة مباشرة لنماذج عام 2026. يوضح هذا المثال أنه عند قراءة استنتاجات التقييم ينبغي أولًا النظر في عدد مرات التشغيل خلف كل رقم، وما النتائج التي استُبعدت.
الطريقة العملية لتقييم وكلاء المجال الطبي: التشغيل الذاتي على نفس إطار التنفيذ (Harness)
بالنسبة لفرق التطوير، الطريقة الأكثر واقعية هي تثبيت إطار التنفيذ، ثم قياس مؤشرَي الأداء معاً على مجموعة المهام الخاصة بالفريق: مؤشرات المهام الفرعية ومؤشرات الأداء الكلي من طرف إلى طرف. ويوضح المثال التالي استخدام حكيم من نوع LLM Judge يقيّم المواد التي يقدمها الوكيل، بواجهة متوافقة مع OpenAI SDK:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI الموحّدة، تتيح تبديل نماذج التحكيم المختلفة
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是评测裁判,只输出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像报告与既往治疗记录。\n提交内容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
عرض التنفيذ الكامل: حساب معدل نجاح المهام الفرعية ومعدل النجاح من طرف إلى طرف في الوقت ذاته
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # هل هي خطوة حرجة (فشلها يعني فشل المهمة بأكملها)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # يتضمن بالفعل رموز إعادة المحاولة، لا تُجمع مرة أخرى

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """استخدام LLM Judge للمهام الفرعية التي يصعب تحويلها إلى قواعد"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只输出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 توصية تقنية: من الأفضل أن تُعرض درجات المهام الفرعية ومعدل النجاح من طرف إلى طرف جنباً إلى جنب، على نفس إطار التنفيذ (Harness) ونفس دفعة المهام. وعبر الواجهة المتوافقة مع OpenAI على APIYI apiyi.com، يمكنك بمفتاح API واحد التبديل بين OpenAI وClaude وGemini وغيرها من النماذج — سواء لنموذج التنفيذ أو لنموذج التحكيم — ما يقلل من المتغيرات الناشئة عن اختلاف طرق الربط.
حساب تكلفة الوكيل الطبي وتقسيم النماذج إلى طبقات
سعر التوكن الواحد ليس سوى نقطة البداية. وفقًا لأسعار السياق القصير القياسية (Standard) التي أعلنتها OpenAI في 17 نوفمبر 2026، كان سعر الإدخال والإخراج والإدخال المخزّن مؤقتًا في GPT-6 Astra على التوالي 10 و50 و1 دولار لكل مليون توكن، وكانت الأسعار المقابلة في GPT-6 Luna هي 0.10 و0.50 و0.01 دولار. وتؤثر سرعة المعالجة وطول السياق والمنطقة الجغرافية في الفاتورة الفعلية. أداة Computer Use تعتمد على استدعاءات متعددة الجولات، وكل لقطة شاشة في كل جولة تُحتسب إدخالًا بصريًا؛ لذلك عند الحساب ينبغي إحصاء الإدخال البصري/النصي والإخراج المفوتر لكل جولة على حدة، ثم إضافة تكاليف الأدوات وبيئة التشغيل والصيانة الهندسية. وإذا كانت التوكنات المستهلكة في إعادة المحاولات محسوبة أصلًا ضمن الإجمالي، فلا تضفها مرة أخرى.
وبالنظر إلى الفجوة بين 0.085 دولار وحوالي 4.25 دولار، فمن المرجح أن يصبح تقسيم النماذج إلى طبقات هو القاعدة: تُسلَّم المهام المعقدة التي تتطلب استدلالًا قويًا إلى النماذج عالية القدرة، وتُسلَّم المهام ذات البنية العالية والتكرار الكبير إلى النماذج منخفضة التكلفة، أما العمليات الثابتة التي أثبتت نجاحها فتُحوَّل إلى شيفرة حتمية على غرار فكرة CVS. وتجدر الإشارة إلى أن هذه التكاليف لكل مهمة مستمدة من ظروف مرجعية محددة، ولا يمكن اعتبارها سعرًا لعروض الإنتاج.
💰 تحسين التكلفة: قبل اختيار الطبقات، يُنصح أولًا بقياس معدل النجاح من البداية إلى النهاية والتكلفة الكاملة لكل مهمة لدى كل نموذج باستخدام دفعة صغيرة من المهام الحقيقية. تعتمد APIYI (apiyi.com) الفوترة حسب الاستخدام، ويحصل المستخدمون الجدد على حصة اختبار مجانية، ما يجعلها مناسبة لإنجاز هذه التجارب المقارنة بتكلفة منخفضة في مرحلة التأسيس.
من وكيل الرعاية الصحية إلى وكيل المؤسسات: أفكار تقييم قابلة للنقل
تتميز الإدارة الصحية بخصوصية عالية المخاطر وقوة التنظيم، لكن المشكلات التي تكشفها موجودة أيضًا في عمليات المؤسسات مثل مطالبات التأمين والتسوية المالية ومستندات سلسلة التوريد: أنظمة متعددة، واعتماد قوي، ونقل بيانات بين الأنظمة. ورأينا أن المبادئ الأربعة التالية قابلة للنقل مباشرة:
- فصل التقارير: تُعرض درجات المهام الفرعية ومعدل النجاح من طرف إلى طرف في عمودين منفصلين، ولا يجوز أبدًا استخدام الأول بديلاً عن الثاني.
- تصنيف مستوى الدليل: تُصنف العروض التوضيحية في بيئات اصطناعية، والتقييمات الذاتية من البائعين، والمعايير من طرف ثالث، والتجارب المؤسسية، وحالات الإنتاج بشكل منفصل، ولا تُخلط.
- تثبيت Harness قبل المقارنة: بمجرد تغيير طريقة الملاحظة أو الموجهات أو إرشادات البوابة، تصبح النتائج غير قابلة للمقارنة.
- الحوكمة أولى من الدرجات: الحد الأدنى من الصلاحيات، والموافقة البشرية على الإجراءات الحرجة، والتحقق من الحالة بعد العمليات، وتتبع Trace طوال العملية، وآليات التوقف عند الأخطاء، يجب أن تكون بنود قبول قبل الإطلاق.
عند إجراء PoC داخل المؤسسة، يمكن تصنيف مجموعة المهام حسب “الخطوات الحرجة”، ثم تشغيل خط أساس من طرف إلى طرف أولاً، وبعد ذلك إدخال إرشادات البوابة أو الملاحظة المنظمة أو تثبيت الشيفرة تدريجيًا، لمراقبة المساهمة الحقيقية لكل تغيير في معدل النجاح الكامل. وإذا كنت بحاجة إلى إعادة إنتاج نفس مجموعة المهام بسرعة بين عدة نماذج، فيمكنك الاتصال بشكل موحد عبر APIYI apiyi.com لتقليل تكلفة الهندسة في المقارنات الأفقية.
من التطورات اللاحقة التي تستحق المراقبة المستمرة: هل ستنشر OpenAI النتائج لكل مهمة والإعدادات التجريبية وراء 94.3%؟ وهل ستنشر الإصدارات اللاحقة من HealthAdminBench معدل نجاح المهام الكامل للنماذج الجديدة وفقًا للمعايير نفسها؟ وهل ستتمكن المزيد من المؤسسات من الإفصاح عن معدلات التدخل البشري وتصنيف الأخطاء في بيئات الإنتاج الحقيقية. قبل ظهور هذه المعلومات، فإن أي ادعاء بأن “الإدارة الصحية أصبحت قابلة للأتمتة الكاملة” يبقى مجرد تخمين.
يثبت 94.3% تقدمًا ملحوظًا للنموذج عند نقاط التقييم، بينما يذكّر 36.3% بأنه: لكي تُنجز سير عمل تجاري بشكل موثوق، يجب اختباره في المهام الكاملة والأنظمة الحقيقية وتحت الإشراف البشري. وكما يقول المثل الإنجليزي: “The proof of the pudding is in the eating.” (الاختبار الحقيقي للبودنج هو تناوله؛ أي إن النتيجة الفعلية تُختبر بالممارسة.)
المراجع
- OpenAI: Advancing computer-use agents for healthcare teams: بيانات التقييم مثل 94.3% و91.8% و99% و93%، وحالات التعاون
- الرابط:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- الرابط:
- ورقة HealthAdminBench 2604.09937v1: 135 مهمة و1,698 مهمة فرعية، والنتائج التفصيلية وتجارب الاستئصال
- الرابط:
arxiv.org/html/2604.09937v1
- الرابط:
- صفحة مشروع HealthAdminBench ومستودع الشفرة: بيئة المعيار وتنفيذ التقييم
- الرابط:
som-shahlab.github.io/health-admin-bench-website/ - الرابط:
github.com/som-shahlab/health-admin-bench
- الرابط:
- صفحة الأبحاث المبكرة لمختبر Stanford Shah Lab: النسخة التاريخية التي تضم 70 مهمة و947 نقطة تقييم
- الرابط:
shahlab.stanford.edu/doku.php?id=healthadminbench
- الرابط:
- وثائق مطوري OpenAI Computer Use وأسعار API: مسار التنفيذ وسعر Standard
- الرابط:
developers.openai.com/api/docs/guides/tools-computer-use - الرابط:
developers.openai.com/api/docs/pricing
- الرابط:
- CVS Health CUA Agent Kit: آليات الاستكشاف والأدلة وتثبيت الشفرة ومراجعة المهندسين
- الرابط:
github.com/cvs-health/cua-agent-kit
- الرابط:
- دراسة مقارنة بين RPA وAgent: عدد مرات التنفيذ المتكرر وتوضيح استثناءات P1
- الرابط:
doi.org/10.1080/23311975.2026.2724760
- الرابط:
- Cambridge Dictionary: تفسير المثل proof of the pudding is in the eating
- الرابط:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: مرحبًا بزيارة APIYI على apiyi.com للتواصل معنا حول ممارسات تقييم Agent. ولمزيد من تعليمات التكامل، يمكنك مراجعة مركز التوثيق docs.apiyi.com


