
ملاحظة المؤلف: تستند هذه المقالة إلى المنشور البحثي الرسمي الذي وثّق إنجاز Claude Fable 5.2 لمسألتين في فيزياء الثقوب السوداء عبر وكلاء متعددين، وتستخلص منه ممارسات قابلة للتطبيق في اختيار النموذج، وتقسيم الأدوار، ورسم خطوط التوقف عند تشغيل مهام الوكيل الثقيلة.
في 17 نوفمبر 2026، نشرت Anthropic منشورًا بحثيًا: عدة نسخ من Claude Fable 5.2 عملت في الخلفية لنحو ستة أسابيع، وأكملت مسألتين في فيزياء الثقوب السوداء. وبالنسبة لمن يشغّلون مهام طويلة ووكلاء متعددين، فالقيمة الجديرة بالانتباه هنا ليست في الفيزياء ذاتها، بل في أنها تُظهر نمط عمل يمتد لوقت طويل، ويسير في مسارات متوازية، ويتحقق كل مسار من الآخر.
هذه ليست مقالة تبسيط علمي للفيزياء، ولن تحدد لك أي مزوّد واجهة برمجية أكثر استقرارًا. تفعل هذه المقالة شيئًا واحدًا: أن تحوّل الإشارات الهندسية القابلة للاقتباس من المنشور البحثي إلى خطوات يمكنك اتباعها كما هي عند تشغيل مهام وكيل ثقيلة بنفسك.
القيمة الأساسية: بعد قراءة المقالة، ستعرف كيف تفصل الاستدلال الرئيسي والتحقق إلى أدوار مختلفة، وتكتب لكل مسار وكيل خط توقف واضحًا، وتختار فقط بين النماذج التي لها سعر معلن صراحةً في جدول الطُرز، بحيث تصبح تكلفة المهام الطويلة قابلة للتقدير مسبقًا ويمكن وضع سقف لها.
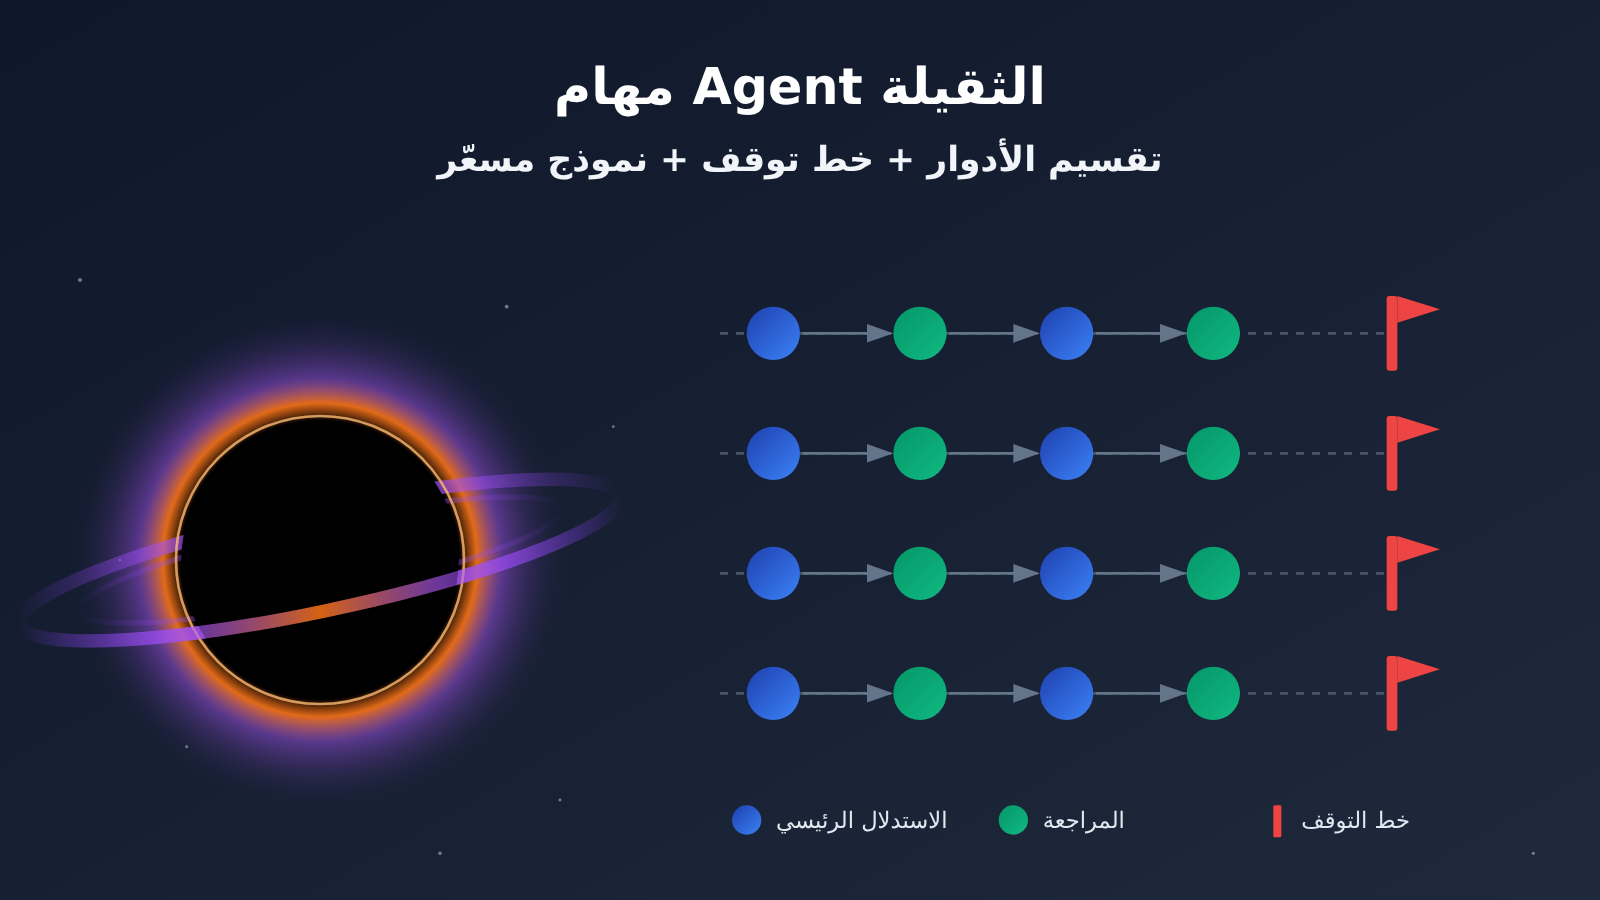
ما يعلّمه منشور بحث Claude Fable 5.2 عن النقاط الأساسية لمهام الوكلاء المكثفة
نبدأ بتوضيح السياق في فقرة أو فقرتين. المنشور البحثي هو سرد رسمي من Anthropic، والورقتان اللتان يتناولهما موجودتان حاليًا كنسخ أولية، وليستا ورقتين خضعتا لمراجعة الأقران. تندرج المسألتان ضمن الفيزياء النظرية، ولا تصفان الكون الذي نعيش فيه، وليس لهما استخدام عملي؛ لذا تكمن أهمية المنشور أساسًا في «الطريقة»، لا في «مدى أهمية النتائج».
بحسب ما يذكر المنشور، في أغسطس 2026 طلب الباحث Hongbin Chen من Claude أن يعدّد مسائل مفتوحة في مجال الثقوب السوداء وbootstrap، وحصل بعد بضع ساعات على 22 مسألة. ثم خصّص لكل مسألة وكيلًا منفصلًا، وكان بإمكان الوكلاء الاطلاع على تقدّم بعضهم، وشغّل المهمة في الخلفية لنحو ستة أسابيع. العبارة الحرفية في المنشور هي «من دون إعداد خاص»، لكن هذا وصف رسمي لطريقة البناء، ولا يعني أن التكلفة صفر، كما أن المنشور لم يقدّم بيانًا بالتكاليف.
| حقيقة واردة في المنشور البحثي | الدرس المستفاد لمهام الوكلاء المكثفة | ما يمكنك فعله |
|---|---|---|
| وكيل لكل مسألة، والوكلاء يطّلعون على تقدّم بعضهم | يجب أن يكون حجم تقسيم المهام واضحًا، وأن تكون الحالة المشتركة قابلة للقراءة | وكيل مستقل لكل مهمة فرعية، مع كتابة التقدم في تخزين مشترك |
| في كل خطوة تقريبًا، ينفّذ وكيلان مستقلان العمل ثم يقارنان النتائج بالأدبيات | الخطوات الحاسمة تحتاج إلى مراجعة مستقلة | فصل الاستدلال الرئيسي والمراجعة إلى دورين |
| في المراحل المبكرة، جرّب الوكلاء بالتوازي 61 مرة ولم ينجحوا | الفشل أمر طبيعي، لكن يجب أن يكون له سقف | لكل مسار، حدّد بوضوح الحد الأقصى لعدد مرات الفشل والميزانية |
| تُجرى تحقّق رسمي من النتائج باستخدام Lean، ويفحصها فيزيائيون | النتائج الآلية تحتاج أخيرًا إلى تحقّق خارجي | خصّص مرحلة للتحقق البشري أو الآلي |
| شُغّل العمل في الخلفية لنحو ستة أسابيع | تتراكم تكاليف المهام الطويلة | قدّر التكلفة وفق الأسعار المعلنة لكل نموذج، وحدّد سقفًا للتكلفة |
ماذا توضح المسألتان في مهام الوكيل (Agent) الثقيلة؟
المسألة الأولى هي حساب تحول طور هوكينغ-بيج، الذي اقتُرح عام 2003 ولم يكتمل حسابه حتى الآن. يقول المنشور إن كل خطوة تقريبًا نفّذها وكيلان مستقلان، ثم قُورنت النتيجة مع الأدبيات، وكان الاستنتاج أن التحول يظل مفاجئًا في الاقتران الضعيف. وتوصّل فيزيائي آخر، بطريقة مختلفة وبشكل مستقل، إلى الإجابة نفسها، ما شكّل تحققًا متقاطعًا. أما بالنسبة للممارسة الهندسية، فإن هذه المسألة توضح أسلوب المراجعة القائم على «التكرار المستقل + المقارنة الخارجية».
المسألة الثانية هي مسألة الحد الأعلى لأبسط نسخة من mod bootstrap. جرّبت دفعة أسبق من وكلاء Claude 61 محاولة متوازية دون نجاح، ثم لاحظ وكيل لاحق نمطًا في النتائج العددية، فاستعار طريقة من مسألة أخرى لتعبئة الكرات، وأثبت أن الحد الأعلى لكتلة أخف ثقب أسود يساوي تقريبًا c/9.1266، وأشار إلى أن هذه الطريقة لا تسمح بخفض الحد الأعلى أكثر من ذلك. وفي سبتمبر 2026، خضعت النتيجة لتحقق شكلي باستخدام Lean، وكُتبت الورقة بواسطة Claude، وراجع الفيزيائيون النتائج الرئيسية. والدرس الهندسي من هذه المسألة هو أن المحاولات الفاشلة الكثيرة جزء من العملية، لذلك يجب أن يكون لكل مسار ميزانية وشرط توقف.
من الضروري توضيح أن ما ورد في المنشور هو «نسخ متعددة من النموذج نفسه تتحقق من بعضها»، وليس «التخطيط بنموذج مكلف والمراجعة بنموذج أرخص». وخطة تقسيم الأدوار لتقليل التكلفة أدناه هي ممارسة هندسية يمكن للقارئ تجربتها، وليست نتيجة تحقّق منها هذا البحث.
كيف نفصل الأدوار في مهام Agent الثقيلة: فصل الاستدلال الرئيسي عن المراجعة
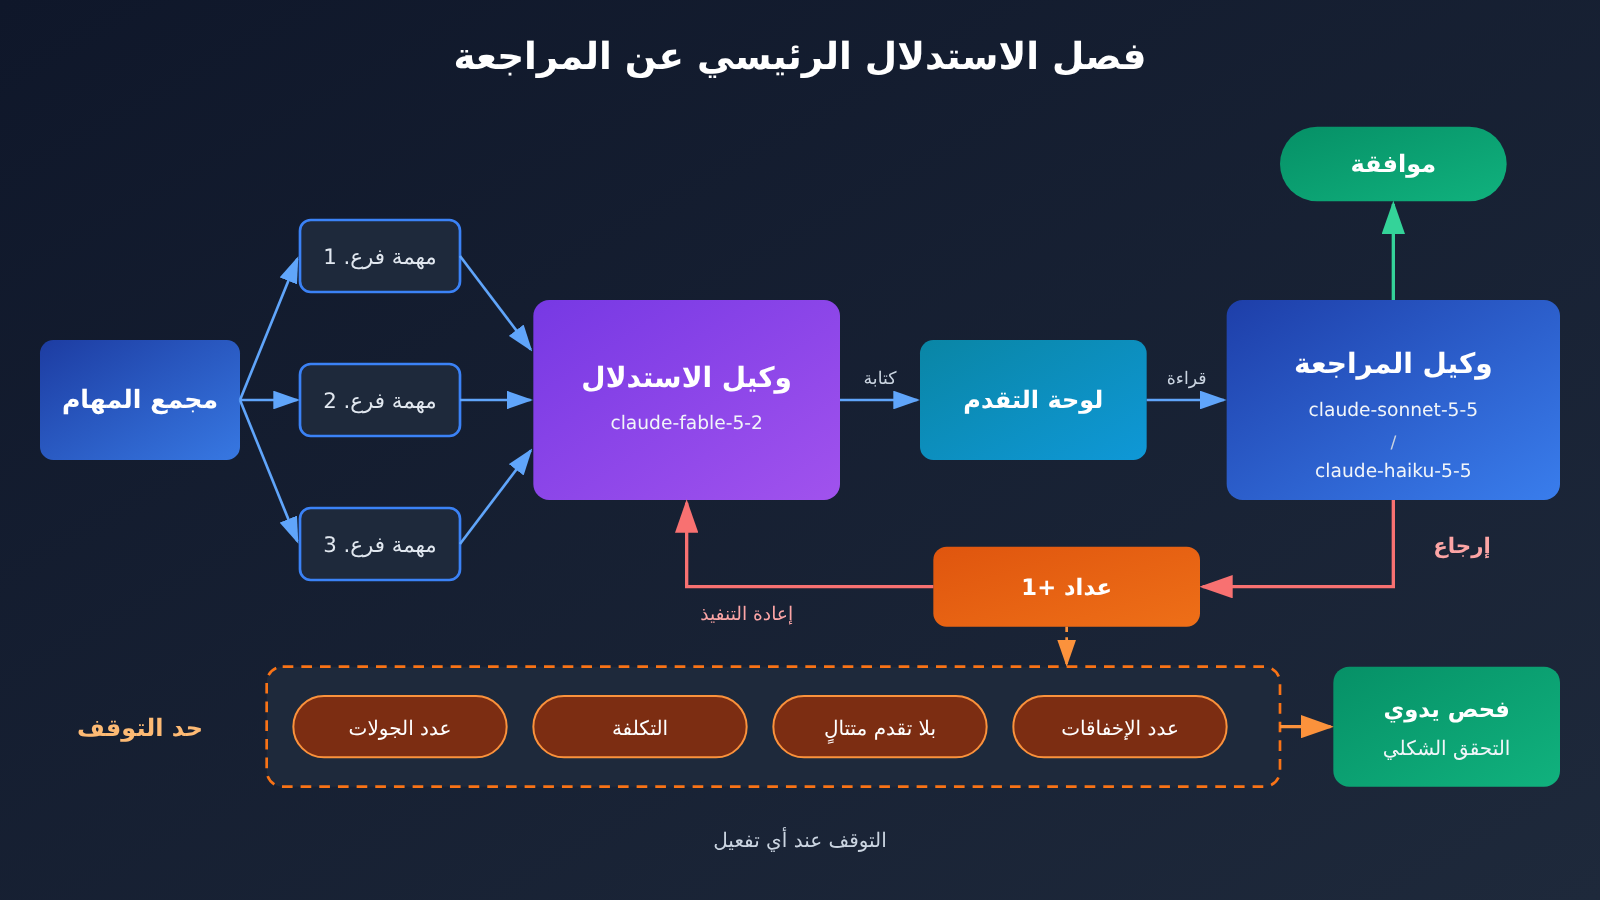
في مهام Agent الثقيلة، يكون المسار الذي يحتاج إلى استدلال عميق هو الأغلى عادةً، بينما تكون إجراءات المراجعة مثل الفحص والمقارنة والتحقق من التنسيق هي الأكثر تكرارًا. وإذا مررت كل الاستدعاءات عبر النموذج الأغلى نفسه، فستزداد التكلفة خطيًا مع عدد الجولات، بل وربما فوق خطيًا. لذا فإن تقسيم «التفكير» و«الفحص» إلى دورين هو أبسط وسيلة مباشرة للتحكم في التكلفة.
يمكن تلخيص مبدأ التقسيم على النحو التالي: الخطوات التي تتطلب استدلالًا مفتوحًا وتخطيطًا لسلاسل طويلة تُسند إلى دور الاستدلال الرئيسي؛ أما عمليات الفحص التي لها معيار واضح — مثل الحكم بما إذا كانت هذه الخطوة متسقة مع الخطوة السابقة، أو ما إذا كان تنسيق الإخراج مطابقًا، أو ما إذا كانت النتيجة تتعارض مع أدبيات معروفة — فتُسند إلى دور المراجعة. وينبغي أن يقدم دور المراجعة حكمًا منظمًا، لا أن يعيد الاستدلال من الصفر.
| الدور | المسؤولية | معرّفات النماذج المرشحة | متطلبات الإخراج |
|---|---|---|---|
| الاستدلال الرئيسي | الاستدلال المفتوح، توليد الخطط، الخطوات الأساسية | claude-fable-5-2، claude-fable-5-2-thinking |
عملية استدلال كاملة ونتائج وسيطة |
| المراجعة من المستوى الأول | الاتساق المنطقي، مقارنة الخطوات، التحقق من الاستشهادات | claude-sonnet-5-5 |
PASS / FAIL مع السبب |
| الفحص الخفيف | فحص التنسيق، اكتمال الحقول، المقارنات البسيطة | claude-haiku-5-5 |
نتيجة JSON منظمة |
| التحقق الخارجي | الإثبات الرسمي، التحقق العددي، المراجعة البشرية | أدوات أو بشر | تأكيد نهائي |
بعد هذا التقسيم، يمكن لجميع الأدوار أن تمر عبر نقطة استدعاء واحدة. فمن خلال APIYI apiyi.com، يكفي مفتاح API واحد للتبديل بين النماذج المذكورة في الجدول أعلاه؛ والواجهة متوافقة مع OpenAI، لذا لا يحتاج دور الاستدلال الرئيسي والمراجعة إلا إلى تغيير معامل model، من دون الحاجة إلى إدارة عدة مجموعات SDK ومفاتيح متعددة. وبالنسبة للمهام الطويلة التي تتطلب تنفيذًا متوازيًا على عدة مسارات، تتيح نقطة الدخول الموحدة أيضًا تجميع إحصاءات الاستخدام في مكان واحد، ما يسهل عملية التسوية.
لكن انتبه: أن يكون نموذج المراجعة أرخص لا يعني أنه أكثر موثوقية. فقدرة دور المراجعة على أداء مهمته تتوقف على ما إذا كانت معايير الحكم التي تقدمها له واضحة بما يكفي. يُنصح أولًا بتشغيل دفعة صغيرة من العينات ذات الإجابات المعروفة، والتأكد من أن أحكام القبول والرفض التي يصدرها نموذج المراجعة تتوافق مع التوقعات بشكل أساسي، ثم إدخاله في المهام الطويلة.
كيف تختار API لمهام الوكيل المكثفة: الأسعار ومعرّفات النماذج
التحكم في ميزانية المهام الطويلة يفترض أن يكون سعر كل استدعاء محددًا بوضوح. أوصي بالالتزام بمبدأ واحد: لا تستدعِ إلا النماذج التي لها سعر معلن صراحةً في جدول الطرازات، وثبّت معرّف النموذج والسعر المقابل له مباشرةً في الشيفرة، بدلًا من تغييرهما مؤقتًا أثناء التشغيل.
وفقًا لصفحة النماذج الرسمية من Anthropic، صدر Claude Fable 5.2 في 9 نوفمبر 2026، ومعرّف النموذج هو claude-fable-5-2، ونافذة السياق مليون توكن، والحد الأقصى للإخراج 128 ألف توكن، ووضع التفكير مفعّل افتراضيًا. يضم الجدول التالي الأسعار المعلنة، في تاريخ التحقق (2026-11-19)، للنماذج ذات الصلة في جدول الطرازات الكامل لدى APIYI على apiyi.com، بوحدة دولار لكل مليون توكن.
| معرّف النموذج | الإدخال | القراءة من الذاكرة المؤقتة | الإخراج | الدور المقترح في هذه المقالة |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | المعالجة الرئيسية |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | المعالجة الرئيسية (نسخة التفكير) |
claude-fable-5-1 |
10 | 0.25 | 50 | إصدار مجاور، للمقارنة |
claude-sonnet-5-5 |
2 | 0.1 | 10 | مراجعة المستوى الأول |
claude-haiku-5-5 |
0.1 | 0.01 | 0.5 | تحقق خفيف |
يمكن استخلاص عدة معلومات بالغة الأهمية للمهام الطويلة من الجدول. أولًا، السعر المعلن لـ claude-fable-5-2 أقل من سعر claude-fable-5-1 المجاور، فإذا كانت معالجتك الرئيسية تستخدم الإصدار القديم، فمن المفيد تقييم الانتقال إليه. ثانيًا، سعر القراءة من الذاكرة المؤقتة لا يمثل سوى 2.5% من سعر الإدخال؛ وفي المهام الطويلة يقرأ الوكيل مرارًا التقدم المشترك ومطالبات النظام والمستندات الخلفية، وإذا تحققت إصابة الذاكرة المؤقتة لهذا الجزء فسيظهر فرق واضح في التكلفة. أما تحقق الإصابة فيعتمد على طريقة الاستدعاء وقواعد المنصة، والمرجع هو ما توضحه الوثائق. ثالثًا، الفرق في سعر الوحدة بين نموذج المراجعة ونموذج المعالجة الرئيسية يبلغ رتبة مقدار.
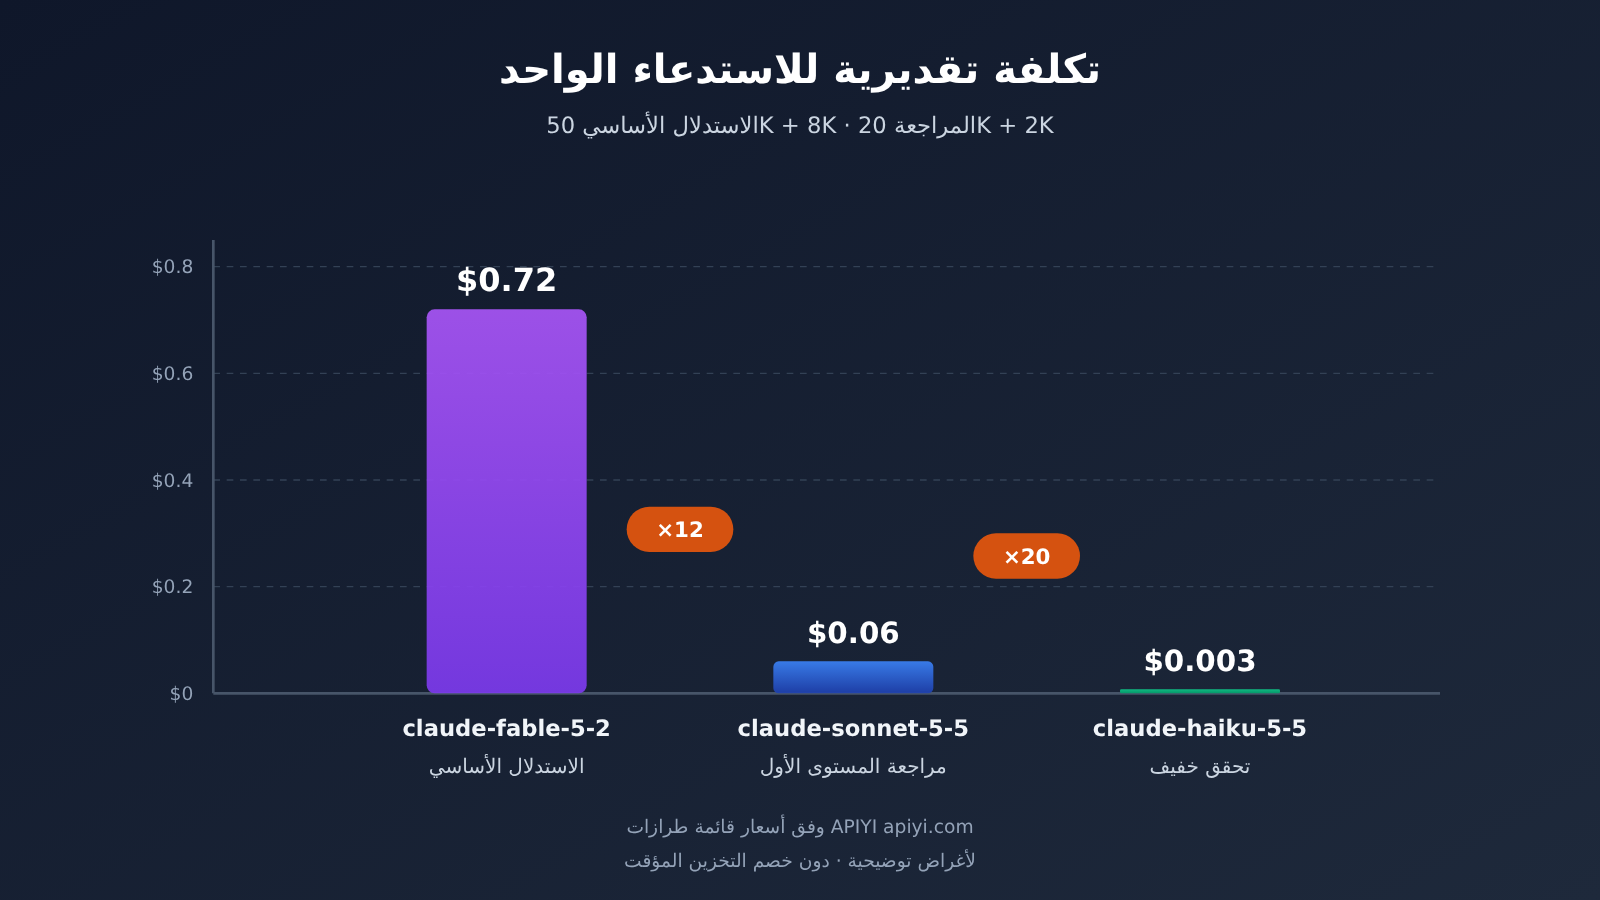
لنستشعر الأمر عبر مجموعة أرقام افتراضية: استدعاء معالجة رئيسية واحد بإدخال 50 ألف توكن وإخراج 8 آلاف توكن يكلّف على claude-fable-5-2 نحو 0.4 + 0.32 = 0.72 دولار؛ واستدعاء مراجعة واحد بإدخال 20 ألف توكن وإخراج 2000 توكن يكلّف على claude-sonnet-5-5 نحو 0.04 + 0.02 = 0.06 دولار، وعلى claude-haiku-5-5 نحو 0.003 دولار. وإذا استُخدم نموذج المعالجة الرئيسية نفسه في المراجعة، فسيكلّف استدعاء المراجعة نفسه نحو 0.16 + 0.08 = 0.24 دولار. هذا مجرد توضيح حسابي، أما عدد التوكنات الفعلي فيعتمد على مهمتك.
بالإضافة إلى ذلك، تجد على صفحة النماذج الرسمية أن سعر Opus 5.5 هو 4 للإدخال و20 للإخراج، وSonnet 5.5 بسعر 2 و10، أما Haiku 5.5 فيبدأ من 0.10 و0.50. يمكنك اعتبار هذه الأرقام مرجعًا لفهم تدرّج الأسعار الرسمي. عند الاستدعاء الفعلي، تكون الطرازات والأسعار وفقًا لقائمة الطرازات على المنصة. تدعم سلسلة claude-fable-5-2 من APIYI كلا النقطتين الطرفيتين chat وmessages، ونقطة الدخول موحّدة عبر https://api.apiyi.com/v1.
البدء السريع مع مهام الوكيل المكثّفة: كود جدولة بخط إيقاف
مثال مبسّط
أولاً تأكد من أن نموذج الاستدلال الرئيسي يُستدعى بشكل طبيعي، وأنك تستطيع الحصول على حقل usage، فهذا هو الأساس لحساب التكاليف لاحقًا:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # يُستخدم لإحصاء الـ tokens وتقدير التكلفة
اكتب خط توقف واضح لكل مسار وكيل
في منشور البحث، جرّب الوكلاء في المراحل المبكرة 61 محاولة متوازية دون نجاح، وهذا يذكّرنا بأن مهام الوكيل المكثّفة ستتضمن حتمًا عددًا كبيرًا من المحاولات الفاشلة، والفشل نفسه يستهلك المال. وظيفة خط التوقف هي أن يتوقف كل مسار وكيل تلقائيًا قبل أن يخرج عن السيطرة، ويُترك القرار للإنسان أو للأداة.
| خط التوقف | المعنى | القيمة الأولية المقترحة (تُعدّل حسب المهمة) |
|---|---|---|
| الحد الأقصى لعدد الجولات | الحد الأعلى لتبادلات الاستدلال الرئيسي والمراجعة | 10-30 جولة |
| سقف التكلفة | الحد الأعلى للتكلفة التقديرية التراكمية للمسار الواحد | يُحدد حسب ميزانية السؤال الواحد |
| عدم التقدم المتتالي | إعادة المراجعة بشكل متتالٍ دون استنتاج جديد | 3-5 مرات |
| الحد الأقصى لعدد الإخفاقات | العدد التراكمي لمرات الرفض من المراجعة | نحو نصف عدد الجولات |
| طول المخرجات | الحد الأعلى لـ tokens في المخرجات الواحدة | أقل بكثير من الحد الأقصى للمخرجات 12.8 万 |
عرض كود التنفيذ الكامل
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # مدخل APIYI الموحد، يستخدمه الاستدلال الرئيسي والمراجعة معًا
)

# سعر الوحدة: دولار / مليون token، مكتوب بشكل ثابت وفق جدول الطرازات على المنصة، ويُحدَّث يدويًا عند التغيير
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """تقدير وفق السعر المعلن، دون احتساب خصم التخزين المؤقت، والنتيجة متحفظة."""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
يحتوي هذا الكود على ثلاثة قرارات تصميم متعمدة. أولاً، جدول أسعار الوحدات مضمّن مباشرة في الكود، وأي شخص يغيّر النموذج عليه أن يغيّر سعر الوحدة في الوقت نفسه، وذلك لتجنّب تشويه تقدير الميزانية عند «التبديل إلى نموذج غير مسعّر». ثانياً، دور المراجعة مطالب بأن يخرج فقط بـ PASS أو FAIL مع السبب، من دون إعادة استنتاج، وذلك للحد من طول مخرجات المراجعة. ثالثاً، عند التوقف يعيد التقدم الحالي والتكلفة التراكمية، لتسهيل تولّي المهمة يدوياً، بدلاً من ترك الوكيل يعيد المحاولة بلا نهاية.
🚀 بداية سريعة: يُنصح أولاً باستخدام حصة الاختبار المجانية للمستخدمين الجدد على APIYI apiyi.com، وتشغيل المسار أعلاه عبر مسألة صغيرة تعرف إجابتها، للتأكد من أن قرار المراجعة وتقدير التكلفة يطابقان التوقعات، ثم زيادة عدد المسارات المتوازية وعدد الدورات تدريجياً.
الأسئلة الشائعة حول اختيار API لمهام Agent الثقيلة
س1: هل يمكن الوثوق بأن Claude Fable 5.2 حل مشكلة في فيزياء الثقوب السوداء؟
هذا تصريح رسمي من Anthropic في منشور بحثي بتاريخ 17 نوفمبر 2026. الورقتان البحثيتان المرتبطتان به هما نسختان أوليتان (preprint) لم تخضعا بعد لمراجعة الأقران. نتيجة المسألة الثانية تم التحقق منها شكليًا باستخدام Lean في سبتمبر 2026، بينما توصل عالم فيزياء آخر إلى الإجابة نفسها في المسألة الأولى بطريقة مختلفة. لذلك ينبغي التعامل مع الأمر على أنه «تصريح رسمي + نسخة أولية».
س2: يقول المنشور البحثي إنه «دون إعدادات خاصة». هل يعني ذلك أنه رخيص جدًا؟
لا. يصف «دون إعدادات خاصة» طريقة الإعداد، ولم يقدم المنشور أي فاتورة بالتكاليف. فمع 22 مسألة، ووكيل واحد لكل مسألة، وتشغيل في الخلفية لنحو ستة أسابيع، يكون حجم الاستدعاءات كبيرًا في الأصل. عند تشغيل مهام مشابهة بنفسك، قدّر التكلفة بناءً على الأسعار المعلنة في جدول النماذج، وحدد سقفًا للتكلفة.
س3: هل استخدام نموذج رخيص للمراجعة طريقة تحقق منها المنشور البحثي؟
لا. طريقة المنشور هي أن تعيد نسخ متعددة من النموذج نفسه العمل بشكل مستقل، ثم تتحقق من بعضها. أما «الاستدلال الرئيسي بنموذج مكلف والمراجعة بنموذج رخيص» فهي ممارسة هندسية نقترح عليك تجربتها في هذا المقال، ويجب أن تتحقق من فاعليتها على مهامك الخاصة. وبالنسبة للخطوات التي تتطلب دقة عالية جدًا، يمكنك الإبقاء على أسلوب «نسختين من الاستدلال الرئيسي تعيدان العمل بشكل مستقل».
س4: كيف أختار بين `claude-fable-5-2` و`claude-fable-5-2-thinking`؟
السعر المعلن لكليهما في جدول النماذج لدى APIYI متطابق: الإدخال 8، وقراءة التخزين المؤقت 0.2، والإخراج 40 دولارًا لكل مليون توكن. وتوضح صفحة النموذج الرسمية أن التفكير في Fable 5.2 مفعّل افتراضيًا. أما الفروق الدقيقة بين المعرفين في سلوك الاستدعاء فتحددها توضيحات النماذج على المنصة. ننصح بتشغيل كل منهما عدة مرات على المهمة نفسها، ومقارنة طول الإخراج و`usage`، ثم اختيار أيهما للاستدلال الرئيسي.
س5: كيف أستدعي نموذج الاستدلال الرئيسي ونموذج المراجعة عبر واجهة واحدة؟
بعد التسجيل في APIYI عبر apiyi.com والحصول على مفتاح API، عيّن `base_url` في SDK على `https://api.apiyi.com/v1`. يكفي بعد ذلك تبديل معامل `model` بين الاستدلال الرئيسي والمراجعة، مثل `claude-fable-5-2` و`claude-sonnet-5-5`. يحصل المستخدمون الجدد على رصيد تجريبي مجاني، وهو مناسب للتحقق أولاً من خط التوقف ومنطق المراجعة.
س6: ما أهمية سعر قراءة التخزين المؤقت في المهام الطويلة؟
سعر قراءة التخزين المؤقت في Fable 5.2 يساوي 2.5% من سعر الإدخال، أي 0.2 دولار لكل مليون توكن. المهام الطويلة متعددة الوكلاء تعيد قراءة موجه النظام والمواد الخلفية والتقدم المشترك مرارًا. وإذا بقي هذا المحتوى ثابتًا ووُضع في مقدمة الموجه، زادت فرصة إصابة التخزين المؤقت. أما ما إذا كانت الإصابة ستحدث وكيف تتم الفوترة، فتحدده وثائق المنصة.
س7: ما القيمة المناسبة لحدود التوقف؟
لا يوجد رقم واحد يصلح لكل الحالات. يُفضّل البدء بقيم متحفظة: عدد الجولات 10-30، و3-5 مرات متتالية بلا تقدّم، وسقف لتكلفة كل مسار يُحدَّد وفق قيمة المهمة. وبعد تشغيل دفعة كاملة، انظر إلى توزيع أسباب التوقف: إذا كانت الغالبية من نوع «بلوغ سقف التكلفة» مع اقتراب المهمة من الاكتمال، فوسّع الحدود قليلًا؛ أما إذا كانت الغالبية «بلا تقدّم متتالي»، فهذا يعني أن تقسيم المهام لم يكن دقيقًا بما يكفي.
س8: ما القيود التي يتضمنها هذا الأسلوب؟
أولًا، قد يفوت نموذج المراجعة بعض الحالات أو يخطئ في تقديرها، لذلك يلزم معايرته بعينات ذات إجابات معروفة مسبقًا. ثانيًا، تقديرات التكلفة مبنية على الأسعار المعلنة، دون احتساب خصومات التخزين المؤقت ولا تذبذب إعادة المحاولة عند الفشل. ثالثًا، كما في منشور البحث، لا تزال النتائج النهائية بحاجة إلى تحقق خارجي، مثل إثبات شكلي أو مراجعة من خبير في المجال؛ فتوافق الوكلاء فيما بينهم لا يعني أن النتيجة صحيحة.
مهام الوكيل (Agent) الكثيفة: نقاط أساسية عند اختيار API — Key Takeaways
- تحديد الطبيعة من المصدر: دراسة الثقوب السوداء على Fable 5.2 هي رواية رسمية من الجهة نفسها، والورقة البحثية ما تزال مسودة (preprint)؛ ركّز على المنهج لا على النتيجة
- توزيع الأدوار: اترك الاستدلال المفتوح لنموذج الاستدلال الرئيسي، وأسند الفحوص التي لها معايير واضحة إلى نموذج المراجعة
- استقلالية المراجعة: نموذج المراجعة يحكم فقط دون إعادة استدلال، ويُخرج PASS / FAIL مع ذكر السبب
- حدود التوقف لا بد من كتابتها: أربعة حدود يجب ألا يغيب أي منها: عدد الجولات، والتكلفة، وتتالي الجولات بلا تقدّم، وعدد مرات الفشل
- استخدم فقط النماذج ذات الأسعار المعلنة: اكتب معرّف النموذج وسعر الوحدة مباشرة في الشفرة، وعند تغيير النموذج يجب تحديث السعر في الوقت نفسه
- أحسِن استخدام قراءة التخزين المؤقت: ضع الخلفية الثابتة والتقدّم في المقدمة، فقراءة التخزين المؤقت لا تكلف سوى 2.5% من سعر الإدخال
- ابدأ من بوابة موحّدة: عبر APIYI يمكنك التبديل بين نموذج الاستدلال الرئيسي ونموذج المراجعة بمفتاح واحد، وابدأ بتشغيل المهام الصغيرة باستخدام الحصة المجانية
ملخص
انطلاقًا من قصة حل Claude Fable 5.2 لمسألة صعبة في فيزياء الثقوب السوداء، هناك ثلاث نقاط جديرة بالاستفادة في مهام الوكيل المكثفة:
- افصل الاستدلال الرئيسي عن المراجعة: استخدم منشور البحث عدة نسخ من النموذج نفسه لتتحقق كل منها من الأخرى. ويمكنك انطلاقًا من ذلك تجربة اختيار نماذج بأسعار مختلفة حسب الدور، والتحقق من جودة المراجعة عبر عينات.
- حدّد خط التوقف بوضوح لكل مسار: تشير 61 محاولة فاشلة إلى أن الفشل أمر طبيعي، لذا يجب وضع حدود قصوى لعدد الجولات والتكلفة وعدم التقدم وعدد الإخفاقات.
- لا تستدعِ إلا النماذج التي لها سعر معلن في جدول الطرازات: أدرج معرّفات النماذج مثل
claude-fable-5-2وclaude-sonnet-5-5وclaude-haiku-5-5وسعر الوحدة داخل الشفرة، حتى تصبح التكلفة قابلة للتقدير والتقييد بسقف أعلى.
غالبًا ما لا يتحدد نجاح المهام الطويلة أو فشلها بمدى ذكاء استدعاء واحد، بل بقدرة العملية بأكملها على التقدم باستمرار ضمن ميزانية قابلة للتحكم مع ترك نتائج قابلة للتحقق. نوصي بالبدء عبر APIYI apiyi.com باستخدام رصيد اختبار مجاني لتشغيل مسألة صغيرة من البداية إلى النهاية، ثم ضبط المعاملات خطوة بخطوة وفق أسباب التوقف والتوسع في الحجم.
📚 المراجع
-
منشور بحثي من Anthropic: رواية رسمية من Claude Fable 5.2 عن إنجازه مسألتين في فيزياء الثقوب السوداء بواسطة وكلاء متعددين
- الرابط:
anthropic.com/research/claude-black-hole-physics - الوصف: وصف مباشر من المصدر يساعد على فهم توزيع المهام بين الوكلاء، والمدة الزمنية، وطريقة المراجعة
- الرابط:
-
الورقة البحثية الأولية الأولى: نسخة أولية مرتبطة بمنشور البحث، لم تخضع لمراجعة الأقران
- الرابط:
hexagonmath.org/2611.00175v1 - الوصف: مناسبة للقراء الذين يرغبون في الاطلاع على النتائج بنصّها الأصلي
- الرابط:
-
الورقة البحثية الأولية الثانية: نسخة أولية أخرى مرتبطة بمنشور البحث، لم تخضع لمراجعة الأقران
- الرابط:
hexagonmath.org/2611.00174v1 - الوصف: تُقرأ بالتوازي مع الورقة السابقة
- الرابط:
-
صفحة النموذج الرسمية لـ Claude Fable 5.2: معرّف النموذج، ونافذة السياق، والحد الأقصى للمخرجات، والسعر الرسمي
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview - الوصف: للتحقق من مواصفات النموذج وفئات التسعير الرسمية
- الرابط:
المؤلف: فريق التقنية في APIYI
للتواصل التقني: يسعدنا تواصلكم معنا عبر الصفحة الرئيسية لموقع APIYI، ويمكن الاطلاع على شروحات النماذج والأسعار في مركز الوثائق docs.apiyi.com


