
在特定條件下是的,但生產環境不能照搬這個數字。2026 年 11 月 16 日,OpenAI 披露 GPT-6 Luna 在 HealthAdminBench 醫療行政基準中的單任務成本爲 0.085 美元,比 GPT-6 Astra 低 98%。這個數字來自基準測試,不是醫院生產部署的報價。
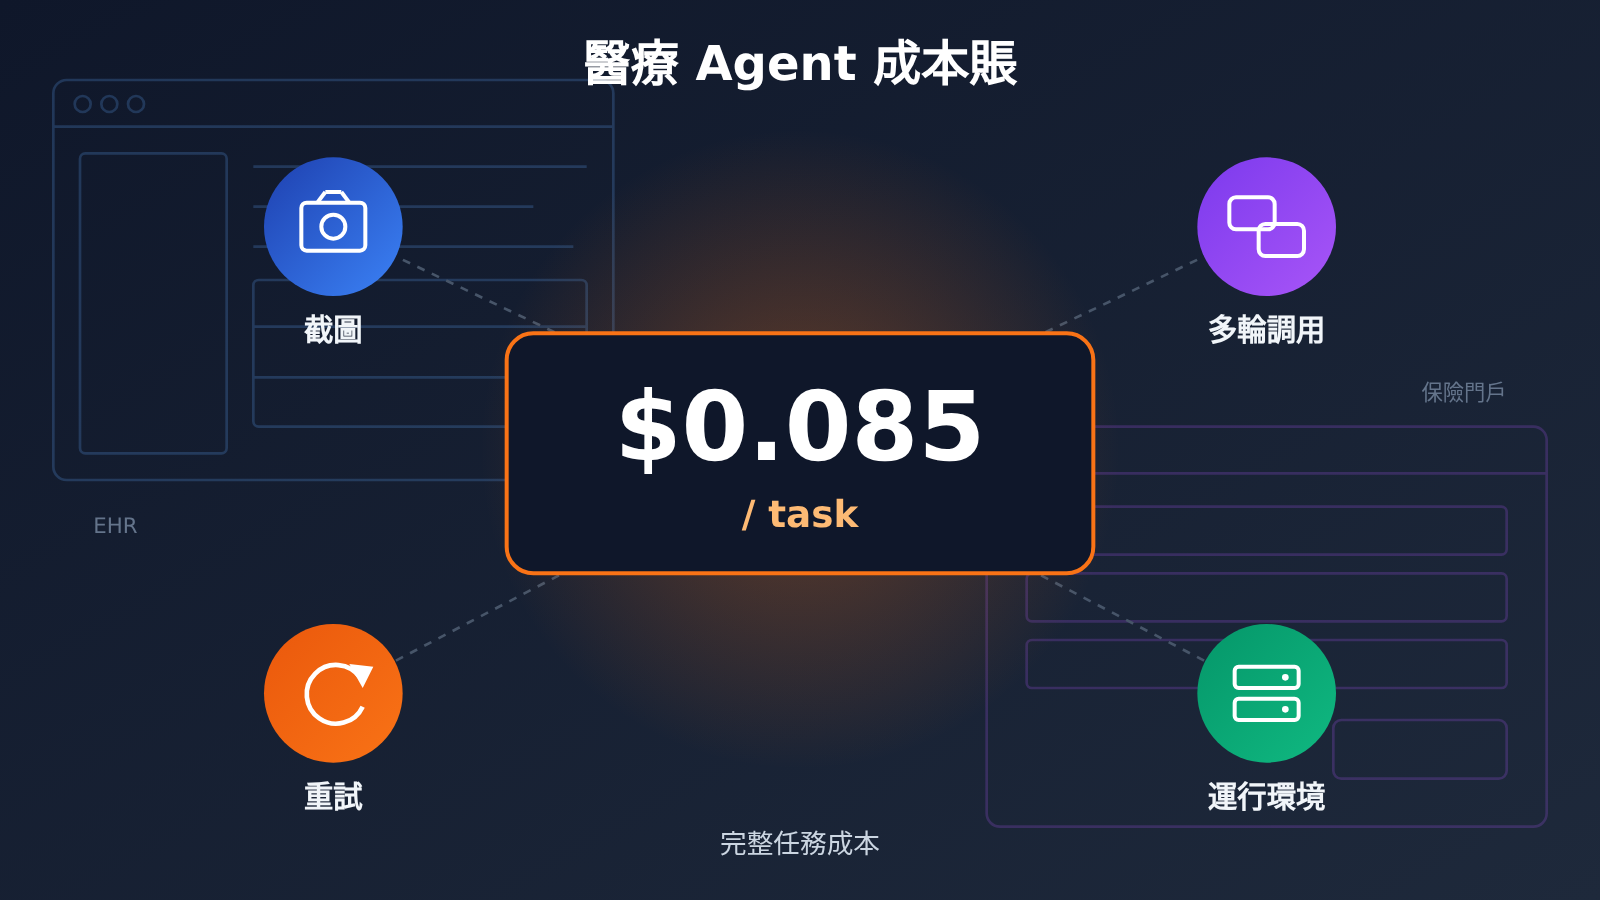
Agent 成本也不能簡單按每百萬 Token 的單價換算。一次 Computer Use 任務包含多輪模型調用、截圖輸入、工具執行、失敗重試和運行環境,真正需要覈算的是完整任務成本。對開發者來說,合理的模型分層、緩存、工作流固化和成本監控,比挑選單價最低的模型更重要。
讀完本文,您能瞭解醫療 Agent 成本的哪些問題?
- 8.5 美分是在什麼測試條件下得出的,哪些是官方披露值,哪些是反推估算值
- 一次醫療 Agent 完整任務的成本由哪幾部分組成,截圖、多輪調用和重試如何推高費用
- 怎樣做模型分層,怎樣用公式和月度任務量估算自己的 Agent 項目預算
本文索引:醫療 Agent 成本賬從哪裏讀起
客觀事實部分先講 8.5 美分對應哪個基準、什麼評分口徑,再解釋 Token 單價爲什麼不能代表任務成本。之後拆開一次 Agent 任務的六類費用來源,並以 CVS Health 開源的 CUA Agent Kit 說明,爲什麼固定流程不必每次都調用大模型。分析判斷部分討論高能力模型與低成本模型的分工,給出可直接套用的預算公式和測算情景,最後說明 API 層面的用量管理能解決什麼、不能解決什麼。
To Know:醫療 Agent 成本相關概念
| 概念 | 簡要解釋 |
|---|---|
| Computer Use | 通過觀察軟件界面、執行點擊和輸入等操作來完成任務的能力 |
| EHR | 電子健康記錄系統,即醫院使用的電子病歷系統 |
| MCP | 用於發現和調用外部工具的標準協議 |
| RPA | 按預先配置的規則或腳本執行重複流程的自動化方式 |
| Rubric points | 按評測規則獲得的評分點,衡量部分要求的達成情況 |
| 端到端成功率 | 完整任務滿足全部成功條件的比例,比評分點佔比更嚴格 |
| Trace | 記錄執行過程、操作動作和界面狀態的軌跡證據 |
| Maximum Reasoning Effort | 模型的最高推理強度檔位,通常會消耗更多推理 Token |
| 緩存輸入 | 重複出現的輸入前綴按較低單價計費的機制 |
影響速覽:醫療 Agent 成本對誰意味着什麼
- 開發者與技術負責人:不能拿官方基準數字直接報預算。需要按自己的任務驗證執行機制、端到端完成率和完整成本,同時把截圖量、調用輪次和重試率納入統計。
- 醫療機構與工作流負責人:要區分合成演示、廠商評測、試點和生產案例。低單任務成本不能替代人工審批、最小權限和審計日誌的配置,這些治理措施本身也會產生成本。
客觀事實:醫療 Agent 8.5 美分背後的數據
8.5 美分能完成什麼醫療 Agent 任務?
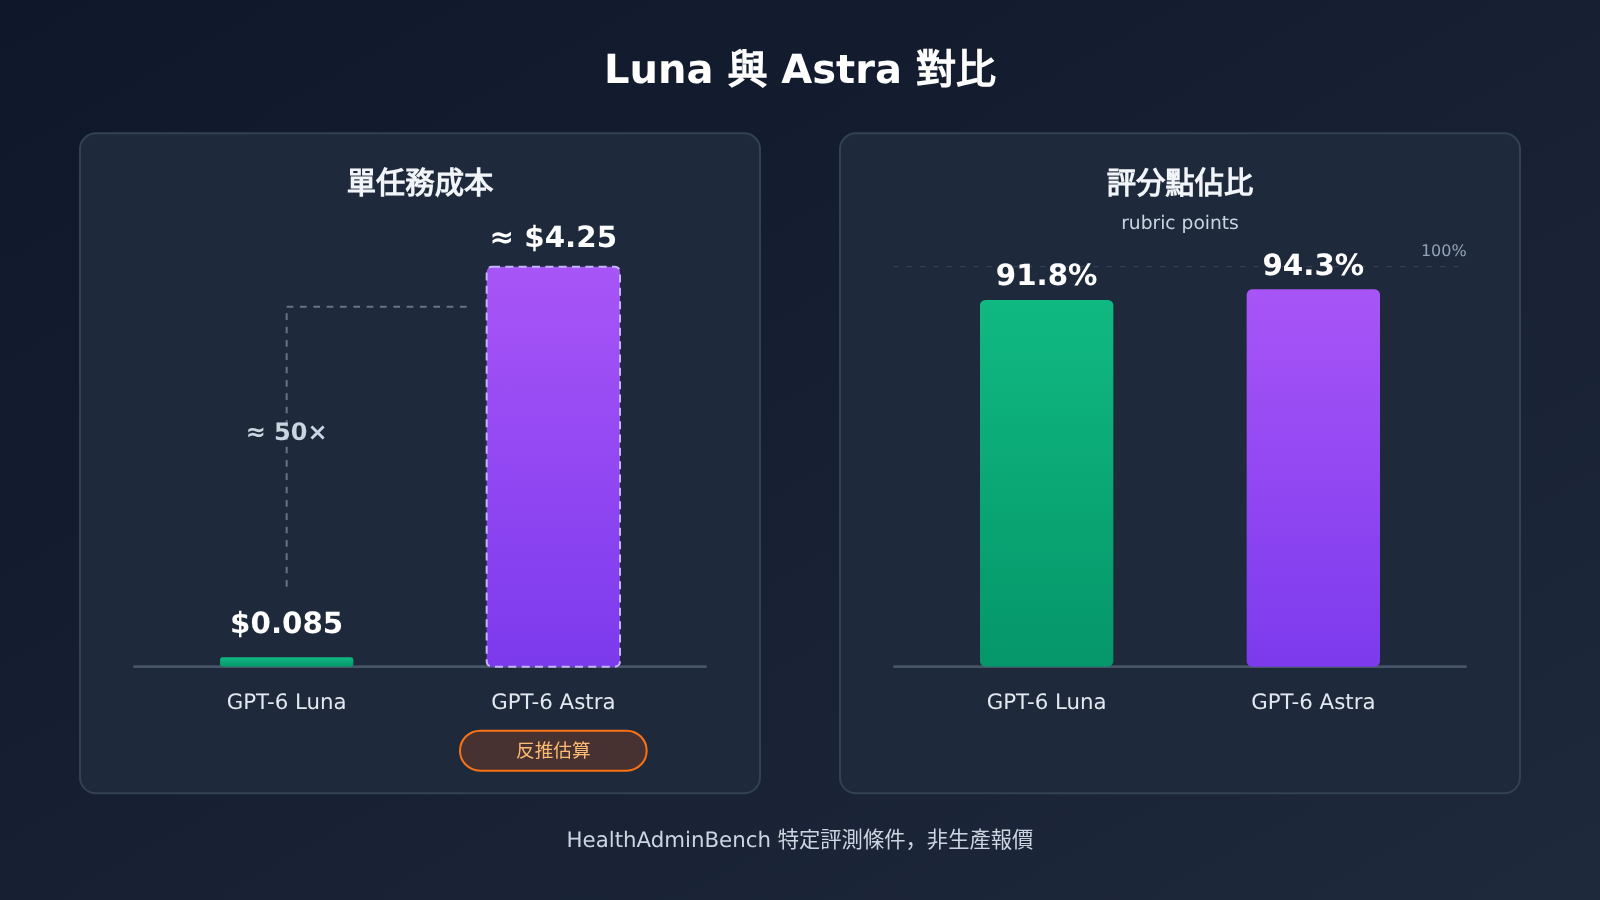
8.5 美分出自 OpenAI 2026 年 11 月 16 日發佈的醫療 Computer Use Agent 公告。OpenAI 用斯坦福 Shah Lab 提出的 HealthAdminBench 評測了兩款模型,兩者都使用最高推理強度。該基準在模擬的 EHR、保險支付方門戶和傳真系統中,考察保險資格覈驗、預授權申請、醫療設備訂購和跨系統文檔處理等行政任務。
| 項目 | GPT-6 Luna | GPT-6 Astra | 數據性質 |
|---|---|---|---|
| HealthAdminBench 得分 | 91.8% | 94.3% | 官方披露,rubric points 佔比 |
| 單任務成本 | $0.085 | 約 $4.25 | Luna 爲官方披露,Astra 按 98% 降幅反推 |
| 1,000 次任務成本 | $85 | 約 $4,250 | 基準口徑下的線性換算,非生產報價 |
| 輸入價格(每百萬 Token) | $0.10 | $10.00 | 官方 Standard 短上下文價格,2026-11-17 查詢 |
| 輸出價格(每百萬 Token) | $0.50 | $50.00 | 同上 |
| 緩存輸入(每百萬 Token) | $0.01 | $1.00 | 同上 |
Astra 的約 4.25 美元來自 0.085 ÷(1 − 0.98)的計算,是近似值,並非 OpenAI 單獨公佈的價格。94.3% 和 91.8% 也不是完整任務成功率。它們統計的是可得評分點的佔比,不能寫成”94.3% 的醫院行政工作已經實現全自動”。
HealthAdminBench 有多個公開版本,需要區分口徑。論文版本 2604.09937v1 包含 135 項任務、1698 個子任務,其中 1177 個由確定性規則判定,521 個由模型裁判評分。論文中 36.3% 的完整任務成功率屬於 Claude Opus 4.6 CUA,82.8% 的子任務成功率屬於 GPT-5.4 CUA。早期 Shah Lab 網頁描述的是 70 項任務、947 個評分點的版本,只能作爲歷史對照。不同模型、日期、執行條件和指標的結果,不能排成同一張榜單。
爲什麼醫療 Agent 任務不能只看 Token 單價?
從價格表看,兩款模型的輸入、輸出和緩存輸入單價都相差 100 倍。按 98% 的降幅計算,兩者的單任務成本只相差約 50 倍。由此可以推斷,兩款模型在同一基準裏的實際消耗量並不相同。調用輪次、輸入輸出 Token 數、推理消耗和重試次數都可能不同,所以單任務成本只能根據真實用量覈算。
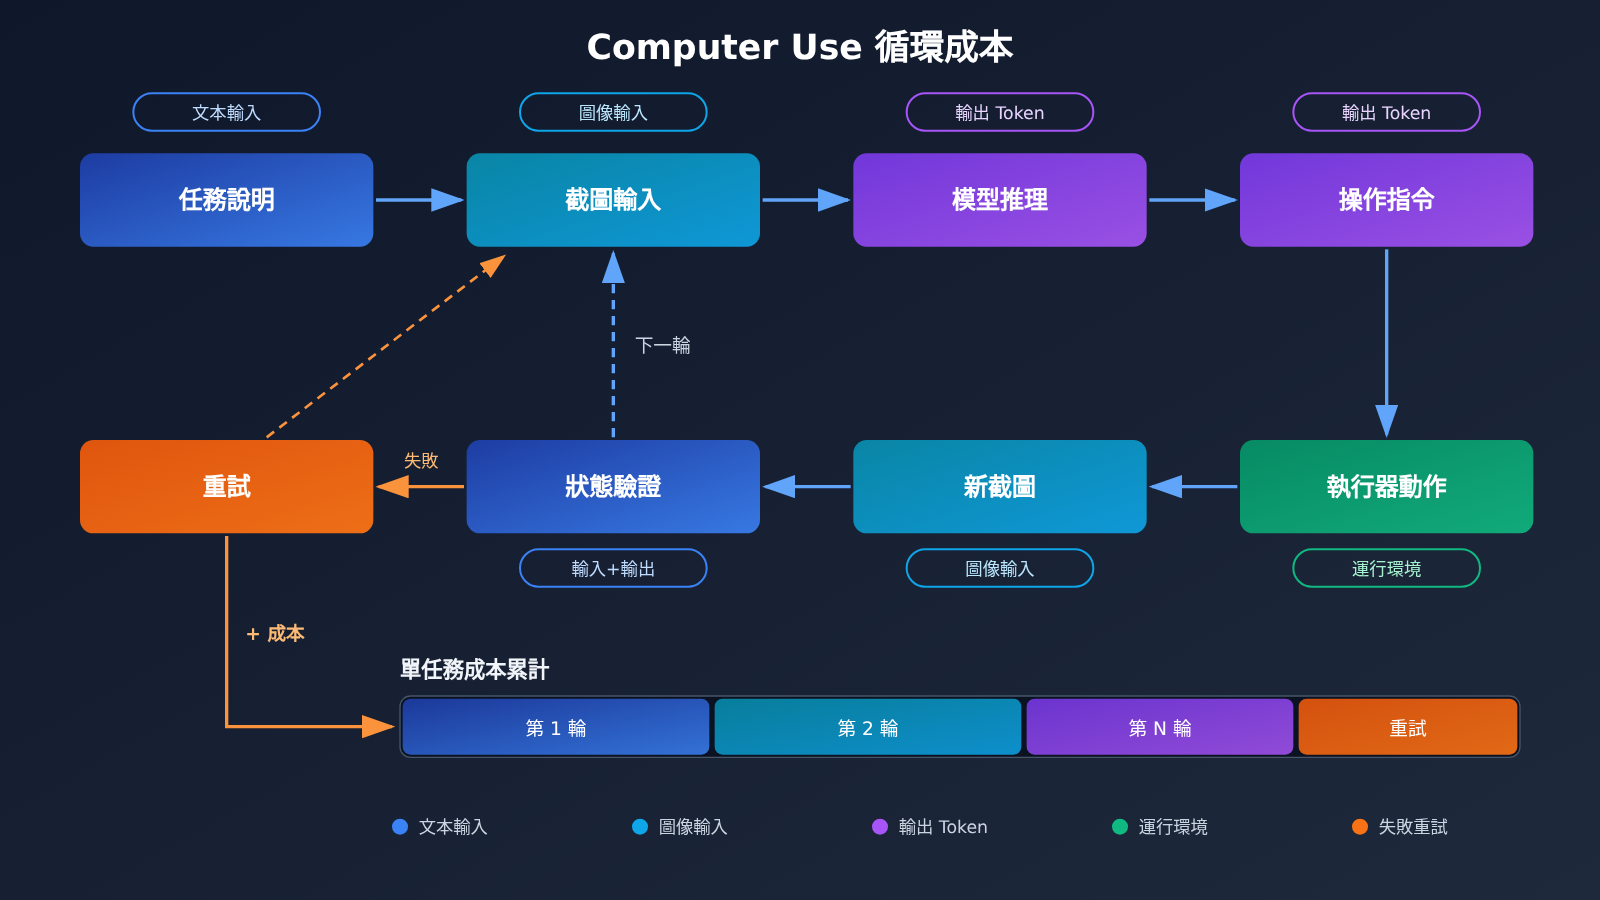
根本原因在於 Computer Use 的執行方式。按照 OpenAI 開發者文檔,一個典型循環是:接收任務,觀察屏幕截圖,生成操作指令,由應用執行點擊或輸入,返回新截圖,模型再判斷下一步,直到完成或請求人工審批。每走一步,任務說明、歷史上下文和新截圖都可能重新輸入模型。
普通問答可能只需要一次調用,跨系統的預授權流程則可能連續經歷十幾輪”觀察、操作、驗證”。截圖屬於圖像輸入,會單獨產生視覺 Token 費用,而且每輪都會出現,因此最容易被低估。另外要注意,模型生成了操作指令,並不代表操作已經成功,應用必須執行並驗證結果,驗證本身也會消耗調用。
一次醫療 Agent 任務的錢究竟花在哪裏?
把一次任務拆開,可以歸入六類直接成本。工程維護屬於持續投入,單獨覈算更清楚。
| 成本類別 | 產生原因 | 統計要點 |
|---|---|---|
| 輸入 Token | 系統提示、任務說明、歷史上下文、工具返回 | 按輪次累計,區分可緩存部分 |
| 輸出 Token | 操作指令、生成的代碼、決策與推理 | 高推理強度會顯著增加輸出 |
| 視覺輸入 | 每輪截圖及界面理解 | 按模型的圖像計費規則單獨統計 |
| 工具調用 | 內置工具、託管瀏覽器、代碼執行 | 內置工具消耗的 Token 按對應模型計費 |
| 運行環境 | 瀏覽器、虛擬機、容器 | 只在實際使用對應服務時計入 |
| 失敗重試 | 頁面加載異常、定位失敗、操作錯誤 | 若重試 Token 已計入總量,不要重複加算 |
運行環境的計費差異很大。OpenAI 定價頁列出的 Hosted Shell 與 Code Interpreter 容器費用爲:1 GB 每 20 分鐘 0.03 美元,4 GB 爲 0.12 美元,16 GB 爲 0.48 美元,64 GB 爲 1.92 美元。文件與圖片上傳存儲按 0.10 美元/GB-day 計費。如果開發者在自己的服務器上運行 Playwright 或桌面執行器,這部分就變成自有基礎設施成本,結構完全不同。
因此,覈算時需要分清三個層次:模型成本是處理輸入輸出的費用,運行成本是瀏覽器、服務器、容器等基礎設施費用,工程成本是工作流設計、測試、監控和維護的人力投入。只看第一層,預算一定偏低。
爲什麼有些醫療 Agent 不應該每次都調用大模型?
CVS Health 在公告中披露了生產環境案例。一個 Agent 在一個週末清理了積壓數月的文件發送任務,另一個 Agent 每天處理數萬次專科會診中的系統操作步驟。這裏的”數萬次”指操作步驟,不是由 AI 獨立完成的臨牀決策。系統同時配有驗證檢查、人工監督,以及基於截圖和操作記錄的狀態覈查。
更值得開發者關注的是 CVS 開源的 CUA Agent Kit(Apache-2.0 許可)。它把自動化分爲兩個階段:先由 OpenAI Computer Use Agent 按自然語言執行任務,記錄截圖、動作、目標位置和 Trace;再由 Codex Skill 根據成功的軌跡,生成或更新確定性工作流代碼,並經工程師審查。README 說明,確定性運行階段不需要模型 API Key。
這套設計直接針對成本問題:探索未知流程時需要大模型推理,重複執行已知流程時交給普通代碼。只要流程穩定,單次運行就不再支付視覺輸入和推理費用,結果波動也會減小。項目的一個核心觀點是,”發現如何完成任務”和”長期穩定地重複執行”是兩個不同的問題。
傳統 RPA 與 Agent 的關係也可以從這個角度理解。一項 RPA 比較研究(DOI: 10.1080/23311975.2026.2724760)中,P2、P3 兩項任務每種技術各運行 10 次,P1 任務的 Agent 只運行了 1 次且失敗,未納入後續統計,因此不能籠統地說”所有任務都執行了 10 次”。該研究使用的是 2025 年的工具配置,不能當作 2026 年模型的直接成績。不過它提示了一點:評估自動化方案時,重複運行的穩定性和單次成功同樣重要。
分析判斷:醫療 Agent 成本賬該怎麼算
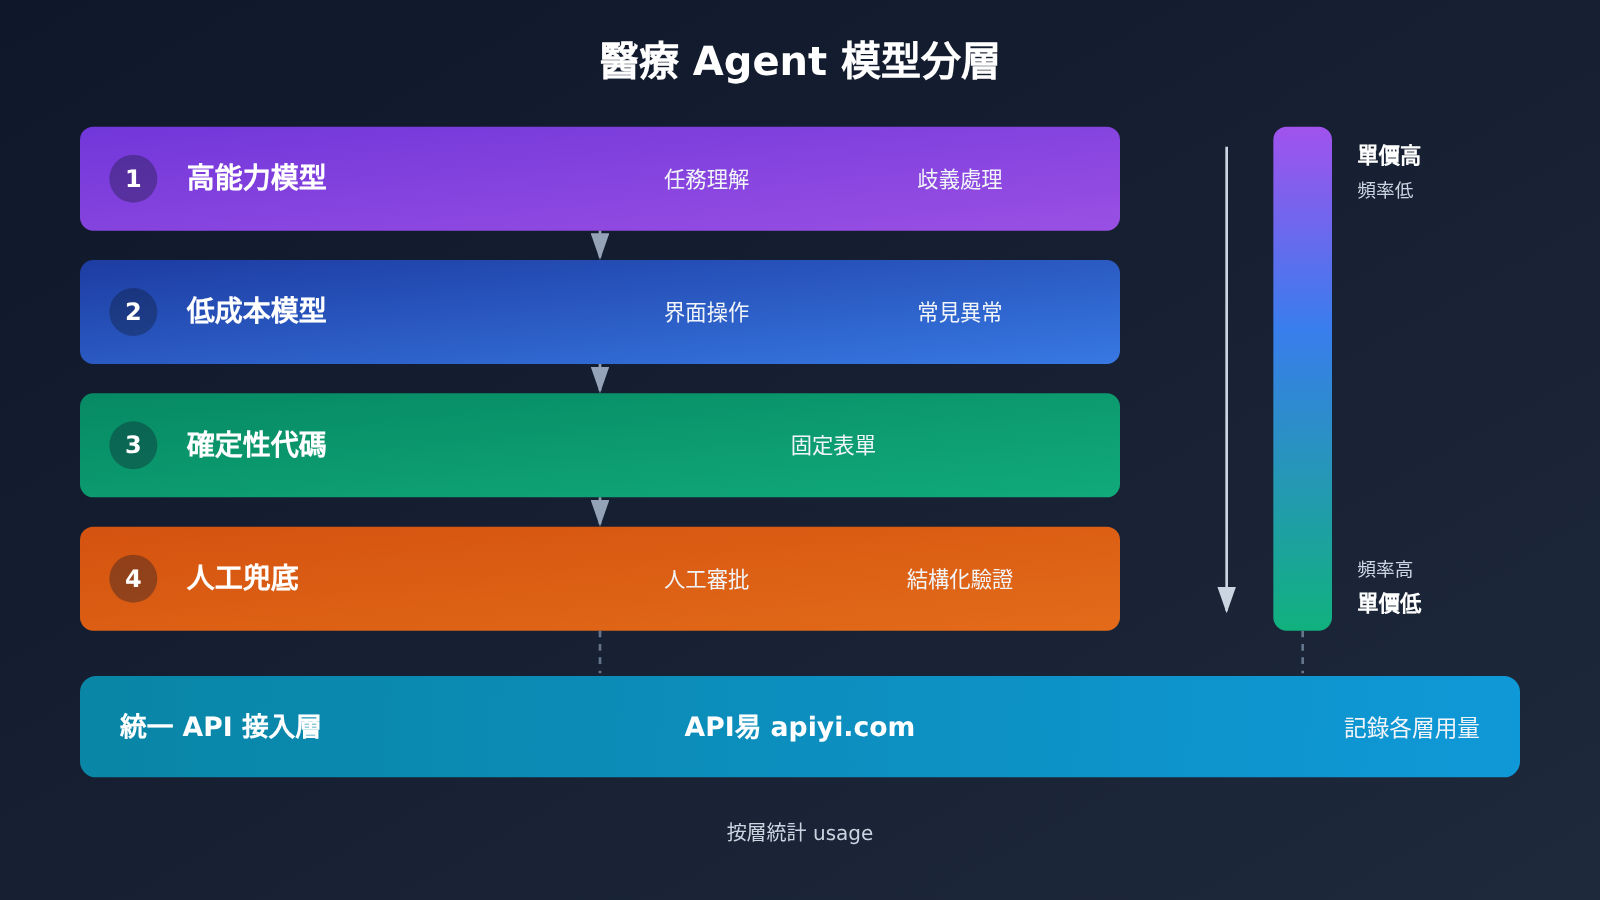
高能力模型與低成本模型如何在醫療 Agent 中分工?
基準數據顯示,Luna 的評分點佔比比 Astra 低 2.5 個百分點,成本卻只有 Astra 的約 2%。這說明,在結構化程度較高的行政任務中,低成本模型已經具備可觀的執行能力。但評分點差距不等於端到端成功率差距,少拿的那部分分數如果恰好落在文件上傳或狀態更新等關鍵步驟,業務結果可能完全不同。這是我們的判斷,需要用自己的任務數據來驗證。
更穩妥的做法是按階段分配,而不是整個任務只用一個模型:
| 工作階段 | 建議承擔者 | 理由 |
|---|---|---|
| 理解複雜任務、拆解步驟 | 高能力模型 | 出錯代價高,調用次數少 |
| 處理病歷歧義、模糊信息 | 高推理模型 + 人工確認 | Ambience 的方案在歧義時停止並詢問醫生 |
| 常規界面操作 | 低成本模型 | 調用次數多,對單價最敏感 |
| 重複填寫固定表單 | 確定性代碼 | 參照 CUA Agent Kit 的代碼固化思路 |
| 常見異常處理 | 低成本模型或規則 | 模式固定,可逐步沉澱爲規則 |
| 關鍵操作審批 | 人工 | 提交、發送、簽署等動作保留人工最終權限 |
| 最終結果驗證 | 結構化檢查 + 人工抽查 | 以系統狀態爲準,而非模型的”已完成”聲明 |
這種分層的收益在於,高單價模型只出現在低頻、高價值的環節,高頻環節交給低成本模型或代碼。當多個模型並存時,統一的調用接口能降低切換成本。例如通過 API易 apiyi.com 這類 OpenAI 兼容網關,開發者可以只改 model 參數來對比不同模型。具體可用的模型以平臺當前模型列表和賬戶權限爲準。
開發者怎樣計算自己的醫療 Agent 項目預算?
建議採用下面的單任務成本框架。其中 T 爲實際 Token 數,P 爲每百萬 Token 價格:
C_task = C_input + C_output + C_image + C_tools + C_runtime + C_retry

C_input  = T_input  × P_input  / 1,000,000   (可緩存部分按緩存價單列)
C_output = T_output × P_output / 1,000,000
C_image  = 按模型視覺計費規則,逐輪截圖單獨統計
C_retry  = 僅計尚未併入上述 Token 總量的重試開銷

單個成功任務成本 = 全部任務總成本 ÷ 成功任務數
月度預算 = 單個成功任務成本 × 月成功任務目標 + 工程維護投入
真正決定預算準確性的,是這幾項實測指標:單任務平均調用輪次、平均截圖數、失敗重試率、人工介入率和端到端成功率。用”單個成功任務成本”而不是”單次運行成本”做分母,能把失敗的消耗計入進去。
下表是我們自行構建的預算情景,所有用量均爲假設,僅用於演示計算方法。單價採用前文的官方 Standard 價格:
| 情景假設(自建,非實測) | 低成本模型(Luna 單價) | 高能力模型(Astra 單價) |
|---|---|---|
| 每任務 15 輪,每輪視覺 + 文本輸入 2 萬 Token | 30 萬 × $0.10/M = $0.030 | 30 萬 × $10/M = $3.00 |
| 每輪輸出 500 Token | 7,500 × $0.50/M ≈ $0.004 | 7,500 × $50/M = $0.375 |
| 單次運行模型成本 | 約 $0.034 | 約 $3.38 |
| 假設端到端成功率 80% 後的單個成功任務成本 | 約 $0.042 | 約 $4.22 |
| 月成功任務 10,000 次的模型成本 | 約 $420 | 約 $42,200 |
| 託管容器(4 GB,每 20 分鐘串行 4 個任務) | 約 $300/月 | 約 $300/月 |
這個情景揭示了一個容易被忽略的現象:當模型足夠便宜時,運行環境費用可能與模型費用處於同一量級,甚至更高。優化方向隨之改變,從”換更便宜的模型”變成”減少截圖輪次、複用容器、把固定步驟改成代碼”。這是情景推演得出的判斷,實際比例要以您的實測數據爲準。
採集真實用量最直接的辦法,是在每次模型調用後記錄 usage 字段。下面是最簡示例:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="YOUR_MODEL_NAME",  # 以 API易 後臺模型列表爲準
    messages=[{"role": "user", "content": "根據以下字段生成預授權申請覈對清單:..."}],
)
u = resp.usage
print("input:", u.prompt_tokens, "output:", u.completion_tokens)
查看按任務累計成本的完整實現代碼
from dataclasses import dataclass, field
from openai import OpenAI

# 2026-11-17 官方 Standard 短上下文價格(美元/百萬 Token),實際以對應計費檔位爲準
PRICES = {
    "gpt-6-luna":  {"input": 0.10,  "cached": 0.01, "output": 0.50},
    "gpt-6-astra": {"input": 10.00, "cached": 1.00, "output": 50.00},
}

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # 統一接入,後臺可對照 Token 與費用日誌
)

@dataclass
class TaskCostMeter:
    model: str
    rounds: int = 0
    screenshots: int = 0
    retries: int = 0
    input_tokens: int = 0
    cached_tokens: int = 0
    output_tokens: int = 0
    runtime_usd: float = 0.0
    log: list = field(default_factory=list)

    def record(self, usage, has_screenshot=False, is_retry=False):
        self.rounds += 1
        self.screenshots += int(has_screenshot)
        self.retries += int(is_retry)
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        self.cached_tokens += cached
        self.input_tokens += usage.prompt_tokens - cached
        self.output_tokens += usage.completion_tokens
        self.log.append((self.rounds, usage.prompt_tokens, usage.completion_tokens))

    def model_cost(self):
        p = PRICES[self.model]
        return (self.input_tokens * p["input"]
                + self.cached_tokens * p["cached"]
                + self.output_tokens * p["output"]) / 1_000_000

    def total_cost(self):
        # 重試輪次的 Token 已在 record 中累計,這裏不再重複加算
        return self.model_cost() + self.runtime_usd

def cost_per_success(meters, success_flags):
    total = sum(m.total_cost() for m in meters)
    wins = sum(success_flags)
    return total / wins if wins else float("inf")
🎯 預算建議:先挑 20 到 50 個真實任務樣本做小規模試跑,再做月度測算。通過 API易 apiyi.com 統一接入時,可以對照後臺的 Token 消耗與費用日誌校驗自己的計量結果,新用戶的免費測試額度足夠完成這一步。
從模型價格到 API 成本管理:醫療 Agent 網關能做什麼
Agent 項目進入多模型階段後,成本失控往往不是因爲單價高,而是因爲沒人說得清哪個環節、哪個模型消耗了多少。API Gateway 的價值在於把分散的調用匯集到一處:統一的 Key 與 Endpoint、按模型拆分的用量日誌、可回溯的費用明細,團隊據此才能發現某個步驟截圖過多,或者某類異常反覆觸發重試。
以 API易 爲例,根據其快速開始文檔,接入方式是註冊賬戶、在 Token 頁面獲取 API Key,然後把原 OpenAI Endpoint 替換爲 https://api.apiyi.com,部分應用需在地址後添加 /v1。官方 SDK 和代碼示例可以直接使用,後臺可查看模型、Token 消耗和費用日誌,頁面標註 OpenAI 和 Claude 費率與官方一致,並支持開票。對於需要在多個模型之間做分層和對比的團隊,API易 apiyi.com 提供了一個按量計費、統一計量的接入層。
它的邊界也需要說清楚。API 網關解決的是模型調用的接入與計量,不是 Agent 執行器:瀏覽器和桌面環境、截圖採集、業務權限控制、人工審批流程和工作流維護,仍需開發者自行構建。在醫療場景中,HIPAA 合規還取決於適用產品資格、BAA、安全配置和數據治理,不會因爲換了接入方式就自動滿足。具體某個 GPT-6 模型能否調用,也要以平臺當前的模型列表爲準。
回到 8.5 美分這個數字,它證明了低成本模型在高頻行政自動化中的潛力,卻回答不了您的工作流要花多少錢。答案只能來自自己的任務樣本、自己的成功率和自己的用量日誌。正如那句英文諺語所說:
The proof of the pudding is in the eating.
(布丁好不好,喫了才知道;實際效果要靠實踐檢驗。)
參考資料
- OpenAI 醫療 Computer Use Agent 公告:HealthAdminBench 得分與單任務成本的原始出處
- 鏈接:
openai.com/index/advancing-computer-use-for-healthcare-teams
- 鏈接:
- OpenAI API 定價頁:GPT-6 Astra、GPT-6 Luna Token 價格及容器費用
- 鏈接:
developers.openai.com/api/docs/pricing
- 鏈接:
- OpenAI Computer Use 開發者文檔:執行循環、Computer Tool 與 Code Execution 兩種路徑
- 鏈接:
developers.openai.com/api/docs/guides/tools-computer-use
- 鏈接:
- HealthAdminBench 論文 v1:135 任務、1698 子任務的明確版本
- 鏈接:
arxiv.org/html/2604.09937v1
- 鏈接:
- CVS Health CUA Agent Kit:AI 探索與代碼固化的開源實現
- 鏈接:
github.com/cvs-health/cua-agent-kit
- 鏈接:
- RPA 比較研究:重複運行設計與例外說明
- 鏈接:
doi.org/10.1080/23311975.2026.2724760
- 鏈接:
- 諺語釋義覈對:Cambridge Dictionary
- 鏈接:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- 鏈接:
作者: API易 技術團隊
技術交流: 歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入說明可訪問 docs.apiyi.com 文檔中心


