
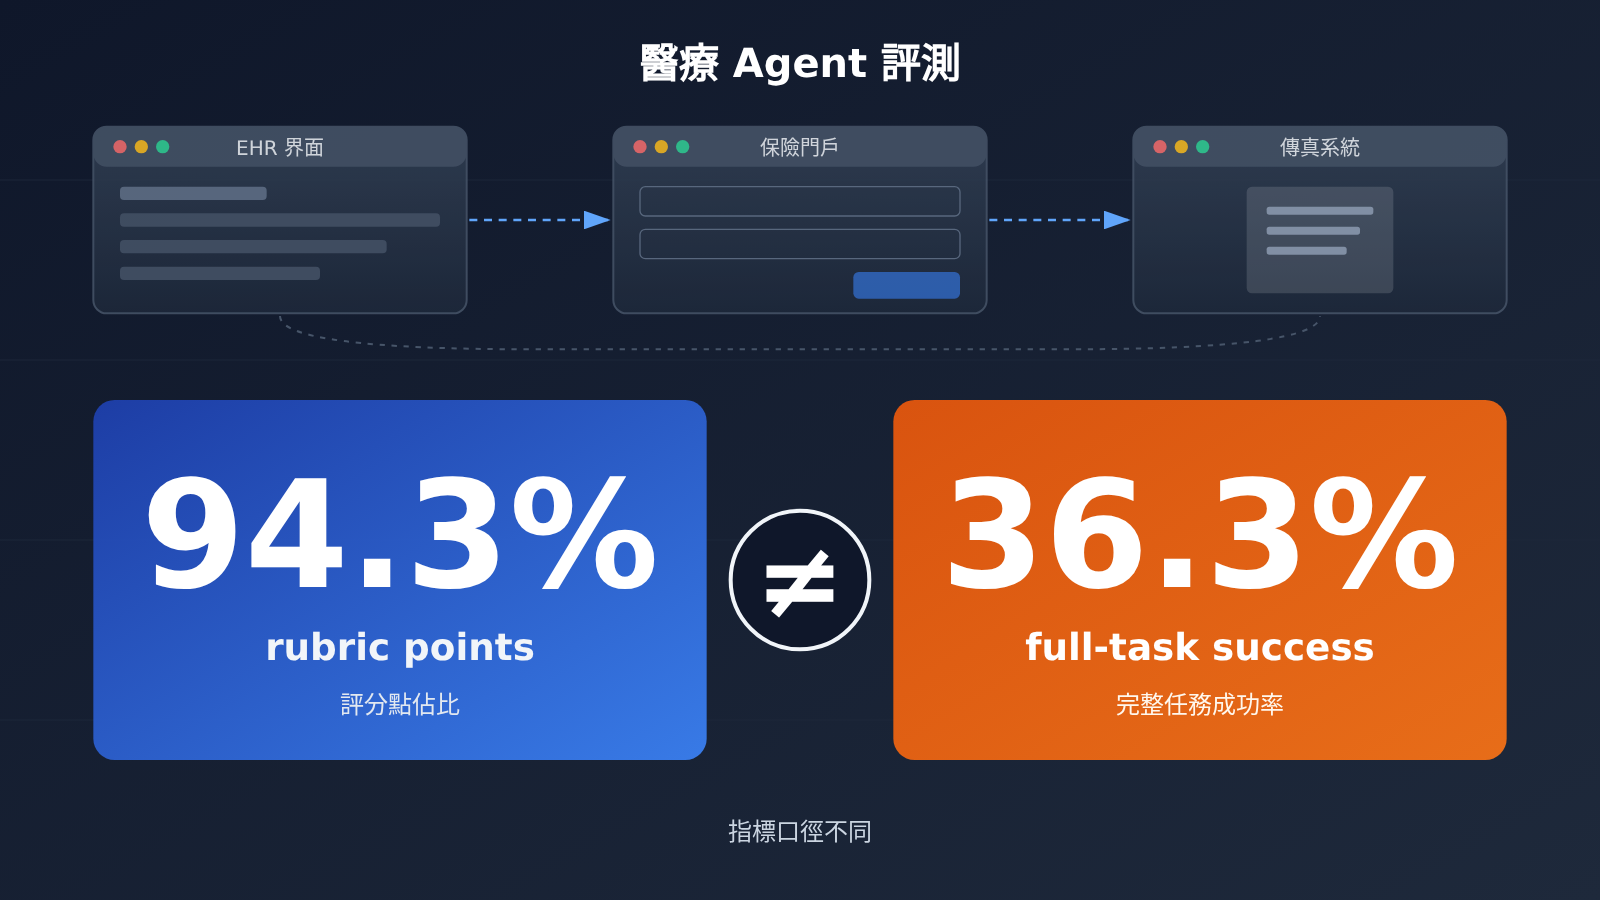
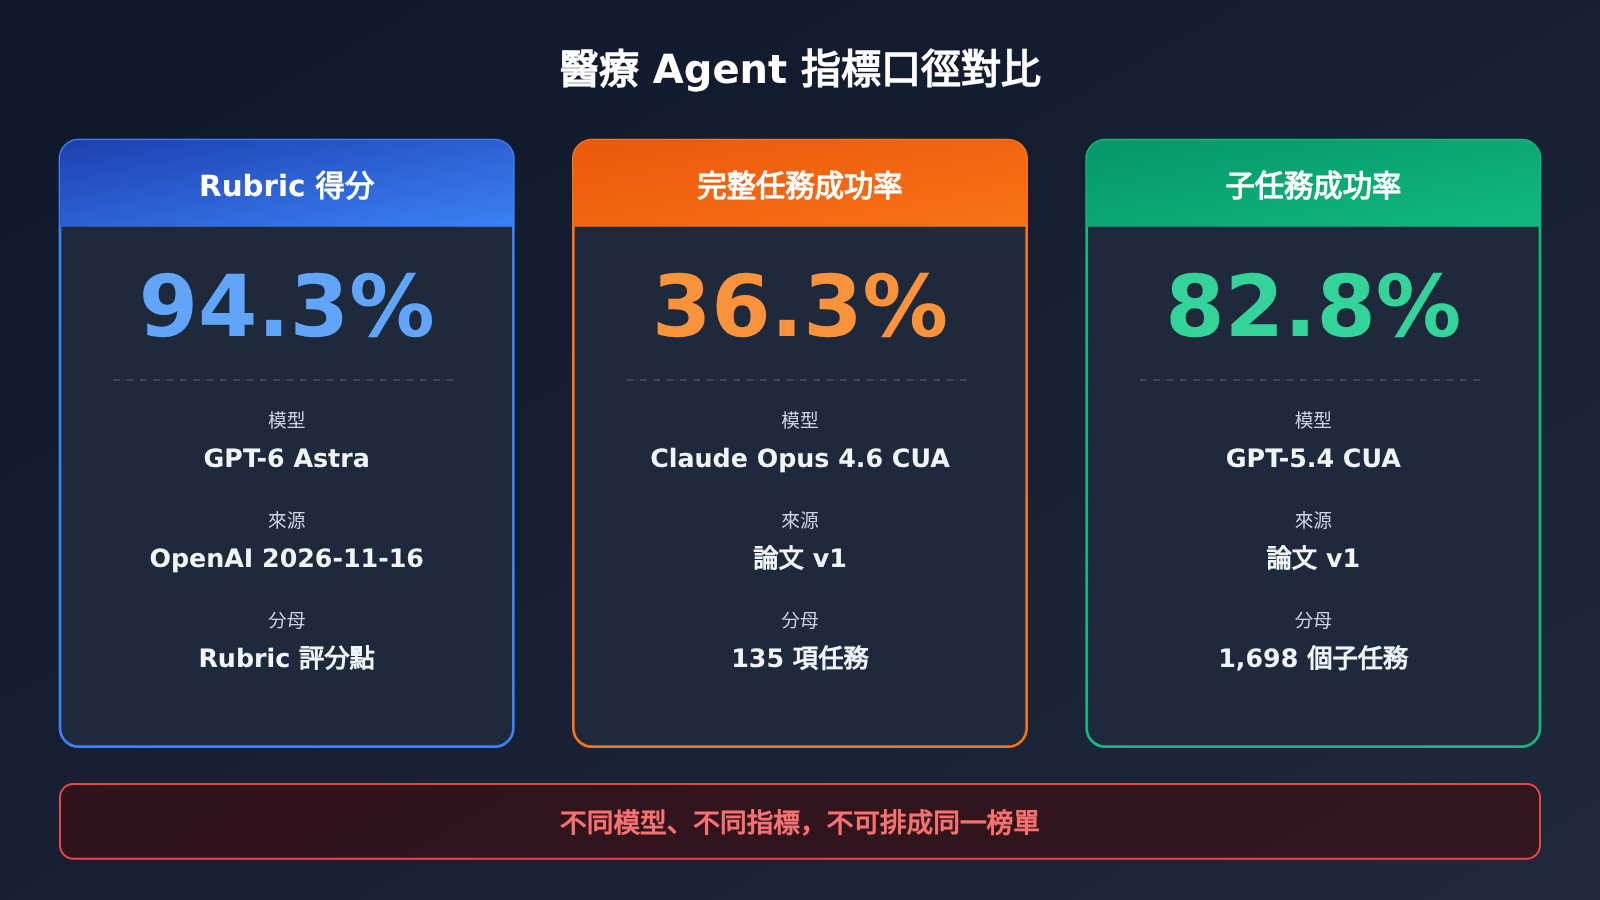
94.3% 不代表 94.3% 的醫療行政任務被完整做完。OpenAI 在 2026 年 11 月 16 日公佈的 GPT-6 Astra 94.3%,是 HealthAdminBench 的 rubric points(評分點)得分比例;斯坦福 Shah Lab 論文中 Claude Opus 4.6 CUA 的 36.3%,是完整任務成功率(full-task success)。前者衡量“滿足了多少評分點”,後者衡量“有多少任務全部滿足成功條件”,兩者不是同一指標,也不能排進同一張榜單。
醫療 Agent 可以在信息檢索、文檔處理、表單填寫等單項操作上表現很好,卻依然無法穩定走完一條跨系統業務流程。判斷一個 Agent 是否具備生產價值,需要同時看子任務表現、端到端成功率、錯誤類型、執行成本和人工介入情況,任何單一分數都不夠。
您讀完此文能瞭解到什麼?
- 94.3% 與 36.3% 分別統計的是什麼,爲什麼不能直接比較
- HealthAdminBench 的任務構成、評分點來源和兩種驗證機制
- 一套面向生產環境、可遷移到其他企業 Agent 的評價維度
索引:客觀事實部分依次交代 94.3% 的成績爲什麼引起關注、HealthAdminBench 究竟測量什麼、子任務成功與完整任務成功的區別、醫療 Agent 最容易在哪些環節失敗,以及同一模型爲何會因執行框架不同而表現不同;分析判斷部分則討論如何建立綜合評測框架、如何覈算成本,以及企業在應用中應當怎樣取捨。
To Know:讀懂醫療 Agent 評測的 7 個概念
| 概念 | 簡要解釋 |
|---|---|
| Computer Use | 通過觀察軟件界面並模擬點擊、輸入、滾動等操作來完成任務的能力 |
| EHR | 電子健康記錄系統,醫院存儲患者診療信息的核心軟件 |
| MCP | 用於發現和調用外部工具的標準協議 |
| RPA | 通過預先配置的規則或腳本執行重複流程的自動化方式 |
| Rubric points | 按評測規則獲得的評分點,用於衡量部分要求的達成情況 |
| 端到端成功率 | 完整任務滿足全部成功條件的比例,任何一個關鍵條件失敗即判爲失敗 |
| Trace | 記錄執行過程、操作動作和界面狀態的軌跡證據 |
醫療 Agent 評測影響速覽
- 開發者與技術負責人:不能只引用廠商公佈的單一分數做選型,需要按自身任務驗證執行機制、端到端完成率以及包含截圖、重試、運行環境在內的完整成本。
- 醫療機構與工作流負責人:需要區分合成環境中的演示、基準評測、機構試點和生產案例這四類證據,並在部署時落實人工審批、最小權限和操作審計。
客觀事實:94.3% 與 36.3% 背後的醫療 Agent 評測
94.3% 的成績爲什麼引起關注?
2026 年 11 月 16 日,OpenAI 發佈面向醫療團隊的計算機操作 Agent 進展,並披露了多組評測數據。其中 GPT-6 Astra 在 HealthAdminBench 上得分 94.3%,GPT-6 Luna 得分 91.8%,兩者均在最高推理強度(maximum reasoning effort)下評測。OpenAI 同時公佈,Luna 的單任務成本爲 0.085 美元,比 Astra 低 98%。
這些數字之所以引人注目,是因爲斯坦福此前公開的 HealthAdminBench 結果明顯更低。需要強調的是,OpenAI 公佈的 94.3% 和 91.8% 是 rubric points 得分比例,而不是獨立的完整任務成功率。同一份公告中的另外兩組數據,同樣來自不同評測環節,分母各不相同:
| 指標 | 數值 | 分母/口徑 | 不代表什麼 |
|---|---|---|---|
| HealthAdminBench 得分(Astra) | 94.3% | rubric points 佔比 | 完整任務成功率 |
| HealthAdminBench 得分(Luna) | 91.8% | rubric points 佔比 | 完整任務成功率 |
| 臨牀任務安全性(Astra) | 99% | 325 項經審覈任務 | 醫學診斷準確率 |
| 醫生高度認可佔比(Astra) | 93% | 646 次醫生評價 | 任務成功率,也不等於 646 名醫生 |
| Luna 單任務成本 | $0.085 | 特定評測條件下的每任務成本 | 生產部署報價 |
這三套數據分母不同,不能合併成一個“綜合準確率”。此外,OpenAI 公告正文沒有公開逐任務結果、完整實驗配置、置信區間和全部失敗案例,外界目前無法獨立複覈 94.3% 的得分構成。Astra 的單任務成本約爲 4.25 美元,這是按 98% 降幅反推的估算值,並非官方直接公佈的價格。
HealthAdminBench 究竟測量什麼?
HealthAdminBench 由斯坦福大學 Shah Lab 提出,專門評測計算機操作 Agent 在醫療行政任務中的表現。它的公開版本前後有差異:早期研究網頁描述的是 70 項任務、947 個評分點、6 個 Agent;論文 2604.09937v1 版本擴展到 135 項任務、1,698 個可驗證子任務、7 組模型配置。本文以論文版本爲準,早期網頁數據只作歷史對照。
論文版本的四個模擬 GUI 環境分別是 EHR、保險支付門戶 A、保險支付門戶 B 和傳真門戶。135 項任務分爲三類行政工作流:
| 任務類型 | 數量 | 主要內容 |
|---|---|---|
| Prior Authorization(預授權) | 60 | 保險資格覈驗、收集病歷、提交預授權申請 |
| Appeals and Denials Management(申訴與拒賠) | 60 | 審查拒賠、收集證明、準備並提交申訴 |
| DME Order Processing(醫療設備訂單) | 15 | 收集醫療設備資料、提交訂單、記錄結果 |
1,698 個評分點由兩種機制產生。1,177 項採用確定性檢查,藉助 JMESPath 等結構化手段覈對系統狀態,比如是否找到正確患者、是否填寫指定字段、是否生成正確訂單,思路接近傳統軟件測試。另外 521 項交給 LLM Judge 判斷,主要評估文檔內容是否充分、提交材料是否符合要求等難以用規則直接驗證的部分。
所有任務都使用合成患者數據,而非真實患者記錄。這意味着該基準提供的是一個可復現的測試環境,並不是在真實醫院生產系統中進行測試,也不直接測量患者護理結果。
子任務成功與完整任務成功有什麼區別?
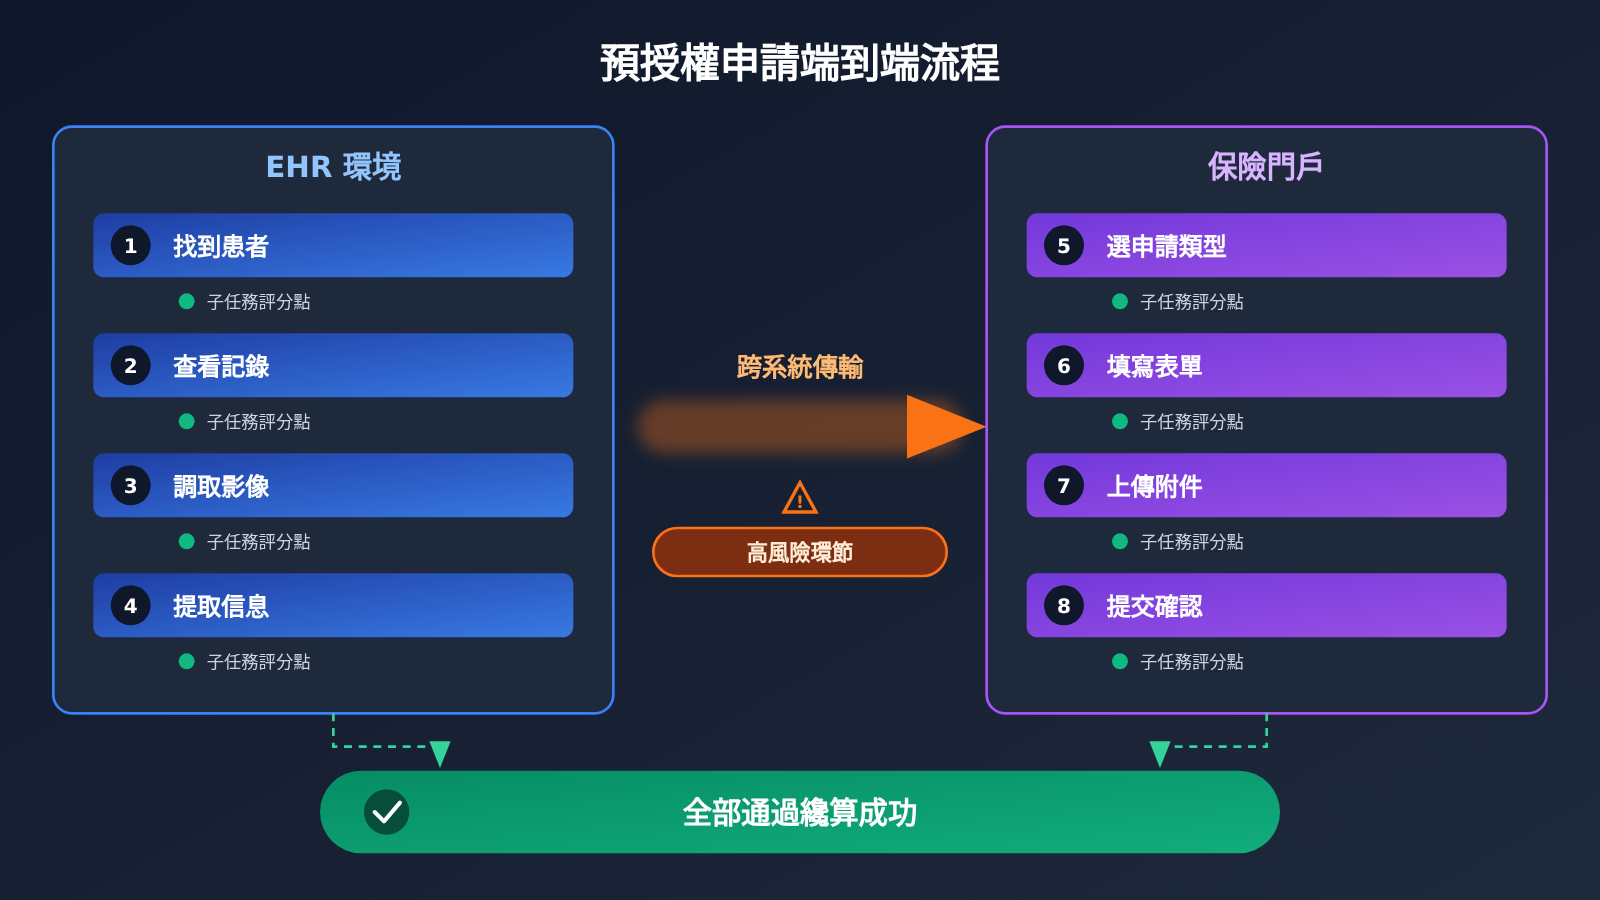
用一條預授權申請流程最容易看清兩者的差別。按照研究資料的描述,一項預授權任務可能要求 Agent 依次完成:
- 在 EHR 中找到正確的患者
- 查看患者的診療記錄
- 找到影像檢查和既往治療材料
- 判斷保險申請需要哪些證明
- 從病歷中提取所需信息
- 進入保險支付門戶
- 選擇正確的申請類型
- 填寫申請表
- 附加所需文件
- 提交申請並確認狀態
這十步之間存在強依賴關係。第 1 步選錯患者,後面每一步做得再規範都是錯的;前九步全部正確,但第 9 步漏傳附件或第 10 步沒有真正提交,整項任務仍然判爲失敗。子任務成功率統計的是“十步中做對了幾步”,完整任務成功率統計的是“十步是否全部做對”。
論文給出的數據清楚體現了這種落差:GPT-5.4 CUA 的子任務成功率爲 82.8%,而 Claude Opus 4.6 CUA 的完整任務成功率爲 36.3%。這兩個數字分屬不同模型,同樣不能直接對比,但它們共同說明一個事實:局部動作完成與整個業務流程完成,是兩種不同的能力。
早期研究網頁也報告過類似的落差:Claude Opus 4.5 的最佳完整任務成功率爲 22.9%,Gemini 3 的子任務成功率爲 76.4%。由於任務規模和版本不同,這些數字只能用來觀察趨勢,不能與論文版本或 OpenAI 的結果放進同一排名。
醫療 Agent 最容易在哪些環節失敗?
論文按子任務類別公佈了兩組 CUA 配置的成績:
| 子任務類別 | Claude Opus 4.6 CUA | GPT-5.4 CUA |
|---|---|---|
| 信息檢索 | 96.5% | 96.1% |
| 文檔編制 | 74.3% | 84.4% |
| 表單填寫 | 88.9% | 84.9% |
| 任務解決 | 70.7% | 66.2% |
| 文檔處理 | 92.3% | 94.3% |
| 臨牀推理 | 61.3% | 77.0% |
需要特別提醒:表中 GPT-5.4 CUA 在文檔處理上的 94.3%,與 OpenAI 公佈的 GPT-6 Astra 總體 rubric points 94.3% 只是數字巧合,兩者的模型、指標和來源完全不同。
從分項看,信息檢索已經接近飽和,而臨牀推理、任務解決和文檔編制相對較弱。論文同時指出,文檔處理(Document Handling)和跨系統數據傳輸(Cross-system Data Transfer)是導致端到端失敗的主要問題。早期網頁版本曾報告六個模型中有五個在文檔處理子任務上準確率低於 20%,但那屬於不同版本的任務設定,不能與上表直接比較。
跨系統傳輸爲什麼特別容易出錯?在預授權流程中,同一份信息要從 EHR 讀出、在 Agent 的上下文中保存、再寫入保險門戶的另一種表單結構,附件還可能經過傳真門戶流轉。每一次轉移都是一次可能出錯的機會,而上游的一個錯誤會被原樣複製到下游系統。OpenAI 資料中列出的風險裏,也包括“將錯誤信息從一個系統傳播到另一個系統”和“在系統狀態不明確時錯誤報告任務完成”。
爲什麼同一個模型會因執行框架不同而表現不同?
論文做了提示方式和觀察模式的消融實驗,主要發現有三點:
- 提供 Portal Guidance(門戶操作指導)通常比只給任務描述表現更好
- Accessibility Tree(無障礙結構樹)觀察方式通常優於純截圖觀察
- 門戶操作指導與結構化頁面信息結合時,端到端表現通常更好
論文也指出,真實生產環境未必能提供完整的 Accessibility Tree。換言之,Agent 的成績不僅取決於底層模型,還取決於執行框架(Harness)、頁面觀察方式、提示詞和任務說明。
OpenAI 的開發者文檔同樣體現了執行路徑的差異。官方指南分別說明了 ComputerToolset、BrowserToolset 與託管瀏覽器入口;對 GPT-6 Astra,當前文檔推薦 Code Execution 方式,即由模型生成 Playwright 等代碼來操作界面,Computer Tool 仍作爲可選方案。文檔還強調,模型生成操作指令不等於操作已經成功,應用必須執行後再通過新截圖或其他方式驗證結果。
CVS Health 開源的 CUA Agent Kit(Apache-2.0)則提供了另一種工程思路。其 README 公開的機制是:先由 Computer-use Agent 探索工作流並保存截圖、動作和 Trace 作爲證據,再由 Codex Skill 把成功軌跡固化爲確定性代碼,並經過工程師審查;後續確定性運行不需要模型 Key。這把“發現怎麼做”和“穩定重複地做”拆成了兩個問題。
分析判斷:如何評價真正可用的醫療 Agent
怎樣評價一個真正可用的 Agent?
以下是本文的判斷,而非任何機構的官方標準。我們認爲,94.3% 這類 rubric points 分數適合回答“模型的局部能力進步了多少”,但不足以回答“能不能放進生產流程”。後一個問題需要一組相互制約的指標:
| 評價維度 | 衡量什麼 | 爲什麼需要 | 數據來源 |
|---|---|---|---|
| 端到端成功率 | 完整任務全部滿足成功條件的比例 | 業務只認最終結果 | 系統最終狀態校驗 |
| 關鍵步驟準確性 | 選患者、提交、上傳附件等關鍵節點的正確率 | 關鍵步驟一錯全錯 | 確定性檢查 |
| 錯誤嚴重程度 | 失敗是可恢復的遺漏,還是寫錯數據、錯發消息 | 同樣的失敗率風險差異巨大 | 人工複覈 + 分級標籤 |
| 人工介入率 | 需要人工接管或審批修正的比例 | 決定實際節省的人力 | 審批日誌 |
| 執行時間 | 單任務耗時與長尾耗時 | 影響吞吐與排隊 | Trace 時間戳 |
| 單任務完整成本 | 模型、截圖、重試、運行環境、維護的總和 | Token 單價無法代表真實成本 | 賬單 + 運行記錄 |
| 異常恢復能力 | 遇到歧義、超時、頁面變化時能否停止或回退 | 醫療場景必須“會停” | 故障注入測試 |
這套框架的核心,是把“做對了多少步”和“做成了多少件事”分開報告,再用錯誤嚴重程度和人工介入率修正兩者。Ambience 展示的方案正好體現了“異常恢復”這一維度:當病歷存在歧義時,Agent 停下來詢問醫生,並在醫生批准後才提交預授權申請。這只是該公司展示的治理方案,並不意味着所有醫療 Agent 默認具備相同配置。
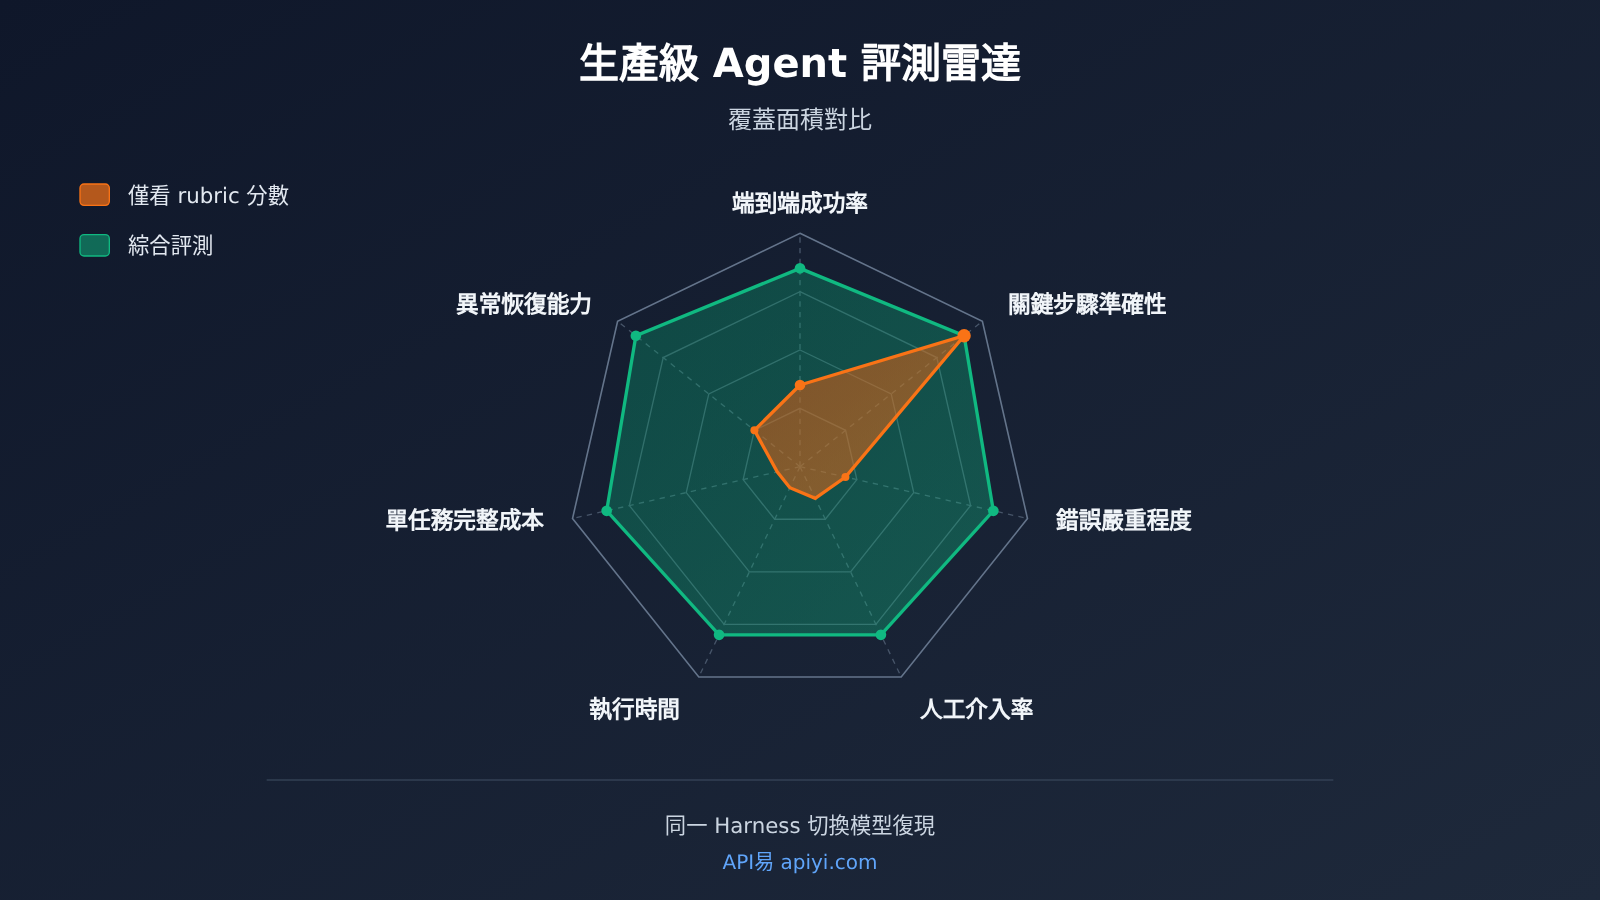
樣本量和重複次數同樣要公開。一項比較 RPA 與 Agent 的研究(DOI: 10.1080/23311975.2026.2724760)在 P2、P3 兩個流程上對每項技術各執行 10 次,但在 P1 上 Agent 僅執行 1 次且失敗,未納入後續統計;該研究使用的是 2025 年的工具配置,不能當作 2026 年模型的直接成績。這個例子說明,讀評測結論時要先看每個數字背後跑了幾次、哪些結果被排除。
醫療 Agent 評測的落地做法:同一 Harness 下自己跑
對開發團隊來說,最實際的做法是固定執行框架,在自己的任務集上同時統計子任務和端到端兩套指標。下面的示例用一個 LLM Judge 給 Agent 的提交材料打分,接口兼容 OpenAI SDK:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 統一接口,可切換不同裁判模型
)

resp = client.chat.completions.create(
    model="YOUR_JUDGE_MODEL",
    messages=[
        {"role": "system", "content": "你是評測裁判,只輸出 PASS 或 FAIL 及一句理由。"},
        {"role": "user", "content": "要求:附上影像報告與既往治療記錄。\n提交內容:<Agent 提交的材料摘要>"}
    ]
)
print(resp.choices[0].message.content)
查看完整實現:同時計算子任務成功率與端到端成功率
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

@dataclass
class Subtask:
    name: str
    critical: bool          # 是否爲關鍵步驟(失敗即整任務失敗)
    passed: bool = False

@dataclass
class TaskResult:
    task_id: str
    subtasks: list = field(default_factory=list)
    human_intervened: bool = False
    cost_usd: float = 0.0   # 已含重試 Token,勿重複累加

def llm_judge(requirement: str, submission: str, model: str) -> bool:
    """對難以規則化的子任務使用 LLM Judge"""
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "只輸出 PASS 或 FAIL。"},
            {"role": "user", "content": f"要求:{requirement}\n提交:{submission}"}
        ]
    )
    return resp.choices[0].message.content.strip().upper().startswith("PASS")

def summarize(results: list) -> dict:
    total_sub = sum(len(r.subtasks) for r in results)
    passed_sub = sum(s.passed for r in results for s in r.subtasks)
    full_success = sum(all(s.passed for s in r.subtasks) for r in results)
    critical_fail = sum(
        any(s.critical and not s.passed for s in r.subtasks) for r in results
    )
    n = len(results)
    return {
        "subtask_rate": passed_sub / total_sub,
        "end_to_end_rate": full_success / n,
        "critical_failure_rate": critical_fail / n,
        "human_intervention_rate": sum(r.human_intervened for r in results) / n,
        "avg_cost_usd": sum(r.cost_usd for r in results) / n,
    }
🎯 技術建議:子任務得分和端到端成功率最好在同一套 Harness、同一批任務上並排報告。通過 API易 apiyi.com 的 OpenAI 兼容接口,可以用一個 API Key 在 OpenAI、Claude、Gemini 等模型之間切換執行模型或裁判模型,減少因接入方式不同帶來的變量。
醫療 Agent 成本覈算與模型分層
Token 單價只是起點。按 2026 年 11 月 17 日 OpenAI 公佈的 Standard 短上下文價格,GPT-6 Astra 輸入、輸出、緩存輸入分別爲每百萬 Token 10、50、1 美元,GPT-6 Luna 爲 0.10、0.50、0.01 美元;處理速度、上下文長度和地域都會影響實際計費。Computer Use 是多輪調用,每輪截圖都算視覺輸入,因此覈算時應把每輪視覺/文本輸入和計費輸出分別統計,再加上工具、運行環境和工程維護;重試消耗的 Token 如果已計入總量,就不要再重複加一次。
從 0.085 美元與約 4.25 美元的差距看,模型分層很可能成爲常態:複雜、需要強推理的任務交給高能力模型,結構化程度高、頻次大的任務交給低成本模型,而已經跑通的固定流程則像 CVS 的思路那樣固化爲確定性代碼。需要說明,這些單任務成本來自特定基準條件,不能作爲生產報價。
💰 成本優化:做分層選型前,建議先用小批量真實任務測出各模型的端到端成功率和單任務完整成本。API易 apiyi.com 採用按量計費,新用戶有免費測試額度,適合在立項階段低成本完成這類對照實驗。
從醫療 Agent 到企業 Agent:可遷移的評測思路
醫療行政的特殊性在於高風險和強監管,但它暴露的問題在保險理賠、財務對賬、供應鏈單據等企業流程中同樣存在:多系統、強依賴、跨系統搬運數據。我們的判斷是,以下四條原則可以直接遷移:
- 拆開報告:子任務得分與端到端成功率分列,絕不用前者代替後者
- 標註證據等級:合成環境演示、廠商自評、第三方基準、企業試點和生產案例分別歸屬,不混用
- 固定 Harness 再比較:觀察方式、提示詞、門戶指導一旦變化,成績就不再可比
- 治理優先於分數:最小權限、關鍵動作人工審批、操作後狀態驗證、全程 Trace 留痕和異常停止機制,應在上線前就作爲驗收項
在企業內部做 PoC 時,可以把任務集按“關鍵步驟”打標籤,先跑出端到端基線,再逐步引入門戶指導、結構化觀察或代碼固化,觀察每項改動對完整成功率的真實貢獻。如果需要在多個模型之間快速復現同一批任務,可以通過 API易 apiyi.com 統一接入,降低橫向對比的工程成本。
值得持續關注的後續發展包括:OpenAI 是否公開 94.3% 背後的逐任務結果與實驗配置;HealthAdminBench 後續版本是否在同一口徑下發布新模型的完整任務成功率;以及更多機構能否披露真實生產環境中的人工介入率和錯誤分級數據。在這些信息出現之前,任何關於“醫療行政已可全面自動化”的說法都屬於推測。
94.3% 證明了模型在評分點上的顯著進步,36.3% 則提醒人們:一條業務流程能否被可靠完成,最終要在完整任務、真實系統和人工監督下檢驗。正如那句英文諺語所說:“The proof of the pudding is in the eating.”(布丁好不好,喫了才知道;實際效果要靠實踐檢驗。)
參考資料
- OpenAI:Advancing computer-use agents for healthcare teams:94.3%、91.8%、99%、93% 等評測數據與合作案例
- 鏈接:
openai.com/index/advancing-computer-use-for-healthcare-teams/
- 鏈接:
- HealthAdminBench 論文 2604.09937v1:135 項任務、1,698 個子任務、分項結果與消融實驗
- 鏈接:
arxiv.org/html/2604.09937v1
- 鏈接:
- HealthAdminBench 項目頁與代碼倉庫:基準環境與評測實現
- 鏈接:
som-shahlab.github.io/health-admin-bench-website/ - 鏈接:
github.com/som-shahlab/health-admin-bench
- 鏈接:
- Stanford Shah Lab 早期研究頁面:70 項任務、947 個評分點的歷史版本
- 鏈接:
shahlab.stanford.edu/doku.php?id=healthadminbench
- 鏈接:
- OpenAI Computer Use 開發者文檔與 API 定價:執行路徑與 Standard 價格
- 鏈接:
developers.openai.com/api/docs/guides/tools-computer-use - 鏈接:
developers.openai.com/api/docs/pricing
- 鏈接:
- CVS Health CUA Agent Kit:探索、證據、代碼固化與工程師審查機制
- 鏈接:
github.com/cvs-health/cua-agent-kit
- 鏈接:
- RPA 與 Agent 比較研究:重複執行次數與 P1 例外說明
- 鏈接:
doi.org/10.1080/23311975.2026.2724760
- 鏈接:
- Cambridge Dictionary:諺語 proof of the pudding is in the eating 釋義
- 鏈接:
dictionary.cambridge.org/us/dictionary/english/proof-of-the-pudding-is-in-the-eating
- 鏈接:
作者:APIYI 技術團隊
技術交流:歡迎訪問 API易 apiyi.com 與我們交流 Agent 評測實踐,更多接入說明可查閱 docs.apiyi.com 文檔中心


