
作者注:本文借 Claude Fable 5.2 多代理做完兩道黑洞物理題的官方研究帖,整理重度 Agent 任務在選模型、拆角色、設停機線上的可落地做法。
2026 年 11 月 17 日,Anthropic 發了一篇研究帖:Claude Fable 5.2 的多份拷貝在後臺跑了大約六週,做完了兩道黑洞物理題。對跑長任務、多代理的開發者來說,這件事值得看的地方不在物理本身,而在於它展示了一種長時間、多路並行、互相覈對的工作方式。
這不是一篇物理科普,也不會替你判斷哪家接口更穩。本文只做一件事:把研究帖裏能借鑑的工程信號,翻譯成你自己跑重度 Agent 任務時可以照着做的步驟。
核心價值:讀完本文,你會知道怎麼把主推理和複覈拆成不同角色、給每一路代理寫清停機線,並且只在型號表裏有明確標價的模型之間做選擇,讓長任務的花費可預估、可封頂。
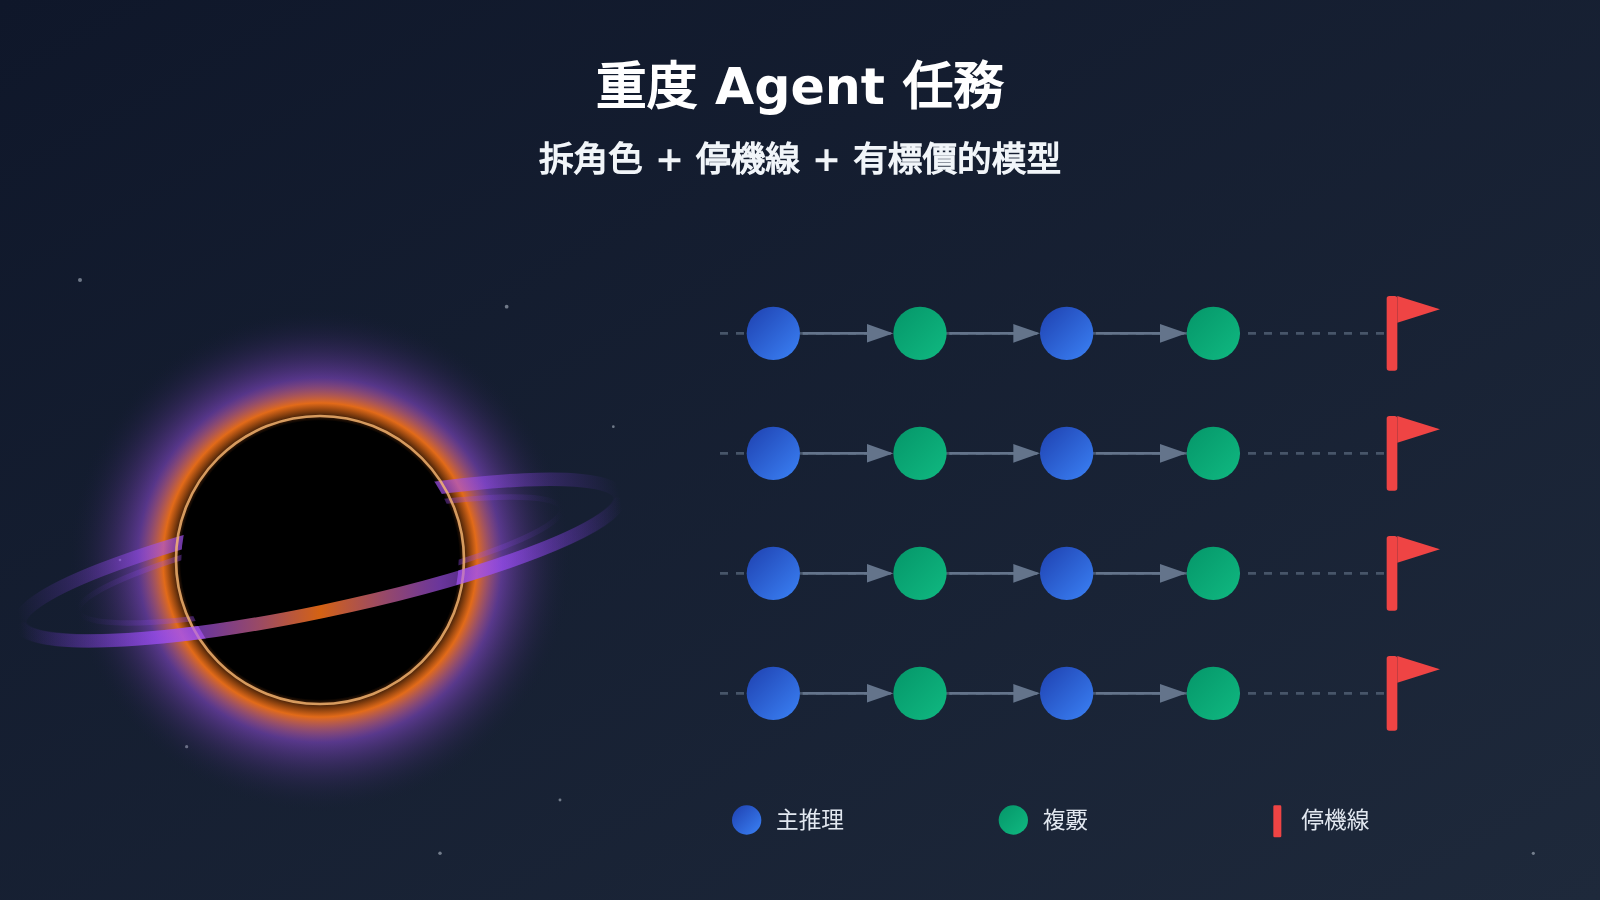
從 Claude Fable 5.2 研究帖看重度 Agent 任務的核心要點
先用一兩段把由頭講清楚。研究帖是 Anthropic 的官方自述,涉及的兩篇論文目前是預印本,並非已經過同行評審的論文。兩道題都屬於理論物理,描述的不是我們所在的宇宙,也沒有實際用途,所以它的意義主要在“方法”,而不是“結論有多重要”。
按帖子的說法,2026 年 8 月研究員 Hongbin Chen 讓 Claude 列出黑洞與 bootstrap 方向的開放題,幾小時後得到 22 道。他給每道題單獨分配一個代理,代理之間能讀到彼此的進度,然後在後臺跑了大約六週。帖子原話是“沒有特殊配置”,但這是官方對搭建方式的描述,不等於零成本,帖子也沒有給出成本賬單。
| 研究帖中的事實 | 對重度 Agent 任務的啓發 | 你可以怎麼做 |
|---|---|---|
| 一題一代理,代理可讀彼此進度 | 任務拆分粒度要清楚,共享狀態要可讀 | 每個子任務獨立代理,進度寫入共享存儲 |
| 幾乎每一步由兩份代理獨立做再對文獻 | 關鍵步驟需要獨立複覈 | 主推理與複覈分成兩個角色 |
| 早期代理並行試了 61 次沒做成 | 失敗是常態,失敗要有上限 | 每一路寫清最大失敗次數與預算 |
| 結果用 Lean 形式化覈驗、物理學家檢查 | 機器結果最終要外部驗證 | 留出人工或工具校驗環節 |
| 後臺跑了大約六週 | 長任務的花費會累積 | 按型號表標價預估,並設費用封頂 |
重度 Agent 任務的兩道題分別說明了什麼
第一題是 2003 年就被提出、一直沒算完的霍金-佩奇相變計算。帖子說幾乎每一步都由兩份代理獨立做一遍,再與文獻對照,結論是在弱耦合下躍遷仍然是突然的。另一位物理學家用不同方法獨立得到了同樣的答案,形成了交叉印證。對工程實踐而言,這一題說明的是“獨立重複 + 外部對照”這套複覈思路。
第二題是模 bootstrap 最簡單版本的上限問題。更早的一批 Claude 代理並行嘗試了 61 次都沒做成,後來的代理從數值結果裏看出規律,借用了另一道球填充問題的方法,證出最輕黑洞質量的上限大約是 c/9.1266,並且指出這套方法無法再把上限壓得更低。2026 年 9 月,這個結果用 Lean 做了形式化覈驗,論文由 Claude 撰寫,物理學家檢查了主要結果。這一題對工程的啓發是:大量失敗嘗試是過程的一部分,所以每一路都必須有預算和停機條件。
需要特別說明的是,帖子裏的做法是“同一個模型的多份拷貝互相覈對”,並不是“規劃用貴模型、複覈用便宜模型”。下文的拆角色省錢方案,是讀者可以嘗試的工程做法,而不是這篇研究已經驗證過的結論。
重度 Agent 任務如何拆角色:主推理與複覈分開
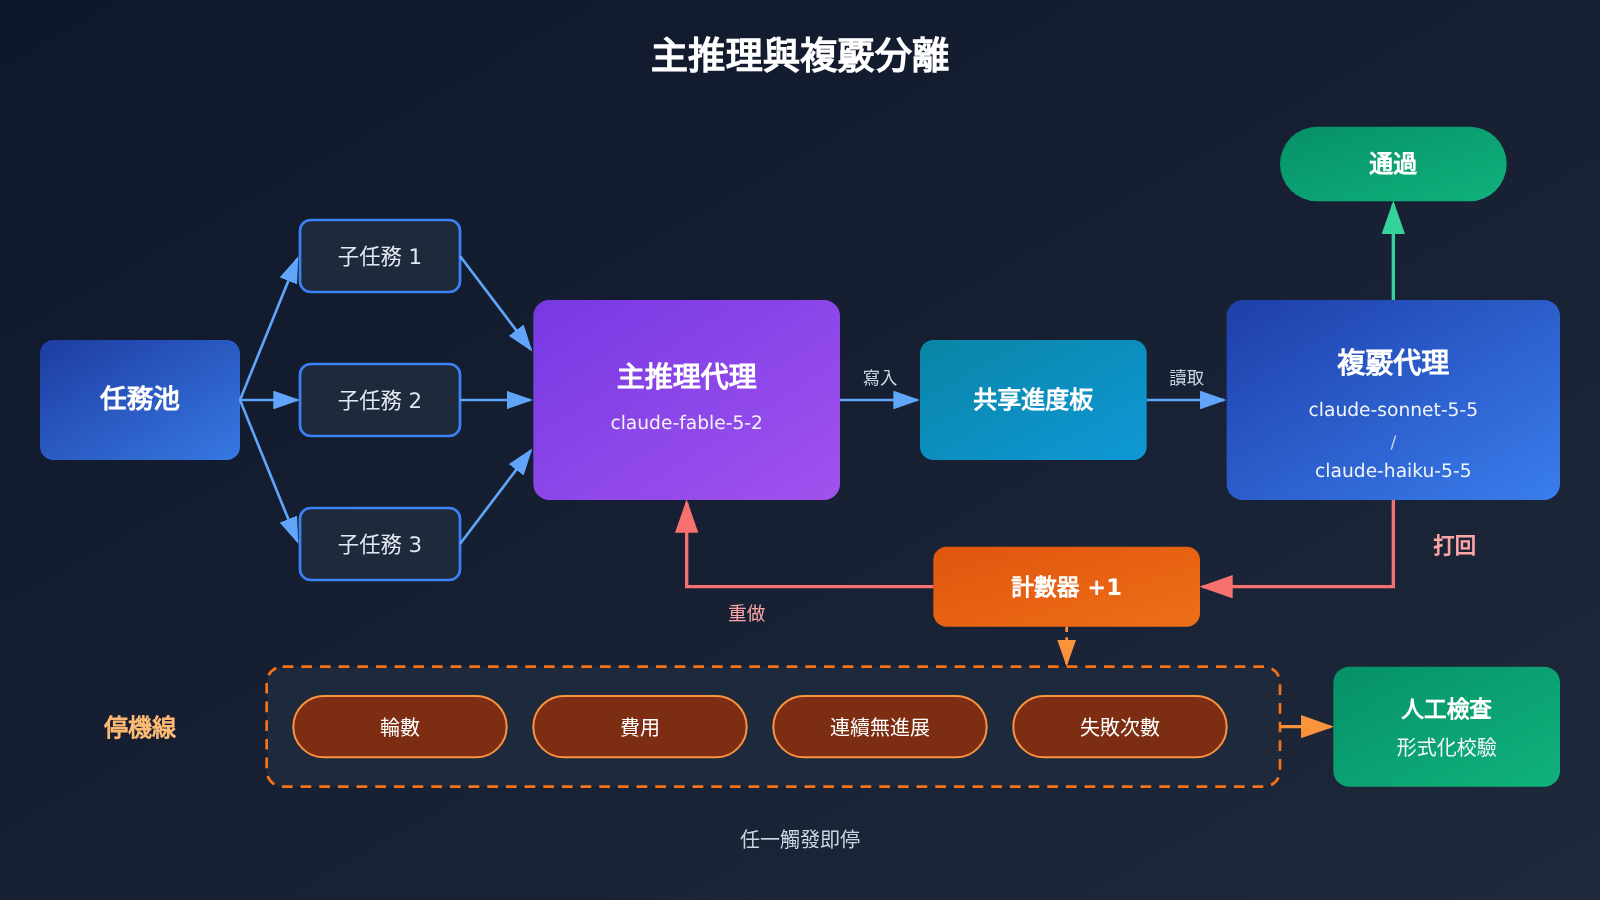
重度 Agent 任務裏,最貴的通常是需要深度推理的那一路,最頻繁的則是檢查、比對、格式校驗這類複覈動作。如果所有調用都走同一個最貴的模型,費用會隨着輪數線性甚至超線性增長。把“想出來”和“查一遍”拆成兩個角色,是控制成本最直接的手段。
拆分的原則可以概括爲:需要開放式推理、長鏈條規劃的步驟交給主推理角色;判斷“這一步是否和上一步一致”“輸出格式是否合規”“結論是否和已知文獻衝突”這類有明確標準的檢查,交給複覈角色。複覈角色給出的應當是結構化判斷,而不是重新推一遍。
| 角色 | 負責內容 | 候選模型 ID | 輸出要求 |
|---|---|---|---|
| 主推理 | 開放式推導、方案生成、關鍵步驟 | claude-fable-5-2、claude-fable-5-2-thinking |
完整推理過程與中間結論 |
| 一級複覈 | 邏輯一致性、步驟對照、引用覈對 | claude-sonnet-5-5 |
PASS / FAIL 加理由 |
| 輕量校驗 | 格式檢查、字段完整性、簡單比對 | claude-haiku-5-5 |
結構化 JSON 結果 |
| 外部校驗 | 形式化證明、數值驗證、人工審閱 | 工具或人工 | 最終確認 |
這樣拆分以後,所有角色可以走同一個調用入口。通過 API易 apiyi.com,一個 API Key 就能在上表這些模型之間切換,接口是 OpenAI 兼容的,主推理和複覈只需要改 model 參數,不必維護多套 SDK 和多份密鑰。對於需要多路並行的長任務,統一入口也能讓用量統計集中在一處,便於對賬。
不過要注意,複覈模型更便宜並不意味着更可靠。複覈角色能否勝任,取決於你給它的判斷標準是否足夠明確。建議先用一小批已知答案的樣本跑一遍,確認複覈模型的通過與打回判斷基本符合預期,再放進長任務裏。
重度 Agent 任務怎麼選 API:對價格和模型 ID
長任務的預算控制,前提是每一次調用的單價都是確定的。建議堅持一條原則:只調用型號表裏有明確標價的模型,並且在代碼裏寫死模型 ID 與對應單價,而不是在運行中臨時更換。
根據 Anthropic 官方模型頁,Claude Fable 5.2 於 2026 年 11 月 9 日發佈,模型 ID 是 claude-fable-5-2,上下文 100 萬 tokens,最大輸出 12.8 萬 tokens,思考默認開啓。下表是覈對日(2026-11-19)API易 apiyi.com 型號總表中與本文相關模型的標價,單位爲美元每百萬 tokens。
| 模型 ID | 輸入 | 緩存讀 | 輸出 | 本文建議角色 |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | 主推理 |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | 主推理(思考版) |
claude-fable-5-1 |
10 | 0.25 | 50 | 相鄰版本,供對照 |
claude-sonnet-5-5 |
2 | 0.1 | 10 | 一級複覈 |
claude-haiku-5-5 |
0.1 | 0.01 | 0.5 | 輕量校驗 |
從表裏能讀出幾個對長任務很關鍵的信息。第一,claude-fable-5-2 的標價低於相鄰的 claude-fable-5-1,如果你原來的主推理在用舊版本,值得評估遷移。第二,緩存讀價格只有輸入價的 2.5%,長任務裏代理反覆讀取共享進度、系統提示和背景文檔,這部分如果能命中緩存,費用差異會很明顯,是否命中取決於調用方式和平臺規則,以文檔說明爲準。第三,複覈模型與主推理的單價差距是數量級的。
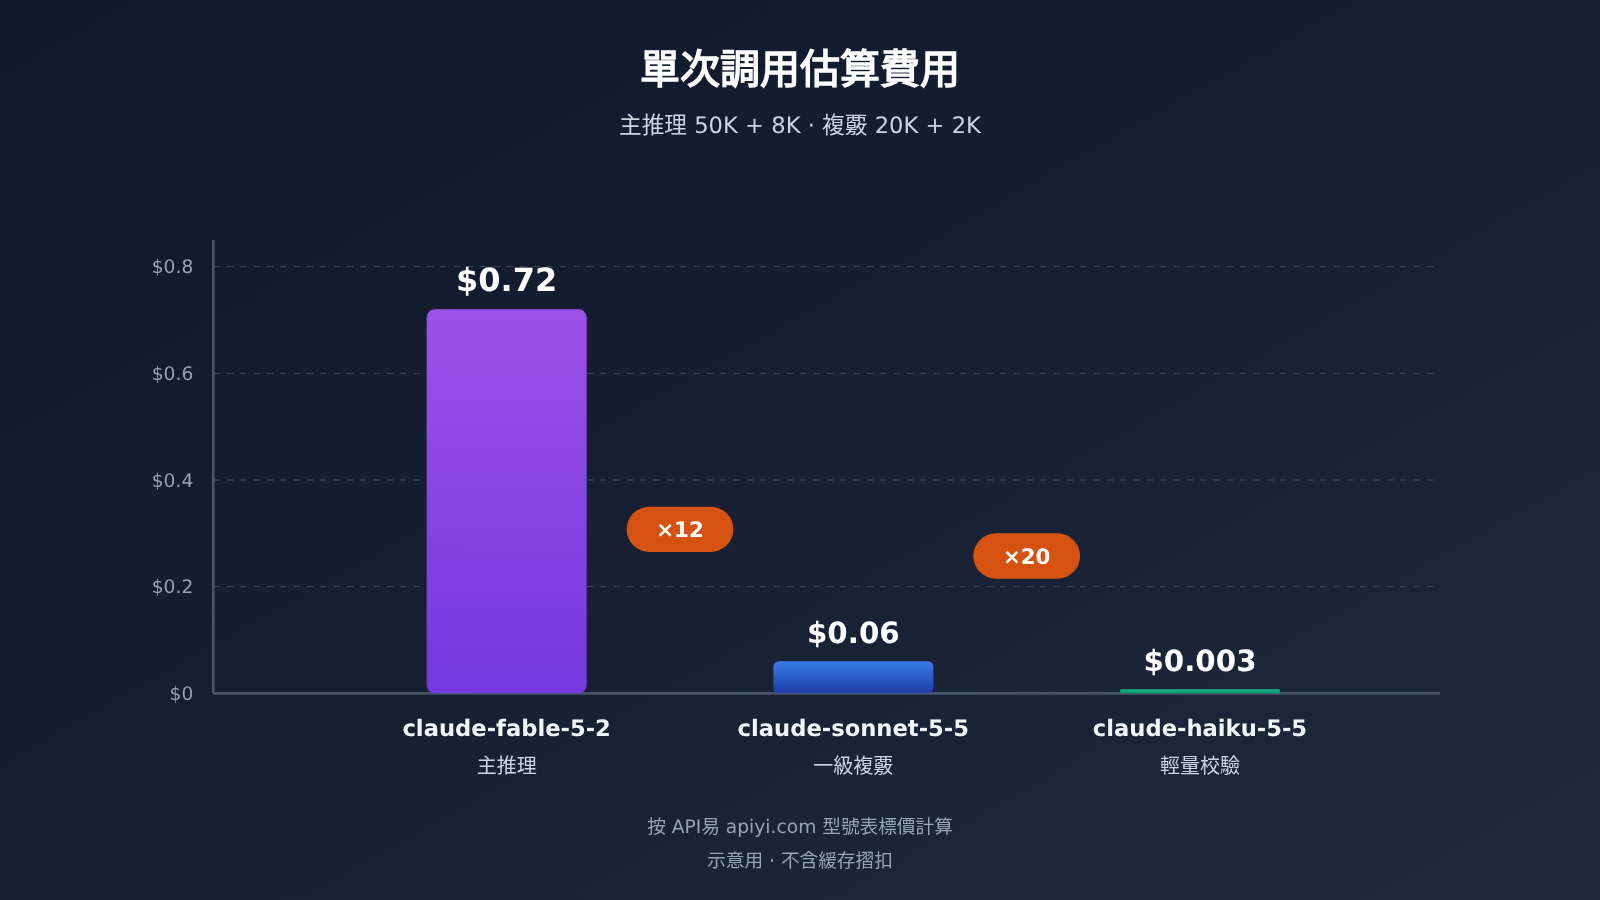
用一組假設數字感受一下:一次主推理調用輸入 5 萬 tokens、輸出 8 千 tokens,在 claude-fable-5-2 上約 0.4 + 0.32 = 0.72 美元;一次複覈輸入 2 萬、輸出 2 千 tokens,在 claude-sonnet-5-5 上約 0.04 + 0.02 = 0.06 美元,在 claude-haiku-5-5 上約 0.003 美元。如果複覈也用主推理模型,同樣的複覈調用約 0.16 + 0.08 = 0.24 美元。這只是算術示意,實際 token 數取決於你的任務。
另外,官方模型頁上 Opus 5.5 的標價爲輸入 4、輸出 20,Sonnet 5.5 爲 2 和 10,Haiku 5.5 從 0.10 和 0.50 起,可以作爲了解官方定價梯度的參照。實際調用時,型號和價格以平臺型號列表爲準,API易 的 claude-fable-5-2 系列支持 chat 和 messages 兩種端點,入口統一爲 https://api.apiyi.com/v1。
重度 Agent 任務快速上手:帶停機線的調度代碼
極簡示例
先確認主推理模型能正常調用,並且能拿到 usage 字段,這是後面做費用統計的基礎:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出這一步推導需要獨立覈對的三個關鍵假設"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # 用於統計 token 與估算費用
爲每一路代理寫清停機線
研究帖裏早期代理並行嘗試了 61 次都沒成功,這提醒我們:重度 Agent 任務一定會有大量失敗嘗試,而失敗本身也在花錢。停機線的作用,就是讓每一路代理在失控之前自動停下來,交給人或工具判斷。
| 停機線 | 含義 | 建議初始值(按任務調整) |
|---|---|---|
| 最大輪數 | 主推理與複覈往返的上限 | 10-30 輪 |
| 費用封頂 | 單路累計估算費用上限 | 按單題預算設定 |
| 連續無進展 | 複覈連續打回且無新結論 | 3-5 次 |
| 最大失敗次數 | 累計被複核打回的次數 | 輪數的一半左右 |
| 輸出長度 | 單次輸出 token 上限 | 遠低於最大輸出 12.8 萬 |
查看完整實現代碼
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # API易 統一入口,主推理與複覈共用
)

# 單價:美元 / 百萬 tokens,按平臺型號表寫死,變更時手動更新
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """按標價估算,未計入緩存摺扣,結果偏保守。"""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "達到最大輪數"
    if state.cost_usd >= line.max_cost_usd:
        return "達到費用封頂"
    if state.no_progress >= line.max_no_progress:
        return "連續無進展"
    if state.failures >= line.max_failures:
        return "失敗次數過多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚無進展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推進一步,寫清依據。"},
            {"role": "user", "content": f"任務:{task}\n當前進展:{progress}\n請推進下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是複覈代理,不重新推導,只判斷。"
                                          "第一行只輸出 PASS 或 FAIL,第二行給理由。"},
            {"role": "user", "content": f"已有進展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("覈對給定推導中每一步的符號約定是否一致,完成後寫“已完成”"))
這段代碼有三個刻意的設計。其一,單價表寫死在代碼裏,任何人改模型都必須同時改單價,避免“換了個沒標價的模型”導致預算失真。其二,複覈角色被要求只輸出 PASS 或 FAIL 加理由,不允許重新推導,控制複覈的輸出長度。其三,停機後返回當前進展和累計費用,方便人工接手,而不是讓代理無限重試。
🚀 快速開始:建議先在 API易 apiyi.com 用新用戶的免費測試額度,拿一道你已知答案的小題跑通上面的流程,確認複覈判斷和費用估算都符合預期,再逐步放大並行路數和輪數。
重度 Agent 任務選 API 常見問題 FAQ
Q1:Claude Fable 5.2 破解黑洞物理難題這件事可信嗎?
這是 Anthropic 2026 年 11 月 17 日研究帖中的官方自述。相關兩篇論文是預印本,尚未經過同行評審。其中第二題的結果在 2026 年 9 月用 Lean 做了形式化覈驗,第一題有另一位物理學家用不同方法得到同樣答案。閱讀時應按“官方自述 + 預印本”的級別理解。
Q2:研究帖說“沒有特殊配置”,是不是意味着很便宜?
不是。“沒有特殊配置”描述的是搭建方式,帖子並沒有給出成本賬單。22 道題、每題一個代理、後臺跑約六週,調用量本身就不小。自己跑類似規模的任務時,應按型號表標價自行估算,並設費用封頂。
Q3:用便宜模型做複覈,是研究帖驗證過的做法嗎?
不是。帖子的做法是同一模型的多份拷貝獨立重做、互相覈對。“主推理用貴模型、複覈用便宜模型”是本文建議你嘗試的工程做法,效果需要你在自己的任務上驗證。對正確性要求極高的步驟,也可以保留“兩份主推理獨立重做”的方式。
Q4:`claude-fable-5-2` 和 `claude-fable-5-2-thinking` 怎麼選?
兩者在 API易 型號表中的標價相同,都是輸入 8、緩存讀 0.2、輸出 40 美元每百萬 tokens。官方模型頁說明 Fable 5.2 思考默認開啓。兩個 ID 在調用行爲上的具體差異以平臺型號說明爲準,建議各跑幾次同一任務,對比輸出長度和 `usage`,再決定主推理用哪個。
Q5:如何通過一個接口同時調用主推理和複覈模型?
在 API易 apiyi.com 註冊並獲取 API Key 後,把 SDK 的 base_url 設爲 `https://api.apiyi.com/v1`,主推理與複覈只需切換 `model` 參數即可,例如 `claude-fable-5-2` 與 `claude-sonnet-5-5`。新用戶有免費測試額度,適合先驗證停機線和複覈邏輯。
Q6:長任務裏緩存讀價格有什麼意義?
Fable 5.2 的緩存讀價格是輸入價的 2.5%,即 0.2 美元每百萬 tokens。多代理長任務會反覆讀取系統提示、背景資料和共享進度,這部分內容保持穩定、放在提示前部,更有機會命中緩存。是否命中、如何計費,以平臺文檔爲準。
Q7:停機線設多少合適?
沒有通用數字。建議先從保守值開始:輪數 10-30、連續無進展 3-5 次、單路費用按題目價值設封頂。跑完一批後看停機原因分佈,如果大多數是“費用封頂”卻已接近完成,再適當放寬;如果大多數是“連續無進展”,說明任務拆得不夠細。
Q8:這種做法有哪些限制?
一是複覈模型可能漏判或誤判,需要用已知答案樣本校準。二是費用估算基於標價,未計緩存摺扣和失敗重試的波動。三是像研究帖那樣,最終結論仍需要外部校驗,例如形式化證明或領域專家審閱,代理之間互相通過不等於結果正確。
重度 Agent 任務選 API 核心要點 Key Takeaways
- 由頭定性:Fable 5.2 黑洞研究是官方自述,論文爲預印本,看方法不看結論
- 拆角色:開放推理交給主推理模型,有明確標準的檢查交給複覈模型
- 複覈要獨立:複覈只判斷不重推,輸出 PASS / FAIL 加理由
- 停機線必寫:輪數、費用、連續無進展、失敗次數四條線缺一不可
- 只用有標價的模型:模型 ID 與單價寫死在代碼裏,換模型必須同步改價
- 善用緩存讀:穩定的背景與進展放前部,緩存讀僅爲輸入價的 2.5%
- 統一入口上手:通過 API易 一個 Key 切換主推理與複覈模型,先用免費額度跑小題
總結
從 Claude Fable 5.2 破解黑洞物理難題這件事出發,重度 Agent 任務最值得借鑑的是三點:
- 主推理與複覈分開:研究帖用同一模型多份拷貝互相覈對,你可以在此基礎上嘗試按角色選不同價位的模型,並用樣本驗證複覈質量。
- 每一路寫清停機線:61 次失敗嘗試說明失敗是常態,輪數、費用、無進展和失敗次數都要有上限。
- 只調型號表裏有標價的模型:把
claude-fable-5-2、claude-sonnet-5-5、claude-haiku-5-5等模型 ID 和單價寫進代碼,費用纔可預估、可封頂。
長任務的成敗往往不取決於某一次調用有多聰明,而取決於整體流程能否在可控預算內持續推進並留下可校驗的結果。推薦通過 API易 apiyi.com 用免費測試額度先跑通一道小題,再按停機原因逐步調參、擴大規模。
📚 參考資料
-
Anthropic 研究帖:Claude Fable 5.2 多代理完成兩道黑洞物理題的官方自述
- 鏈接:
anthropic.com/research/claude-black-hole-physics - 說明:瞭解代理分工、時長與複覈方式的一手描述
- 鏈接:
-
預印本論文一:研究帖關聯的預印本,未經同行評審
- 鏈接:
hexagonmath.org/2611.00175v1 - 說明:適合想查看結果原文的讀者
- 鏈接:
-
預印本論文二:研究帖關聯的另一篇預印本,未經同行評審
- 鏈接:
hexagonmath.org/2611.00174v1 - 說明:與上一篇對照閱讀
- 鏈接:
-
Claude Fable 5.2 官方模型頁:模型 ID、上下文、最大輸出與官方標價
- 鏈接:
platform.claude.com/docs/en/models/fable-5-2/overview - 說明:覈對模型規格與官方定價梯度
- 鏈接:
作者:API易 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,型號與價格說明可查閱 docs.apiyi.com 文檔中心


